同じお題で AI を比べる 第14回
文字起こしの精度を AI 3 つで比較 会議・早口・雑音ありの合成音声で試した
 佐々木 航
この記事でわかること
- 合成の音声 6 本(会議・早口・雑音あり)で測った字の誤り
- 数字・架空の名前・用語のうち、原稿どおりにならなかった所
- 話者の分け方と料金、会議の録音を送る前に確かめること
確認した環境: YOBITSUGI AI で各モデルを実行 / 2026年10月14日に確認
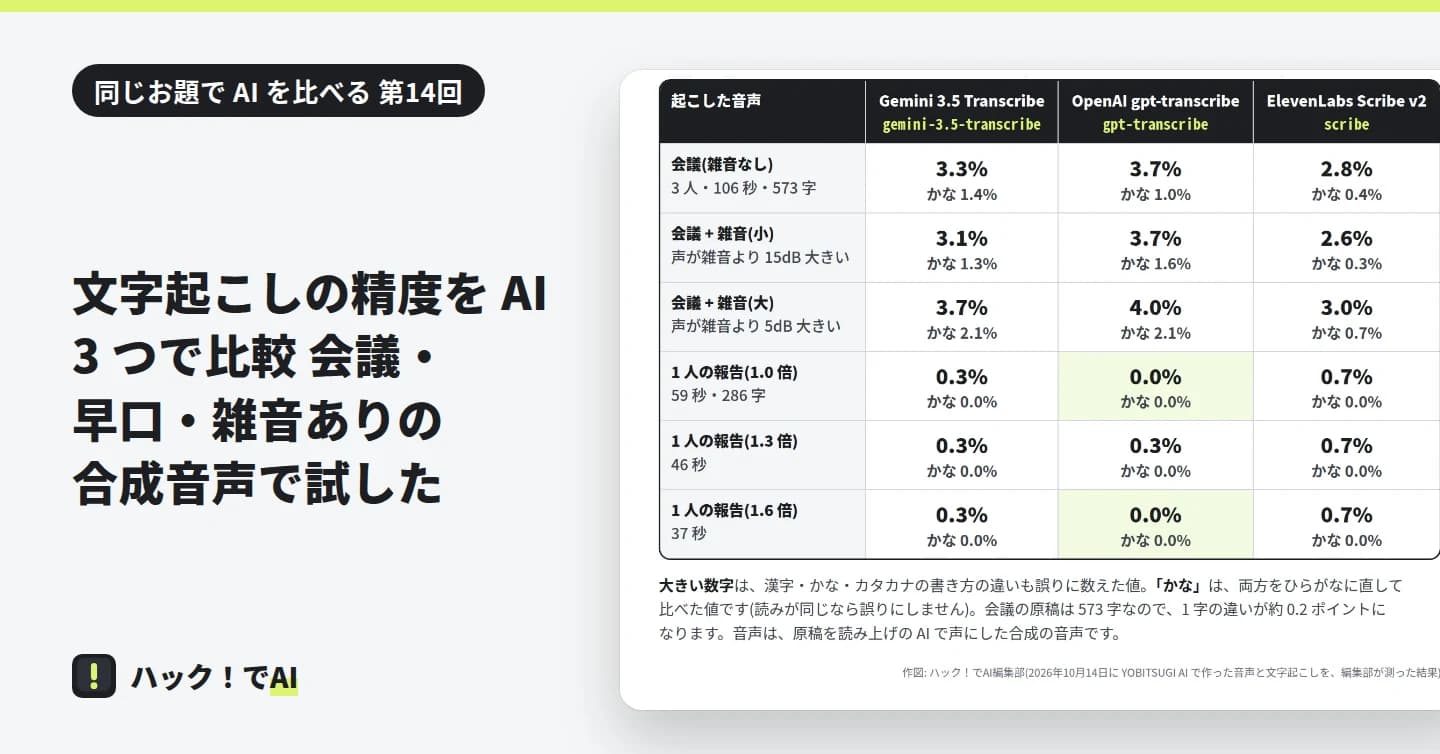
会議の録音を AI で文字にするとき、どれが正確で、早口や雑音があるとどれくらい落ちるのか。正解の原稿を書き、読み上げの AI で声にした合成の音声 6 本を、3 つの文字起こしの AI に同じように渡して、原稿と 1 字ずつ比べました。3 人の会議の音声(106 秒・原稿 573 字)では、誤りは 16〜21 字(2.8〜3.7%)で、数字・日付・金額の 10 か所は 3 つとも全部合っていました。誤りの 6〜7 割は架空の会社名と商品名の中で、1.6 倍に速めた音声でも誤りは増えず、大きな雑音を重ねると 1〜2 字増えました。
結果の早見
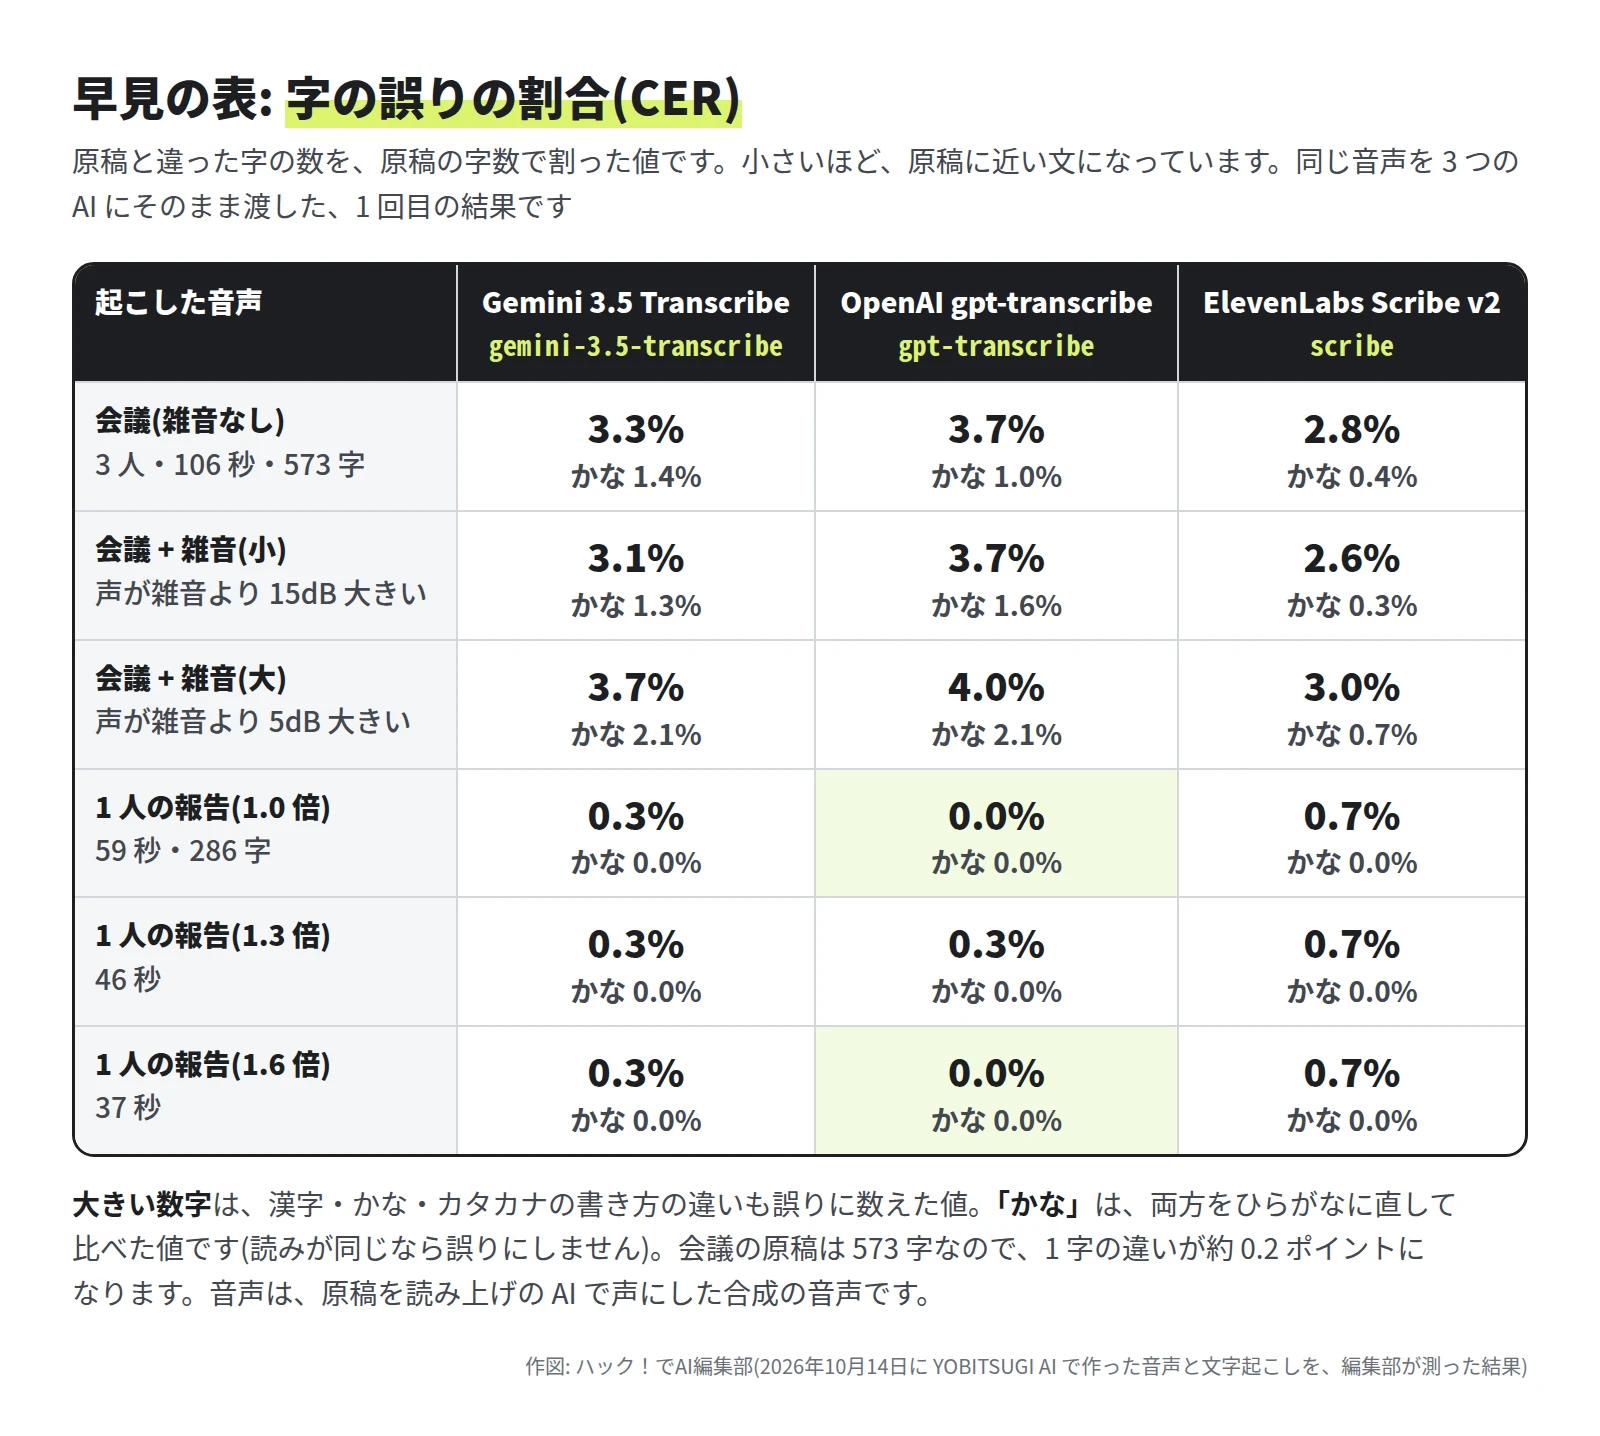
CER(字の誤りの割合)は、原稿と違った字の数を、原稿の字数で割った値です。会議の原稿は 573 字なので、1 字の違いが約 0.2 ポイントになります。会議の 3 本では、3 つの AI の誤りの字数の差は、大きい所で 5〜6 字でした。どれも 1 本の音声を 1 回ずつ起こした結果なので、値の小さい順を、そのまま正確さの順位としては読めません。
比べ方
モデル
| 記事での呼び方 | YOBITSUGI AI の記録の名前 | YOBITSUGI AI が渡した設定 |
|---|---|---|
| Gemini 3.5 Transcribe | gemini-3.5-transcribe | 音声と一緒に「この音声を、話されている言葉のまま文字に起こしてください。」という文を渡す。言語の指定は渡らない |
| gpt-transcribe(OpenAI) | gpt-transcribe | 言語に日本語(ja)を指定 |
| ElevenLabs Scribe v2 | scribe | YOBITSUGI AI では Scribe v2(scribe_v2)を指定して呼んでいる。言語に日本語(ja)を指定。話者を分ける設定が入っている |
- 起こし方の指示(用語や書き方の注文)は付けていません。表の設定は、YOBITSUGI AI の道具の既定です。
- ElevenLabs の記録の名前は scribe で、v2 で動いたかは記録からは確かめられません。記事では、指定した名前で Scribe v2 と呼びます。
- 18 回とも 1 回目で返り、やり直しはありません。1 件ずつ順に頼みました。
正解が分かる音声を作った
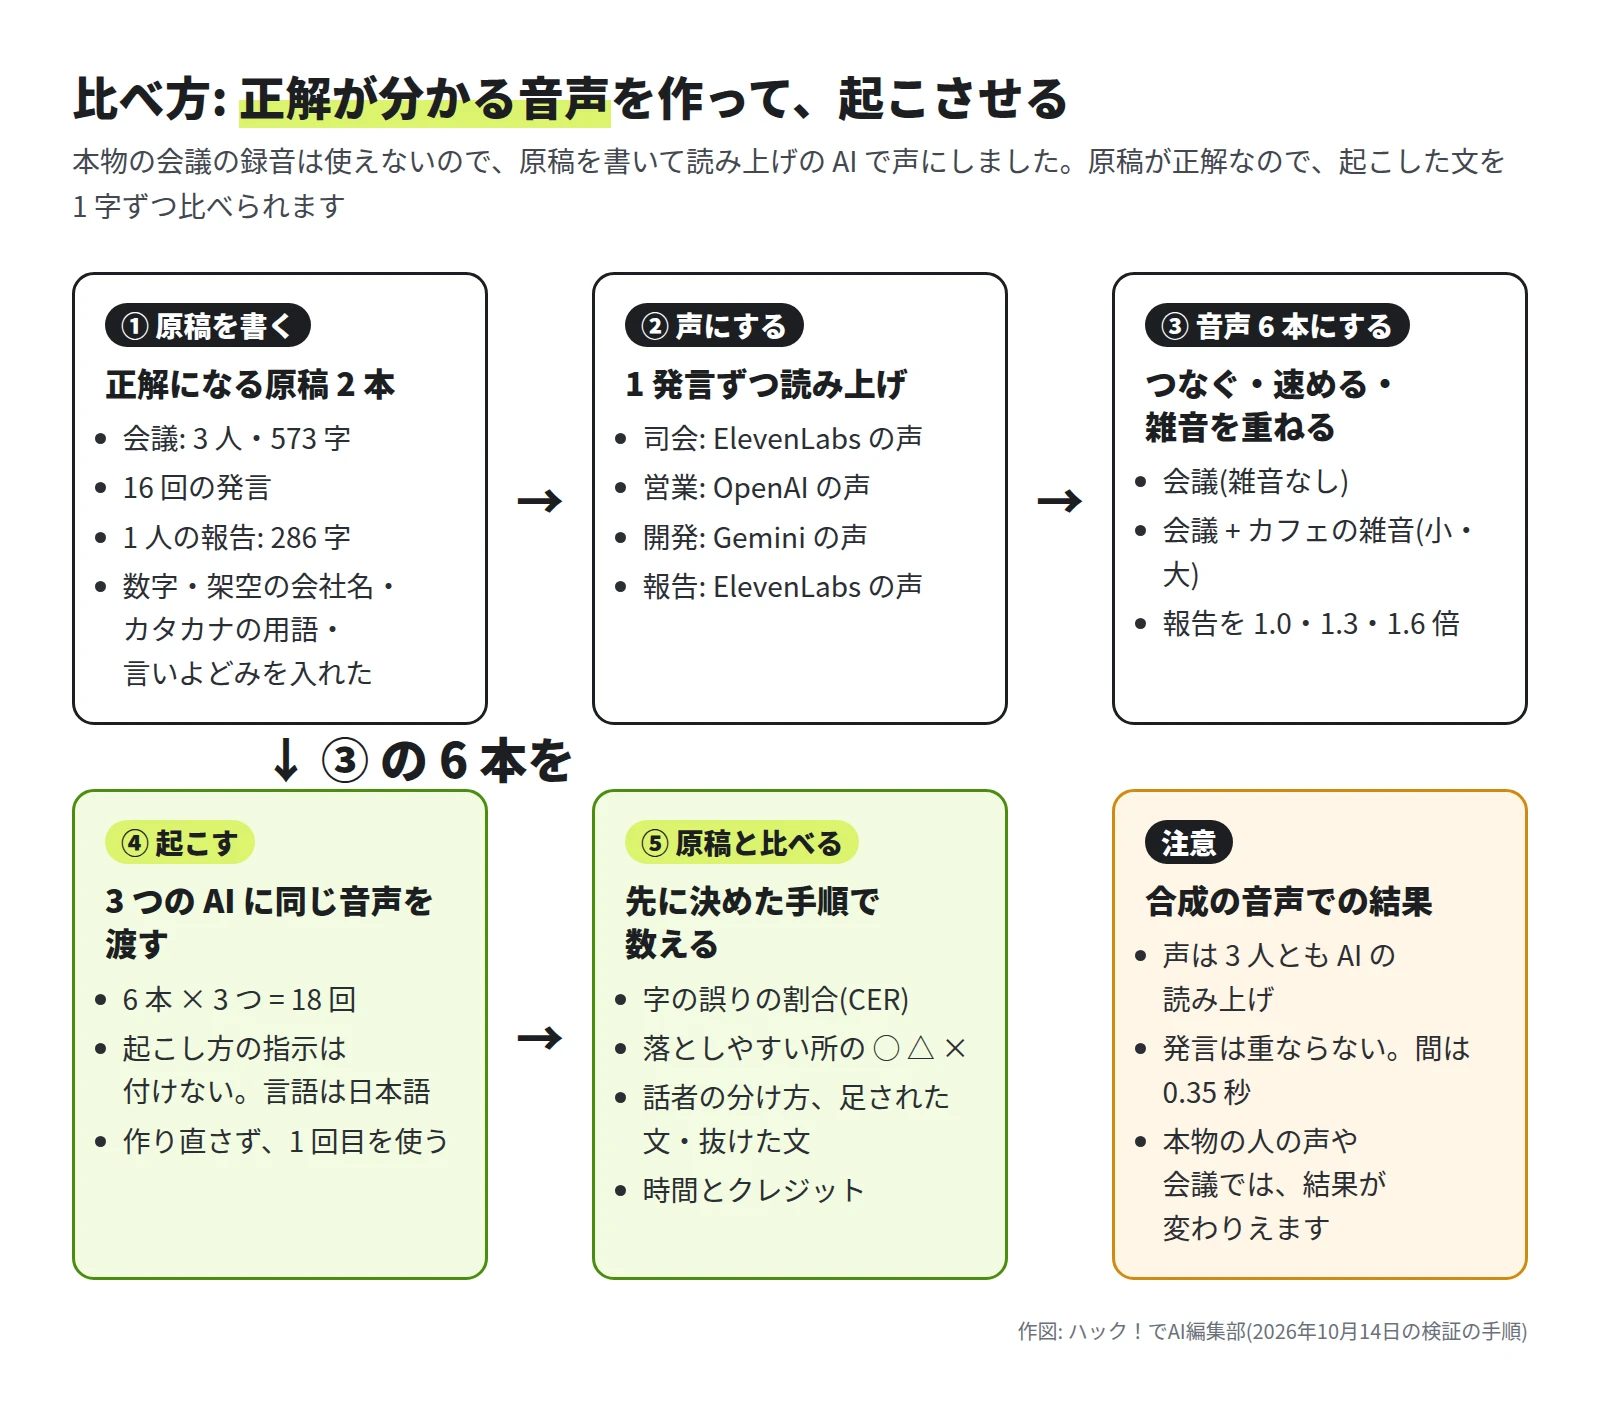
原稿は 2 本です。会社・人・商品は、どれも架空です。
- 会議: 3 人の 16 回の発言です。日付・金額・バージョンの番号、架空の会社名(ホシミネ物流・アオバネ商事)と商品名(ツムギノート)、カタカナの用語、言いよどみ 4 か所を入れました。
- 1 人の報告: 件数・割合・時間などの数字を 8 か所入れました。
会議は、話者ごとに別の会社の読み上げの声で 1 発言ずつ作ってつなぎ、3 つの AI と同じ会社の声が 1 人ずつ入るようにしました。
| 音声 | 中身 | 長さ |
|---|---|---|
| 会議(雑音なし) | 3 人の声をつないだもの。話者ごとに声の大きさをそろえた | 106 秒 |
| 会議 + 雑音(小) | カフェの雑音を重ねた。声が雑音より 15dB 大きい | 106 秒 |
| 会議 + 雑音(大) | 同じ雑音を大きくした。声が雑音より 5dB 大きい | 106 秒 |
| 報告(1.0 倍) | 1 人の声。1 秒あたり約 5.3 字 | 59 秒 |
| 報告(1.3 倍) | 同じ音声を、高さを変えずに速くした。約 7.0 字 | 46 秒 |
| 報告(1.6 倍) | 同じく。約 8.5 字 | 37 秒 |
- 速さは、句読点を含む 313 字を、前後の無音を除いた長さで割った値です。速めるのには ffmpeg の atempo を使いました。
- 雑音は、ElevenLabs の効果音で作ったカフェの環境音です。大きさは ffmpeg の volumedetect で測り、声(無音を除いて -23.1dB)に、雑音を -38.1dB と -28.1dB にして重ねました。
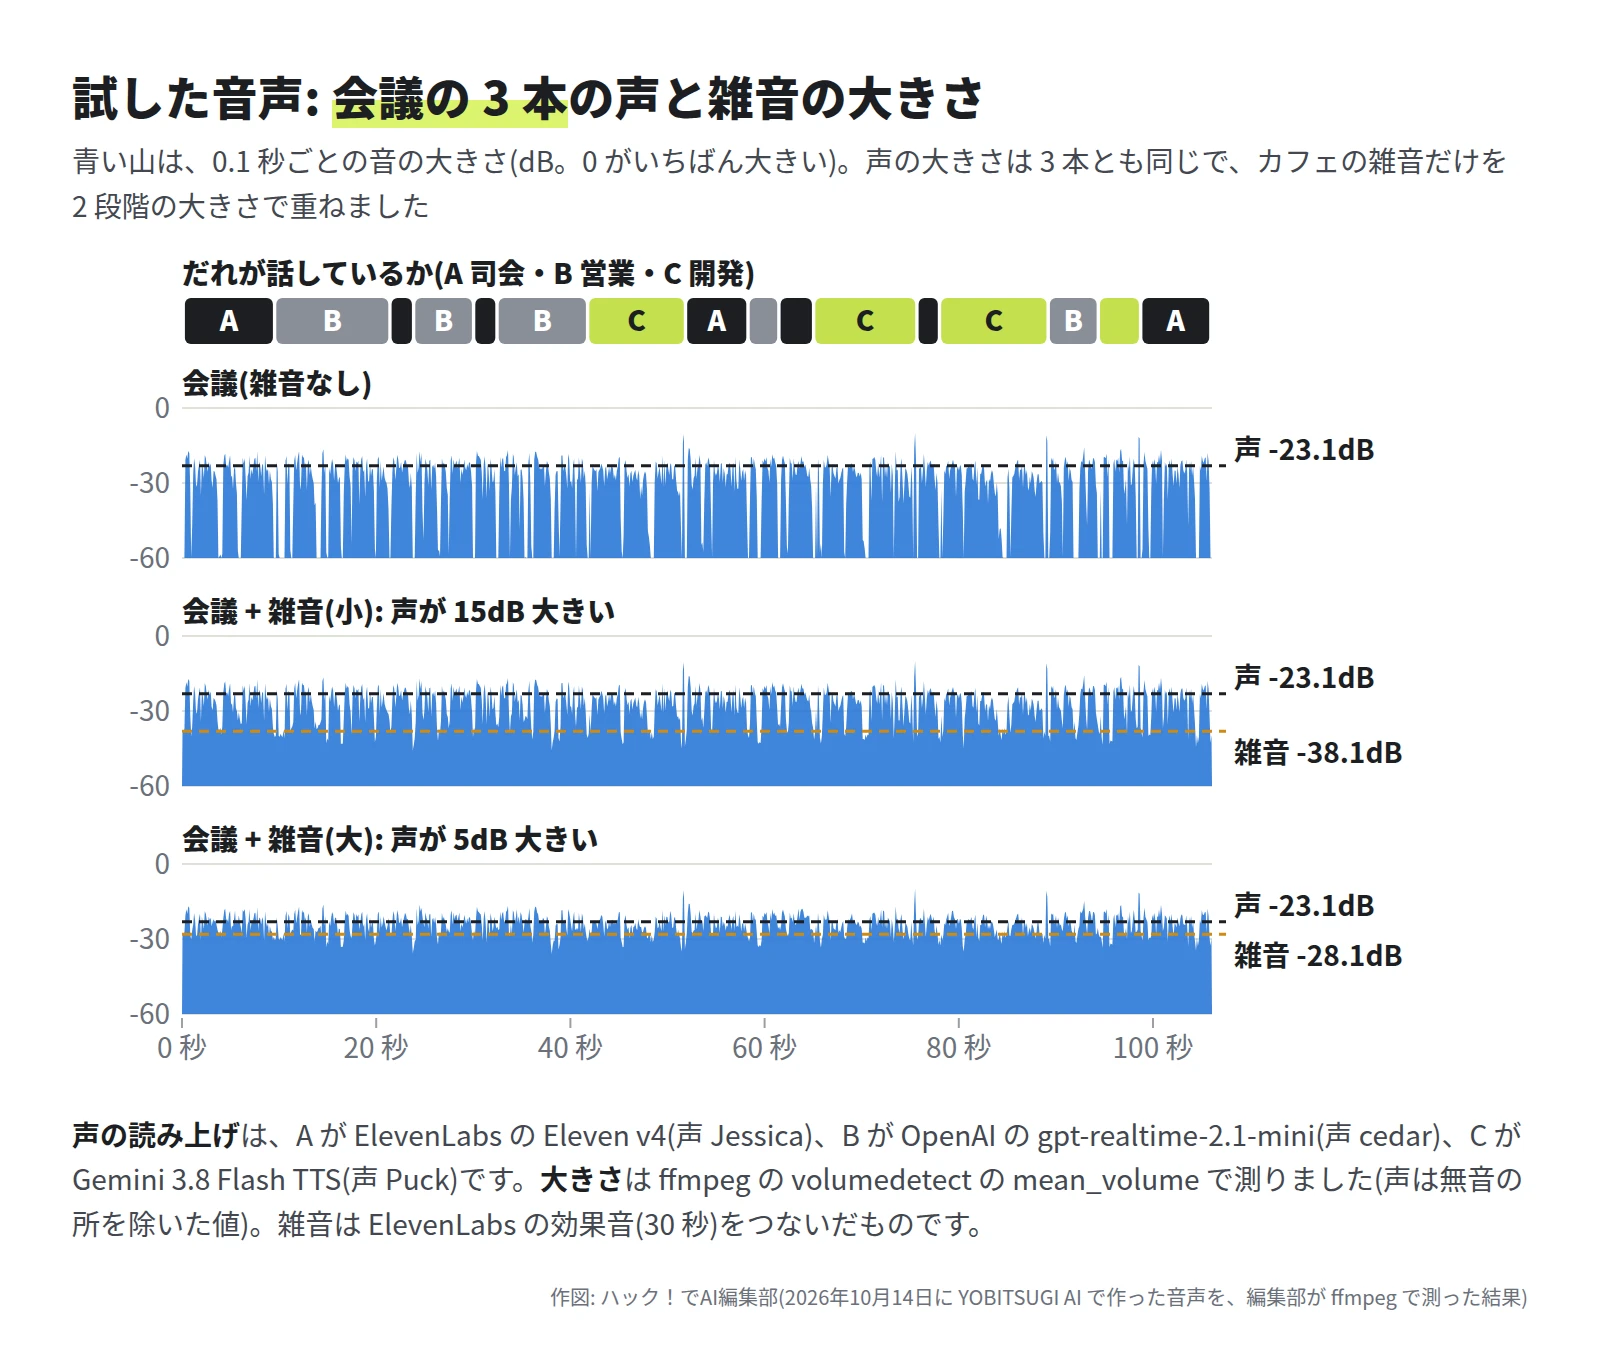
使った音声
3 つの AI に渡したのと同じ音声です(mp3・128kbps・モノラル)。
原稿 1: 会議(16 回の発言の全文)
早瀬(司会): それでは、10月14日の定例会議を始めます。今日のアジェンダは3つです。まず、柏木さんから営業の報告をお願いします。
柏木(営業): はい。えーと、先週は商談が12件ありました。そのうち、ホシミネ物流さんから、ツムギノートを42アカウントで契約したいという連絡をいただいています。
早瀬(司会): 金額はどのくらいになりますか。
柏木(営業): 月額で18万9,000円、年間ですと226万8,000円の見込みです。
早瀬(司会): 導入の時期は決まっていますか。
柏木(営業): 先方の希望は11月4日です。ただ、オンボーディングの担当が足りないので、あのー、宮下さんのチームから1名お借りできないでしょうか。
宮下(開発): うーん、11月の第1週は、バージョン3.2のリリースと重なります。11月10日以降でしたら、2名出せます。
早瀬(司会): では、柏木さんは先方に、開始を11月10日にできないか確認してください。
柏木(営業): 承知しました。金曜日までに回答をもらいます。
早瀬(司会): 次に、開発の進み具合をお願いします。
宮下(開発): はい。ダッシュボードの表示速度の改善は、85%まで終わりました。平均のレスポンスは、2.4秒から0.8秒に短くなっています。
早瀬(司会): 残っている課題は何ですか。
宮下(開発): CSVのインポートで、5万行を超えるとタイムアウトする不具合があります。まあ、修正は10月21日までに終える予定です。
柏木(営業): アオバネ商事さんからも問い合わせが来ています。進み具合を共有してもらえますか。
宮下(開発): 分かりました。毎週水曜日にチャットで報告します。
早瀬(司会): 最後に、次回の定例は10月28日の14時30分からです。お疲れさまでした。
かっこの中の名前と役は、原稿の上だけのものです。音声では読んでいません。
原稿 2: 1 人の報告(全文)
続いて、サポート窓口の9月の状況を報告します。問い合わせの件数は合計で1,356件で、8月より7.5%増えました。内訳は、メールが820件、チャットが412件、電話が124件です。最初の返信までの時間は、平均で3時間20分でした。目標の4時間以内を達成しています。ただ、解決までにかかった日数は平均2.6日で、目標の2日に届いていません。原因は、請求書の再発行と、パスワードの再設定の問い合わせが、月末に集中したことです。対策として、10月20日から、よくある質問のページにテンプレートを追加します。また、新しく入った2名のトレーニングを、11月中旬までに終える予定です。来月は、満足度のアンケートの結果もあわせて報告します。
数え方
数え方は、結果を見る前に決めて、計算のコードを書いてから起こさせました。
- 字の誤りの割合(CER): 原稿と起こした文を同じ手順でそろえてから、置き換わった字・抜けた字・足された字を数えます。手順は、話者の名前の札を外す・全角と半角をそろえる・数字を算用数字にそろえる(十八万九千円・18万9千円 は同じに扱う)・句読点と空白を除く、の 4 つです。
- かなにそろえた値: 「ください・下さい」のような書き分けは、音では決められません。両方を漢字かな変換の道具(pykakasi)でひらがなに直した値も並べました。道具の読みは自動なので、誤りを含みえます(下の「架空の会社名と商品名」に例)。
- 言いよどみ(えーと・あのー・うーん・まあ)も、原稿の字として数えます。
- 落としやすい所: 会議の 20 か所と、報告の 12 か所を先に決めました。
- 話者の分け方と、足された文・抜けた文の数。
採点は編集部(Claude Code を使用)が、先に決めた手順のコードで行い、判定を起こした文と照らして確かめました。18 回の CER は、校閲の担当が別に書いたコードでも同じ値になりました。結果を見たあとに足したのは、誤りの字を「名前・言いよどみ・そのほか」に分けた集計と、○ △ × の判定を 2 か所直したことです。
会議の音声の結果(雑音なし)
数字・日付・金額は、3 つとも全部合った
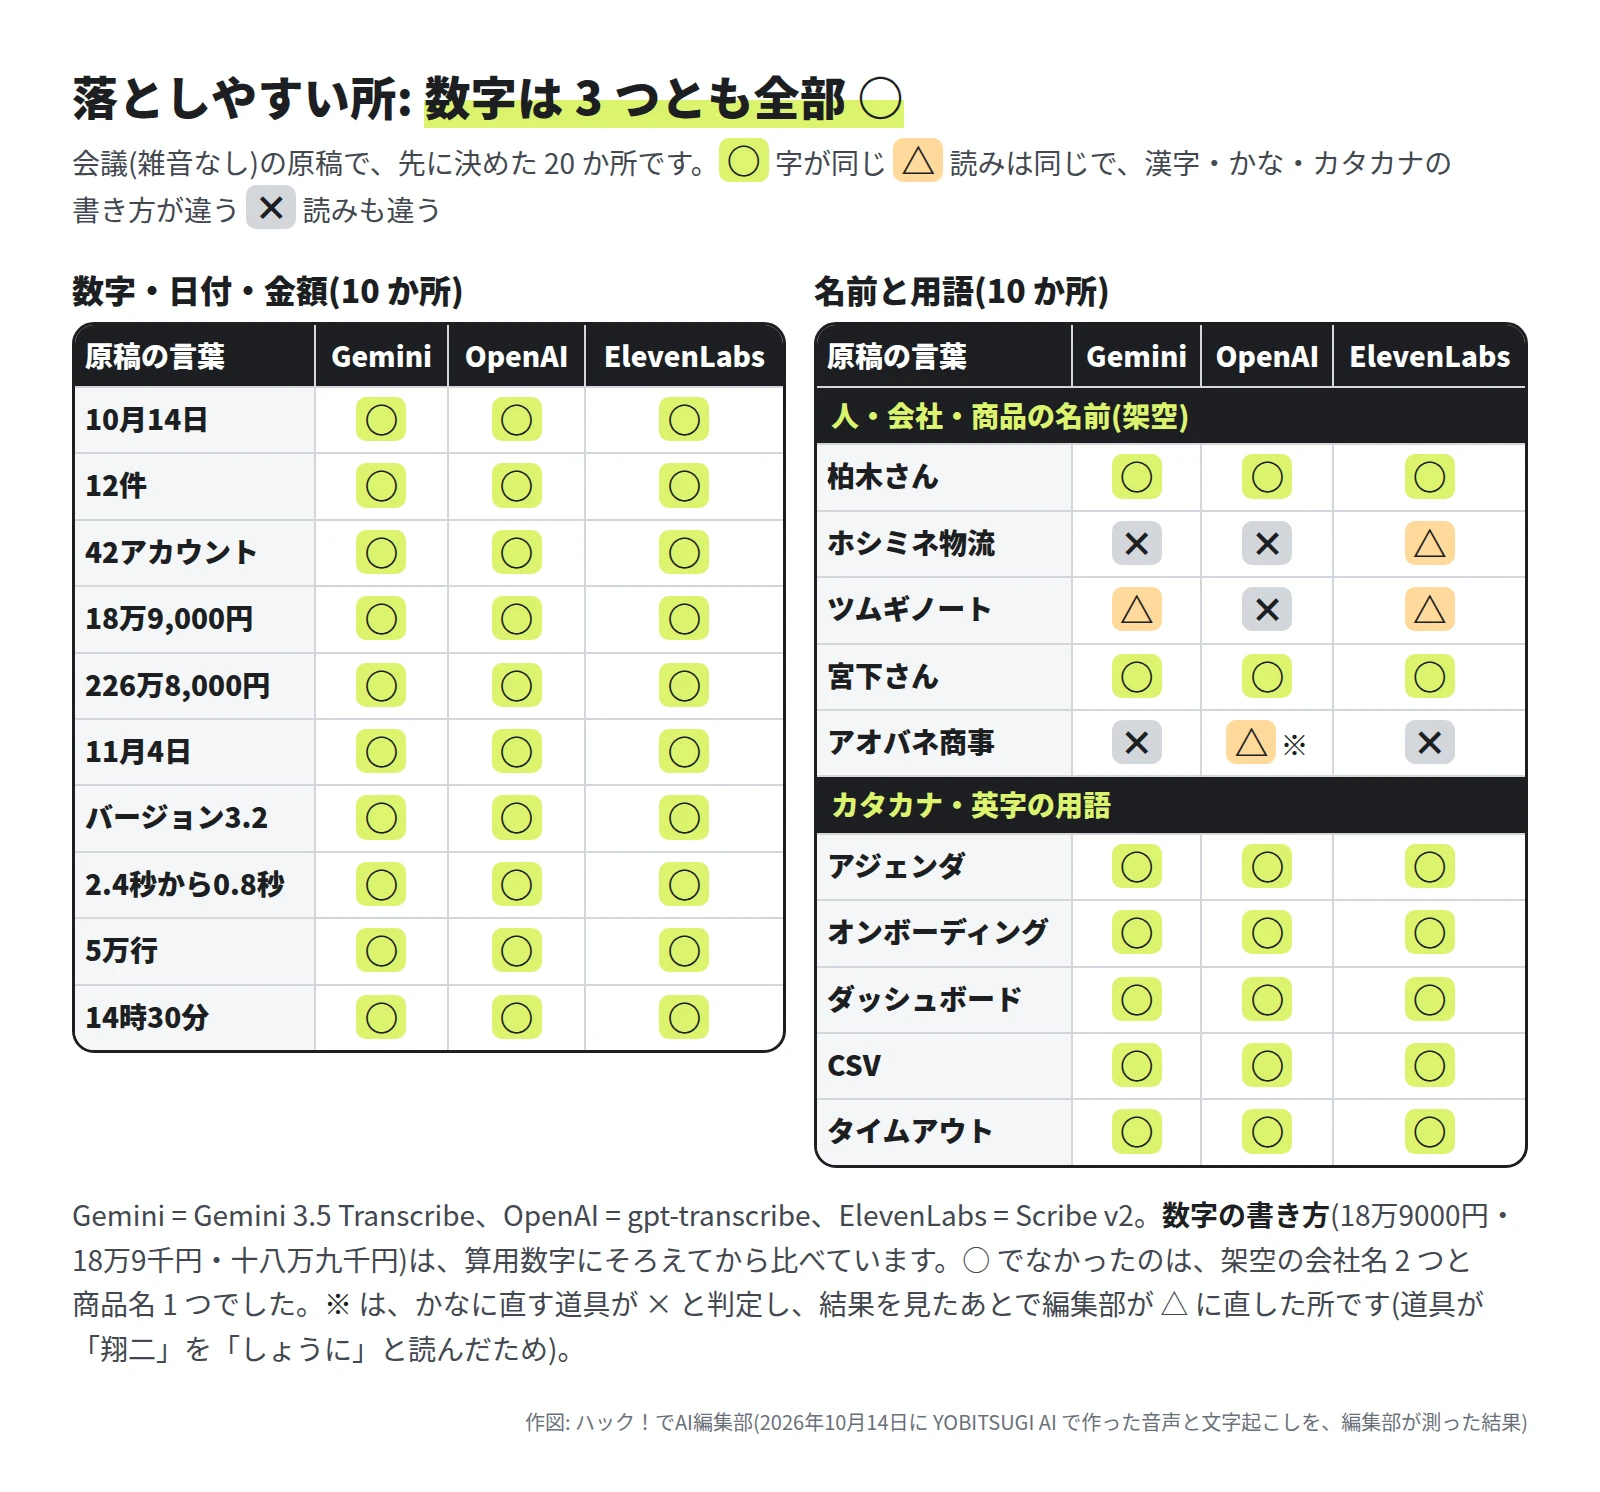
- 雑音を重ねた 2 本と、1 人の報告の 3 本でも、数字の所は全部合っていました。
- 数字の書き方は違います。Gemini 3.5 Transcribe と gpt-transcribe は算用数字、Scribe v2 は漢数字が中心でした。CER では、算用数字にそろえてから比べています。
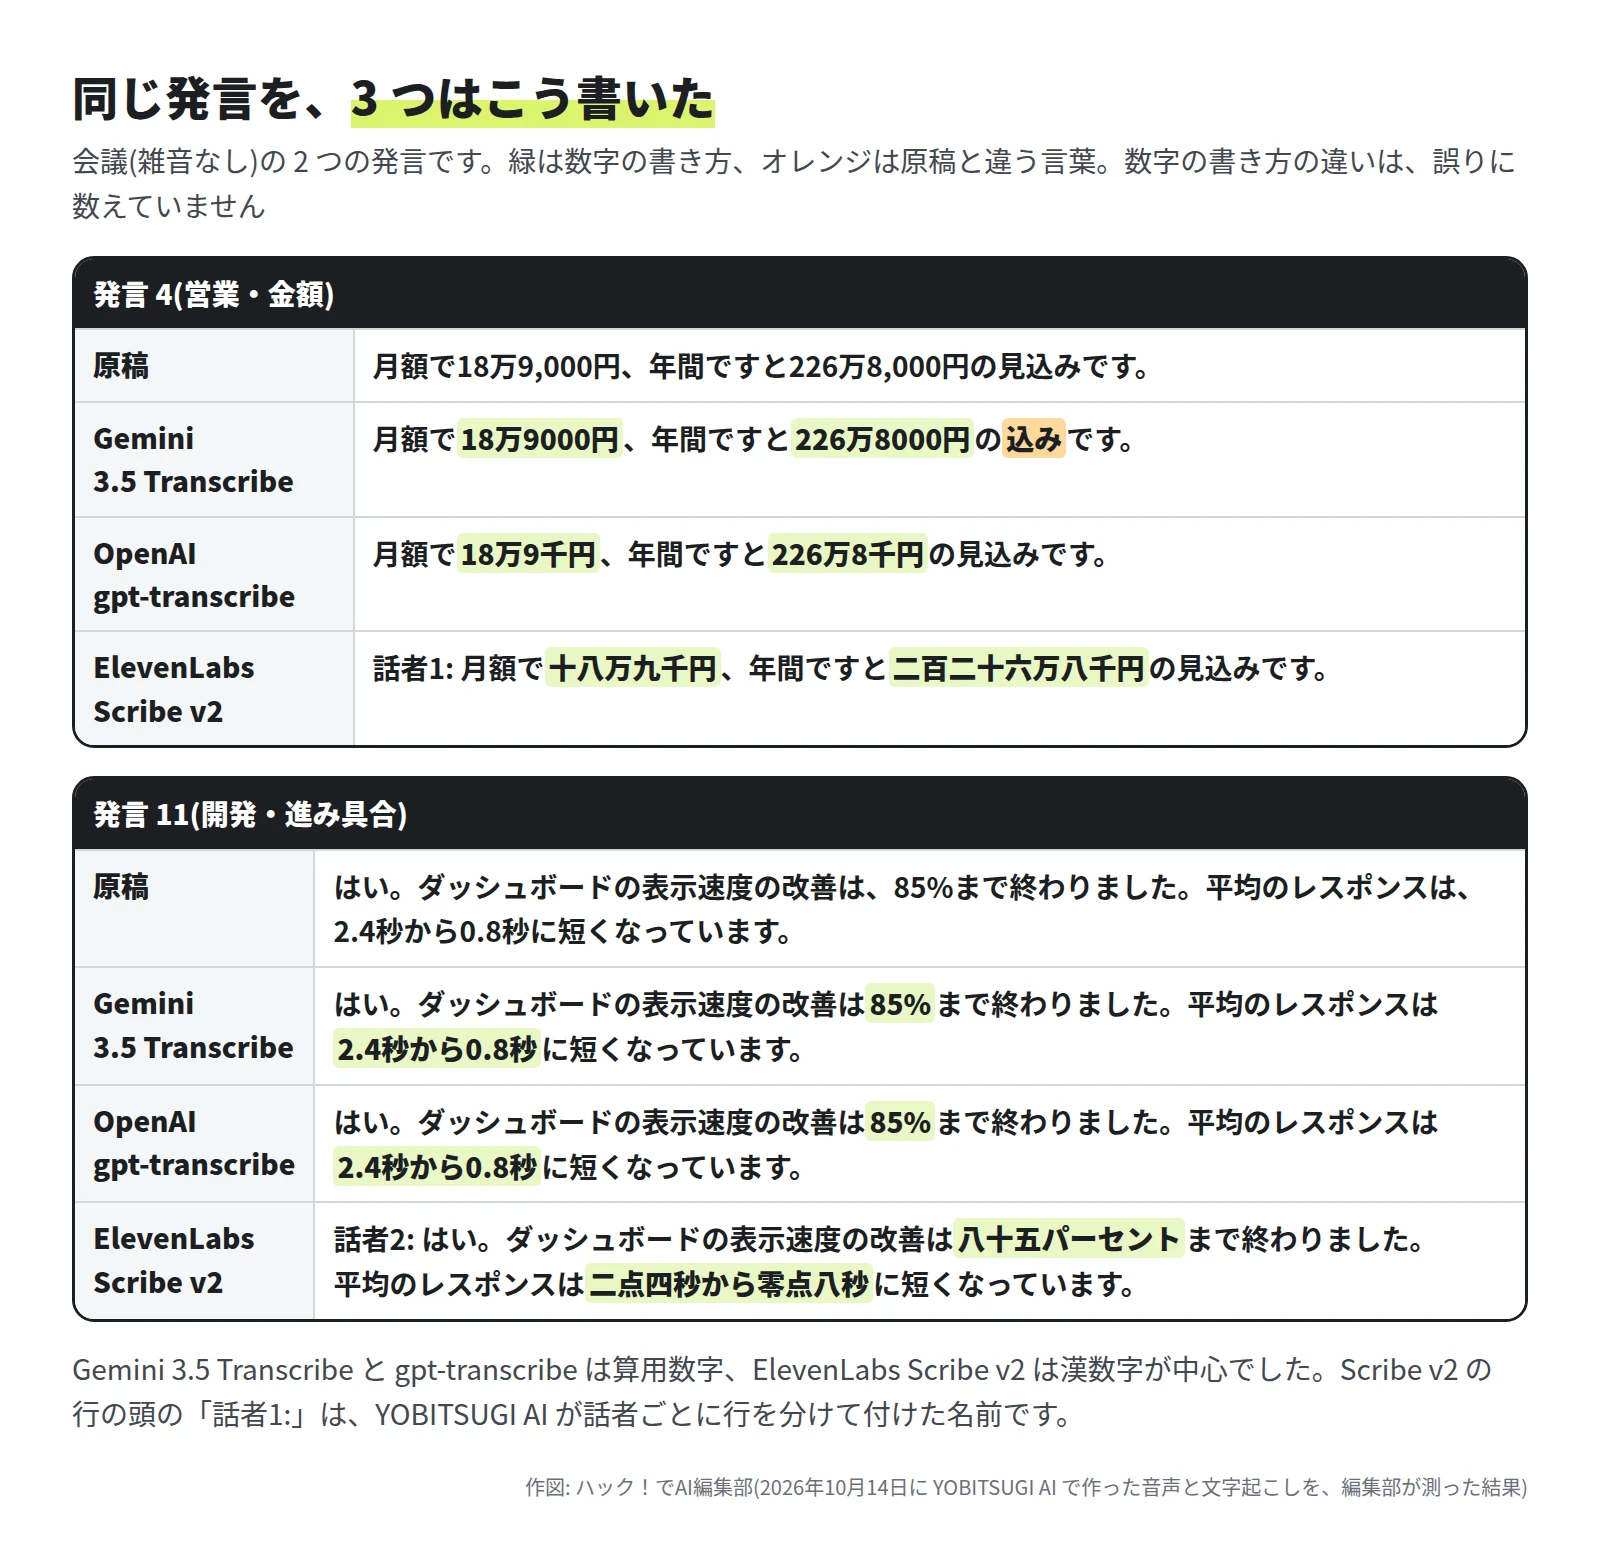
誤りの多くは、架空の名前の中
雑音なしの会議で数えた誤りの字のうち、架空の会社名 2 つと商品名 1 つの中の字は、Gemini 3.5 Transcribe が 19 字のうち 12 字、gpt-transcribe が 21 字のうち 15 字、Scribe v2 が 16 字のうち 11 字でした。残りは次のような違いです。
- 言いよどみの書き方: 「えーと」を Gemini は「ええと」、gpt-transcribe は「えっと」と書きました。「うーん」を Gemini は「ううん」と書いています。言いよどみ 4 か所は、3 つとも消さずに残しました。
- 書き分け: 「お疲れさま」を 3 つとも「お疲れ様」、「分かりました」を gpt-transcribe と Scribe v2 が「わかりました」と書きました。かなにそろえた値では、誤りに数えていません。
- 字の抜け: Gemini は「見込みです」を「込みです」と書きました。
言いよどみの 4 か所を除いて計算し直すと、562 字のうち 16 字・19 字・15 字で、CER は Gemini 2.8%・gpt-transcribe 3.4%・Scribe v2 2.7% です。
会議(雑音なし)を Gemini 3.5 Transcribe が起こした文(全文)
それでは10月14日の定例会議を始めます。今日のアジェンダは3つです。まず柏木さんから営業の報告をお願いします。はい。ええと、先週は商談が12件ありました。そのうち星峰物産さんからつむぎノート42アカウントで契約したいという連絡をいただいています。金額はどのくらいになりますか?月額で18万9000円、年間ですと226万8000円の込みです。導入の時期は決まっていますか?先方の希望は11月4日です。ただオンボーディングの担当が足りないので、あの、宮下さんのチームから1名お借りできないでしょうか?ううん、11月の第1週はバージョン3.2のリリースと重なります。11月10日以降でしたら2名出せます。では柏木さんは先方に開始を11月10日にできないか確認してください。承知しました。金曜日までに回答をもらいます。次に開発の進み具合をお願いします。はい。ダッシュボードの表示速度の改善は85%まで終わりました。平均のレスポンスは2.4秒から0.8秒に短くなっています。残っている課題は何ですか?CSVのインポートで5万行を超えるとタイムアウトする不具合があります。まあ、修正は10月21日までに終える予定です。青羽商事さんからも問い合わせが来ています。進み具合を共有してもらえますか?分かりました。毎週水曜日にチャットで報告します。最後に次回の定例は10月28日の14時30分からです。お疲れ様でした。
会議(雑音なし)を gpt-transcribe が起こした文(全文)
それでは、10月14日の定例会議を始めます。今日のアジェンダは3つです。まず、柏木さんから営業の報告をお願いします。はい。えっと、先週は商談が12件ありました。そのうち、星峰物理さんから紡ぎノード42アカウントで契約したいという連絡をいただいています。金額はどのくらいになりますか?月額で18万9千円、年間ですと226万8千円の見込みです。導入の時期は決まっていますか?先方の希望は11月4日です。ただ、オンボーディングの担当が足りないので、あの、宮下さんのチームから1名お借りできないでしょうか。うーん、11月の第1週はバージョン3.2のリリースと重なります。11月10日以降でしたら2名出せます。では、柏木さんは先方に開始を11月10日にできないか確認してください。承知しました。金曜日までに回答をもらいます。次に、開発の進み具合をお願いします。はい。ダッシュボードの表示速度の改善は85%まで終わりました。平均のレスポンスは2.4秒から0.8秒に短くなっています。残っている課題は何ですか?CSVのインポートで5万行を超えるとタイムアウトする不具合があります。まあ、修正は10月21日までに終える予定です。青葉根翔二さんからも問い合わせが来ています。進み具合を共有してもらえますか?わかりました。毎週水曜日にチャットで報告します。最後に、次回の定例は10月28日の14時30分からです。お疲れ様でした。
会議(雑音なし)を ElevenLabs Scribe v2 が起こした文(全文)
話者0: それでは十月十四日の定例会議を始めます。今日のアジェンダは三つです。まず、柏木さんから営業の報告をお願いします。
話者1: はい。えーと、先週は商談が十二件ありました。そのうち星峰物流さんからつむぎノート四十二アカウントで契約したいという連絡をいただいています。
話者0: 金額はどのくらいになりますか?
話者1: 月額で十八万九千円、年間ですと二百二十六万八千円の見込みです。
話者0: 導入の時期は決まっていますか?
話者1: 先方の希望は十一月四日です。ただ、オンボーディングの担当が足りないので、あの、宮下さんのチームから一名お借りできないでしょうか。
話者2: うーん、十一月の第一週はバージョン三点二のリリースと重なります。十一月十日以降でしたら二名出せます。
話者0: では、柏木さんは先方に開始を十一月十日にできないか確認してください。
話者1: 承知しました。金曜日までに回答をもらいます。
話者0: 次に、開発の進み具合をお願いします。
話者2: はい。ダッシュボードの表示速度の改善は八十五パーセントまで終わりました。平均のレスポンスは二点四秒から零点八秒に短くなっています。
話者0: 残っている課題は何ですか?
話者2: CSVのインポートで五万行を超えるとタイムアウトする不具合があります。まあ、修正は十月二十一日までに終える予定です。
話者1: 青羽商事さんからも問い合わせが来ています。進み具合を共有してもらえますか?
話者2: わかりました。毎週水曜日にチャットで報告します。
話者0: 最後に、次回の定例は十月二十八日の十四時三十分からです。お疲れ様でした。
架空の会社名と商品名
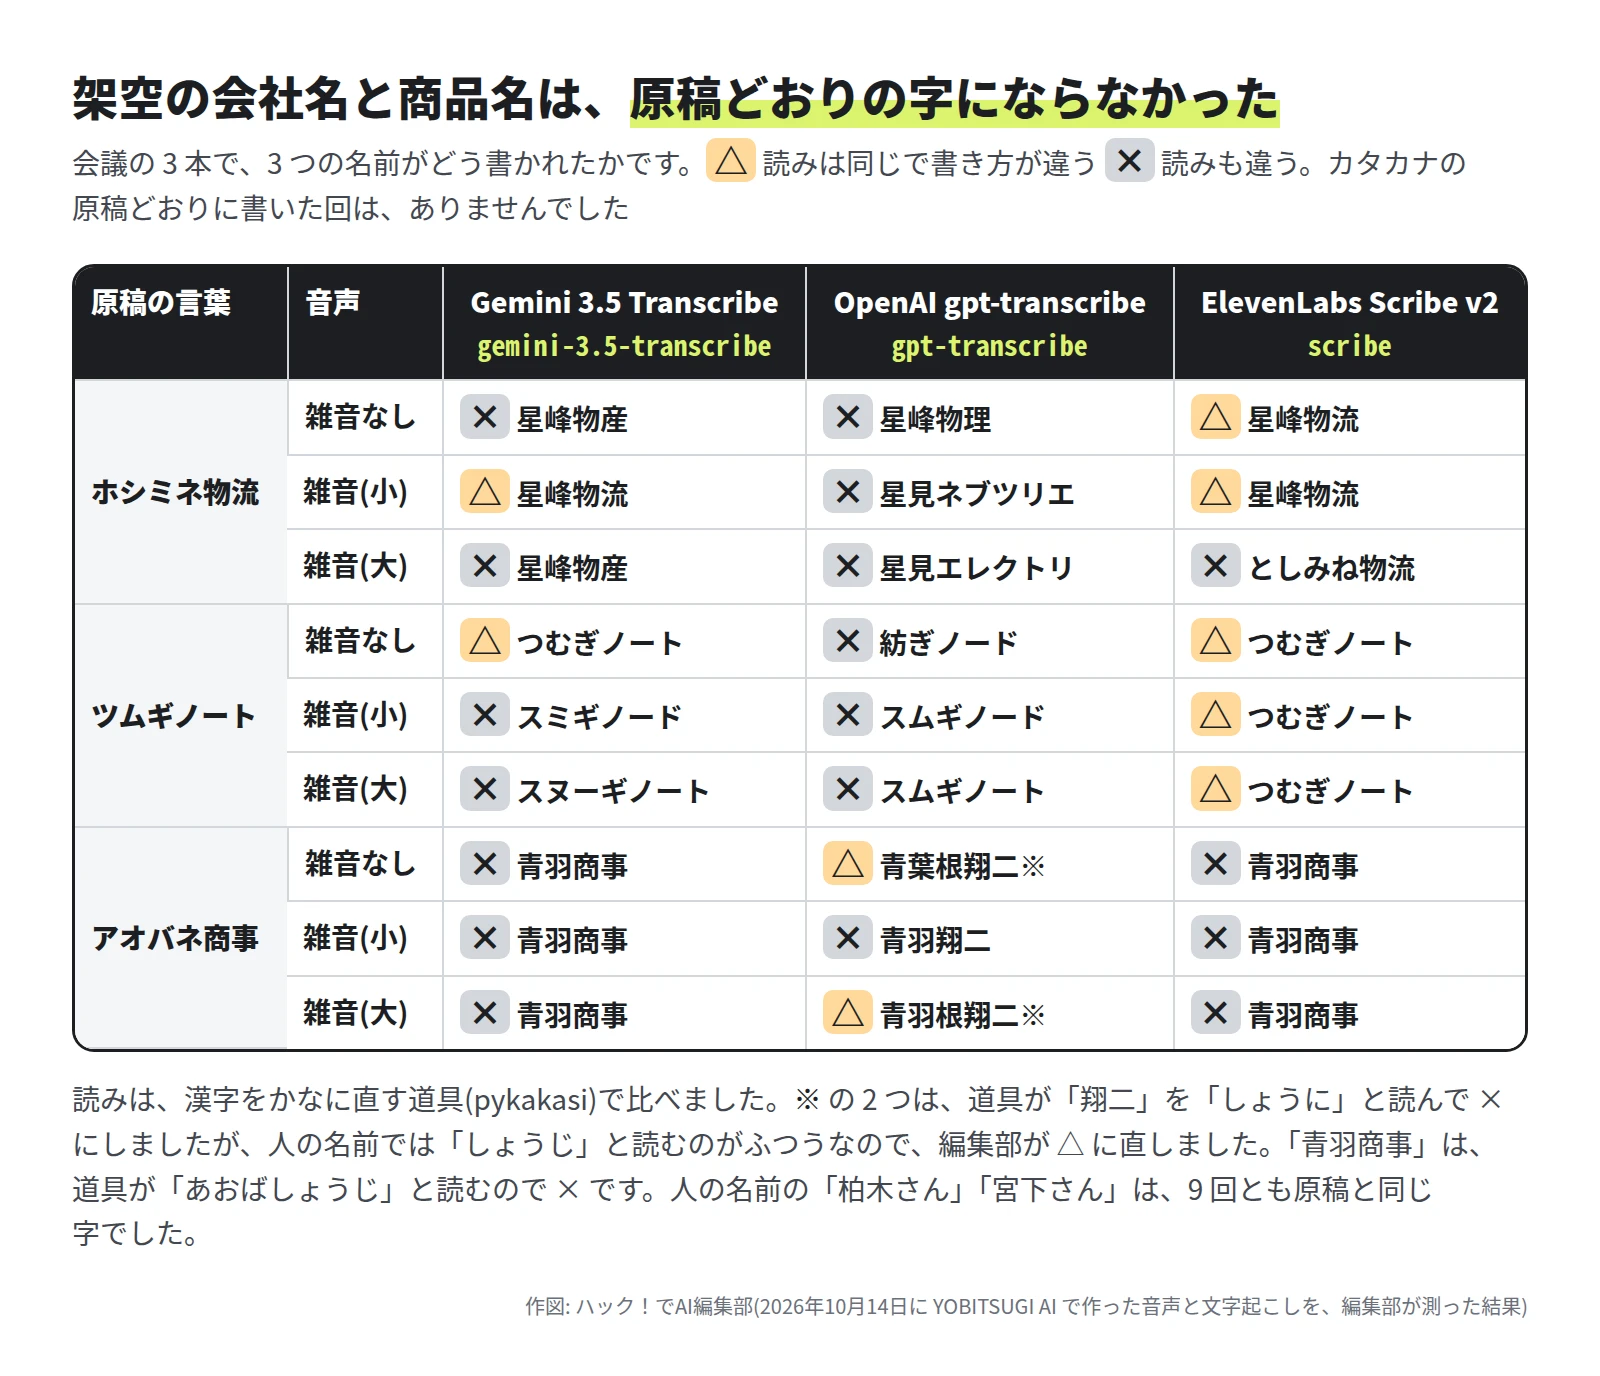
- 3 つの AI は、聞いた音に漢字やひらがなを当てて書きました(「星峰物流」「つむぎノート」など)。読みが合っていれば △ にしています。
- 9 か所(名前 3 つ × 会議 3 本)のうち △ だったのは、Scribe v2 が 5 か所、Gemini 3.5 Transcribe と gpt-transcribe が 2 か所ずつです。残りは、読みも違いました。
- 「アオバネ商事」は、Gemini と Scribe v2 が 3 本ずつ「青羽商事」と書きました。かなに直す道具は「あおばしょうじ」と読み、名前の読みとしてもふつうなので × にしています(「あおばね」と読ませる当て字の可能性はあります)。
- gpt-transcribe は「青葉根翔二」のように、会社名を人の名前の字で書きました。道具は「翔二」を「しょうに」と読みましたが、人の名前では「しょうじ」と読むのがふつうなので、結果を見たあとで、編集部が 2 か所を × から △ に直しました(図の ※)。直さなければ、gpt-transcribe の △ は 9 か所のうち 0 か所で、「落としやすい所」の図の「アオバネ商事」も × です。
かなに直す道具の読み違い(18 本を見直した結果)
- 道具の読み違いは、ほかに gpt-transcribe の「星見」(ほしけん と読んだ)がありました。「ほしみ」と読んでも原稿と違うので、× のままです。Gemini と Scribe v2 の文には、道具の読み違いで誤りに数えた所はありませんでした。
- かなにそろえた CER は、どれも直していません。gpt-transcribe の会議の 3 本の値には、この 2 つの読み違いが 1〜3 字ずつ入っています(読みを直すと 0.9%・1.1%・1.8%)。
早口の結果
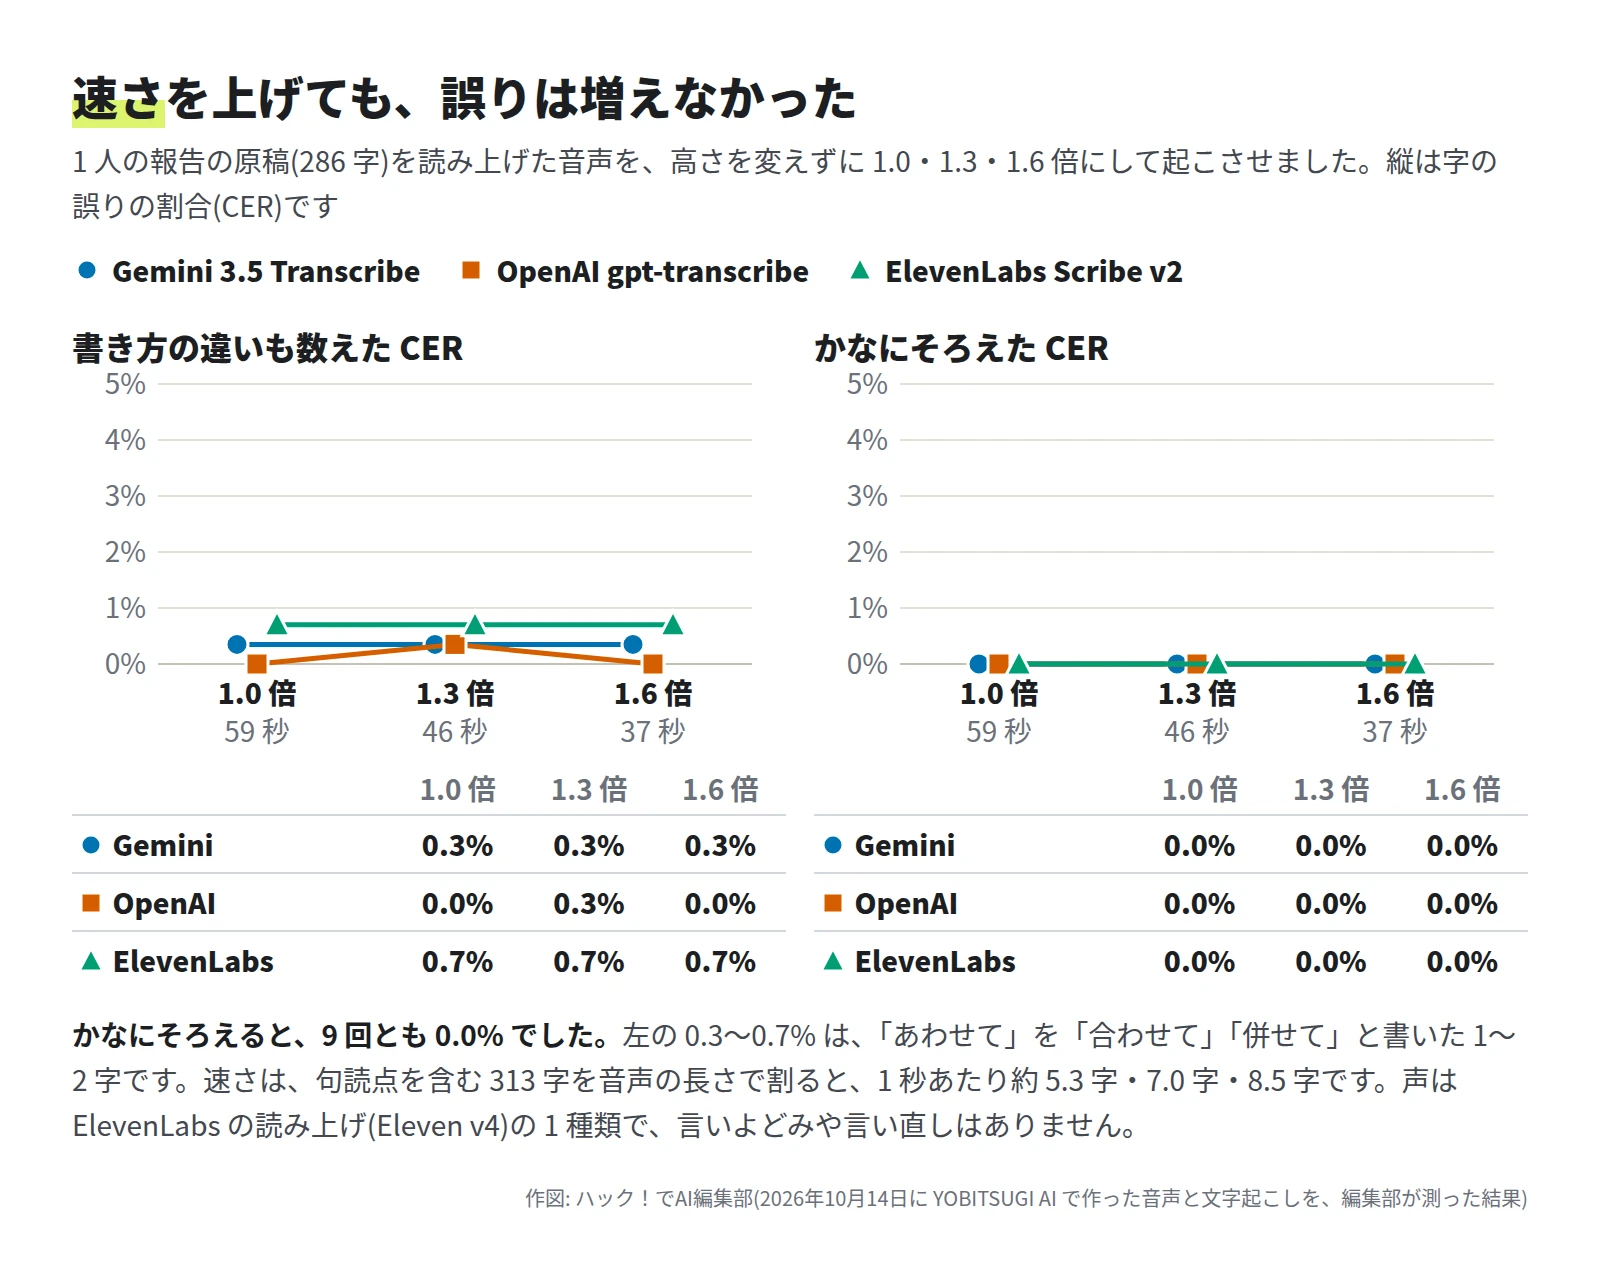
- 1.6 倍(1 秒あたり約 8.5 字)にしても、誤りは増えませんでした。数字 8 か所とカタカナの用語 4 か所は、9 回とも原稿どおりです。
- 書き方の違いも数えた値で残った 1〜2 字は、原稿の「あわせて」を、Gemini が「合わせて」、Scribe v2 が「併せて」と書いた所です。gpt-transcribe は、1.3 倍の 1 回だけ「合わせて」と書きました。
- 速めたのは機械で、人が早口で話した音声ではありません。
早口の 9 回の要点
- 9 回とも、原稿の文を 1 文も落とさず、足した文もありませんでした。
- 数字は、Gemini 3.5 Transcribe と gpt-transcribe が算用数字(gpt-transcribe は「1,356件」とけた区切りを入れた)、Scribe v2 が「千三百五十六件」「七点五パーセント」のような漢数字でした。
- 1.6 倍の音声を Gemini 3.5 Transcribe が起こした文の全文です。
続いて、サポート窓口の9月の状況を報告します。問い合わせの件数は合計で1356件で、8月より7.5%増えました。内訳は、メールが820件、チャットが412件、電話が124件です。最初の返信までの時間は平均で3時間20分でした。目標の4時間以内を達成しています。ただ、解決までにかかった日数は平均2.6日で、目標の2日に届いていません。原因は、請求書の再発行とパスワードの再設定の問い合わせが月末に集中したことです。対策として、10月20日からよくある質問のページにテンプレートを追加します。また、新しく入った2名のトレーニングを11月中旬までに終える予定です。来月は満足度のアンケートの結果も合わせて報告します。
雑音ありの結果
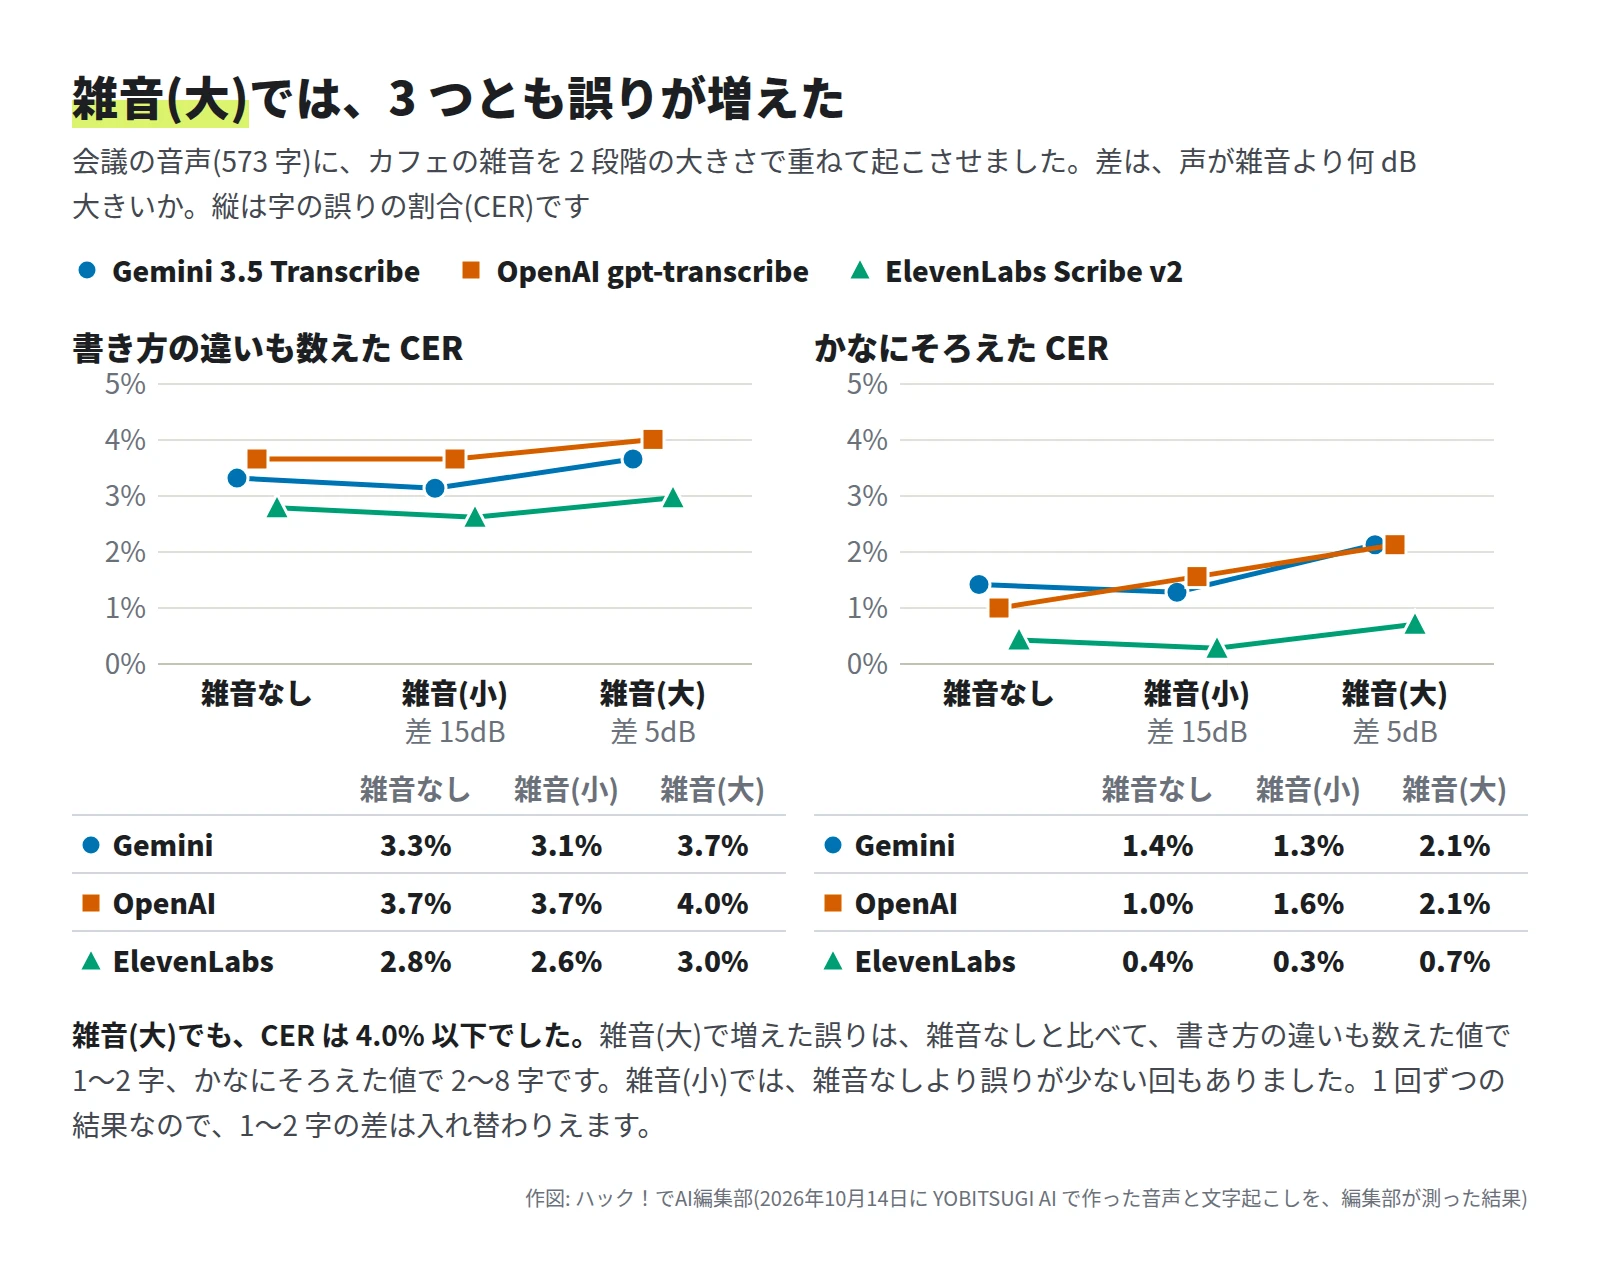
- 雑音(小)(声が 15dB 大きい)では、誤りの数は雑音なしとほぼ同じでした。増えた回と減った回があります。
- 雑音(大)(声が 5dB 大きい)では、3 つとも誤りが増えました。雑音なしと比べて、書き方の違いも数えた値で 1〜2 字(19→21 字・21→23 字・16→17 字)、かなにそろえた値で 2〜8 字です。CER は 3.0〜4.0% でした。
- 名前のほかで増えたのは、「さんからも」の「も」が 3 つとも抜けた所などです(下の「間違いの実例」)。
雑音ありの 6 回の要点(雑音なしと比べて変わった所)
- Gemini 3.5 Transcribe・雑音(小): 「ホシミネ物流」が「星峰物流」に(読みは合った)、「ツムギノート」が「スミギノード」に。
- Gemini 3.5 Transcribe・雑音(大): 「スヌーギノート」「回答をもらえます」「青羽商事さんから」(「も」が抜けた)。
- gpt-transcribe・雑音(小): 「星見ネブツリエ」「スムギノード」「青羽翔二さん」。
- gpt-transcribe・雑音(大): 「星見エレクトリ」「スムギノート」。言いよどみの「あのー」が消えた。「青羽根翔二さんから」(「も」が抜けた)。
- Scribe v2・雑音(小): 名前の書き方は雑音なしと同じ。雑音なしでは書かなかった「つむぎノートを」の「を」を書いた。
- Scribe v2・雑音(大): 「商談が十二件入りました」「としみね物流」「青羽商事さんから」(「も」が抜けた)。発言 14 を 4 人目の話者とした。
間違いの実例
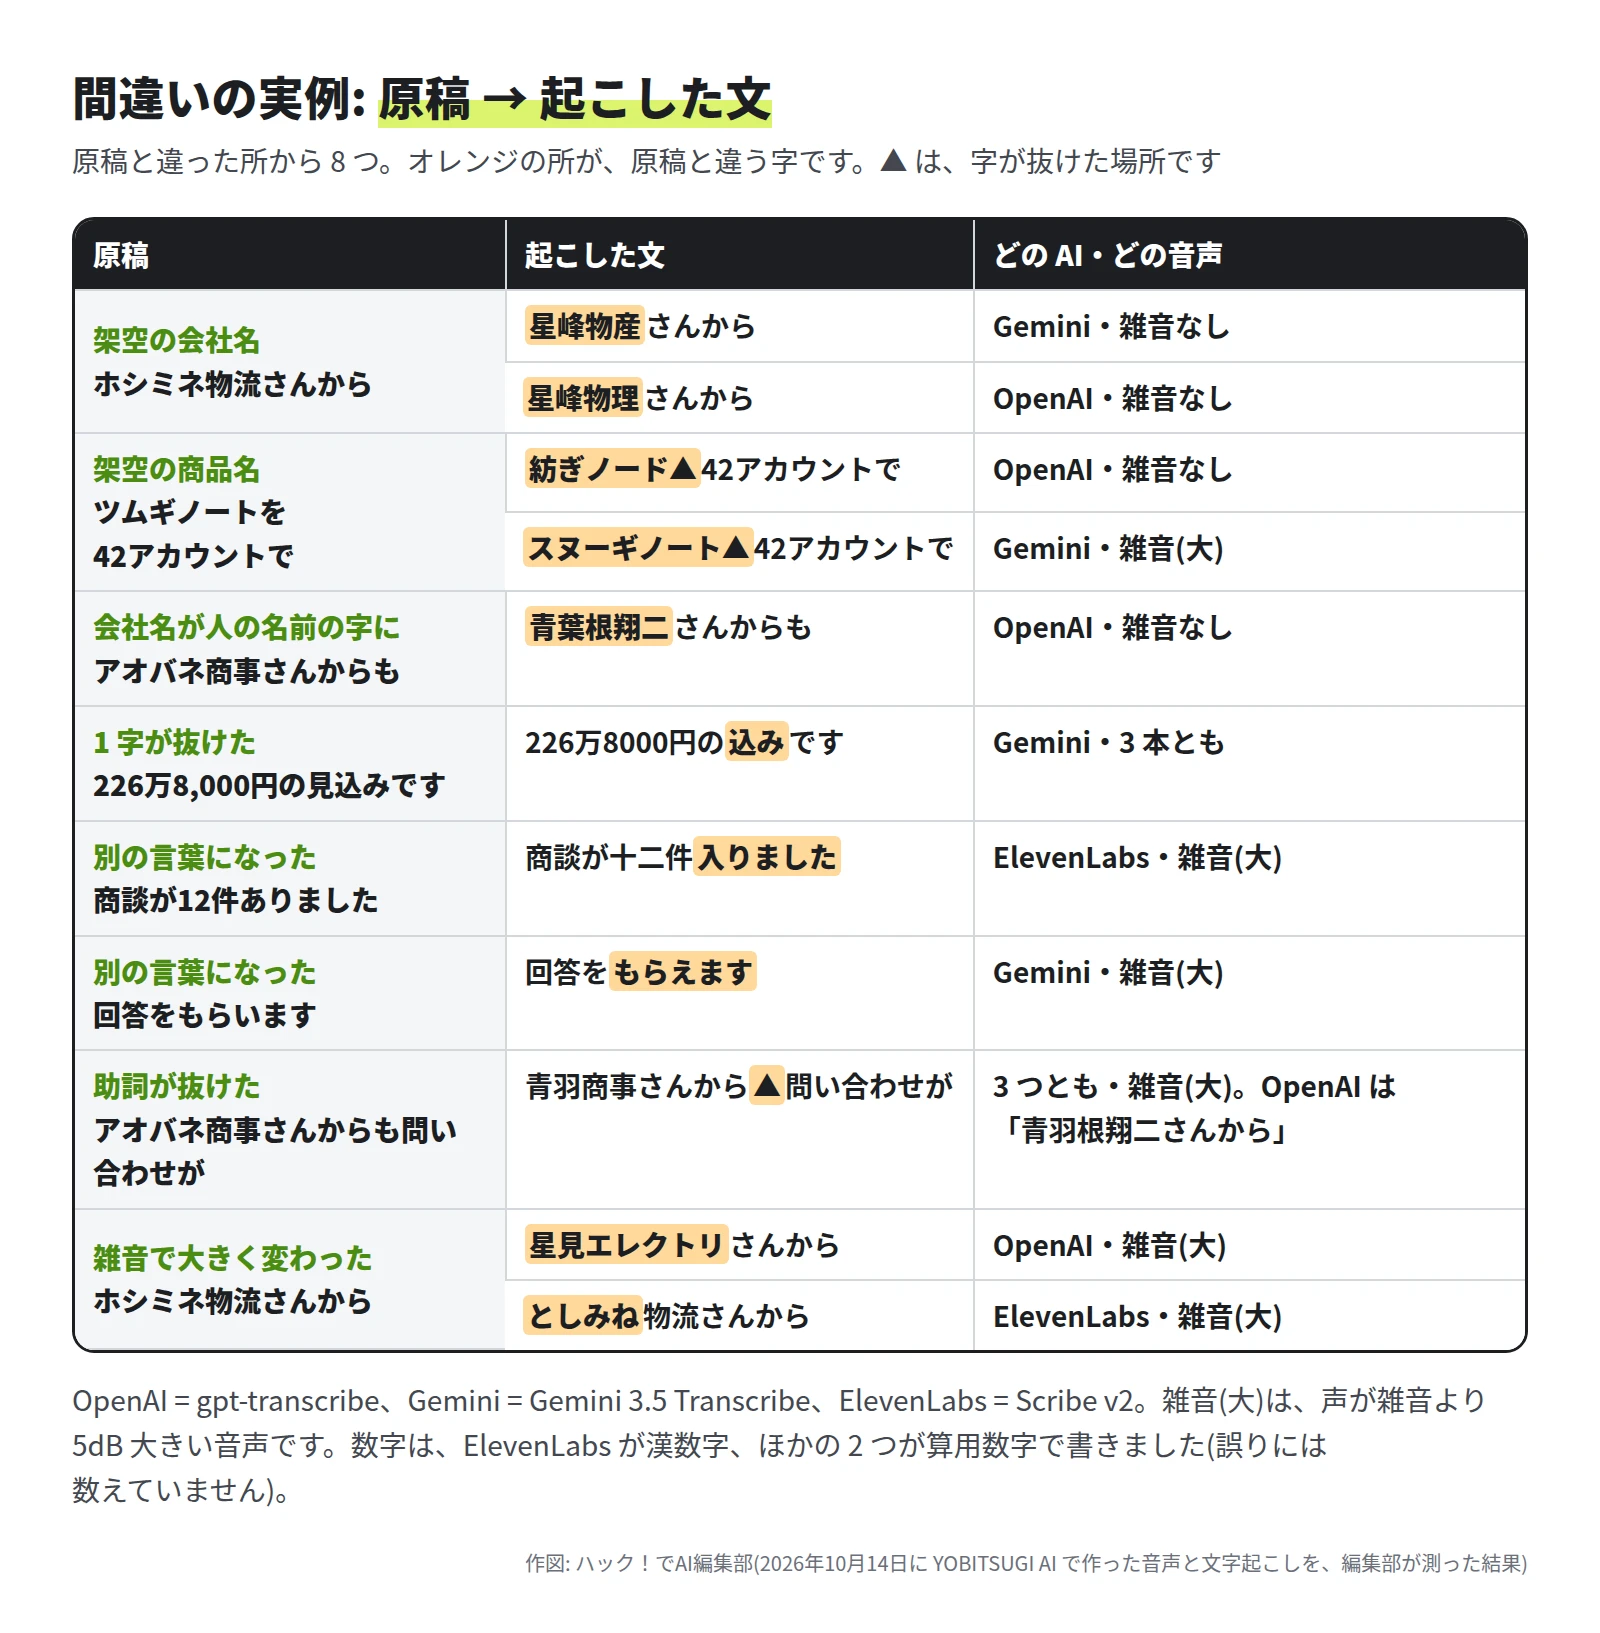
- 「見込み」が「込み」になった所と、「もらいます」が「もらえます」になった所は、1 字の違いで意味が変わります。「入りました」も、商談の件数の話では意味が通ってしまいます。
話者の分け方
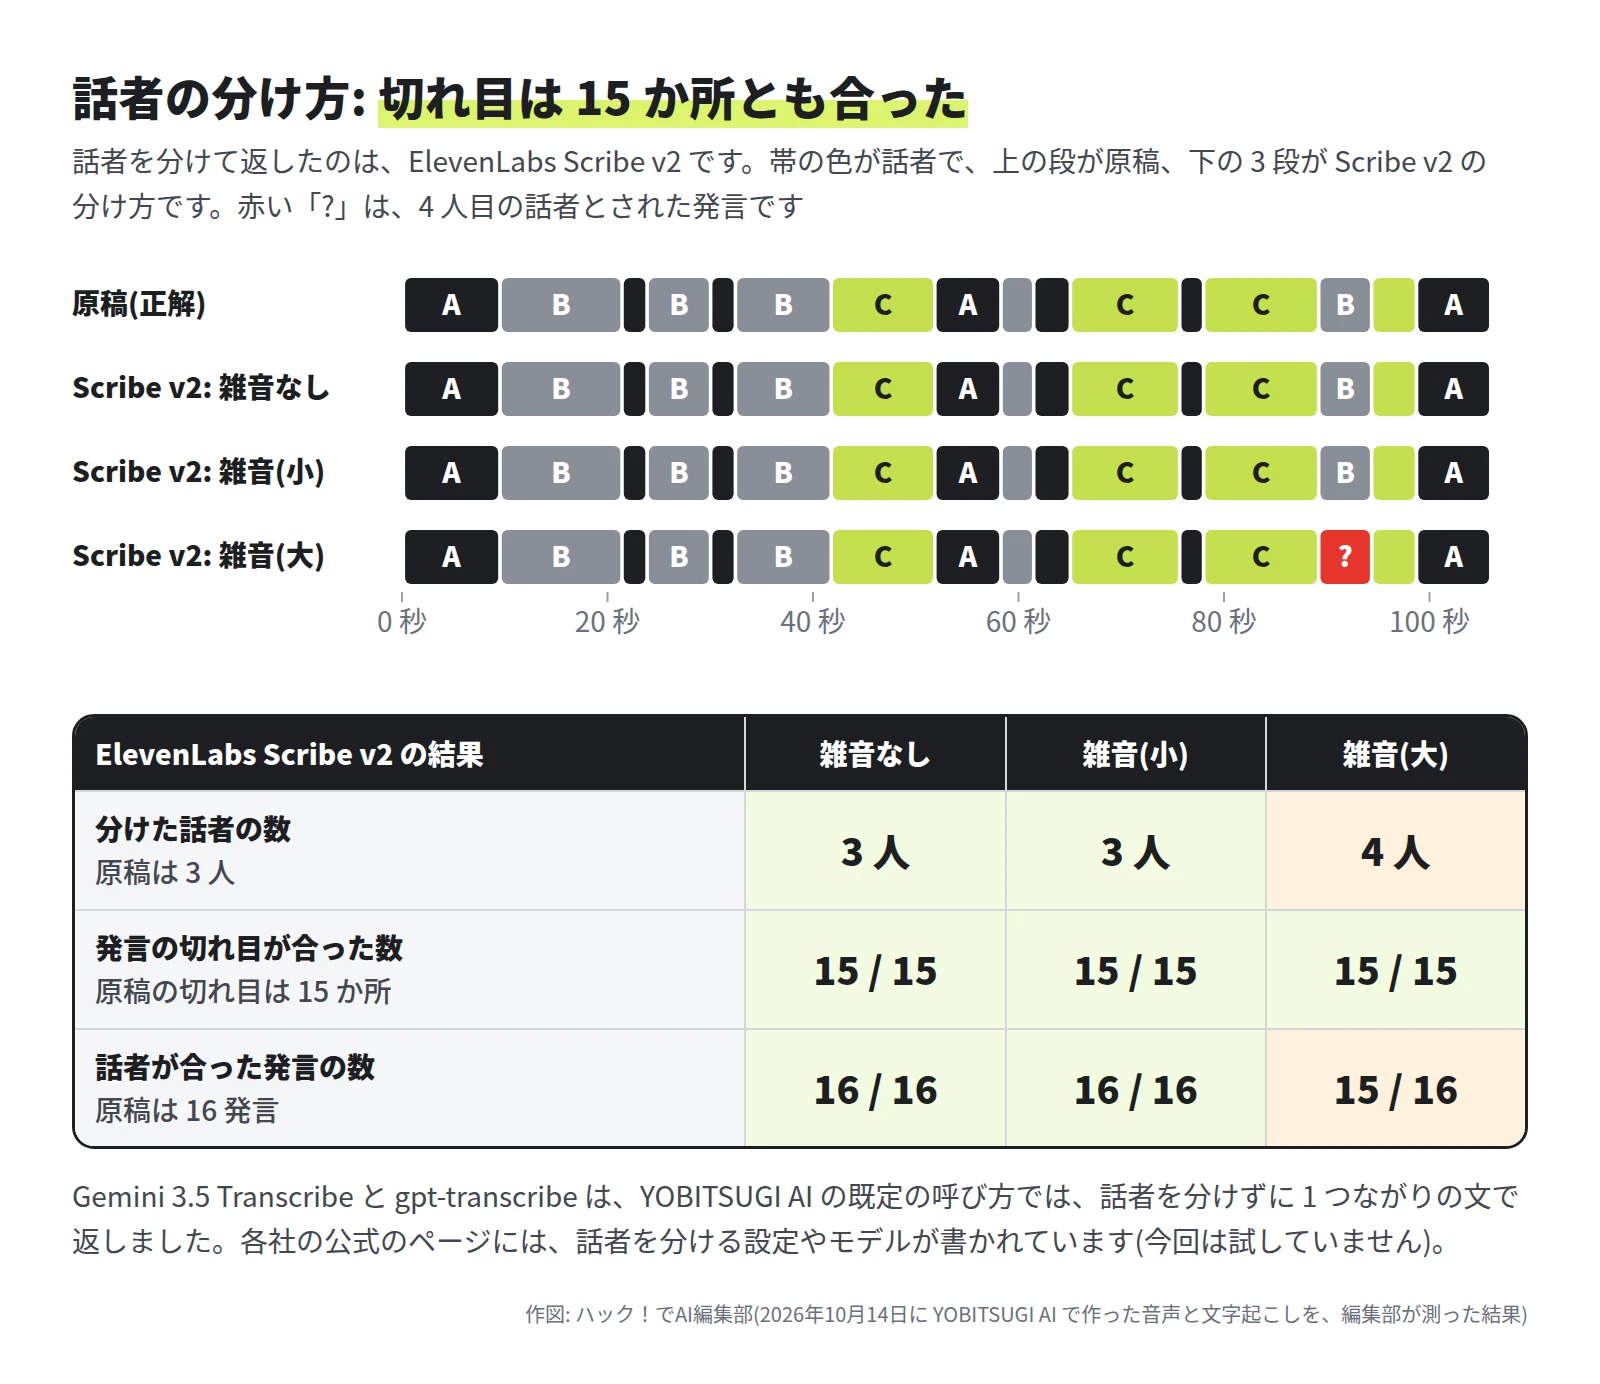
- 話者を分けて返したのは、Scribe v2 だけです。Gemini 3.5 Transcribe と gpt-transcribe は、今回の呼び方では、改行のない 1 つながりの文で返しました。
- Scribe v2 は、雑音なしと雑音(小)では 16 発言の話者がすべて合い、雑音(大)では営業の人の発言 1 回を 4 人目の話者としました。
- 今回の音声は発言の間に無音があり、話者ごとに別の会社の声です。話が重なる会議や、似た声の人がいる会議は試していません。Gemini と OpenAI の話者を分ける設定とモデル(下の「気をつけること」)も試していません。
読み上げの側の読み違いの疑い
読み上げの AI が読み違えていれば、正しく起こしても誤りに数えられます。雑音なしの 2 本で 3 つがそろって同じように違えた所は、「あのー」を「あの」と書いた 1 か所でした。また、雑音なしの会議では 3 つとも「ツムギノートを」の「を」を書きませんでした(雑音ありの 2 本では、Scribe v2 は書いています)。どちらも読み上げの側が原因かは分かりません。3 つとも 1 字ずつなので、除いても字数の差は変わりません。
かかった時間と料金
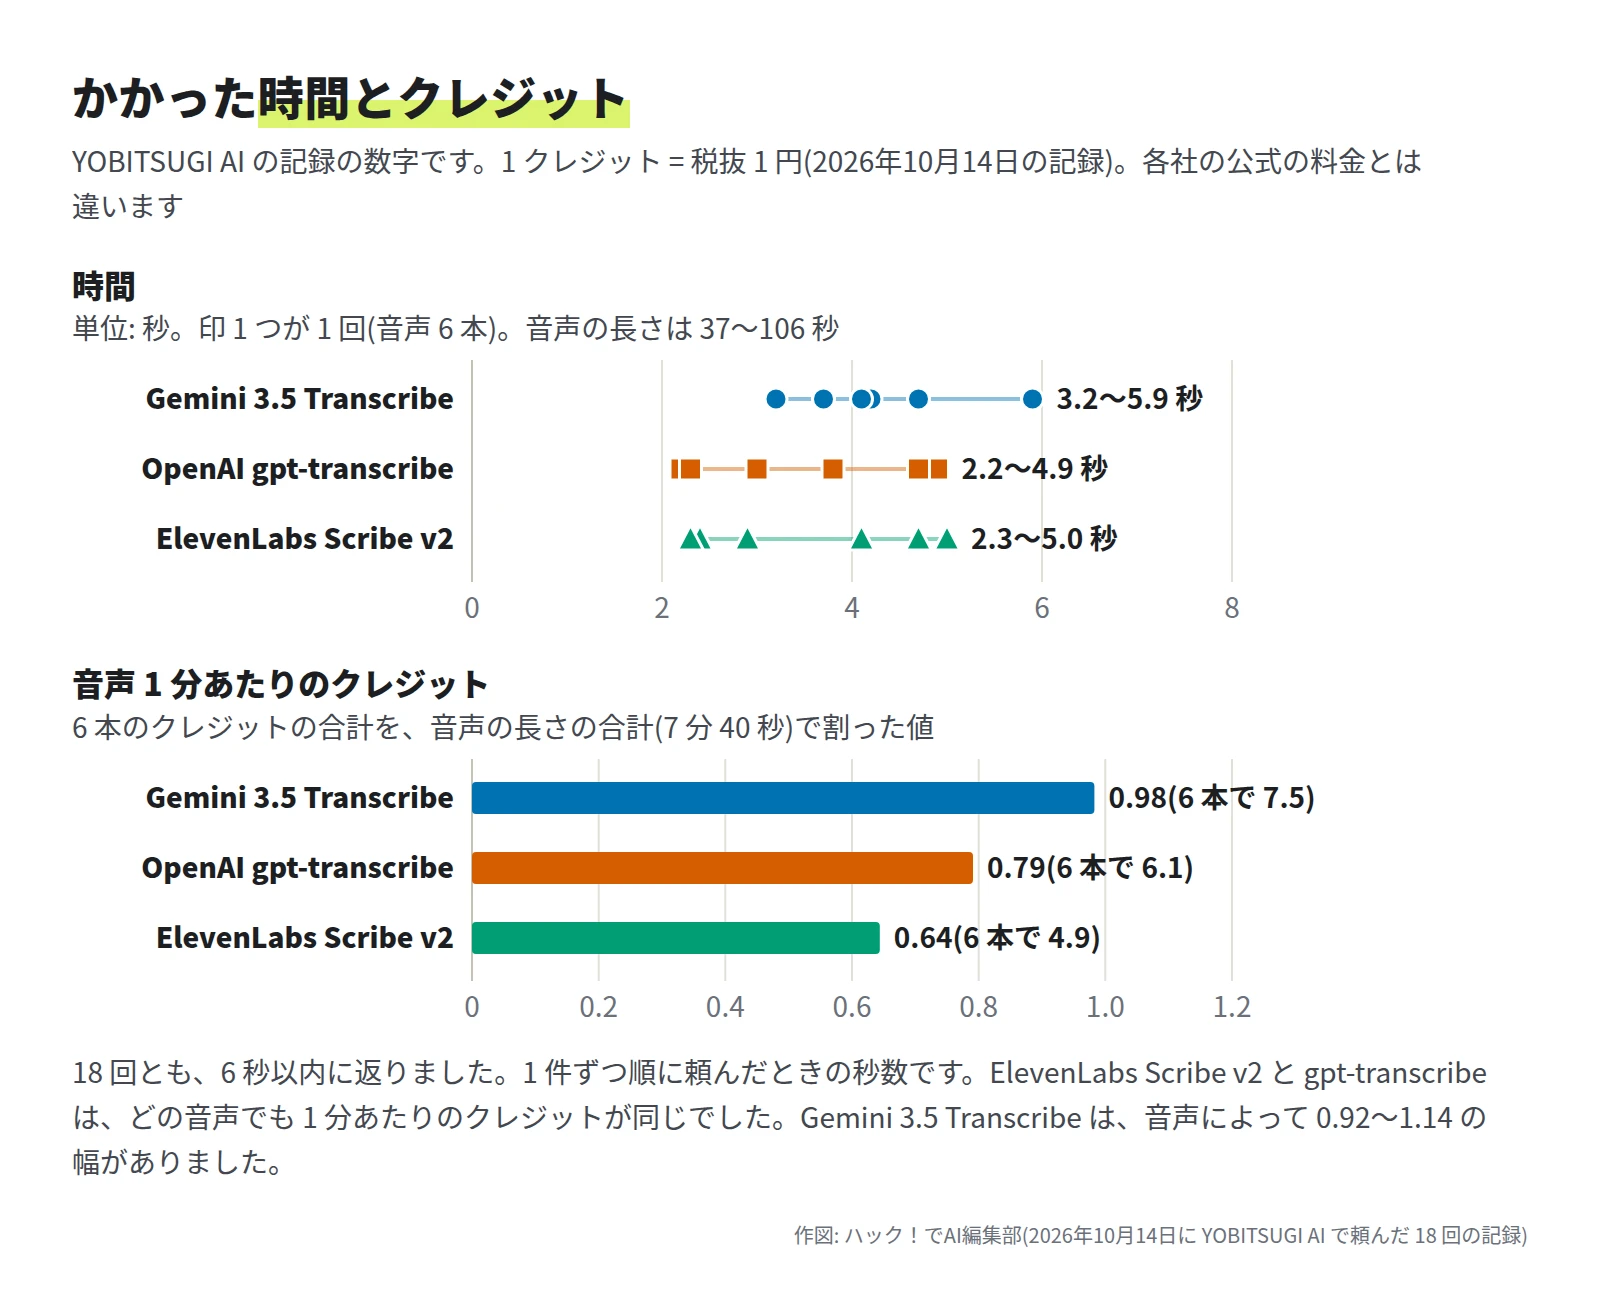
| モデル | 時間(6 回の幅) | 会議 1 本(106 秒) | 音声 1 分あたり | 6 本の合計 |
|---|---|---|---|---|
| Gemini 3.5 Transcribe | 3.2〜5.9 秒 | 1.7 | 0.98 | 7.5 |
| gpt-transcribe | 2.2〜4.9 秒 | 1.4 | 0.79 | 6.1 |
| ElevenLabs Scribe v2 | 2.3〜5.0 秒 | 1.1 | 0.64 | 4.9 |
- 時間の列のほかは、クレジットです。1 分あたりの値は、6 本の合計を音声の長さの合計(7 分 40 秒)で割りました。
- 時間は、頼んでから文が返るまでの秒数です。
- Gemini 3.5 Transcribe だけは、1 分あたりのクレジットに、音声によって 0.92〜1.14 の幅がありました。
- 文字起こし 18 回の合計は 18.6 クレジットでした。このほかに、音声を作るのに 21.8 クレジット(読み上げ 17 本で 11.2、雑音で 10.6)を使っています。
使い分けの目安
今回の 6 本の音声の範囲で言えることです。
- 数字・日付・金額: 算用数字で読みたいときは Gemini 3.5 Transcribe か gpt-transcribe、漢数字の多い文でよければ Scribe v2 です(書き方の指示は試していません)。
- だれが話したかを残したい: 今回の呼び方で話者を分けたのは、Scribe v2 だけでした。
- 社名・商品名の多い会議: どれも原稿どおりにならず、あとで置き換える手間がかかります。読みが合っていた回は、9 か所のうち Scribe v2 が 5 か所、ほかの 2 つが 2 か所ずつでした。
気をつけること
長さ・大きさ・話者の分け方(公式のページ)
2026年10月14日に、各社の公式のページで確かめました。
| Gemini 3.5 Transcribe | gpt-transcribe | ElevenLabs Scribe v2 | |
|---|---|---|---|
| 1 回に渡せる長さ | 1 時間まで。話者を分ける・単語ごとの時刻を付けるときは 30 分まで | 確かめたページには書かれていない | 10 時間まで(標準のモード) |
| ファイルの大きさ | 文字起こしのページには書かれていない。数秒より長い録音は Files API で渡すよう案内している | 25MB まで。mp3・mp4・mpeg・mpga・m4a・wav・webm | 3GB まで |
| 話者を分ける | 設定(diarization_mode)で分ける。8 人まで(3 人以上は試験的な扱い) | 別のモデル gpt-4o-transcribe-diarize を使う | 分けられる。32 人まで |
- OpenAI は、25MB を超える録音は圧縮するか、文の途中で切らずに 25MB 以下に分けるよう案内しています。gpt-4o-transcribe-diarize は、2027年2月26日に API から外れる予定です(「Deprecations」のページ)。
- ElevenLabs は、日本語を誤りの割合 5% 以下の言語に入れています。ただし単語の単位(WER)の値で、今回の字の単位の値とは数え方が違います。
送った音声の扱い
- Gemini API: 無料の枠で送った内容は製品の改善に使われ、人が読むことがあります。規約は、機密や個人の情報を無料の枠に送らないよう求めています。有料の枠では改善に使わず、違反を見つけるために限られた期間だけ記録します。
- OpenAI: API に送ったデータは、自分で共有を選ばない限り学習に使われません。文字起こしの窓口の、監視のための保存は「None」です。
- ElevenLabs: 既定では履歴が残ります。すぐに消す Zero Retention Mode は、Enterprise の契約で API から使うときだけです。
別のサービスを通すときは、そのサービスの規約も確かめてください。
録音に入っている人の情報
- 個人情報保護委員会のガイドライン(通則編)は、個人情報に当たる例として「本人の氏名が含まれる等の理由により、特定の個人を識別できる音声録音情報」を挙げています。
- 同じ委員会の「生成AIサービスの利用に関する注意喚起等」(2023年6月2日)は、事業者が生成 AI のサービスに個人情報を含むプロンプトを入力するときは、利用目的の達成に必要な範囲内かを十分に確認するよう求めています。あらかじめ本人の同意を得ずに個人データを含むプロンプトを入力する場合は、サービスの事業者がそのデータを機械学習に使わないこと等を十分に確認するよう求めています。
- 会議の録音に参加者の同意が要るかは、社内の決まりや法務の担当に確かめてください。
まとめ
- 合成の会議の音声 3 本では、字の誤りの割合は 2.6〜4.0% で、数字・日付・金額は 3 つとも全部合っていました。
- 誤りの多くは架空の会社名と商品名でした。1.6 倍に速めた音声では増えず、大きな雑音で 1〜2 字増えました。話者を分けて返したのは Scribe v2 だけでした。
- 議事録に使うときは、名前と、意味の変わる 1 字の違いを、録音と照らして直してから使ってください。
参考にした公式の情報
- Google AI for Developers「Audio transcription」(Gemini API)
- Google AI for Developers「Gemini 3.5 Transcribe」
- Google AI for Developers「Gemini API Additional Terms of Service」
- OpenAI API ドキュメント「File transcription」
- OpenAI API ドキュメント「Deprecations」
- OpenAI API ドキュメント「Data controls in the OpenAI platform」
- ElevenLabs ドキュメント「Transcription」
- ElevenLabs ドキュメント「Zero Retention Mode (Enterprise)」
- 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」
- 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
同じお題で AI を比べる全 14 回の目次
- 1日本語の文字が崩れない画像生成 AI はどれ? 同じ看板を 5 つのモデルに描かせて比べた
- 3日本語の読み上げが自然な AI はどれ? 同じ原稿を 4 つの声で聞き比べ
- 4生成 AI の使い分け 2026 年版 同じお題で 13 回比べて分かった得意分野
- 5Claude・GPT・Gemini・Grok に同じ仕事を頼んで比べた 要約・メール・企画書の 3 本勝負
- 6GPT-Image-2.5 と Nano Banana Pro、どっちがいい? 同じ 10 のお題で描き比べた
- 7画像生成 AI を実写とアニメで比較 同じプロンプトで 6 モデルの得意と苦手を見る
- 8商品画像は AI のどれで作る? 同じ商品写真から 5 モデルで作って比べた
- 9サムネイルとバナーを AI 5 つに作らせた 文字入りはどこまで使える?
- 10動画生成 AI 5 つを同じプロンプトで比較 動き・破綻・1 本あたりの料金
- 11アニメ調の動画に強い AI はどれ? 同じ 1 枚絵を 5 モデルで動かした
- 12日本語に強い AI はどれ? 敬語・要約・言い換えを 6 モデルで比べた
- 13高いモデルと安いモデル、差が出るのはどんな仕事? 同じ 10 問を料金つきで比べた
- 14文字起こしの精度を AI 3 つで比較 会議・早口・雑音ありの合成音声で試した(この記事)
- 15Tripo と Meshy を比較 同じ 1 枚の写真から 3D モデルを作って回して見た