同じお題で AI を比べる 第4回
生成 AI の使い分け 2026 年版 同じお題で 13 回比べて分かった得意分野
 佐々木 航
この記事でわかること
- やりたいこと 12 種類ごとに、13 回の比べ方で分かったこと
- 文章・画像・動画・音声・3D で使ったクレジットの幅(単位は分野ごと)
- 既定のままでもそろわなかった条件と、自分で比べる手順
確認した環境: 連載 13 本の記録(YOBITSUGI AI で各モデルを実行)/ 2026年10月14日に確認
「生成 AI がたくさんあって、どれを何に使えばよいか分からない」。連載「同じお題で AI を比べる」では、同じお題を複数のモデルにそのまま渡し、できた物を数えて比べてきました。13 回を通すと、得意がはっきり分かれた分野は少なく、仕事の文章・日本語の文章・読み上げ・文字起こしは、数えた点や誤りの差が小さく、どれがよいとは決められませんでした。はっきり違ったのは、料金と、日本語の字を描けたか(Gen-4 Image)、答える前に考える段(問題を段階を追って考える仕組み)のない版が動いたか(Grok の下の設定)でした。画像と動画では、数・位置・余白の指示と、頼んでいない物で外れが多く出ました。
先に結論: やりたいことごとの早見
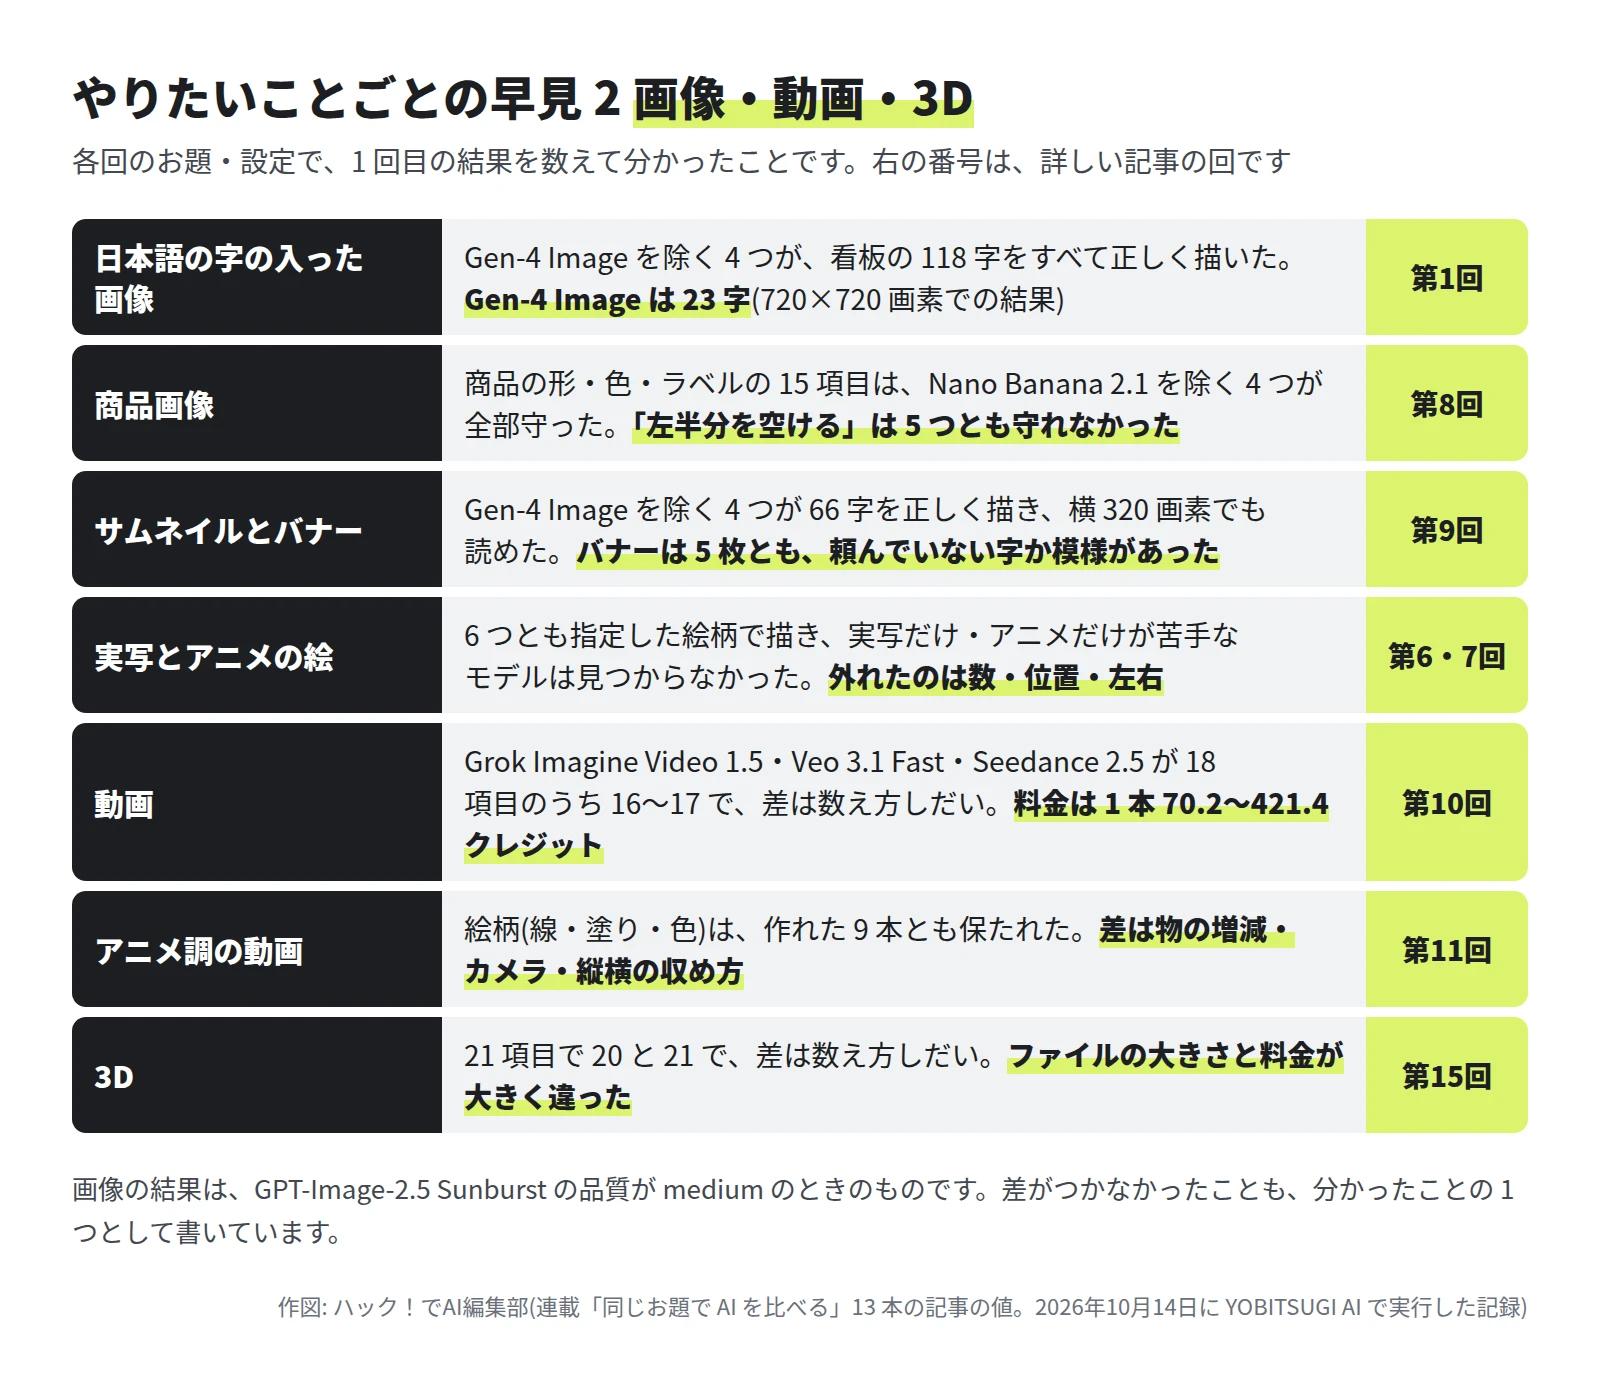
各回のお題・設定で、1 回目の結果を数えて分かったことです。
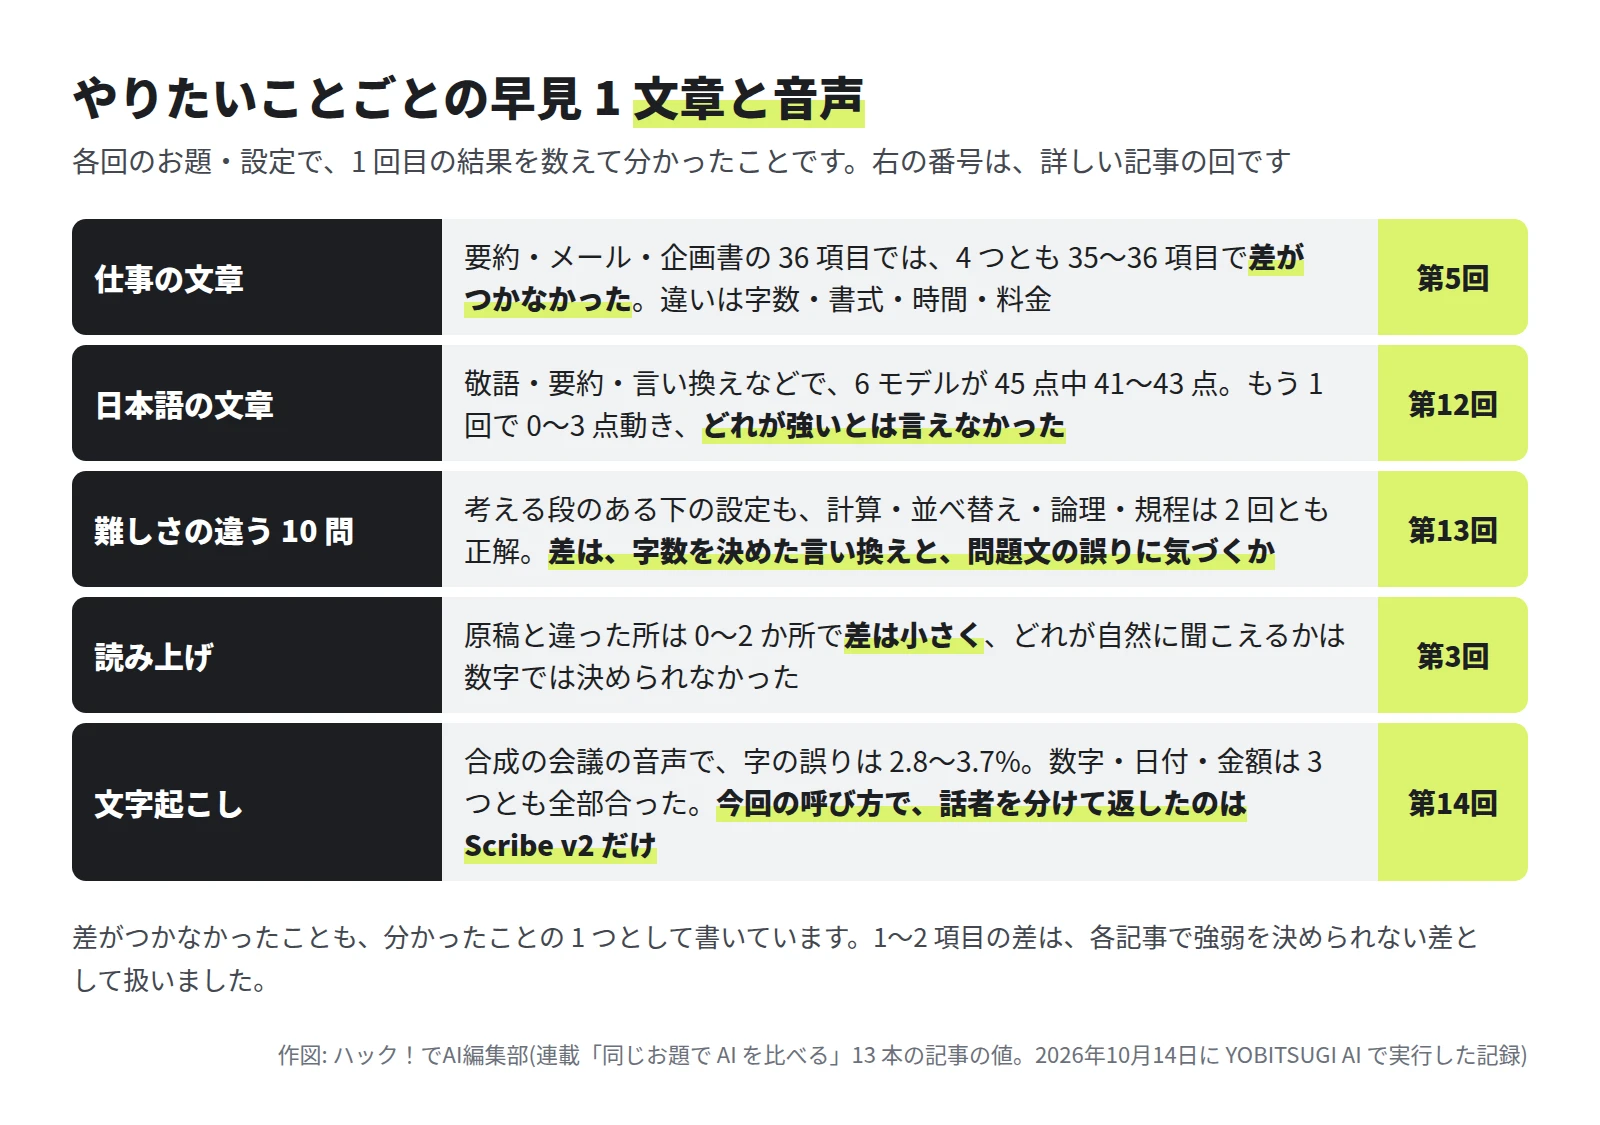
- 仕事の文章: 要約・メール・企画書の 36 項目では、4 つとも 35〜36 項目で、差がつきませんでした(第5回)。
- 日本語の文章: 6 モデルが 45 点中 41〜43 点で、もう 1 回渡すと 0〜3 点動き、どれが強いとは言えませんでした(第12回)。
- 難しさの違う 10 問: 考える段のある下の設定も、計算・並べ替え・論理・規程は 2 回とも正解でした。差が出たのは、字数を決めた言い換えと、問題文の誤りに気づくかです(第13回)。
- 読み上げ: 原稿と違った所は 0〜2 か所で、どれが自然に聞こえるかは数字では決められませんでした(第3回)。
- 文字起こし: 合成の会議の音声で字の誤りは 2.8〜3.7%(差は 2〜5 字)で、今回の呼び方で話者を分けて返したのは ElevenLabs Scribe v2 だけでした(第14回)。
- 日本語の字の入った画像: Gen-4 Image を除く 4 つが看板の 118 字をすべて正しく描き、Gen-4 Image は 23 字でした(720×720 画素での結果。第1回)。
- 商品画像: 商品の形・色・ラベルの 15 項目は Nano Banana 2.1 を除く 4 つが全部守り、「左半分を空ける」指示は 5 つとも守れませんでした(第8回)。
- サムネイルとバナー: Gen-4 Image を除く 4 つが 66 字を正しく描きましたが、バナーは 5 枚とも、頼んでいない字か字のような模様がありました(第9回)。
- 実写とアニメの絵: 実写だけ・アニメだけが苦手なモデルは見つからず、外れたのは数・位置・左右の指示でした(第6回・第7回)。
- 動画: Grok Imagine Video 1.5・Veo 3.1 Fast・Seedance 2.5 が 18 項目のうち 16〜17 で、差は数え方しだいでした。料金は 1 本 70.2〜421.4 クレジットと大きく違いました(第10回)。
- アニメ調の動画: 絵柄は作れた 9 本とも保たれ、差は物の増減・カメラ・縦横の収め方に出ました(第11回)。
- 3D: 21 項目で 20 と 21 で、差は数え方しだいでした。ファイルの大きさと料金は大きく違いました(第15回)。
文章: 点の差は小さく、字数・料金・考える段で違った
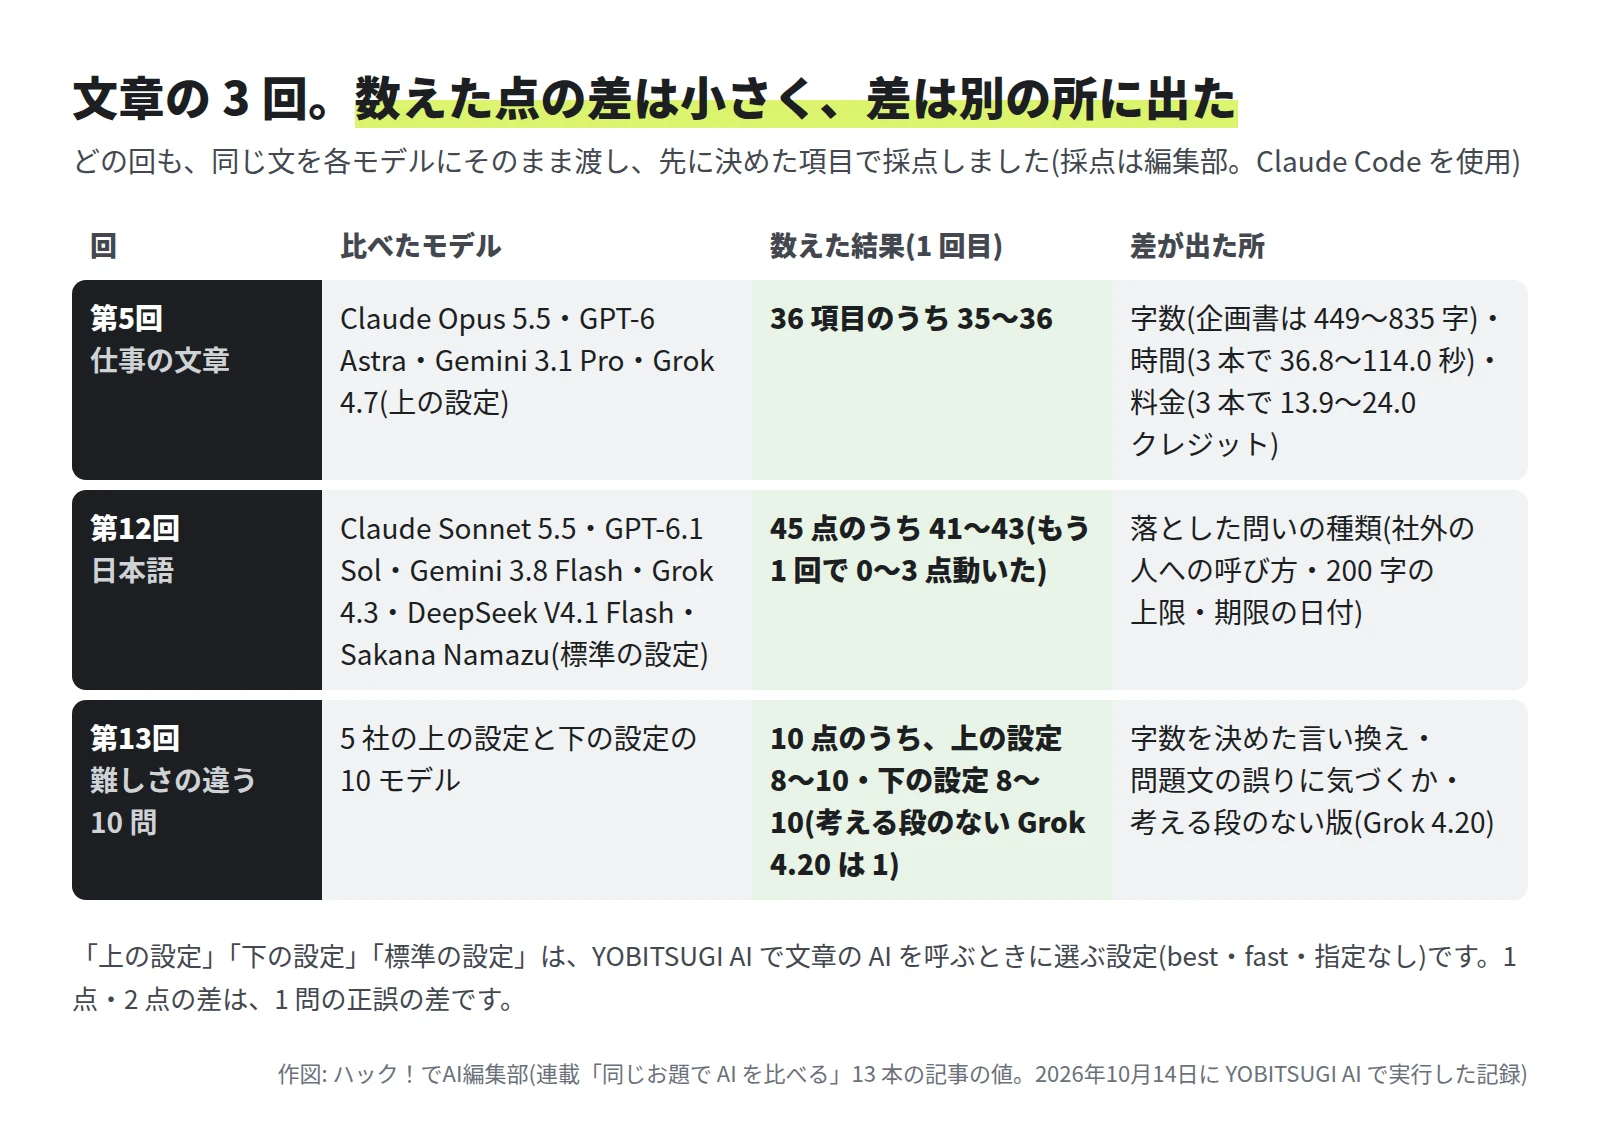
「上の設定」「下の設定」「標準の設定」は、YOBITSUGI AI で文章の AI を呼ぶときに選ぶ設定(best・fast・指定なし)です。
- Claude・GPT・Gemini・Grok に同じ仕事を頼んで比べた 要約・メール・企画書の 3 本勝負: 1 項目の差は、Gemini 3.1 Pro の企画書が 835 字で、800 字を超えたことです。紛らわしい数字を入れた要約と、曜日を付けさせたメールは、4 つとも誤りがありませんでした。
- 日本語に強い AI はどれ? 敬語・要約・言い換えを 6 モデルで比べた: 2 回とも残った誤りは、社外の人に「田中部長は」と言う(3 モデル)、品物に「おそろいでしょうか」と言う(2 モデル)などです。日本語に特化したと Sakana AI が説明する Sakana Namazu も、ほかの 5 モデルと同じ範囲の点でした。
- 高いモデルと安いモデル、差が出るのはどんな仕事? 同じ 10 問を料金つきで比べた: 下の設定のうち、Grok だけは考える段のない版(Grok 4.20)が動き、10 点中 1 点でした。Grok の公式ドキュメントのモデルの一覧には、考える版と考えない版が別の名前で載っています。クレジットは、今回の 10 問の合計を同じ会社で比べると、上の設定が下の設定の 6〜55 倍でした。
画像: 字の正しさより、数・位置・余白で外れた
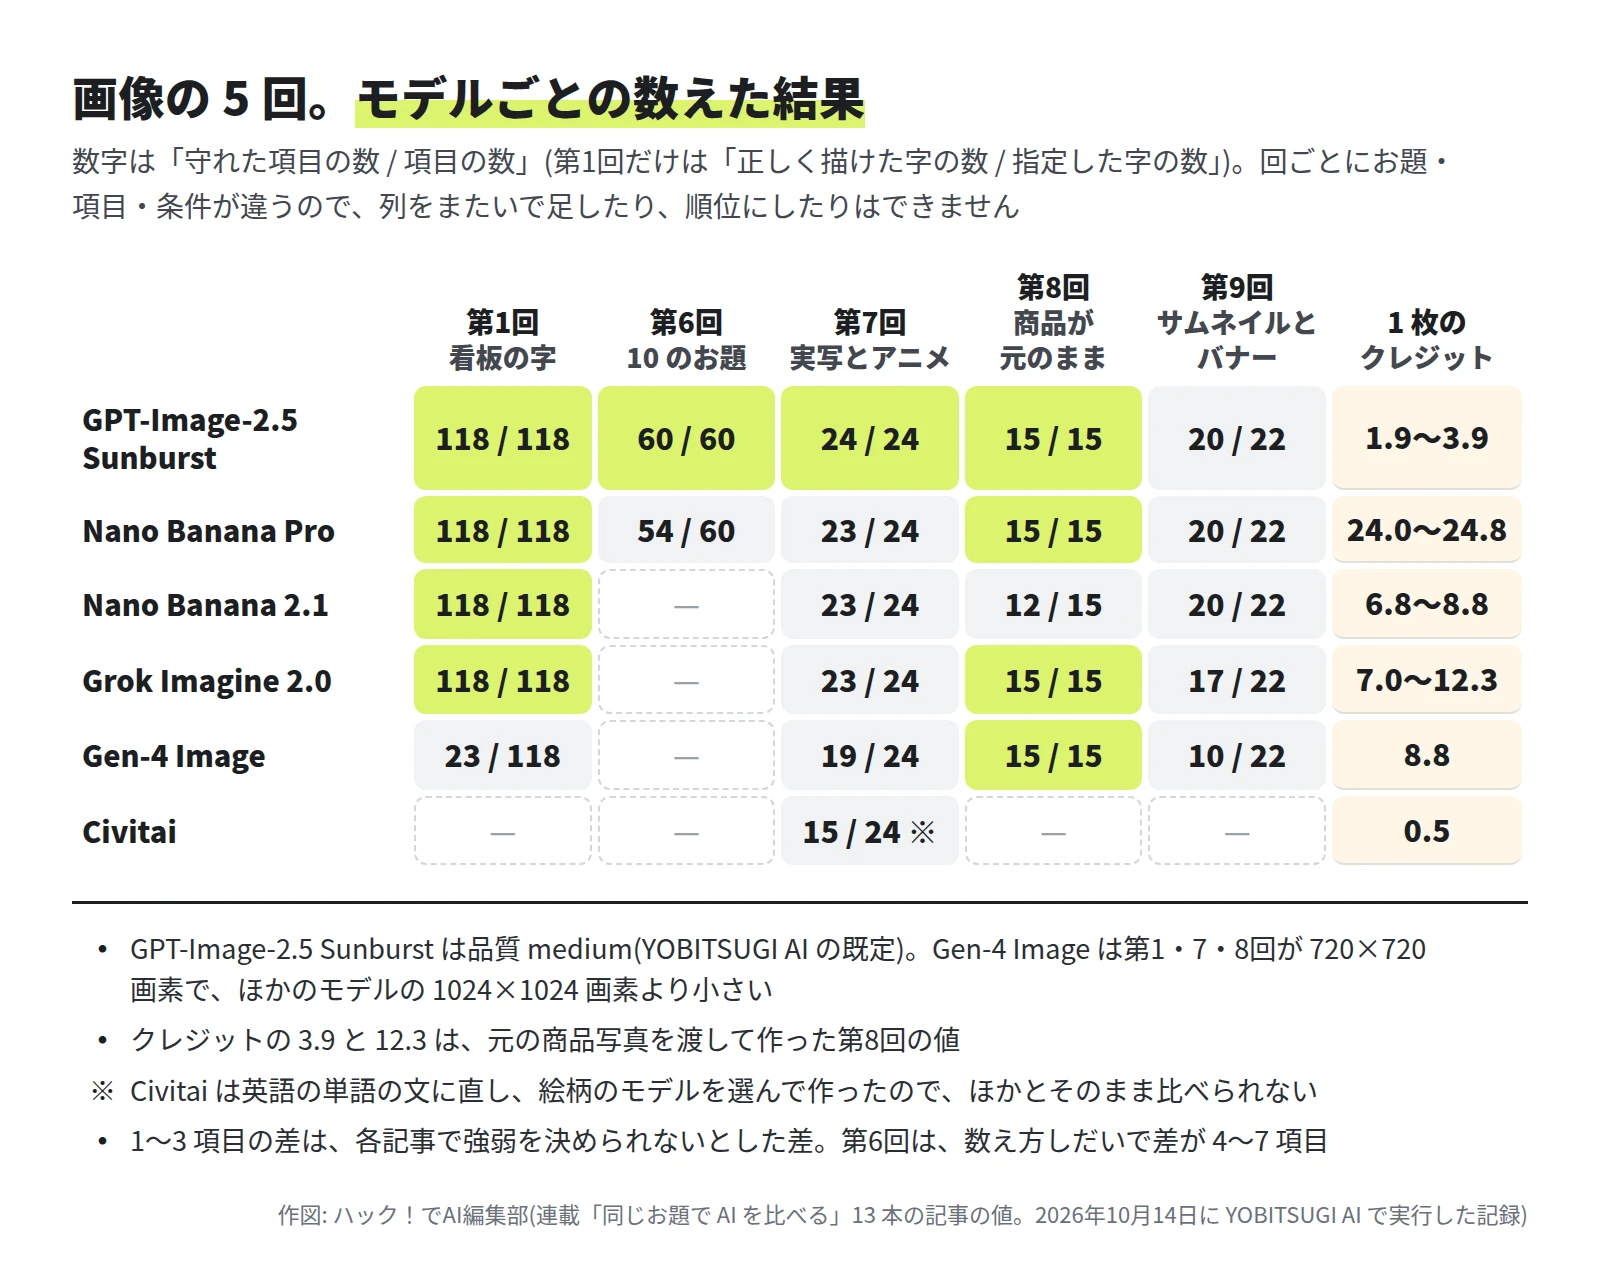
- 日本語の文字が崩れない画像生成 AI はどれ? 同じ看板を 5 つのモデルに描かせて比べた: 118 字を正しく描いた 4 つの違いは、料金・時間・頼んでいない字でした。Grok Imagine 2.0 は、4 枚のうち 2 枚で、文の中のかぎかっこも看板に描きました。
- GPT-Image-2.5 と Nano Banana Pro、どっちがいい? 同じ 10 のお題で描き比べた: 60 項目のうち、GPT-Image-2.5 Sunburst が 60、Nano Banana Pro が 54 でした。数え方しだいで、差は 4〜7 項目のあいだで変わります。× の 6 か所のうち 4 か所は、木・花・字が指示より多く描かれたものです。
- 画像生成 AI を実写とアニメで比較 同じプロンプトで 6 モデルの得意と苦手を見る: 人物を描いた 12 枚で、手の指の数の誤りは 0 でした。外れた 17 項目のうち 15 は、数・位置・左右・しぐさの指示です。
- 商品画像は AI のどれで作る? 同じ商品写真から 5 モデルで作って比べた: 背景の差し替えでは、Gen-4 Image 以外の 4 つが、びんを元の写真のまま残しました。Nano Banana 2.1 は、ふたと丸の灰色が茶色に寄った画像が 2 枚ありました。
- サムネイルとバナーを AI 5 つに作らせた 文字入りはどこまで使える?: 守れた数は 22 項目のうち 10〜20 で、字を正しく描いた 4 つの差は、字の場所と、頼んでいない字や模様でした。字のない背景を作らせて字をあとから重ねる方法なら、字の誤りは起きません。
動画: 料金の差が大きく、断られた 1 本もあった
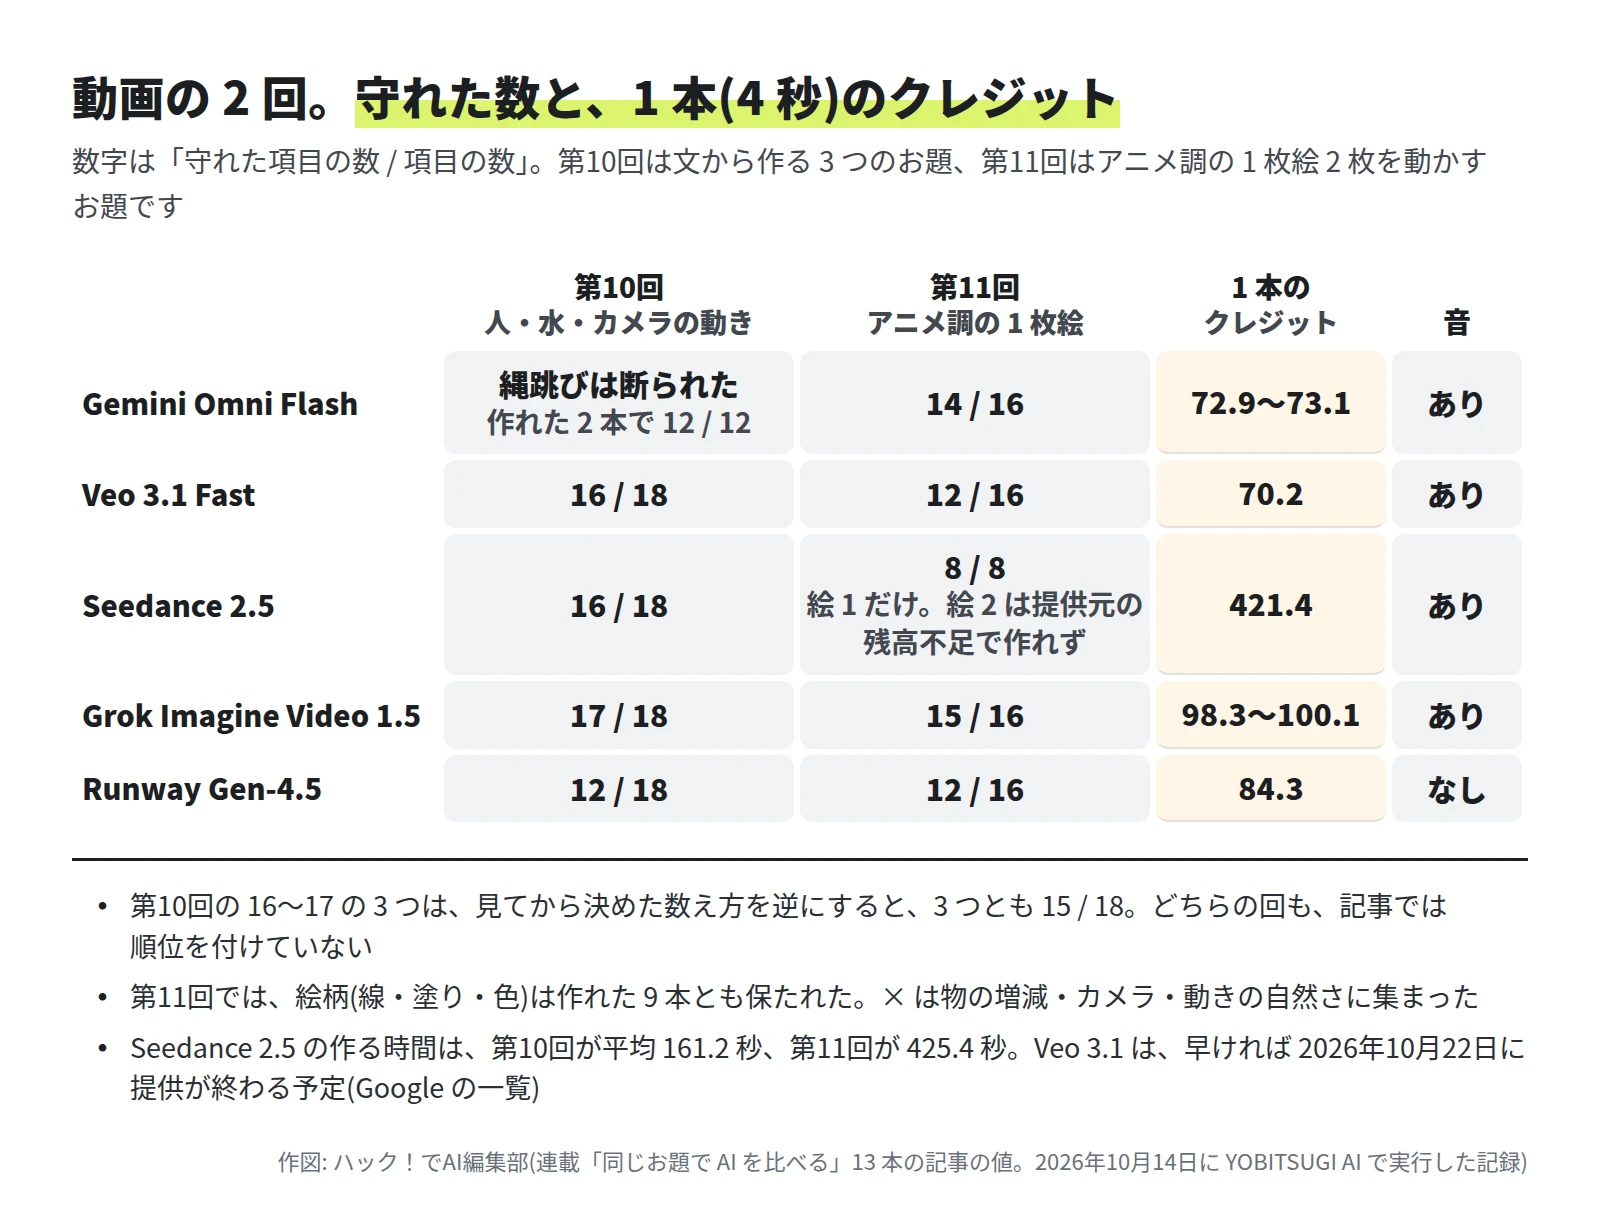
- 動画生成 AI 5 つを同じプロンプトで比較 動き・破綻・1 本あたりの料金: Gemini Omni Flash は、架空の人の縄跳びのお題を安全の判定で断り、作れた 2 本では 12 項目すべてを守りました。Runway Gen-4.5 は 12 / 18 で、3 本とも音が入っていませんでした。Seedance 2.5 は 1 本 421.4 クレジットで、今回の項目では、高い分だけ多く守ったお題はありませんでした。
- アニメ調の動画に強い AI はどれ? 同じ 1 枚絵を 5 モデルで動かした: 正方形の絵を切らずに動かせたのは、960×960 の正方形で作れた Seedance 2.5・Grok Imagine Video 1.5・Runway Gen-4.5 です。2 枚とも物の増減が無かったのは、Grok Imagine Video 1.5 でした。Seedance 2.5 は、提供元の残高が足りず、絵 2 を作れませんでした。
- Veo 3.1 は、Google の提供終了の一覧で、早ければ 2026年10月22日に提供を終える予定とされています。後継は Gemini Omni Flash です。
音声: 数えた差は小さく、機能と料金で違った
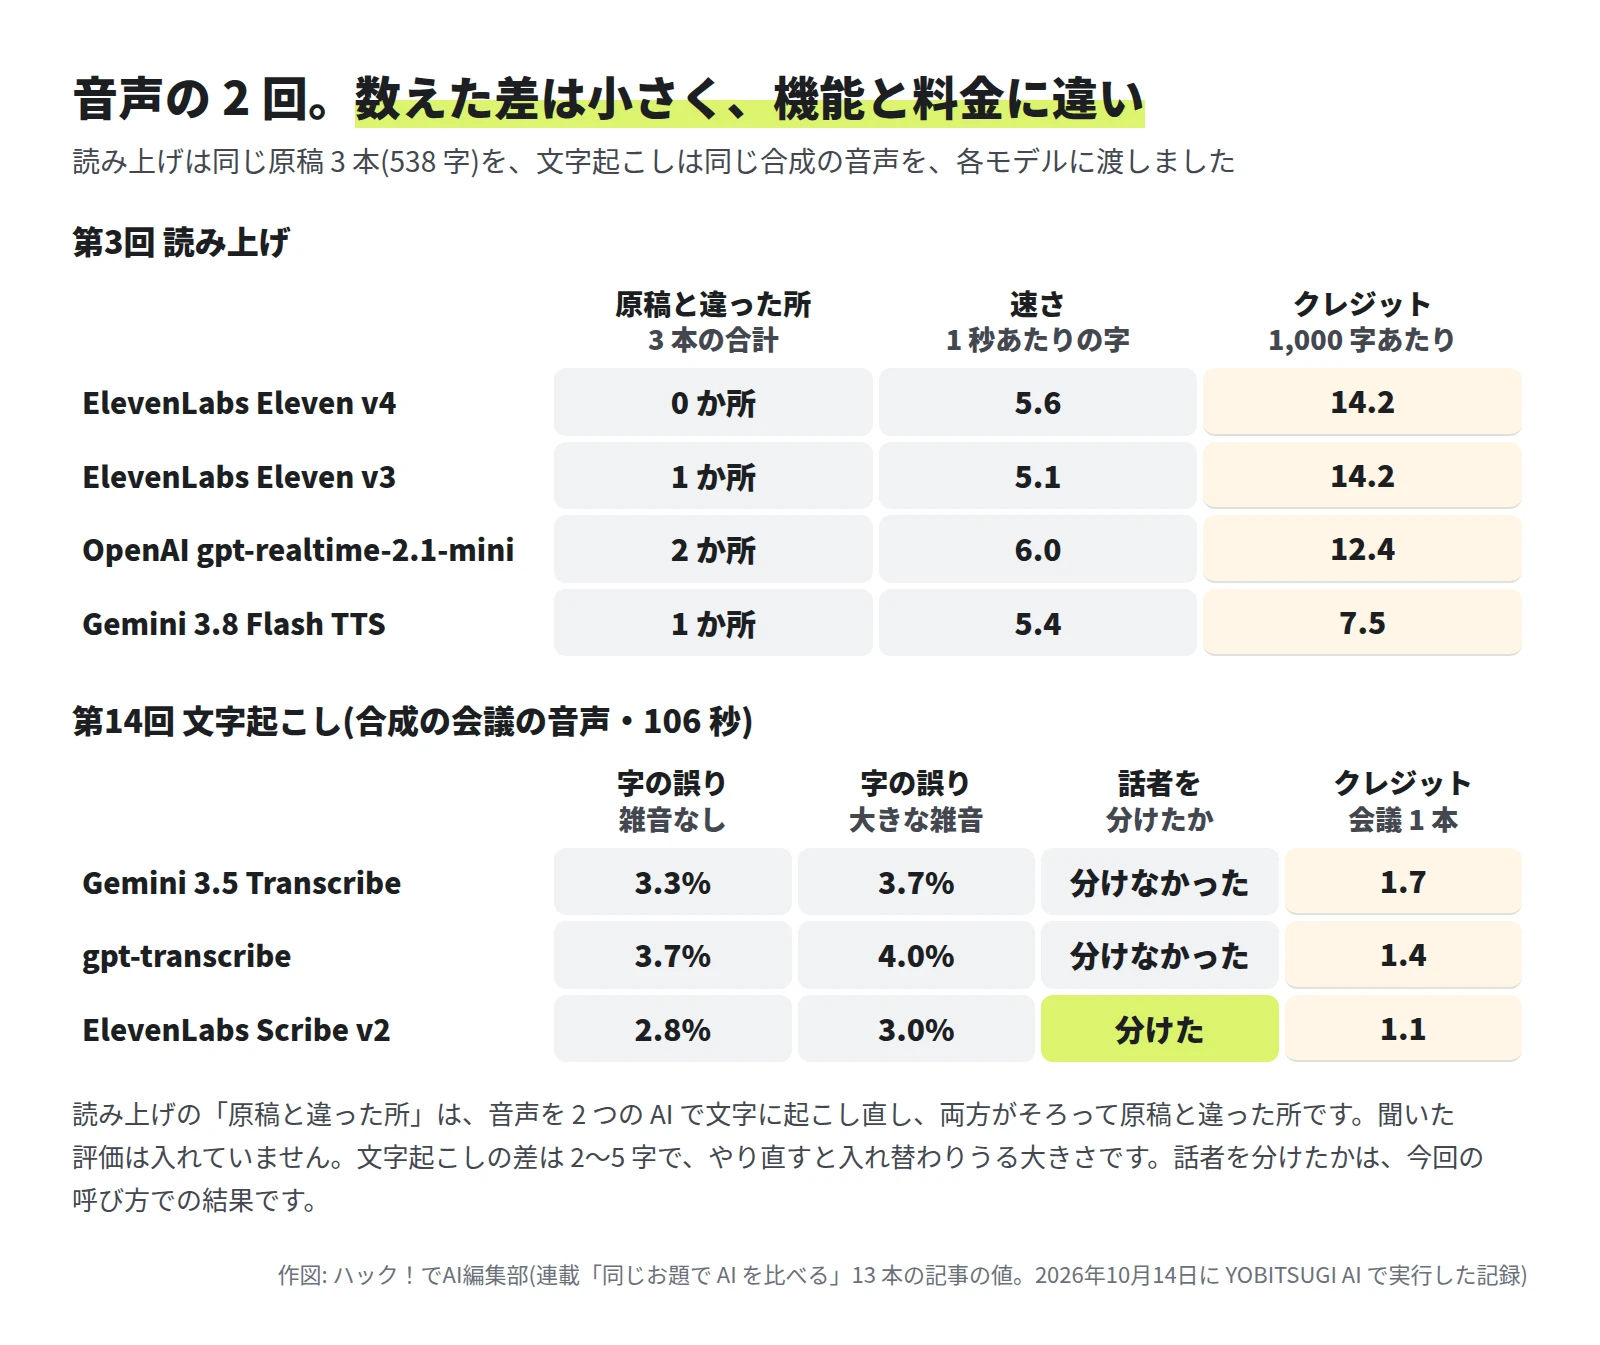
- 日本語の読み上げが自然な AI はどれ? 同じ原稿を 4 つの声で聞き比べ: 音声を 2 つの AI で文字に起こし直して、原稿と比べました。読みが分かれる語(今日・行った など)の読みは、この方法では確かめられませんでした。どれが自然に聞こえるかは、記事の音声 20 本で聞いて確かめてください。
- 文字起こしの精度を AI 3 つで比較 会議・早口・雑音ありの合成音声で試した: 誤りの 6〜7 割は、架空の会社名と商品名の中でした。1.6 倍に速めた音声でも誤りは増えず、大きな雑音を重ねると 1〜2 字増えました。音声は読み上げの AI で作った合成の音声で、本物の会議の録音では結果が変わりえます。
3D: 形の差は小さく、ファイルと料金が違った
- Tripo と Meshy を比較 同じ 1 枚の写真から 3D モデルを作って回して見た: 形と色の 21 項目で、Tripo v3.1 が 20、Meshy が 21 でした。ファイルは Meshy が 1 個 5.7〜11.9 MB で、Tripo v3.1(40〜43 MB)の 4〜7 分の 1 です。料金は Tripo v3.1 が 1 個 52.7 クレジットで、Meshy(105.3)の半分でした。
料金の目安
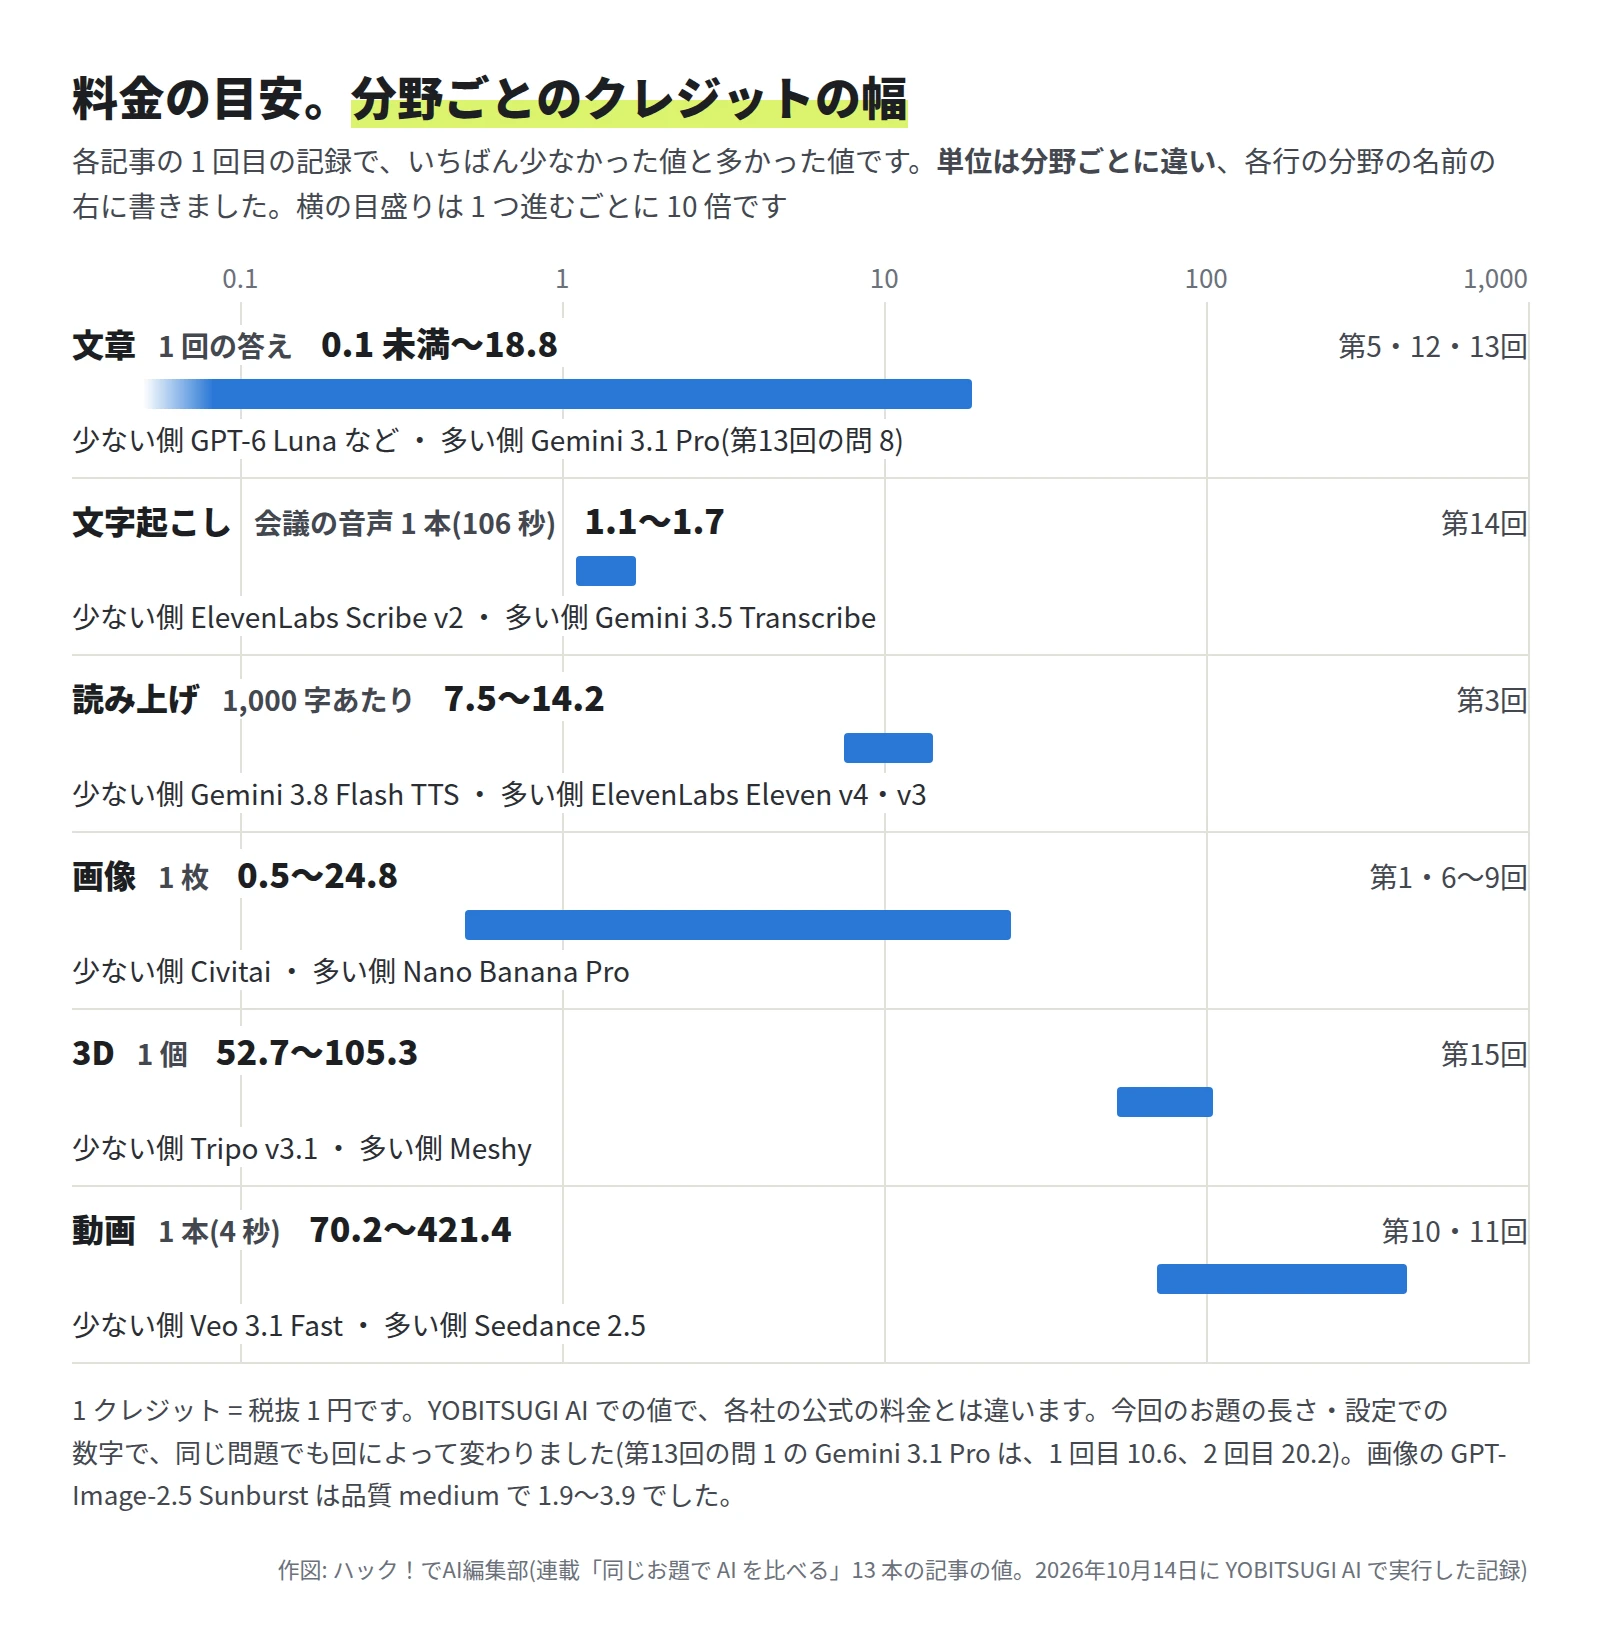
各記事の 1 回目の記録で、いちばん少なかった値と多かった値です。今回のお題の長さ・設定での数字で、単位は分野ごとに違います。
| 分野 | 1 回の単位 | クレジット |
|---|---|---|
| 文章 | 1 回の答え | 0.1 未満〜18.8 |
| 文字起こし | 会議の音声 1 本(106 秒) | 1.1〜1.7 |
| 読み上げ | 1,000 字あたり | 7.5〜14.2 |
| 画像 | 1 枚 | 0.5〜24.8 |
| 3D | 1 個 | 52.7〜105.3 |
| 動画 | 1 本(4 秒) | 70.2〜421.4 |
- 文章の 18.8 は、第13回の 8 つの決まりを守ってお知らせを書く問題の、Gemini 3.1 Pro です。同じ回の 1 問あたりの平均は、上の設定が 1.1〜5.9、下の設定が 0.1 未満〜0.9 でした。
- 同じ文でも、回によって変わりました。第13回の問 1 の Gemini 3.1 Pro は、1 回目が 10.6、2 回目が 20.2 クレジットでした。
13 回を通して分かったこと
既定のままでも、条件はそろわなかった
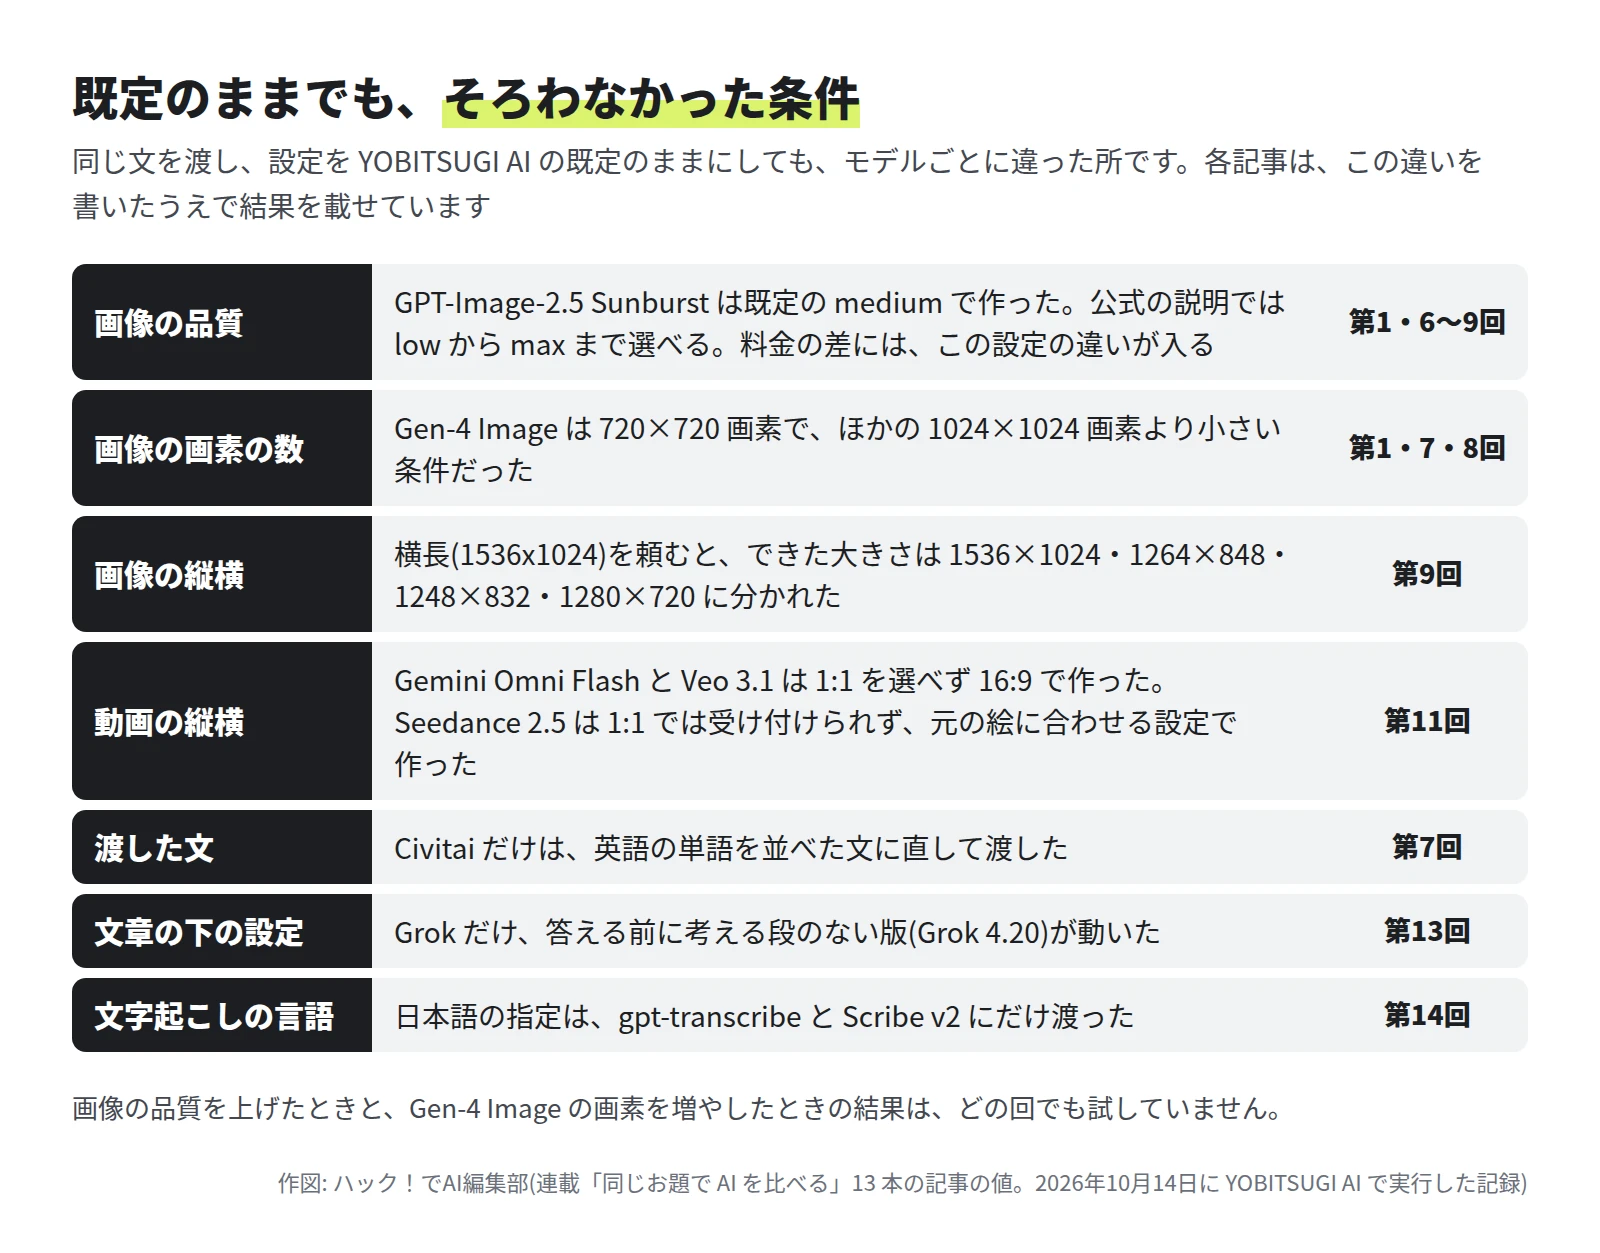
同じ文を渡し、設定を既定のままにしても、モデルごとに条件が違う所がありました。各記事は、この違いを書いたうえで結果を載せています。
- GPT-Image-2.5 Sunburst は、YOBITSUGI AI の既定の品質 medium で作りました。OpenAI の説明では、品質は low から max まで選べます。画像の料金の差には、この設定の違いが入っています。
- Gen-4 Image は 720×720 画素で、ほかの 1024×1024 画素より小さい条件でした。横長を頼んだ第9回では、できた画像の大きさが 4 通りに分かれました。
- 正方形の絵を動かした第11回では、Gemini Omni Flash と Veo 3.1 は 1:1 を選べず、16:9 で作りました。
- 文章の下の設定では、Grok だけ、考える段のない版が動きました。
1 回ずつの結果は、入れ替わることがある
- 第12回は、同じ文をもう 1 回渡すと合計が 0〜3 点動き、点の並びが入れ替わりました。
- 第13回は、2 回目に 8 か所の ○ × が変わりました。問題文の誤りに気づいたモデルは、1 回目の 4 つから、2 回目は 1 つになりました。
- 第5回は、Claude Opus 5.5 の守れた項目が 36 から 35 になり、企画書の料金の案は 4 つとも別の金額になりました。
- 結果を見てから決めた数え方を逆にすると、差は変わりました(第6回は 4〜7 項目、第10回は 3 つとも 15 / 18、第15回はどちらも 20〜21)。
1〜2 項目の差は、どの回でも、強弱を決められる差として扱っていません。
料金の高いほうが、多く守るとは限らなかった
- 第13回では、計算・並べ替え・論理・規程の読み取りは、考える段のある下の設定でも 2 回とも正解しました。差が出たのは、字数を決めた言い換え(下の設定で 1 字超えが出た)と、問題文の誤りに気づく問題(上の設定でも分かれた)です。
- 第1回の Nano Banana Pro と Nano Banana 2.1 は、正しく描けた字の数が同じで、クレジットは Pro が約 3 倍でした。
- 第10回の Seedance 2.5 は、ほかの 4〜6 倍のクレジットで、高い分だけ多く守ったお題はありませんでした。第11回の絵 1 では、8 項目すべてを守っています。
外れが集まったのは、数・位置・余白と、頼んでいない物
- 画像では、第7回の外れ 17 項目のうち 15 が数・位置・左右・しぐさの指示でした。第8回の「左半分を空ける」は、5 つとも守れませんでした。
- 字の入った画像では、背景や小物に、頼んでいない字や字のような模様が出ました(第1回・第9回)。
- 動画では、第11回の × 11 のうち 5 が物の増減でした。
- 文章では、字数の上限(第5回・第12回・第13回)と、入れるべき日付(第12回)で外れました。
今回比べていないもの
- Midjourney・Suno・Sora・Kling は、今回は作っていません。
- 文章の AI のうち、Claude Fable 5.1 と Gemini 4 Argon は、どの回でも比べていません。
- 音楽を作る AI は、13 回のどれでも比べていません。
自分で比べるときの手順
13 本で編集部がやった比べ方を、自分の仕事で試す手順にしました。
-
自分のお題を 1 つ決め、同じ文を候補の AI にそのまま渡す
モデルごとに言い換えません。設定を変えるなら、全部のモデルで同じにします。
-
見る項目を、結果を見る前に書いておく
字数・入れる要点・物の数と位置・字の正しさなど、数えられることにします。
-
1 回目をそのまま並べて数える
画像は拡大して 1 字ずつ、動画はコマ送りで、音声は文字に起こし直して確かめます。時間とクレジットも書き留めます。
-
気になる差は、もう 1 回渡して確かめる
1〜2 項目の差は、2 回目で入れ替わることがありました。
-
名前・数字・日付・頼んでいない物は、人が確かめてから使う
まとめ
- 13 回の多くで、先に決めた項目で数えた差は小さく、1 つのモデルに決められませんでした。
- 違いがはっきりしたのは、料金、日本語の字を描けたか、考える段のない版が動いたか、今回の呼び方で話者を分けて返したか、3D のファイルの大きさでした。
- 選ぶときは、自分のお題で同じ文を渡し、1 回目を数えて比べてください。
参考にした公式の情報
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
同じお題で AI を比べる全 14 回の目次
- 1日本語の文字が崩れない画像生成 AI はどれ? 同じ看板を 5 つのモデルに描かせて比べた
- 3日本語の読み上げが自然な AI はどれ? 同じ原稿を 4 つの声で聞き比べ
- 4生成 AI の使い分け 2026 年版 同じお題で 13 回比べて分かった得意分野(この記事)
- 5Claude・GPT・Gemini・Grok に同じ仕事を頼んで比べた 要約・メール・企画書の 3 本勝負
- 6GPT-Image-2.5 と Nano Banana Pro、どっちがいい? 同じ 10 のお題で描き比べた
- 7画像生成 AI を実写とアニメで比較 同じプロンプトで 6 モデルの得意と苦手を見る
- 8商品画像は AI のどれで作る? 同じ商品写真から 5 モデルで作って比べた
- 9サムネイルとバナーを AI 5 つに作らせた 文字入りはどこまで使える?
- 10動画生成 AI 5 つを同じプロンプトで比較 動き・破綻・1 本あたりの料金
- 11アニメ調の動画に強い AI はどれ? 同じ 1 枚絵を 5 モデルで動かした
- 12日本語に強い AI はどれ? 敬語・要約・言い換えを 6 モデルで比べた
- 13高いモデルと安いモデル、差が出るのはどんな仕事? 同じ 10 問を料金つきで比べた
- 14文字起こしの精度を AI 3 つで比較 会議・早口・雑音ありの合成音声で試した
- 15Tripo と Meshy を比較 同じ 1 枚の写真から 3D モデルを作って回して見た