AI の記事はつまらない? 95 本(10 月 15 日時点)を作った編集部が見た違い
 佐々木 航
この記事でわかること
- 10 月 15 日までの 95 本で見た、人と AI の分担と時間・費用
- AI の校閲が 15 本で直した 231 件の種類と実例
- 決まりなしで AI に書かせたリードと、公開した記事の違い
確認した環境: 編集部の作業の記録・公開の記録(2026年10月11日〜15日 21 時・95 本)/ YOBITSUGI AI で Claude Opus 5.5・GPT-6 Astra・Gemini 3.1 Pro を実行 / 2026年10月15日に確認
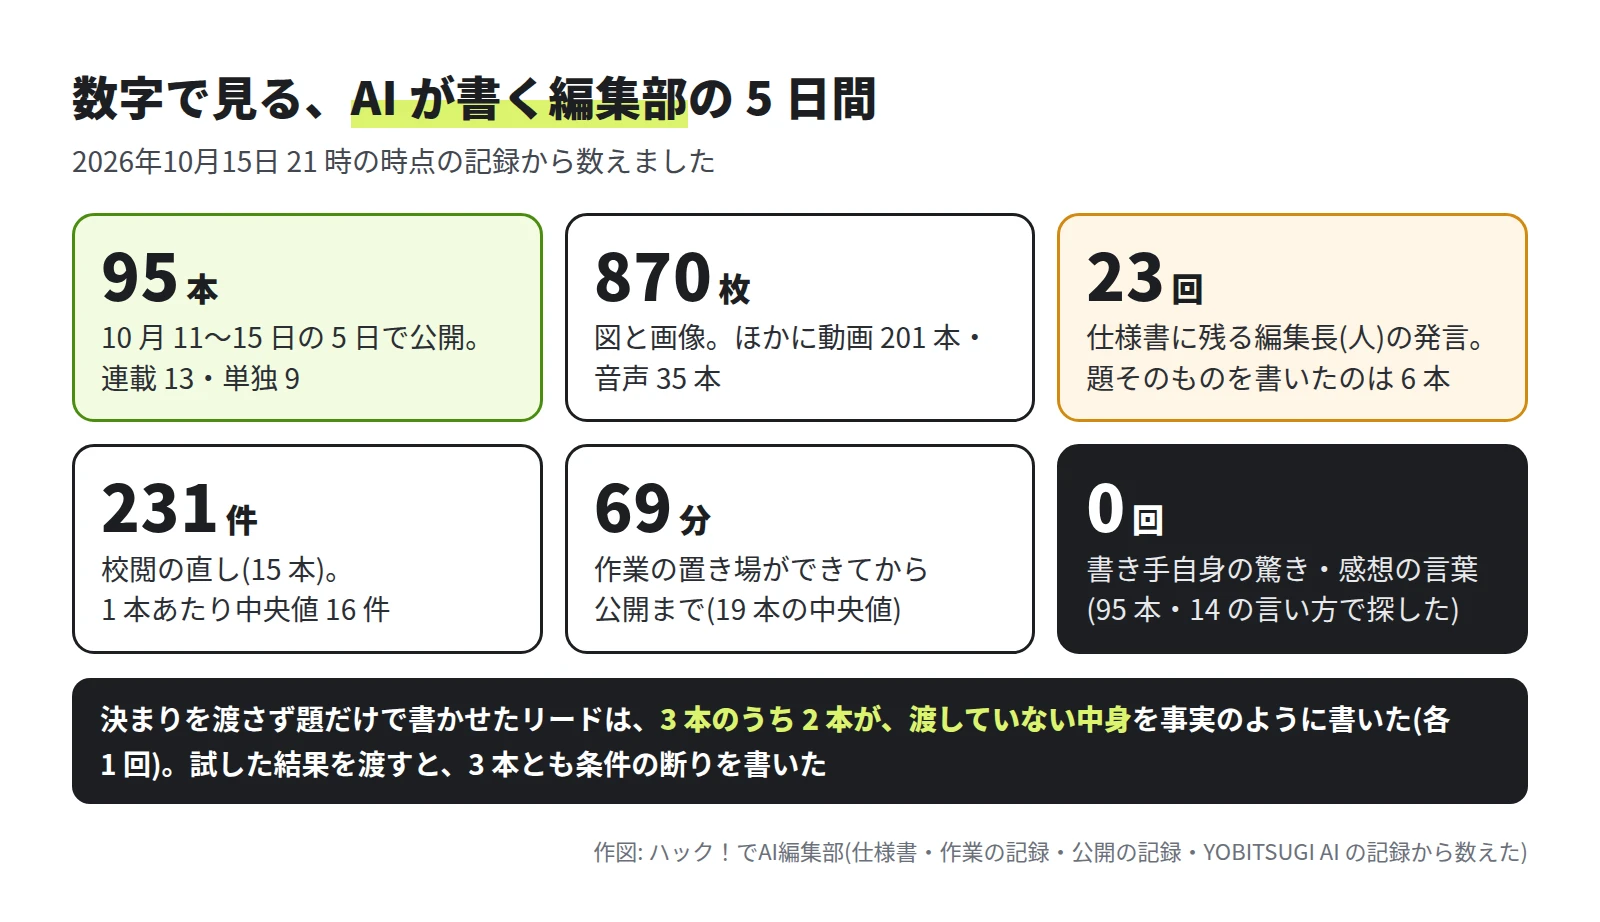
AI の記事がつまらないかどうかは、読み手の評価を取っていないので、この記事では決めません。代わりに、10 月 11 日から 15 日 21 時までに 95 本の記事を AI に書かせた、この編集部の記録を数えました。95 本の本文には数字が約 2 万個ありましたが、書き手自身の驚きや感想の言葉は、決めた 14 の言い方で探した範囲では見つかりませんでした。題だけを渡して AI に書かせた小さな試しでは、3 本のうち 2 本が、渡していない中身(架空の看板や結果など)を事実のように書きました。
この記事の数字の数え方(1 行ずつ)
- 95 本・連載 13・単独 9: 公開の記録で、10 月 15 日 21 時までに公開した記事を数え、先頭の項目の連載の名前で分けました。
- 図と画像 870 枚・動画 201 本・音声 35 本: 95 本の本文に載せた図(画面の写しと、AI に作らせた絵を含む)・動画・音声の数です。
- 発言 23 回・指示 61 件: 仕様書の「指示の記録」にある編集長の発言の数と、それを指示ごとに分けた数です(10 月 15 日 21 時台の版)。
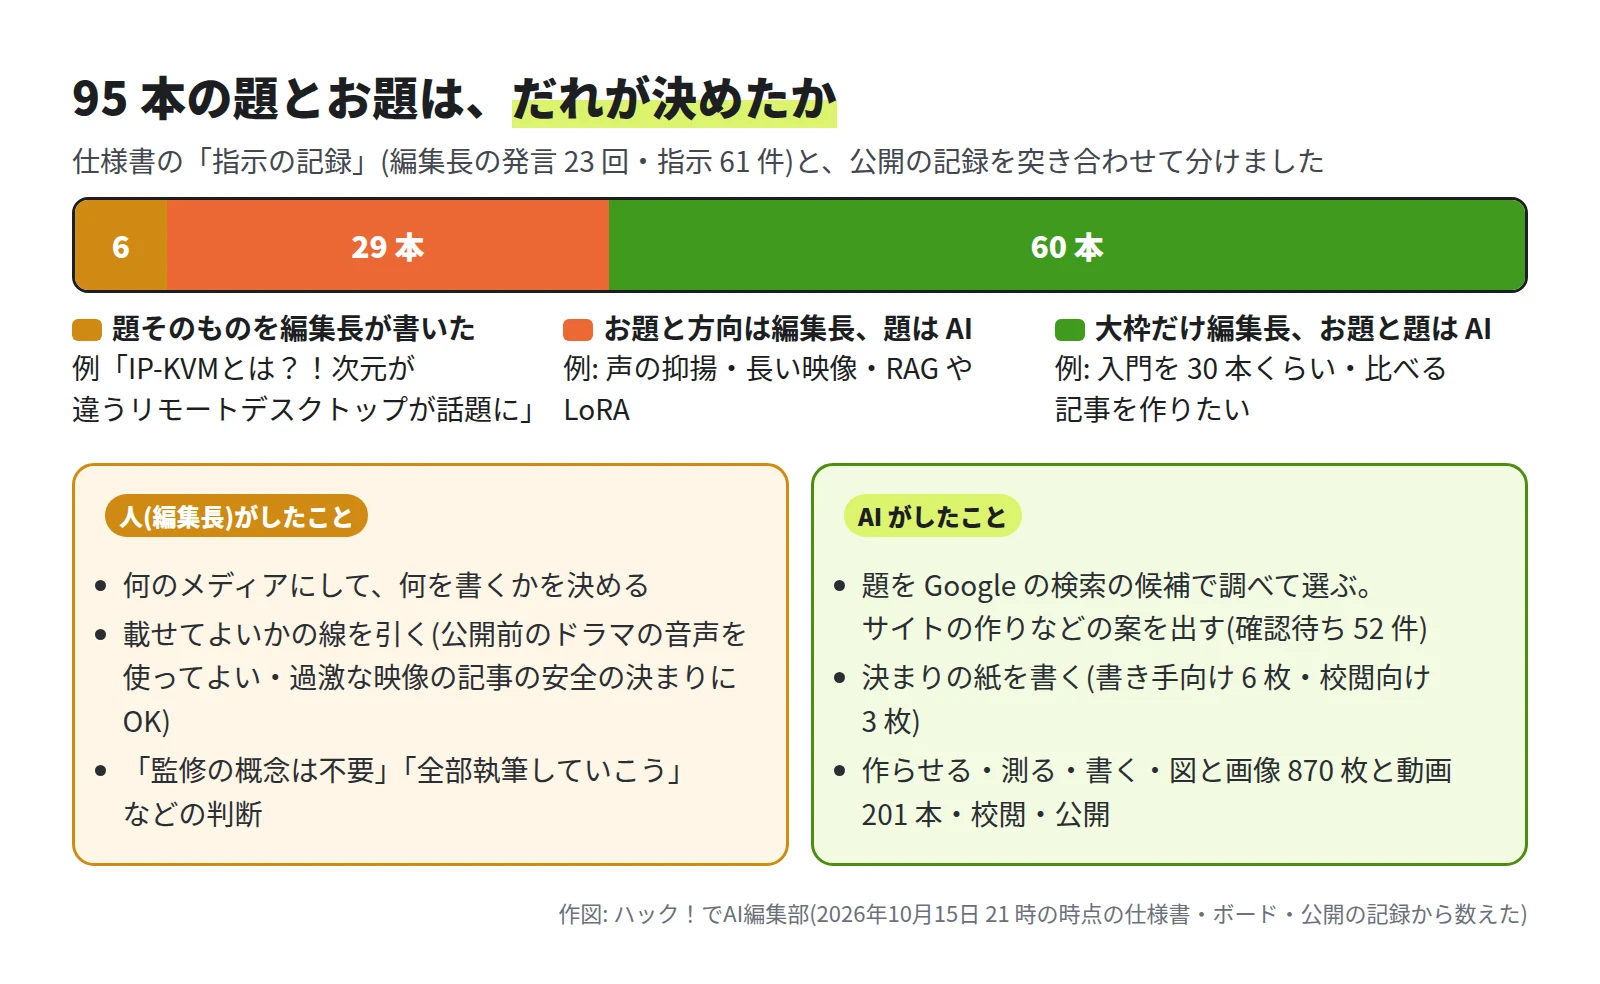
- 題の決め方 6・29・60 本: 公開した題を発言の文と突き合わせ、題がそのまま発言にある物、お題と方向が発言にある物、それ以外に分けました。分けたのは AI です。
- 校閲の直し 231 件: 直す前の控えと最初に公開した版の差を取り、目的が 1 つの書き換えを 1 件と数えました。3 つの AI が 5 本ずつ分けました。
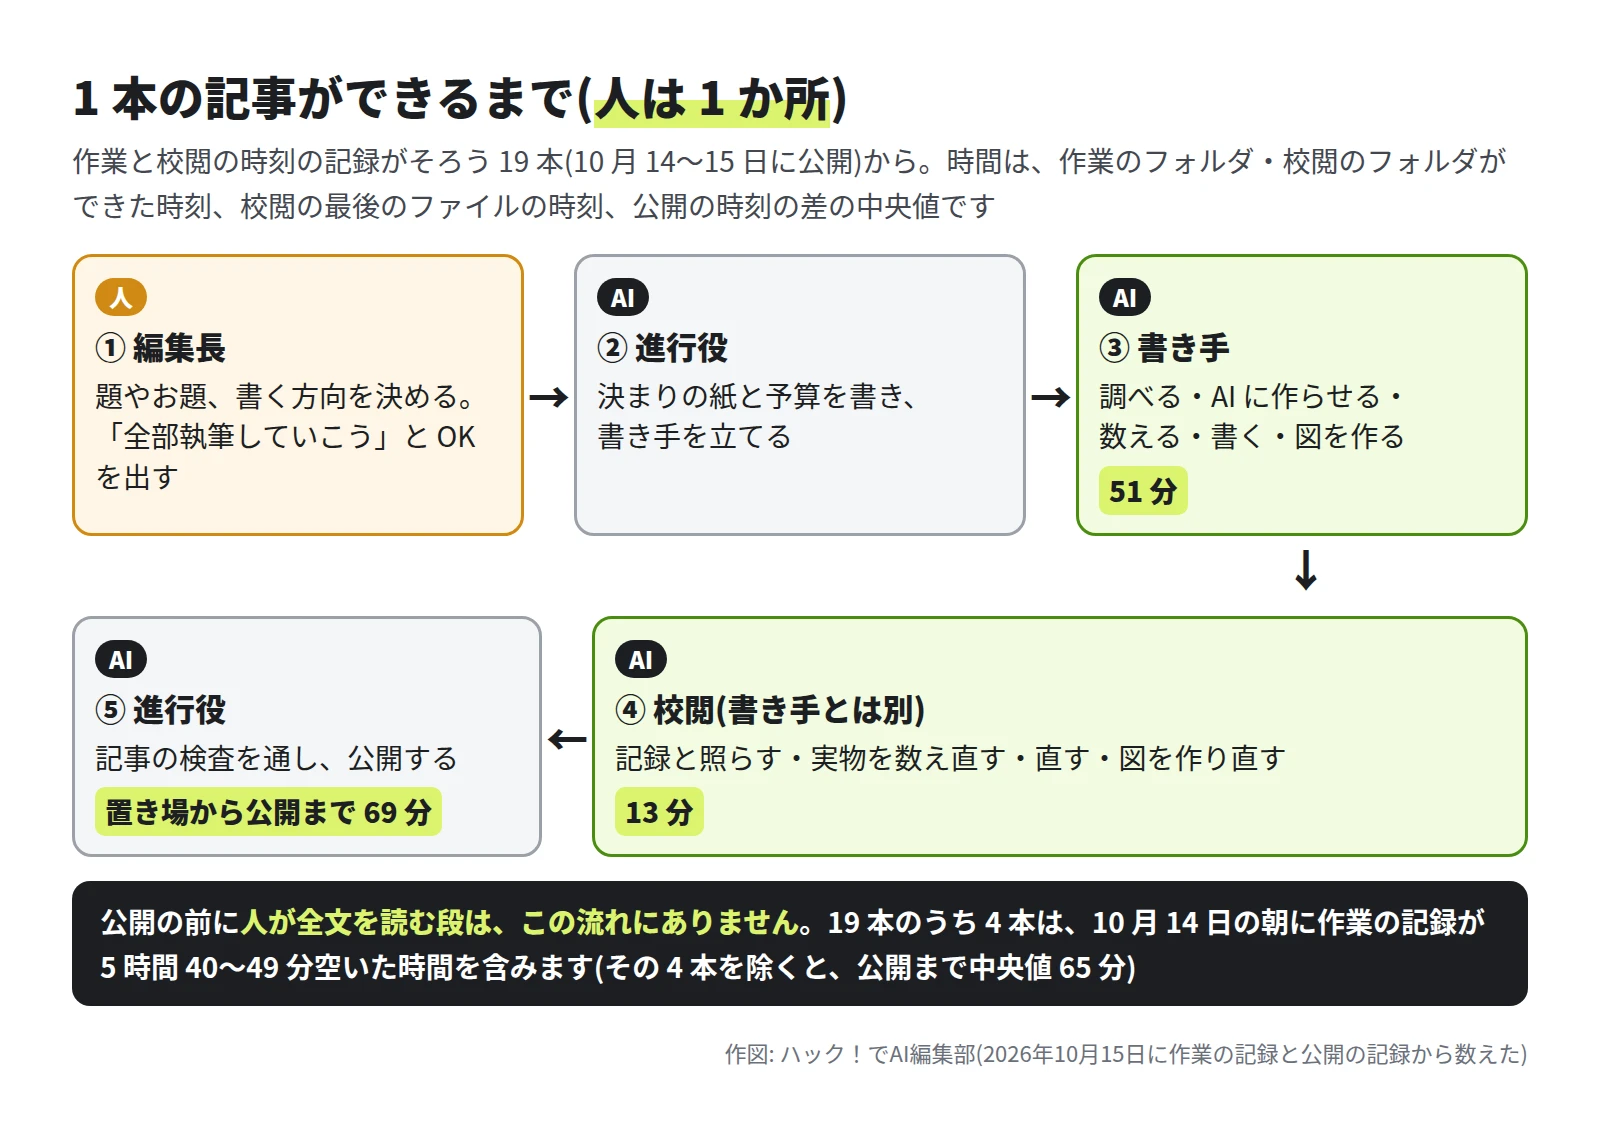
- 時間 69 分・51 分・13 分: 作業のフォルダができた時刻、校閲のフォルダができた時刻、その中の最後のファイルの時刻、公開の時刻の差です。校閲のフォルダがある 22 本から、時刻が合わない 3 本を除いた 19 本の中央値です。
- クレジット 26,554.8: YOBITSUGI AI の記事ごとの記録の合計です。試し打ちと作り直しの分も入ります。
- 数字約 2 万個: 本文(コードの枠と図の行を除く)の算用数字のまとまりを数えました。「2.5」は 1 つ、「1024×1024」は 2 つです。
- 驚き・感想 0 回: 同じ本文で 14 の言い方(意外・驚・面白・と感じ・と思い・と思う・と思っ・おすすめ・残念・うれし・嬉し・楽し・がっかり・びっくり)を探し、出た 13 か所を 1 つずつ読みました。
- 見立て 74 回: 同じ本文で「見立て」という語が出た回数です。
この編集部の記事づくり
5 日で 95 本、仕様書に残る人の発言は 23 回
10 月 15 日 21 時の時点で公開していた 95 本は、13 の連載に入る 86 本と、単独の記事 9 本です。10 月 11 日に 31 本、12 日に 28 本、14 日に 17 本、15 日は 21 時までに 19 本を公開しました(13 日は 0 本)。本文に載せた図と画像は 870 枚、動画は 201 本、音声は 35 本です。
1 本の記事は、次の順で作ります。編集長(人)が題やお題を決めます。進行役の AI が、書き手に渡す決まりの紙と予算を書き、書き手の AI を立てます。書き手は公式のページで調べ、AI に画像や動画を作らせ、数えて書き、図を作ります。書き手とは別の AI が校閲し、進行役の AI が記事の検査を通して公開します。公開の前に人が全文を読む段は、この流れにありません。
人が決めたことと、AI がしたこと
編集部の仕様書(決めたことの記録)に残る編集長の発言は 23 回で、指示に分けると 61 件です。題そのものを編集長が書いたのは 6 本です。29 本は、編集長がお題と方向を決め、AI が題を付けました。残りの 60 本は、編集長が、基礎的な使い方の記事を 30 本くらい、比べる記事を作りたい、のような大枠を出し、AI がお題と題を選びました(比べる記事の 15 本は、AI が出した一覧に編集長が OK を出しています)。
題は、AI が Google の検索の候補で調べて選ぶことが多くあります(連載「同じお題で AI を比べる」の最初の 15 本など)。サイトの作りなどで AI が出し、編集長の確認を待っている案も 52 件あります。書き手と校閲に渡す決まりの紙(9 枚)を書いたのも、進行役の AI です。編集長の発言にあるのは「ビジュアルをできる限り多く」のような大きな方向で、「1〜2 項目の差で順位を付けない」のような細かい決まりは入っていません。仕様書とボードの形は、プロジェクトごとに軽い管理の仕組みを作るで紹介しています。
校閲で直した誤り
直す前の控えが残る記事から、10 月 14〜15 日に公開した 15 本を選び、控えと最初に公開した版を比べました。直した所は 231 件で、1 本あたり 10〜22 件(中央値 16 件)です。図も約 64 枚を作り直していました(一部は、ファイルの更新の時刻からの推測です)。1 件は、目的が 1 つの書き換えとして数えています。分けたのは編集部の AI(3 つの AI が 5 本ずつ)なので、1 件のまとめ方は少しずつ違い、どちらの種類とも取れる直しもありました。
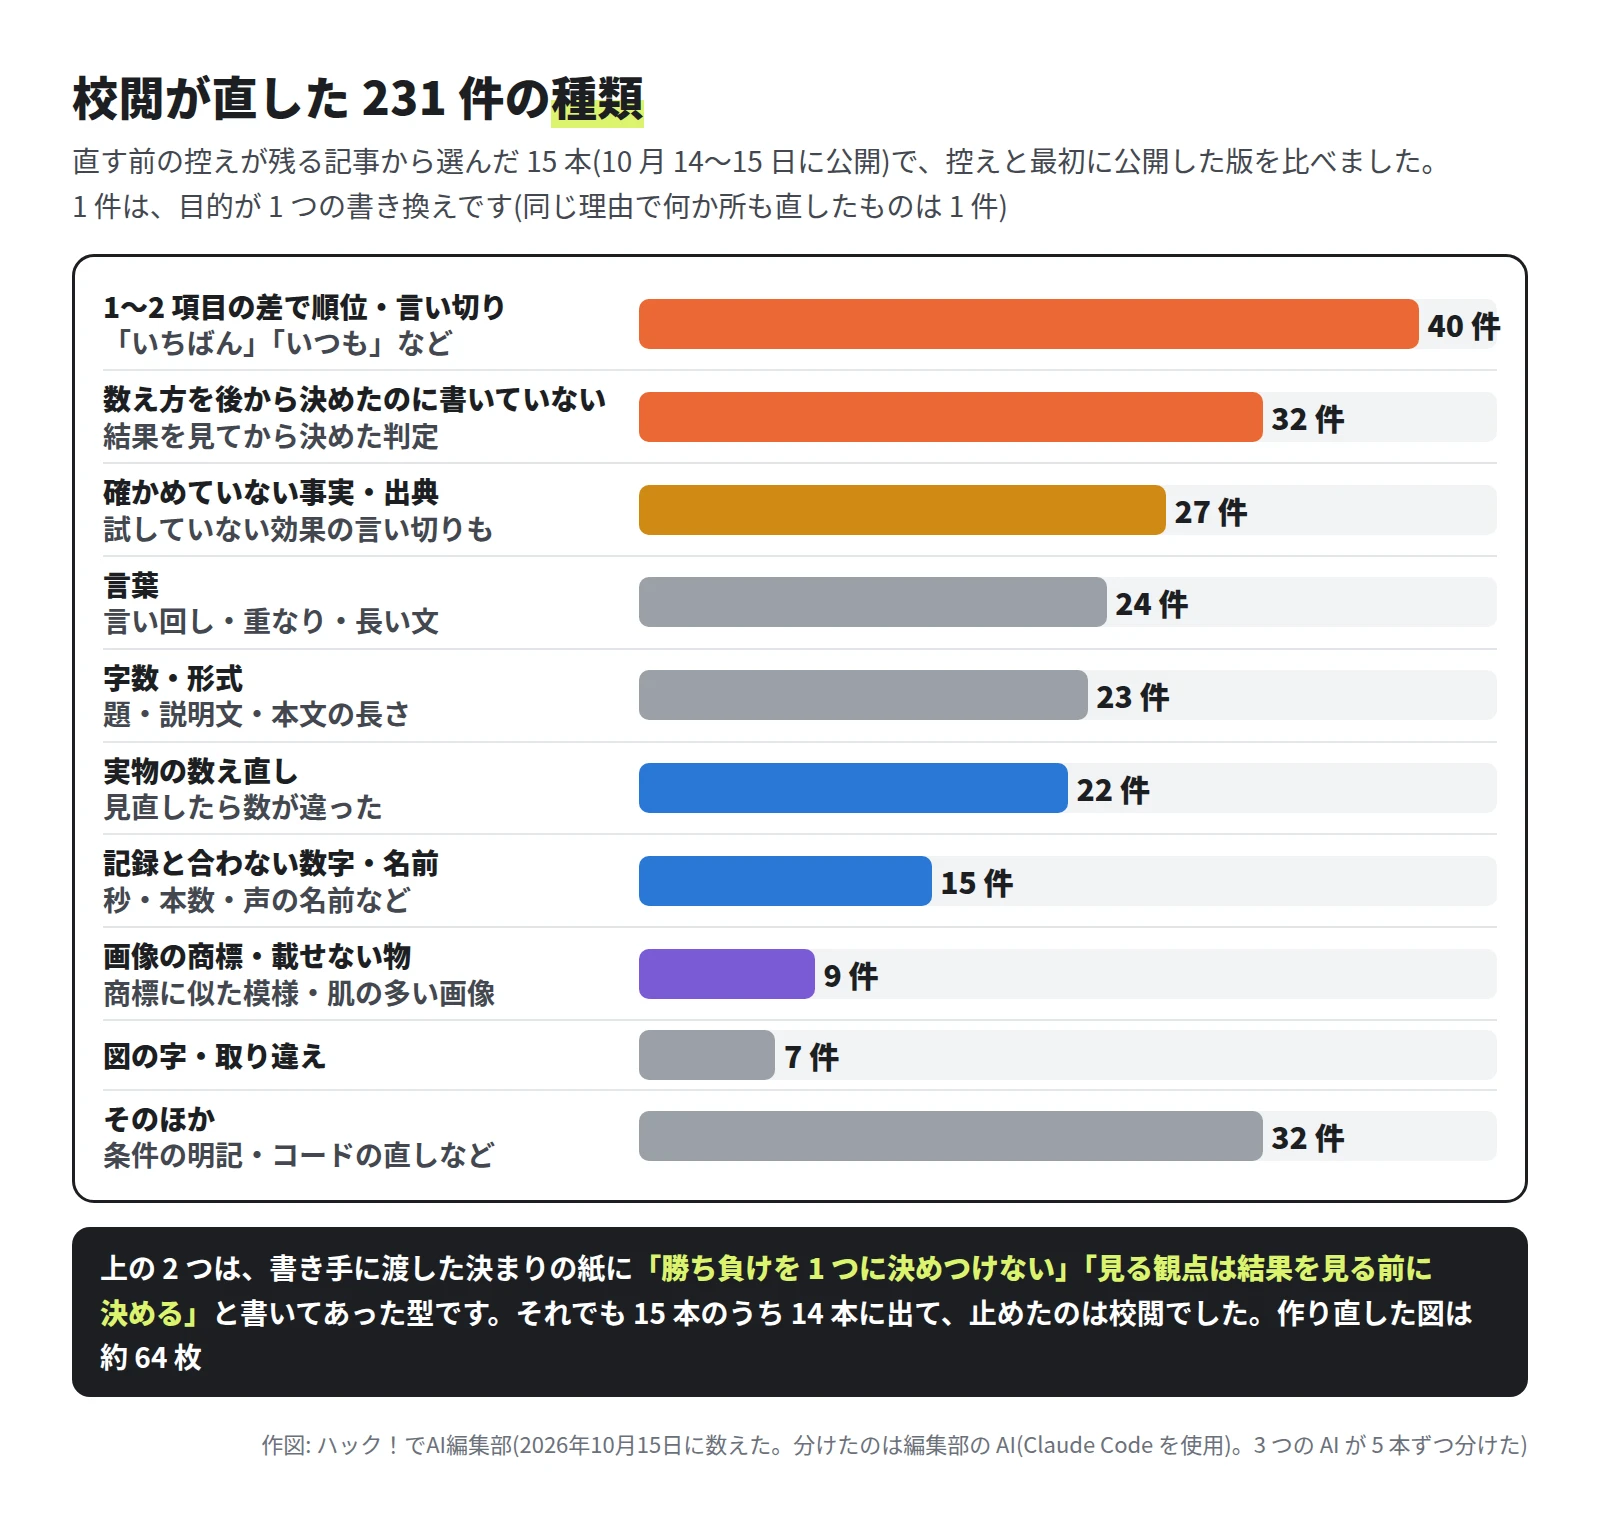
多かった 2 つの型は、書き手に渡した決まりの紙に、はじめから「しない」と書いてあった物です。それでも 15 本のうち 14 本に出ました。止めていたのは校閲でした。
| 型 | 記事 | 直す前 → 直した後 |
|---|---|---|
| 1〜2 項目の差で順位 | 動画生成 AI 5 つ | 18 項目で 17・16・16 と並べていた → 有利に数えた所を逆にすると、3 つとも 15 / 18 と書いた |
| 後から決めた数え方 | 商品画像 | 「○ にしました(編集部の見立て)」→ 絵を見てから決めた判定で、× にすると 21/24 と足した |
| 記録と合わない数 | カメラワーク | 頼み直した動画「16 本」→ 記録では 15 本 |
| 測る道具の誤り | Tripo と Meshy | 3D の閉じていない辺「94・60・400 本」→ 道具が近い頂点までまとめていた。直すと 6・0・0 本 |
| 試していない効果 | 絵コンテ(Tripo と Meshy も同じ型) | 「同じ絵と文でも、作るたびに動きは変わります」→「同じ絵と文で作り直したときの違いは確かめていません」 |
| 聞いていない音 | 読み上げ | 「記号の名前を声に出して読んだモデルは、ありませんでした」→「記号の名前が起こし直しに出たモデルは、ありませんでした」 |
| 画像の商標 | バトルシーン | 袖の模様が、どんな会社の商標に似ているかまで書いていた → 「商標に似た模様」とだけ書いた |
公開の前の校閲で、全部を拾えているわけではありません。公開の 1 分後に、会社名の書き方を直した記事もありました。
1 本の時間と費用
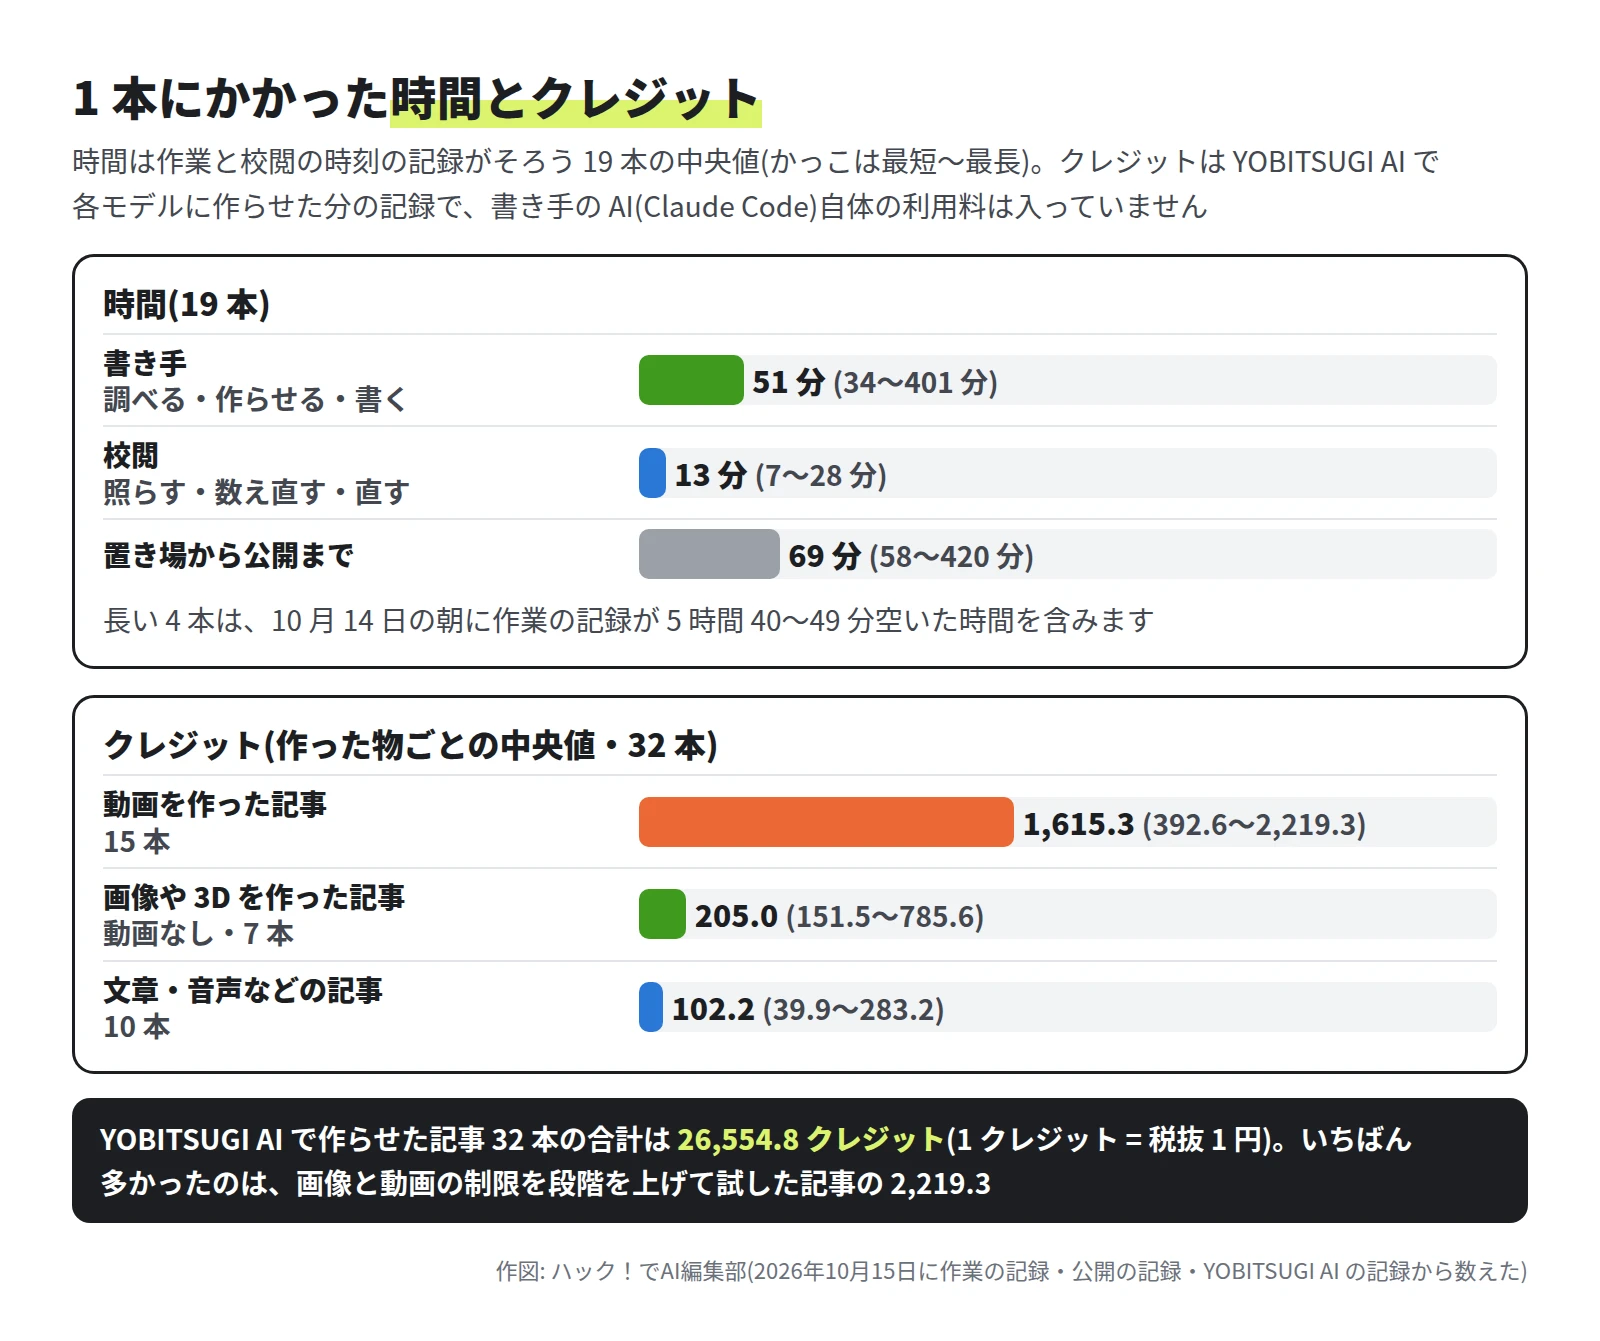
作業と校閲の時刻の記録がそろう 19 本では、作業の置き場ができてから公開までが中央値 69 分でした。書き手が 51 分、校閲が 13 分です。19 本のうち 4 本は、10 月 14 日の朝 4 時台から 10 時台まで、作業の記録が 5 時間 40〜49 分空いた時間を含みます(理由は記録に残っていません)。
YOBITSUGI AI で各モデルに作らせた記事 32 本の費用は、合わせて 26,554.8 クレジットでした。1 本あたりの中央値は、動画を作った 15 本が 1,615.3、動画は作らず画像や 3D を作った 7 本が 205.0、文章と音声などの 10 本が 102.2 クレジットです。書き手の AI(Claude Code)自体の利用料は、この数に入っていません。
AI の記事が「つまらない」と言われる理由
これまでの議論と調査
- 作り方より中身: Google 検索は 2023 年 2 月のガイダンスで、「コンテンツがどのように制作されたかではなく、その品質に重点を置く」と書いています。コンテンツの作り方の説明のページでは、品質の目安の E-E-A-T に「エクスペリエンス」(実体験)が入り、作った目的について「『なぜ』はおそらく、コンテンツに関して答えるべき最も重要な質問です」とも書いています。
- 似てくる: Doshi と Hauser の実験(2024 年・書き手 293 人、評価は別の 600 人)では、AI の案を見て書いた短い話は、1 本ずつの新しさの評価が上がりました(案 5 つで 8.1%)。一方で、話どうしは似ていきました。
- 同じ言葉が増える: Kobak らは、2024 年の生物医学の論文の抄録の少なくとも 13.5% に、大規模言語モデルの手が入ったと見積もりました。「delves」は、2021〜2022 年から見込んだ頻度の 28 倍でした。
- 見分けの手がかり: Wikipedia の編集者がまとめた「Signs of AI writing」は、大げさな重要さ・宣伝のような言葉・3 つ並べ・課題と展望でしめる段落などを挙げます。ただし、ページ自身が「規則ではなく観察」と断っています。
- 読み手の受け止め: Reuters Institute の 2025 年の調査(日本を含む 6 か国)では、6 か国の平均で、AI だけで作ったニュースに抵抗がない人は 12%、人だけで作ったニュースは 62% でした。日本とアルゼンチンの回答は、ほかの 4 か国より生成 AI に前向きな傾向でした。
- 「AI が作った」と書くと信頼が下がる: Toff と Simon の実験では、「AI が作った」と書いた記事は、正確さは下がって見えないのに、信頼が下がりました。使った出典を並べると、下がり方はおおむね打ち消されました。
- 実際の騒ぎ: 2023 年 1 月、CNET は AI で書いた 77 本のうち 41 本に訂正を入れました。
- 日本の報道機関の見方: 日本新聞協会は 2023 年 5 月の見解で、「筆者も内容も不確かな記事」が検索結果の上位を占める現象がすでに起きていると書き、無秩序な開発が進めば AI がこれを助長する懸念がある、としています。
編集部の記録から見えたこと
数字は増え、書き手の声は 0 回のまま。本文 1,000 字あたりの数字は、公開時の入門の記事で 8.2 個、比べる記事と映像の記事で 46.1 個でした。驚きや感想の言葉(「意外」「驚」「面白」「と思う」など 14 の言い方)は、95 本で 13 回出ました。ただ、どれも公式の説明・絵の説明・プロンプトの文などの中で、書き手自身の言葉としては 0 回です。代わりに「見立て」が 24 本で 74 回あり、うち 72 回は「編集部の見立て」です。決まりで、見立ては数えた結果と分けて書くことにしているためです。
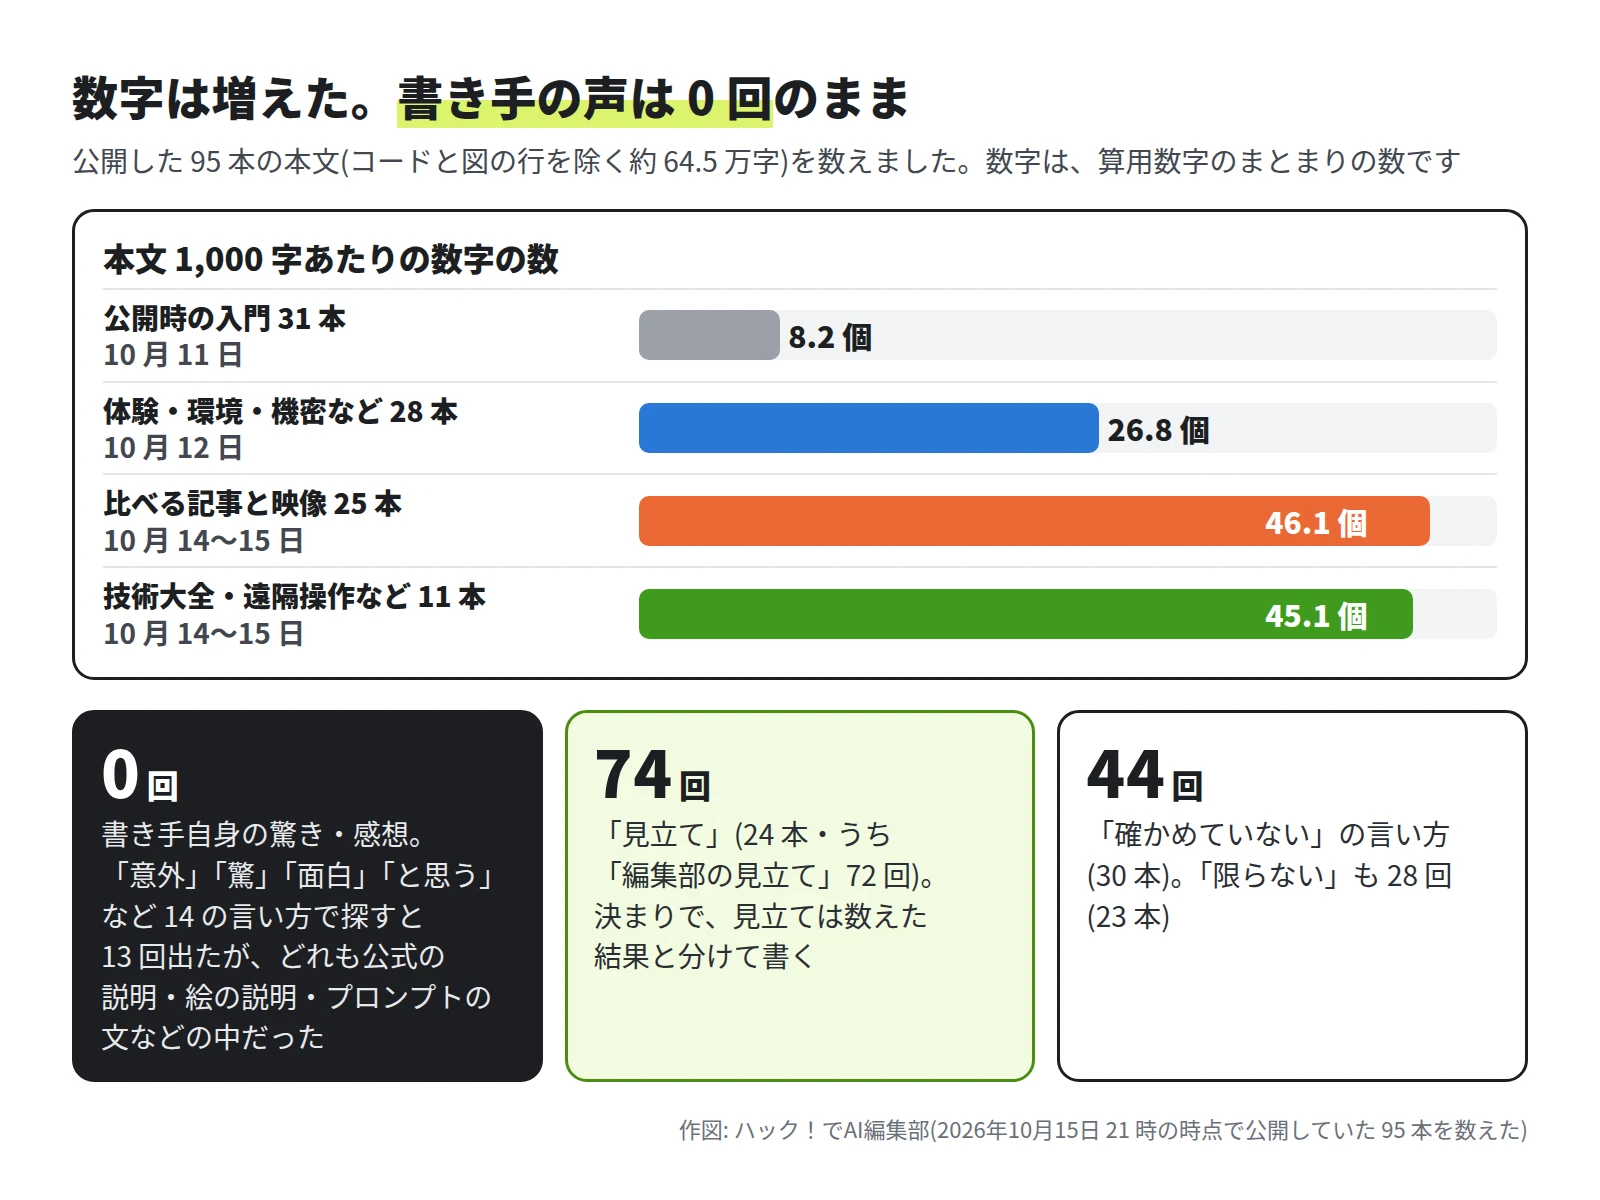
「で、どれがいい?」との間。決まりでは、1〜2 項目の差で順位を付けません。校閲はこの型を 15 本で 40 件直しました。読み手が知りたいのは「で、どれがいい?」なのに、記事の答えは「お題ごとに向き不向きがある」になりがちです。正確さを守る代わりに、はっきりした答えを出しにくくしている面があります(編集部の見立て)。
編集長の題は、問いの形が多い。
| 題を書いた人 | 本数 | 「?」がある | 「?!」がある | 数字がある |
|---|---|---|---|---|
| 編集長 | 6 本 | 5 本 | 3 本 | 0 本 |
| AI | 89 本 | 32 本 | 1 本 | 29 本 |
AI の題で「?!」があるのは、編集長の言い方(VFX映像はつくれる?!)を借りた 1 本だけです。AI の題には、「同じ看板を 5 つのモデルに描かせて比べた」のように中身を先に言う物が目立ちます(数えてはいません)。検索で探す人には合いますが、知らないことに気づかせる形ではありません。Loewenstein は 1994 年の論文で、好奇心を、自分の知識の隙間に気づいたときに生まれるものと説明しました。編集長の「アプリしかないあのサービスも遠隔で見られるかも」は、その隙間を残す題です(編集部の見立て)。
小さな試し: 決まりなしで書かせたリードと比べる
やり方
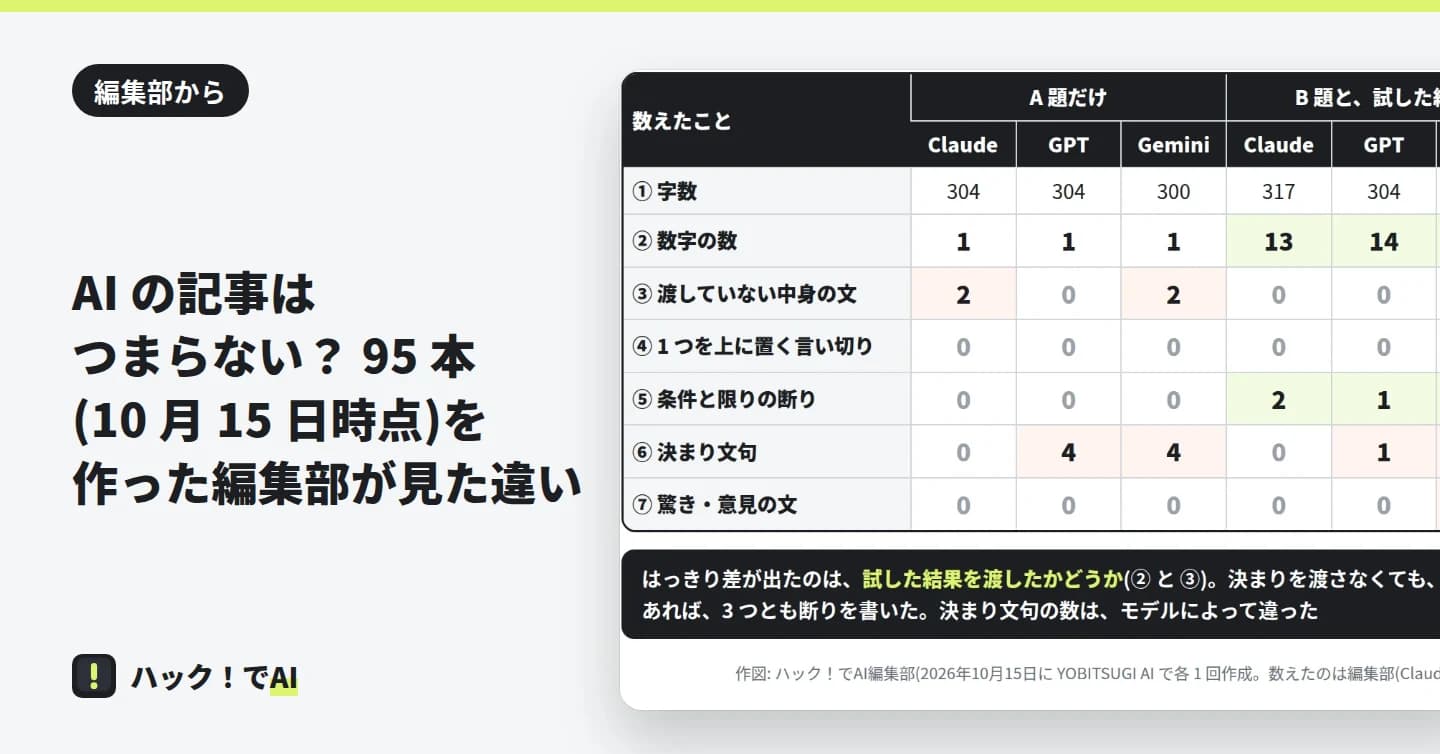
同じ題のリード(記事の最初の段落)を 3 通り並べ、作る前に決めた 7 項目で数えました。題は、連載「同じお題で AI を比べる」の第 1 回日本語の文字が崩れない画像生成 AI はどれ?です。
- A 題だけ: 決まりを何も渡さず、題だけで書かせた。
- B 題と結果: 決まりは渡さず、題と、編集部が試した結果(公開した記事の結論と同じ事実)を渡した。
- C 公開: 編集部の決まりで書き、校閲を通して公開したリード。
A と B は、Claude Opus 5.5・GPT-6 Astra・Gemini 3.1 Pro(記録の名前は gemini-3.1-pro-preview)に、同じ文を各 1 回渡しました。作り直しはしていません。6 本で 18.4 クレジット、1 本 8.4〜11.8 秒でした。A に渡した文は次のとおりです(B に渡した文は下の補足に全文)。
次の題の Web 記事の、最初の段落(リード)を日本語で 300 字くらいで書いてください。段落だけを出力してください。

題: 日本語の文字が崩れない画像生成 AI はどれ? 同じ看板を 5 つのモデルに描かせて比べた
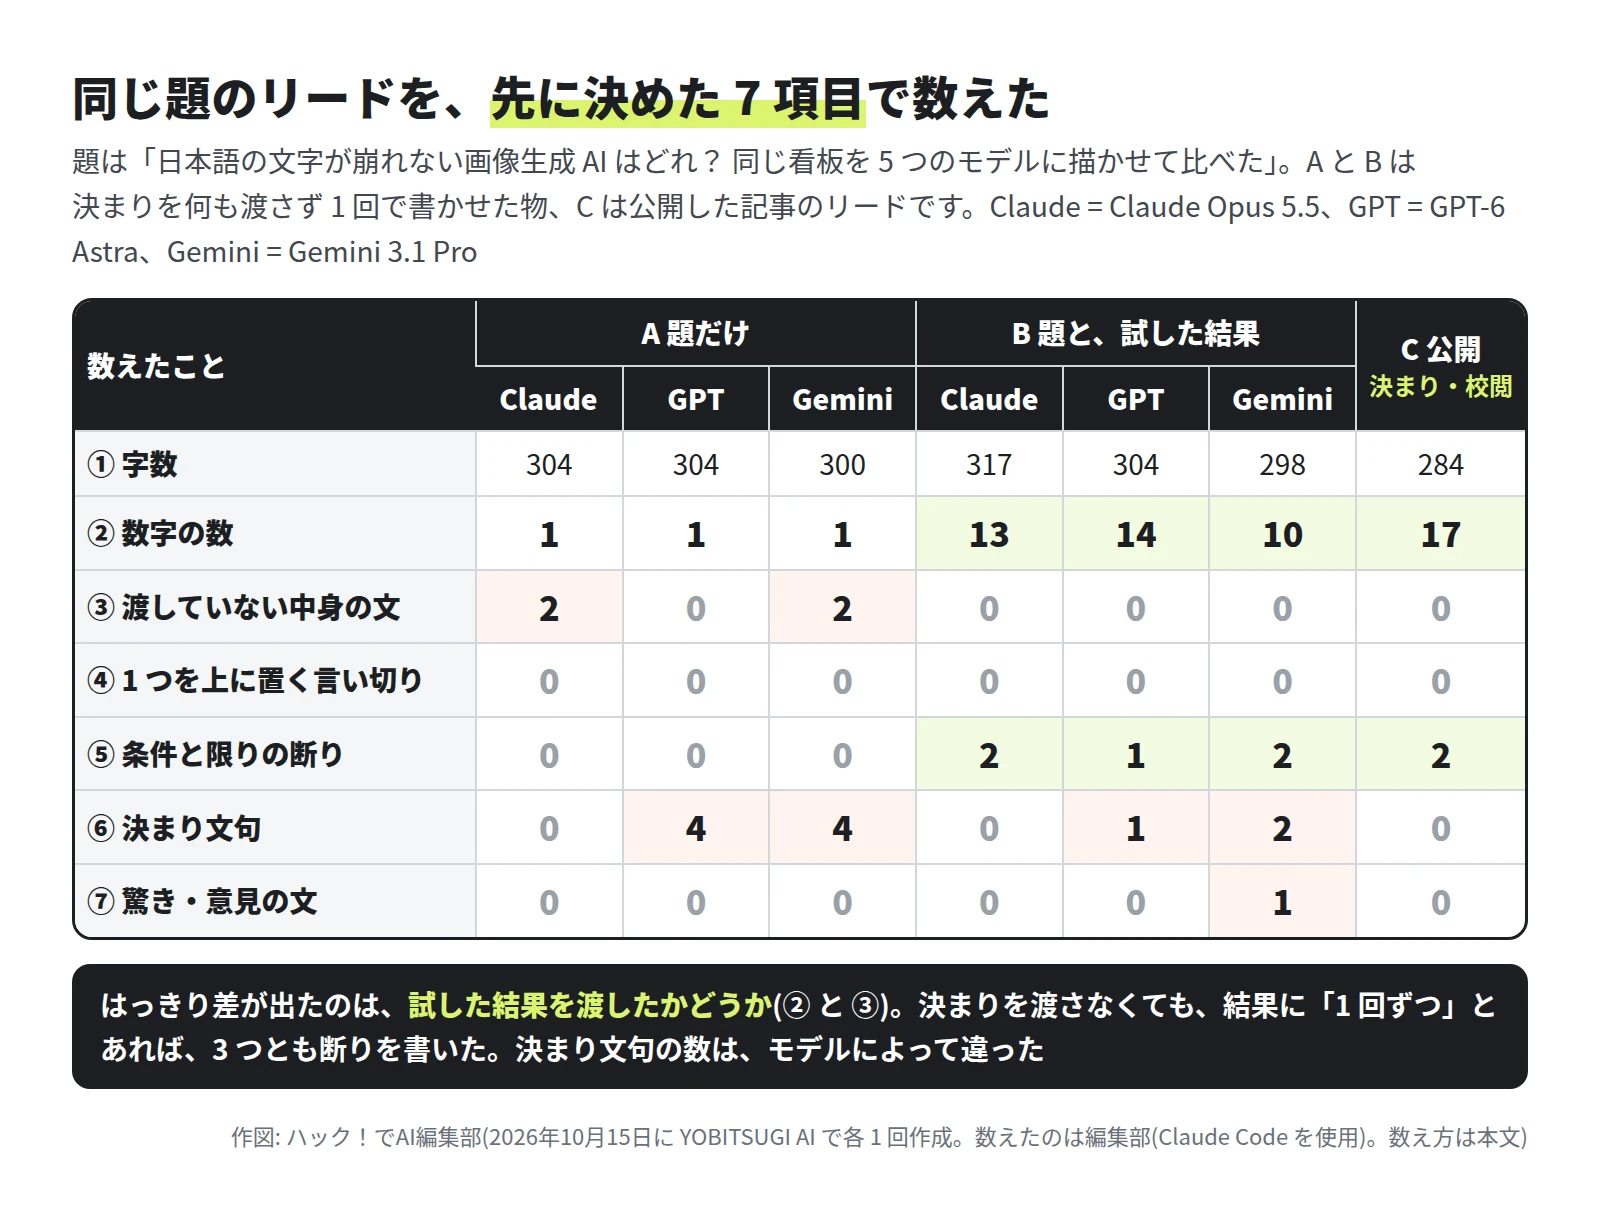
数えた 7 項目は、① 字数(空白を除く)② 数字の数(モデルの名前の中の数字も数える)③ 渡していない中身を事実のように書いた文 ④ 1 つを上に置く言い切り ⑤ 条件と限りの断り ⑥ 決まり文句 ⑦ 驚き・意見の文、です。⑥ は先に決めた一覧(近年・昨今・注目・話題・徹底・完全・最強・圧倒的・さまざまな・多くの人・「本記事では」の予告・「〜でしょうか」「〜ませんか」の問いかけ など)に合う物だけを数えました。数えたのは編集部(Claude Code を使用)です。③ は、作る前の計画では「データが無いのに結果として書いた文」でした。数えるときに、していない検証や画像をあるように書いた文も入れています(A の Gemini の 2 文)。計画どおり結果の文だけを数えると、A の Claude の 1 文だけです。
数えて分かったこと
- 渡していない中身を書いたのは A の 2 本です。Claude は、架空の看板「ラーメン 味自慢」を描かせて比べたと書き、「想像以上に大きな差が出た」と結びました。Gemini は「徹底検証しました」「実際の生成画像とともに詳しく解説します」と書きました。どちらも、渡した文には無い中身です。
- 数字は、A は 3 本とも題の「5」だけでした。B は 10〜14 個、C は 17 個です。
- B の 3 本は、決まりを渡していないのに「1 回ずつ」や解像度の違いを書きました。渡した結果に「1 回ずつ」とあったためと見ています。ただし Gemini は「1回限りの一発勝負」と、限りではなく見どころとして書いています。
- 決まり文句は、Claude が A・B とも 0 でした。GPT と Gemini は、A で 4 ずつ、B で 1 と 2 です。
- 1 つを上に置く言い切りは、7 本とも 0 でした。
7 項目の外で、あとから気づいたこともあります。GPT の A は、ダッシュ 2 字のあとに問いかける書き出しでした。B の Gemini は、渡していない「最新」と、記録より強い「数字以外はほぼ全滅」(実際は「月」も正しく描けていた)を書きました。一覧にない言い方(「人も多いだろう」「進化は目覚ましい」「気になるところ」)は、数に入っていません。
A の Claude の「ラーメン 味自慢」のような具体的な名前や、B の Gemini の「なんと」「驚きの精度」は、編集部の決まりと校閲が外す種類の言い方です。前者は作り話で、後者は記録より強い言い方だからです。こうした言い方を外したあとに、何で読み手を先へ引っぱるかは、まだ答えが出ていません。今回の試しは 1 つの題・各 1 回です。どのリードが面白いかの判定はしておらず、読み手の評価も取っていません。
B に渡した文(全文)
次の題の Web 記事の、最初の段落(リード)を日本語で 300 字くらいで書いてください。段落だけを出力してください。下の「結果」は、編集部が実際に試した記録です。

題: 日本語の文字が崩れない画像生成 AI はどれ? 同じ看板を 5 つのモデルに描かせて比べた

結果:
- お題は 4 つ(短い店名・5 行のメニュー・日付と時刻の入った案内・ひらがなの手書きの黒板)。指定した字は合わせて 118 字。
- GPT-Image-2.5 Sunburst・Nano Banana Pro・Nano Banana 2.1・Grok Imagine 2.0 の 4 つは、118 字すべてを正しく描いた。
- Gen-4 Image が正しく描いたのは 23 字(数字 22 字と「月」の 1 字)。Gen-4 Image だけ 720×720 画素で、ほかの 4 つは 1024×1024 画素。
- Grok Imagine 2.0 は、4 枚のうち 2 枚で、頼んだ文の中のかぎかっこも看板に描いた。
- 1 枚の料金は、2.4 クレジット(GPT-Image-2.5 Sunburst)から 24.3 クレジット(Nano Banana Pro)まで。
- どれも 1 回ずつ作った結果。
A 題だけで書かせたリード(3 本の全文)
Claude Opus 5.5(2.6 クレジット・8.4 秒)
画像生成AIの進化で、写真と見分けがつかないほどの絵を誰でも数秒で作れるようになった。ところが、看板やポスターに日本語を入れようとすると話は別だ。ひらがなが見たことのない記号に化けたり、漢字の画数が足りなかったりと、「それっぽいけれど読めない」文字が出てきてがっかりした経験のある人も多いだろう。英語ならきれいに描けるのに、なぜ日本語は苦手なのか。そして、最新のモデルはどこまで改善しているのか。そこで今回は、商店街にある「ラーメン 味自慢」の看板を描くという同じ指示を、主要な5つの画像生成AIに与え、文字の正確さや自然さ、デザインとしての完成度を比べてみた。結果は、モデルによって想像以上に大きな差が出た。
GPT-6 Astra(3.5 クレジット・10.5 秒。原文のダッシュ 2 字は、サイトの決まりで〔ダッシュ 2 字〕と置き換えて載せています)
写真のようにリアルな街並みは描けるのに、看板の日本語はどこかおかしい〔ダッシュ 2 字〕。画像生成AIを使っていて、そんな「あと一歩」に悩んだことはありませんか。漢字の画数が増えたり、ひらがなが別の形になったりすると、雰囲気のよい画像も、そのままでは使いづらくなります。では、日本語の文字を正しく描くのが得意なモデルはどれなのでしょうか。本記事では、5つの画像生成AIに同じ文言の看板を描かせ、文字の正確さや読みやすさ、デザインとの調和を比較します。ぱっと見の美しさだけでは気づきにくい誤字や文字の欠落にも注目。看板やポスターなど、文字を含む画像づくりに役立つモデル選びのポイントと、生成結果を確認する際の注意点を探ります。
Gemini 3.1 Pro(2.4 クレジット・11.3 秒)
画像生成AIの進化は目覚ましいものの、多くのユーザーが直面する課題が「文字の崩れ」です。特に日本語の描画は難易度が高く、看板やポスターの画像を生成しようとすると、意味不明な象形文字のようになってしまうことが少なくありません。しかし最近では、日本語を正確に描写できると謳うモデルも登場し始めています。そこで本記事では、「結局、日本語の文字が崩れないAIはどれなのか」を徹底検証しました。話題の画像生成AIを5つピックアップし、まったく同じプロンプトで「日本語の看板」を描かせて比較します。果たして、最も自然で正確な日本語を出力できたのはどのモデルなのでしょうか? 実際の生成画像とともに詳しく解説します。
B 題と結果を渡して書かせたリード(3 本の全文)
Claude Opus 5.5(3.3 クレジット・9 秒)
看板やポスターを画像生成 AI に作らせると、日本語の文字が崩れることがあります。そこで編集部は、短い店名、5 行のメニュー、日付と時刻の入った案内、ひらがなの手書きの黒板という 4 つのお題で、5 つのモデルに同じ看板を描かせました。指定した 118 字をすべて正しく描いたのは、GPT-Image-2.5 Sunburst、Nano Banana Pro、Nano Banana 2.1、Grok Imagine 2.0 の 4 つです。Gen-4 Image は数字を中心に 23 字にとどまりましたが、このモデルだけ解像度が低い条件でした。また、どのモデルも 1 回ずつ作った結果です。1 枚の料金は最大で約 10 倍の差があり、指示文のかぎかっこまで描いてしまう例もありました。
GPT-6 Astra(3.9 クレジット・9.7 秒)
「画像生成AIは日本語が苦手」は、今も当てはまるのでしょうか。編集部では5つのモデルに同じ条件で看板を描かせ、短い店名、5行のメニュー、日時入りの案内、ひらがなの手書き黒板という4つのお題で比べました。指定した計118字は、4モデルがすべて正しく描画。一方、Gen-4 Imageは数字22字と「月」の計23字にとどまりました。ただし、同モデルだけ解像度が低く、生成も各お題1回ずつのため、これだけで性能を断定はできません。Grok Imagine 2.0が2枚で不要なかぎかっこまで描いた点や、1枚2.4〜24.3クレジットという料金差も気になるところ。文字の正確さに加え、指示への忠実さやコストも見ていきます。
Gemini 3.1 Pro(2.8 クレジット・11.8 秒)
画像生成AIで「日本語の文字」を正しく描けるモデルはどれか。本記事では、5つの最新モデルを対象に、短い店名や5行のメニュー、日時入りの案内、ひらがなの手書き黒板という4つの看板を描かせるテストを実施しました。指定した文字数は計118字。すべて1回限りの一発勝負で検証した結果、なんと4つのモデルが118字すべてを正確に出力するという驚きの精度を見せました。一方で、数字以外はほぼ全滅だったモデルや、指示文の「かぎかっこ」まで律儀に描いてしまうモデルなど、それぞれの個性も浮き彫りに。1枚あたり2.4から24.3クレジットというコストの差や、出力解像度の違いも含め、各モデルの実力を徹底比較します。
C 公開した記事のリード(全文)
AI で画像を作ると、看板やメニューの日本語が読めない字になることがあります。そこで、同じ看板のお題を 5 つの画像生成 AI に同じ文で頼み、指定した字が正しく描けたかを 1 字ずつ数えました。今回の 1 回ずつの結果では、GPT-Image-2.5 Sunburst・Nano Banana Pro・Nano Banana 2.1・Grok Imagine 2.0 の 4 つが、4 つのお題の 118 字をすべて正しく描きました。Gen-4 Image は 23 字で、正しく読めたのは数字と「月」だけでした。ただし、Gen-4 Image だけは 720×720 画素(ほかの 4 つは 1024×1024 画素)での結果です。
これから
次に試すこと
- 体験を人から受け取る: 95 本の多くは、AI が自分で試せる物(画像や動画を作らせて数える・文章を比べる)でした。人の失敗談や迷いは、記録に残っていない限り書けません。編集長の体験を聞き取って書く記事も準備しています。
- 絵を中心にした雑誌: 今までの記事の中身を、絵を中心に、人が読むための雑誌「THE AI」にまとめ直しました(編集日記と PDF)。
- 試しの続き: 今回は 1 つの題・各 1 回でした。題の数を増やすこと、読み手がどのリードを読み進めたかを測る方法は、まだ決めていません。
人が受け持ち続けること
- 何を書くかを選ぶ(お題と題)。
- 載せてよいかの線を引く(公開前の音声を使ってよいか・過激な映像の記事でどこまで載せるか)。
- 体験と意見を出す(うまくいかなかったことも含めて)。
まだ分からないこと
- 読み手が面白いと感じたかどうか。
- 決まりが、読み手の感じる面白さにどう効いているのか。試しでは、数字と断りの数は「結果を渡したか」で大きく変わり、B と C の差は小さめでした。
- 校閲が見落とした誤りの数。公開のあとに直した記事は、今回は数えていません。
まとめ
- 10 月 15 日 21 時までの 5 日で 95 本を AI が書き、仕様書に残る人の発言は 23 回でした。人は主に「何を書くか」と「どこまで載せるか」を決めています。
- AI の校閲は、15 本で 231 件を直しました。多いのは、1〜2 項目の差で順位を付ける型と、後から決めた数え方を書かない型です。
- 題だけで書かせると、AI は渡していない中身を事実のように書くことがありました。数字と断りの数は、主に「試した結果を渡したか」で変わりました(今回の 1 回では)。
参考にした公式の情報
- Google 検索セントラル ブログ「AI 生成コンテンツに関する Google 検索のガイダンス」(2023年2月8日)
- Google 検索セントラル「有用で信頼性の高い、ユーザーを第一に考えたコンテンツの作成」
- Doshi, Hauser「Generative AI enhances individual creativity but reduces the collective diversity of novel content」(Science Advances, 2024・PMC 版)
- Kobak ほか「Delving into LLM-assisted writing in biomedical publications through excess vocabulary」(Science Advances, 2025・PMC 版)
- Wikipedia「Wikipedia:Signs of AI writing」(WikiProject AI Cleanup)
- Reuters Institute「Generative AI and news report 2025」(2025年10月7日)
- Toff, Simon「"Or They Could Just Not Use It?": The Dilemma of AI Disclosure for Audience Trust in News」(The International Journal of Press/Politics, 2024)
- The Verge「CNET found errors in more than half of its AI-written stories」(2023年1月25日)
- 日本新聞協会「生成 AI による報道コンテンツ利用をめぐる見解」(2023年5月17日)
- Loewenstein「The Psychology of Curiosity: A Review and Reinterpretation」(Psychological Bulletin, 1994)
- YOBITSUGI AI「料金」
- Claude Code ドキュメント「Overview」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。