AIを動かす環境とコスト 第10回
動画生成はサーバースペックが命。GPU vs API
 佐々木 航
この記事でわかること
- 5 秒の動画を作る秒数。CPU・家庭用 GPU・A100・API
- 6 本まとめて作るとき、A100 の枚数で秒数がどう変わるか
- 1 本あたりの電力量と電気代、API の料金
確認した環境: Wan 2.2(ComfyUI 0.39.0・0.40.0)/ CPU のみ・RTX 5060 Ti 8GB・A100 40GB で計測 / 2026年10月14日〜15日に確認
動画を作る AI は、インターネット越しに頼む API(窓口)で使う方法と、GPU(画像の計算に強い部品)のある機械を用意してモデルを動かす方法があります。編集部は、同じモデルを「GPU のないサーバー」「家庭用 GPU の PC」「A100 のサーバー」で動かし、API の動画生成 3 種にも同じ画像と文を渡して、時間・電気・料金を測りました。同じ 5 秒の動画(画像から)は、家庭用 GPU で 137.7 秒、A100 1 枚で 50.2 秒、API 3 種で 33.5〜151.5 秒でした。GPU のないサーバーは、本番の大きさの文章から動画を作る種目で、1 ステップ目が約 54 分たっても終わらず中止しました。
結果の早見
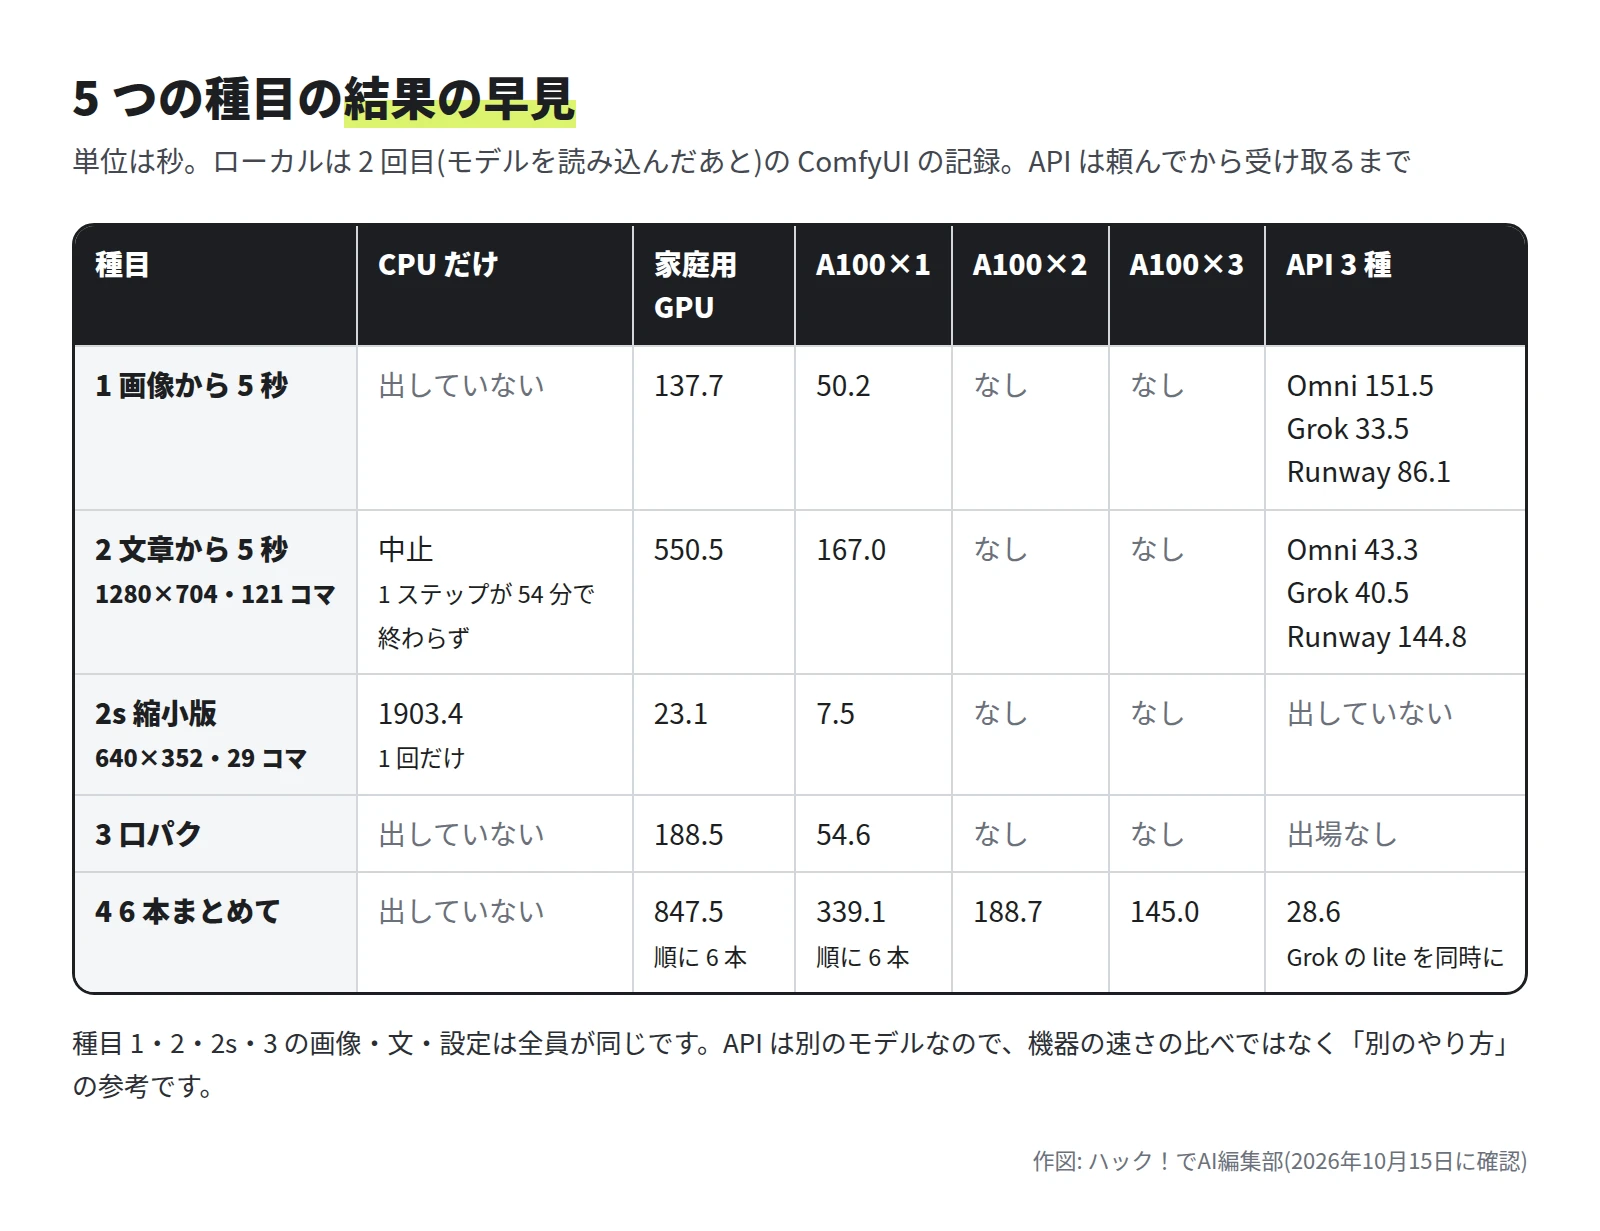
- 機器の速さを比べたのは、同じモデル(Wan 2.2)で動かした 3 者です。A100 1 枚は家庭用 GPU より、2 回目の秒数で約 2.7〜3.5 倍速く終わりました。
- API は別のモデルです。機器の差ではなく「別のやり方」として、時間・料金・できることで見ます。
- 6 本まとめては、A100 を 1 枚から 3 枚に増やすと、339.1 秒から 145.0 秒になりました。
- 電気代は、GPU の分だけなら 1 本 1 円に届きませんでした。
動画づくりに GPU とメモリが要る理由
文章や画像から動画を作るモデルは、次の順に動きます。
- 文と画像を、計算できる数字にします。
- 絵の素になるデータを、何回かくり返して磨きます。この回数が「ステップ」で、いちばん重い処理です。
- 磨いたデータを、VAE(圧縮したデータを絵に戻す部品)でコマに戻します。
- コマをまとめて動画のファイルにします。
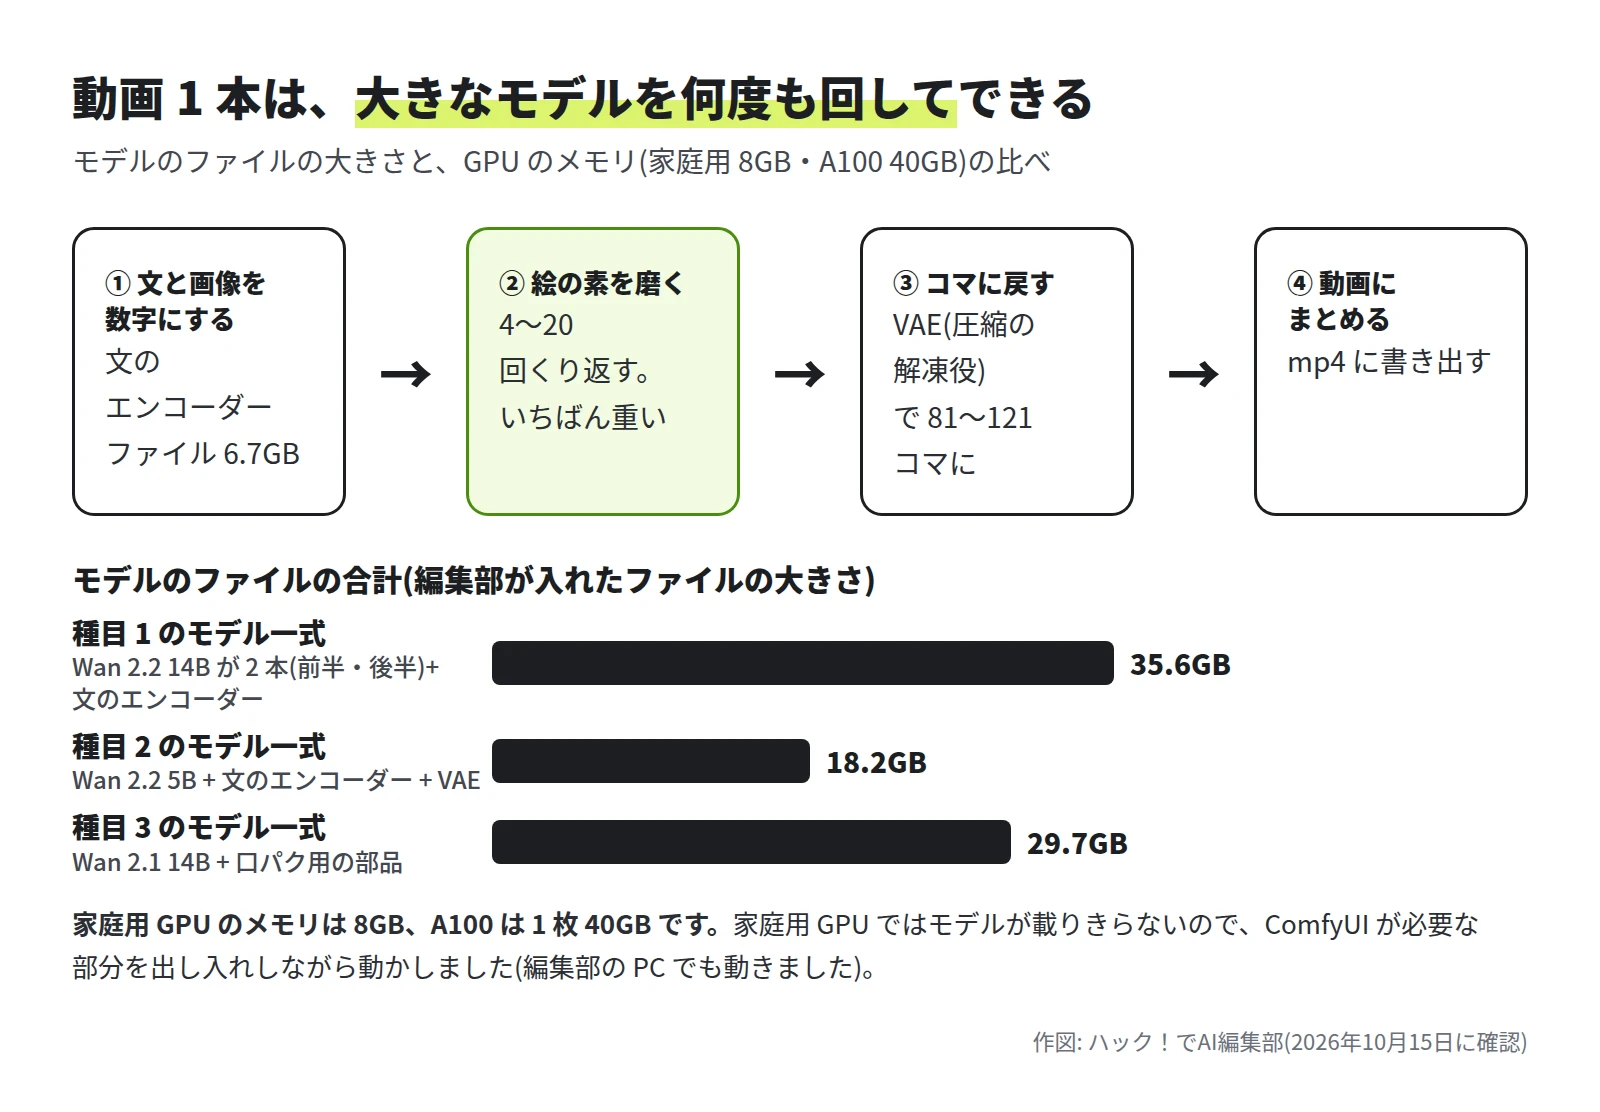
今回は、オープンなモデルの Wan 2.2 を使いました。公式の GitHub には、Apache 2.0 のライセンスで公開されていること、14B(140 億個の数値を持つ大きさ)の動画モデルは「前半を受け持つモデル」と「後半で細部を整えるモデル」の 2 つを使うこと、5B の小さいモデルは 720p・24 コマ/秒の動画を作れることが書かれています。
メモリの目安も公式にあります。GitHub の手順どおりに 1 枚の GPU で動かす場合、14B は 80GB 以上、5B は 24GB 以上の GPU とされています。一方、ComfyUI(画面でつなぎ合わせて AI を動かす道具)の公式ドキュメントには、5B は 8GB のメモリでも動く、という説明があります。編集部は、数値を小さくした版(fp8)で、14B も 8GB の家庭用 GPU で動かせました。載りきらない分は出し入れしながら動くので、そのぶん時間がかかります。
14B の画像から動画のモデルには、4 ステップで済ませるための追加のデータ(LoRA)を入れました。種目 2 の 5B は 20 ステップです。
出場した機器と API
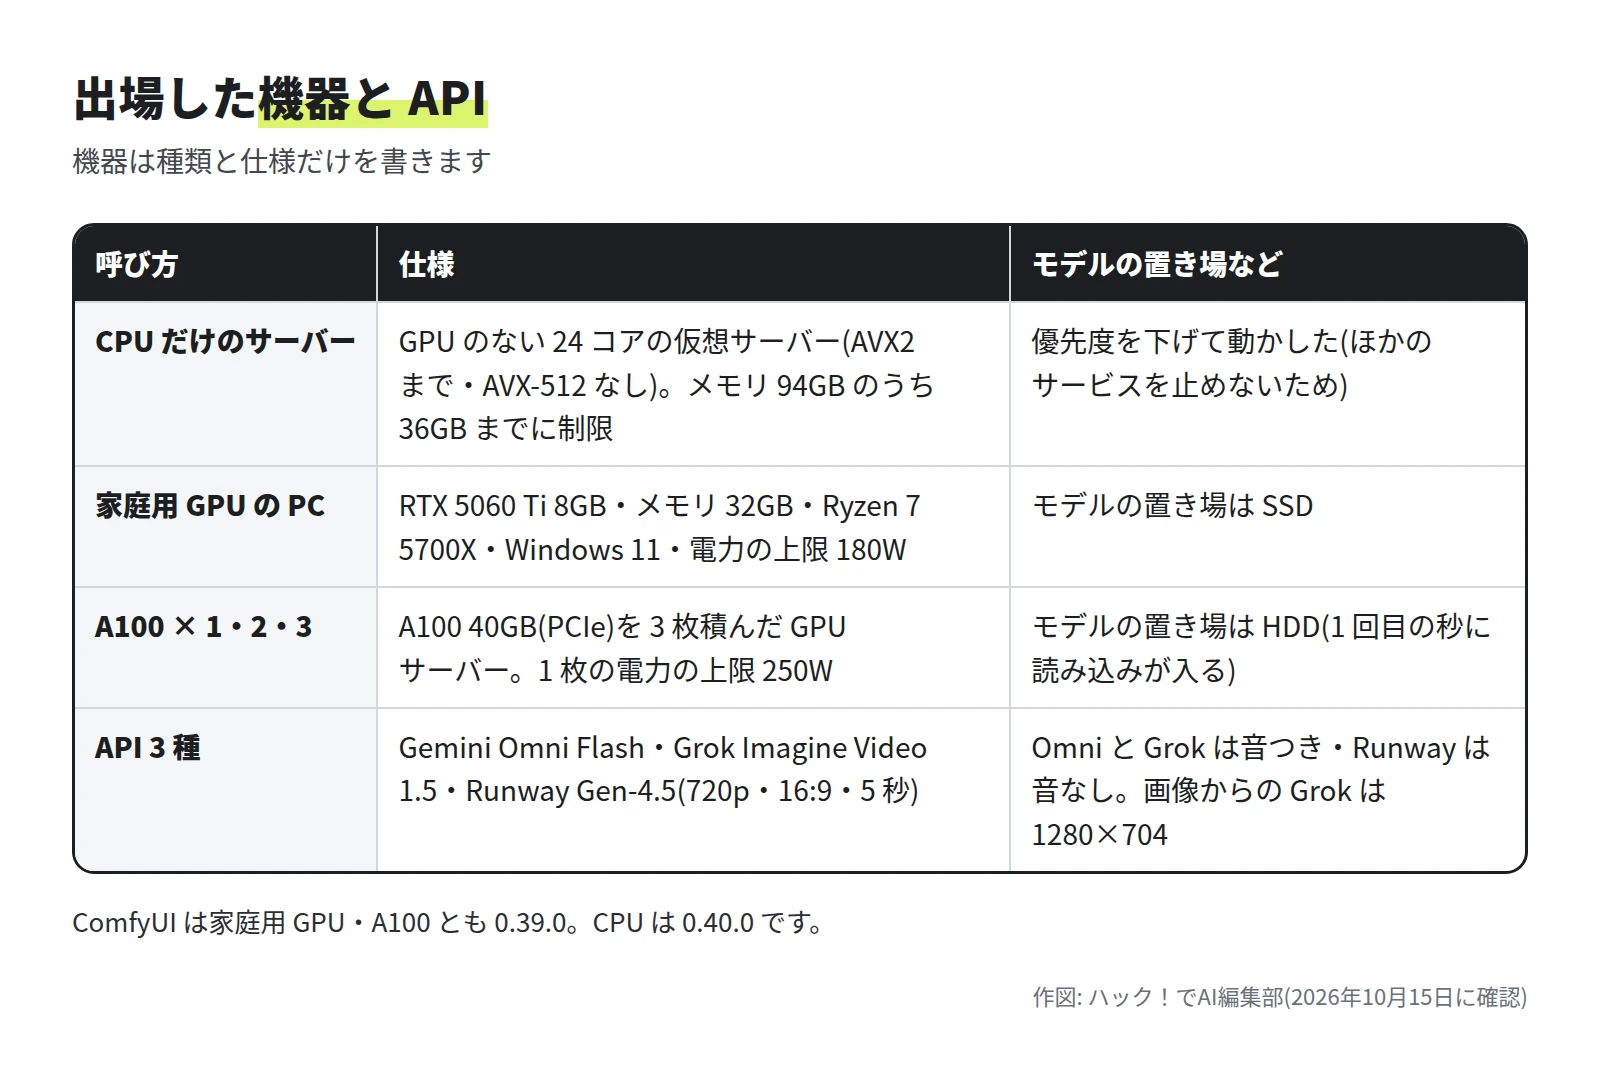
CPU だけのサーバーは、ほかのサービスも動いているので、メモリを 36GB までに制限し、優先度を下げて動かしました。消費電力の上限は、RTX 5060 Ti が 180W(NVIDIA の仕様表)、A100 が 1 枚 250W(nvidia-smi の表示)です。A100 は 1 枚・2 枚・3 枚の 3 通りで測りました。
測る前に決めた 5 つの種目です。
| 種目 | 中身 | 出場 |
|---|---|---|
| 1 | 画像から 5 秒の動画(832×480・81 コマ・16 コマ/秒) | 家庭用 GPU・A100×1・API 3 種 |
| 2 | 文章から 5 秒の動画(1280×704・121 コマ・24 コマ/秒・20 ステップ) | CPU・家庭用 GPU・A100×1・API 3 種 |
| 3 | 口パク(同じ顔の絵と同じ音声。480×832・81 コマ) | 家庭用 GPU・A100×1 |
| 4 | 種目 1 を 6 本まとめて | 家庭用 GPU・A100×1・×2・×3・API |
| 5 | 1 本あたりの電気とお金 | 家庭用 GPU・A100・API |
種目 1 を CPU だけのサーバーに出さなかったのは、14B のモデルを 2 つ読むとメモリが足りず、ほかの処理を止める恐れがあるためです。
時間は ComfyUI の記録(処理の開始から成功まで)の秒数です。ローカルは、種目ごとにモデルを手放してから、1 回目(種 1・モデルの読み込みを含む)、2 回目(種 2・読み込み済み)の順に流しました。種目 4 の種は 11〜16(A100 の 2 枚は 21〜26、3 枚は 31〜36)です。同じ種を続けると前の結果が使い回されるため、種目 1 とは別の種にしました。
種目 1: 画像から 5 秒の動画
入力は、編集部が作った架空の灯台の絵です(YOBITSUGI AI の Gemini の画像生成で作成)。文は次のとおり、全員に同じものを渡しました。
The waves roll against the rocks and the sea surface shimmers in the sunset light. Clouds drift slowly and a few seagulls fly across the sky. The camera stays still.
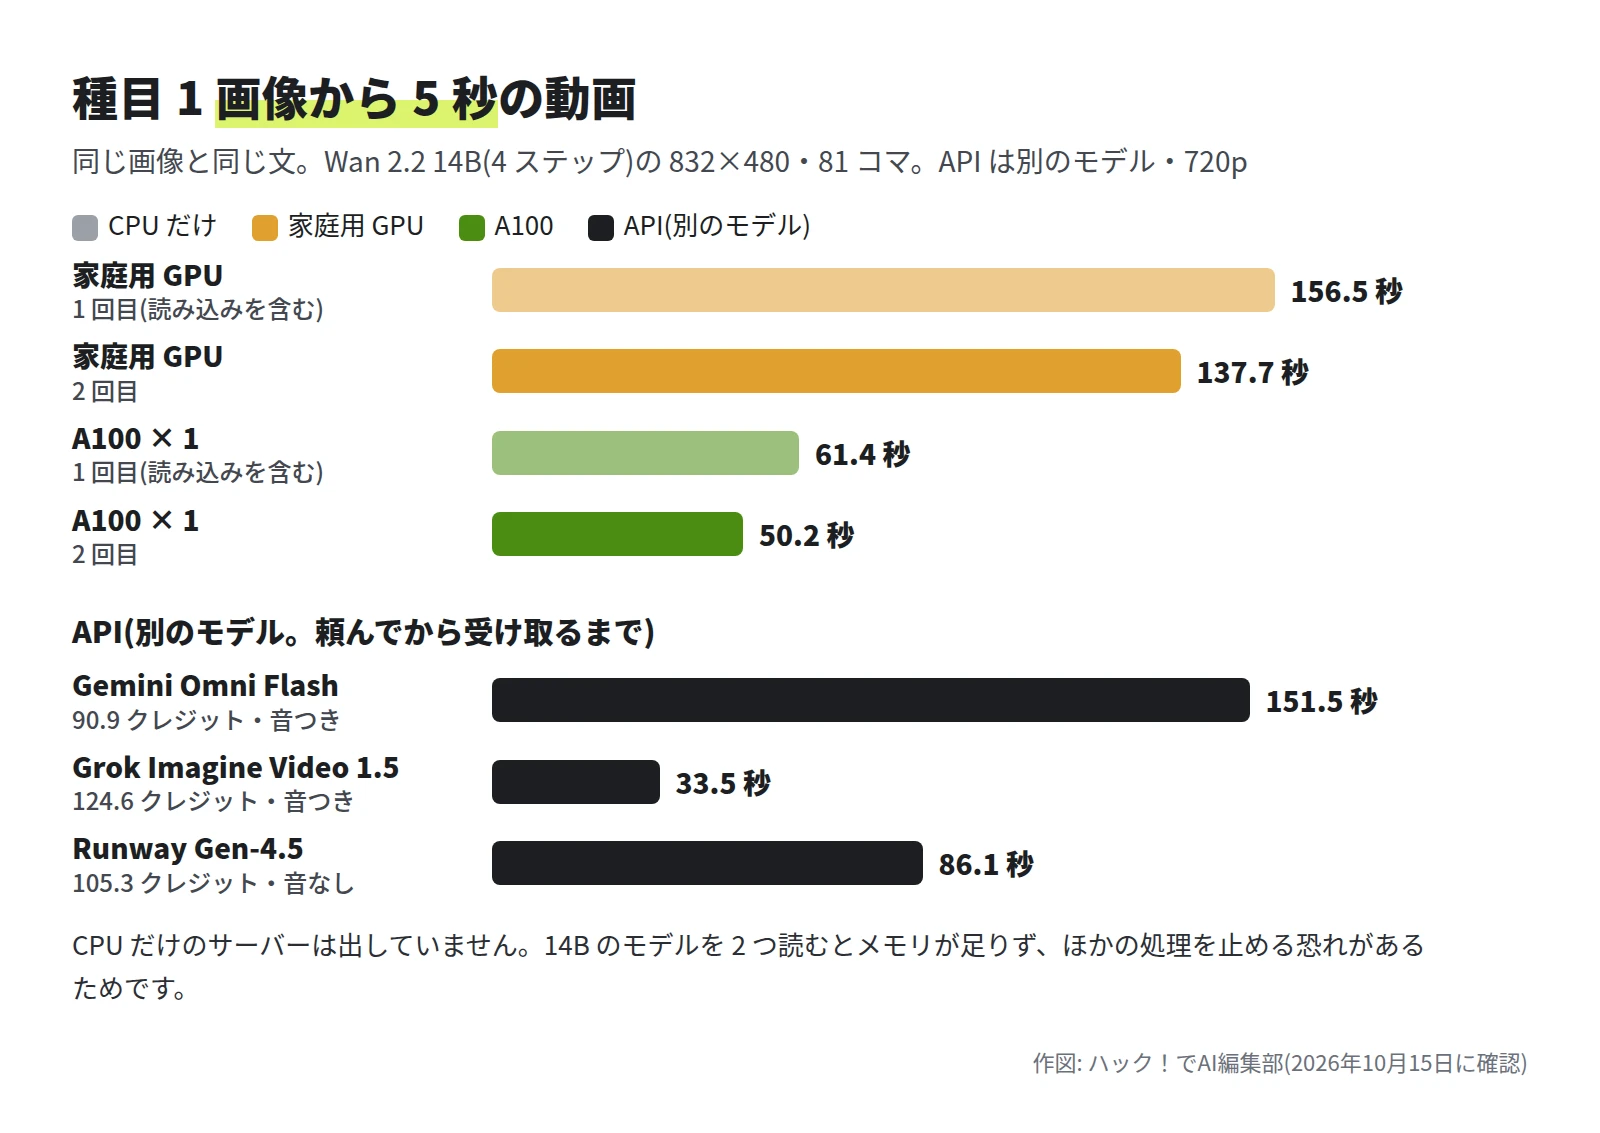
同じモデルの 3 者で見ると、2 回目は家庭用 GPU が 137.7 秒、A100 1 枚が 50.2 秒で、A100 が約 2.7 倍の速さです。1 回目と 2 回目の差は、家庭用 GPU が 18.8 秒、A100 が 11.2 秒でした。モデルの置き場は A100 が HDD、家庭用 GPU が SSD ですが、差の原因が置き場だけかは言い切れません。
API の 3 種は 1 回ずつの結果で、秒数の順位は目安です。米ドルでは Omni が 0.518、Grok が 0.710、Runway が 0.600 でした。出てきた動画の条件も違います。Omni と Grok は音つき、Runway は音なしで、長さは 5.01〜5.04 秒でした。Grok だけは入力の絵の比率に合わせて 1280×704、ほかの 2 つは 1280×720 でした。
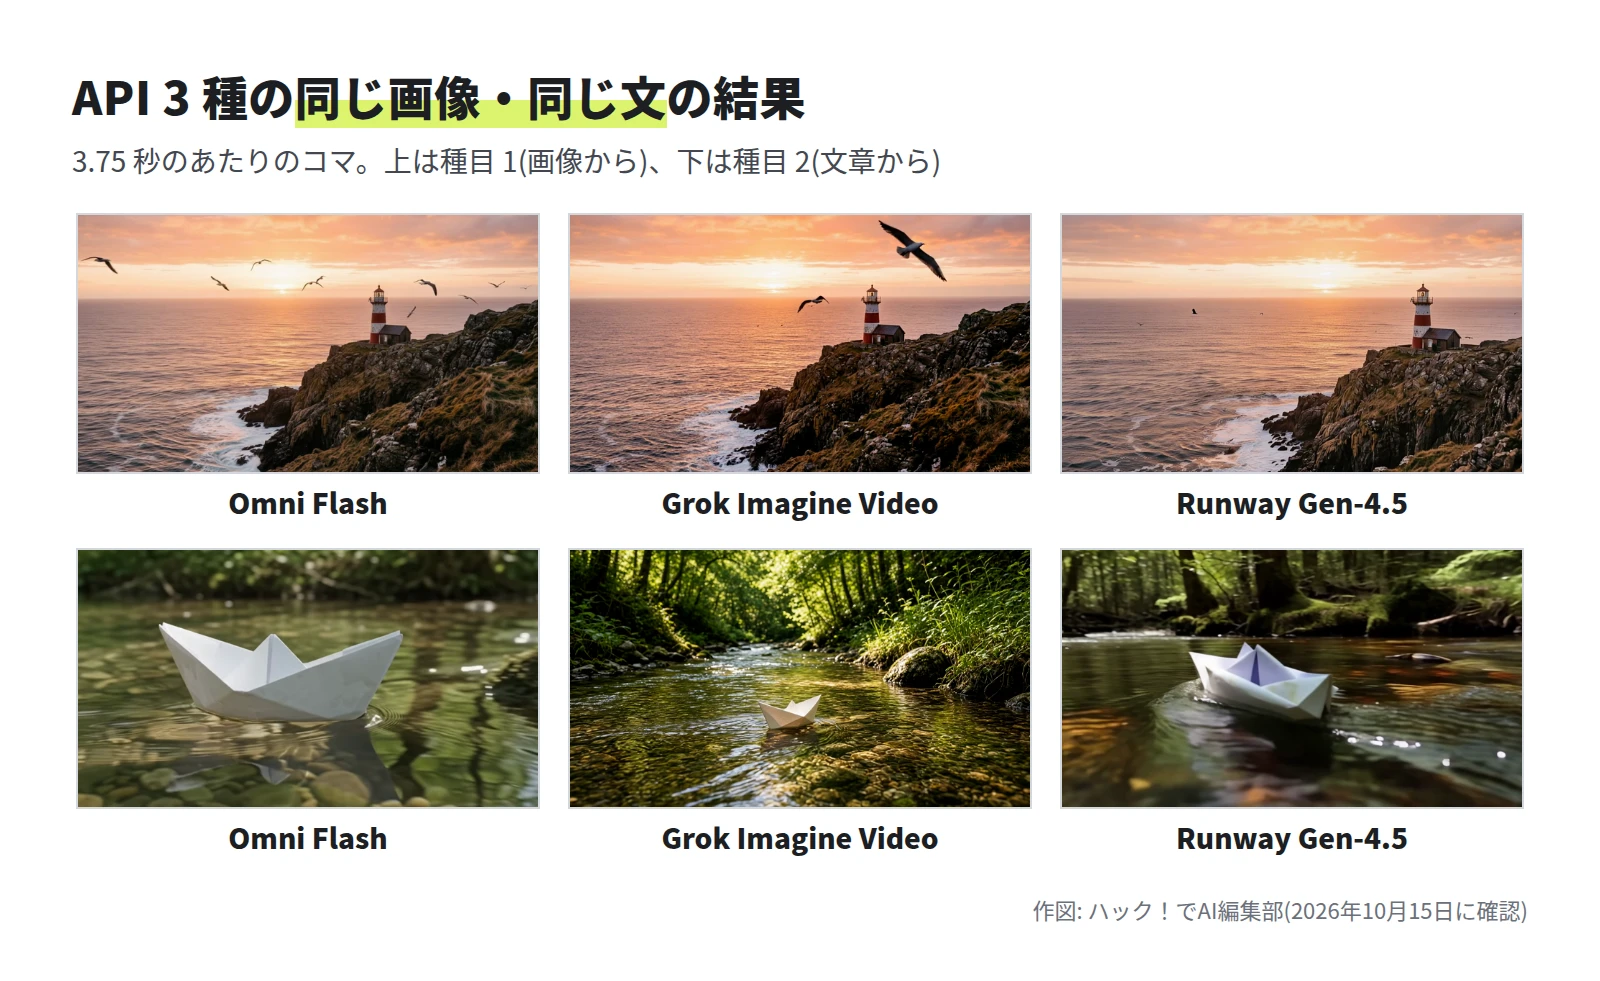
種目 1 の動画(同じ絵と同じ文から)
種目 2: 文章から 5 秒の動画
文は次のとおりです。
A small paper boat floats down a clear stream through a green forest. Sunlight comes through the leaves and the water ripples around the boat. The camera slowly follows the boat. No people, no text.
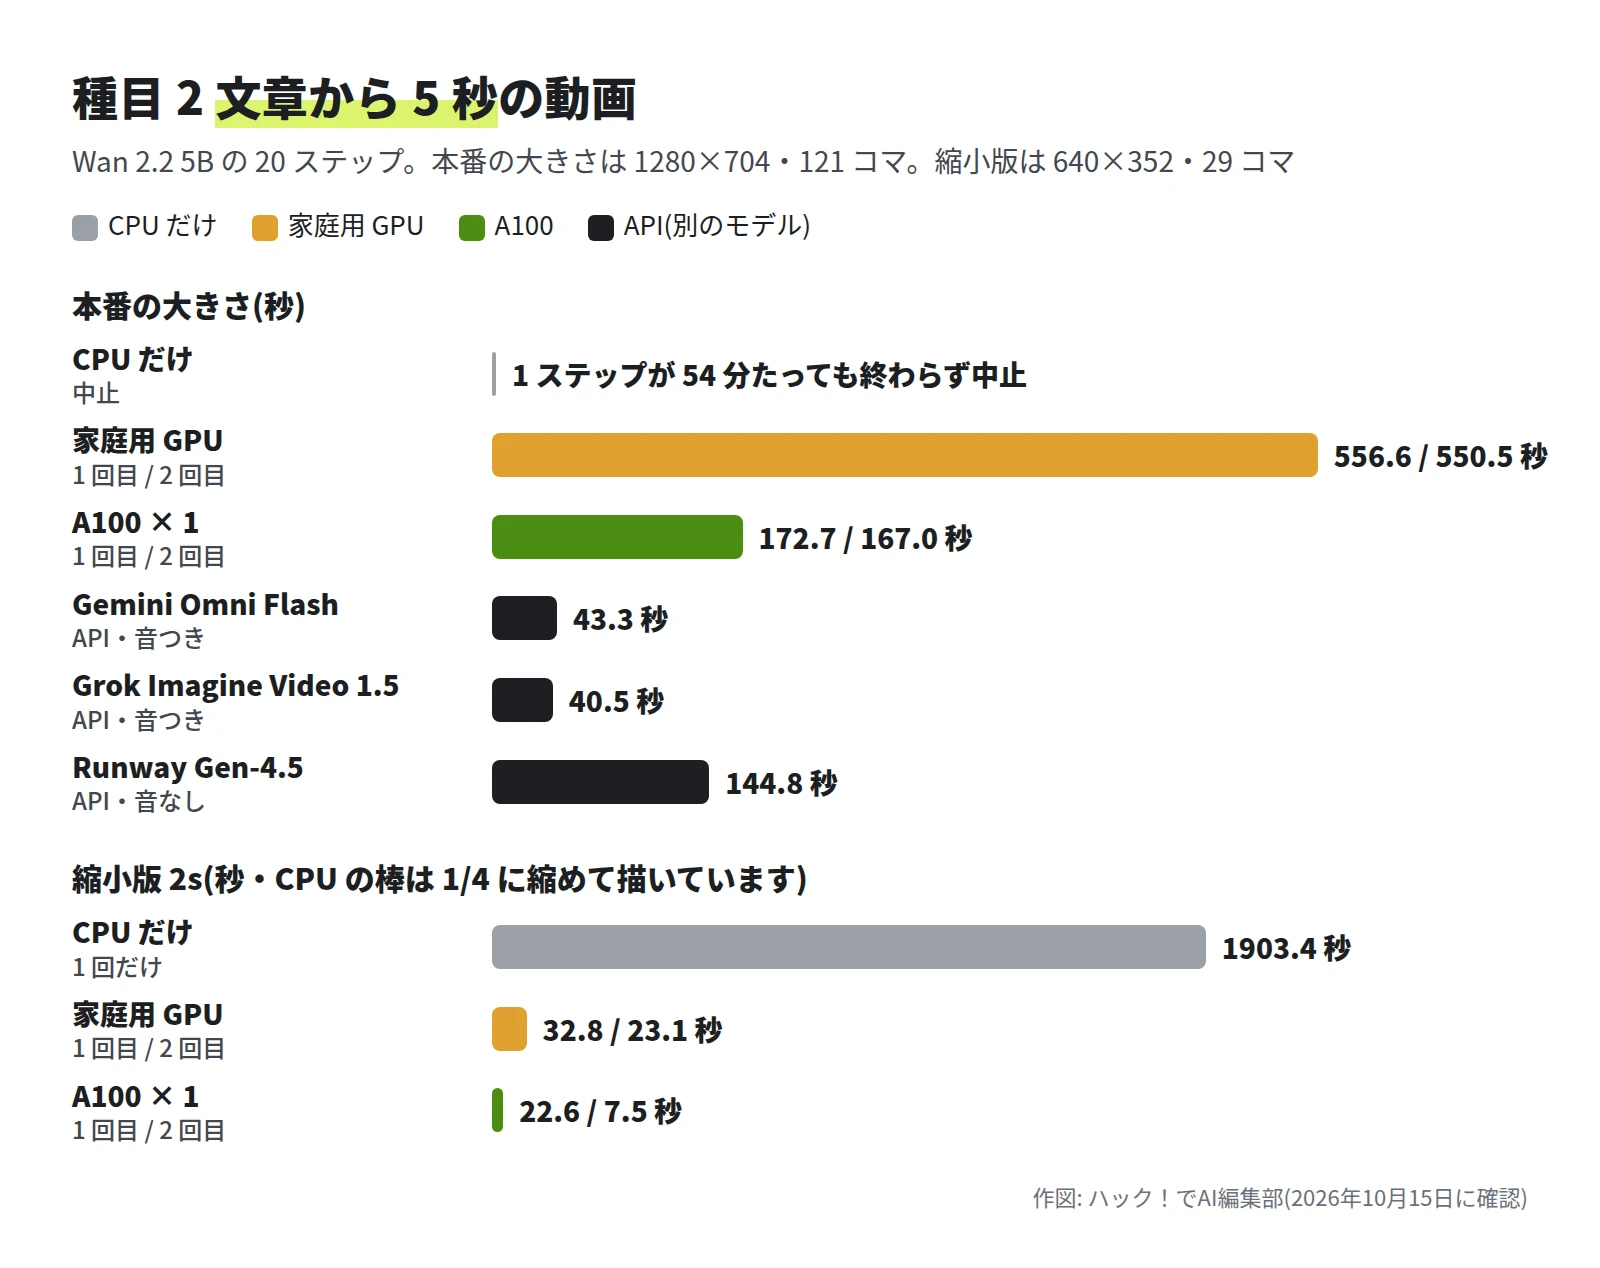
本番の大きさでは、家庭用 GPU が 550.5 秒(2 回目)、A100 1 枚が 167.0 秒で、A100 が約 3.3 倍の速さでした。
縮小版 2s は、CPU が 1,903.4 秒(約 32 分・1 回だけ・モデルの読み込みを含む)でした。ComfyUI の進行表示では 1 ステップが約 79 秒です。家庭用 GPU は 2 回目 23.1 秒、A100 は 2 回目 7.5 秒です。1 回目どうし(家庭用 GPU 32.8 秒、A100 22.6 秒)で比べると、CPU は約 58 倍、約 84 倍かかっています。
この CPU は AVX2 までで、AVX-512 には対応していません。そのぶん差が大きく出た可能性があります。
API の 3 種は、文章だけで頼んで、Omni が 43.3 秒・90.4 クレジット、Grok が 40.5 秒・122.9 クレジット、Runway が 144.8 秒・105.3 クレジットでした。
機器が違っても、同じ絵になるか
同じモデル・同じ文・同じ種なら、機器が違っても絵はほぼ同じになるはずです。家庭用 GPU と A100 の、同じ種(種 1)の同じコマを並べて確かめました。
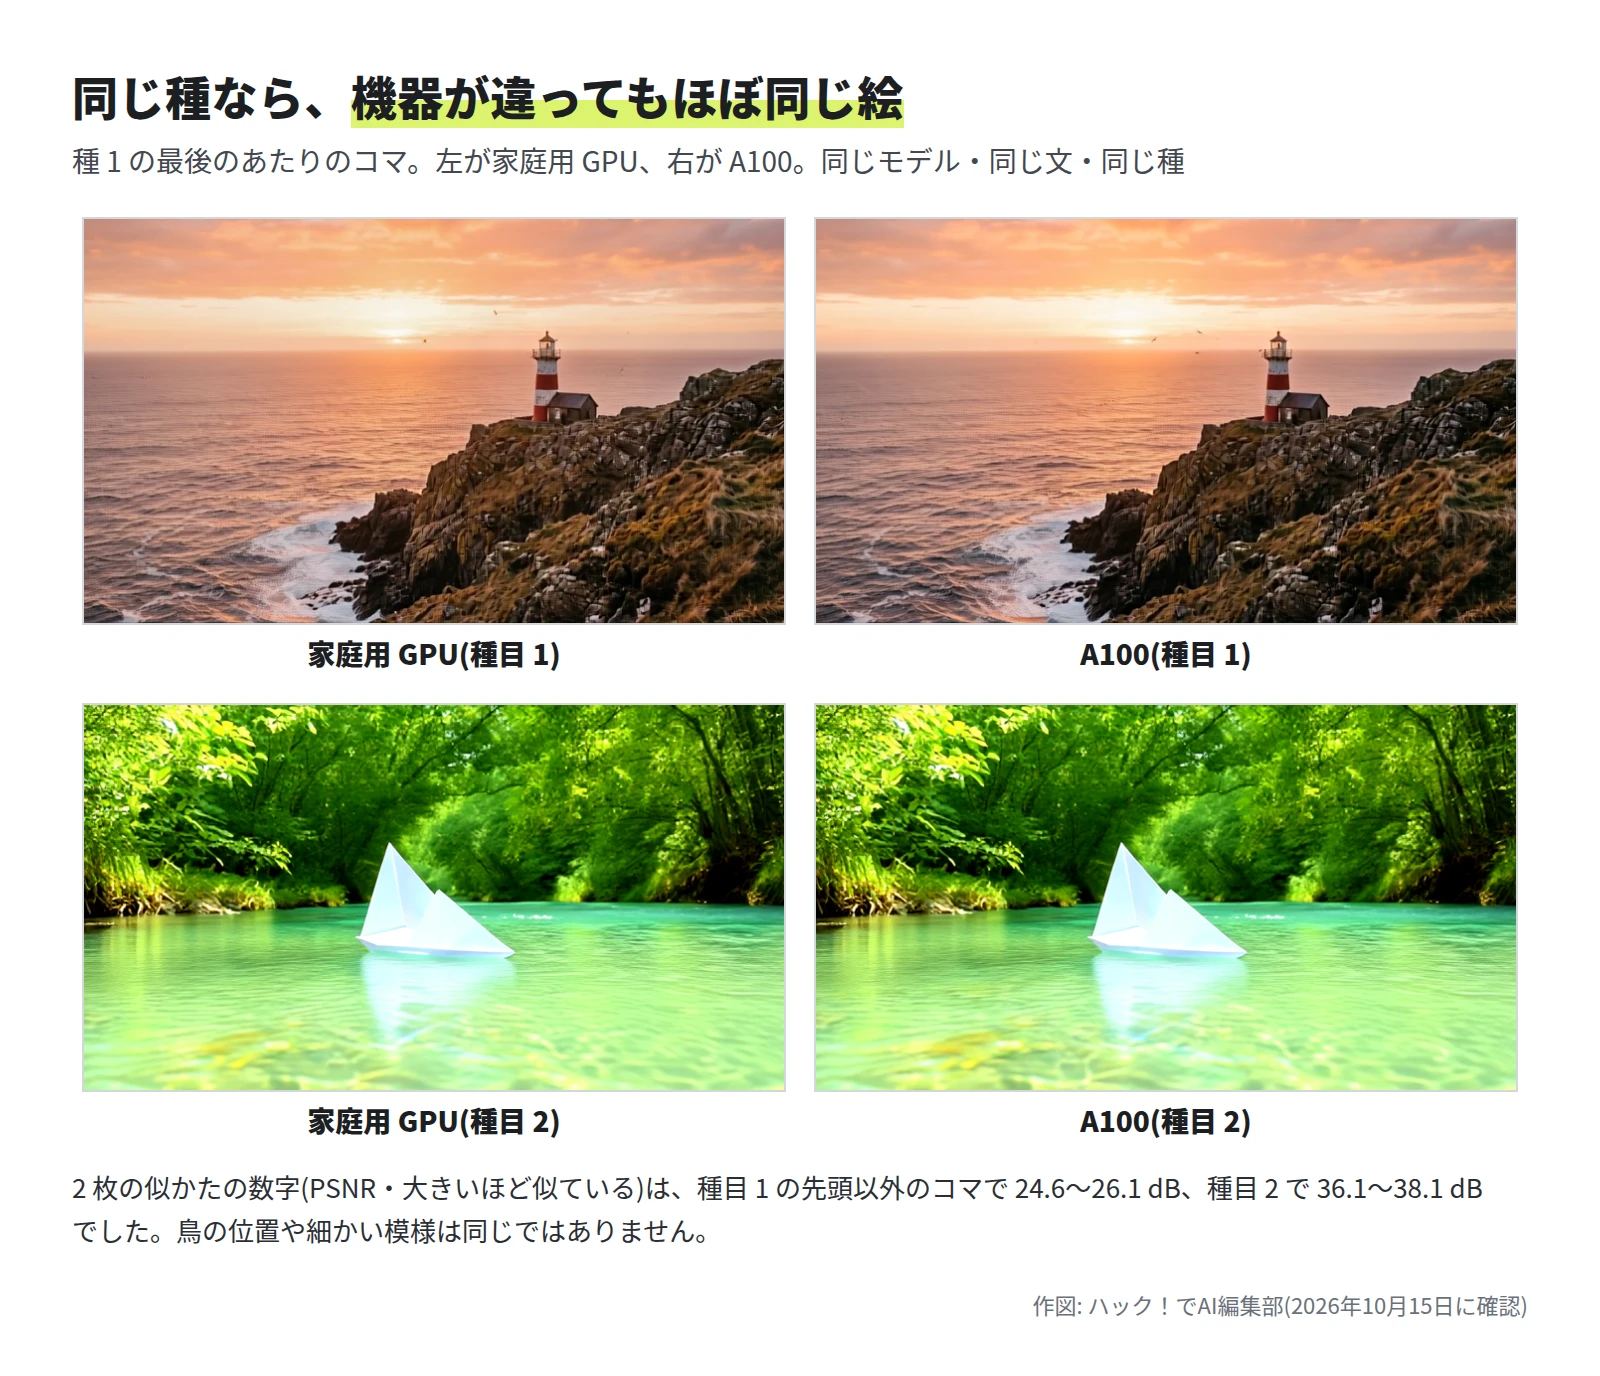
2 枚の似かたを示す PSNR(大きいほど似ている)は、種目 1 の先頭以外のコマで 24.6〜26.1 dB、種目 2 で 36.1〜38.1 dB、種目 3 の 5 コマで 40.1〜52.0 dB でした。構図と色は同じですが、種目 1 は鳥の位置や岩の細かい模様が同じではありません。
縮小版 2s では、違いがはっきり出ました。
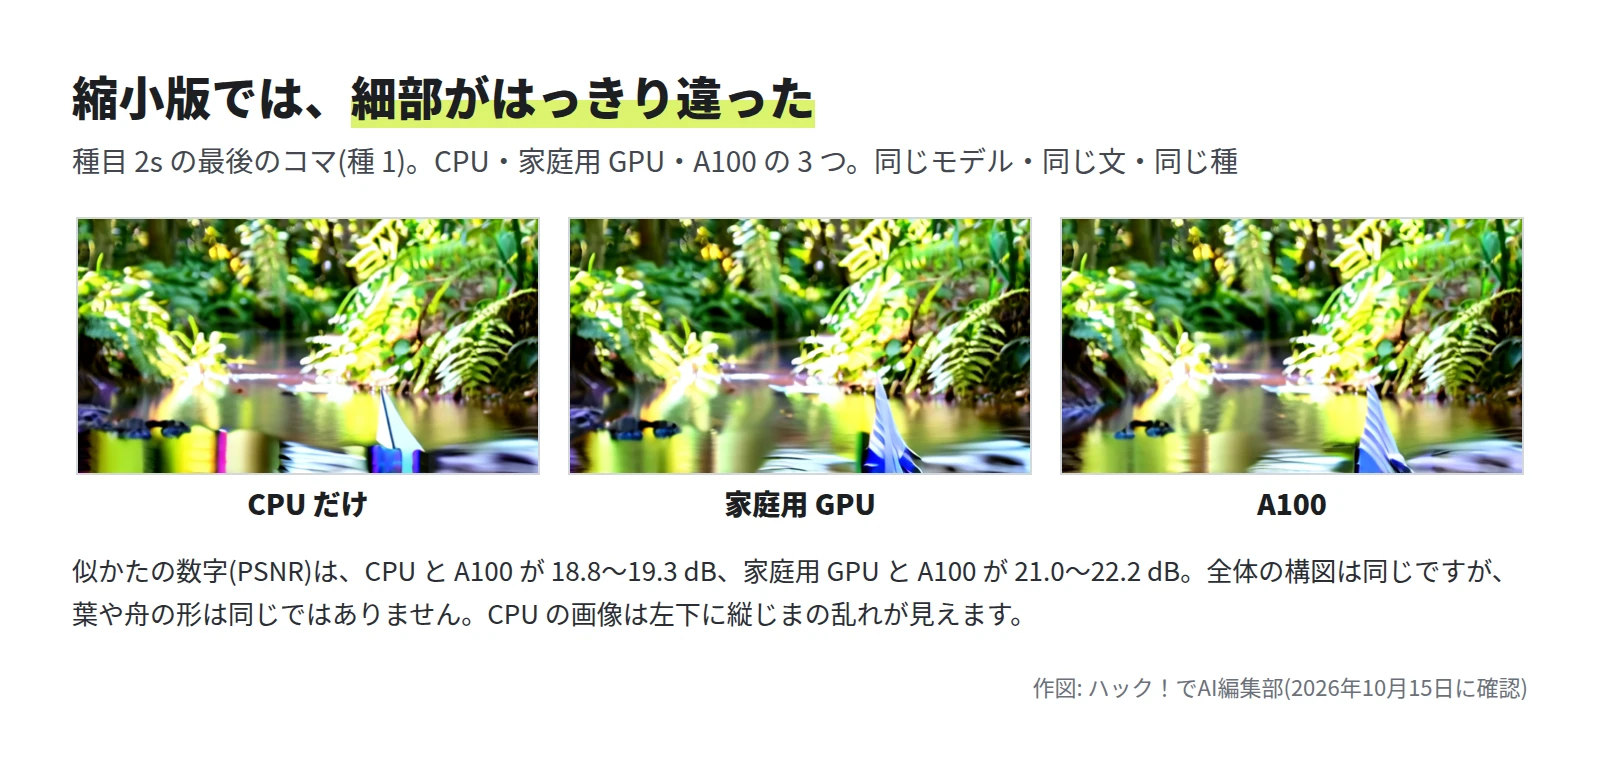
CPU と A100 の PSNR は 18.8〜19.3 dB、家庭用 GPU と A100 は 21.0〜22.2 dB でした。構図は同じですが、葉や舟の形は同じではありません。原因は今回の記録からは分かりません。20 ステップのくり返しの中で、計算のわずかな誤差が積み重なった可能性があります。「同じ種なら必ず同じ絵になる」とは言えない、というのが今回の結果です。
種目 3: 話す人の動画(口パク)
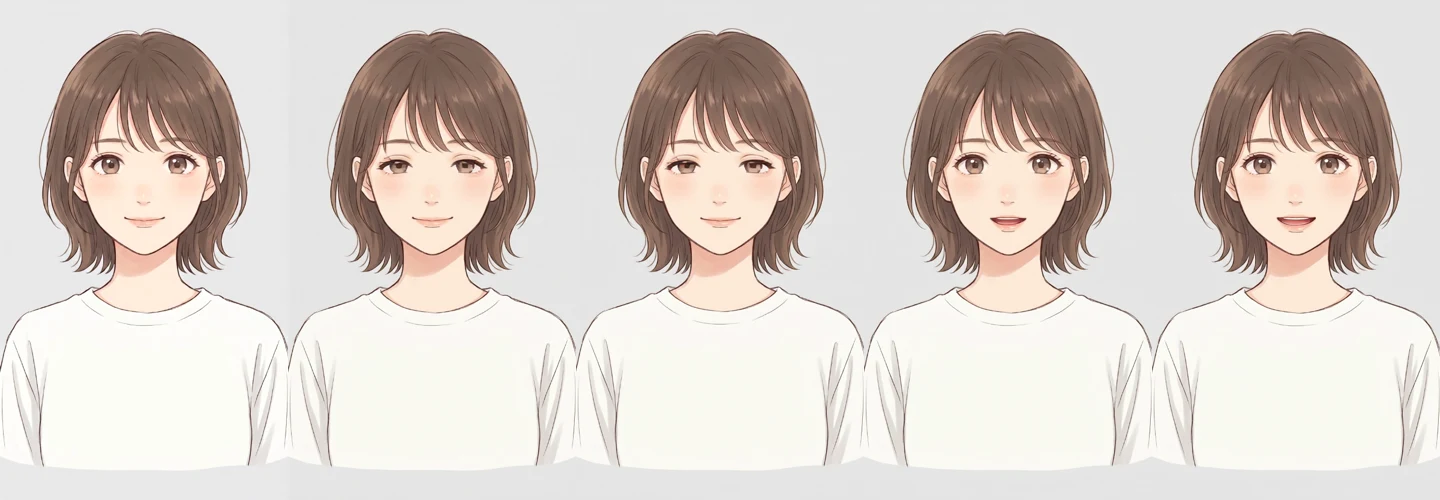
InfiniteTalk(音声に合わせて口が動く動画を作る仕組み)で、架空のイラストの顔 1 枚と、日本語の短い音声を渡しました。音声は「こんにちは。今日は、動画を作るのにかかる時間について、お話しします。」を OpenAI の読み上げで作ったものです。81 コマ(25 コマ/秒で 3.24 秒)分が使われます。
結果は、家庭用 GPU が 1 回目 200.9 秒・2 回目 188.5 秒、A100 1 枚が 1 回目 66.0 秒・2 回目 54.6 秒でした。2 回目では A100 が約 3.5 倍です。
API の 3 種は、この種目に出していません。YOBITSUGI AI の動画の道具には、手持ちの音声を渡す項目がなく、公式の資料(Gemini・xAI・Runway の動画の説明のページ)でも、3 つのモデルについて手持ちの音声に口を合わせる使い方は確かめられませんでした。Runway には音声から話す人の動画を作る別の窓口(avatar_videos)が公式の一覧にありますが、今回使ったモデルとは別のものです。
種目 4: 6 本まとめて作る
種目 1 と同じ設定で 6 本を作りました。A100 は、GPU ごとに ComfyUI を 1 つずつ起動し、6 本を GPU の数ぶんに分けて同時に流しました。
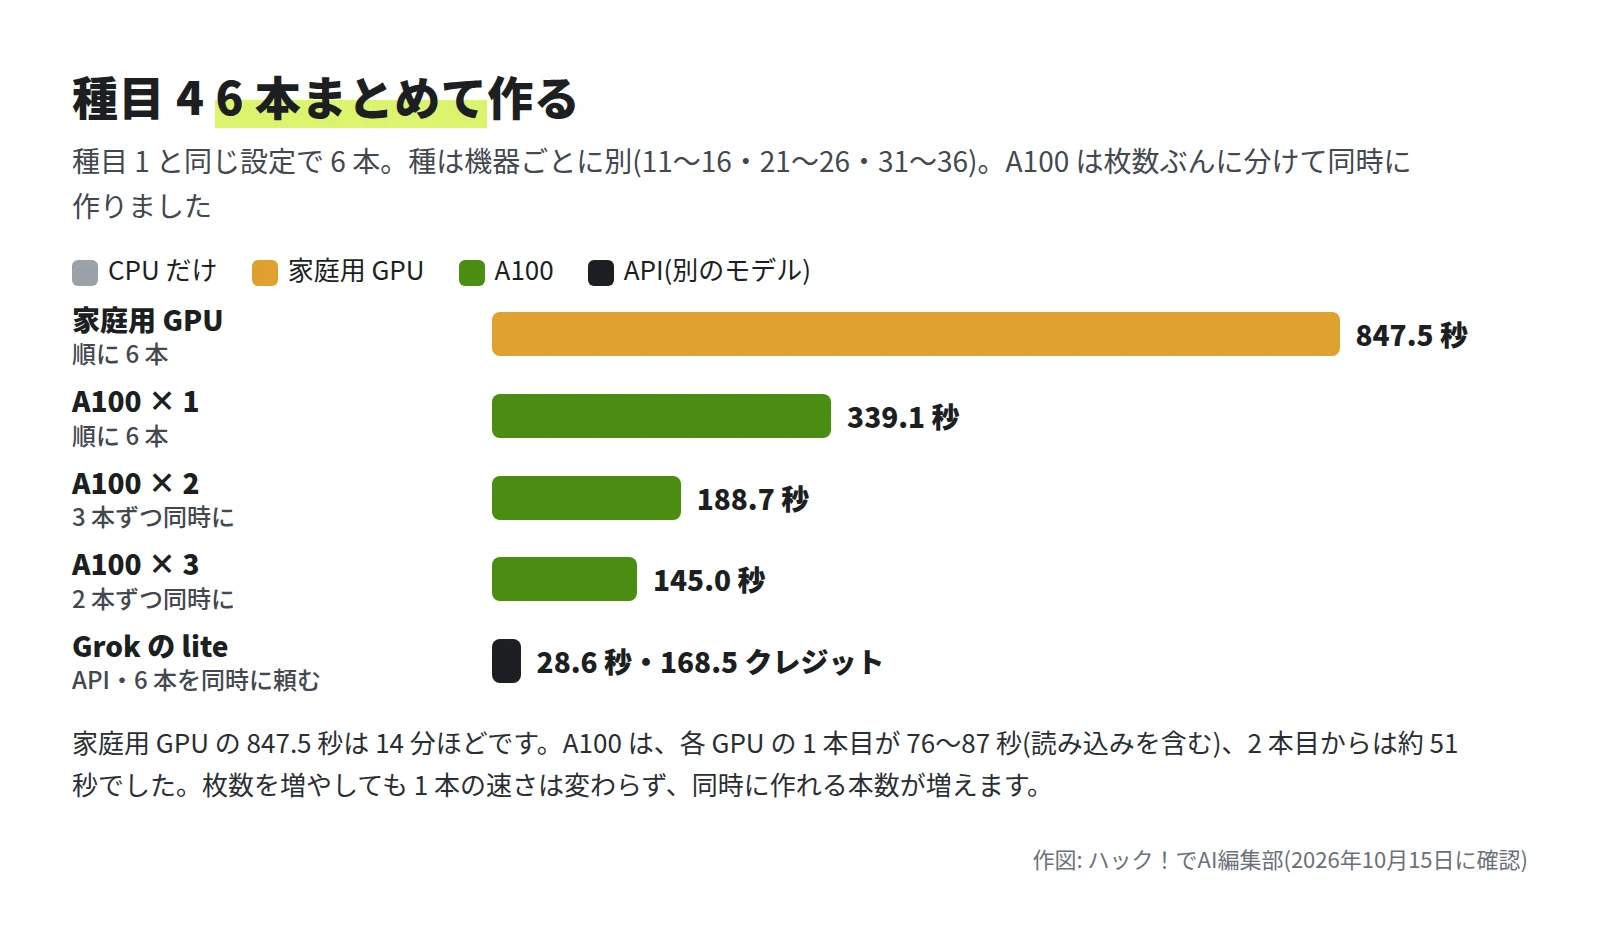
家庭用 GPU は順に 6 本で 847.5 秒(14 分ほど)でした。A100 は 1 枚で 339.1 秒、2 枚で 188.7 秒、3 枚で 145.0 秒で、1 枚と 3 枚を比べると 2.3 倍の速さです。枚数の比(3 倍)より小さいのは、各 GPU の 1 本目に、モデルの読み込みを含む 76.0〜87.3 秒かかるためです。2 本目からは、どの枚数でも 1 本が約 51 秒で、枚数を増やしても 1 本の速さは変わりません。変わるのは、同時に作れる本数です。
API は、Grok の lite(Grok Imagine Video 1.5 の軽い版)に 6 本を同時に頼み、全部が届くまで 28.6 秒でした。1 本は 28.1 クレジットで、6 本で 168.5 クレジットです。別のモデルなので、機器の速さとは比べないでください。
種目 5: 1 本あたりの電気とお金
GPU の消費電力を、nvidia-smi で 1 秒ごとに記録し、積み上げて電力量(Wh)にしました。電気代は、全国家庭電気製品公正取引協議会が公表している電力料金の目安単価、1kWh あたり 31 円(税込。同協議会の「よくある質問」で、2022年7月22日に改定された現在の目安単価とされています)で計算しました。実際の単価は契約によって違います。
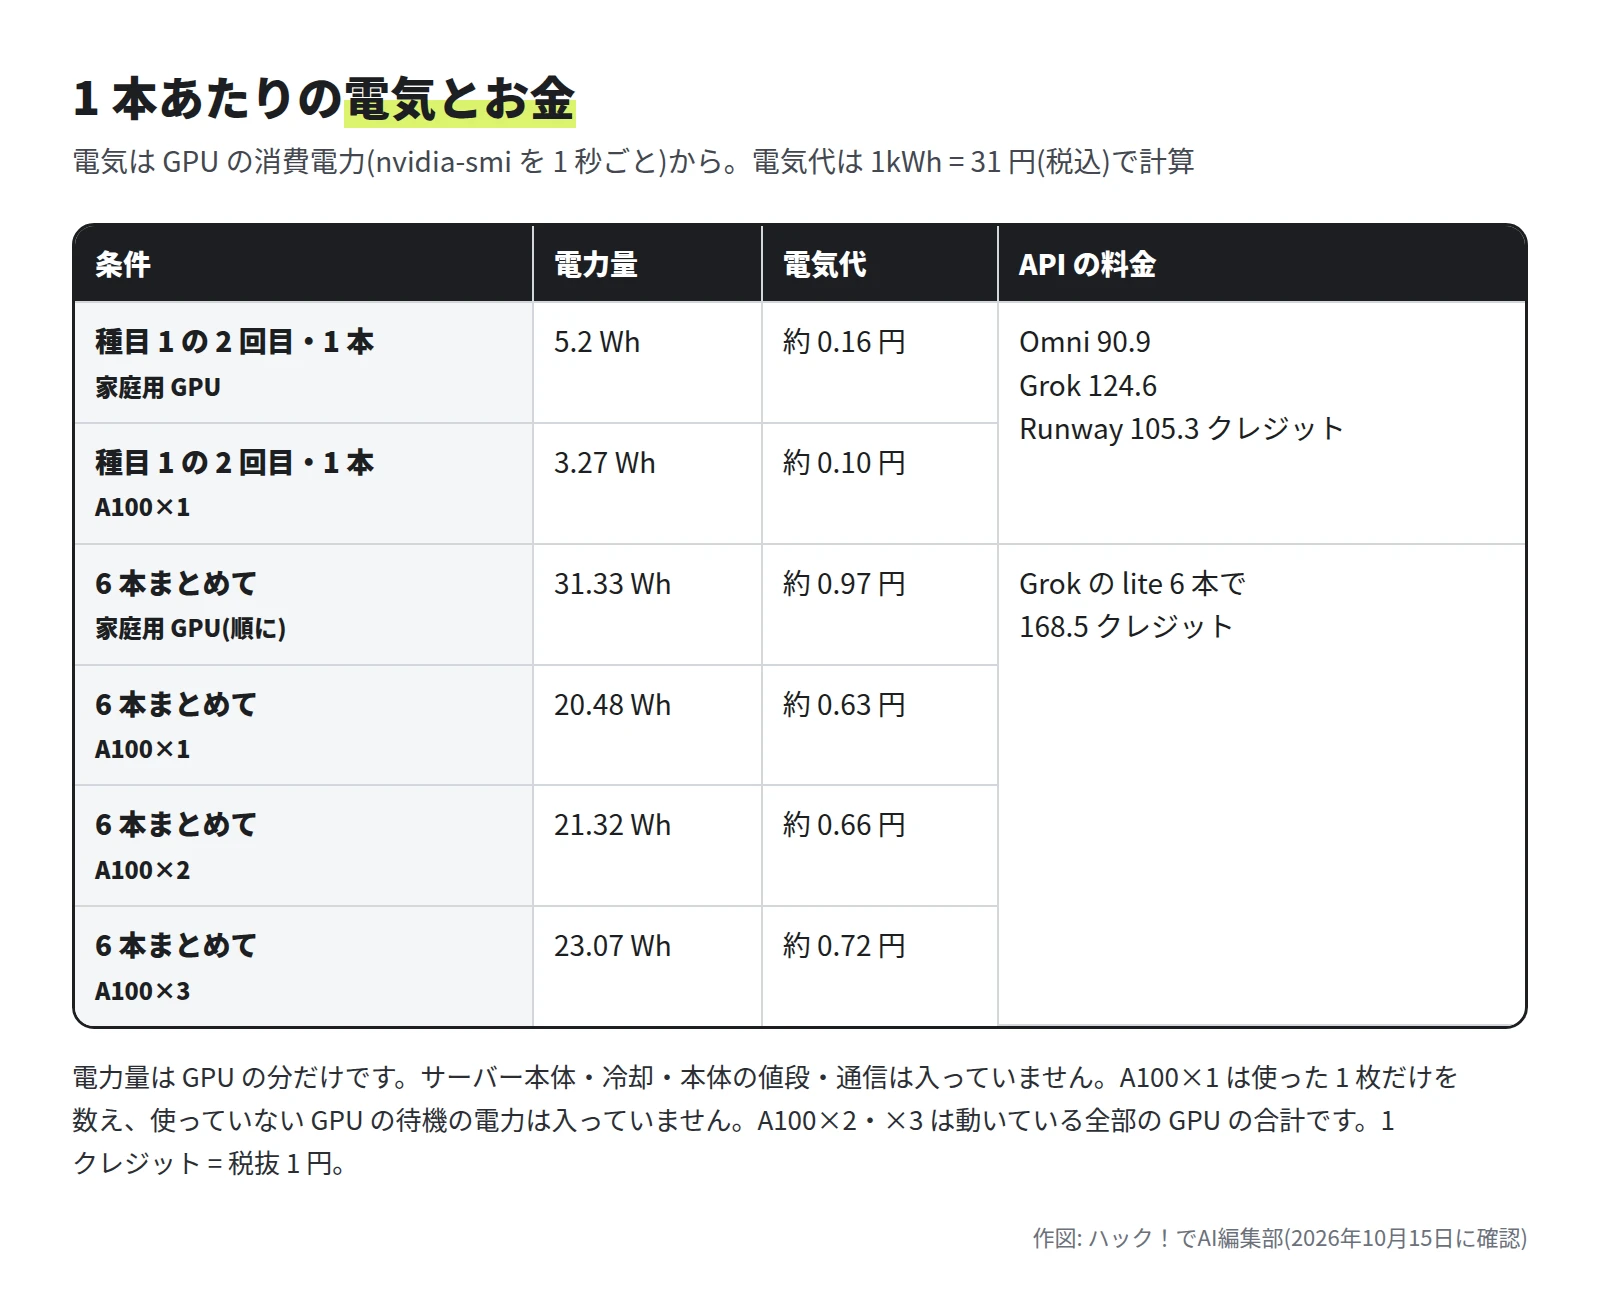
- 1 本: 種目 1 の 2 回目では、家庭用 GPU が 5.19 Wh、A100 が 3.27 Wh でした。速く終わる A100 のほうが少なくなりました。
- 6 本まとめて: A100 は、1 枚で 20.48 Wh、2 枚で 21.32 Wh、3 枚で 23.07 Wh です。枚数を増やしても、全体の電力量は 1 枚の約 13% しか増えませんでした。1 枚の数字は、使った GPU 1 枚だけの電力で、使っていない GPU の待機の電力は入っていません。2 枚・3 枚の数字は、動いた GPU の電力の合計です。並んで動く GPU の電力を重ねて数えてしまうため、2 枚・3 枚の 1 本ごとの電力量は出していません。
- 電気代と API の料金: GPU の電気代は、6 本まとめてでも 1 円に届きません。API は 1 本 90.9〜124.6 クレジット(税抜 90.9〜124.6 円に相当)です。ただし電力量は GPU の分だけで、サーバー本体・冷却・機器の購入や借りる費用・通信は入っていません。「ローカルのほうが安い」という結論は、この数字だけでは出せません。
CPU だけのサーバーは、仮想サーバーで消費電力を測れないので、電力は書きません。
どんなときにどれを使うか
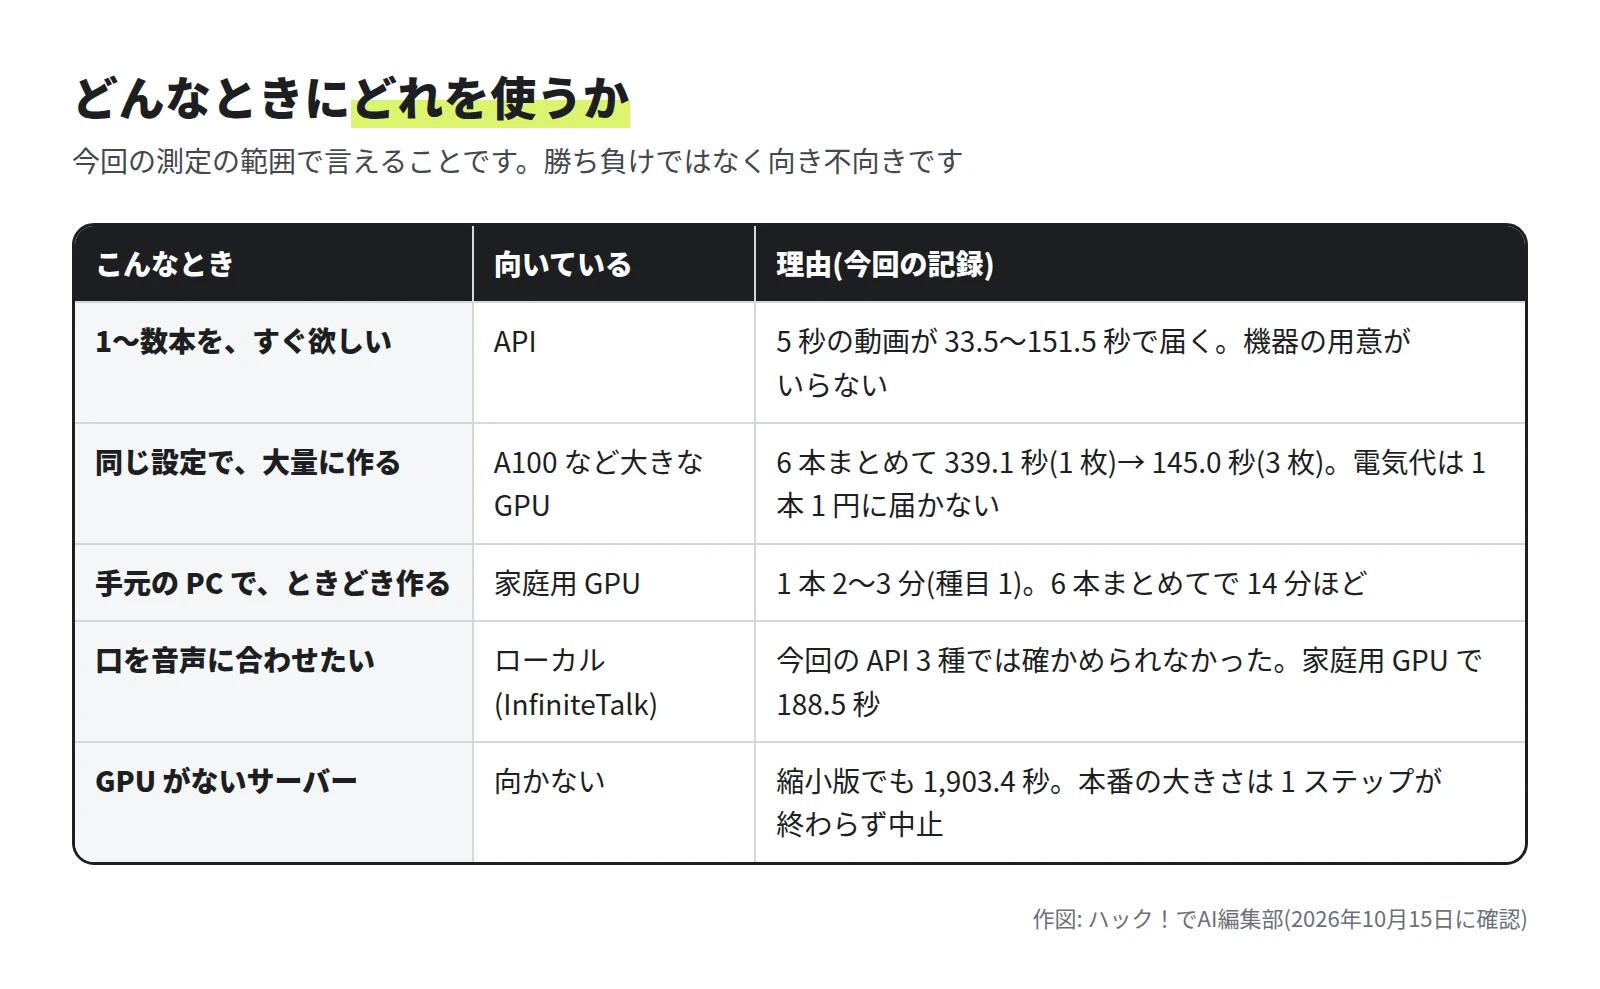
- API: 機器を用意せず、1〜数本をすぐ作りたいときです。1 本ごとに料金がかかり、モデルや設定は提供元が決めたものになります。
- A100 のような大きな GPU: 同じ設定で何十本も作る、モデルを自分で選びたい、素材を外に出したくないときです。用意する費用と手間は別にかかります。
- 家庭用 GPU: 手元の PC で、ときどき作るときです。8GB でも 14B のモデルが動きました。
サーバーの借り方や費用は、この連載のサーバーで AI を動かすメリットとは?とクラウドと VPS の選び方で説明しています。動画を長くする作り方は長い AI 動画の作り方、API の出来の比べは動画生成 AI 5 つを同じプロンプトで比較とアニメ調の動画 AI の比較にあります。
気をつけること
- 1 回ずつの測定です。ローカルは 2 回、CPU と API は 1 回です。差が 1〜2 割のところで、順位を決めないでください。
- 機器の条件が違います。ComfyUI の版は、家庭用 GPU と A100 が 0.39.0、CPU が 0.40.0 です。ローカルには「ぼやけ・文字」などを避ける否定文を渡しましたが、API には渡せません。
- API とローカルの差は、機器ではなくモデルの差です。解像度(API は 720p、ローカルは 832×480 など)・音の有無・長さも違います。
- 今回は作っていません: Veo 3.1・Seedance・Kling です。Google の公式の一覧では、Veo 3.1 は最短で 2026年10月22日に提供を終える予定で、後継は Gemini Omni Flash とされています。
- モデルの使い方の条件: Wan 2.2 は Apache 2.0 と書かれていますが、追加のデータや各 API の利用規約は別です。商用で使うときは、それぞれの規約を確かめてください。
- 画像の扱い: 載せた絵と動画は、すべて AI が作った架空のものです。
まとめ
- 同じ Wan 2.2 で、A100 1 枚は家庭用 GPU より約 2.7〜3.5 倍速く、3 枚で 6 本を作ると 1 枚の 2.3 倍の速さでした。
- GPU のないサーバーは、縮小版でも約 32 分かかり、本番の大きさは中止しました。
- API は、5 秒の動画を数十秒〜数分、1 本 90.4〜124.6 クレジットで受け取れる別のやり方です。
参考にした公式の情報
- GitHub Wan-Video/Wan2.2(モデルの一覧・ライセンス・GPU メモリの目安)
- ComfyUI ドキュメント「Wan2.2 Video Generation ComfyUI Official Native Workflow Example」
- GitHub comfyanonymous/ComfyUI
- NVIDIA GeForce RTX 5060 ファミリー(仕様表)
- Google AI for Developers「Generate and edit videos with Gemini Omni Flash」
- Google AI for Developers(Gemini API)の提供終了の一覧(Deprecations)
- Grok の公式ドキュメント「Video Generation」
- Runway API ドキュメント「Available AI Models」
- 全国家庭電気製品公正取引協議会「よくある質問」(電力料金の目安単価)
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
AIを動かす環境とコスト全 10 回の目次
- 1サーバーで AI を動かすメリットとは? VPS で使う code-server
- 2YES ボタンの押し疲れを減らす。お風呂の間も作業を止めない方法
- 3Claude Code のサブスクと API、どちらが得か 編集部の実測で計算
- 4クラウド vs VPS。AI の時代に VPS でクラウドは超えられるのか
- 5Web はレンタルサーバーで十分。足りなくなる 4 つの場面
- 6自作で脱 SaaS はできる? 作りやすいものと難しいもの
- 7自前でメールサーバーを作る。Gmail やレンタルサーバー以外の選択肢
- 8配信サービスは帯域が肝。YouTube との併用を選んだ訳
- 9API が ATM 化。自社のデータの出し入れに手数料がかかる時代へ
- 10動画生成はサーバースペックが命。GPU vs API(この記事)