 佐々木 航
この記事でわかること
- 最先端の費用と日本の予算、公開モデルの遅れを数字で見る
- 2030 年までの 6 つの予想と、確からしさ・外れる条件
- 「機密を守れる業界専用の AI が勝ち筋」の見方の検証
確認した環境: 各社・各省庁・調査機関の公式の発表と論文 / 2026年10月25日に確認
2022 年 11 月、AI の研究機関 Epoch AI は、質の高い言語データが 2026 年より前に尽きる可能性が高いと予測しました。2024 年 7 月には、Meta のマーク・ザッカーバーグ氏が「オープンソースの AI こそ進む道」と書きました。2025 年 1 月には DeepSeek の登場で NVIDIA の株価が 1 日で約 17% 下がり、「安く作れるなら、計算機への投資は減る」という見方が広がりました。2026 年 10 月の今、この 3 つはどれも、言われたとおりにはなっていません。
予想は外れます。そこでこの記事では、国産 LLM(大規模言語モデル。文章を読み書きする AI の中心の技術)の 2030 年までを 6 つの予想にまとめ、予想ごとに根拠と「外れる条件」を書きます。先に編集部の見立てを書くと、国産 LLM は世界最大のモデルを競う形にはならず、日本語・行政・業界の仕事で、社内や国内で動かせる選択肢として使われていく見込みです。ただし、外に情報を出さない AI の席を、国産モデルだけが占めるとは限りません。
「国産の AI がそろうのを待つか、今の海外の AI で進めるか」と迷っている方が、判断の時期と材料を決められるように書きました。特集「国産LLMのいまとこれから」の最終回(第 6 回)です。
数年前の 3 つの見方を、2026 年 10 月の事実と突き合わせる
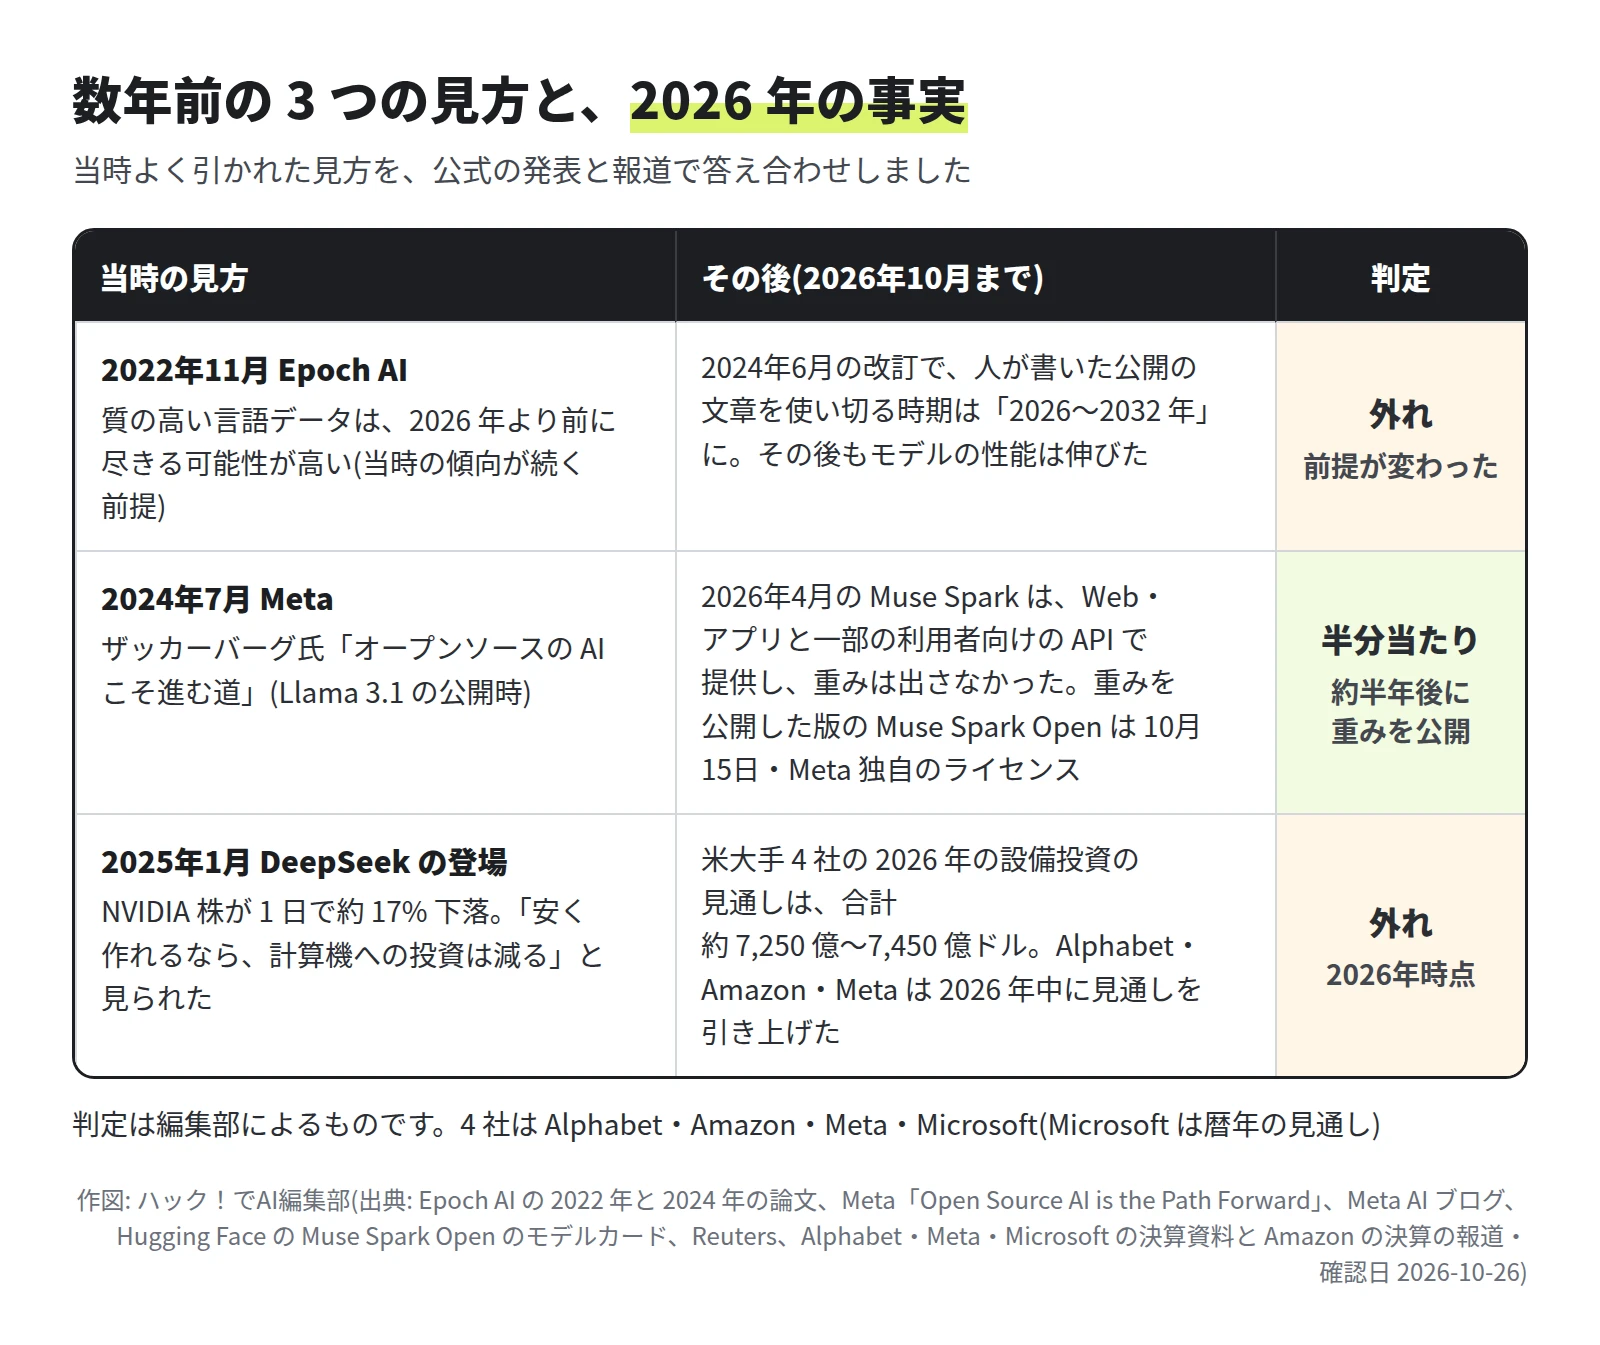
- データは尽きる: Epoch AI の 2022 年の論文は、当時の傾向がそのまま続くという前提を置いていました。2024 年の改訂版では、人が書いた公開の文章を使い切る時期を「2026〜2032 年」に後ろへずらしています。モデルの性能は、その後も伸びました。
- オープンこそ進む道: Meta は 2026 年 4 月、新しいモデル Muse Spark を、Web とアプリ、一部の利用者向けの API で出し、重み(学習で決まる数値の集まり)は公開しませんでした。重みを公開した版の Muse Spark Open(8,160 億パラメーター。パラメーターはモデルの大きさの目安)が出たのは、約半年後の 10 月 15 日です。ライセンスは Meta 独自のものです。
- 計算機への投資は減る: 2025 年 1 月 27 日、NVIDIA の時価総額は 1 日で約 5,930 億ドル減りました(Reuters・株価は約 17% の下落)。それでも、米大手 4 社が 2026 年に見込む設備投資は、合わせて約 7,250 億〜7,450 億ドル(約 114 兆〜117 兆円)です。4 社は Alphabet・Amazon・Meta・Microsoft です(Amazon の見通しは報道による)。Microsoft を除く 3 社は、2026 年のうちに見通しを引き上げました。
3 つとも、その時点の数字や方針を、そのまま先へ伸ばしていました。データの使い方、会社の戦略、需要のどれかが動くと、予想は外れます。この記事の予想に外れる条件を付けるのは、そのためです。
予想の前に、確かな傾向を数字で見る
2030 年まで続く可能性が高い傾向を、4 つ確かめます。
最先端を作る費用は年 3.5 倍で伸び、日本の予算とは桁が違う
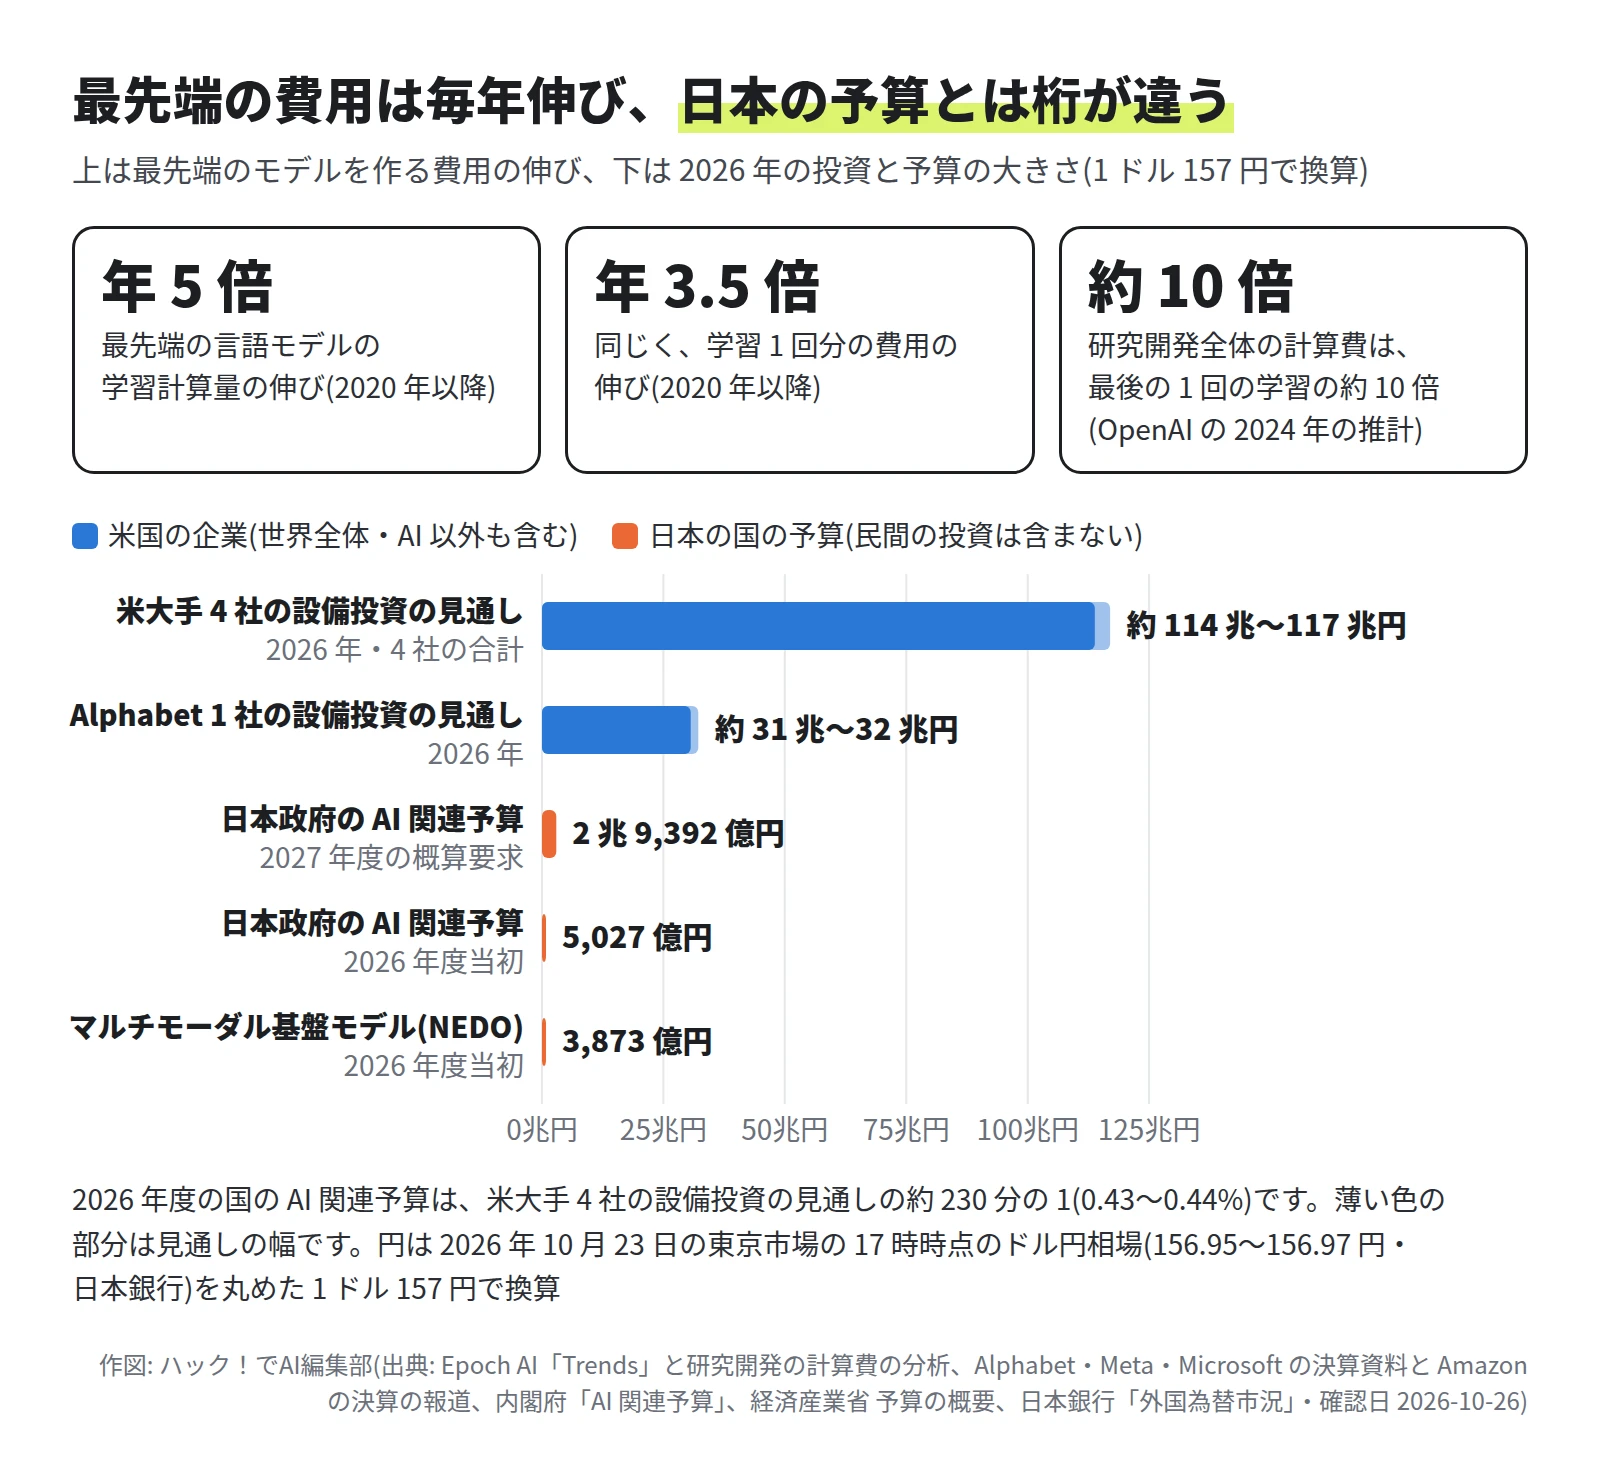
Epoch AI の推計では、最先端の言語モデルの学習計算量は 2020 年以降に年 5 倍、学習 1 回分の費用は年 3.5 倍で伸びています。しかも、最後の 1 回の学習は費用の一部にすぎません。OpenAI の 2024 年の研究開発の計算費は約 50 億ドルで、最後の学習の分はその 9.6% だったと、Epoch AI は見積もっています。
日本の国の AI 関連予算は、2026 年度当初が約 5,027 億円、2027 年度の概算要求が 2 兆 9,392 億円です(内閣府の集計)。2026 年度当初の額は、米大手 4 社が見込む設備投資の約 230 分の 1(0.43〜0.44%)にあたります。米国側は世界全体の投資で AI 以外も含み、日本側は国の予算だけなので、桁の目安として見てください。
公開モデルは数か月遅れで追いつき、値段は下がる
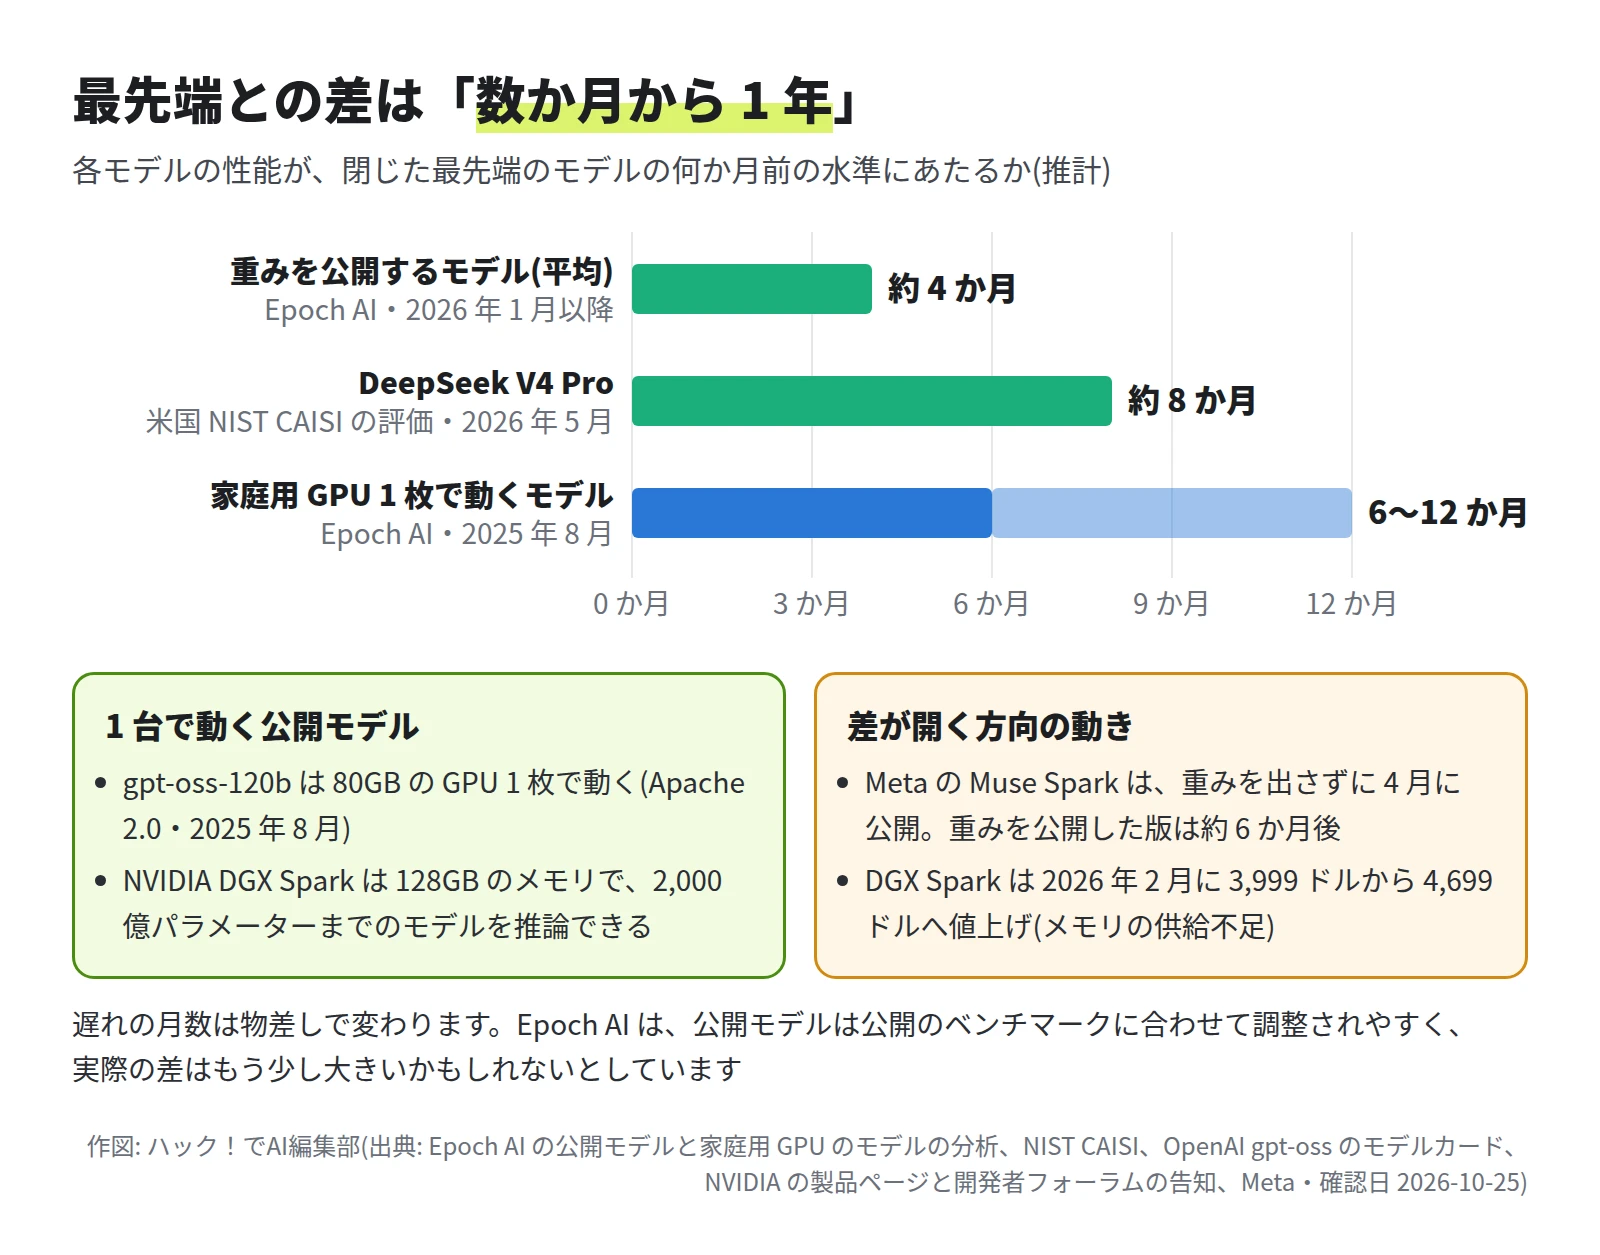
重みを公開しているモデル(公開モデル。自社のサーバーに置いて動かせる)は、閉じた最先端のモデルより平均で約 4 か月遅れの水準にあります(Epoch AI・2026 年 1 月以降)。米国の NIST の評価機関 CAISI は、DeepSeek V4 Pro を約 8 か月遅れと評価しました。家庭用の GPU 1 枚で動くモデルでも、最先端の 6〜12 か月前の水準です(Epoch AI・2025 年 8 月)。
値段も下がっています。Stanford 大学の AI Index 2025 によると、GPT-3.5 並みの性能で答えを作る費用は、2022 年 11 月から 2024 年 10 月までに 280 分の 1 以下になりました。ただし、差がゼロになるわけではありません。人の投票で比べる Arena では、公開モデルと閉じたモデルの最上位どうしの差が 2024 年 8 月に 0.5% まで縮んだあと、2026 年 3 月には 3.3% に開いています(AI Index 2026)。
日本の予定は、2027 年 4 月から動き出す
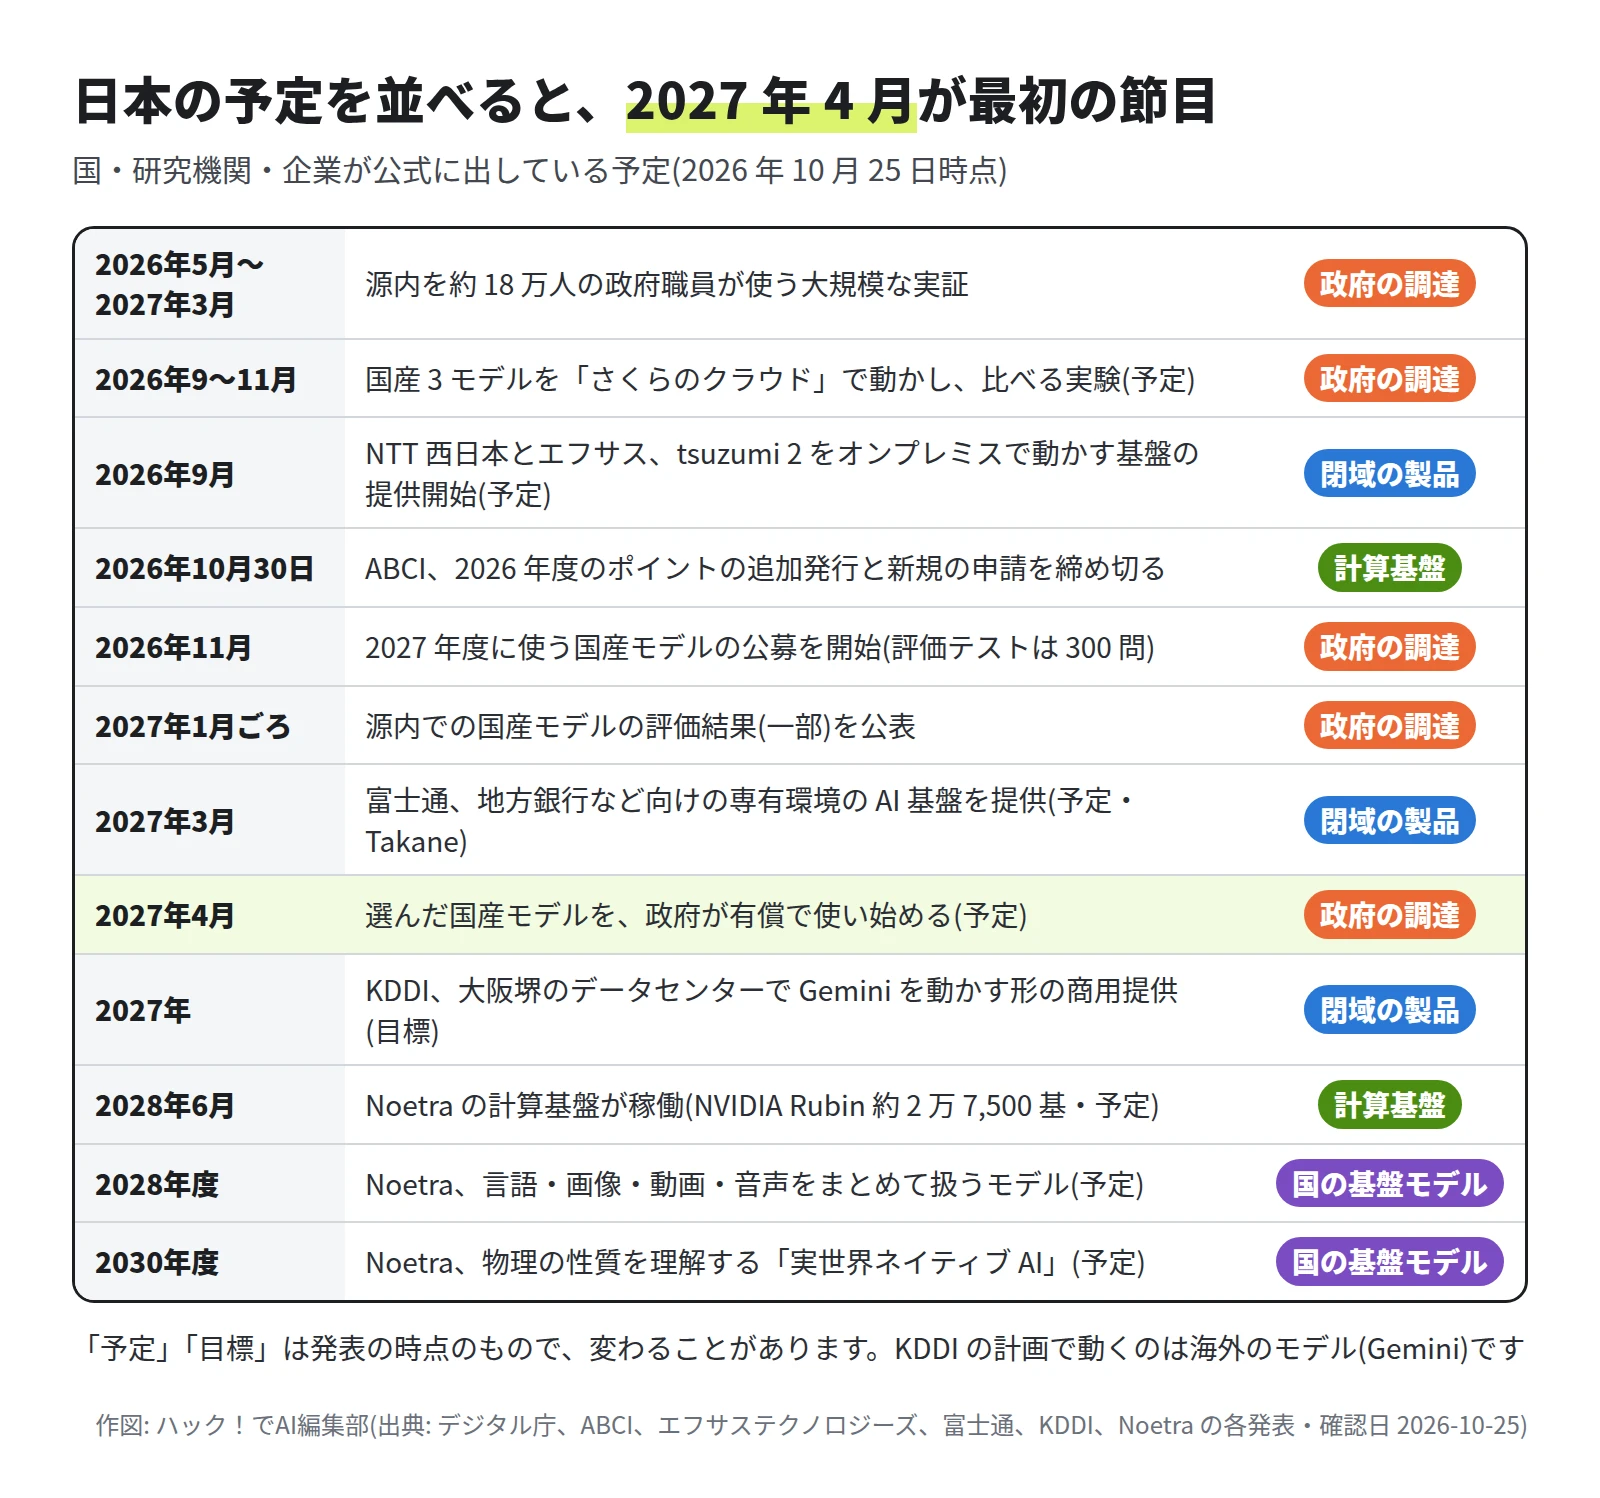
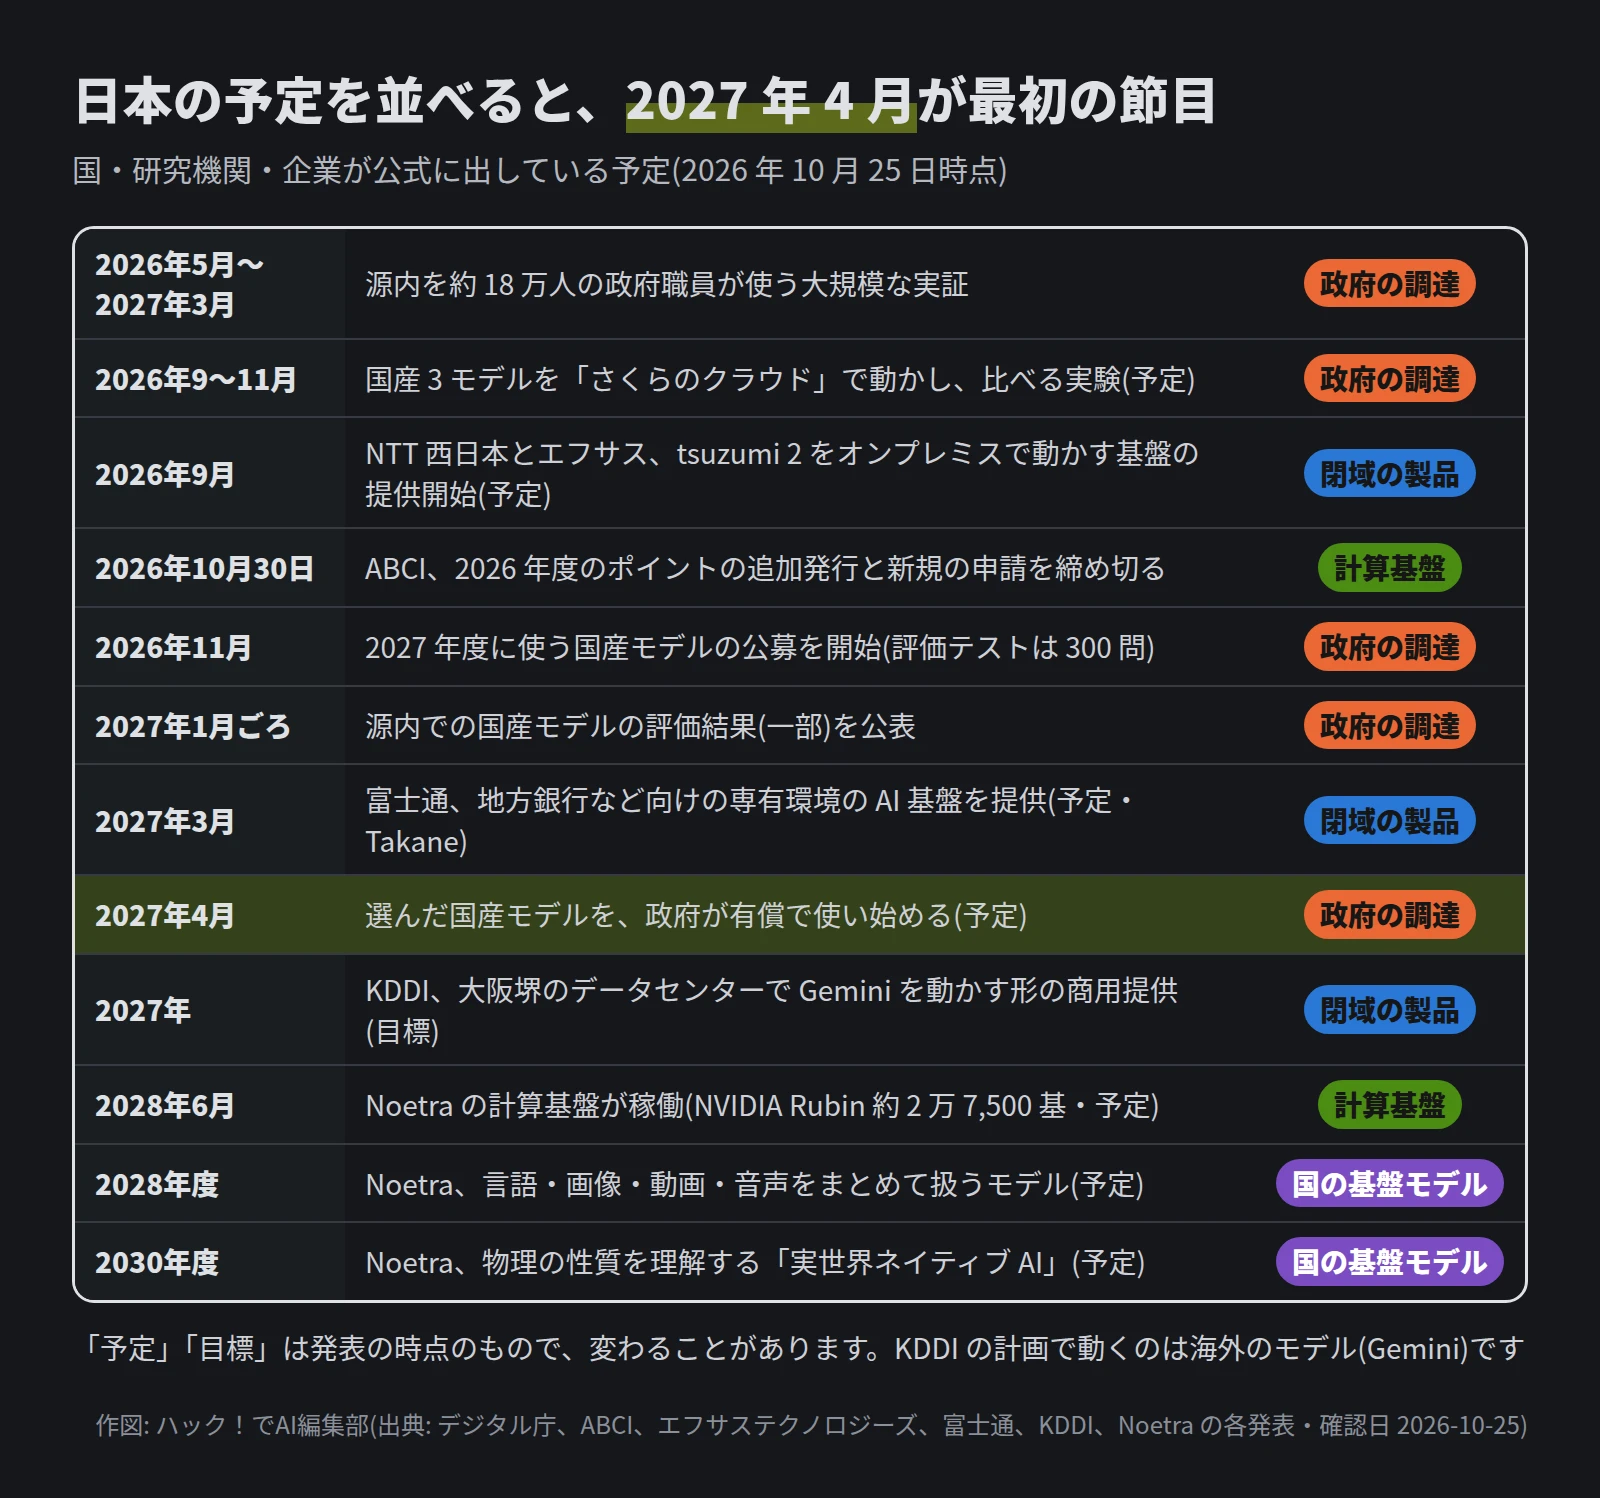
政府が国産 LLM にお金を払って使い始める節目は、2027 年 4 月です。デジタル庁は、政府職員向けの生成 AI の環境「源内」で国産の LLM を 5 社分試していて、2027 年度に使うモデルを 11 月から公募し、4 月から有償で使い始める予定です。今年度に試している国産モデルの評価・検証の結果も、2027 年 1 月ごろに一部が公表される予定です。
計算基盤の大きな節目は、国の基盤モデルの事業を受け持つ Noetra が、NVIDIA の Rubin GPU 約 2 万 7,500 基の計算基盤を動かし始める 2028 年 6 月です。選定と評価の流れや予算の中身は、第 2 回で詳しく読み解きました。
データセンターの電力は増えるが、想定は後ろにずれやすい
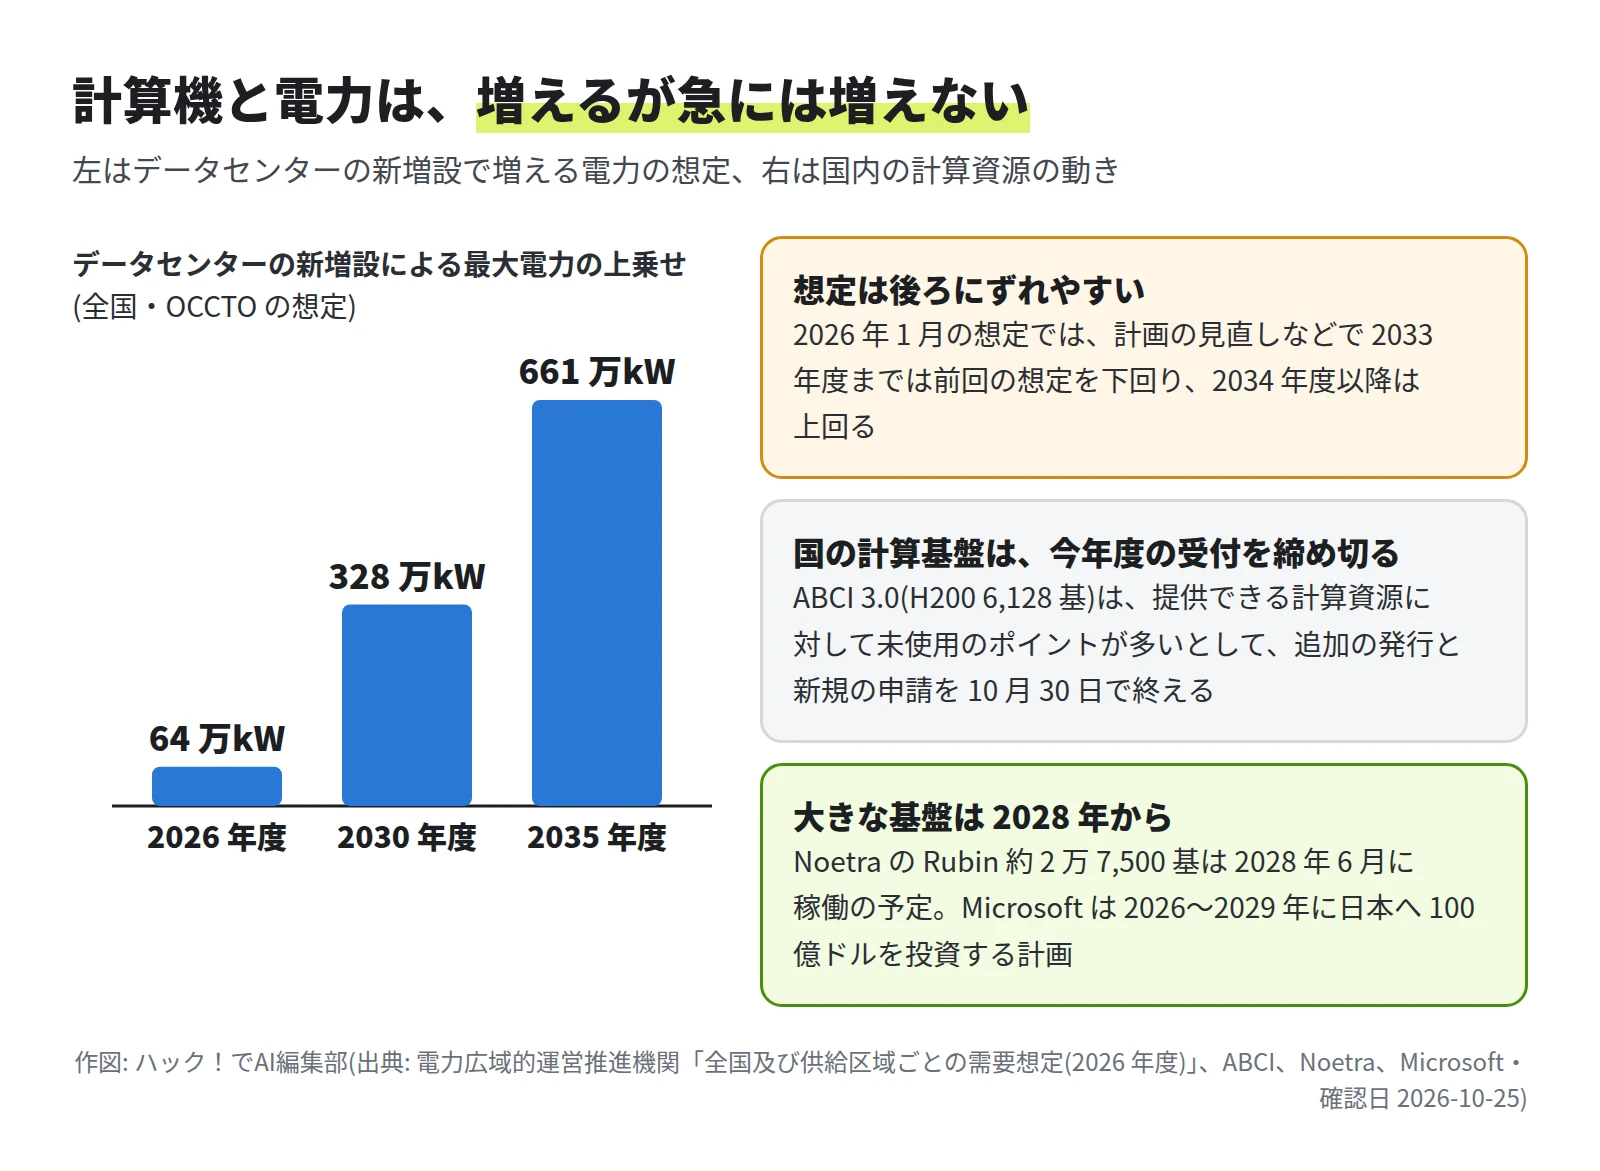
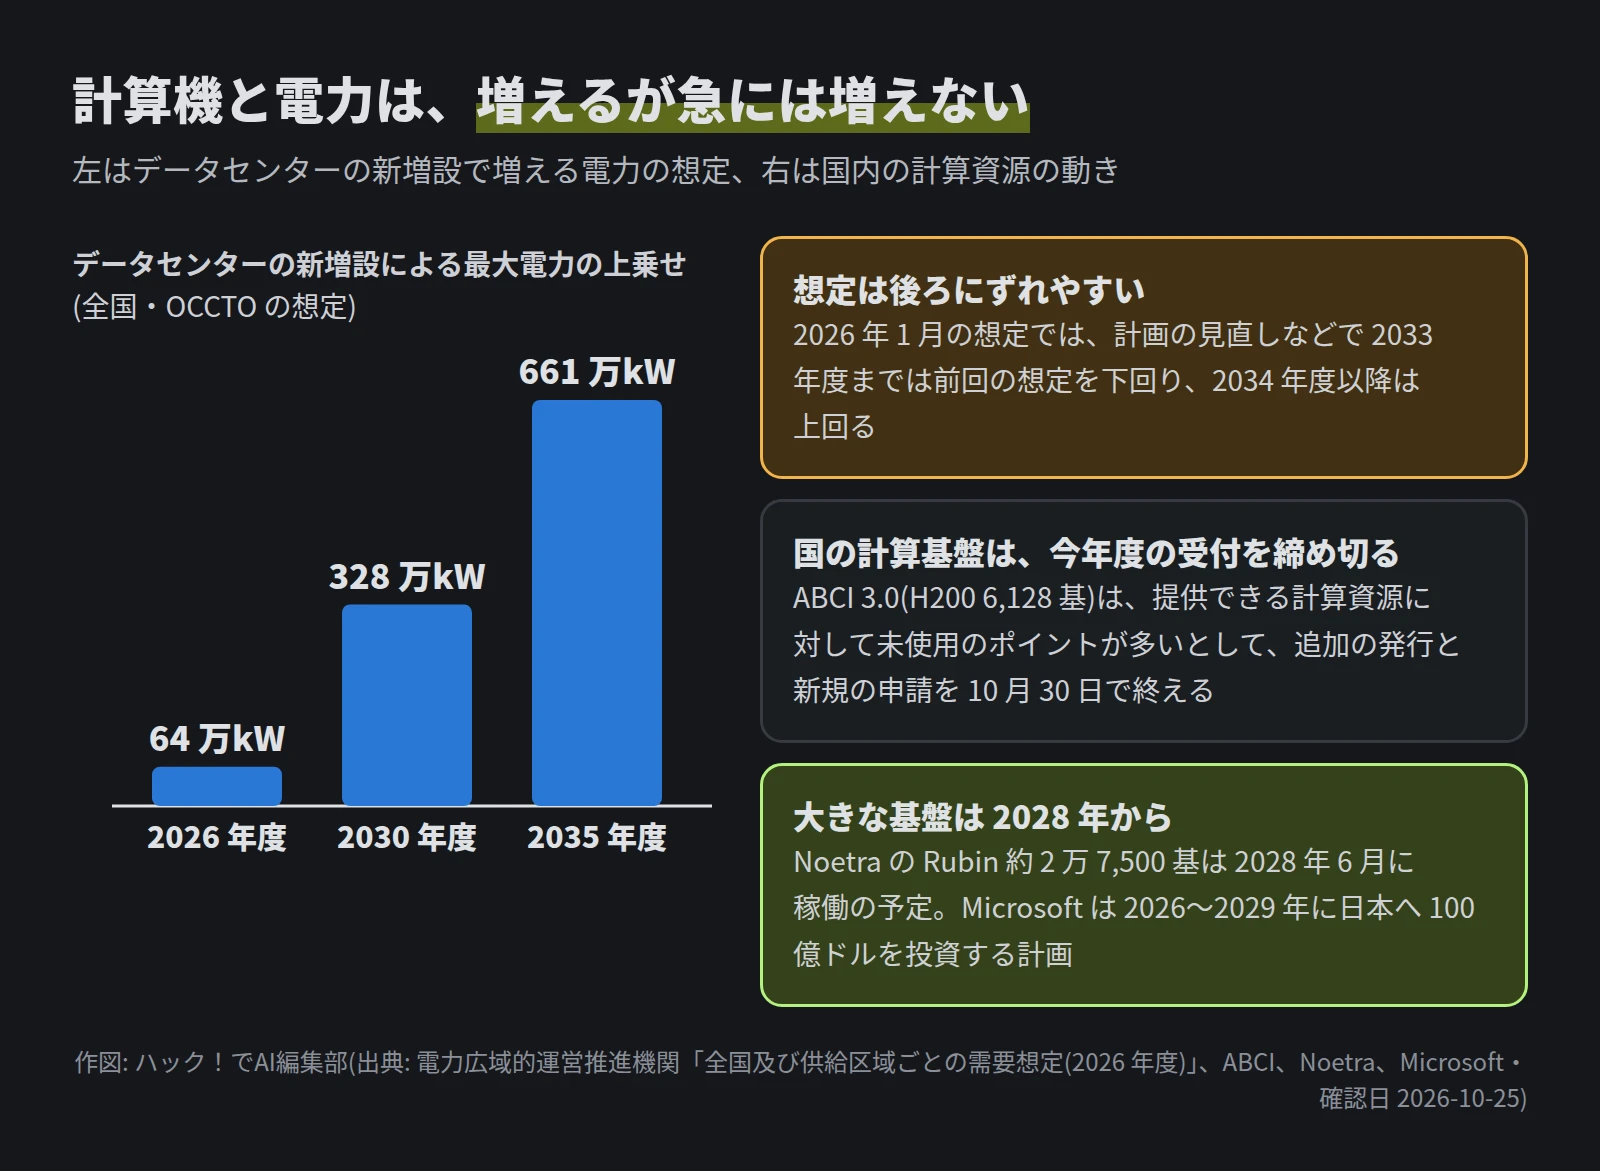
電力広域的運営推進機関(OCCTO)は 2026 年 1 月、データセンターの新増設で増える最大電力を、2030 年度に 328 万 kW、2035 年度に 661 万 kW と想定しました。同じ資料は、計画の見直しなどで 2033 年度までは前回の想定を下回るとしています。国の計算基盤 ABCI 3.0 も、提供できる計算資源に比べて未使用のポイントが多いとして、2026 年度のポイントの追加発行と新規の利用申請の受付を 10 月 30 日で終えます。
2030 年までの 6 つの予想
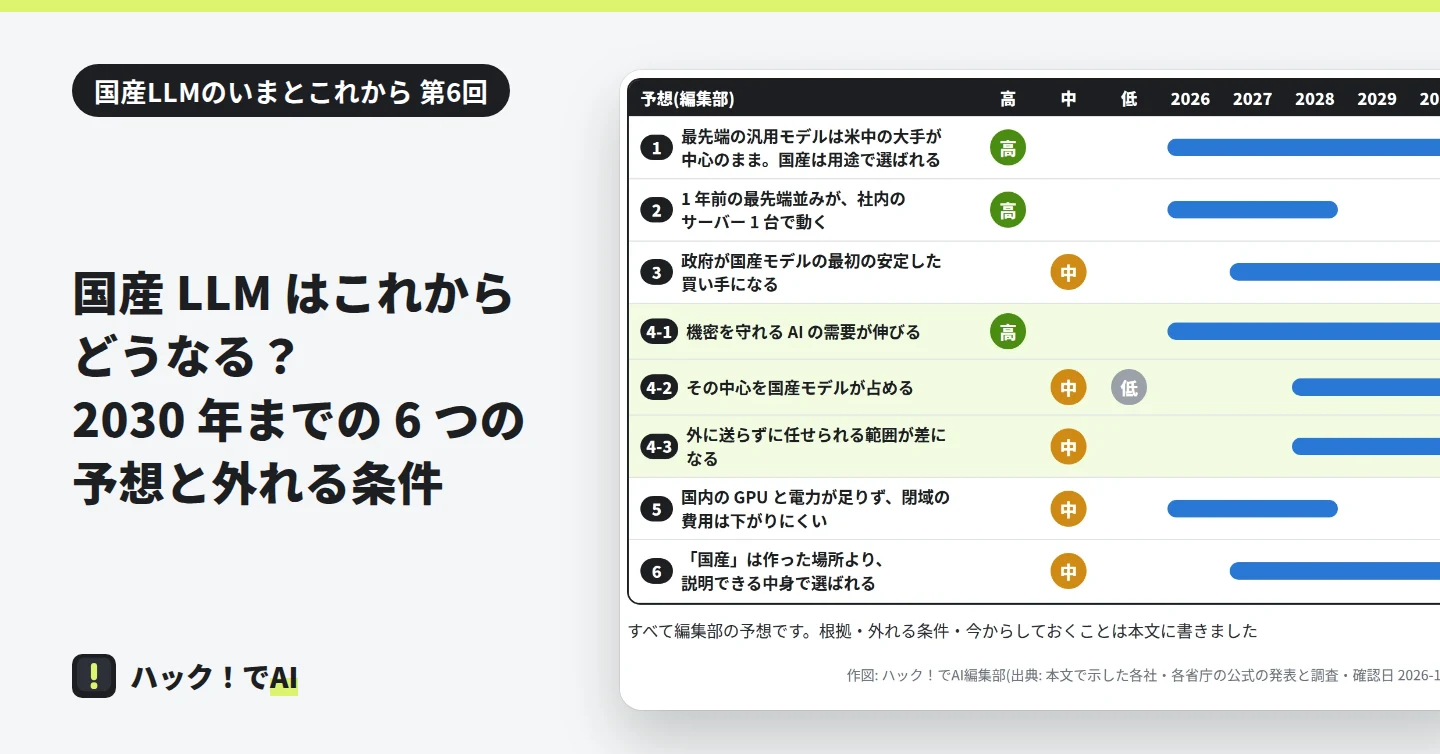
ここからが編集部の予想です。先に 1 枚の図にまとめ、そのあと予想ごとに根拠と外れる条件を書きます。
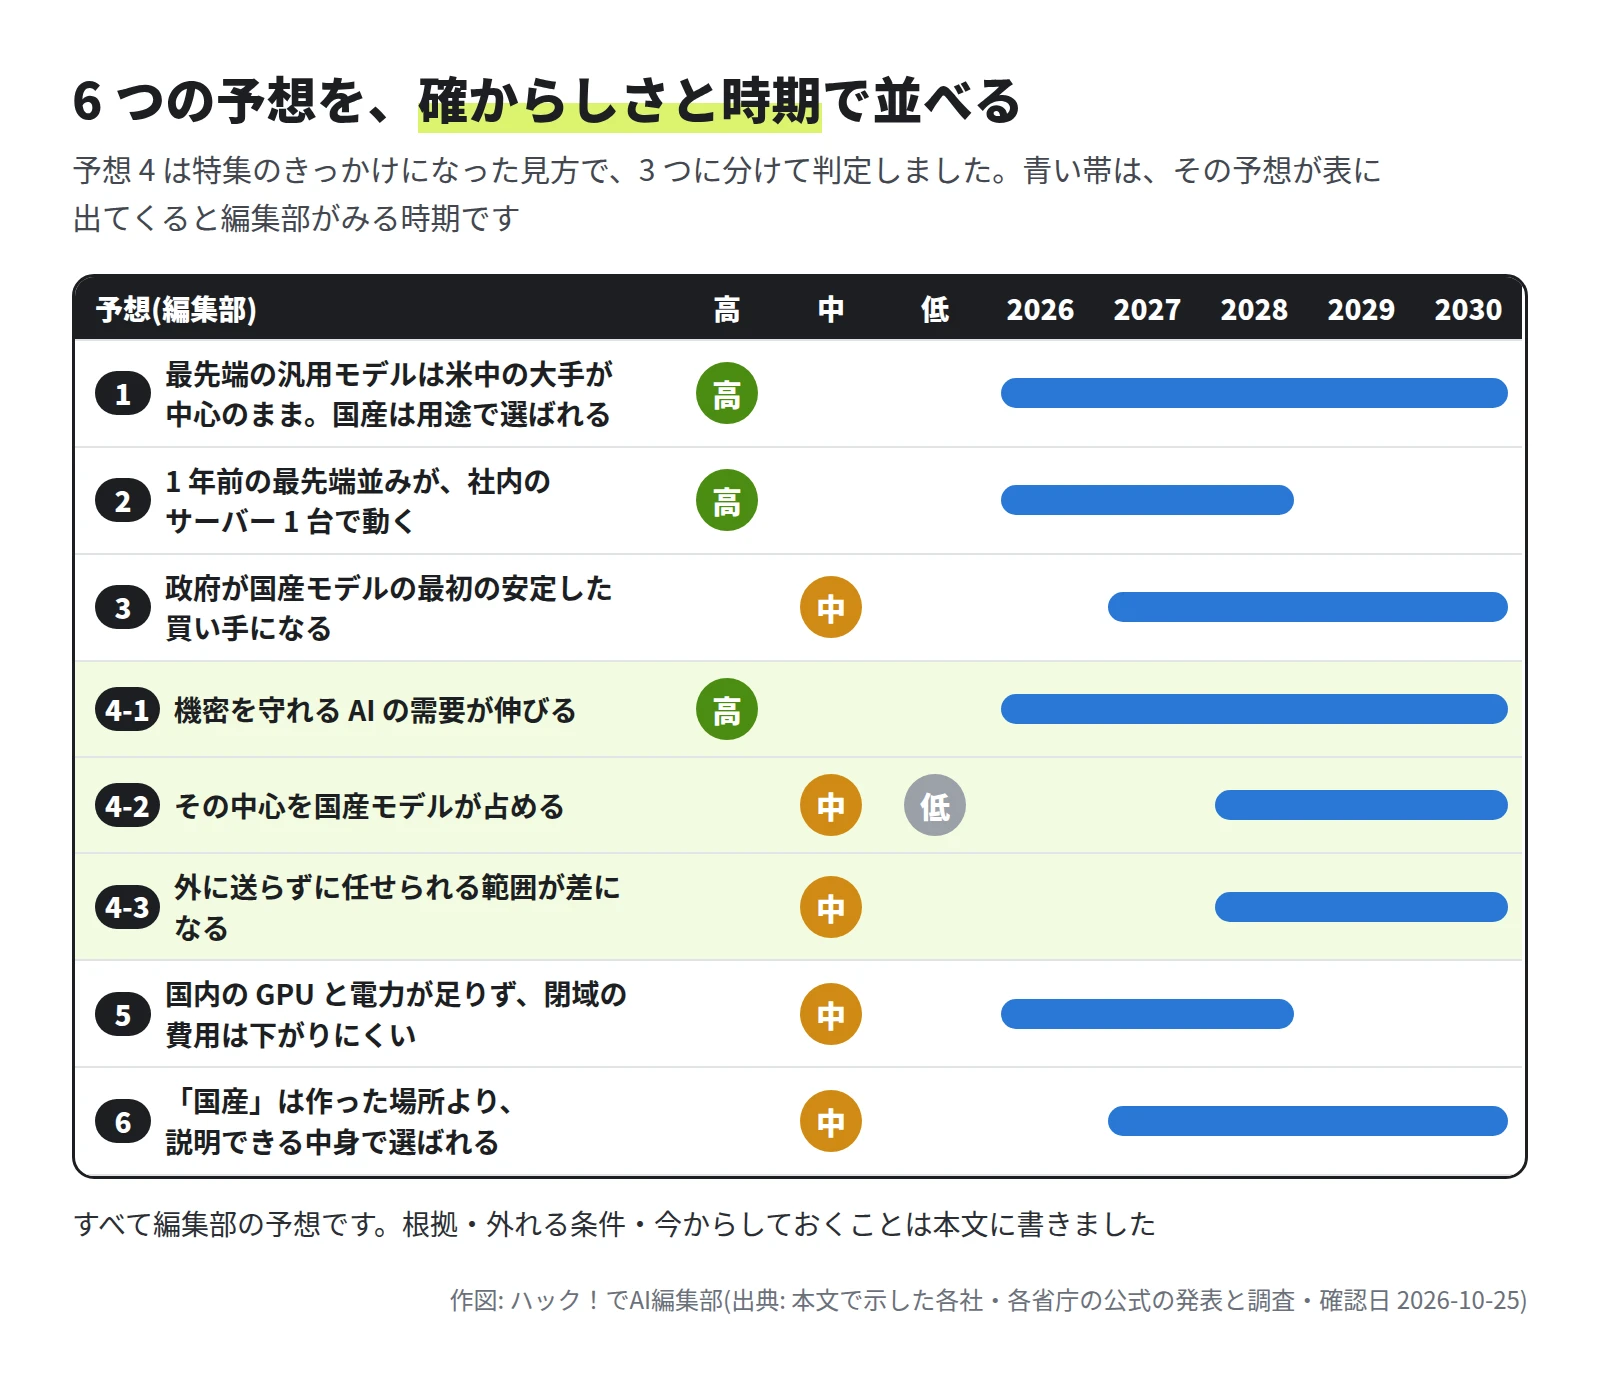
予想 1: 最先端の汎用モデルは米中の大手が中心のまま。国産は用途を選んで使われる
何が起きるか(2030 年まで): 最も性能の高い汎用モデルを作る競争は、米国と中国の大手が中心のまま続きます。国産の汎用モデルは最先端の少し後ろの性能で、日本語の文書・行政・業界の仕事など、用途を選んで使われる見込みです。
根拠: 費用は年 3.5 倍で伸び、国の予算は米大手 4 社の設備投資の約 230 分の 1 です。国の計画の重心も、別のところにあります。2026 年 7 月の人工知能基本計画が日本の勝ち筋に挙げたのは、「バーティカル AI」と「フィジカル AI」です。前者は業界・業務に特化した AI、後者はロボットなど現実の世界で動く AI を指します。日本語の文章でも、編集部が 6 つのモデルの敬語や要約を比べた回では、日本の会社のモデルの点はほかと同じ範囲でした(日本語に強い AI はどれ?)。
確からしさ: 高。費用の差が 2 桁あり、最先端の費用は年 3.5 倍で伸び続けているためです。
外れる条件: 学習の効率が大きく上がり、最先端を作る費用が下がる場合です。計算量を増やしても性能が伸びにくくなれば、後から追う側の不利は小さくなります。
今からしておくこと: 「国産か海外か」を 1 つに決めず、仕事ごとにモデルを替えられる作りにしておきます。構成の型は第 4 回、各社のモデルの地図は第 1 回にまとめました。
予想 2: 2028 年ごろには、1 年前の最先端並みのモデルが社内のサーバー 1 台で動く
何が起きるか: 2028 年ごろまでに、1 年前の最先端並みの公開モデルを、社内のサーバー 1 台で動かせるのが当たり前になる見込みです。
根拠: 公開モデルの遅れは約 4 か月、家庭用 GPU 1 枚で動くモデルの遅れは 6〜12 か月です。OpenAI の gpt-oss-120b は 80GB の GPU 1 枚で動き、商用でも使える Apache 2.0 のライセンスで配られています。NVIDIA の DGX Spark は 128GB のメモリで、2,000 億パラメーターまでのモデルで推論(学習済みのモデルで答えを作ること)ができます。
確からしさ: 高(性能の面)。公開モデルの遅れは数か月で、1 台で動く機材もすでに出ているためです。ただし、動かせることと、会社が実際に置くことは別です。米国の企業への調査では、LLM の利用のうち公開モデルが占める割合は、19% から 11% に下がりました(Menlo Ventures・2025 年 12 月)。
外れる条件: 最上位のモデルを閉じたまま出す会社が増え、公開が遅れる場合です。機材の値上がりもあります。DGX Spark は 2026 年 2 月、メモリの供給不足を理由に 3,999 ドルから 4,699 ドルに値上げされました。
今からしておくこと: 自社の仕事でよく出る問いを集め、どのモデルにも同じ問いで答えさせて比べられるようにしておきます。新しい公開モデルが出たとき、すぐに試せます。第 5 回では、GPU の無いサーバーと GPU 8GB の PC で試しました。モデルを小さくして動かす方法は、LLM の量子化とは?で測っています。
予想 3: 2027 年度から、政府が国産モデルの最初の安定した買い手になる
何が起きるか: 政府は 2027 年 4 月から、源内で国産モデルを有償で使い始める予定です。編集部は、政府がそのまま国産モデルの最初の安定した買い手になり、評価テストの観点も、民間で国産モデルを選ぶときの物差しとして参照されるようになるとみています。
根拠: 源内では 2026 年 5 月から 2027 年 3 月まで、約 18 万人の政府職員を対象にした大規模な実証が進んでいます。2027 年度に使うモデルは、行政の実務を想定した 300 問の評価テストで選ぶ予定です。人工知能基本計画も、国内で開発された AI モデルの積極的な活用を、源内の方針に書き込みました。
確からしさ: 中。予定は公式に出ていますが、評価結果はまだ公表されていません。どのモデルを、どの規模で買うかも決まっていません。7 件の候補のうち 2 社は、契約の前に辞退しました。
外れる条件: 評価で海外のモデルとの差が大きく、調達が小さくなるか、先に延びる場合です。
今からしておくこと: 2027 年 1 月ごろの評価結果の公表を、自社の候補選びの材料にします。行政の文書を多く扱う会社ほど、参考になるはずです。
予想 4: 機密を守れる業界専用の AI は伸びる。ただし担い手が国産とは限らない
この特集のきっかけになった文は、日本の勝ち筋は世界最大のモデルではなく、機密を守れる業界専用のプライベート AI にある、という見方でした。これからは、外に情報を送らずに、どこまで自律的に業務を処理できるかが差になる、という見立ても添えられていました。この見方を 3 つに分けて確かめました。
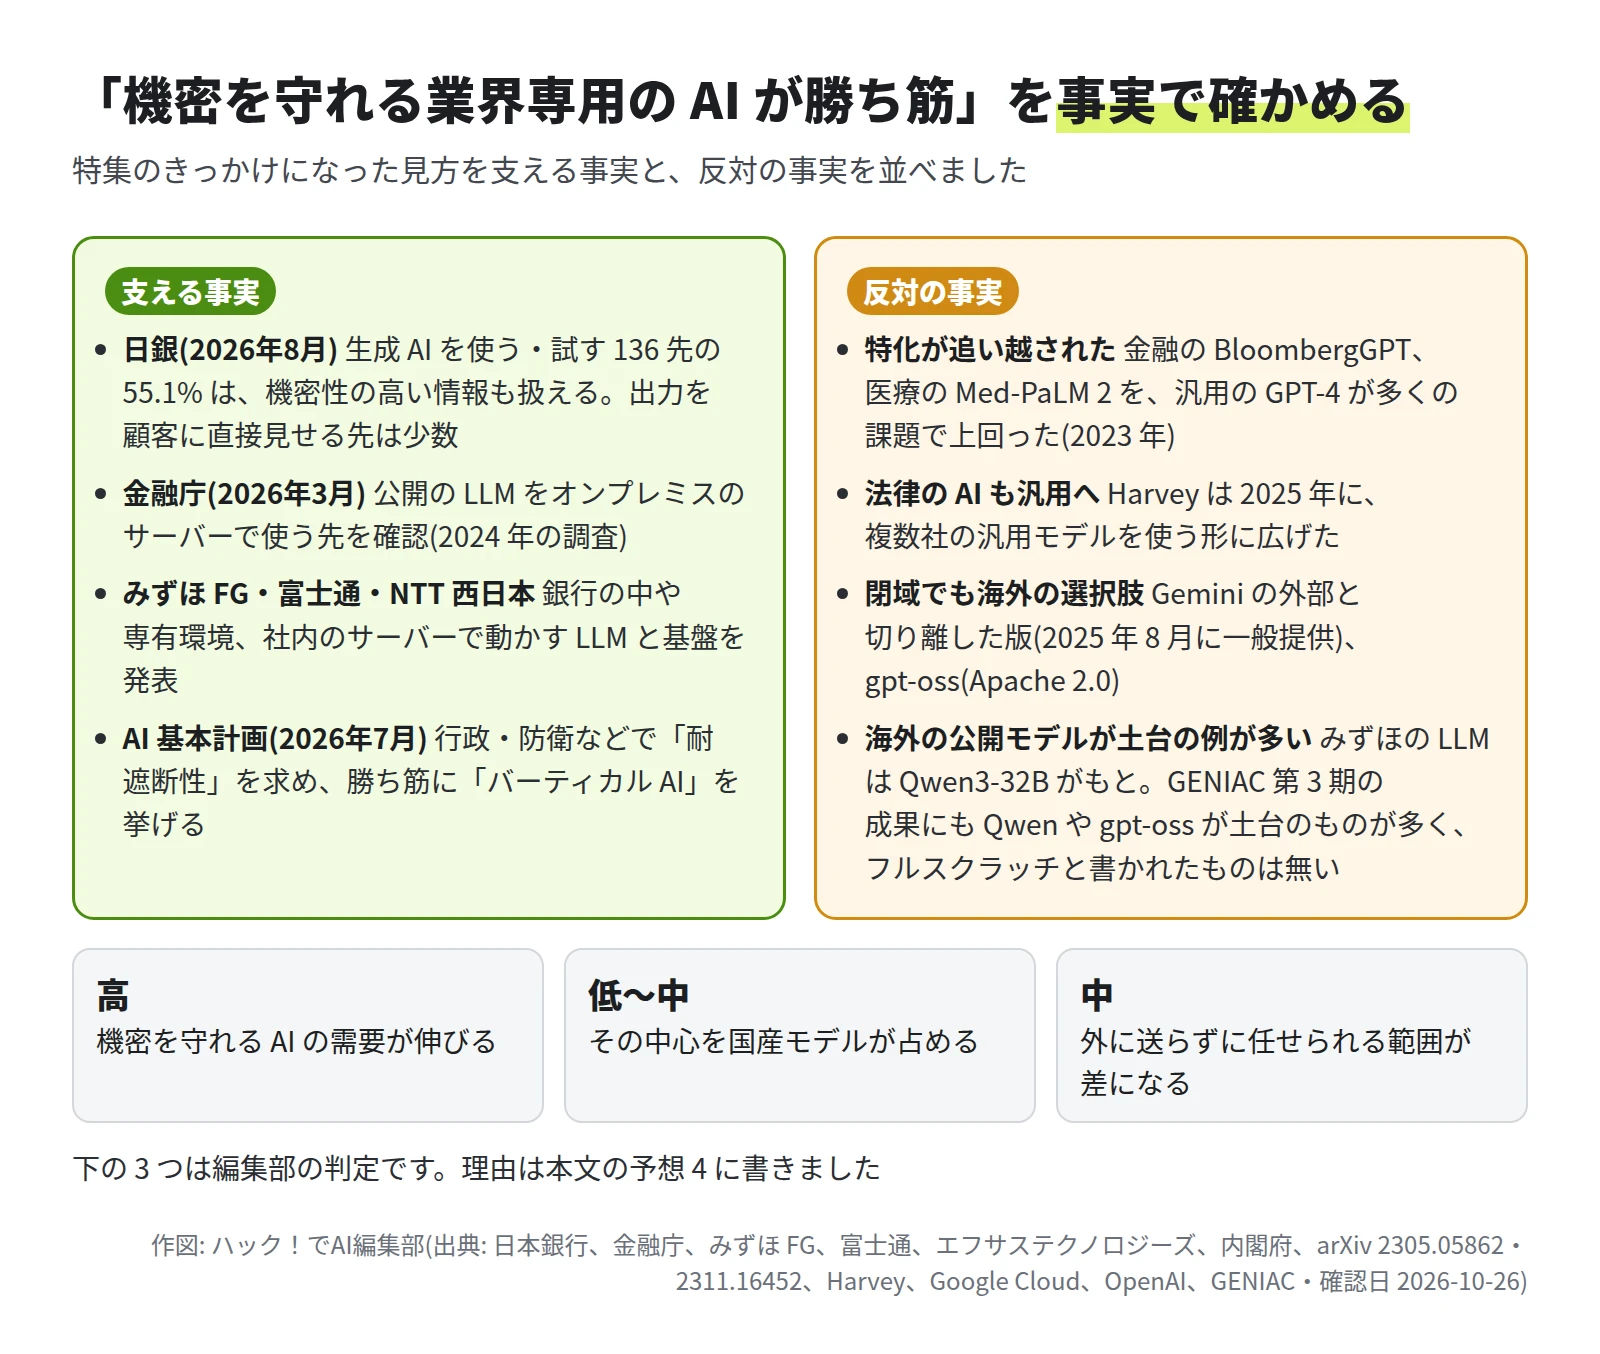
4-1 機密を守れる AI の需要は伸びる(確からしさ: 高): 日本銀行は 2026 年 8 月の調査で、金融機関の生成 AI の利用用途は「汎用的な事務処理から、顧客情報を利用するコア業務へと活用の幅が拡大している」とまとめました。生成 AI を使うか試している 136 先のうち 55.1% は、機密性の高い情報も扱えるとしています。一方、AI の出力を顧客に直接見せる先は「少数にとどまっている」との評価です。
金融庁は、オープンソースの LLM を社内のサーバーで動かす(オンプレミス)先や、各社の生成 AI サービスを、専用線でつないだ閉域(インターネットから切り離したネットワーク)で使う先を確認しました(2024 年の調査)。みずほ FG、富士通、NTT 西日本とエフサステクノロジーズは、銀行の中や専有環境、社内のサーバーで動かす LLM と基盤を発表しています。使い道が機密を含む仕事へ広がっていることが公的な調査で分かり、それに合わせた製品も各社から出ているため、高としました。金融と製造の使い方は第 3 回にまとめました。
4-2 その中心を国産モデルが占める(確からしさ: 低〜中): 反対の事実が多くあります。2023 年には、業界に特化したモデルが汎用モデルの世代交代で追い越される例が続きました。金融の BloombergGPT と比べた研究では、比べられた 5 つの課題のうち、固有表現の抽出を除く 4 つで、汎用の GPT-4 が上回っています。医療でも、プロンプトを工夫しただけの GPT-4 が 9 つの評価のすべてで最高の成績を出し、Med-PaLM 2 などの特化モデルを上回りました。法律の AI サービス Harvey も、2025 年に複数社の汎用モデルを使う形に広げました。
閉域で動かす選択肢も、国産だけではありません。Google は 2025 年 8 月、外部のネットワークから切り離した環境で動く Gemini を一般提供し、KDDI は大阪堺のデータセンターで 2027 年の商用提供を目指しています。
国産と呼ばれるモデルにも、海外の公開モデルを土台にしたものが多くあります。みずほ FG の金融特化 LLM は Qwen3-32B がもとです。GENIAC 第 3 期の成果の一覧でも、Qwen や gpt-oss を土台にしたモデルが多く、フルスクラッチ(ゼロから学習)と書かれたものはありません。業界専用の AI の多くは、海外の公開モデルを土台に国内で追加学習させる形になる、と編集部は見ています。それでも低と言い切らないのは、政府の調達(予想 3)や行政の文書のように、国産モデルが選ばれやすい場面もあるためです。
4-3 外に送らずに任せられる範囲が差になる(確からしさ: 中): AI エージェント(目標を受けて、自分で手順を決めて作業する AI)の性能では、公開モデルが首位に迫っています。同じ条件で比べた SWE-bench Verified(プログラムの不具合を直す課題)では、2026 年 2 月時点の首位が Claude 4.5 Opus の 76.8% でした。公開モデルの MiniMax M2.5 は 75.8% で、差は 1 ポイントです(AI Index 2026)。ただし、エージェントは構造化された課題でも 3 回に 1 回ほど失敗します。
差になるのは、モデルの賢さだけではなさそうです。AI セーフティ・インスティテュート(AISI)は 2026 年 7 月、評価観点ガイドの改訂で AI エージェントの評価観点を加え、評価項目の例に「情報及びツールに対するアクセス権限が必要な範囲に限って付与されているか」を挙げました。外に送らずに任せるには、権限・記録・人の承認の仕組みが欠かせません。閉域で動かせる公開モデルの力は伸びていますが、国産モデルのエージェントの性能を第三者が比べた結果は見つけられなかったため、中としました。
外れる条件: 3 つそれぞれに書きます。
- 4-1: クラウドの AI でも、国内で処理して記録を残さない契約が広く使えるようになる場合です。外に出さないこと自体の重みが下がります。
- 4-2: 源内の評価で国産モデルが海外のモデルと並ぶ結果が出て、政府の調達をきっかけに民間の採用も国産に集まる場合です。
- 4-3: AI エージェントに任せる仕事が広がらず、人が確かめてから使う形にとどまる場合です。任せられる範囲の違いが、差になりません。
今からしておくこと: 社内の情報を区分し、外に出せない情報を使う仕事を書き出します。区分のしかたは、それでも機密を AI で扱いたいときの方法の 1 章が参考になります。
予想 5: 2028 年ごろまでは計算機と電力が足りず、閉域で動かす費用は下がりにくい
何が起きるか: 2028 年ごろまで、国内で GPU を必要なときに借りにくい時期が続き、社内や国内で動かす AI の費用は下がりにくい見込みです。
根拠: ABCI 3.0 は、2026 年度のポイントの追加発行と新規の利用申請の受付を 10 月 30 日で終えます。大きな計算基盤の稼働は、Noetra の 2028 年 6 月が予定です。データセンターの電力の想定も、計画の見直しで 2033 年度までは前回より低くなりました。DGX Spark の値上げのように、メモリの不足は機材の値段にも表れています。
確からしさ: 中。供給も増えるためです。Microsoft は 2026〜2029 年に日本へ 100 億ドルを投資する計画で、同じ性能で比べた推論の値段も、2022〜2024 年に大きく下がりました(AI Index 2025)。
外れる条件: GPU とメモリの供給が需要に追いつき、値下がりする場合です。AI への投資が縮み、余った計算資源が安く出回る場合も外れます。
今からしておくこと: 社内で動かすなら、機材を買う案と国内のクラウドで借りる案を並べて見積もります。要る性能を先に決めておくと、機材を小さくできます。オンプレミスの機材の参考価格と、国内のクラウドで GPU を借りる月額は、第 4 回で並べました。
予想 6: 「国産」は、作った場所より、中身を説明できるかで問われる
何が起きるか: 2027〜2028 年にかけて、モデルを選ぶ条件の重心が「国内で作ったか」から「土台のモデル・学習データ・ライセンスを説明できるか」に移る見込みです。
根拠: デジタル庁は源内の選定の基準に、独自開発モデルか派生モデルかの区別などが「具体的に説明可能であること」を入れました。海外のモデルを元にしたものを外す決まりはなく、GENIAC も、海外の基盤モデルに追加で事前学習(大量の文章でモデルの土台を作る学習)をするモデルを支援の対象にしています。人工知能基本計画は、特定の国や企業への過度な依存を避けるため「複数モデルを統御しながら利用する」としました。
線の引き方が違う国もあります。韓国では 2026 年 1 月、国の基盤モデルの事業の 1 次審査で、Naver Cloud が技術の独自性の条件を満たさないとして外れました。韓国の省は、公開されている映像と音声のエンコーダーを使い、重みを一から学習する条件を満たさなかったとしています(報道)。
重みを公開したモデルでは、発表文やモデルカードに加えて、公開の設定ファイルも作りを確かめる材料になります。東京科学大学などの Swallow は、Qwen3 Swallow のように、土台のモデルの名前をモデル名に入れて公開しています。Hugging Face で公開される設定ファイル(config.json)の architectures の欄には、アーキテクチャ(モデルの構造)の名前が書かれています。土台のモデルの名前が発表文に無いときは、ここも確かめる材料になります。
確からしさ: 中。政府の調達はすでに説明を求めていますが、民間の選び方にどこまで広がるかは分かりません。
外れる条件: 日本も韓国のように「ゼロから作ったものだけ」を条件にする場合や、値段と性能だけで選ばれ、出どころが問われない場合です。
今からしておくこと: モデルやサービスを選ぶときに、土台のモデル・ライセンス・学習データの説明・動かす場所を、書面で確かめる項目に入れます。国産 LLM の作り方の違いは、第 1 回で整理しました。
6 回を通して残った問い: 「国産を待つか」より先に決めること
確からしさを高とみた予想のうち、会社の判断に直接かかわるのは、機密を守れる AI の需要が伸びることと、手元で動くモデルが追いつくことです。その担い手が国産モデルになるかは、政府の評価が出る 2027 年以降にならないと見えてきません。待っていても、答えはすぐには出ません。
だから最初に確かめたいのは、モデルの名前ではなく自社の側です。
- 外に出せない情報を使う仕事を書き出す。情報を区分し、どの仕事がどの区分の情報を使うかを一覧にします。
- その仕事でよく出る問いを集め、答えを確かめる問題集にする。2027 年 1 月ごろの源内の評価の公表や、新しい公開モデルが出たときに、自社の物差しで比べられます。
どの予想が外れても、この 2 つは無駄になりません。国産・海外・公開モデルのどれを選ぶときにも、同じ材料として使えるからです。
特集はこの回で終わりです。最初から読む方は、第 1 回へどうぞ。
参考にした公式の情報
- Epoch AI「Will we run out of ML data? Evidence from projecting dataset size trends」(2022年11月)
- Epoch AI「Will we run out of data? Limits of LLM scaling based on human-generated data」(2024年6月)
- Meta「Open Source AI is the Path Forward」(2024年7月23日)
- Meta AI ブログ「Introducing Muse Spark: Scaling Towards Personal Superintelligence」(2026年4月8日)
- Hugging Face「Muse-Spark-Open-816B-A42B」(Meta のモデルカード)
- Reuters(Yahoo Finance 配信)DeepSeek の登場と NVIDIA 株の下落の記事(2025年1月27日)
- Epoch AI「Trends」
- Epoch AI 研究開発の計算費と学習の計算費の分析(2026年3月23日)
- Alphabet「2026 Q2 Earnings Call」書き起こし(2026年7月22日)
- Fortune Amazon の設備投資の見通しの記事(2026年7月30日・報道)
- Meta「Third Quarter 2026 Results」(PDF・2026年10月21日)
- Microsoft「FY26 Fourth Quarter Earnings Conference Call」書き起こし(2026年7月29日)
- 日本銀行「外国為替市況(日次)」2026年10月23日(PDF)
- 内閣府「令和8年度 AI 関連予算」
- 内閣府「令和9年度 概算要求における AI 関連予算」
- 経済産業省「令和8年度 当初予算の概要」
- Epoch AI 公開モデルと閉じたモデルの性能差の分析(2026年5月29日)
- NIST CAISI による DeepSeek V4 Pro の評価(2026年5月1日)
- Epoch AI 家庭用 GPU で動くモデルと最先端の差の分析(2025年8月15日)
- Hugging Face「openai/gpt-oss-120b」(OpenAI のモデルカード)
- NVIDIA「DGX Spark」
- NVIDIA 開発者フォーラム「2/23/2026 Price Change Announcement」
- Stanford HAI「AI Index Report 2025」
- Stanford HAI「AI Index Report 2026」第2章
- Menlo Ventures 企業の生成 AI の利用の調査(2025年12月9日)
- デジタル庁「国内開発 LLM の公募の結果」(2026年3月6日)
- デジタル庁「ガバメント AI 源内の大規模実証」(2026年3月6日)
- デジタル庁「2027年度の国内開発 LLM の調達の予告」(2026年5月29日)
- デジタル庁「さくらのクラウドでの国産 LLM の実証」
- NEDO「AI ロボット・フィジカル AI を見据えたマルチモーダル基盤モデル開発事業」実施予定先の決定(2026年6月30日)
- Noetra ニュースリリース(2026年7月16日)
- FRONTia
- 電力広域的運営推進機関「全国及び供給区域ごとの需要想定(2026年度)」(2026年1月21日)
- ABCI「2026年度のABCIポイント発行終了予定のお知らせ」(2026年10月15日)
- ABCI「計算資源」
- Microsoft「日本への 100 億ドルの投資」(2026年4月3日)
- 内閣府「人工知能基本計画」(2026年7月14日 閣議決定)
- 日本銀行「金融機関における生成AIの利用状況とリスク管理」(2026年8月6日)
- 金融庁「AI ディスカッションペーパー(第1.1版)」(2026年3月3日)
- みずほフィナンシャルグループ「金融特化 LLM」の発表(PR TIMES・2026年3月5日)
- エフサステクノロジーズ・NTT 西日本 ニュースリリース(2026年8月26日)
- エフサステクノロジーズ「Private AI Platform on PRIMERGY」
- 富士通 プレスリリース(2026年7月28日)
- Li ほか「Are ChatGPT and GPT-4 General-Purpose Solvers for Financial Text Analytics?」(arXiv 2305.05862)
- Nori ほか「Can Generalist Foundation Models Outcompete Special-Purpose Tuning? Case Study in Medicine」(arXiv 2311.16452)
- Harvey ブログ 使うモデルを広げる発表(2025年5月13日)
- Google Cloud ブログ Gemini on Google Distributed Cloud の一般提供の発表(2025年8月)
- KDDI ニュースリリース(2026年4月30日)
- AISI「AI セーフティに関する評価観点ガイド(第1.20版)」(2026年7月7日)
- GENIAC「第3期 成果」
- NEDO「ポスト5G情報通信システム基盤強化研究開発事業」公募(2026年1月27日)
- The Korea Times 韓国の国の基盤モデル事業の 1 次審査の記事(2026年1月15日)
- Hugging Face「tokyotech-llm/Qwen3-Swallow-8B-RL-v0.2」
連載・特集 国産LLMのいまとこれから
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。