 佐々木 航
この記事でわかること
- 外と通信しない環境で、公開モデルの正答を測った
- 考える国産 8B が、2 か所を組み合わせる問を解いた
- 共有のサーバーで動かすときの止め忘れの防ぎ方
確認した環境: llama.cpp b11852(Linux の CPU 版・Windows の CUDA 13.4 版)・Ruri v3・各モデルの公開の GGUF を、GPU の無い検証用のサーバー(CPU 24 コア・メモリ 94GB)と GPU の付いた PC(RTX 5060 Ti 8GB)で実行 / クラウドの 2 つは 2026年10月15日の記録 / 2026年10月26日に確認
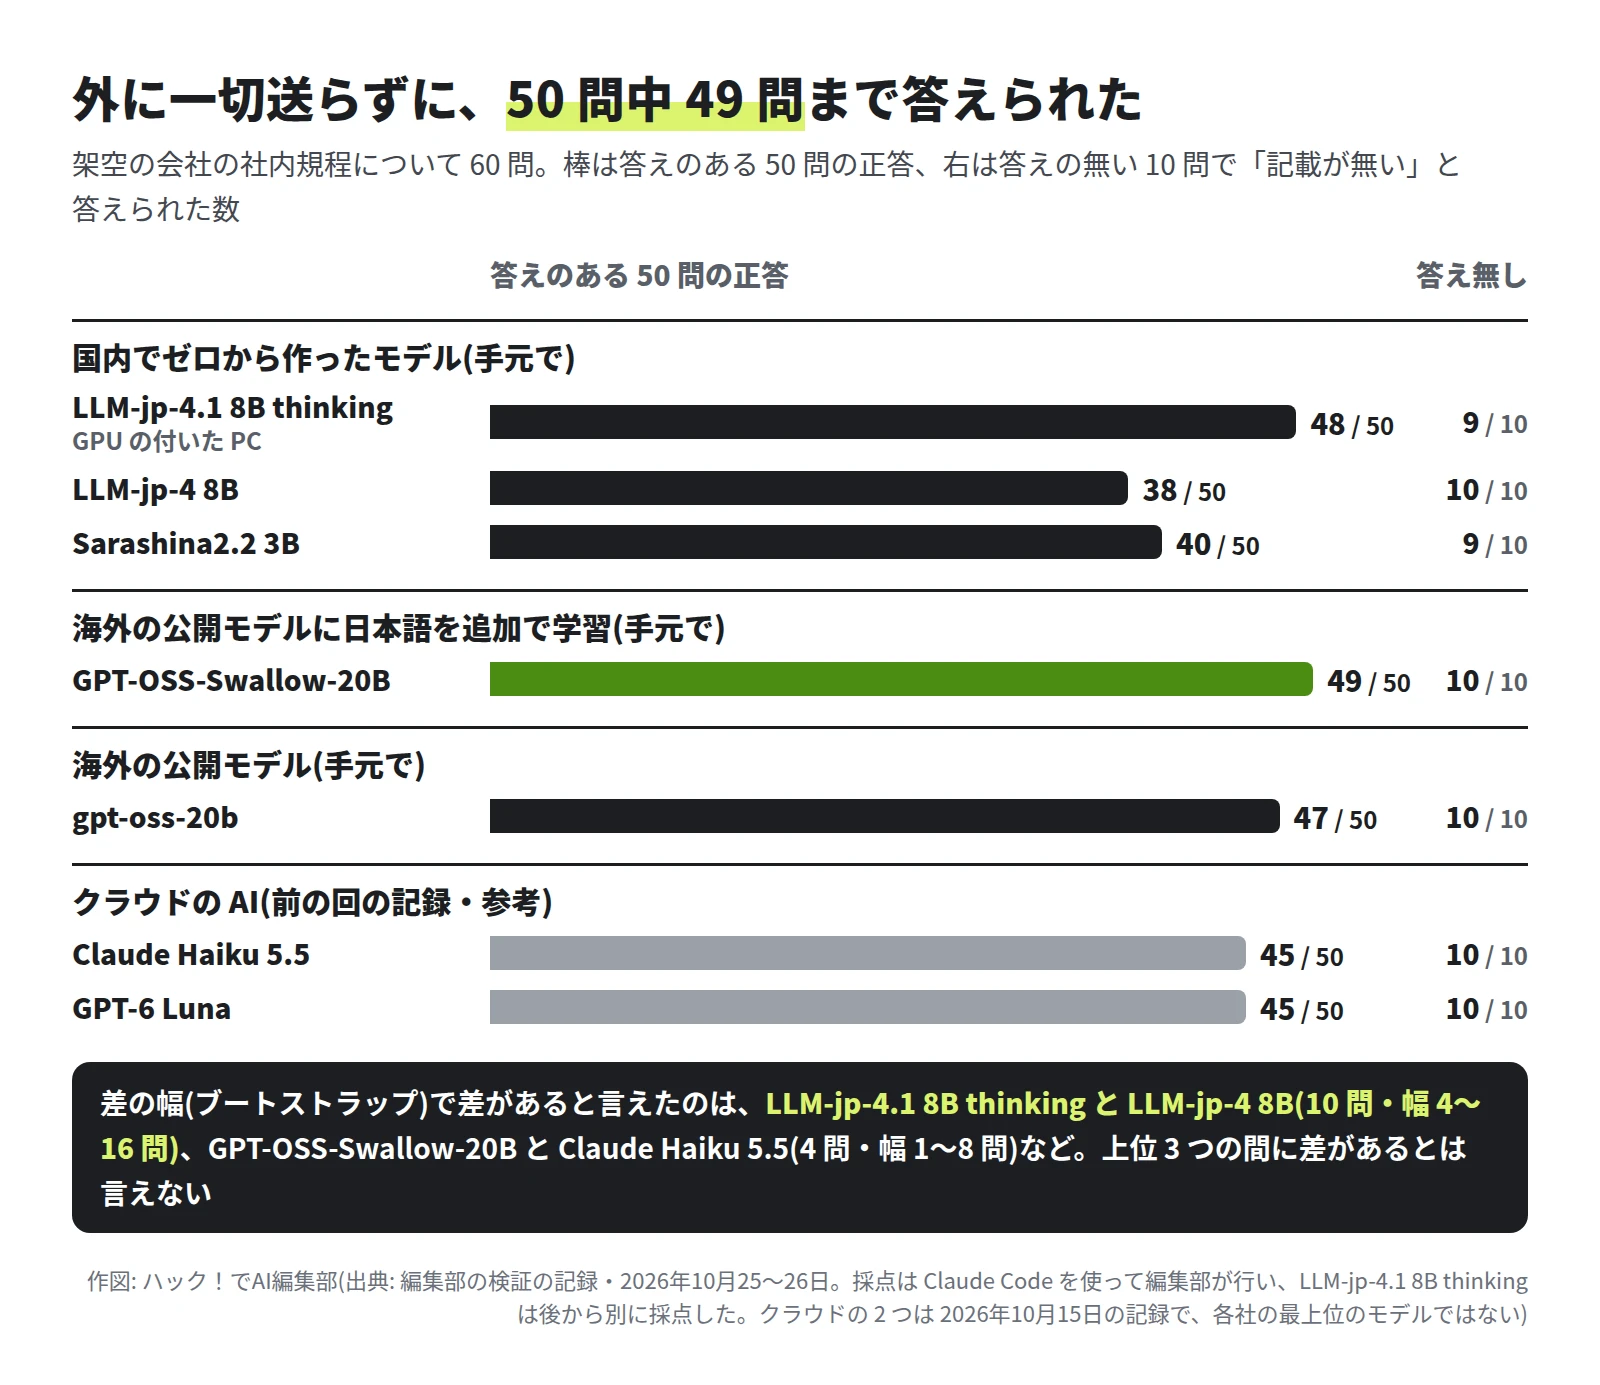
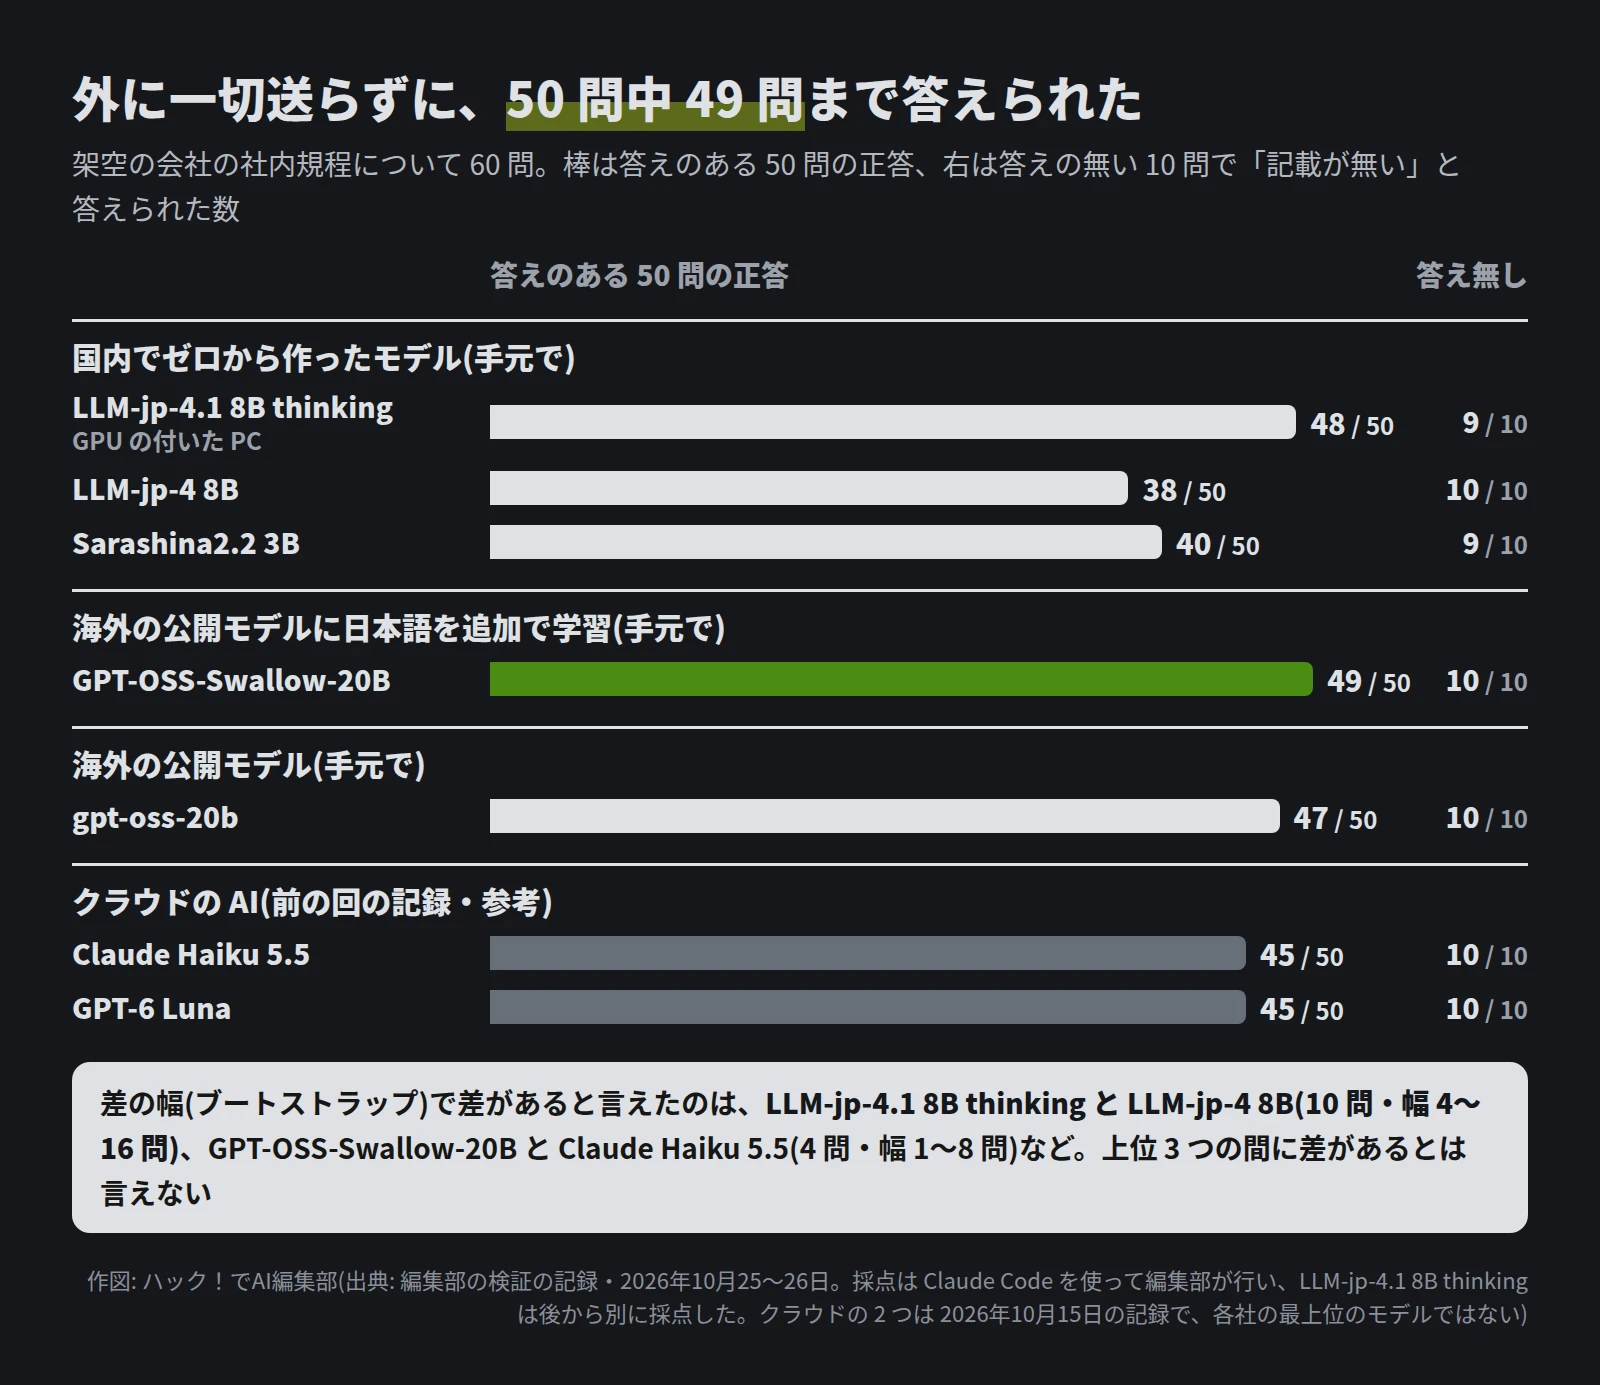
ネットを切ったサーバーで動かした公開モデルが、架空の会社の社内規程の問に、50 問中 49 問を正答しました。GPT-OSS-Swallow-20B で、東京科学大学と産業技術総合研究所が gpt-oss-20b に日本語を追加で学習させたモデルです。同じ資料と同じプロンプト(AI への指示と資料をまとめた入力)で、クラウドの Claude Haiku 5.5 と GPT-6 Luna は 45 問でした。
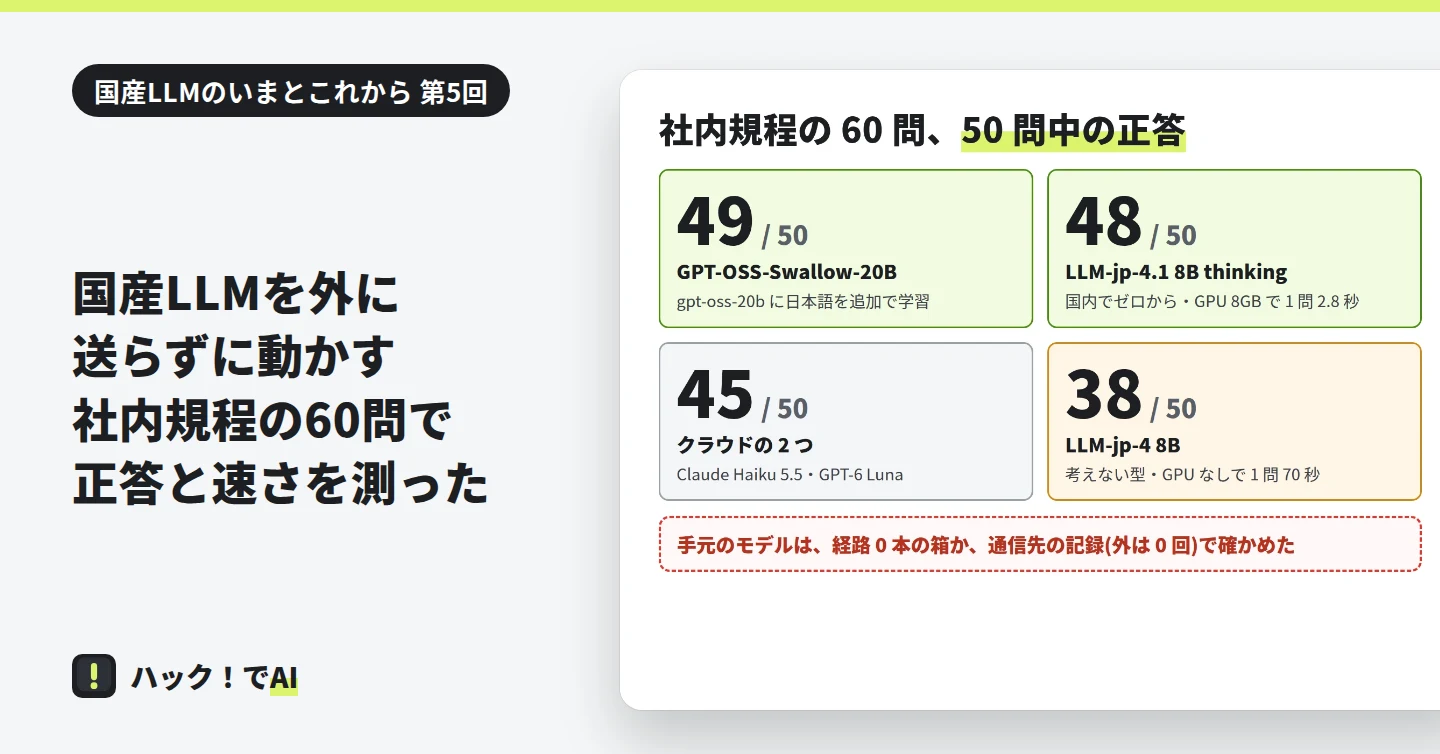
国内でゼロから作られたモデルでは、国立情報学研究所の最新の LLM-jp-4.1 8B thinking が 48 問を正答しました。GPU 8GB の PC で、1 問 3 秒弱です。上位の 3 つ(47〜49 問)の差は、差があるとは言えない程度でした。
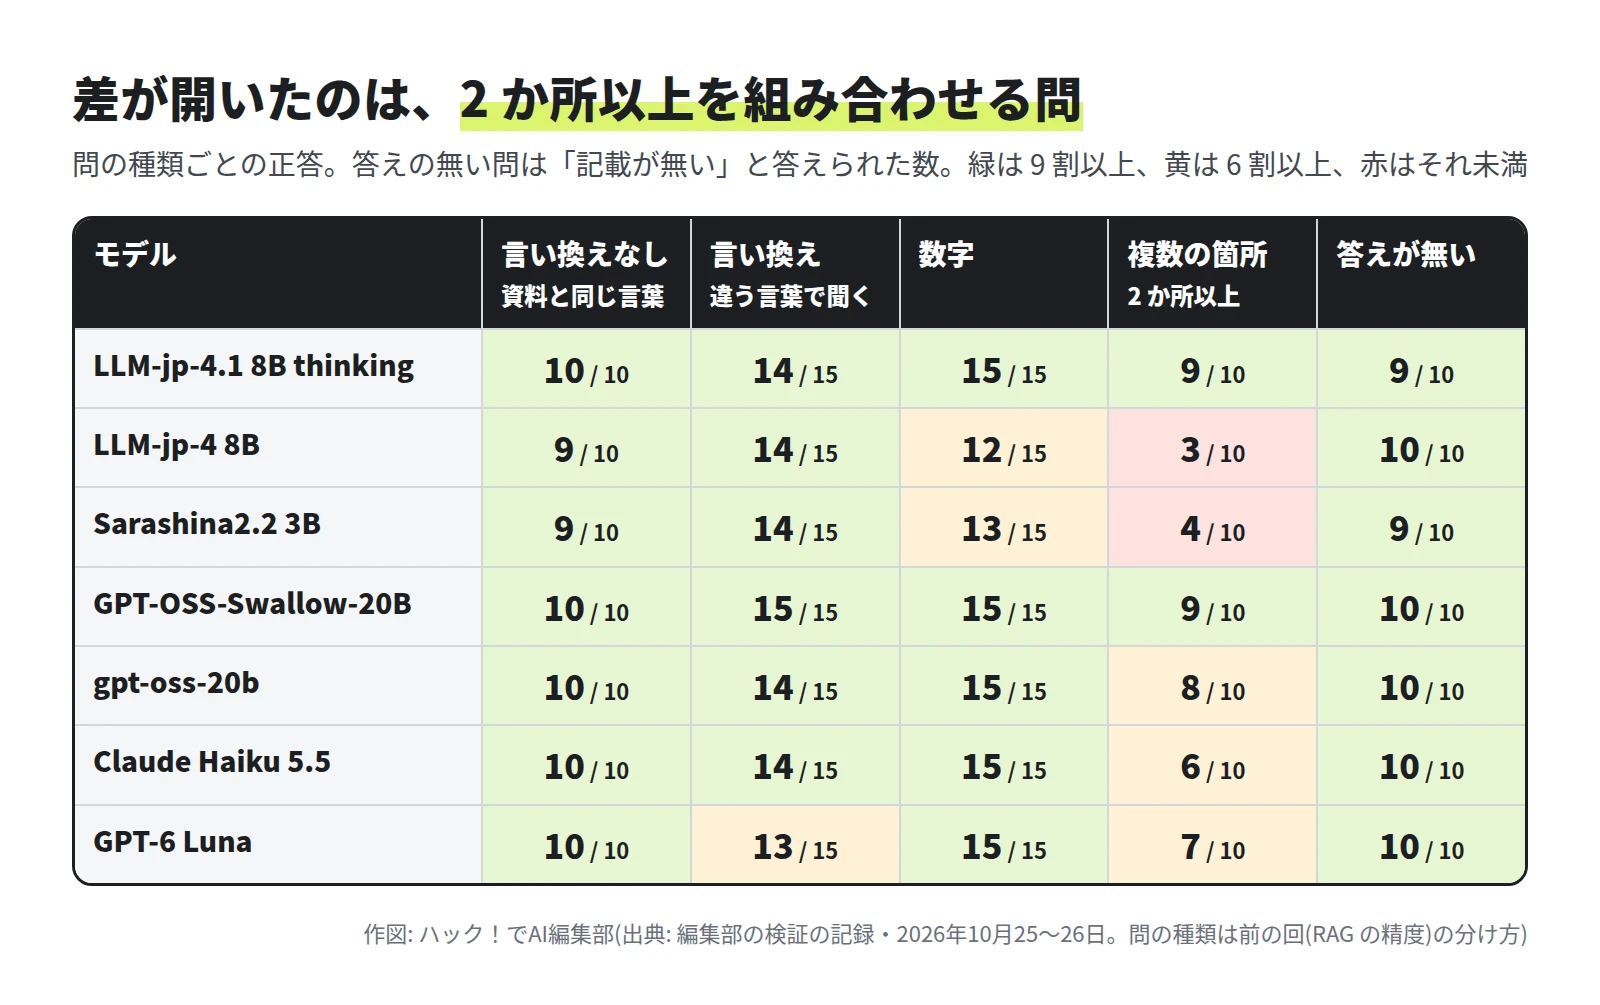
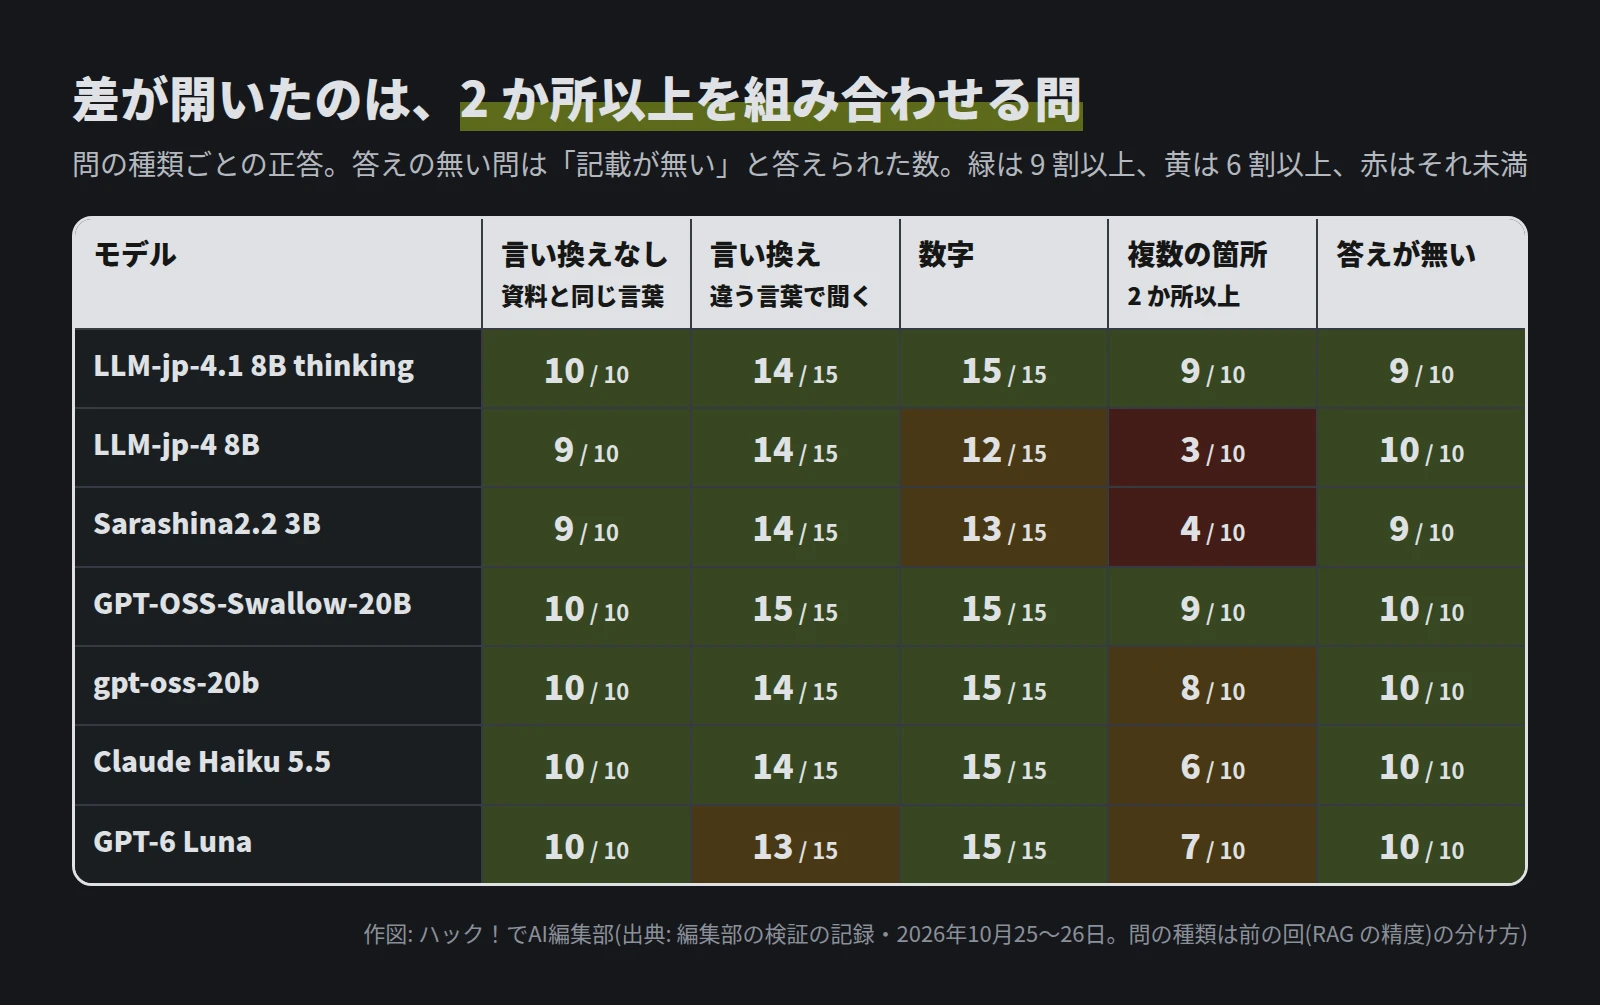
考えない型の LLM-jp-4 8B と Sarashina2.2 3B は 38〜40 問です。1 か所を読めば答えられる問ではクラウドと大きく変わらず、2 か所の規程を組み合わせる問で差が開きました。
「外に出さない」構成は、社内の窓口にどこまで使えるか
第 4 回の機密を扱う生成 AI の構成で、いちばん外に出ない形として、自社のサーバーでモデルを動かすオンプレミスを挙げました。ベンダーの製品として契約しなくても手元で動かせるのは、重み(学習で決まったモデルの中身の数値)が公開されたモデルです。第 1 回の国産 LLM の地図で見たとおり、tsuzumi 2・cotomi・Takane・PLaMo の製品版は、重みが公開されていません。
そこで、手元で動かせる公開モデルが、社内の問い合わせにどこまで答えられるかを測りました。資料と問は、RAG の精度を測った回と同じです。架空の会社「株式会社ソラマド計測」の社内資料 10 本(約 5 万字)と、60 問を使いました。60 問のうち 10 問は、資料に答えが書いていない問です。
今回は、RAG(検索拡張生成。質問に合う資料を探して AI に渡し、それを根拠に答えさせる方法)の検索も答えも、すべて外に出ない場所で動かします。クラウドの AI は前の回に記録した答えを使い、同じ資料・同じプロンプトで並べました。
まず、外に出られない箱を作った
検証用のサーバー(CPU 24 コア・メモリ 94GB・GPU なし)で、Linux の unshare というコマンドを使い、ネットワーク名前空間(通信の設定を別に持つ区画)を作りました。箱の中にあるのは、自分自身への通信(ループバック)だけです。
箱の中では、外への経路が 0 本で、名前の解決(huggingface.co のような名前から接続先を調べること)もできません。この 2 つは、モデルを動かすたびにログの最初の行に残しました。経路が無いので、IP アドレスを直接指定しても外には届きません。
ネットを使ったのは、箱を作る前に、モデルのファイルと検索のモデルをダウンロードしたときだけです。モデルのファイルは、SHA256 のハッシュ値を配布元の値と照合しました。ハッシュ値は、ファイルが壊れたり差し替えられたりしていないかを確かめる値です。
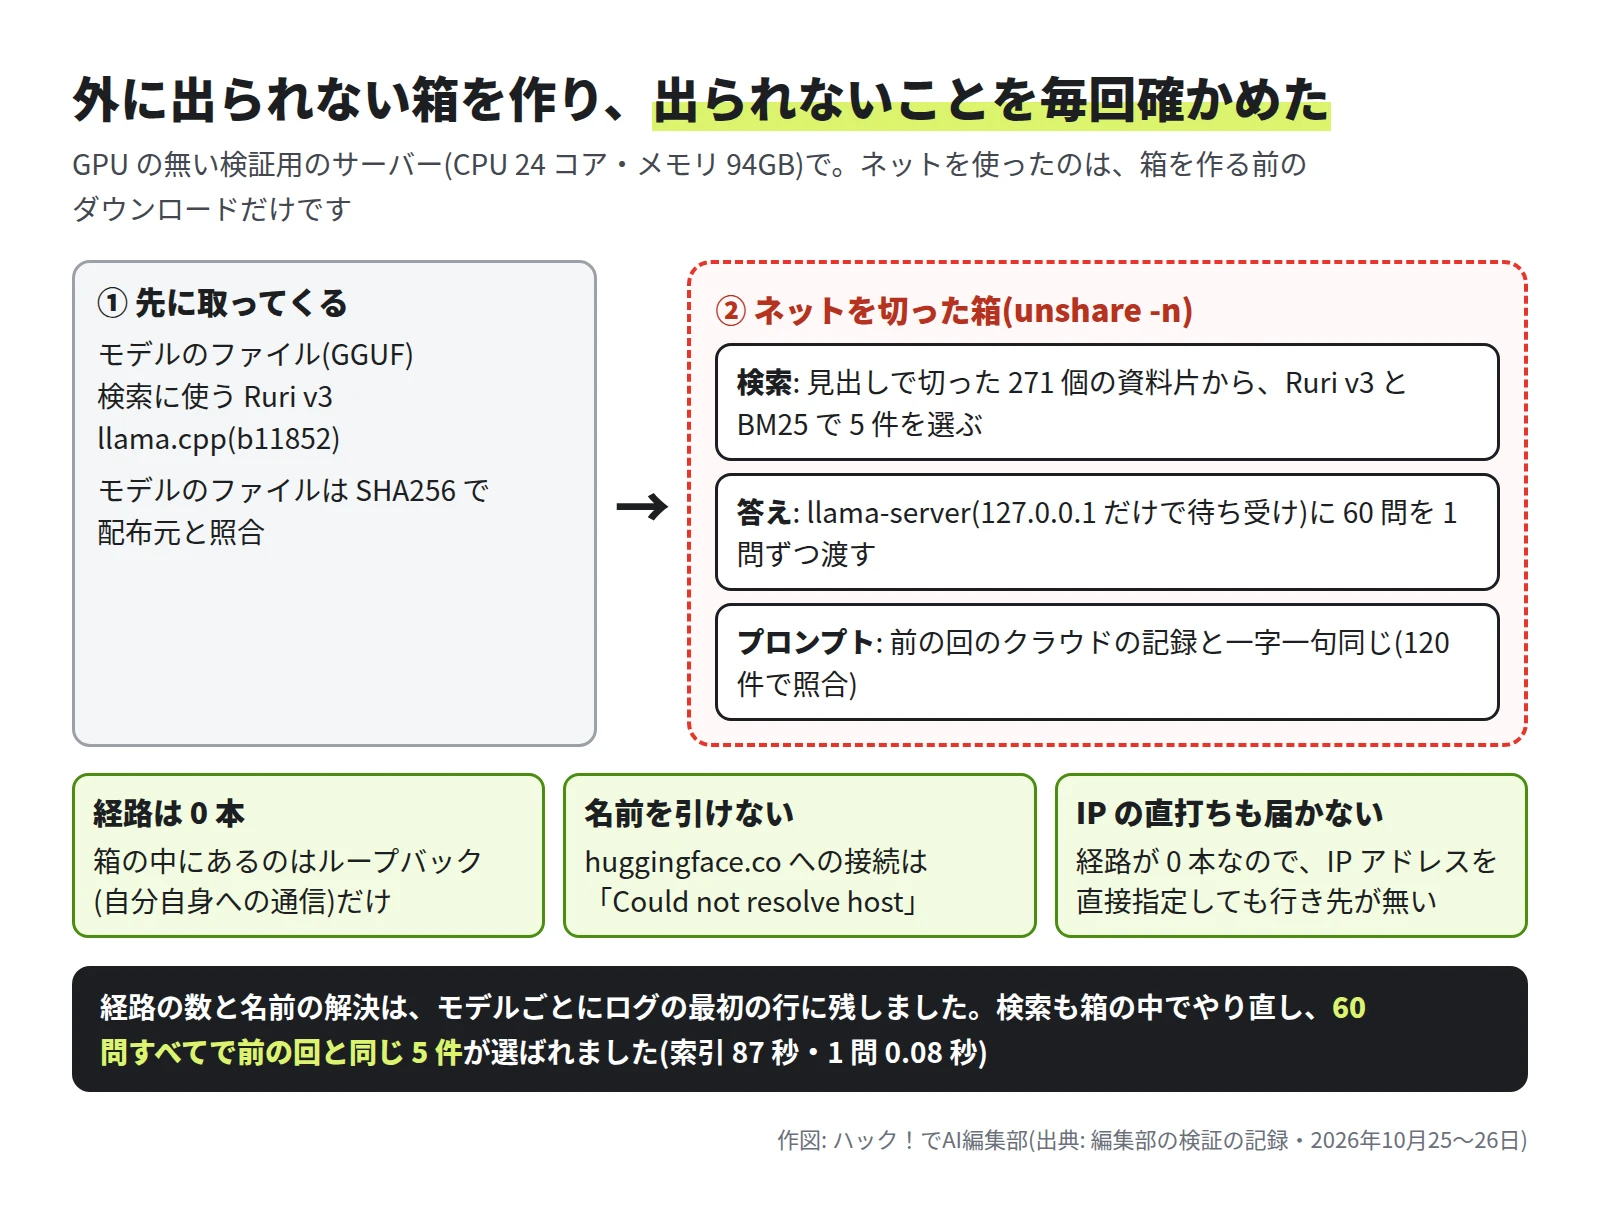
検索も箱の中でやり直しました。資料を見出しで 271 個に切り、日本語の埋め込みモデル(文の意味を数値の並びにするモデル)Ruri v3 と、単語で探す BM25 を組み合わせて、質問ごとに 5 件を選びます。60 問すべてで、前の回と同じ 5 件が選ばれました。CPU だけで、索引を作るのに 87 秒、1 問の検索は 0.08 秒です。
AI に渡すプロンプトも、前の回のクラウドの記録(2 つのモデル × 60 問の 120 件)と一字一句同じであることを確かめています。
使ったのは、重みが公開された 5 つ
選んだのは、国内でゼロから作られたモデル 3 つと、海外の公開モデルに日本語を追加で学習したモデル、その元になった海外のモデルです。ライセンスは Apache 2.0 か MIT で、どちらも商用での利用を認めています。PLaMo の公開版は翻訳用や金融用などに限られ、汎用の対話向けの版が無いので入れていません。
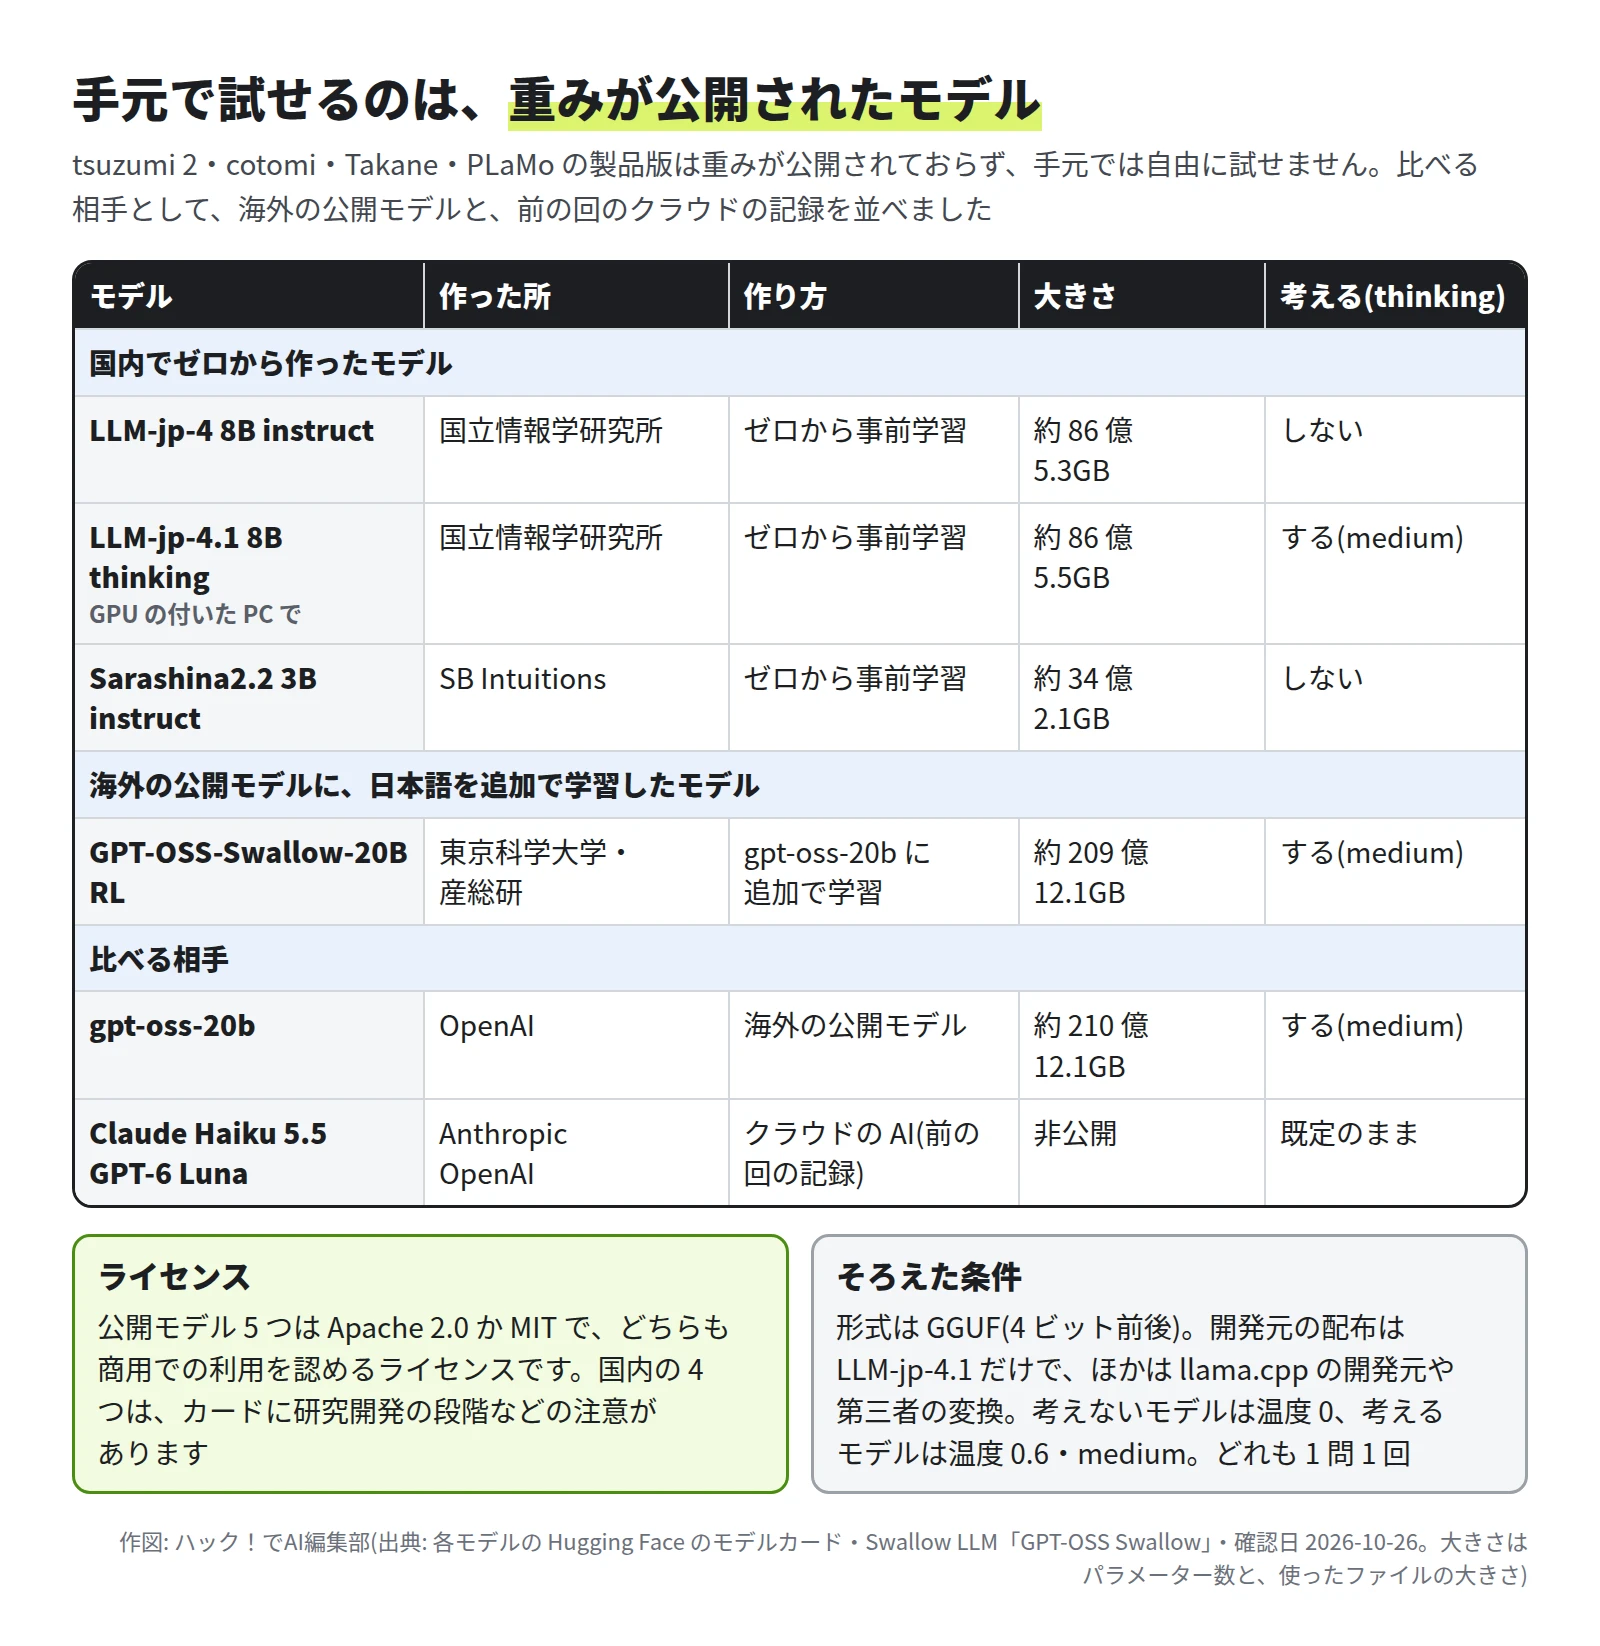
GPT-OSS-Swallow-20B と gpt-oss-20b は、日本語の追加学習の前と後の組です。考える(thinking。答える前に、考えた過程を文章で書く)3 つは、GPT-OSS-Swallow のモデルカードが勧める設定にそろえ、考える深さは medium、温度(答えの揺れの大きさを決める値)は 0.6 にしました。考えない 2 つは温度 0(毎回いちばん確からしい語を選ぶ設定)で、どのモデルも 1 問 1 回です。
計画では 8 つを動かす予定でした。考える型の 8B の 3 つは、GPU の無いサーバーでは 1 問に数分かかる見込みになり、答えを見る前に外しています。LLM-jp-4.1 8B thinking・Qwen3 8B と、それに日本語を足した Qwen3-Swallow 8B です。
ファイルは、llama.cpp(手元の PC やサーバーでモデルを動かすソフト)で使う GGUF という形式で、重みを 4 ビット前後に量子化(数値を粗くしてファイルを小さくすること)したものです。量子化で答えがどう変わるかは、LLM の量子化の回で測っています。
クラウドの 2 つは、10 月 15 日の RAG の回で記録した答えをそのまま使い、この記事のために呼び直していません。当時は、ハック!でAI と同じ株式会社Game が運営する YOBITSUGI AI から呼び出しています。どちらも各社の中で速さと安さを重んじたモデルで、各社の最上位ではありません。
採点は、前の回と同じ 4 つの判定(正答・一部・誤り・記載なし)で、編集部(Claude Code を使用)が行いました。6 つの答えはモデルの名前を伏せて問ごとに並べ、あとから加えた LLM-jp-4.1 8B thinking だけは、同じ問の束で別に採点しています。外れた答えのすべてと、正答から選んだ 15 件を読み直し、判定が合うことを確かめました。採点に使った Claude Code は、比べた相手の Claude Haiku 5.5 と同じ Anthropic のモデルです。名前を伏せたのは、この偏りを避けるためでもあります。
前の回の AI による採点とは、クラウドの答え 120 件のうち 116 件で一致しました。Claude Haiku 5.5 の正答は、前の回の 46 問から 45 問に減っています。区分の当てはめに迷った答えを、今回は「一部」としたためです。
上位の 3 つは 47〜49 問。差があるとは言えない
いちばん多かったのは GPT-OSS-Swallow-20B の 49 問で、LLM-jp-4.1 8B thinking が 48 問、元の gpt-oss-20b が 47 問と続きます。50 問を何度も引き直して差の幅を出すと(ブートストラップ・1 万回・95% の幅)、この 3 つの間の差は、どれも幅に 0 が入りました。差があるとは言えない、ということです。
日本語の追加学習の前と後にあたる gpt-oss-20b と GPT-OSS-Swallow-20B では、差は 2 問で、幅は 0〜5 問です。幅に 0 が入るので、追加学習で正答が増えたとまでは言えません。
GPT-OSS-Swallow-20B と Claude Haiku 5.5 の差は 4 問で、幅は 1〜8 問でした。幅に 0 が入らないので、今回の 50 問に限れば、手元で動かした 20B のほうが多く正答しました。ただし、比べた相手は速さと安さを重んじたクラウドのモデルで、考える深さの設定もそろっていません。
答えの無い 10 問では、7 つのうち 5 つが、10 問すべてで「資料に記載がありません」と答えました。言い切ったのは、Sarashina2.2 3B と LLM-jp-4.1 8B thinking の 1 問ずつです。
考えない小さいモデルは、2 か所を組み合わせる問で落とした
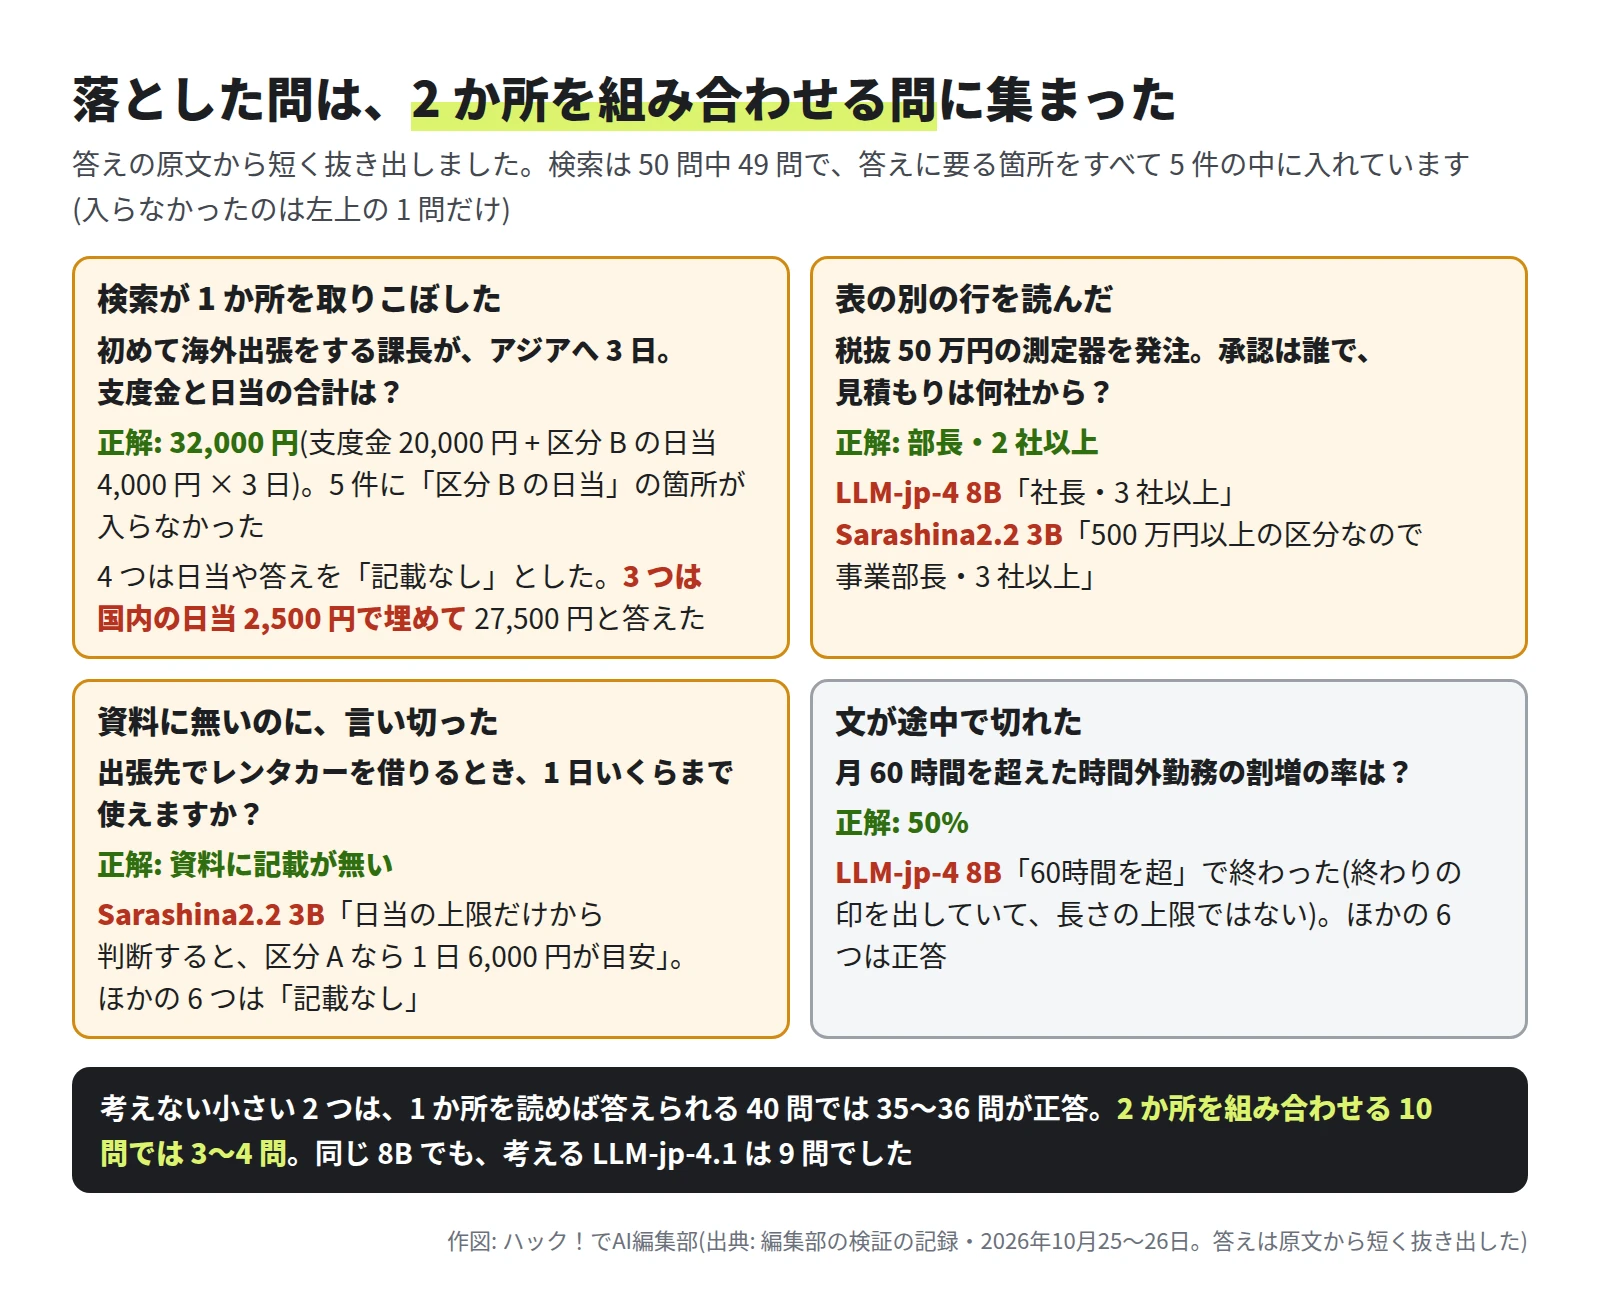
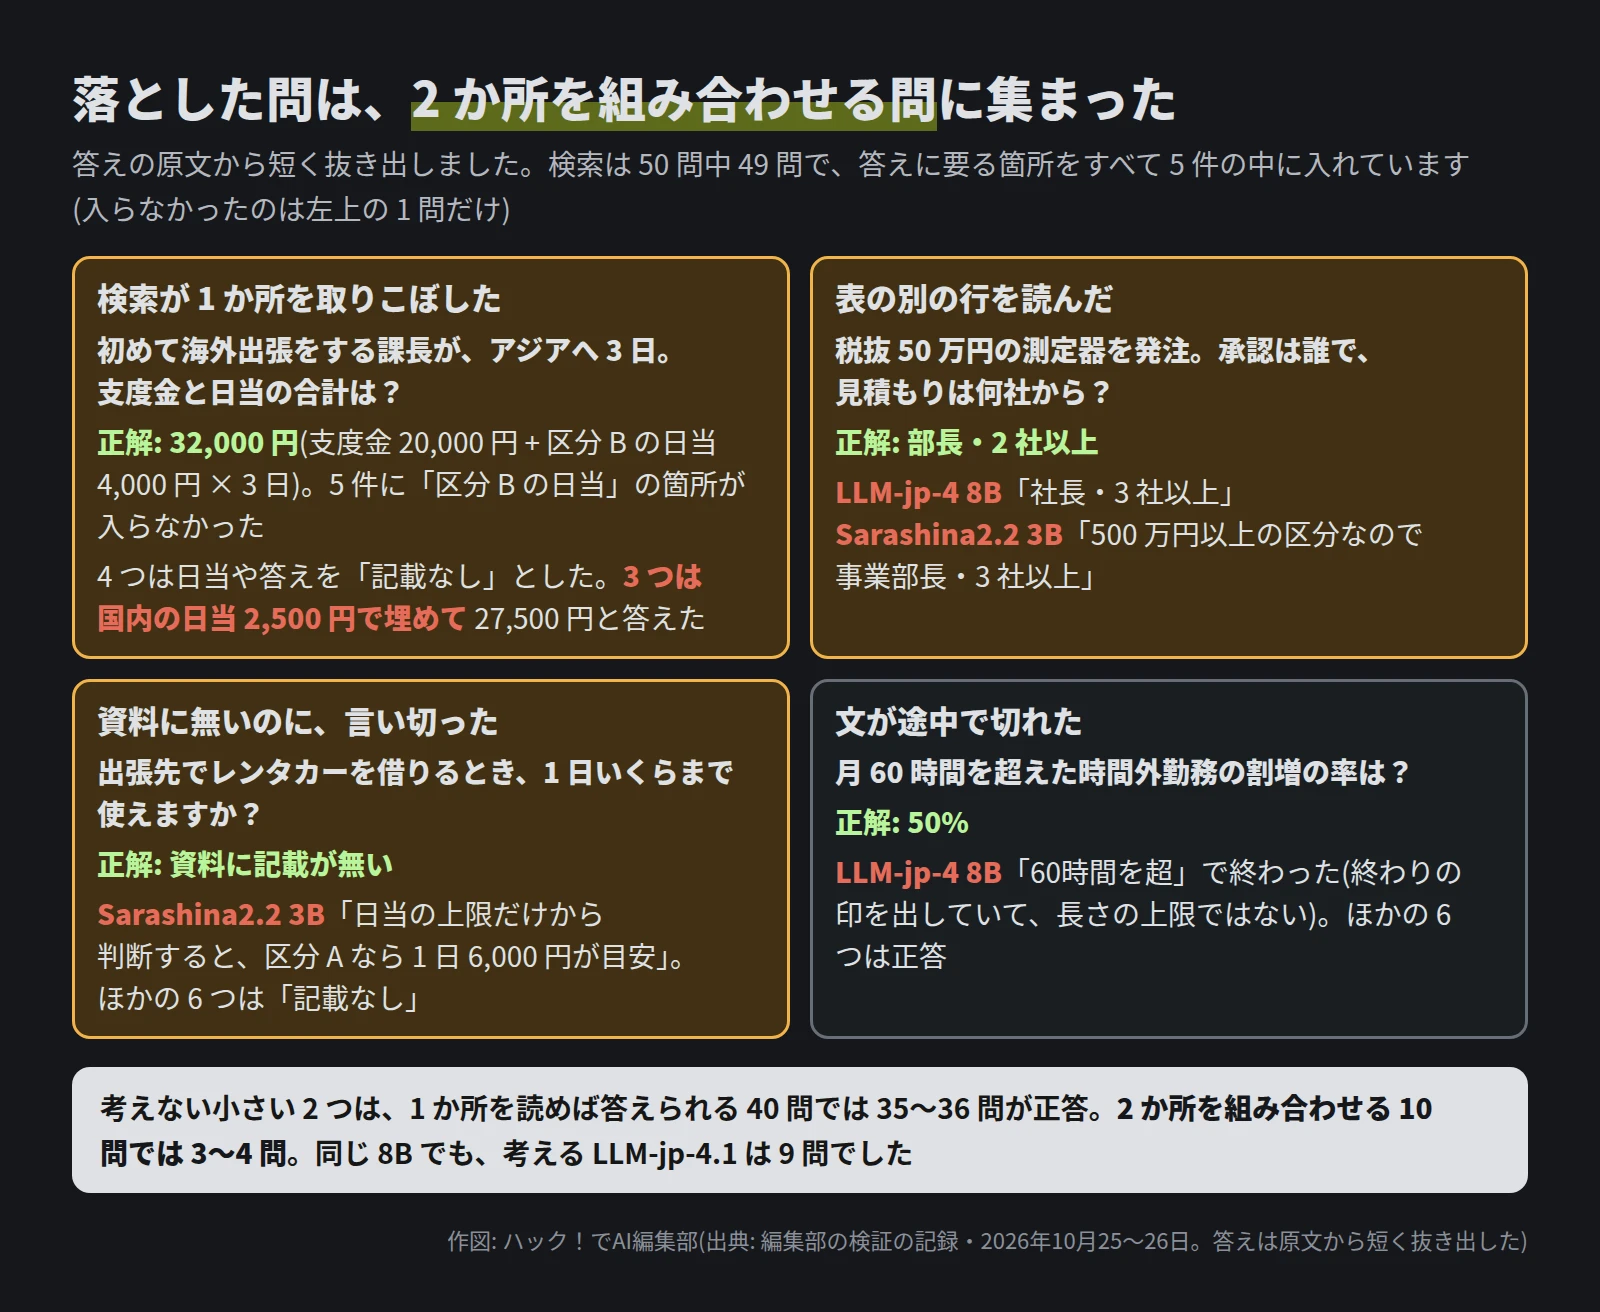
考えない型の LLM-jp-4 8B と Sarashina2.2 3B は、1 か所を読めば答えられる 40 問では 35〜36 問が正答でした。クラウドの 2 つ(38〜39 問)と大きくは変わりません。差が開いたのは、2 か所以上を組み合わせる 10 問で、3〜4 問にとどまりました。同じ 8B でも、考える型の LLM-jp-4.1 8B thinking は 9 問を正答しています。
たとえば、税抜 50 万円の測定器を発注する問の正解は「部長の承認・2 社以上の見積もり」です。LLM-jp-4 8B は「社長・3 社以上」、Sarashina2.2 3B は「500 万円以上の区分なので事業部長」と答えました。資料の表の、別の行を読んでいます。
検索は、50 問中 49 問で答えに要る箇所を 5 件の中に入れていました。どのモデルにも同じ 5 件を渡しているので、差は資料の読み方で出たことになります。考える 3 つは、答える前に中央値で 380〜530 字ほど考えていました。条件を 1 つずつ照らす手順を文章で踏んでいるため、と編集部はみています(確かめたのは考えた字数だけです)。
検索が 1 か所を取りこぼした問もありました。アジアへの出張の支度金と日当を合わせる問で、「区分 B の日当 4,000 円」の箇所が 5 件に入りませんでした。このとき、Claude Haiku 5.5・GPT-6 Luna・gpt-oss-20b・LLM-jp-4.1 8B thinking の 4 つは、日当や答えを「記載なし」としました。
残りの GPT-OSS-Swallow-20B・LLM-jp-4 8B・Sarashina2.2 3B は、国内の日当 2,500 円で埋めて 27,500 円と答えています。正答がいちばん多かった GPT-OSS-Swallow-20B も、ここでは近くの数字で埋めました。資料が足りないときのこの答え方は、運用で気をつけたい点です。
速さ: GPU の無いサーバーでは、1 問 20 秒から 1 分あまり
GPU の無いサーバーでは、1 問にかかった時間の中央値が 21〜70 秒でした。速い順に、Sarashina2.2 3B が 21 秒、GPT-OSS-Swallow-20B が 48 秒、gpt-oss-20b が 66 秒、LLM-jp-4 8B が 70 秒です。ほかの作業と同じサーバーで動かしたので、混み具合(load average)は 15〜110 と大きく揺れています。専用のサーバーの値ではなく、目安です。
20B の 2 つは、全体の大きさは 8B の 2.5 倍ほどあります。ただ、MoE(専門家と呼ぶ部分を選んで使う作り)で、アクティブパラメーター(1 語を書くたびに実際に計算に使うパラメーターの数)は約 36 億です。考える分を足しても 8B と同じくらいの時間で答えたのは、このためとみられます。
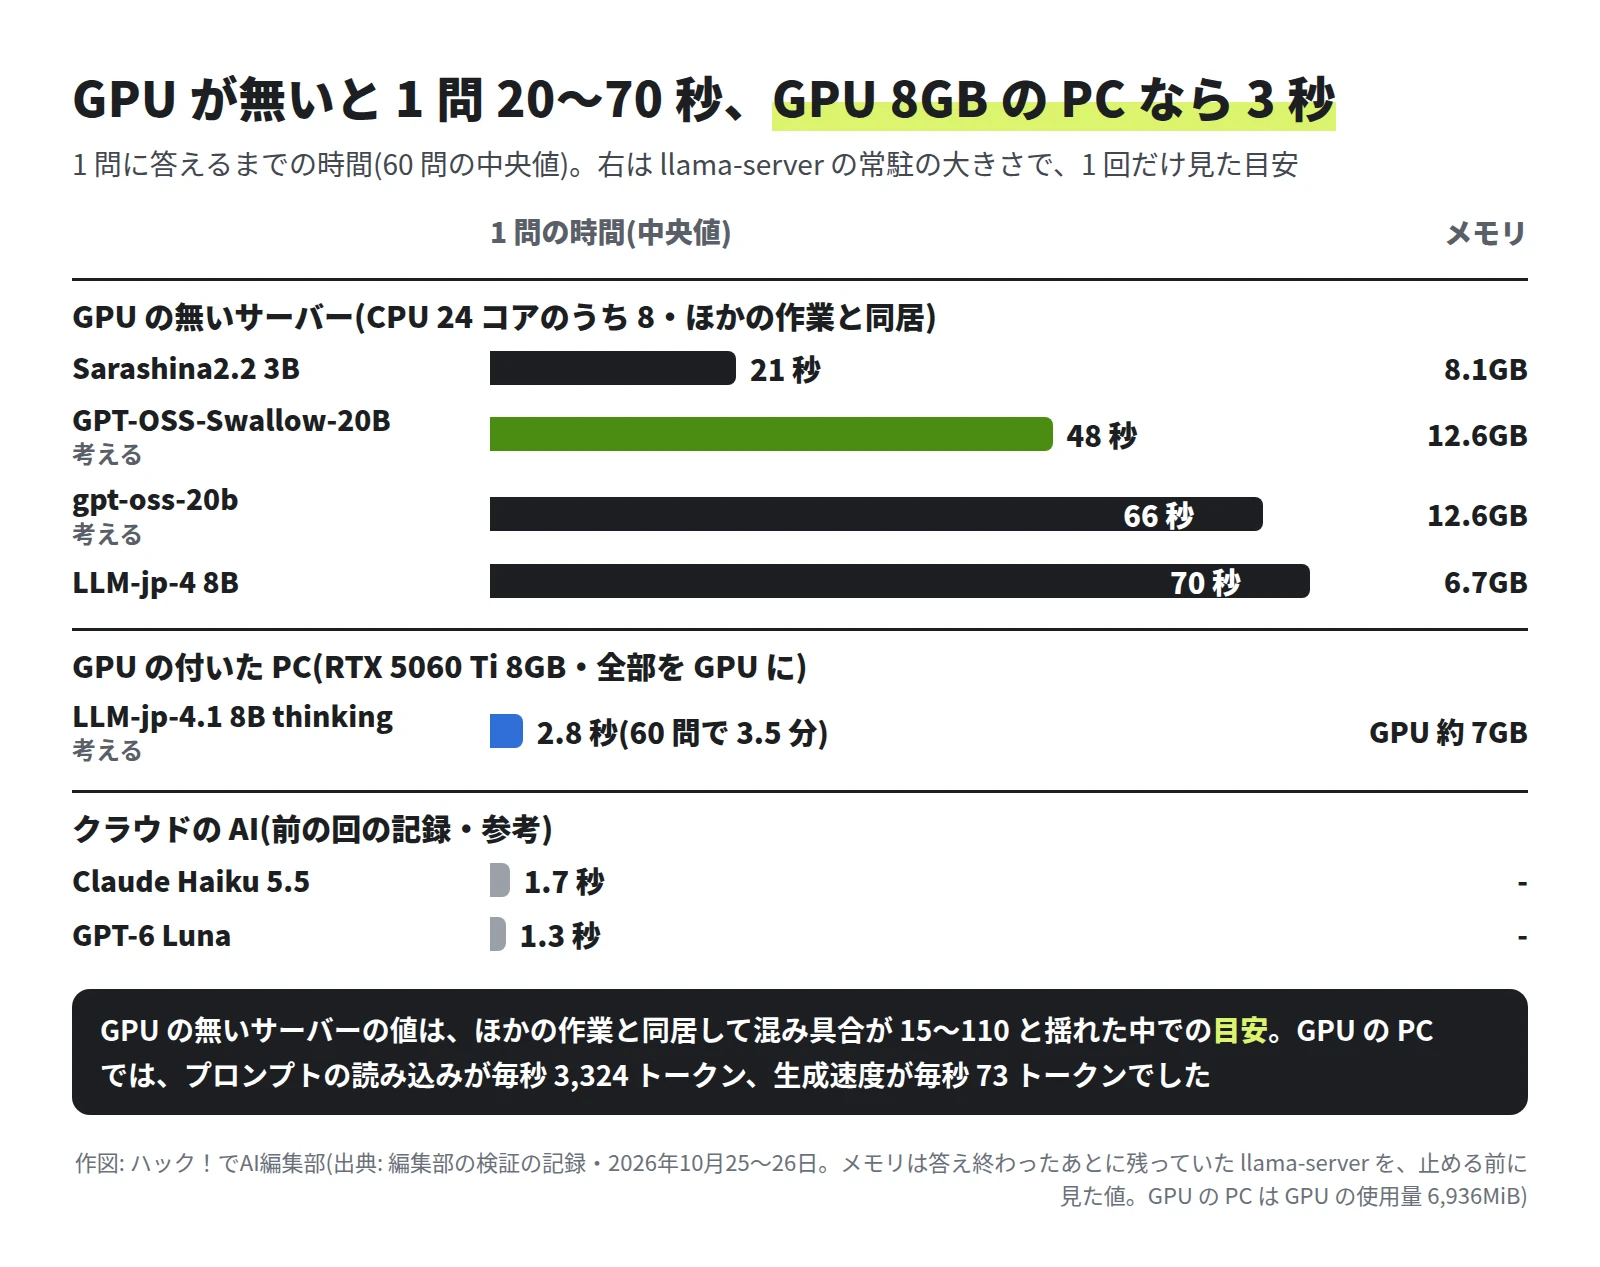
メモリは目安です。llama-server(llama.cpp でモデルを動かすサーバーのプログラム)は、答え終わったあとも残っていました。その常駐の大きさを、止める前に 1 回だけ見ています。
LLM-jp-4 8B が 6.7GB、Sarashina2.2 3B が 8.1GB、20B の 2 つが 12.6GB でした。小さい Sarashina2.2 のほうが大きく出るなど、モデルの大きさの順にもなっていません。8B 以下なら、メモリ 16GB の PC にも収まりそうです。
GPU 8GB の PC で、最新の LLM-jp-4.1 を動かした
最新の LLM-jp-4.1 は、32B の MoE 版を GPU の無いサーバーで動かす予定でした。ところが、後で書く「つまずき」でサーバーのメモリが足りなくなり、残りの計測は GPU の付いた PC に移しています。Windows 11・メモリ 32GB・RTX 5060 Ti 8GB の PC です。32B 版(21.5GB)は GPU の 8GB に収まらないので、全部が GPU に載る 8B の thinking 版(5.5GB)に替えました。
Windows では unshare が使えないので、この PC はネットにつながったまま動かしました。代わりに、動いている間、llama-server の通信の相手を 5 秒ごとに記録しています。41 回の記録で、127.0.0.1(自分自身)以外の相手は 0 回でした。
ネットを切った箱と違い、5 秒の合間の短い通信までは見えないので、確かめ方としては一段弱くなります。モデルのファイルは、この PC で前もってダウンロードし、SHA256 のハッシュ値と照合しました。
結果は、答えのある 50 問のうち 48 問が正答でした。同じ国立情報学研究所の LLM-jp-4 8B(考えない型・38 問)より 10 問多く、差の幅は 4〜16 問です。ただし、2 つは版(4 と 4.1)と考えるかどうかの両方が違い、温度の設定と GGUF の作り手も違うので、どれが効いたのかは分けられません。
答えの無い問では 1 問、正社員にしかないリフレッシュ休暇を、契約社員にも「ある」と言い切りました。
速さは、1 問の中央値が 2.8 秒で、60 問を 3.5 分で解き終えています。プロンプトを読み込む速さは毎秒 3,324 トークン(トークンは文章を細かく区切った単位)、生成速度は毎秒 73 トークンでした。考えた字数は中央値で 533 字ありますが、この速さなら待ち時間はほとんど気になりません。
つまずき: 答え終わったモデルが、止まらずに残っていた
この実験では、失敗も 1 つありました。モデルを 1 つずつ動かすスクリプトは、メモリを測るために、llama-server を time というコマンドで包んで起動していました。答え終わったら停止のシグナル(止める合図)を送っていましたが、受け取っていたのは包んだ側の time だけでした。
time が終わったあとも、llama-server は動き続けました。4 本で 40GB 近くになり、同じサーバーのほかの作業がメモリ不足で止まっています。気づいたのは、すべてのモデルが答え終わったあとでした。
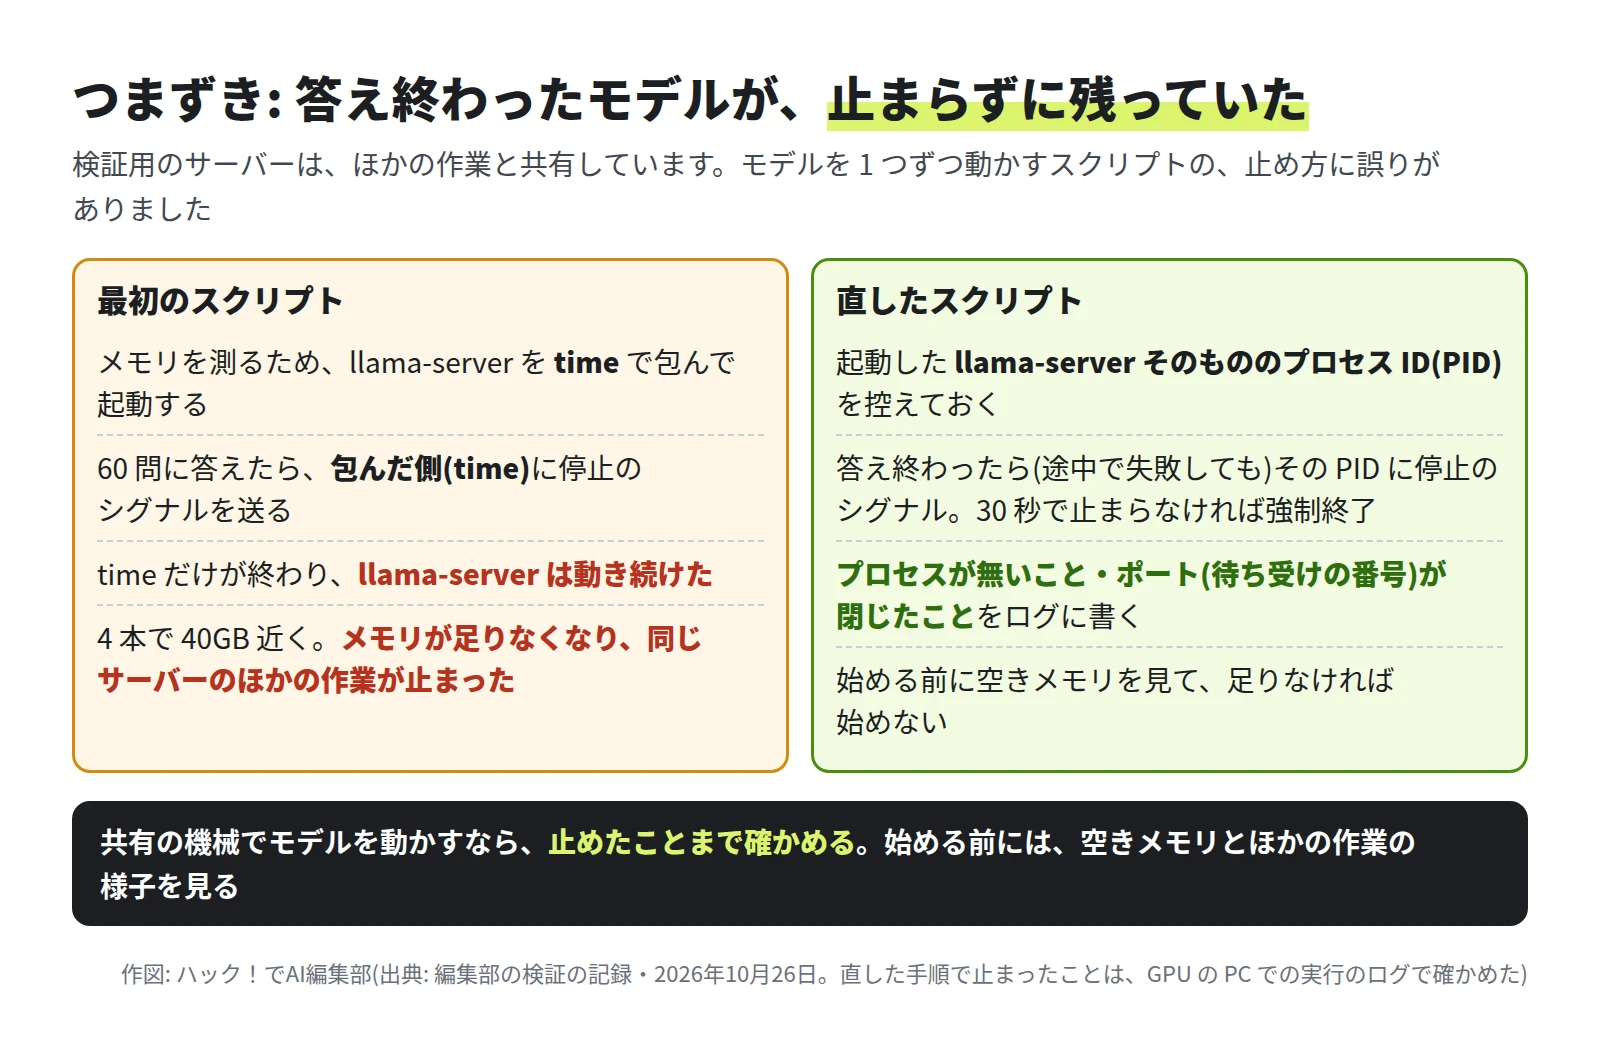
直したスクリプトは、起動した llama-server そのもののプロセス ID(PID)を控え、答え終わったら(途中で失敗しても)その PID を止めます。そのうえで、プロセスが無いことと、ポート(通信の受け口の番号)が閉じたことをログに書きます。始める前には空きメモリを見て、足りなければ始めません。
GPU の PC では、10 分以上だれも操作しておらず、GPU も空いていることを確かめてから始めました。終わったあとは、llama-server が止まり、ポートが閉じたことをログで確かめています。
社内のサーバーで AI を動かすなら、止める手順も手順書に入れます。止めたあとは、プロセスとポートが残っていないことと、空きメモリが戻ったことを確かめてから、次のモデルに進みます。
社内の窓口では、問の形で向き不向きが分かれる
今回の結果を社内の問い合わせ窓口に当てはめると、問の形で分かれます。1 か所を引けば答えられる照会(期限・金額・窓口・日数)なら、GPU の無いサーバーで動く考えない小さいモデルでも、多くは答えられました。承認者の区分や日当の合計のように、2 か所以上を組み合わせる問は、考えるモデルを使うか、最後に人が規程で確かめる前提にします。
考えるモデルの速さは、GPU の無いサーバーで動かした 20B の 2 つが 1 問 1 分前後、GPU 8GB の PC で動かした LLM-jp-4.1 8B thinking が 1 問 3 秒弱でした。2 か所以上を組み合わせる 10 問では、GPT-OSS-Swallow-20B と LLM-jp-4.1 8B thinking が 9 問を正答しています。
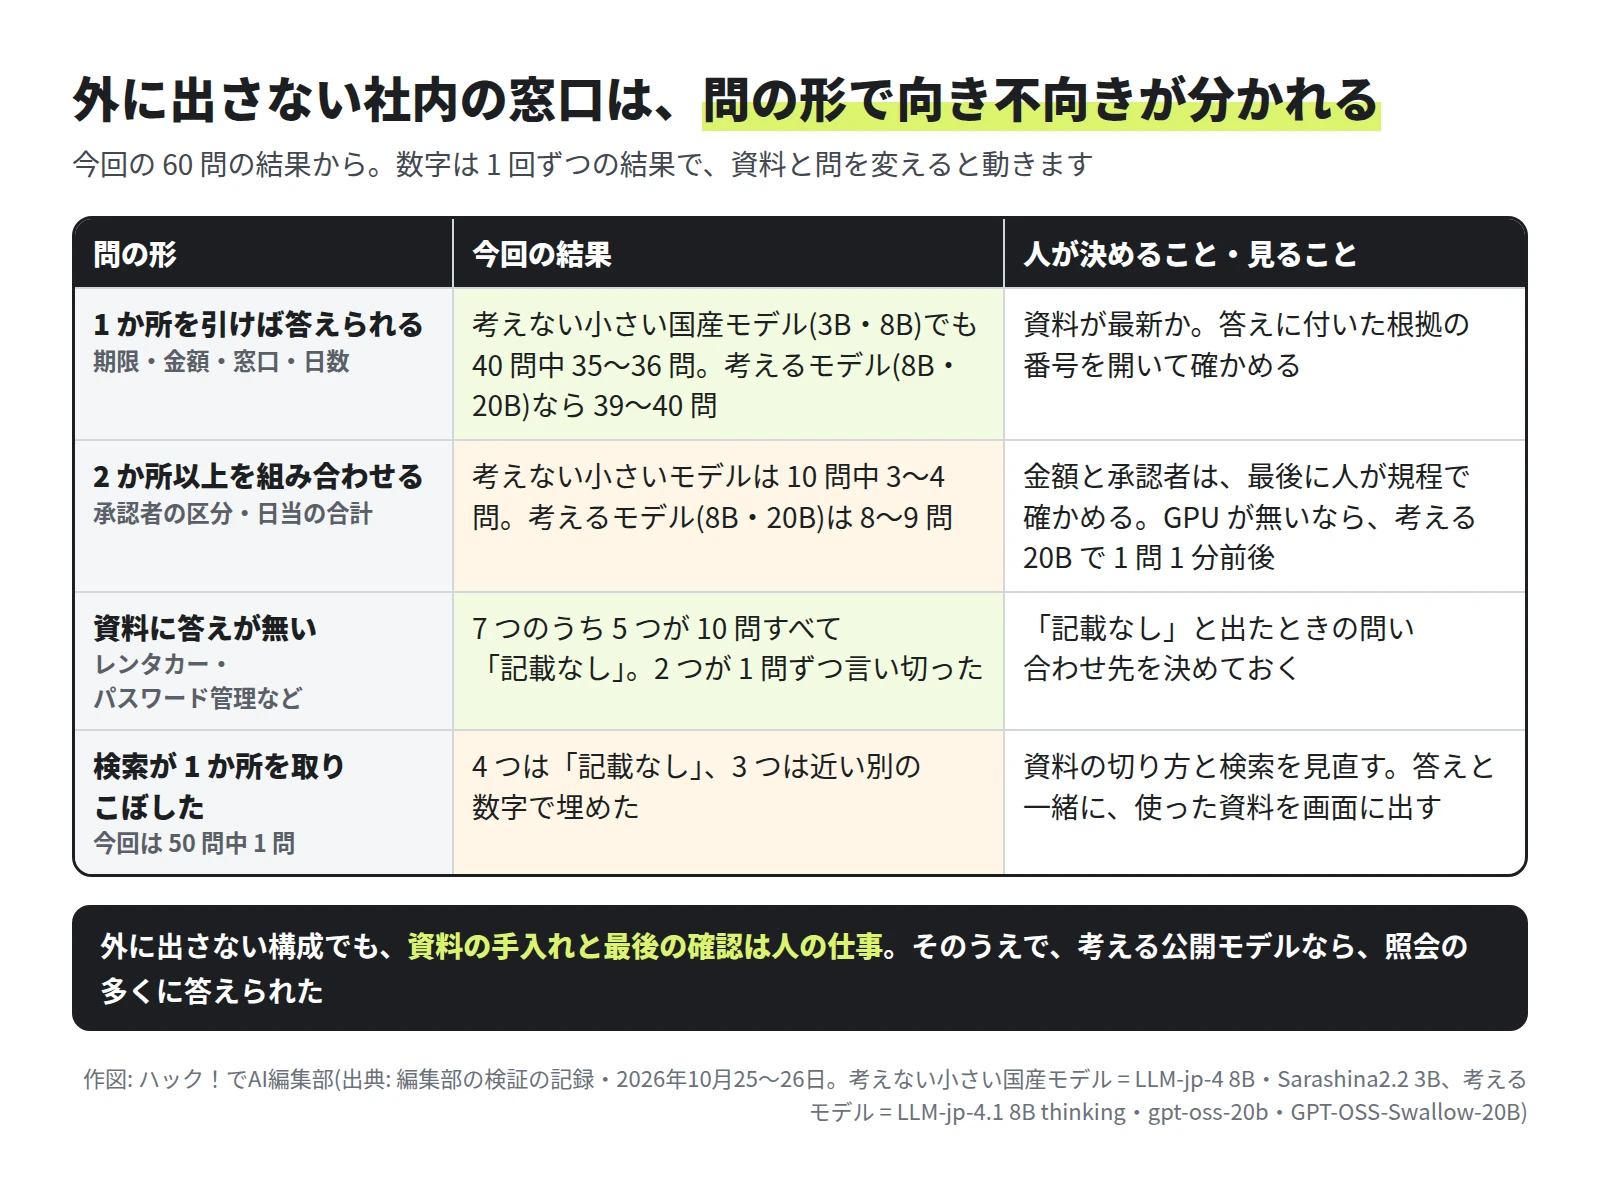
外に出さない構成でも、人の仕事は残ります。資料が古くなっていないかを見ること、答えに付いた根拠の番号を開いて確かめること、「記載なし」と出たときの問い合わせ先を決めておくことです。検索が資料を取りこぼすと AI が近くの数字で埋めることがあるので、答えと一緒に、使った資料を画面に出す作りにしておくと安心です。
資料の切り方と検索の改善は、RAG の精度を測った回で順に試しています。閲覧の権限やログなど、オンプレミスでも自社で受け持つ対策は、第 4 回で挙げた 7 つの穴のとおりです。
国内の 4 つのモデルは、開発元がモデルカードで、研究開発の段階であることや、安全性の調整が限られることを断っています。そのまま窓口に出さず、自社の資料と問で試してから使います。
GPU の無いサーバーでは、1 問に数十秒かかります。チャットのようにすぐ返事がほしいなら GPU を足し、急がない問い合わせなら、夜のうちに答えの下書きをまとめて作っておく使い方が向いています。
最終回の第 6 回は、ここまでの 5 回をもとに、国産 LLM のこれからを、根拠と外れる条件つきで予想します。
参考にした公式の情報
- Hugging Face「llm-jp/llm-jp-4-8b-instruct」
- Hugging Face「llm-jp/llm-jp-4.1-8b-thinking」
- Hugging Face「sbintuitions/sarashina2.2-3b-instruct-v0.1」
- Hugging Face「tokyotech-llm/GPT-OSS-Swallow-20B-RL-v0.1」
- Swallow LLM「GPT-OSS Swallow」
- Hugging Face「openai/gpt-oss-20b」
- GitHub「ggml-org/llama.cpp」リリース b11852
- Hugging Face「cl-nagoya/ruri-v3-310m」
- Linux man-pages「unshare(1)」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。