 佐々木 航
この記事でわかること
- 国産LLMを作り方と使い方で分けた 4 つの型と主なモデル
- 第三者の評価で見た、国産と海外の差と、差の大きい分野
- 重みを公開したモデルのライセンスで、商用の前に見る点
確認した環境: 各社・各省庁の公式の発表 / Hugging Face のモデルカード / Nejumi LLM リーダーボード 4(W&B の公開データ)/ 2026年10月25日に確認
政府のガバメント AI「源内」で、2026 年度に試される国産の LLM(大規模言語モデル。文章を読み書きする AI の本体)は 5 つです。5 つとも重みは公開されておらず、使うには各社の製品として契約します。第三者が日本語の力を比べる Nejumi LLM リーダーボード 4 の今の表(139 件)にも、5 つはどれも載っていません。
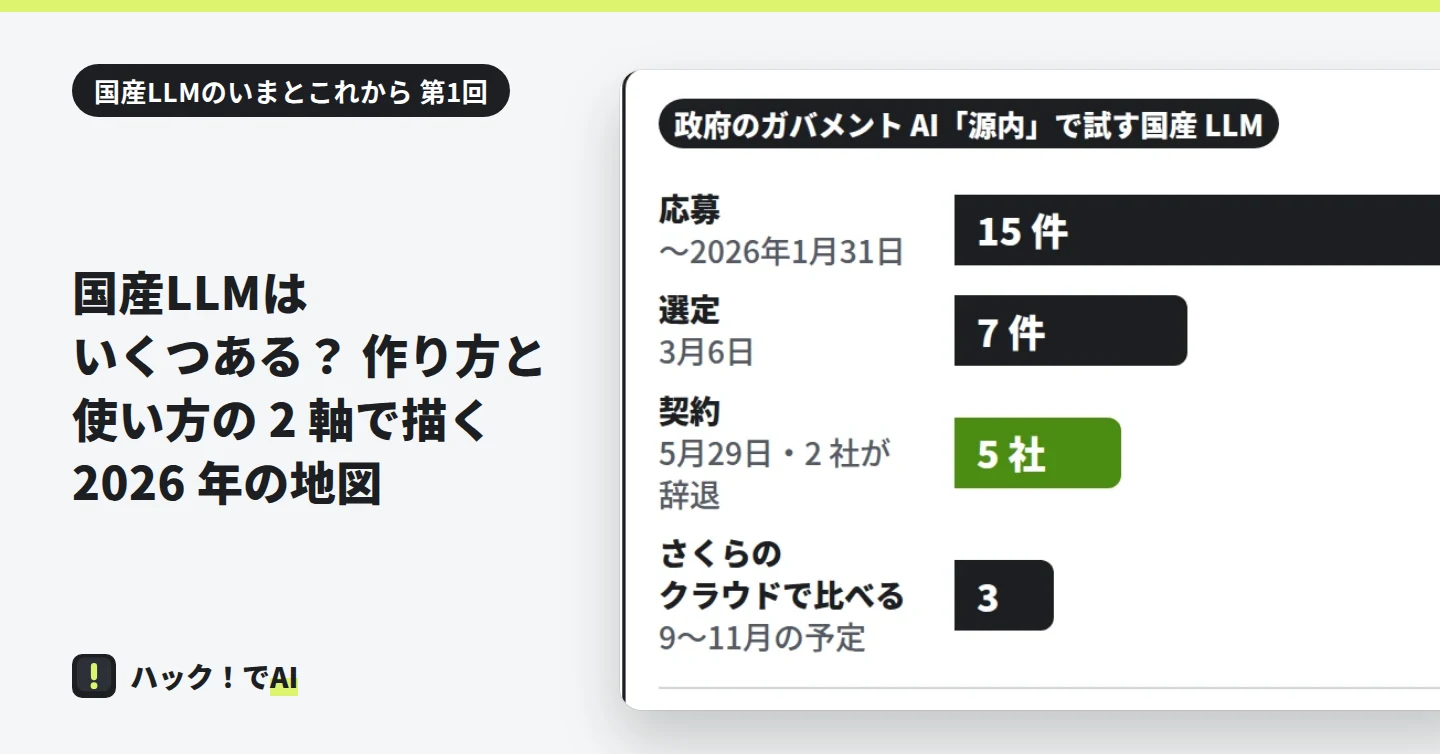
一方で、重みを公開した国内の開発元のモデルは、編集部が Hugging Face(AI のモデルを公開するサイト)で確かめただけで 40 件を超えました。Nejumi 4 で、国内でゼロから作られたモデルとして最も点が高かったのも、重みを公開している国立情報学研究所(NII)の LLM-jp-4.1 33B です。こちらは源内の 5 つに入っていません。
国産 LLM がいくつあるかは、数え方で 5 にも 40 以上にもなります。「国産」の公的な定義が無いからです。「国産の AI も検討して」と頼まれた情シスや企画の担当者が最初に迷うのは、どれとどれを比べればよいのか、だと思います。特集「国産LLMのいまとこれから」の第 1 回では、主なモデルを「作り方」と「使い方」の 2 つの軸で地図に置き、型ごとの向き不向きと、自社の目的からの選び方を示します。
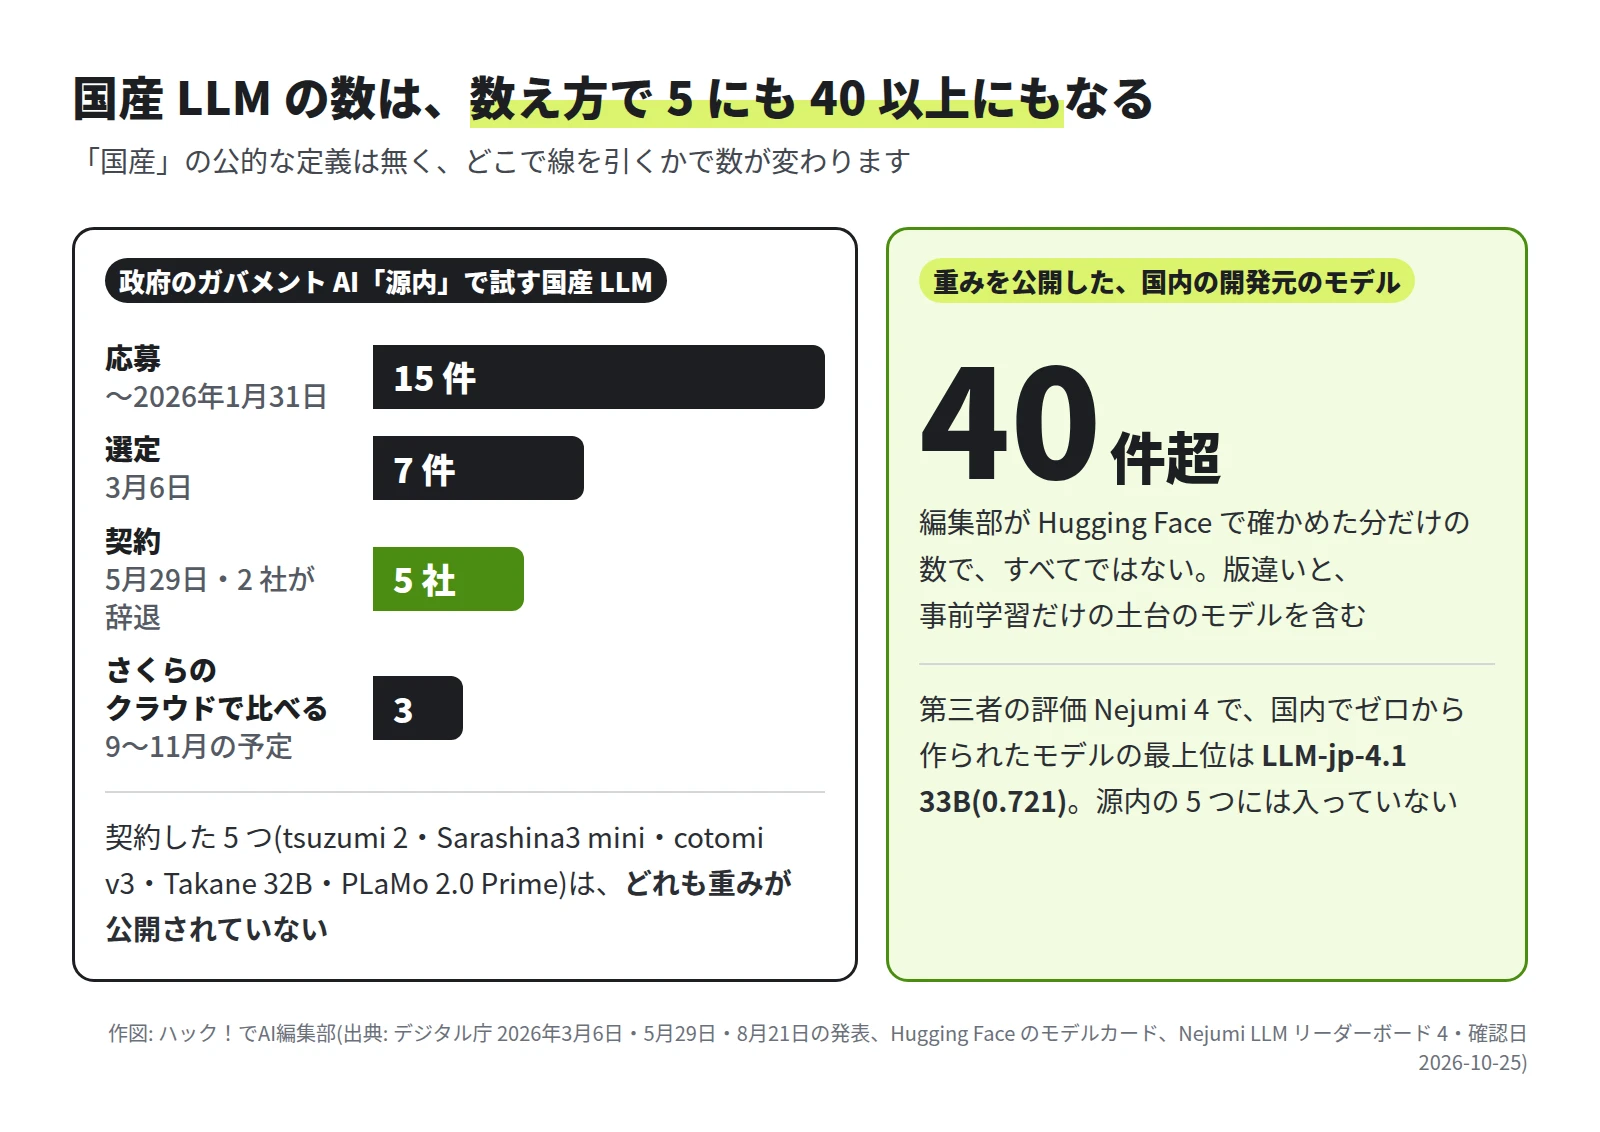
40 件超という数は、編集部がこの特集のために Hugging Face で確かめた範囲の下限です。版違いのモデルと、事前学習だけの土台のモデルを含みます。国内の開発元のモデルを、すべて数えたものではありません。
「国産」の線は、公的な資料のどこにも引かれていない
デジタル庁が 2025 年 12 月に始めた源内の公募は、対象を「国内企業や国内研究機関が開発する大規模言語モデル」としました。2026 年 3 月 6 日の選定の基準も、国内で開発されたことと、「独自開発モデルか派生モデルかの区別等が具体的に説明可能であること」です。海外のモデルを元にしたものを外す決まりはありません。
KDDI と ELYZA が応募した「Llama-3.1-ELYZA-JP-70B」は、Meta の Llama 3.1 が元ですが、7 件に選ばれました。この 1 件は、5 月 29 日に公表された契約の 5 社には入っていません。
経済産業省と NEDO の開発支援 GENIAC も、同じ考え方です。2026 年度の公募は、ゼロから作るモデルに加えて、海外のものを含む既存のモデルに追加で事前学習させるモデルも支援の対象にしています。GENIAC は「国内で開発された基盤モデル」を、国内に登記と開発拠点がある企業・大学などが開発したもの、と定めています。政府が 2026 年 7 月 14 日に改定した人工知能基本計画にも「国産 LLM」の定義は無く、「特定の国や企業への過度な依存を避け」ることを軸にしています。
各社の言い方は分かれます。NTT は tsuzumi 2 を、ゼロから開発した「純国産」のモデルと位置づけています。NII は LLM-jp-4 を「国産LLM」と呼びつつ、設計(アーキテクチャ)は Llama 2 や Qwen3 MoE と同じ型だと明記しています。東京科学大学などの Swallow は、元のモデルが Qwen3 や gpt-oss だと書き、自らを国産とは打ち出していません。
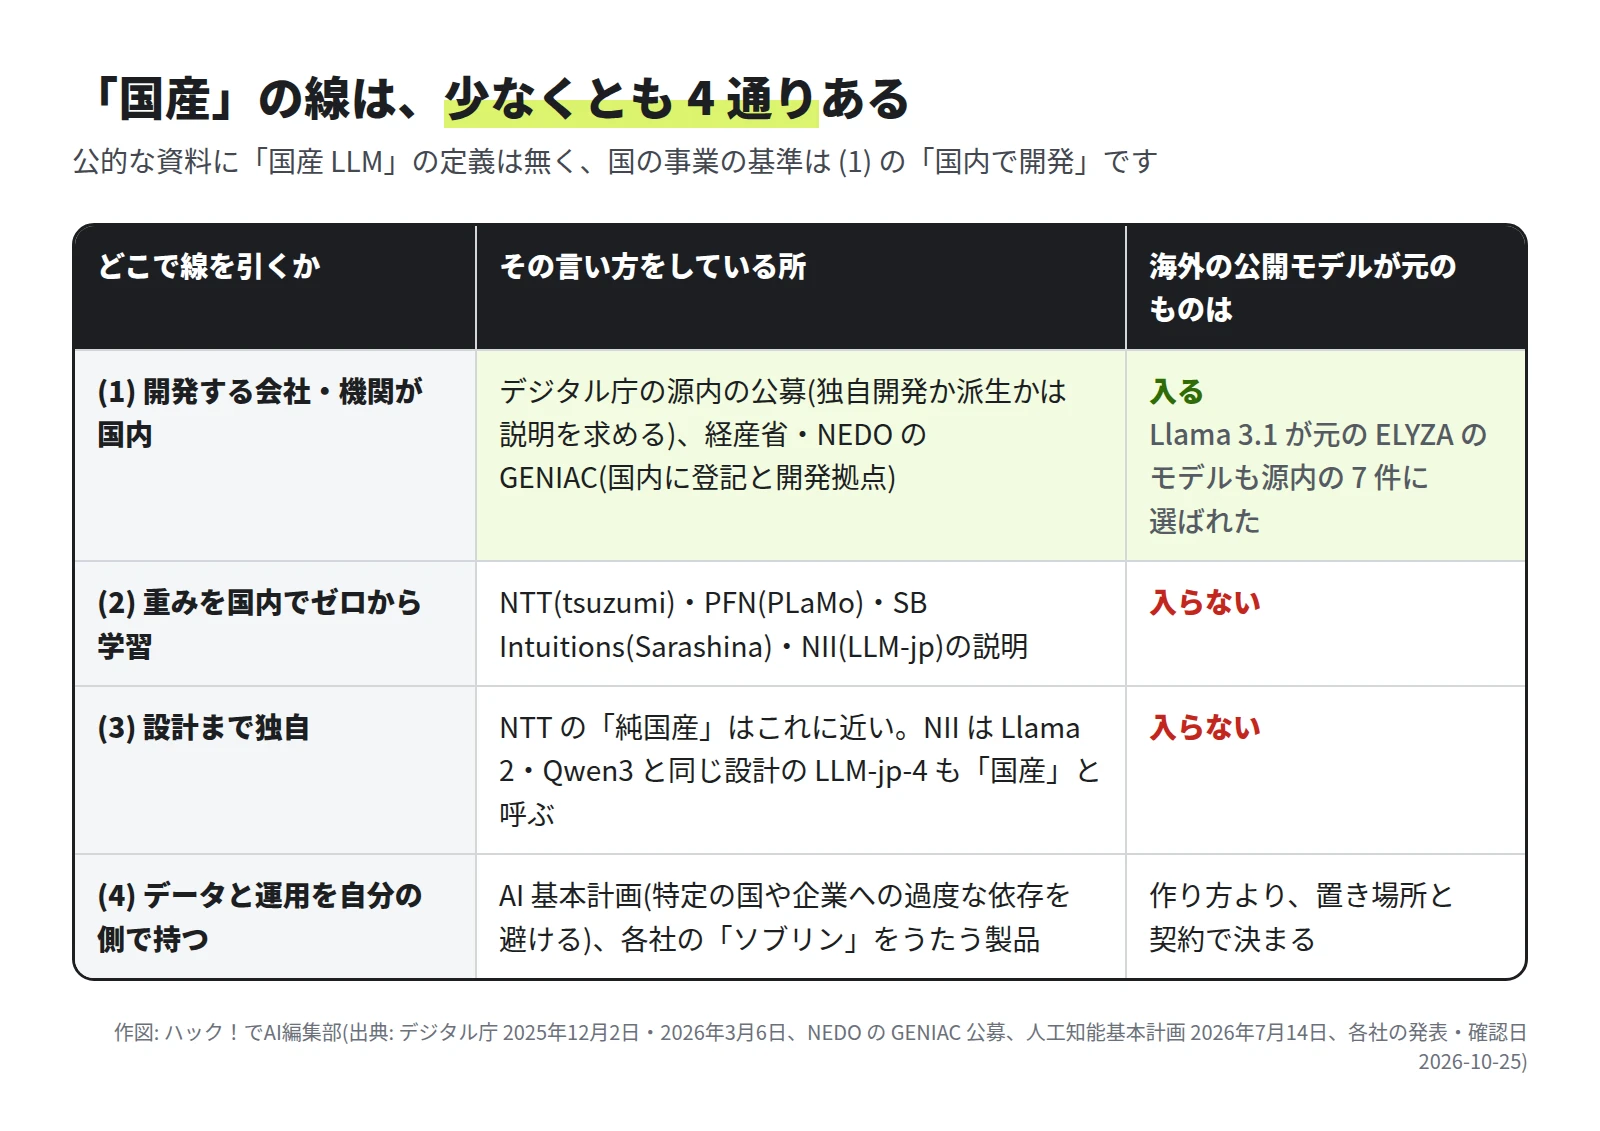
この記事では、(1) の「国内の会社・機関が作った」ものを広く国産 LLM と呼びます。そのうえで、どこまでを国内で作ったかを、次の 2 つの軸で分けます。
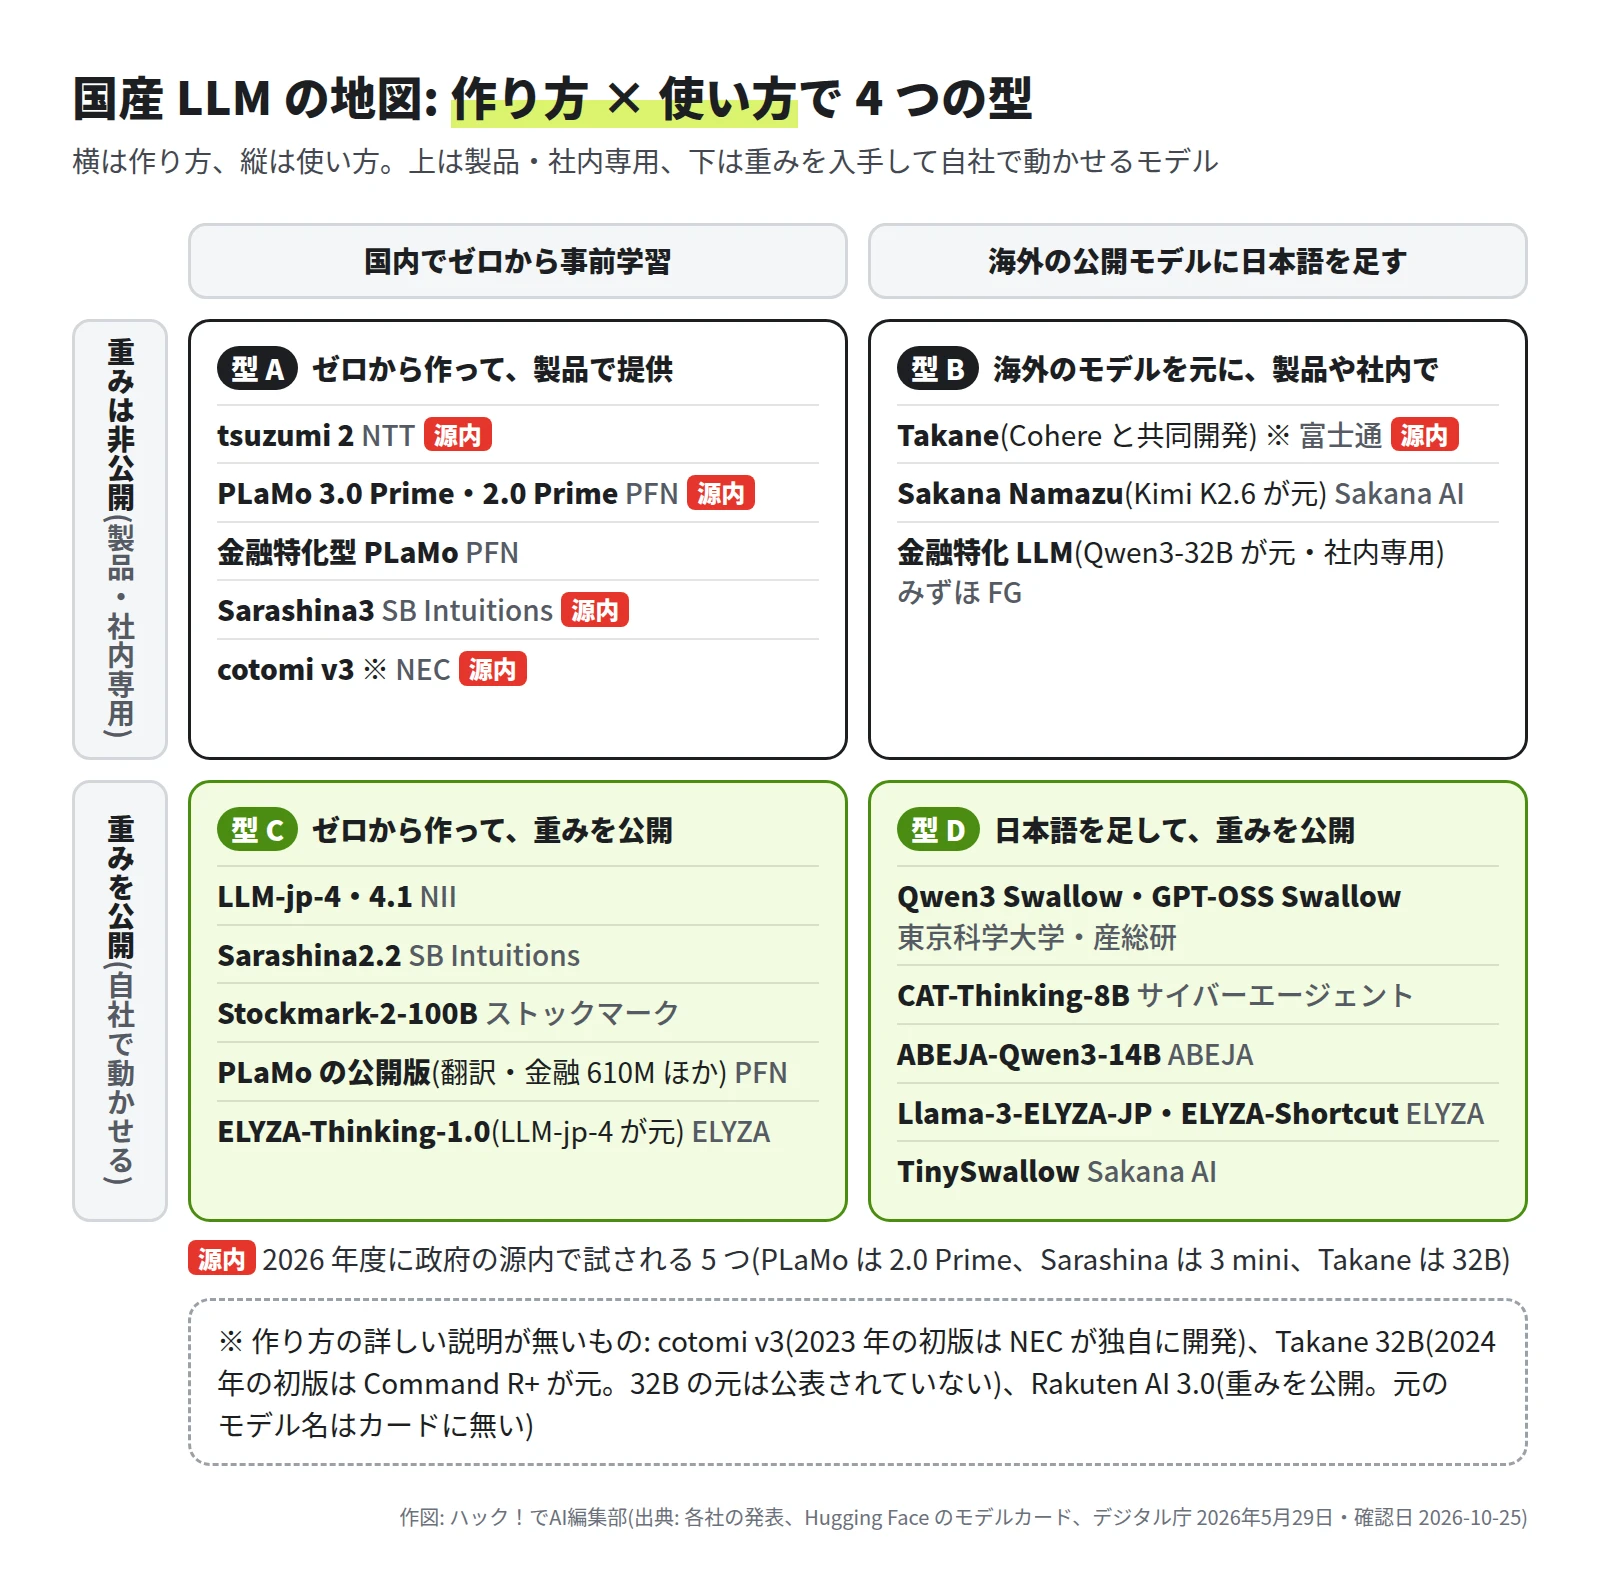
作り方と使い方の 2 軸で、国産 LLM は 4 つの型に分かれる
1 つ目の軸は作り方です。大量の文章で一から学ばせる段階を、事前学習と呼びます。これを国内でゼロから行ったモデルと、海外で公開されたモデルを土台に日本語の文章を追加で学ばせたモデルに分けます。追加の学ばせ方には、事前学習の続きを行う継続事前学習や、目的のデータで仕上げるファインチューニングがあります。
2 つ目の軸は使い方です。重み(学習で決まった数値の集まり。モデルの中身そのもの)が公開されていれば、自社のサーバーに置いて動かせます。公開されていなければ、API(ネット越しに呼び出す窓口)や、ベンダーがオンプレミス(自社の建物やデータセンターに置くサーバー)向けに用意する製品として使います。
重みを手に入れるのは、店で料理を出してもらう代わりに、レシピと仕込んだ材料を受け取るのに近い形です。自分の台所で何度でも作れますが、味の調整も片付けも自分の仕事になります。
型 A: ゼロから作り、製品として届ける
源内で試される 5 つのうち 4 つを、この型に置きました(cotomi v3 の置き方は後で説明します)。NTT の tsuzumi 2(2025 年 10 月 20 日に提供開始)は、パラメーター(モデルの大きさを表す数値の個数)が 300 億(30B)のモデルです。NTT によると、GPU(AI の計算に使う半導体)1 基で動きます。
NTT 西日本とエフサステクノロジーズは 2026 年 8 月 26 日、クラウドを介さずに tsuzumi 2 を動かすオンプレミスの構成の動作検証を終えたと発表しました。この構成は、NTT 西日本が 9 月から提供する予定です。
PFN の PLaMo 3.0 Prime(2026 年 6 月 22 日に正式版)は、情報通信研究機構(NICT)との共同研究で得た事前学習モデルが元で、API とオンプレミスの両方で使えます。PFN は、金融の知識を追加で学ばせた金融特化型 PLaMo も、2026 年 2 月から Snowflake のマーケットプレイスで提供しています。
SB Intuitions の Sarashina3(2026 年 6 月 30 日)は、約 30 兆トークン(トークンは文章を細かく区切った単位)以上で事前学習したモデルで、ソフトバンクのクラウドで使えます。医療版の Med-Sarashina の発表には、SB Intuitions が「フルスクラッチ」(ゼロから)で開発した LLM とあります。
NEC の cotomi v3 も源内の 5 つに入っていますが、NEC は v3 の作り方とパラメーター数を公表していません。2023 年の初版は、NEC が独自に集めたデータで開発した 130 億パラメーターのモデルで、地図ではこの初版にならって型 A に置きました。
この型は、ベンダーの保守を受けながら、データを外に出さない構成を組みたい組織に向きます。NTT 西日本とエフサステクノロジーズの発表でも、対象は官公庁・研究機関・金融機関・製造業などです。重みは手元に来ないので、提供の条件や中身の検証は、ベンダーとの契約に左右されます。
型 B: 海外のモデルを元に、製品や社内のモデルにする
富士通の Takane は、Cohere と共同開発したモデルです。富士通は 2024 年 9 月 30 日、初版を Cohere の Command R+ を元に、日本語を強化して作ったと発表しました。源内の 5 つに入った Takane 32B については、元のモデルを公表していません。Sakana AI の Sakana Namazu(2026 年 8 月 3 日に API を提供開始)は、Moonshot AI が公開した Kimi K2.6 を元に、日本語と日本の業務に合わせたと明記しています。
社内専用の例もあります。みずほフィナンシャルグループは 2026 年 3 月 5 日の発表で、社内で開発している金融特化 LLM の元を Qwen3-32B と明記し、銀行内のオンプレミスで動かせる点を最大の特長に挙げました。発表ごとの中身の違いと実務テストの結果は、第 3 回で詳しく見ています。
この型の利点は、海外の強いモデルの力を、日本語と業務に寄せて使えることです。そのぶん元のモデルの規約や提供の続き方の影響も受けるので、元の名前が公表されているかを最初に確かめます。
型 C: ゼロから作り、重みを公開する
NII は 2026 年 4 月 3 日に LLM-jp-4 を、9 月 28 日に事後学習(事前学習の後に、指示に従う力などを仕上げる学習)を改善した LLM-jp-4.1 を公開しました。大きさは約 86 億・約 320 億・約 332 億パラメーターの 3 つで、ライセンスは Apache-2.0 です。学習データも公開しているので、何を学んだモデルかを自分で追えます。SB Intuitions の Sarashina2.2、ストックマークの Stockmark-2-100B、PFN の PLaMo の公開版(翻訳用や金融用の小さなモデルなど)も、この型です。
ELYZA が 10 月 2 日に公開した ELYZA-Thinking-1.0 は、LLM-jp-4 を元に追加で学習したモデルです。これまで ELYZA は Llama や Qwen を元にしたモデルを出してきましたが、国内でゼロから作られたモデルを土台に選ぶ例が加わりました。
型 D: 海外の公開モデルに日本語を足し、重みを公開する
Qwen3 Swallow と GPT-OSS Swallow は、東京科学大学と産総研が 2026 年 2 月 20 日に公開したモデルです。Qwen3 と gpt-oss に日本語を継続事前学習しており、ライセンスは Apache-2.0 です。
サイバーエージェントの CAT-Thinking-8B は、Qwen3 Swallow をさらに学習させたものです。ABEJA の ABEJA-Qwen3-14B は、Qwen3-14B-Base が元です。ELYZA の Llama-3-ELYZA-JP-8B(Llama 3 が元)や、Sakana AI の TinySwallow(Qwen2.5 が元)もここに入ります。元のモデルの推論やコードの力を引き継ぎやすい半面、ライセンスも元のモデルの条件を引き継ぎます。
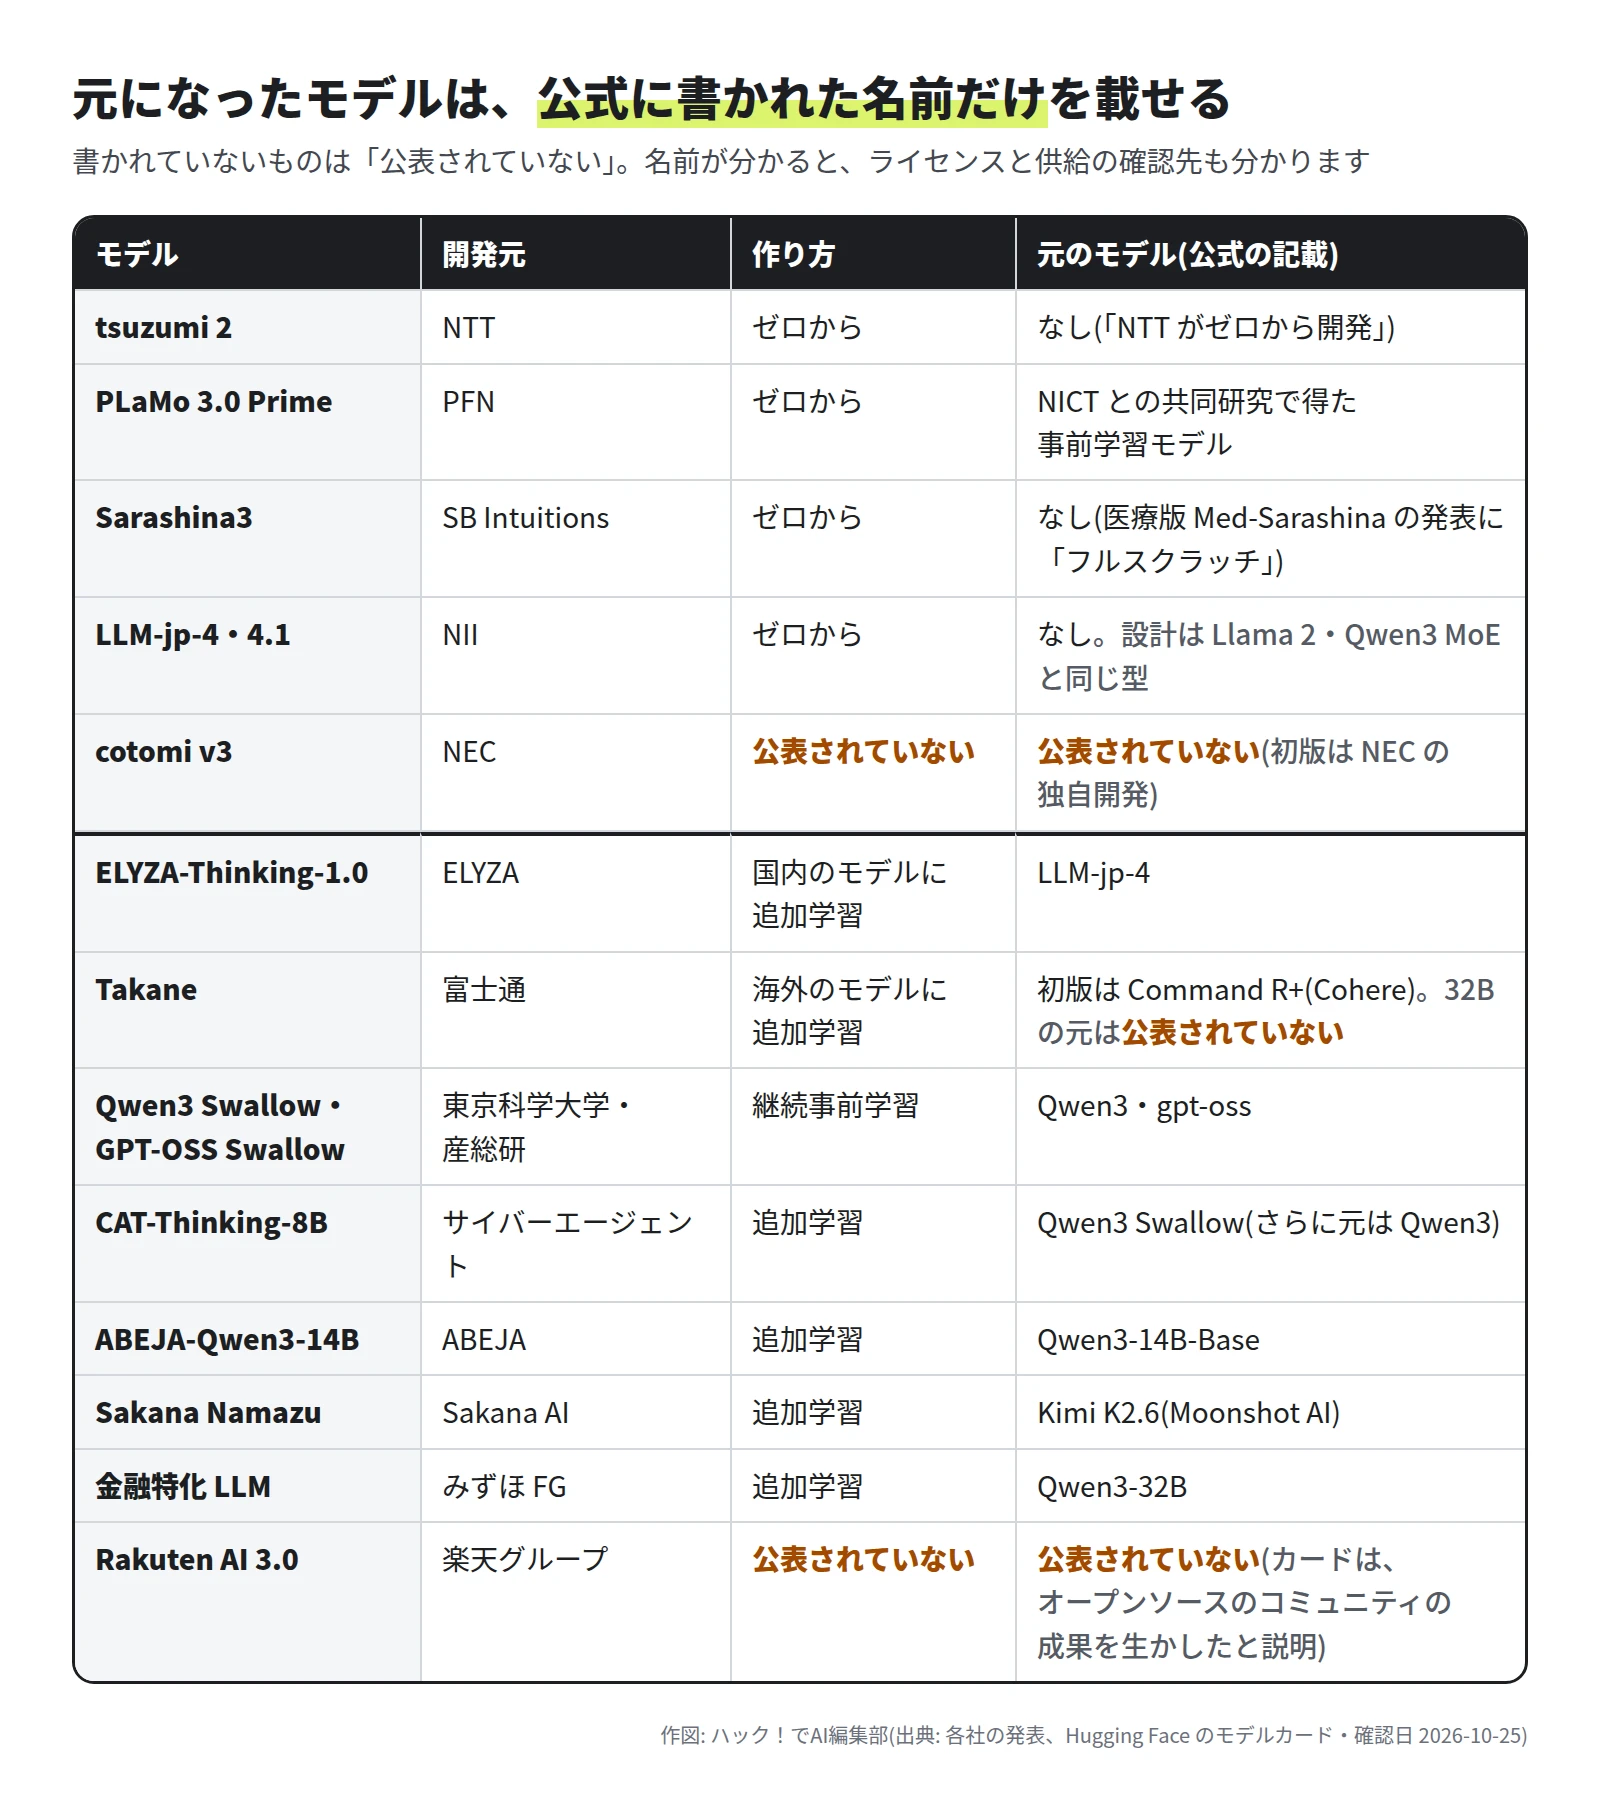
元のモデルの名前が分かると、確かめる先も分かります。ライセンスの条件や提供が続くかどうか、得手不得手は、元のモデルの側にも左右されるからです。楽天グループの Rakuten AI 3.0 は、約 7,000 億パラメーターの重みを Apache-2.0 で公開しています。モデルカードには、オープンソースのコミュニティの成果を生かして開発したとあり、元のモデル名は書かれていません。
日本語の力は、第三者の表と開発元の発表を分けて読む
第三者の Nejumi 4 では、分野ごとに差の大きさが違う
W&B Japan が運営する Nejumi LLM リーダーボード 4 は、日本語の知識・推論・コード・安全性などを同じ条件で評価しています。公開のページで表が表示されなかったため、編集部は 2026 年 10 月 25 日に W&B の公開データを取得し、総合点の順に並べました。順位は編集部が並べたもので、W&B が付けたものではありません。
国内でゼロから作られたモデルの最上位は、LLM-jp-4.1 33B の 0.721(2026 年 10 月 5 日の評価)でした。海外の最上位の Claude Opus 5 は 0.872(7 月 25 日)で、差は 0.151 です。同じくらいの大きさの海外の公開モデルとも差があり、Qwen3.5-27B は 0.805、Gemma 4 31B は 0.808 でした。gpt-oss-120b に日本語を足した GPT-OSS Swallow 120B は 0.691 で、元の gpt-oss-120b の 0.701 とほぼ同じです。
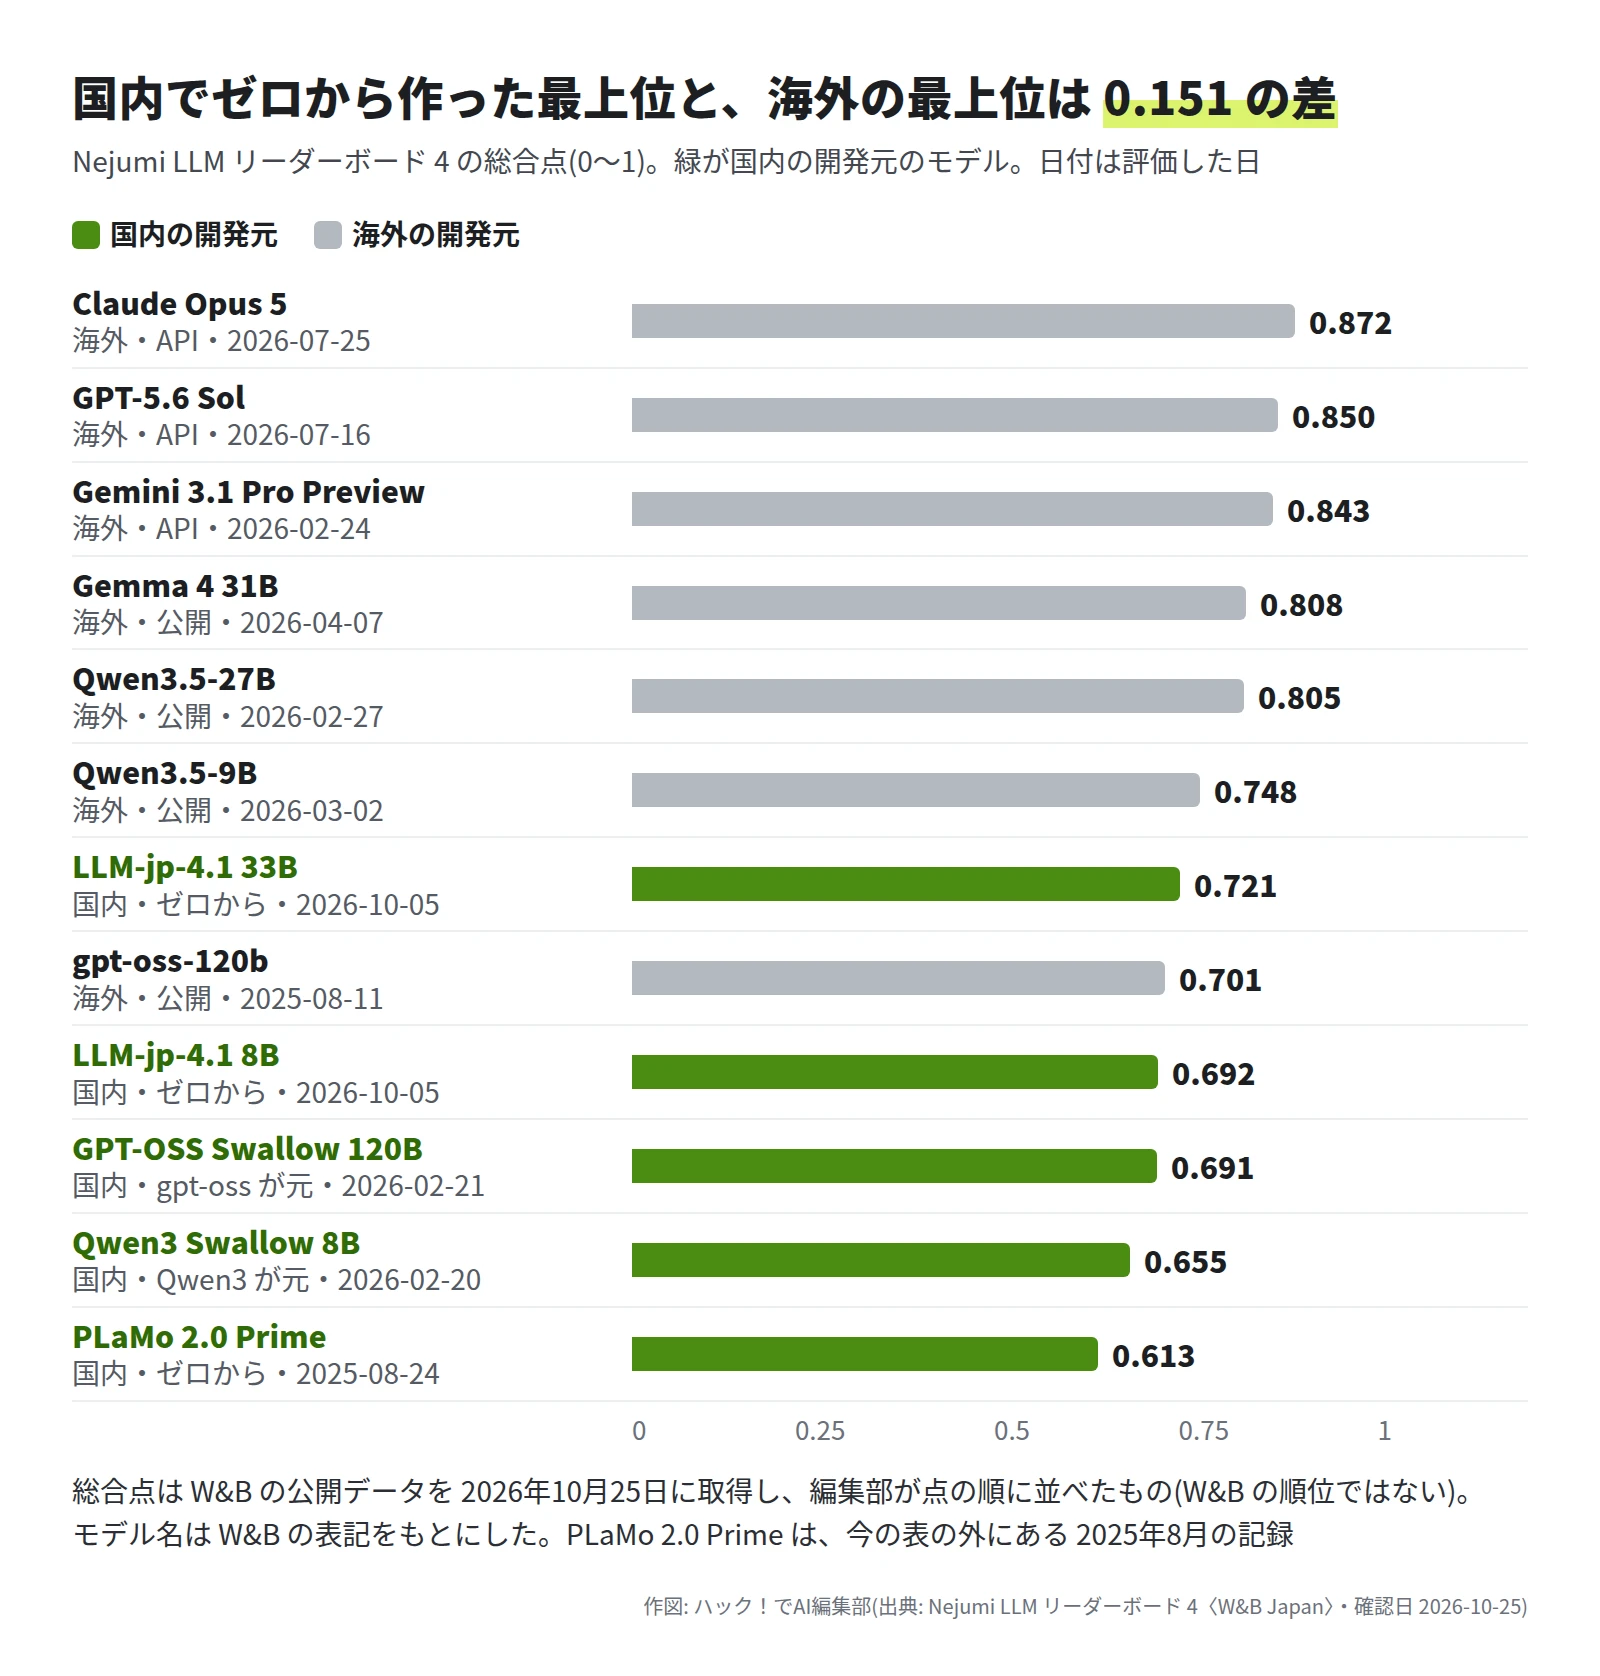
分野別に見ると、差の出方ははっきり分かれます。翻訳は Claude Opus 5 が 0.913、LLM-jp-4.1 33B が 0.903 でほぼ横並びで、文章の表現も 0.988 と 0.938 です。差が大きいのは抽象的推論(0.960 と 0.140)、SWE-bench(ソフトウェアの実際の課題を解いてコードを直す評価。0.750 と 0.288)、コーディング(0.908 と 0.543)でした。一般的知識は LLM-jp-4.1 33B が 0.718 で、同じくらいの大きさの Qwen3.5-27B(0.707)をわずかに上回っています。
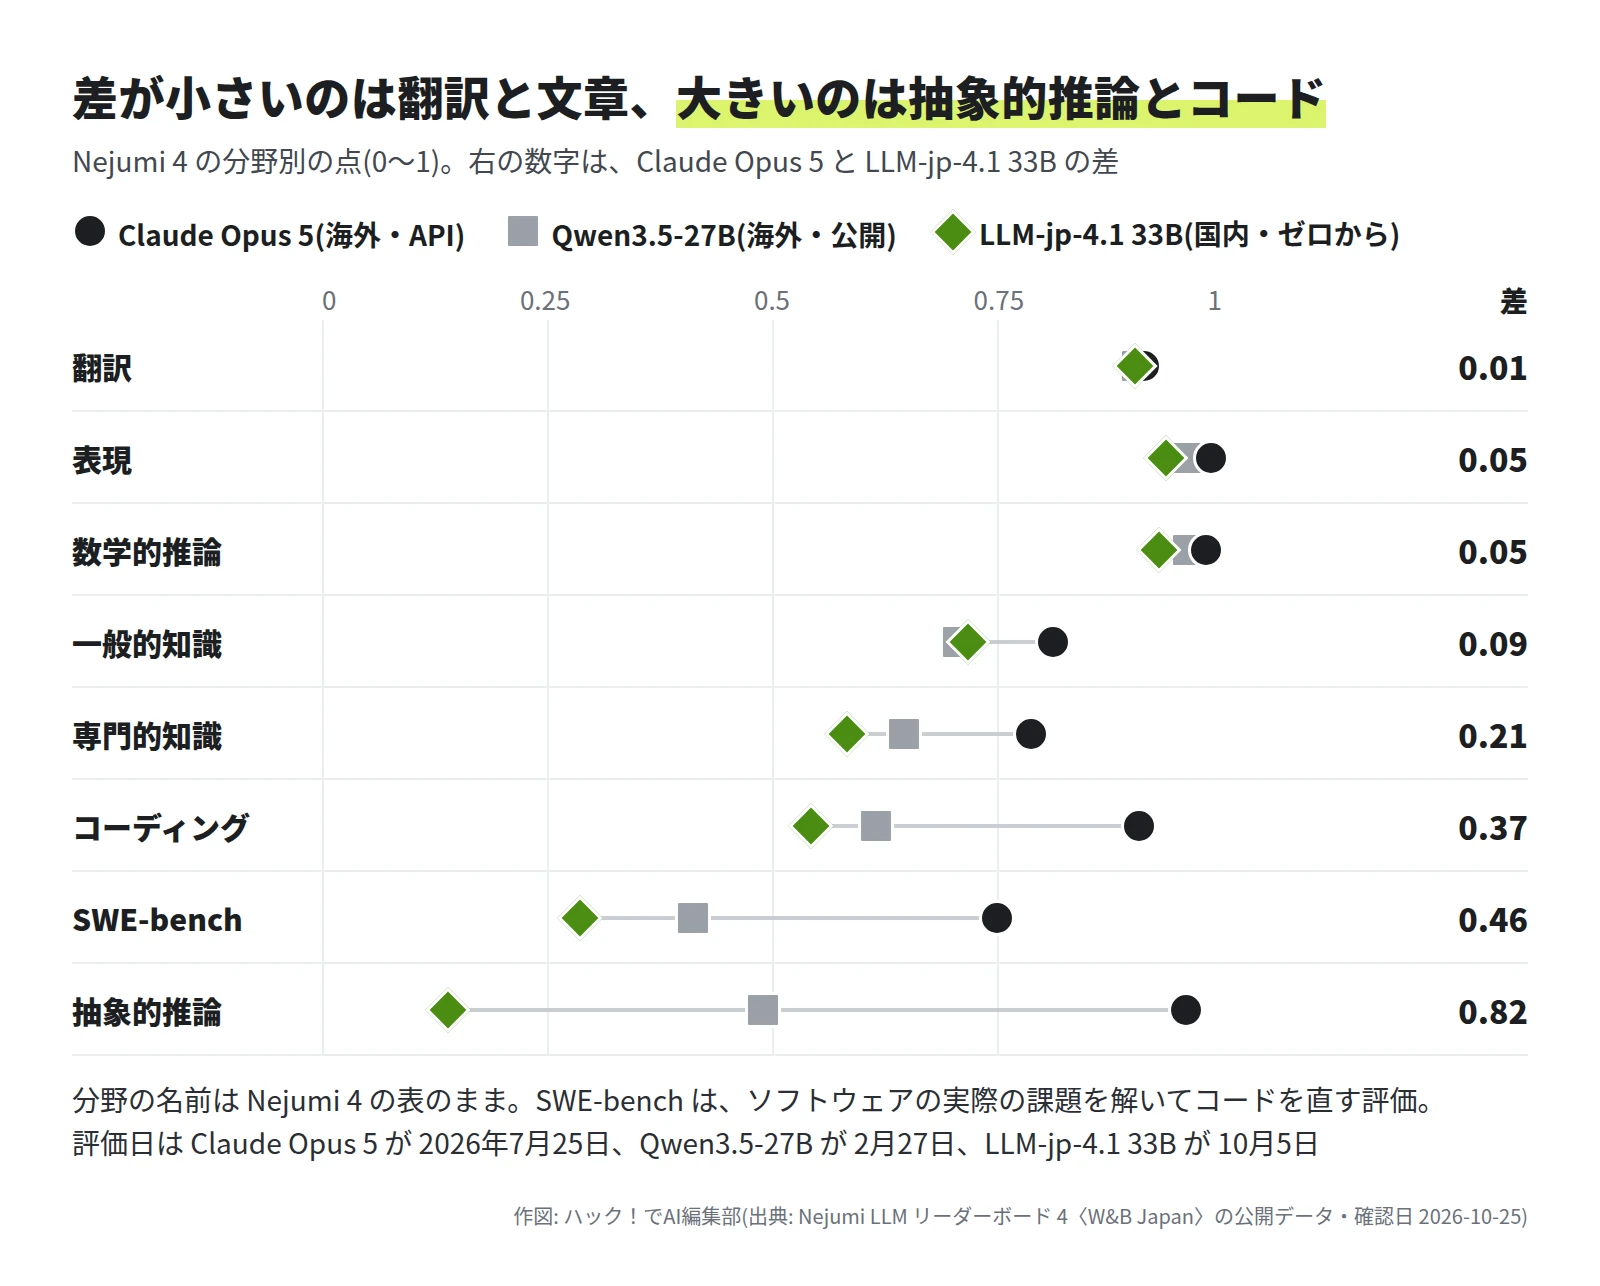
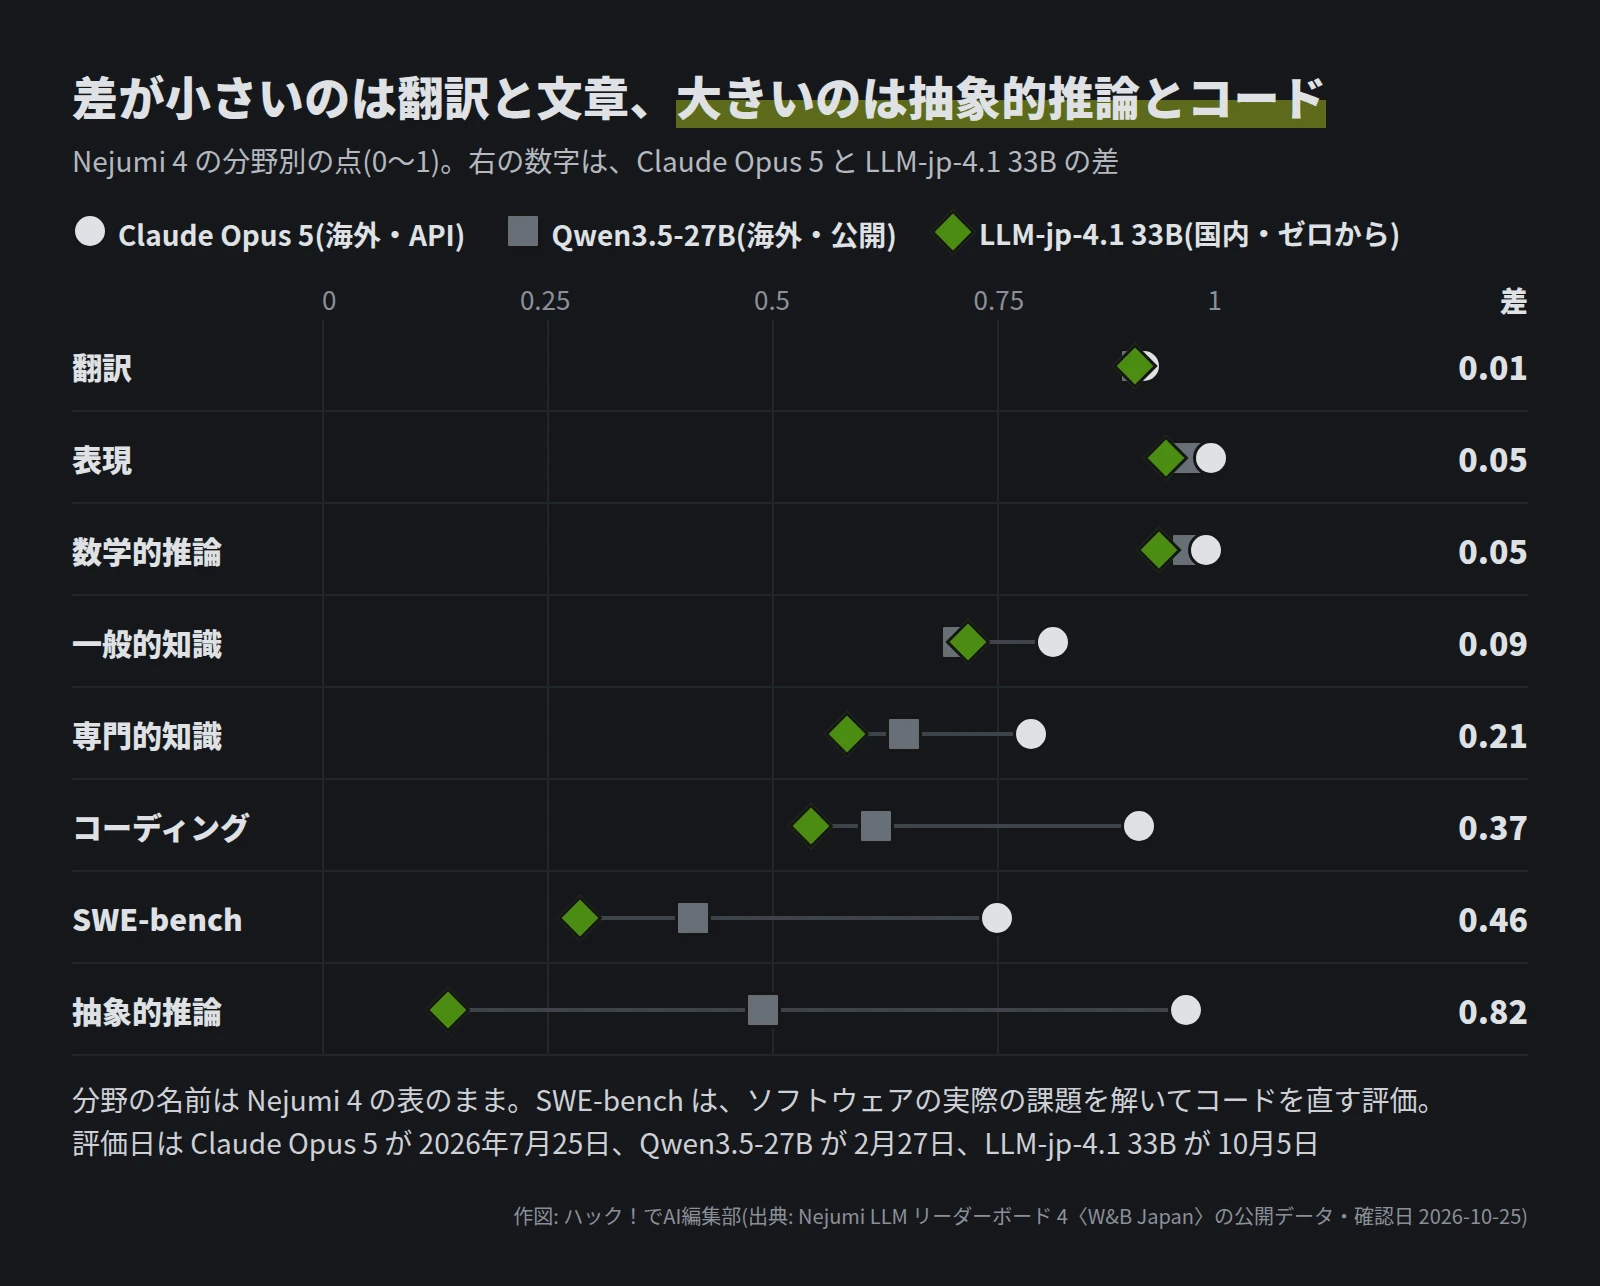
編集部が 6 つのモデルで敬語・要約・言い換えを比べた日本語に強い AI を 6 モデルで比べた記事でも、日本語の文章の点の差は、もう 1 回試すと入れ替わる程度でした。日本の会社の Sakana Namazu も、ほかの 5 つと同じ範囲です。今回の表を見るかぎり、日本語の文章や翻訳では国産か海外かの差は小さく、差が出るのは、考えて解く仕事とコードを書く仕事です。
商用の国産モデルは、第三者の表にほとんど載っていない
tsuzumi 2・PLaMo 3.0 Prime・cotomi v3・Takane・Sarashina3 は、Nejumi 4 の今の表にありません。PLaMo 2.0 Prime には、表の外に 2025 年 8 月の記録(0.613)が残っています。比べられる数字は、各社が自分で測った評価だけです。
たとえば PFN は、PLaMo 3.0 Prime を 15 種のベンチマーク(性能を測る共通の問題集)で比べ、「多くのベンチマークで同等程度」と書きました。同じブログには、Web の探索・長コンテキスト(長い入力を扱う力)・数学的推論・STEM 分野(理工系)・日本の法令では劣っており、改善が必要だという記述もあります。比べた相手は、同じ性能帯の公開モデル(Qwen3.6-27B・gpt-oss-120b)と、同じ価格帯の非公開のモデル(GPT-5.4 Mini・Claude Haiku 4.5)です。
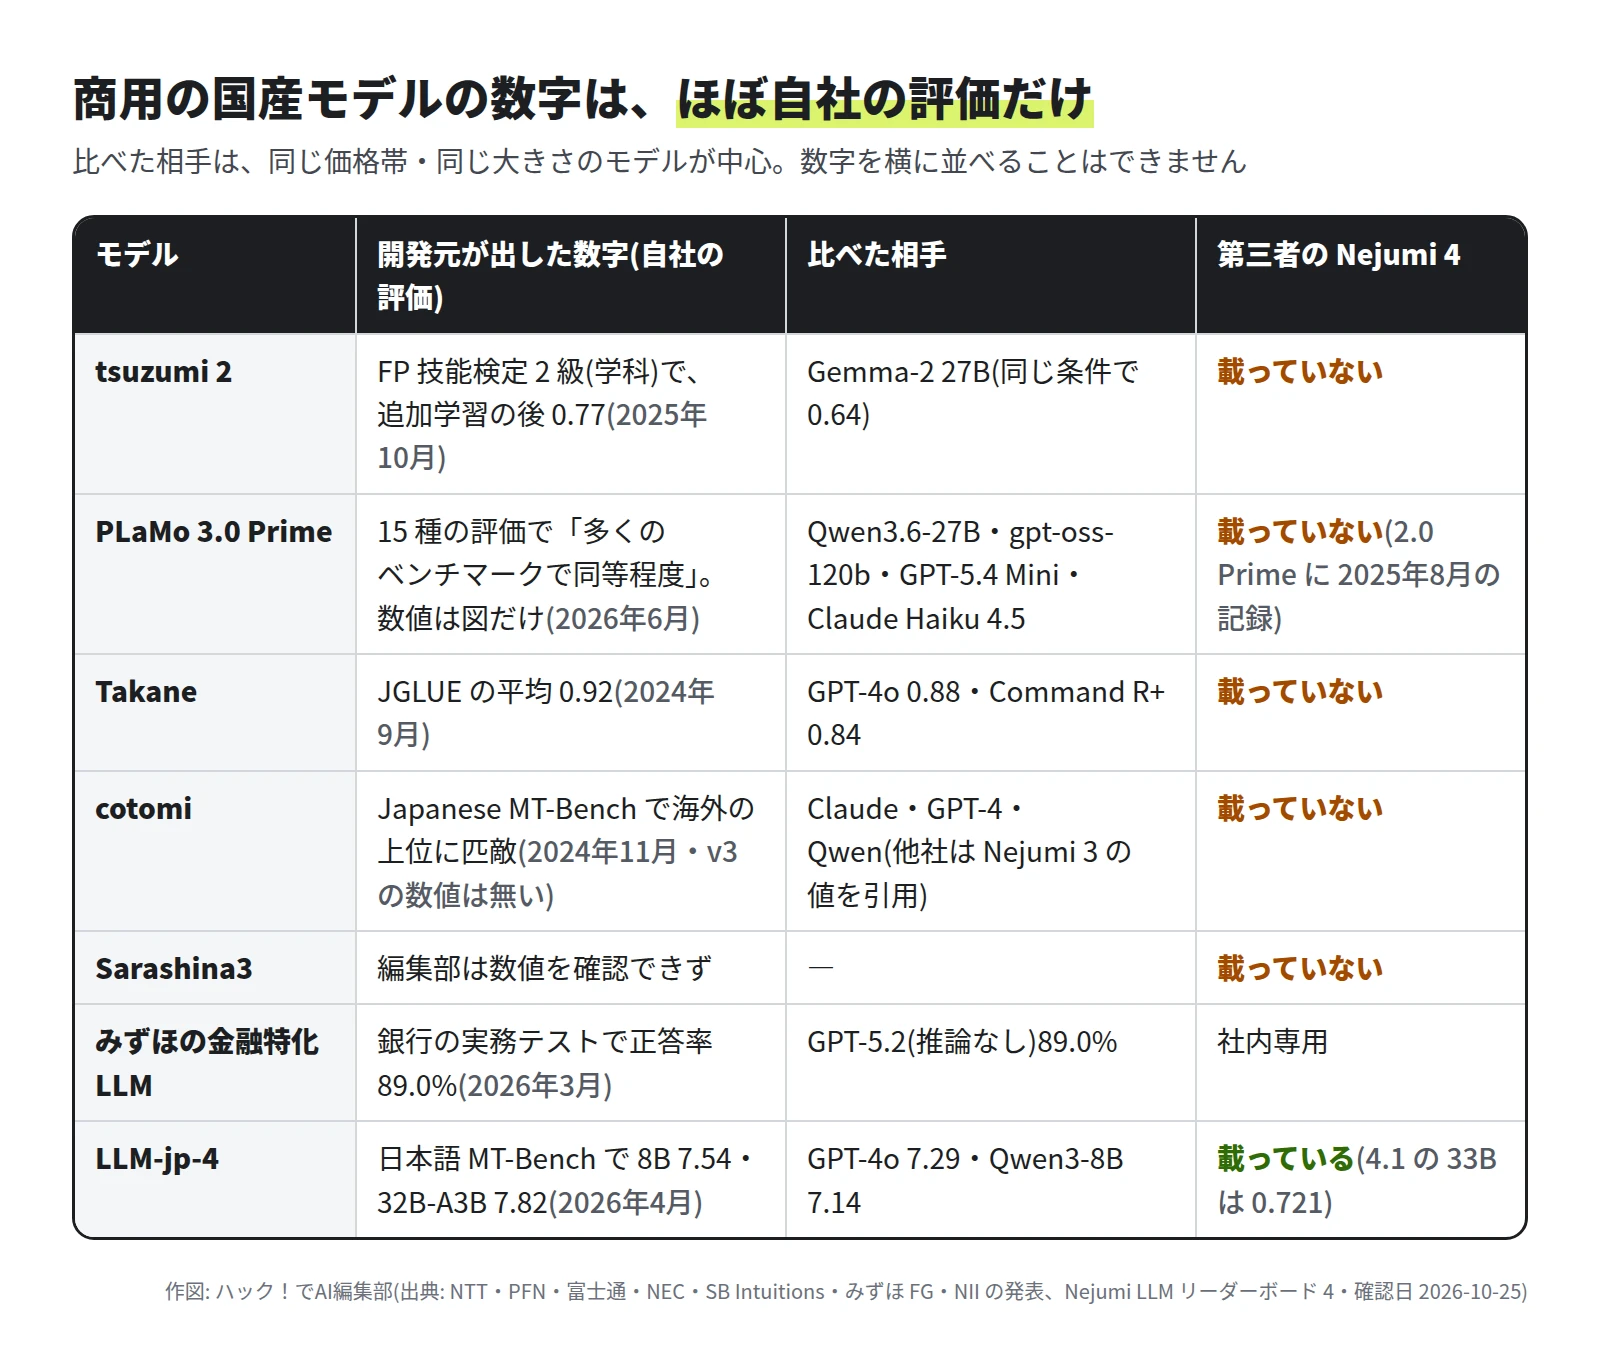
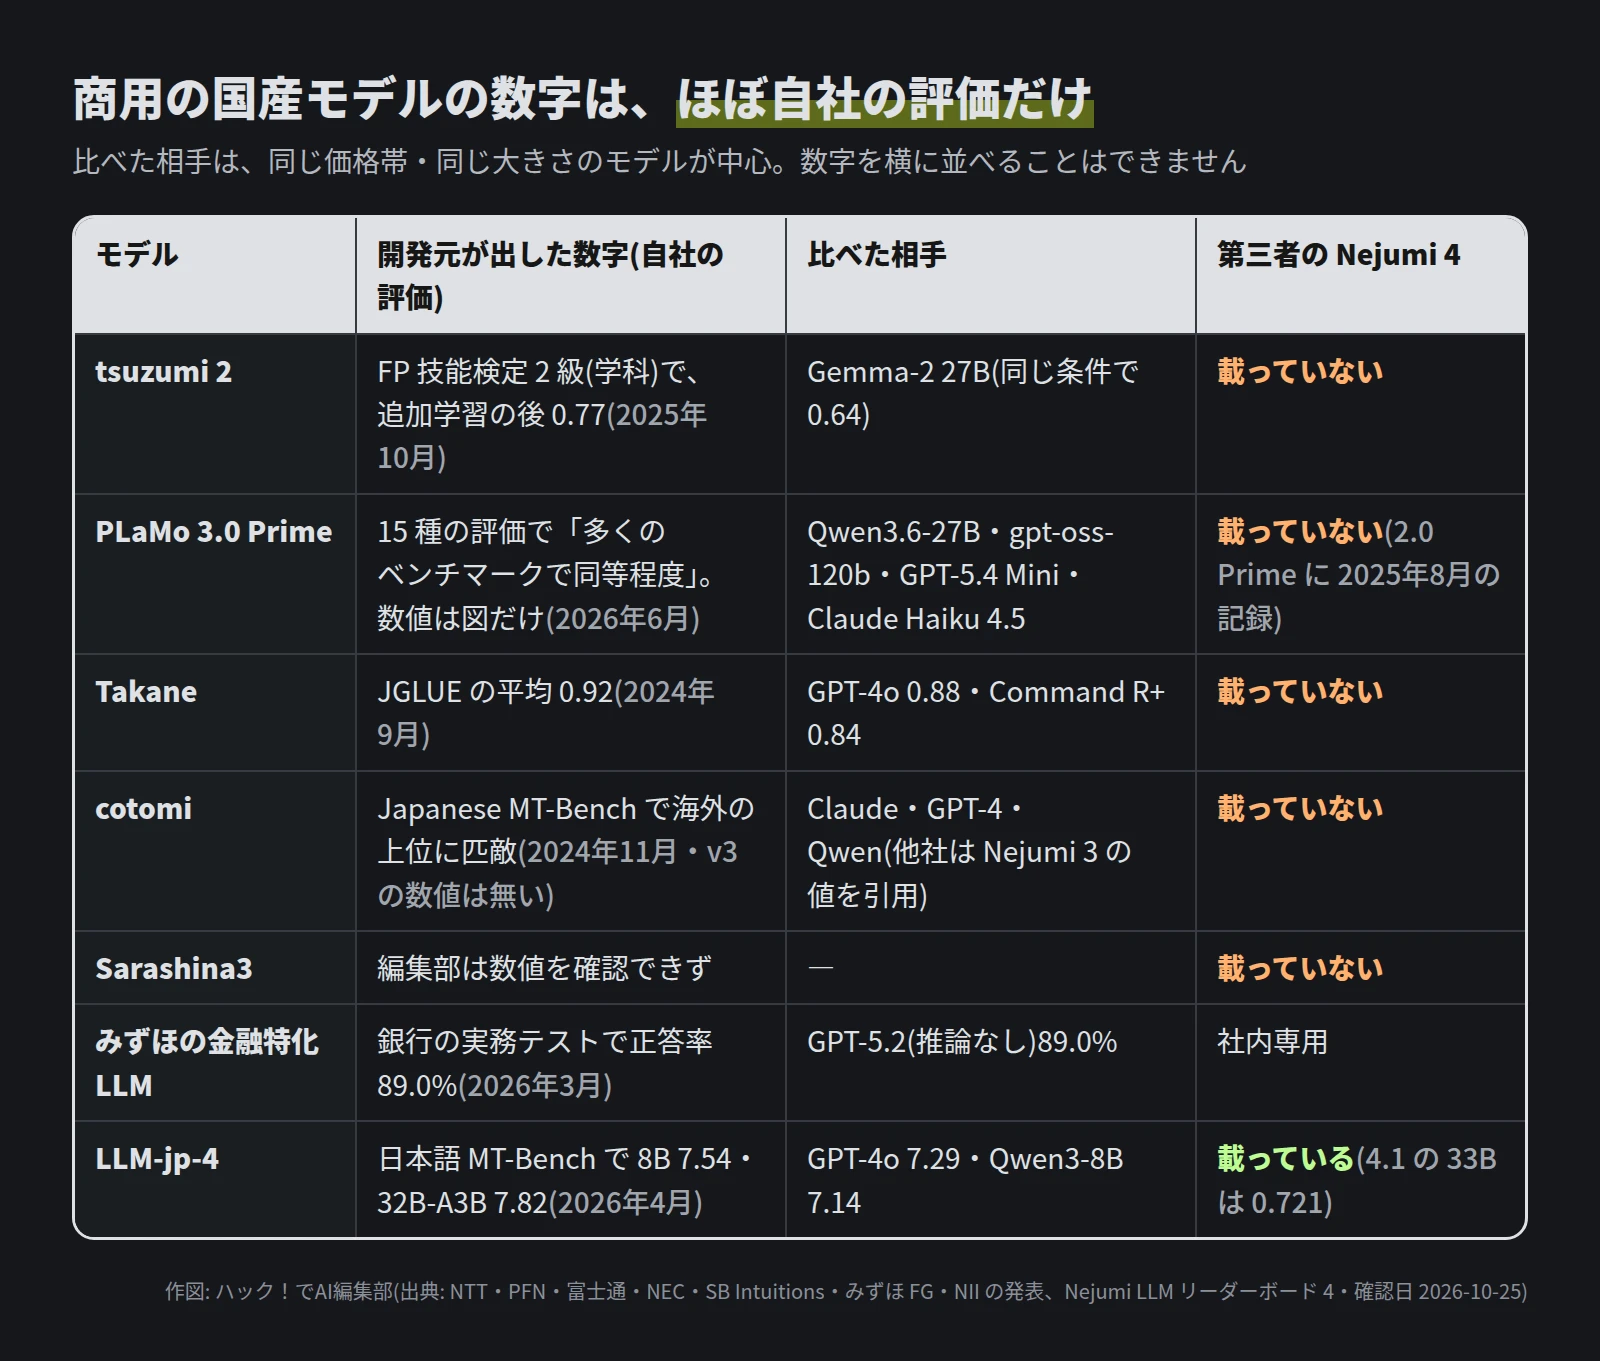
自社の評価が信用できない、という話ではありません。問題・条件・比べる相手が発表ごとに違うので、数字を横に並べられないのです。
デジタル庁は、源内で同じ条件の比べ方を計画しています。tsuzumi 2・Takane 32B・PLaMo 2.0 Prime をさくらのクラウドで動かし、2026 年 8 月までに実験の環境を作ります。そのうえで 9〜11 月に、源内のチャットで既存のモデルと名前を伏せて比べます。
源内での評価の結果は、2027 年 1 月ごろに一部が公表される予定です。それまでは、商用の国産モデルを同じ条件で比べた公開の数字はほとんど出てこないと編集部はみています。
重みが公開されていても、商用で使う前にライセンスを読む
型 C と型 D のモデルは手元で動かせますが、使える条件は同じではありません。Apache-2.0 と MIT は商用でも使え、主な義務はライセンス文や著作権表示を添えることです。
注意が要るのは 3 つです。PLaMo コミュニティライセンスは、商用で使う条件として、PFN への事前登録と、利用者か関係会社の直近の事業年度の収入または売上が 10 億円以下であることの両方を求めます。組織の内部での利用も「商業目的」に含まれるので、この条件を満たさない会社は、社内の業務で使う場合も PFN から商業用のライセンスを受けることになります。第三者に提供するときは、「Built with PLaMo」の表示と、PLaMo を使って作ったモデルの名前に「PLaMo」を入れることが求められます。
Llama 3.1 のライセンスでは、Llama 3.1 の公開日(2024 年 7 月 23 日)の時点で、月間の利用者が 7 億人を超えていた会社は、Meta の許諾が要ります。配布や提供のときは、「Built with Llama」の表示と、作ったモデルの名前の頭に「Llama」を付けることも求められます。
Gemma の利用規約は、使用制限を相手との契約に入れて引き継ぐことを求めます。Gemma が作った合成データで学習したモデルも、派生モデルとして規約の対象です。東京科学大学の Llama-3.1-Swallow-8B-Instruct-v0.5 には、Llama と Gemma の両方の条件が付いています。モデルカードを見ると、指示に従う学習のデータは Gemma 3 で作られていました。
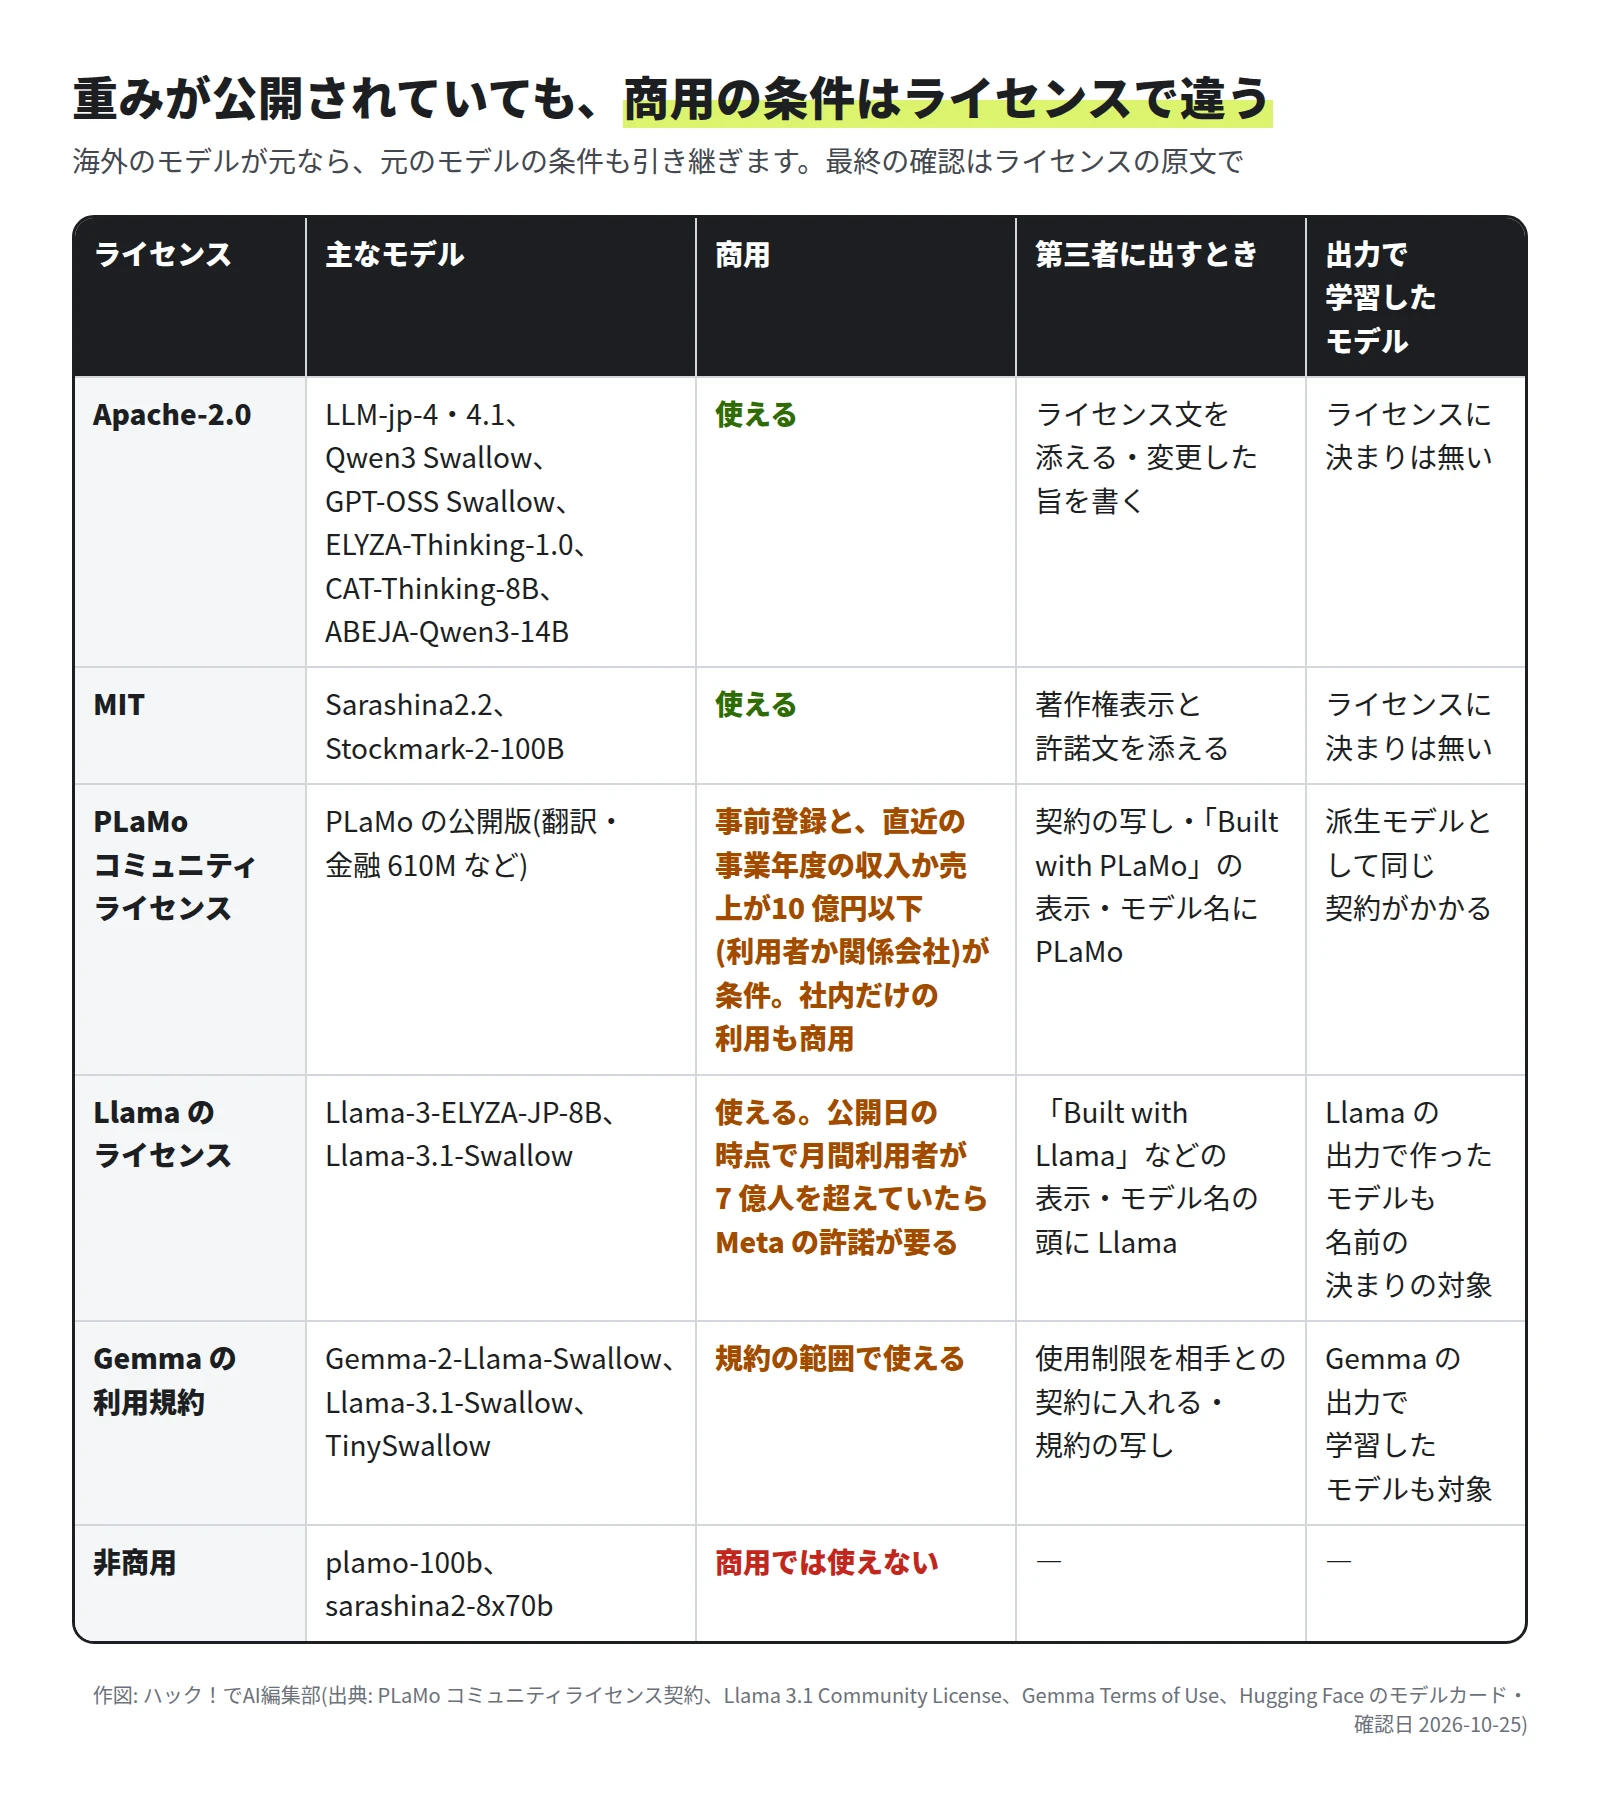
商用で使う前に確かめるのは、(1) そのモデル自体のライセンス、(2) 元のモデルのライセンス、(3) 学習に別のモデルの出力を使ったかどうか、(4) 社外に出すときの表示の決まり、の 4 点です。最終の確認は各ライセンスの原文で行い、必要なら専門家に相談してください。
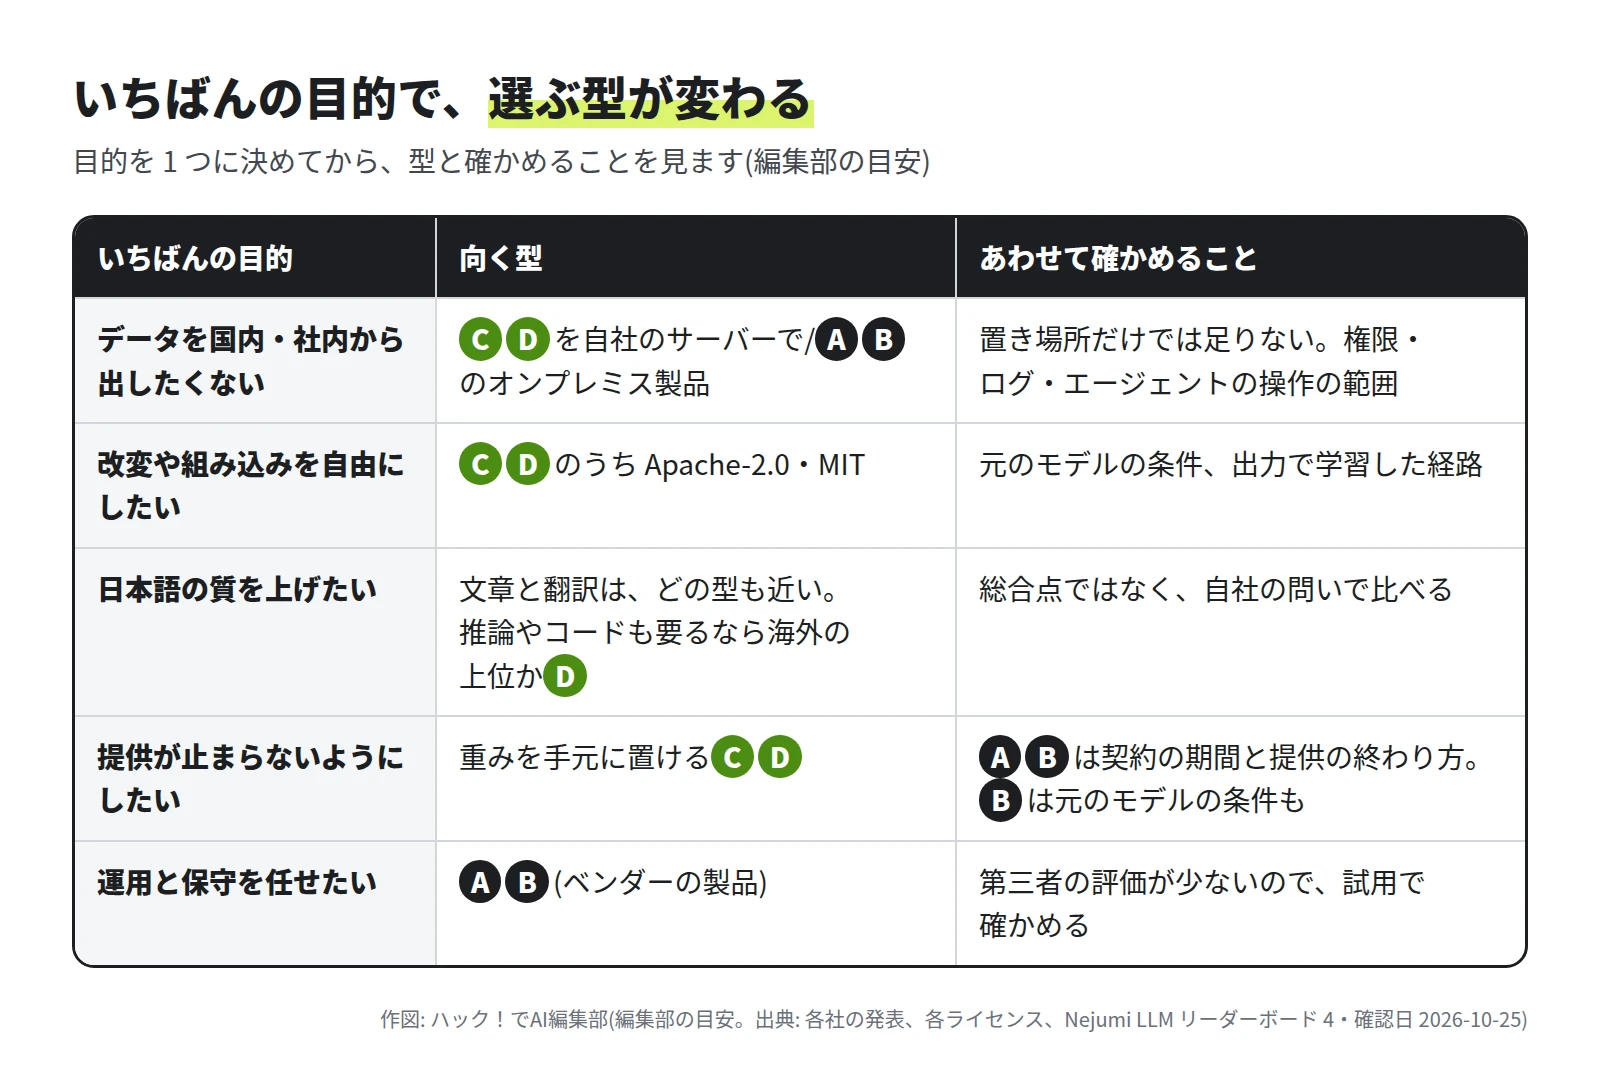
自社のいちばんの目的で、選ぶ型が変わる
どの型がよいかは、何を最も大事にするかで決まります。
- データを国内・社内から出したくない: 型 C・D を自社のサーバーで動かすか、型 A・B のオンプレミス向けの製品を選びます。ただし、置き場所を社内にしただけでは足りず、誰がどのデータを引けるか(権限)や記録(ログ)の設計も要ります。構成は第 4 回、AI に入れた情報の行き先は連載「機密情報とAI」の第 1 回で扱っています。
- 改変や自社製品への組み込みを自由にしたい: 型 C・D のうち、Apache-2.0 や MIT のモデルが候補です。
- 日本語の質を上げたい: 文章と翻訳は、国産か海外かの差が小さい分野でした。推論やコードも任せたいなら、海外の上位のモデルか、海外の公開モデルに日本語を足した型 D が候補になります。
- 提供が止まらないようにしたい: 型 C・D は、提供元の方針が変わっても、手元の重みで動かし続けられます。型 A・B は契約の期間と提供の終わり方を確かめ、型 B は元のモデルの条件も見ます。
- 運用と保守を任せたい: ベンダーの製品である型 A・B が向きます。第三者の評価が少ないので、自社の仕事の問いで試用してから決めます。
「国産なら安心」とも「国産は弱い」とも言い切れない
国産 LLM については、国産のモデルはもうそろっていて、最先端の汎用モデルを追うより、業界ごとに絞ったモデルで強みを出すべきだ、という見方があります。地図と数字で照らすと、確かめられた点と、言い直しが要る点、まだ決められない点に分かれました。
確かめられたのは、国産のモデルが製品としてすでにあり、オンプレミスの構成や金融向けのモデルも出ていることです。最上位の汎用モデルとの差が、第三者の表で推論とコードに大きく出ていることも、この見方と合います。
言い直しが要るのは、「国産」の中身です。国内の会社が作ったモデルにも、海外のモデルが元のもの(Takane の初版、Sakana Namazu、みずほの金融特化 LLM)があります。国産を選ぶことは、海外のモデルに頼らないことと同じではありません。
まだ決められないのは、業界専用のモデルが汎用のモデルより仕事で役に立つかです。公開された比べ方はまだ少なく、みずほの金融特化 LLM が推論を使わない条件で GPT-5.2 と同じ正答率(89.0%)だったのも、自社の実務テストでの結果です。
大きさをそろえても、差は残ります。同じくらいの大きさの Qwen3.5-27B と比べても、LLM-jp-4.1 33B は総合で 0.084 低い結果でした。特に差が開いたのは、抽象的推論(0.490 と 0.140)と SWE-bench(0.413 と 0.288)です。
ここからは編集部の見方です。差の理由はモデルの大きさだけではなく、学習に使った計算資源やデータの違いが効いていそうですが、公表された資料からは決めきれません。選ぶときは、国産かどうかの一言より、「どこで動くか」「誰が提供を止められるか」「何を元に作ったか」の 3 つで見るほうが、自社の判断に結びつきます。
候補を絞るときは、ベンダーに 3 つを聞く
自社の候補を絞るには、まず上の 5 つの目的から、いちばん大事なものを 1 つ選びます。型 A・B の製品なら、ベンダーに「元のモデルはあるか(あれば名前)」「第三者の評価はあるか」「データをどこで処理し、提供が終わるときはどうなるか」の 3 つを聞きます。型 C・D の公開モデルなら、ライセンスを上の 4 点で確かめ、自社の仕事の問いで試します。
重みが公開された国産のモデルを、外と通信しない環境で動かすとどこまで使えるかは、第 5 回で試します。GPU の無いサーバーと、GPU 8GB の PC の両方で動かしました。
次の回は、国がなぜ AI を作らせるのかを、GENIAC・源内・ABCI 3.0 の資料から読み解きます(第 2 回)。
参考にした公式の情報
- デジタル庁「ガバメントAIで試用する国内大規模言語モデル(LLM)の公募」(2025年12月2日)
- デジタル庁「ガバメントAIで試用する国内大規模言語モデル(LLM)の公募結果」(2026年3月6日)
- デジタル庁 2026年度に源内で評価検証を行う国産基盤モデルの発表(2026年5月29日)
- デジタル庁 別紙1「令和8年度(2026年度)に源内で評価検証を行う企業一覧」
- デジタル庁 さくらのクラウドで国産基盤モデルを動かす実証(2026年8月21日更新)
- NEDO GENIAC の公募(2026年度・開発対象と「国内で開発された基盤モデル」の定義)
- 内閣府「人工知能基本計画」(2026年7月14日 閣議決定)
- NTT 報道発表「tsuzumi 2」の提供開始(2025年10月20日)
- NTT「tsuzumi 2」説明資料(2025年10月20日)
- エフサステクノロジーズ・NTT西日本「tsuzumi 2」のオンプレミス運用の動作検証の完了(2026年8月26日・PR TIMES)
- Preferred Networks「PLaMo 3.0 Prime」正式版の提供開始(2026年6月22日)
- Preferred Networks 技術ブログ「PLaMo 3.0 Prime」(2026年6月22日)
- Preferred Networks 金融特化型 PLaMo の Snowflake での提供開始(2026年2月10日)
- PLaMo コミュニティライセンス契約
- NEC「cotomi v3」がデジタル庁の公募に選定(2026年3月9日)
- NEC 130億パラメータの LLM の開発(2023年7月6日)
- NEC cotomi の性能強化(2024年11月27日)
- 富士通「Takane」の提供開始(2024年9月30日)
- SB Intuitions「Sarashina3」シリーズの提供開始(2026年6月30日)
- SB Intuitions「Med-Sarashina」の共同研究(2026年8月10日)
- 国立情報学研究所「LLM-jp-4」の公開(2026年4月3日)
- LLM-jp「LLM-jp-4.1」の公開(2026年9月28日)
- Swallow LLM「Qwen3 Swallow」
- Swallow LLM「GPT-OSS Swallow」
- Hugging Face「ELYZA-Thinking-1.0-llm-jp-4-33b」
- ELYZA のプレスリリース「ELYZA RSI Research」の設立と研究成果の公開(2026年10月2日)
- Hugging Face「Llama-3-ELYZA-JP-8B」
- Hugging Face「Llama-3.1-Swallow-8B-Instruct-v0.5」
- Hugging Face「CAT-Thinking-8B」(サイバーエージェント)
- Hugging Face「ABEJA-Qwen3-14B-Agentic-256k-v0.1」
- Hugging Face「TinySwallow-1.5B-Instruct」(Sakana AI)
- Hugging Face「sarashina2.2-3b-instruct-v0.1」
- Hugging Face「Stockmark-2-100B-Instruct」
- Hugging Face「RakutenAI-3.0」
- Sakana AI「Sakana Namazu」API の提供開始(2026年8月3日)
- みずほフィナンシャルグループ 金融特化LLMの発表(2026年3月5日・PR TIMES)
- Meta「Llama 3.1 Community License」
- Google「Gemma Terms of Use」
- Nejumi LLM リーダーボード 4
- W&B のレポート「Nejumi LLMリーダーボード4」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。