 佐々木 航
この記事でわかること
- Q4_K_M などの名前の読み方と、量子化と蒸留の違い
- 6 つの形式の大きさ・メモリ・速さ・正しさの実測
- PC のメモリの量ごとの、モデルとビット数の選び方
確認した環境: llama.cpp b11852(公式のリリースの Linux の CPU 版)・Qwen3-4B-Instruct-2507 を、編集部の検証用のサーバー(CPU 24 コア・メモリ 94GB・GPU なし)で実行 / 2026年10月24日に確認
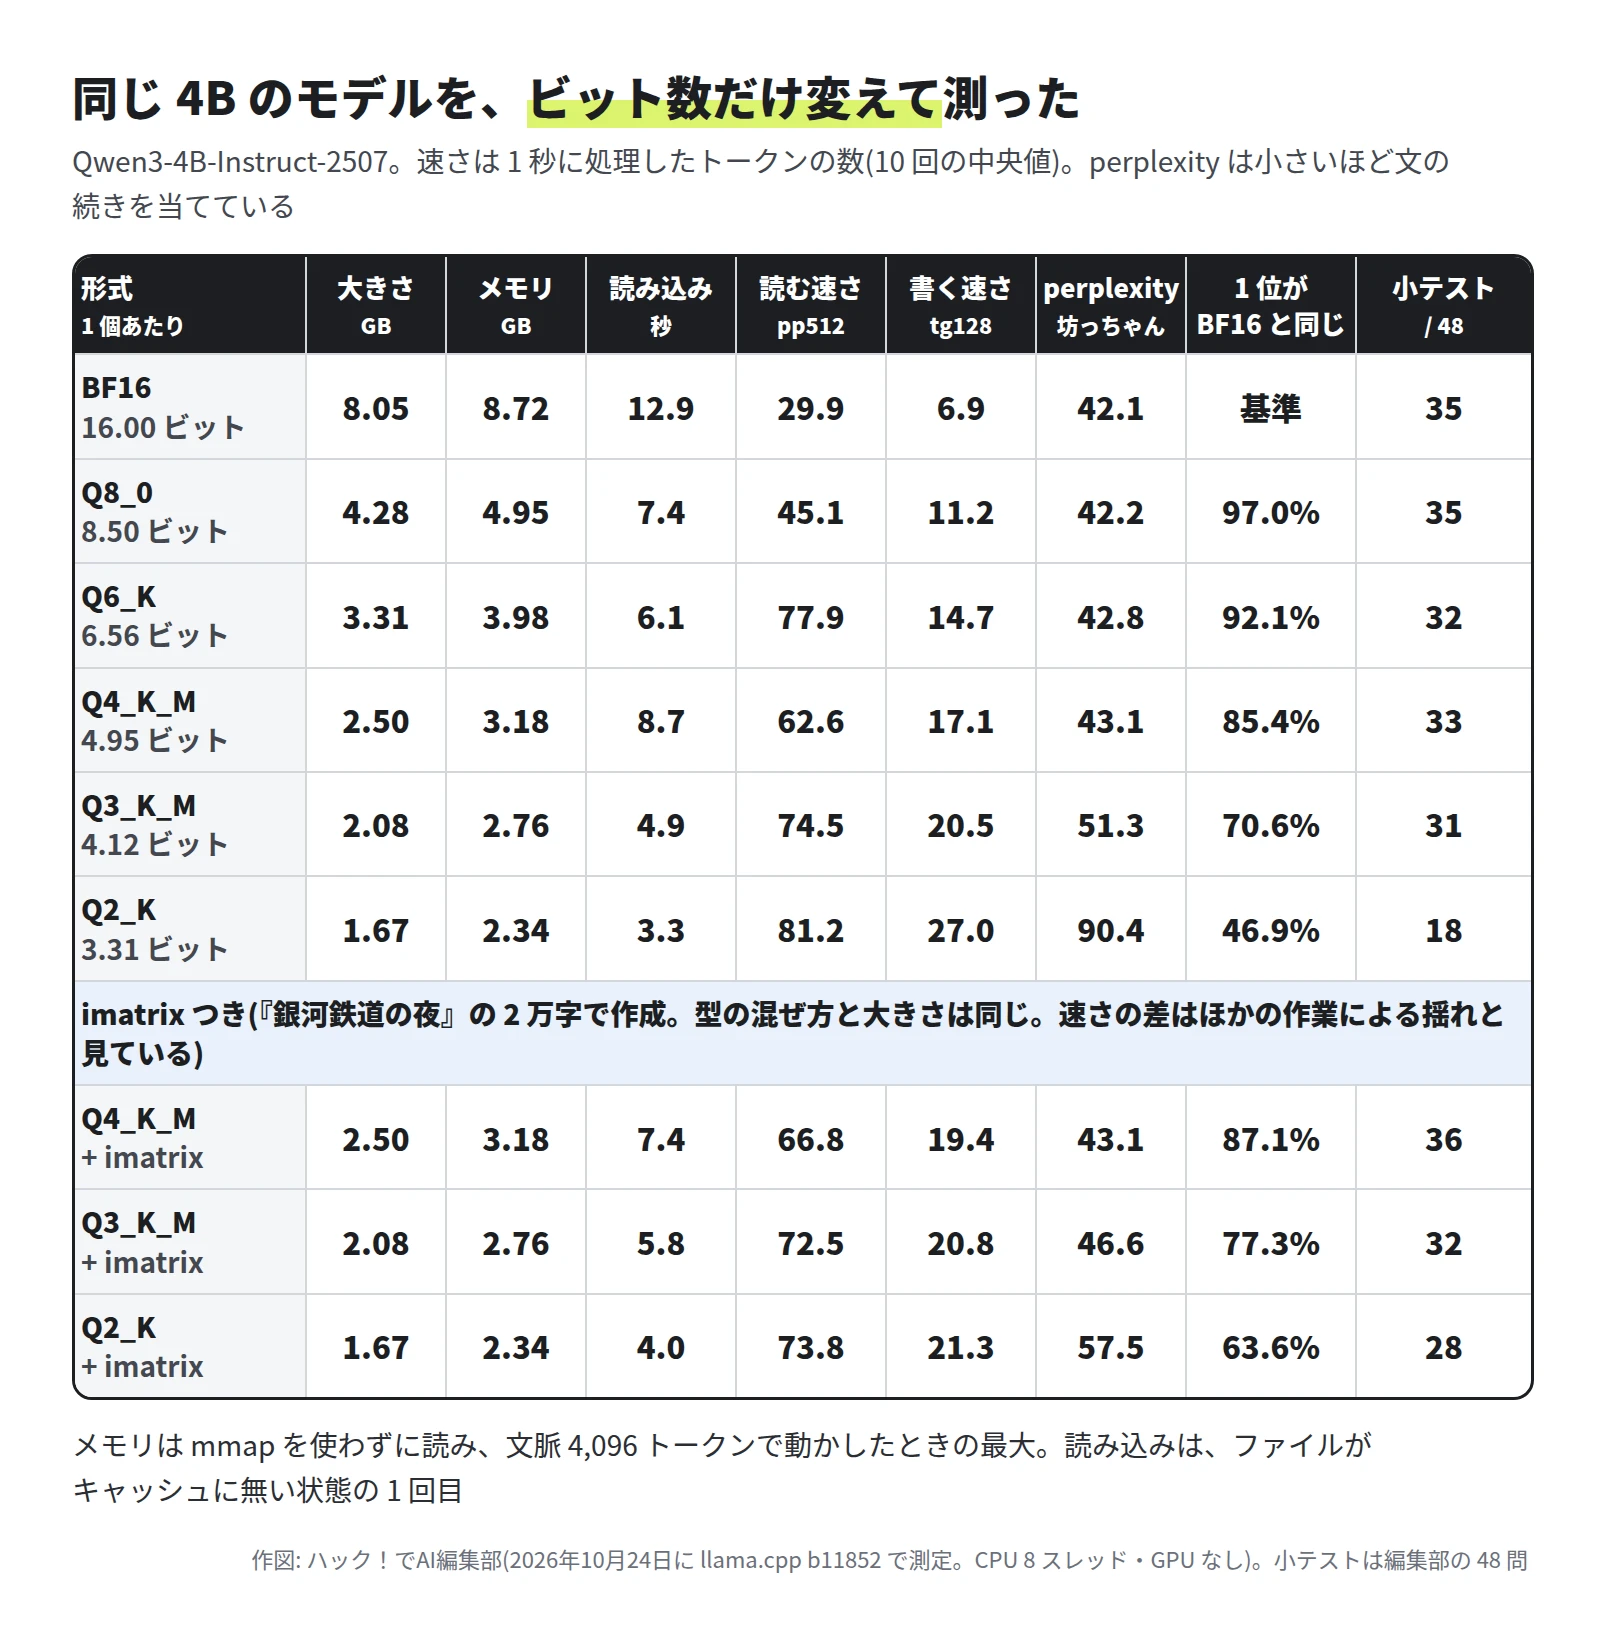
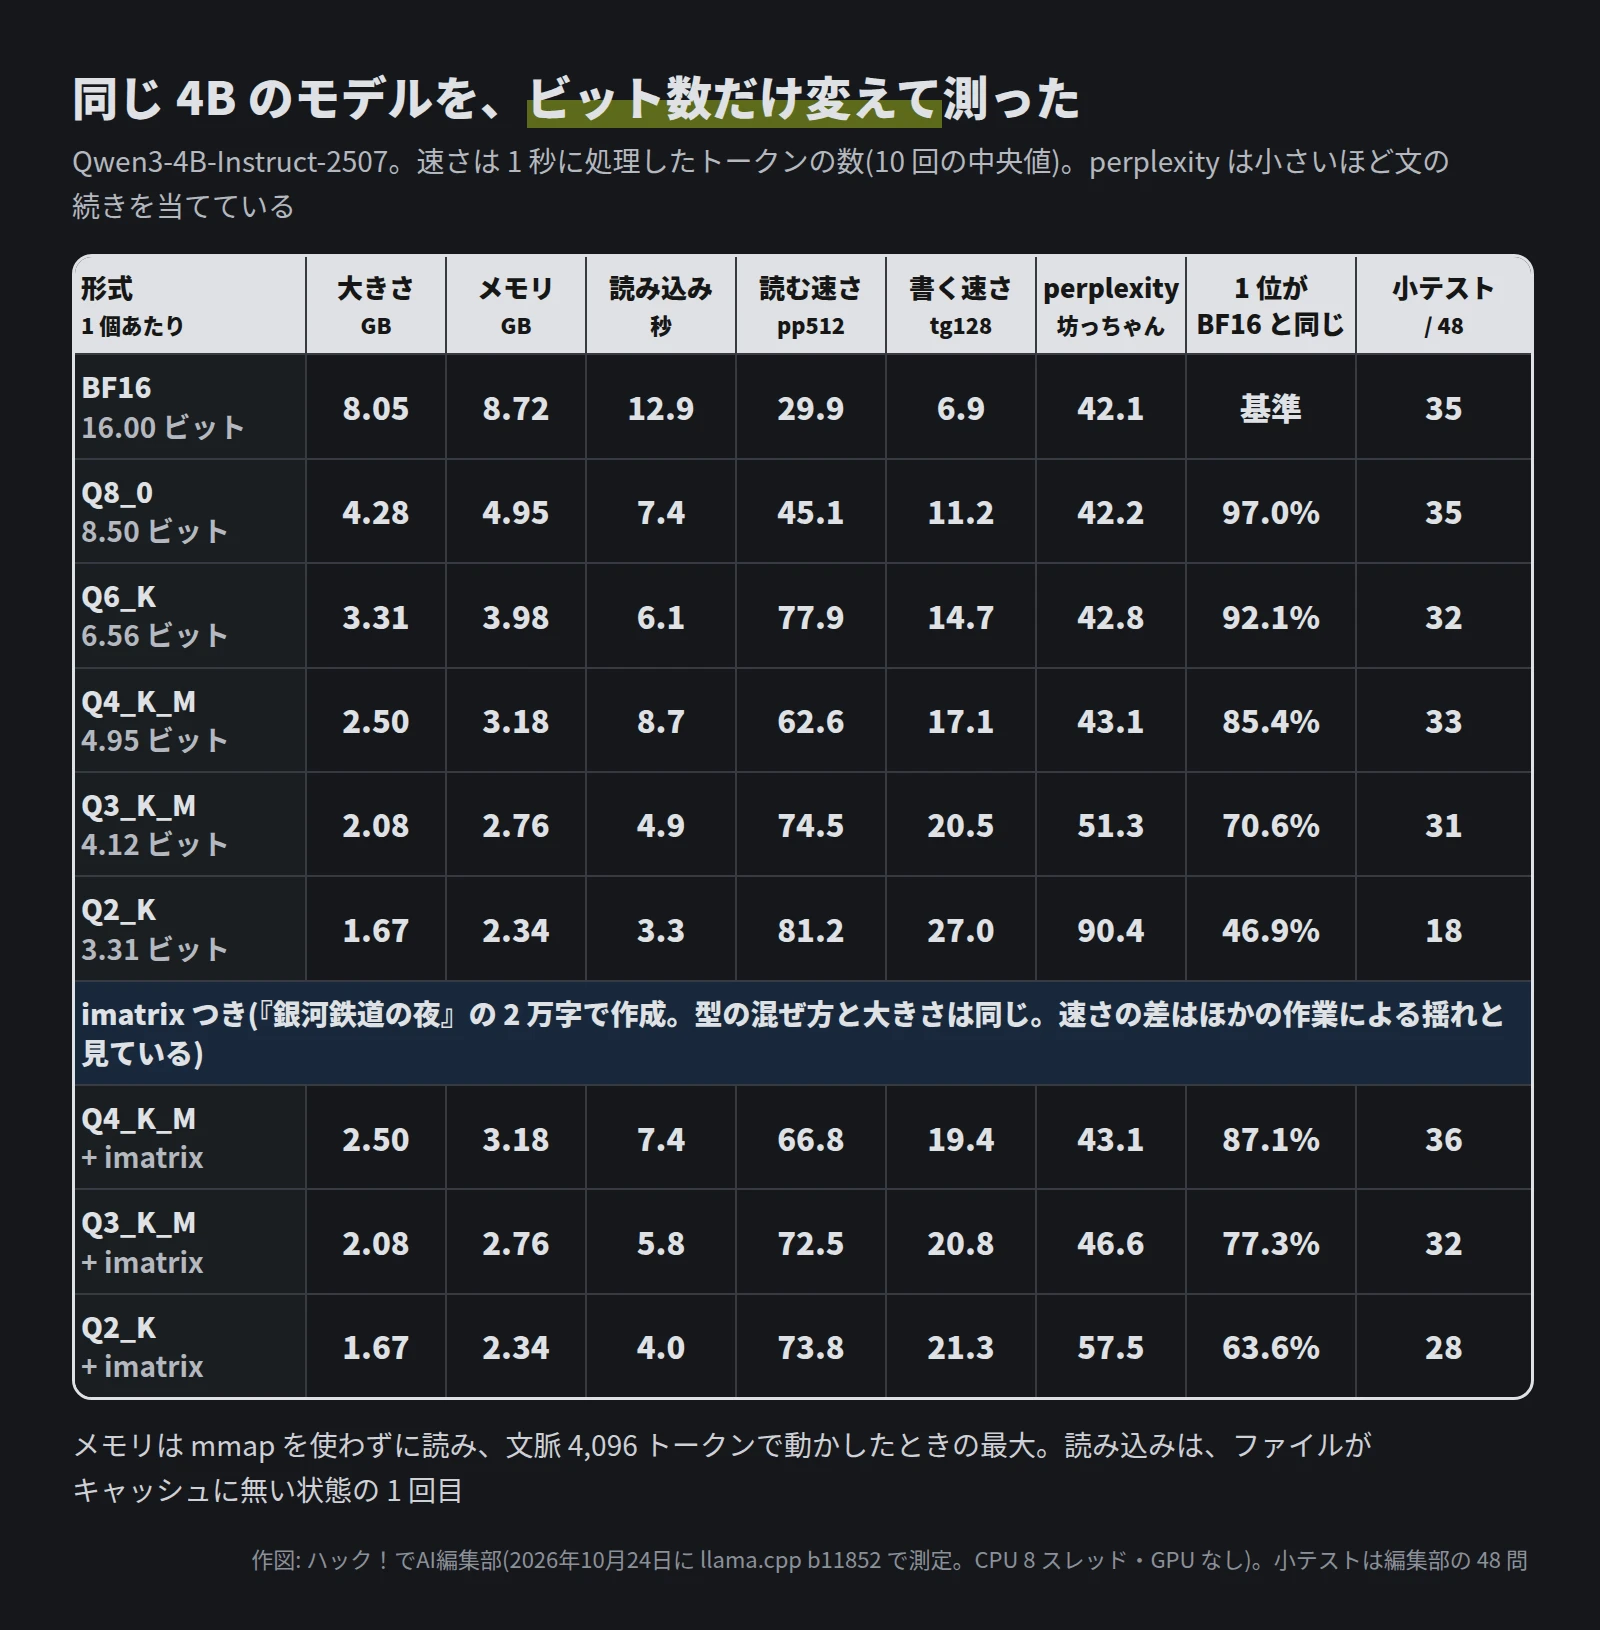
社内の PC で AI を動かそうと Hugging Face を開くと、同じモデルに Q8_0・Q4_K_M・Q2_K とファイルが並んでいて、どれを落とせばよいか迷います。編集部は公開のモデル Qwen3-4B-Instruct-2507 を自分で量子化し、元の BF16 と 5 つの形式を、GPU の無いサーバーで測りました。Q4_K_M はファイルが BF16 の 31%(2.50GB)、答えを書く速さは 2.5 倍で、日本語の文の当てにくさ(perplexity)は BF16 の 1.03 倍でした。3 ビットの Q3_K_M から崩れ始め、2 ビットの Q2_K は 48 問の正答が 35 から 18 に減りました。
結果を 1 枚の表で見る
量子化は、重みを少ない段で持ち直す
LLM の中身は、数十億個の数(重み)です。配られている元の形は 1 個 16 ビットの BF16 が多く、4B のモデルで 8.05GB あります。量子化は、この数を 8・6・4 ビットなどの少ない段に丸めて持ち直すことです。
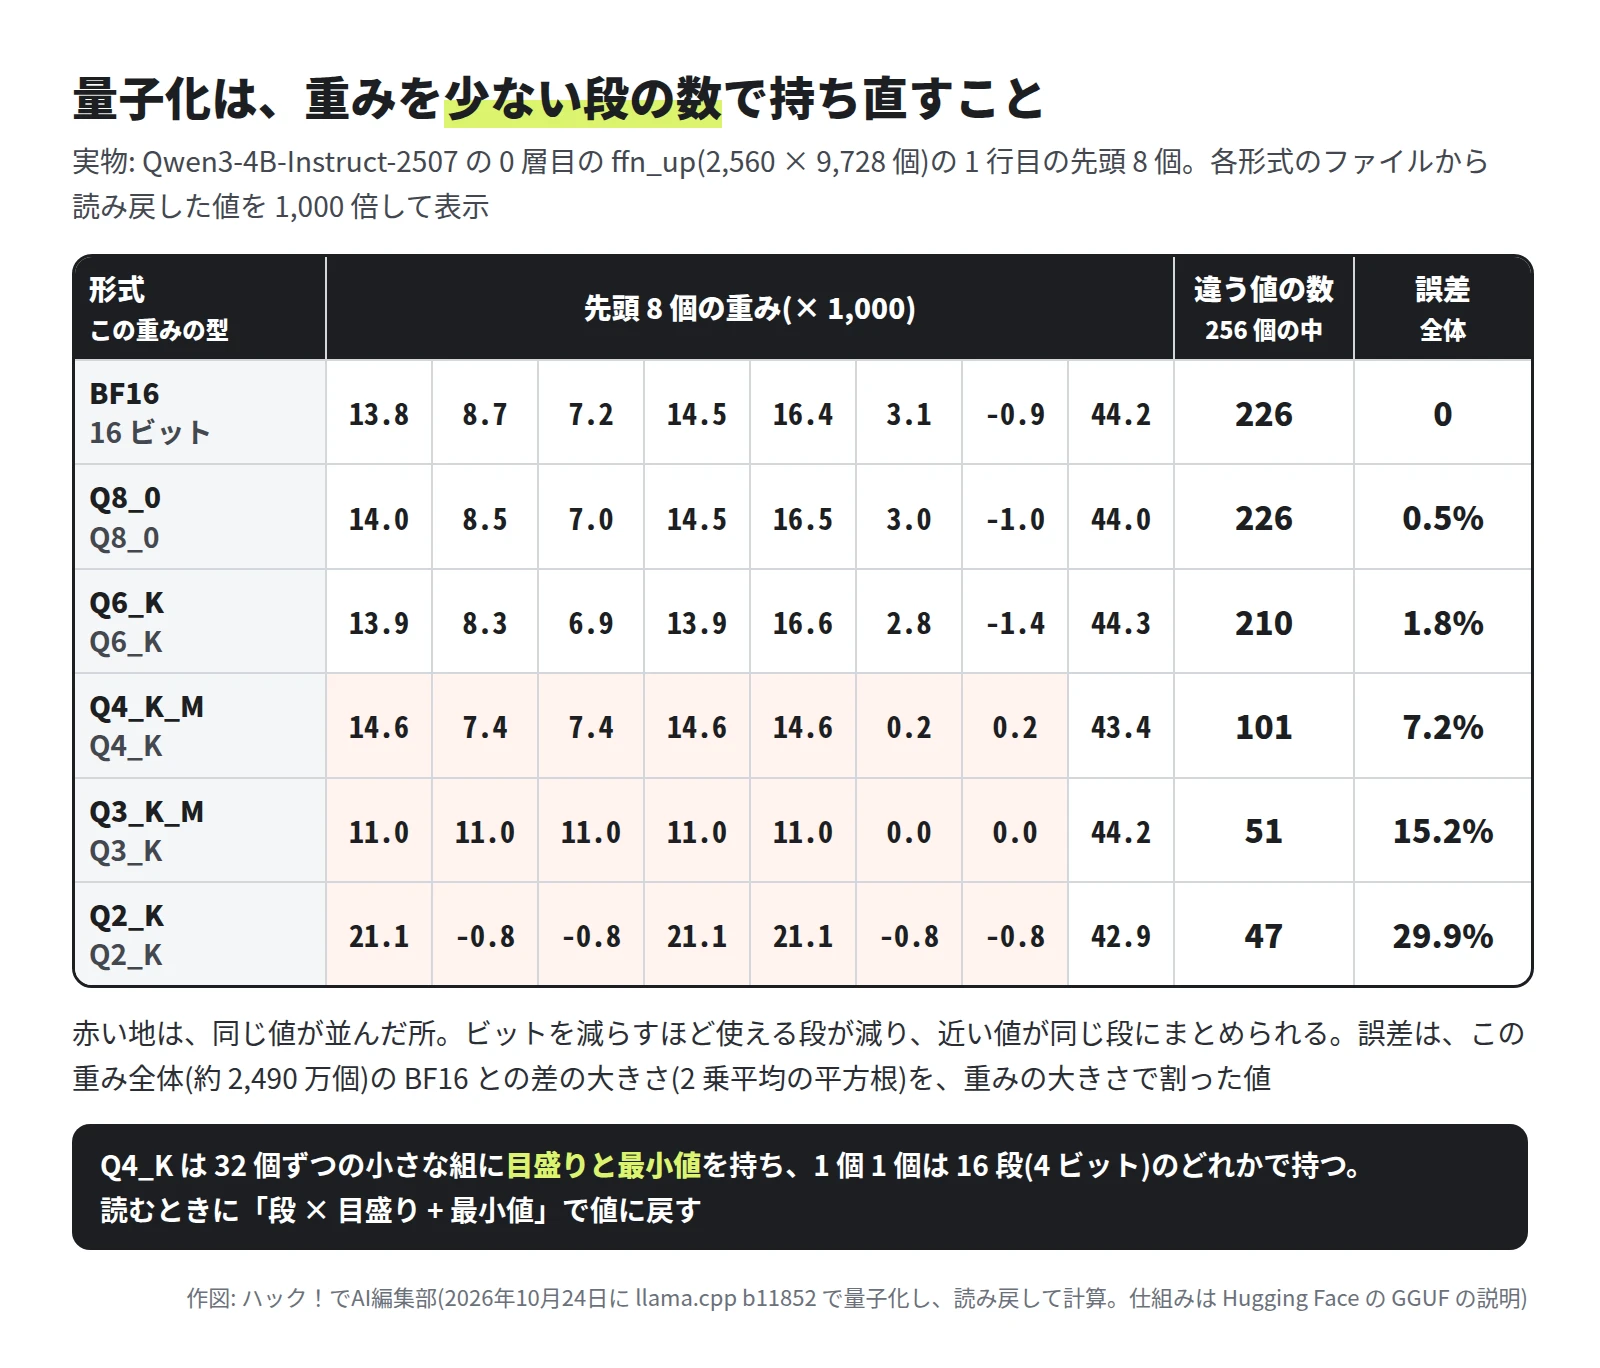
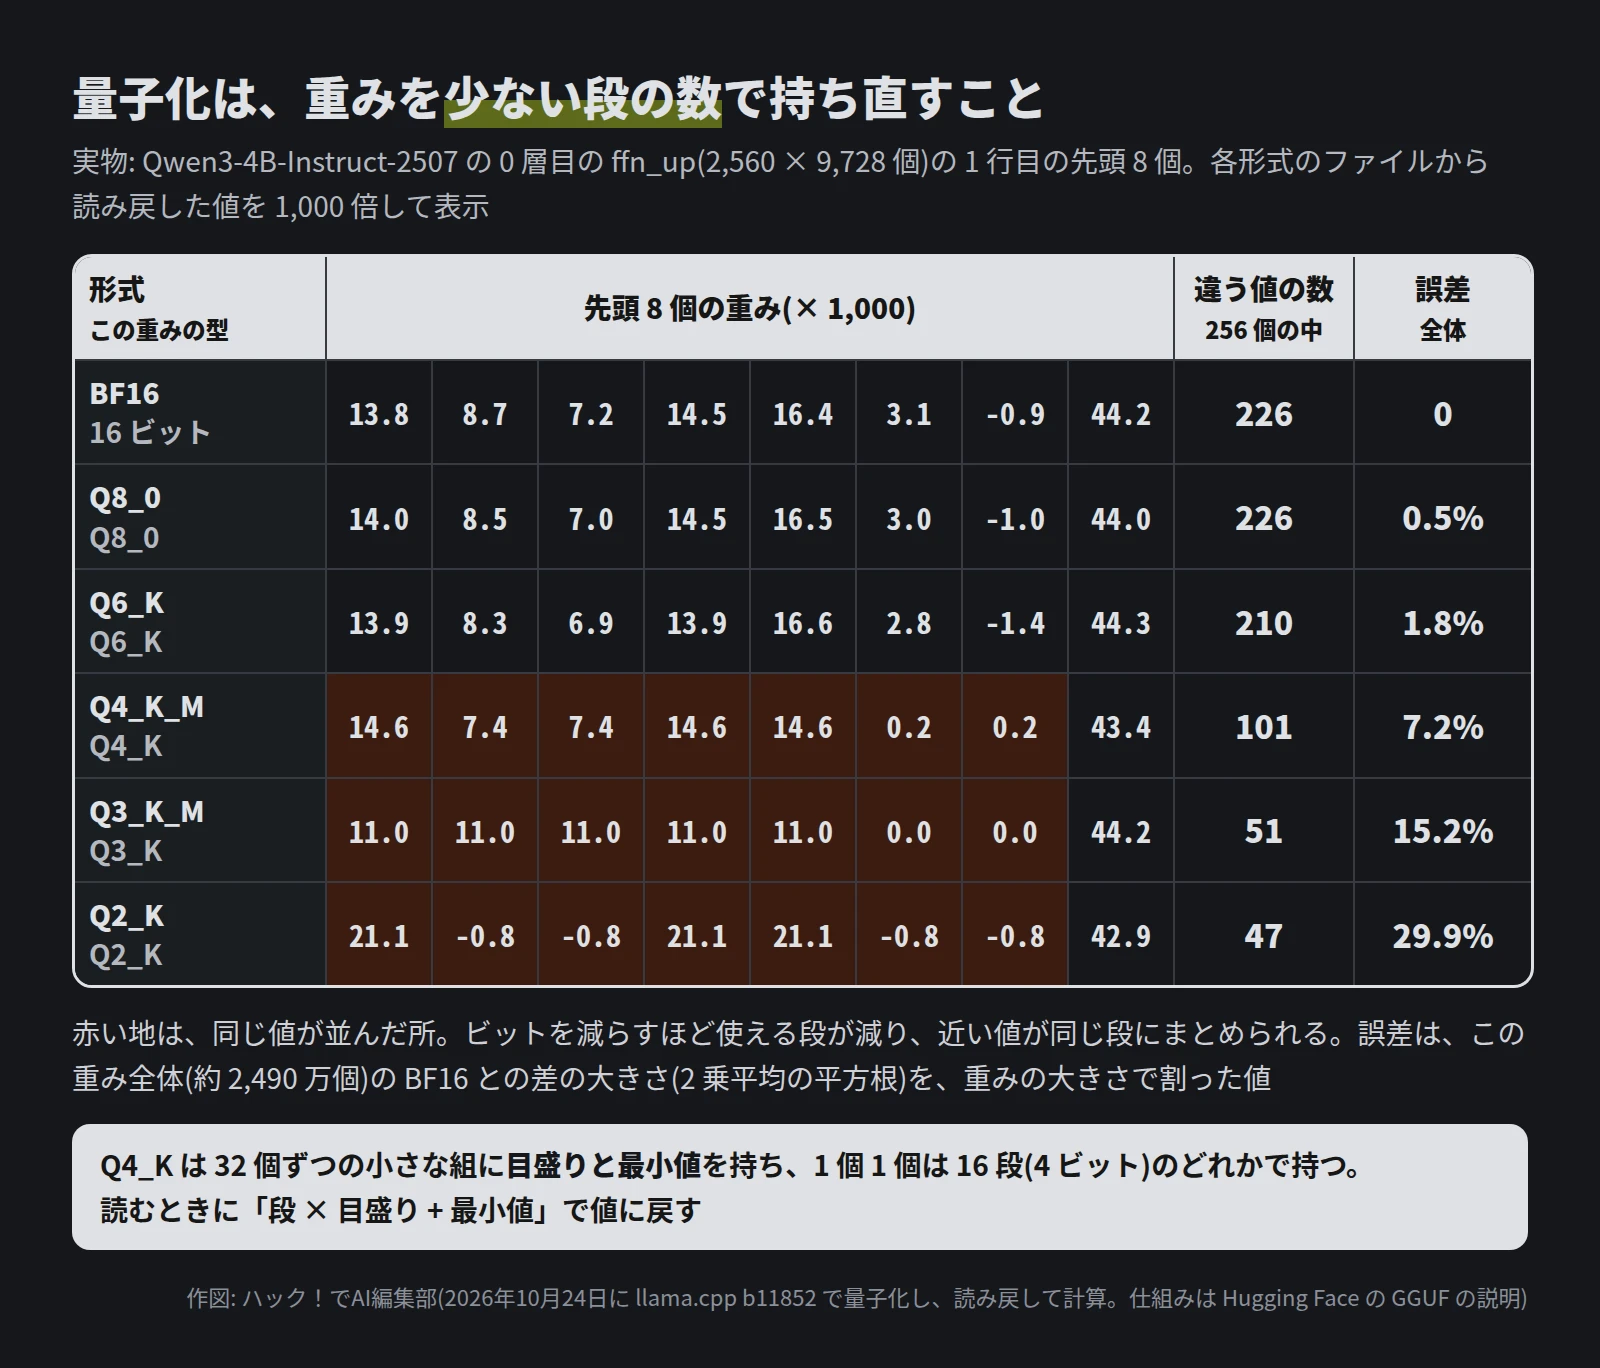
- 実物の重みで、BF16 とのずれ(誤差)は Q8_0 が 0.5%、Q4_K が 7.2%、Q2_K が 29.9% でした。256 個の中の違う値は、226 から 101、47 に減りました。
- 今回の重みでは、ビットを 1 つ減らすごとに、ずれがほぼ 2 倍になりました。どこまで減らしてよいかを、以下で測りました。
蒸留とは、小さくする所が違う
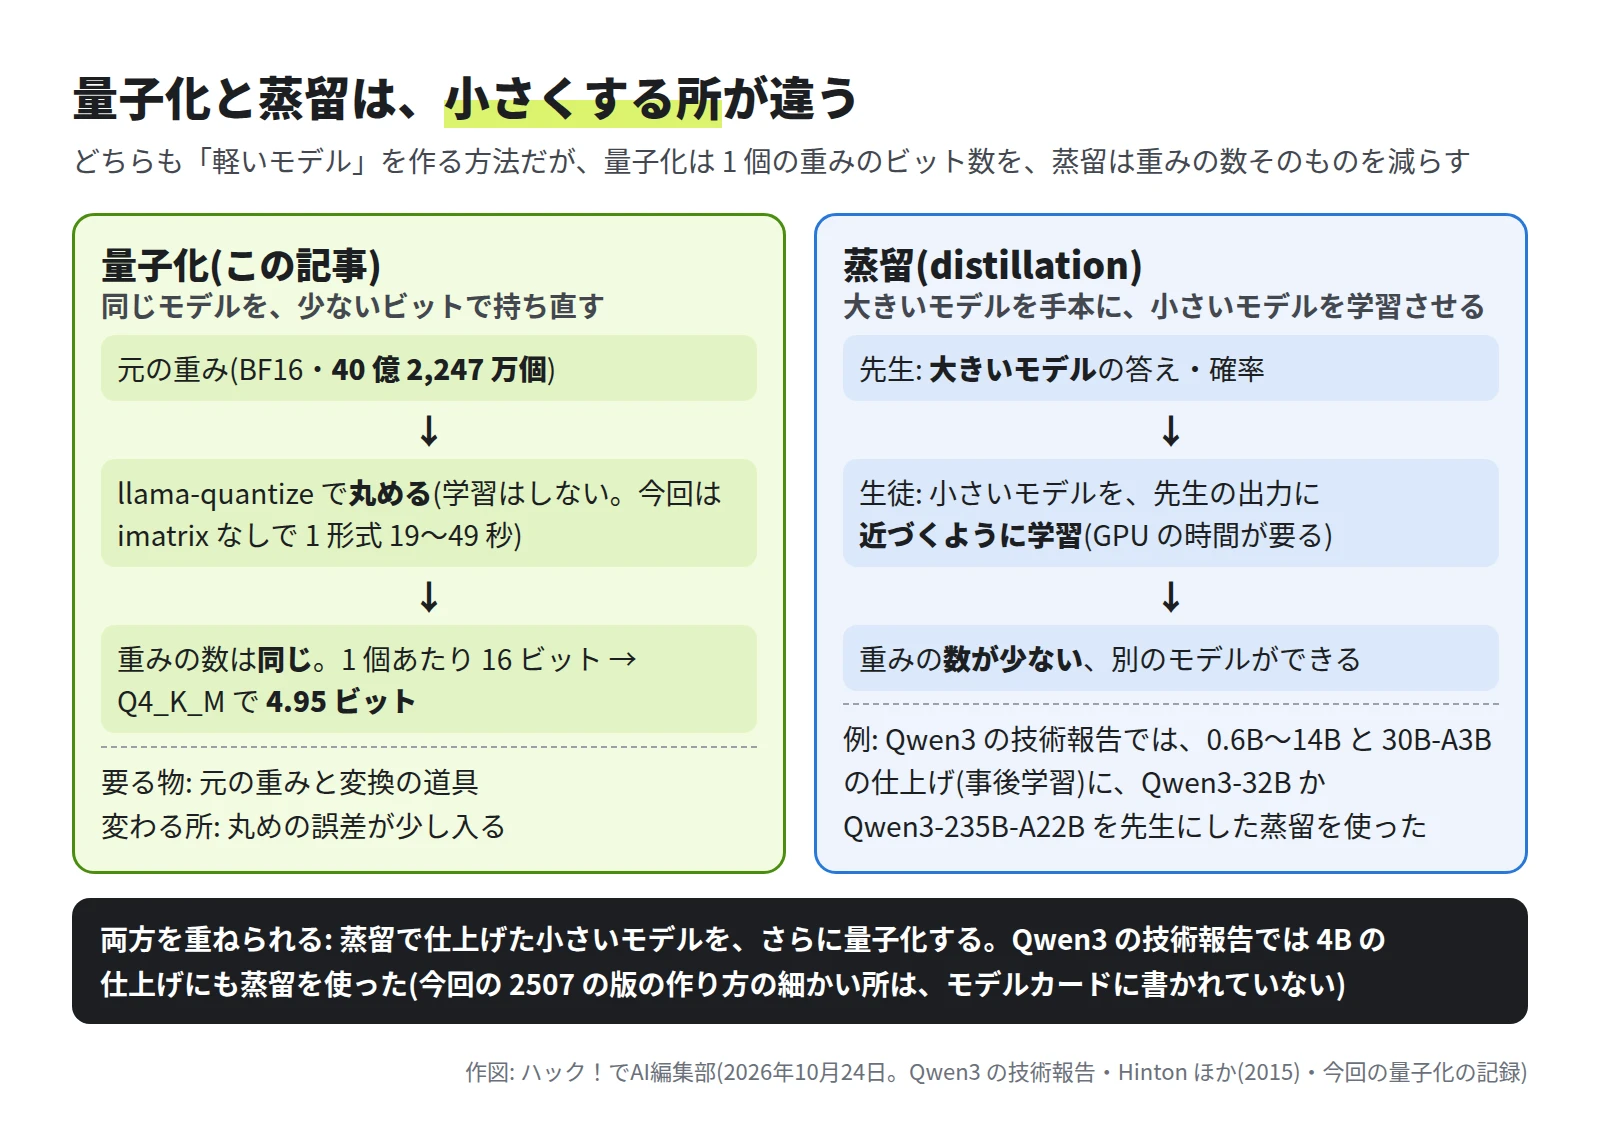
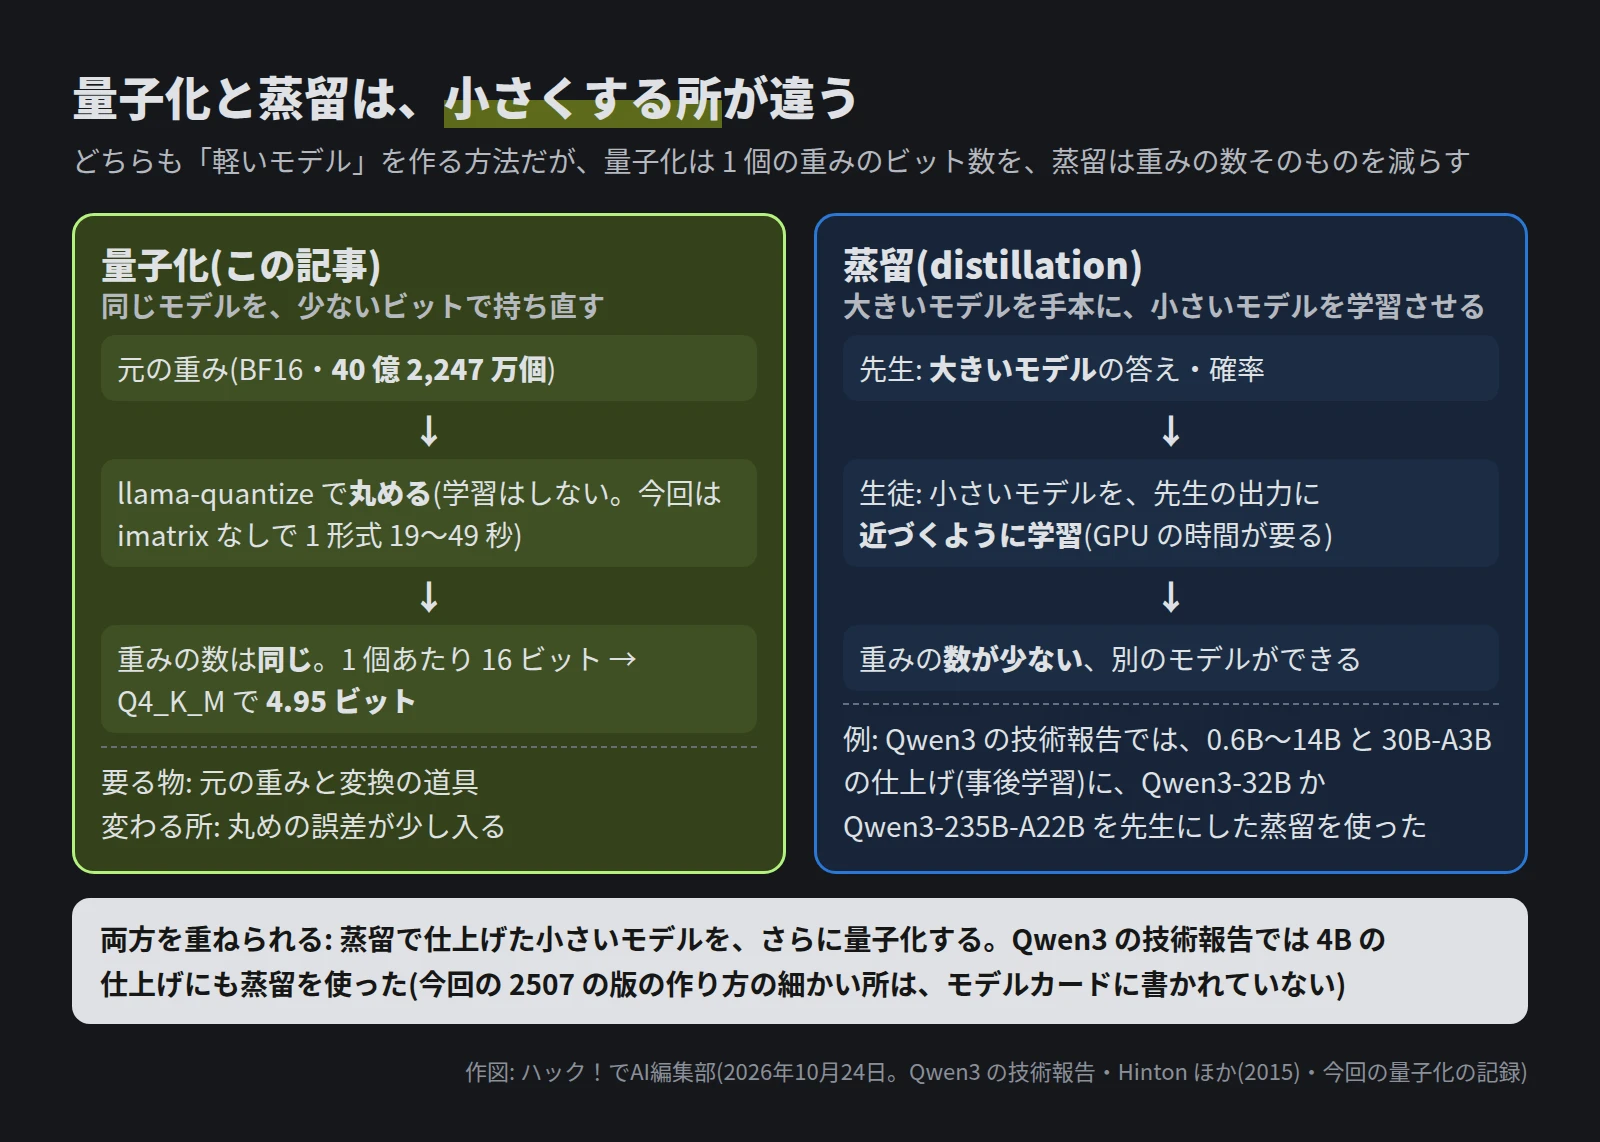
蒸留(distillation)は、大きいモデル(先生)の答えや確率を手本に、小さいモデル(生徒)を学習させる方法です。重みの数が減った別のモデルができ、学習に GPU の時間がかかります。量子化は学習をせず、今回は imatrix なしで 1 形式 19〜49 秒でした。
2 つは重ねられます。Qwen3 の技術報告は、4B を含む小さいモデルの仕上げ(事前学習のあとの事後学習)に、Qwen3-32B か Qwen3-235B-A22B を先生にした蒸留を使ったとしています。今回の 2507 の版の作り方の細かい所は、モデルカードにありません。
Q4_K_M の名前を読む
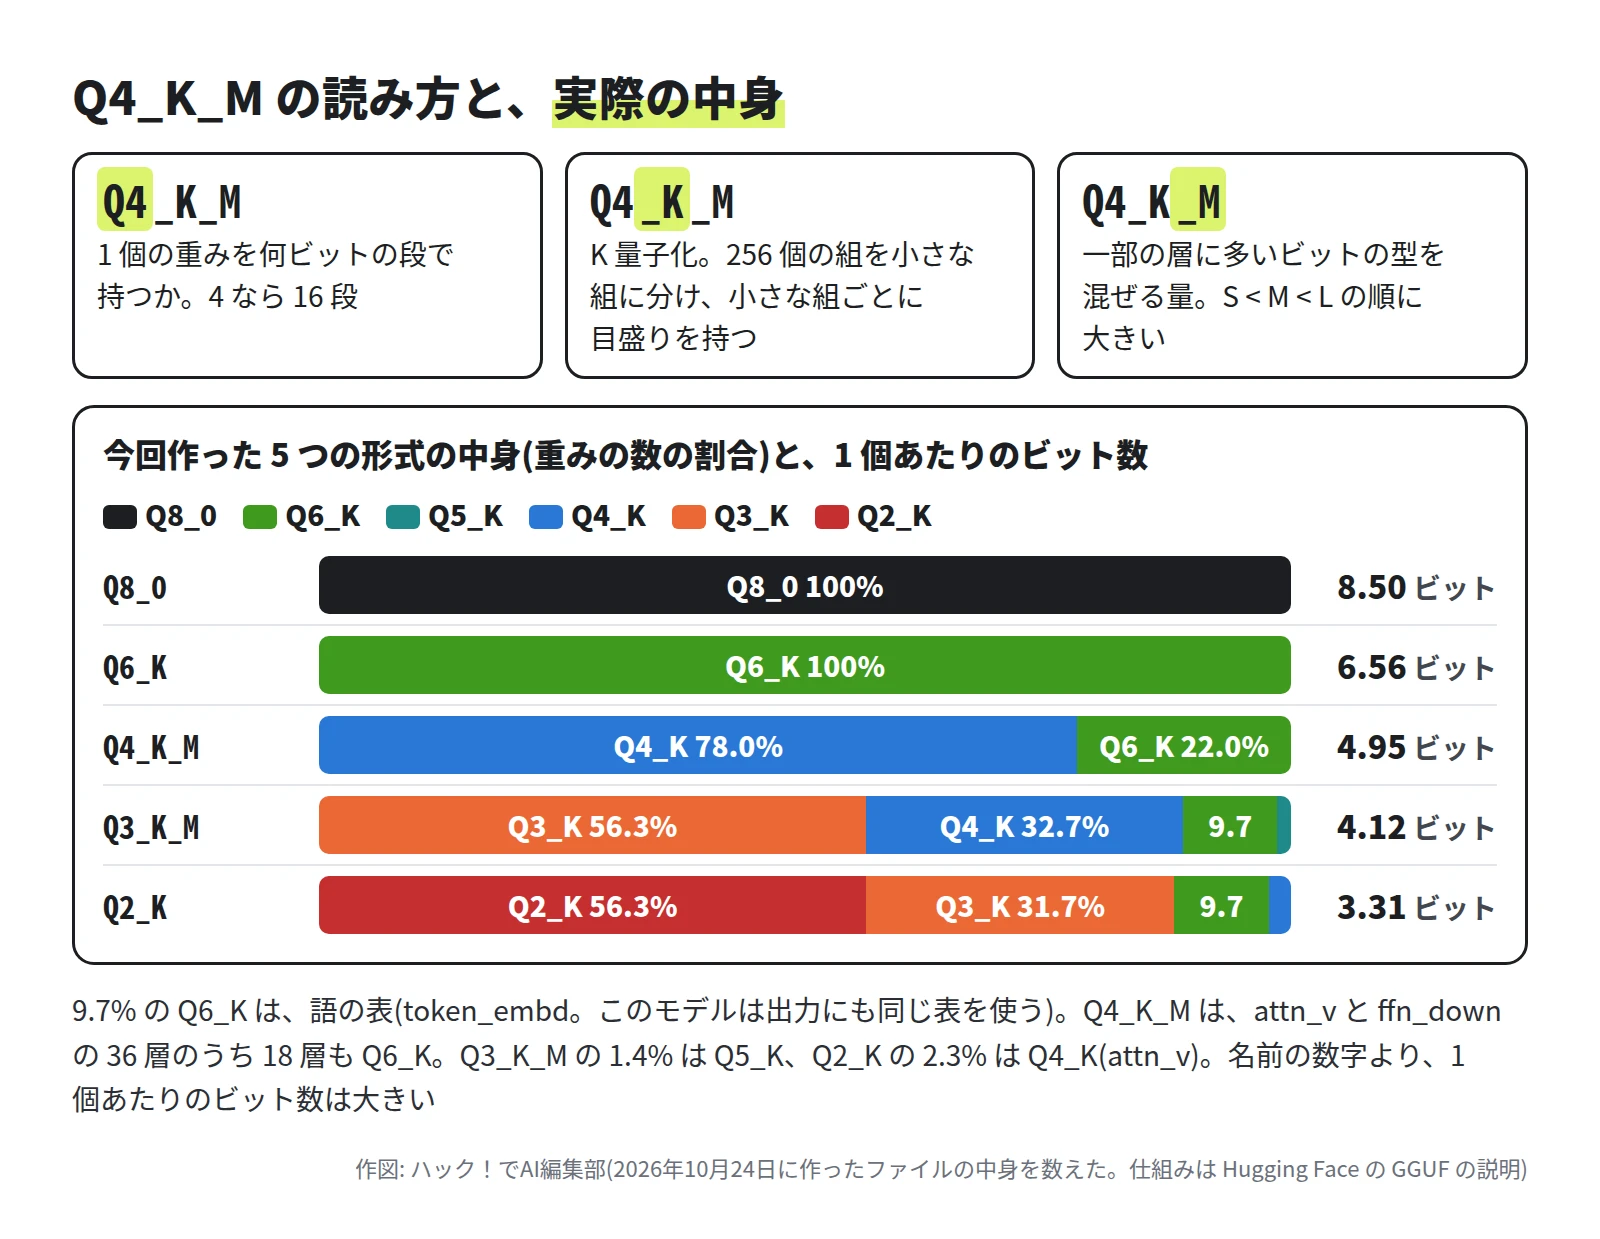
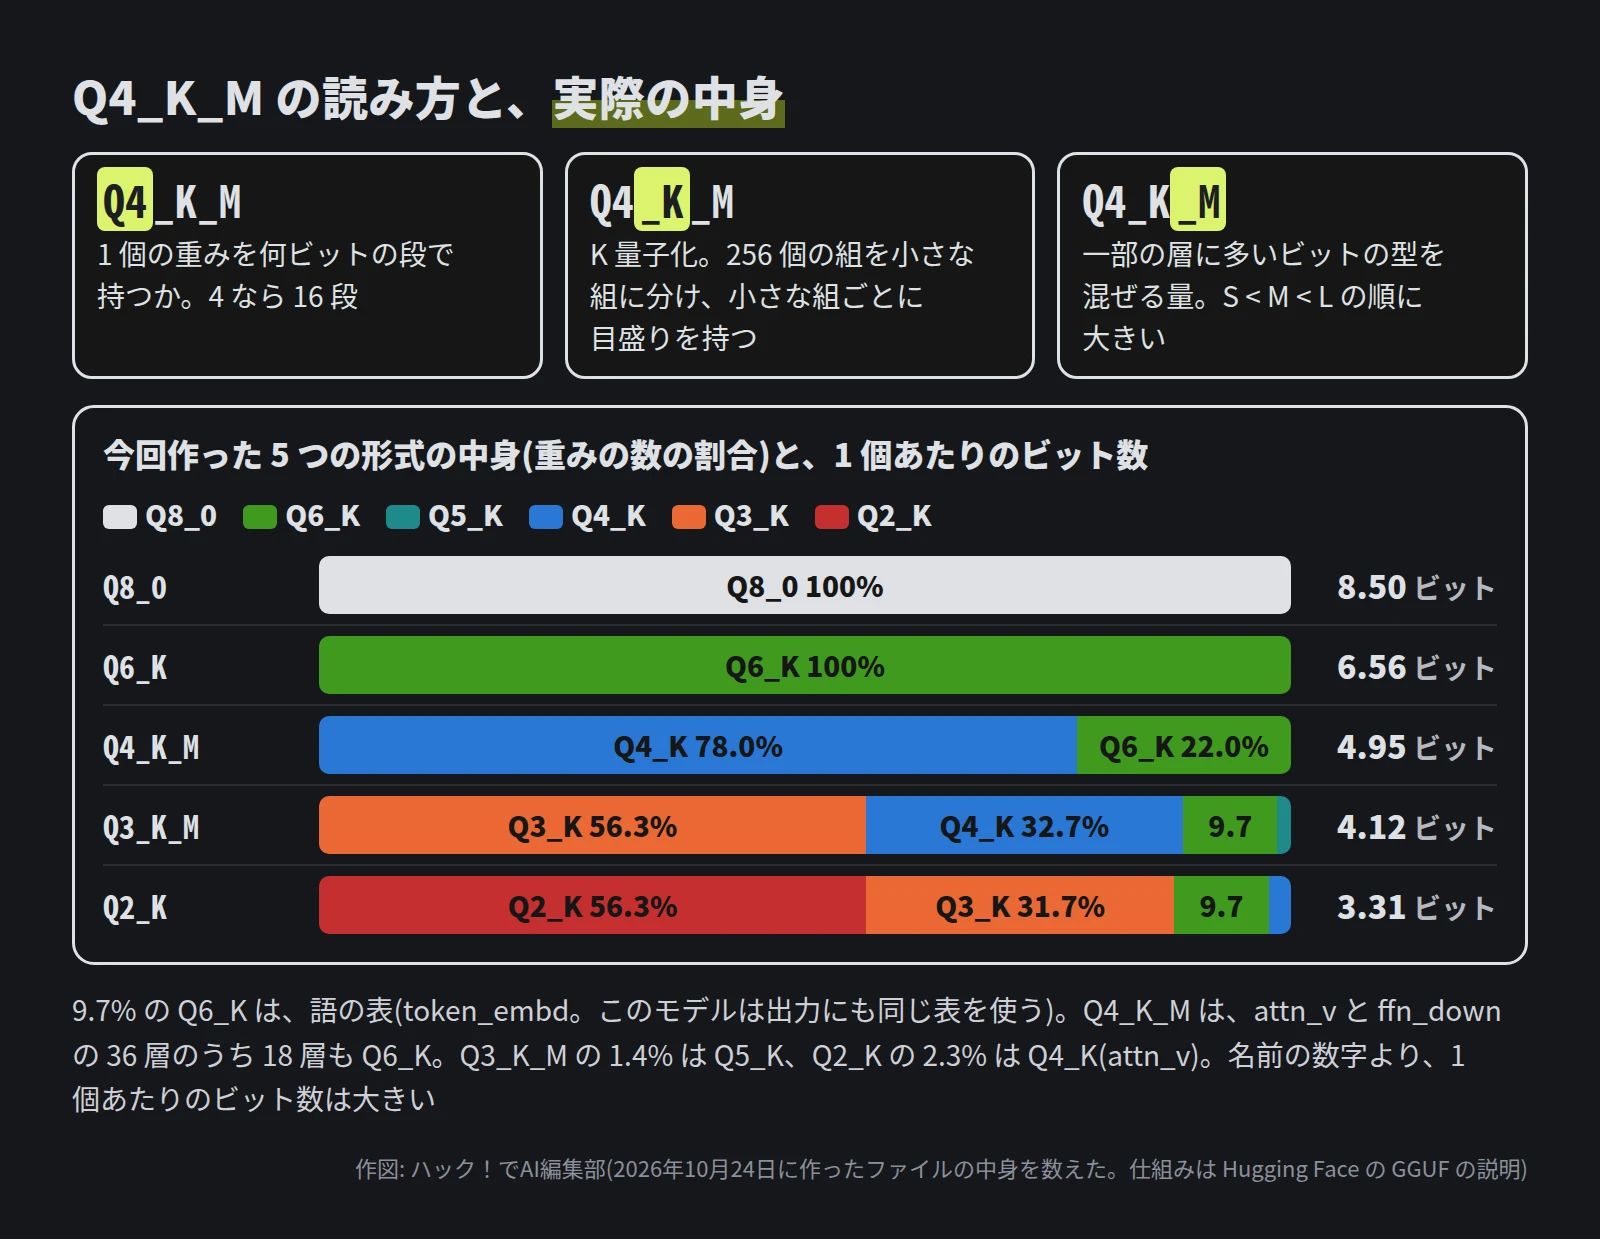
- Q4: 1 個の重みの基本のビット数です。
- K: llama.cpp の K 量子化です。256 個の組を小さな組に分け、組ごとに目盛りを持ちます。Q8_0 は、32 個ごとに目盛りを 1 つ持つ前からある形です。
- M: 一部の層に多いビットの型を混ぜる量で、S・M・L の順に多くなります。今回の Q4_K_M は 22% が Q6_K で、1 個 4.95 ビットでした。
- imatrix(重要度の行列): 手本の文をモデルに通し、重みの行列ごとに、入ってくる値の大きさを数えた物です。量子化のときに渡すと、効きの大きい所のずれが小さくなるように丸めます。型の混ぜ方と大きさは変わりません。
小さくなるのは保存する重みです。読んだ文の計算の結果(KV キャッシュ)は別の設定で、llama-server の既定は 16 ビットです(今回はそのまま)。
自分で量子化して、6 つの形式を測った
| 項目 | 中身 |
|---|---|
| 機械 | 編集部の検証用のサーバー(AMD EPYC・24 コア・メモリ 94GB・GPU なし) |
| 道具 | llama.cpp b11852(2026年10月24日公開の公式のリリース・Linux の CPU 版) |
| モデル | Qwen3-4B-Instruct-2507(Apache 2.0・重み 40 億 2,247 万個)。第3回「ファインチューニングと RAG の違い」と同じ |
| 文 | perplexity は『坊っちゃん』(夏目漱石)の先頭 19,970 字、imatrix は『銀河鉄道の夜』(宮沢賢治)の先頭 19,996 字。どちらも青空文庫で、ルビと注記を除いた |
| 小テスト | 先に作った 48 問(計算・日本語の知識・指示に従うが 16 問ずつ。記事の最後) |
-
llama.cpp の公式のリリースを取る
GitHub のリリースの Linux の CPU 版(llama-b11852-bin-ubuntu-x64.tar.gz)と、変換の台本のために同じ版のソースを展開しました。
-
変換の道具を入れる
ソースの requirements-convert_hf_to_gguf.txt の版で、Python 3.12 の venv(Python の置き場)に入れました。
uv venv -p 3.12 venv uv pip install --python venv/bin/python --extra-index-url https://download.pytorch.org/whl/cpu --index-strategy unsafe-best-match "torch==2.11.0" "numpy~=2.2.6" "sentencepiece>=0.1.98,<0.3.0" "transformers==4.57.6" "protobuf>=4.21.0,<5.0.0" ./llama.cpp-b11852/gguf-py -
BF16 の GGUF にする
Hugging Face の safetensors(約 8GB)を、GGUF(llama.cpp のファイルの形式)にします。1 分 59 秒でした。
venv/bin/python llama.cpp-b11852/convert_hf_to_gguf.py Qwen3-4B-Instruct-2507 --outtype bf16 --outfile qwen3-4b-2507-BF16.gguf -
llama-quantize で量子化する
最後の 8 はスレッドの数です。imatrix を使うときは、先に手本の文で作ります(BF16 で 12 分)。
./llama-b11852/llama-quantize qwen3-4b-2507-BF16.gguf qwen3-4b-2507-Q4_K_M.gguf Q4_K_M 8
# imatrix を使うとき
./llama-b11852/llama-imatrix -m qwen3-4b-2507-BF16.gguf -f calib.txt -o imatrix.gguf -c 512 -t 8
./llama-b11852/llama-quantize --imatrix imatrix.gguf qwen3-4b-2507-BF16.gguf qwen3-4b-2507-Q2_K-imat.gguf Q2_K 8
測り方(どれも 8 スレッド)です。メモリと読み込みは、llama-completion で、ファイルを最初に全部読む設定(mmap なし)・文脈 4,096 トークンにして 3 回動かし、1 回目はファイルを OS のキャッシュから外しました(冷えた状態)。
速さは llama-bench の pp512(512 トークンを読む)と tg128(128 トークンを書く)を 5 回ずつ 2 回。小テストは llama-server に 1 問 1 回、temperature 0(いつも最も確からしい語を選ぶ)・128 トークンまでで渡し、計算と知識には「答えだけを書いてください。」を足しました。
./llama-bench -m qwen3-4b-2507-Q4_K_M.gguf -p 512 -n 128 -t 8 -r 5
./llama-perplexity -m qwen3-4b-2507-BF16.gguf -f bocchan.txt -c 512 -b 512 -t 8 --kl-divergence-base bf16.kld
./llama-perplexity -m qwen3-4b-2507-Q4_K_M.gguf -c 512 -b 512 -t 8 --kl-divergence-base bf16.kld --kl-divergence
大きさとメモリは、ビット数にほぼ比例した
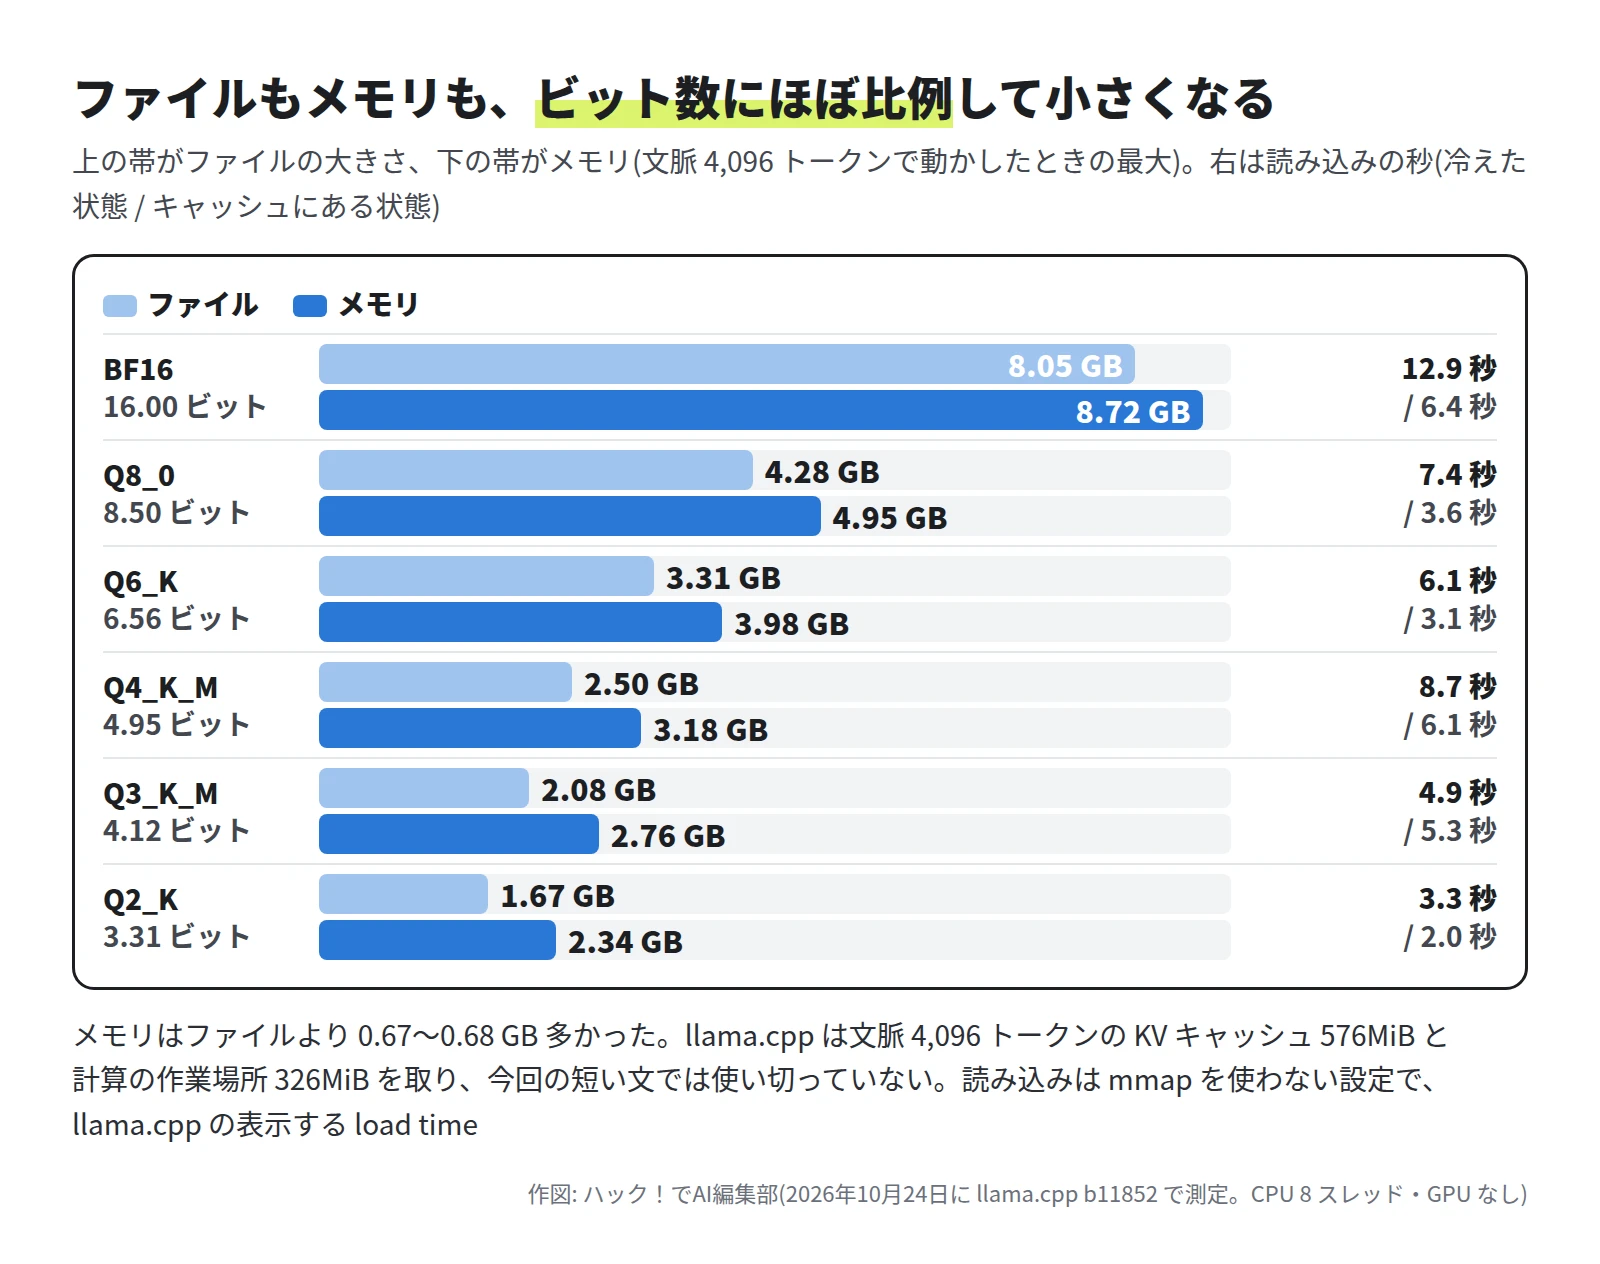
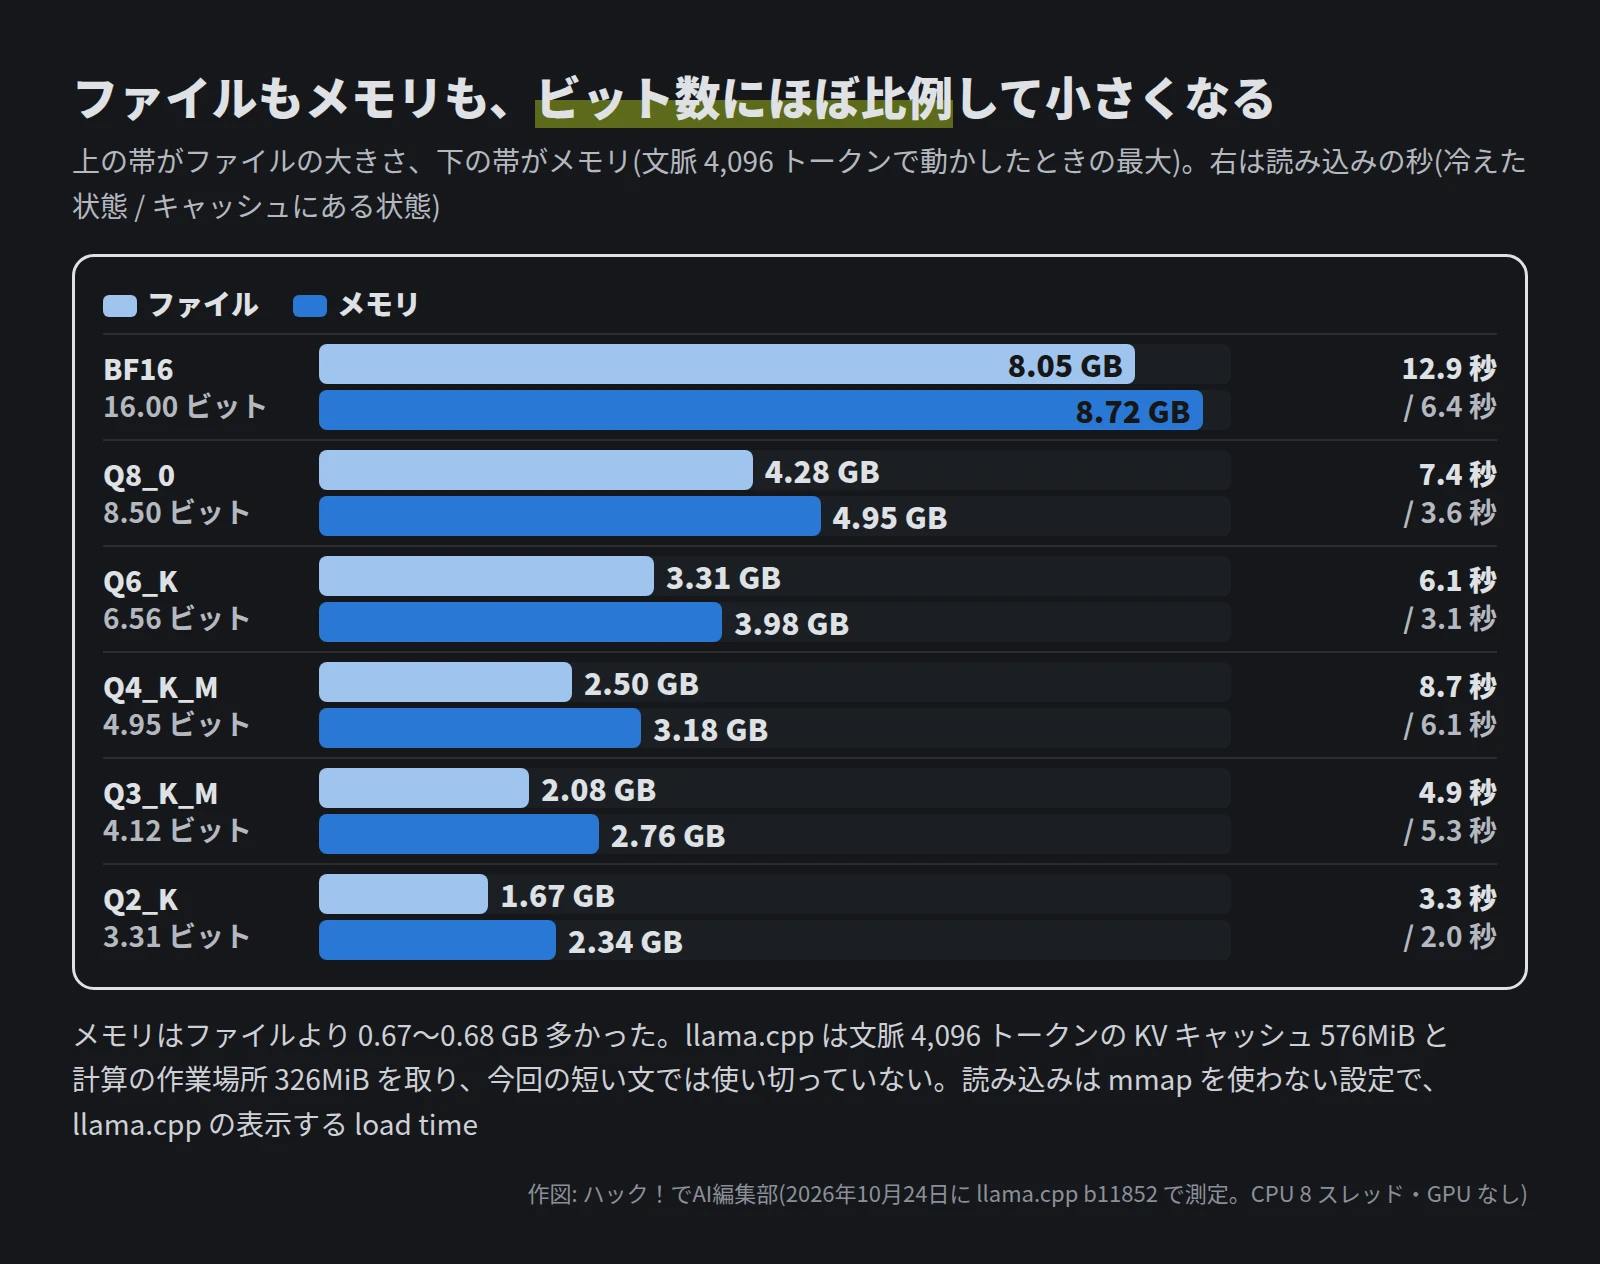
- Q4_K_M はファイル 2.50GB・メモリ 3.18GB で、BF16 の 3 割ほどでした。Q2_K は 1.67GB・2.34GB です。
- メモリは、どの形式もファイルより 0.67〜0.68GB 多くなりました。llama.cpp は文脈 4,096 トークン分の KV キャッシュ 576MiB と、計算の作業場所 326MiB を取ります(あとから足した確かめの記録で確認)。今回の短い文では使い切っておらず、長い文を渡すとメモリはさらに増える見込みです。
- 読み込みは、冷えた状態で BF16 12.9 秒、Q2_K 3.3 秒でした。Q4_K_M は、ファイルの大きい Q8_0 や Q6_K より遅く、キャッシュにあっても 6.1 秒かかりました(理由は次の章)。
速さは、CPU ではビットを減らすほど上がった
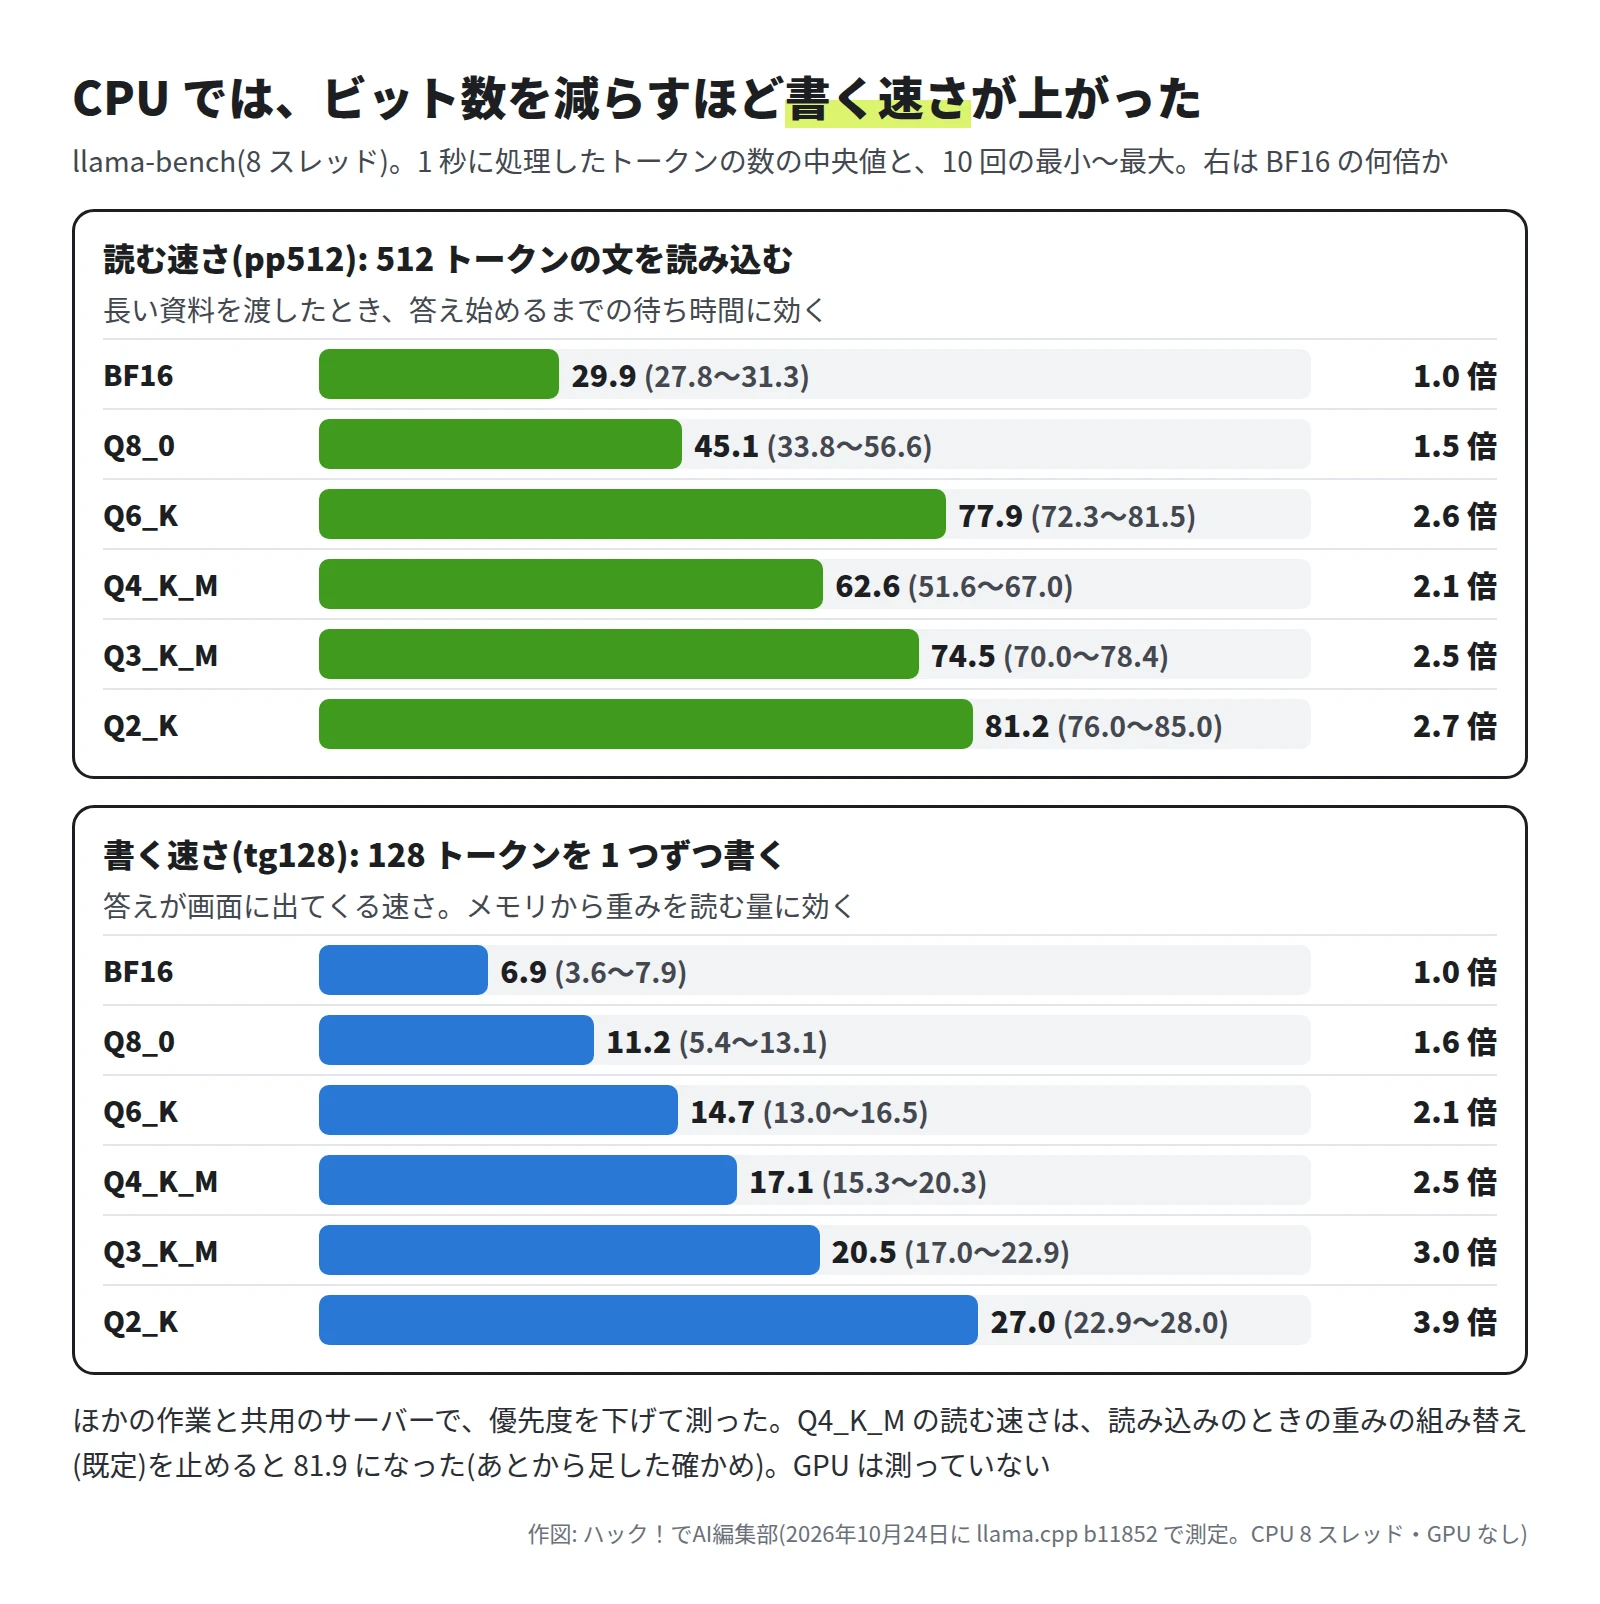
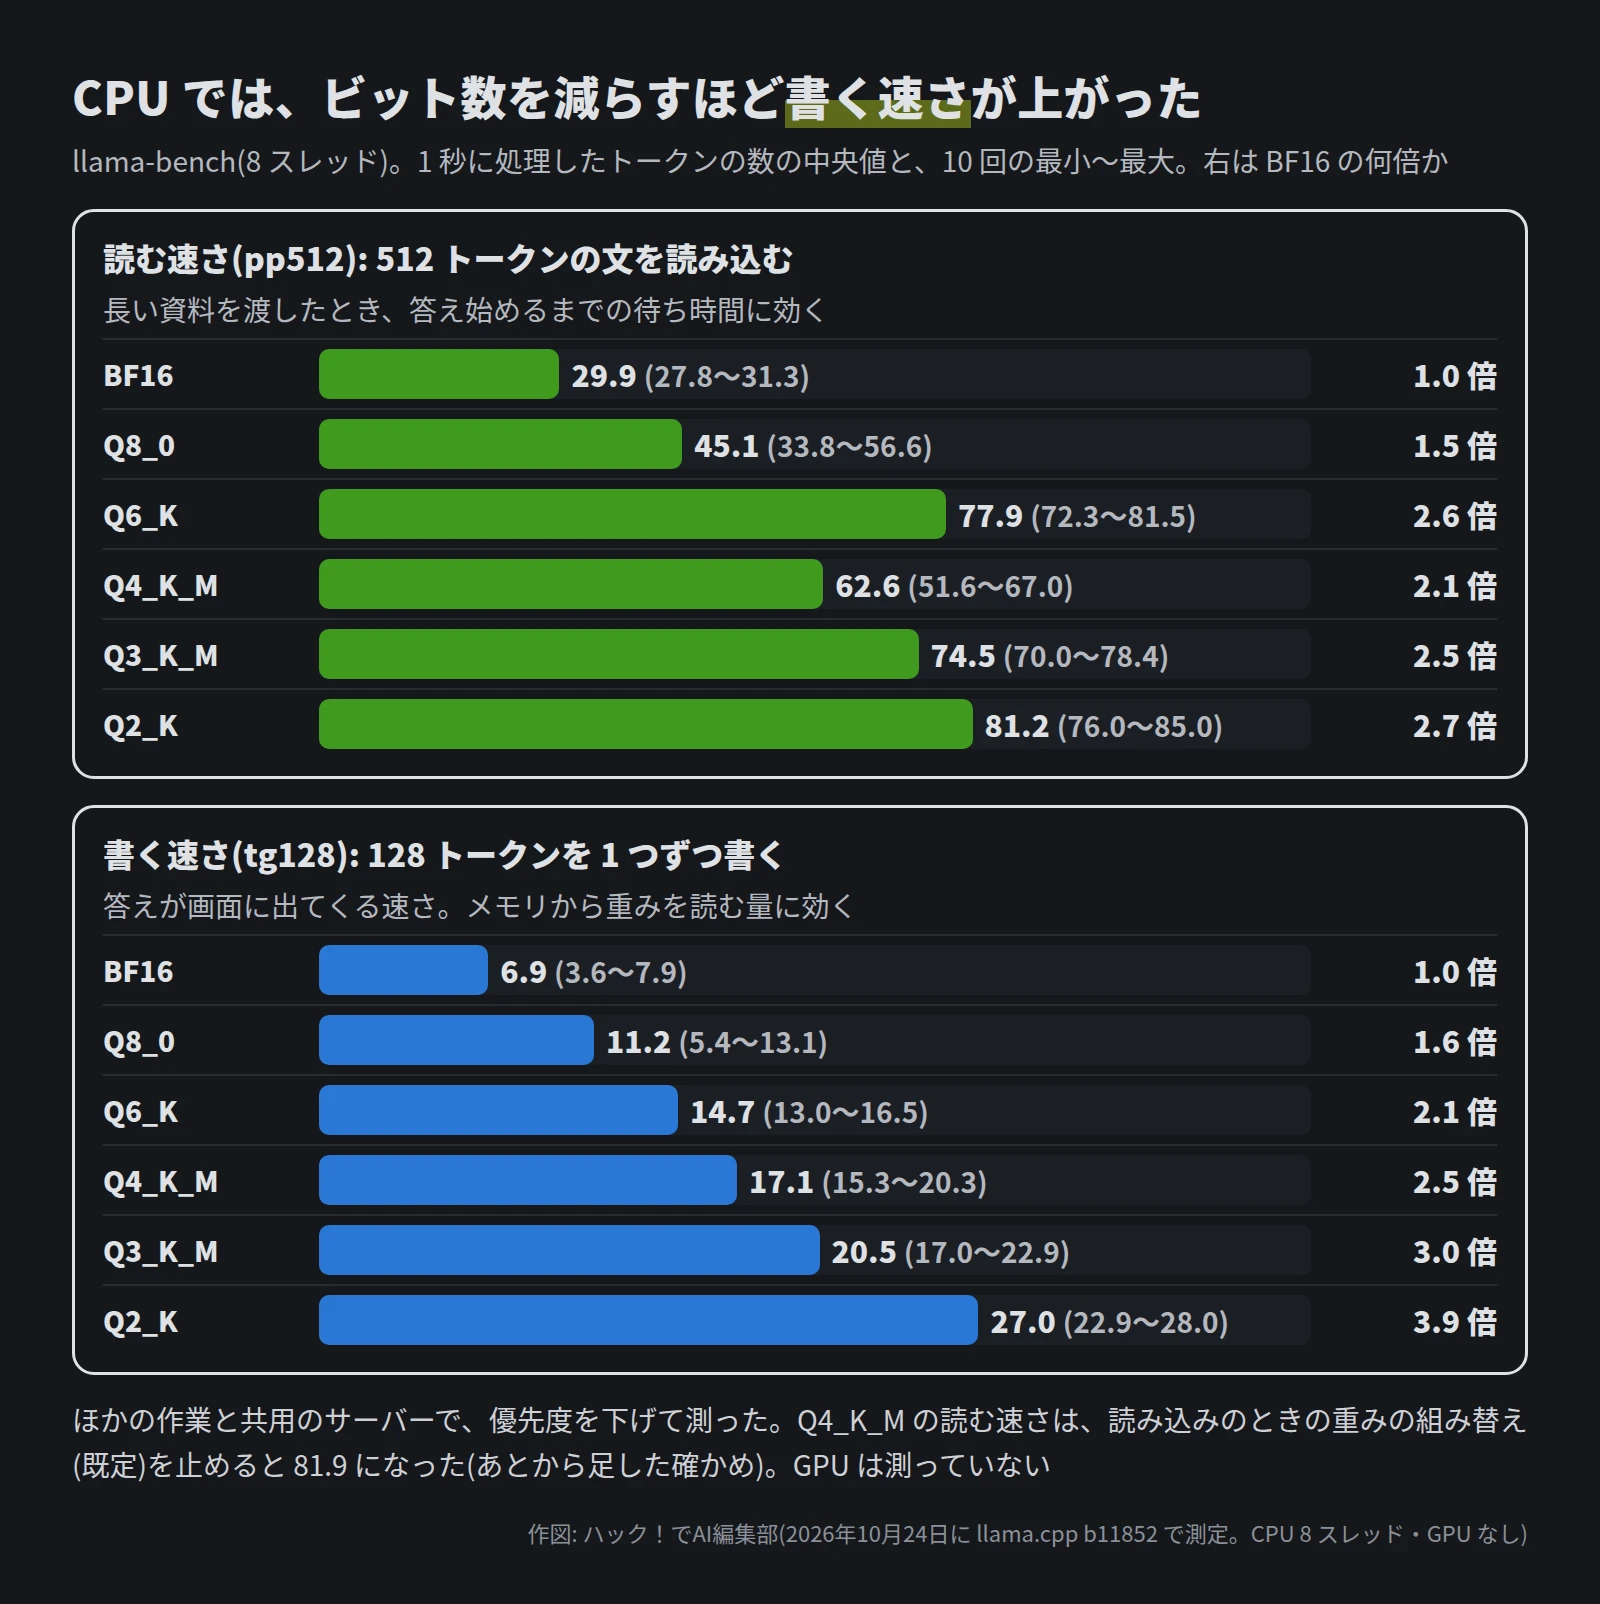
- 書く速さ(答えが出てくる速さ)は、BF16 6.9、Q8_0 11.2、Q4_K_M 17.1、Q2_K 27.0 トークン/秒でした。
- 読む速さ(長い文を渡したときの待ち時間に効く)も上がりましたが、Q4_K_M(62.6)は Q6_K(77.9)より遅くなりました。
- ほかの作業の重さで揺れました。型が同じ Q2_K と imatrix つきの Q2_K でも、書く速さは 27.0 と 21.3 でした。
- GPU では別の数になります(今回、GPU では形式ごとに測っていません)。第3回の RTX 5060 Ti 8GB では、同じモデルの Q8_0 で答えを書く速さが 80.8 トークン/秒でした(測り方は違います)。
Q4_K_M が遅かったのは、重みの組み替えだった
llama.cpp は読み込みのときに、Q4_K の型の重みを CPU 向けの並びに組み替えます(表示は CPU_REPACK。Q4_K_M で 1,683MiB、Q6_K は 0)。結果を見たあとに、組み替えを止める設定(--no-repack、llama-bench は --repack 0)と比べました。
- 読み込み(キャッシュにある状態・3 回の中央値): 6.4 秒から 2.7 秒に。
- 読む速さ(10 回の中央値): 65.7 から 81.9 トークン/秒に上がり、Q6_K(77.9)を上回りました。
- 書く速さ: 18.9 と 21.0 で、揺れの中の差でした。
この CPU の Q4_K_M では、組み替えない方が速くなりました。ほかの CPU では確かめていないので、llama-bench の --repack 1 と 0 で比べてください。
正しさは、4 ビットまでは保たれた
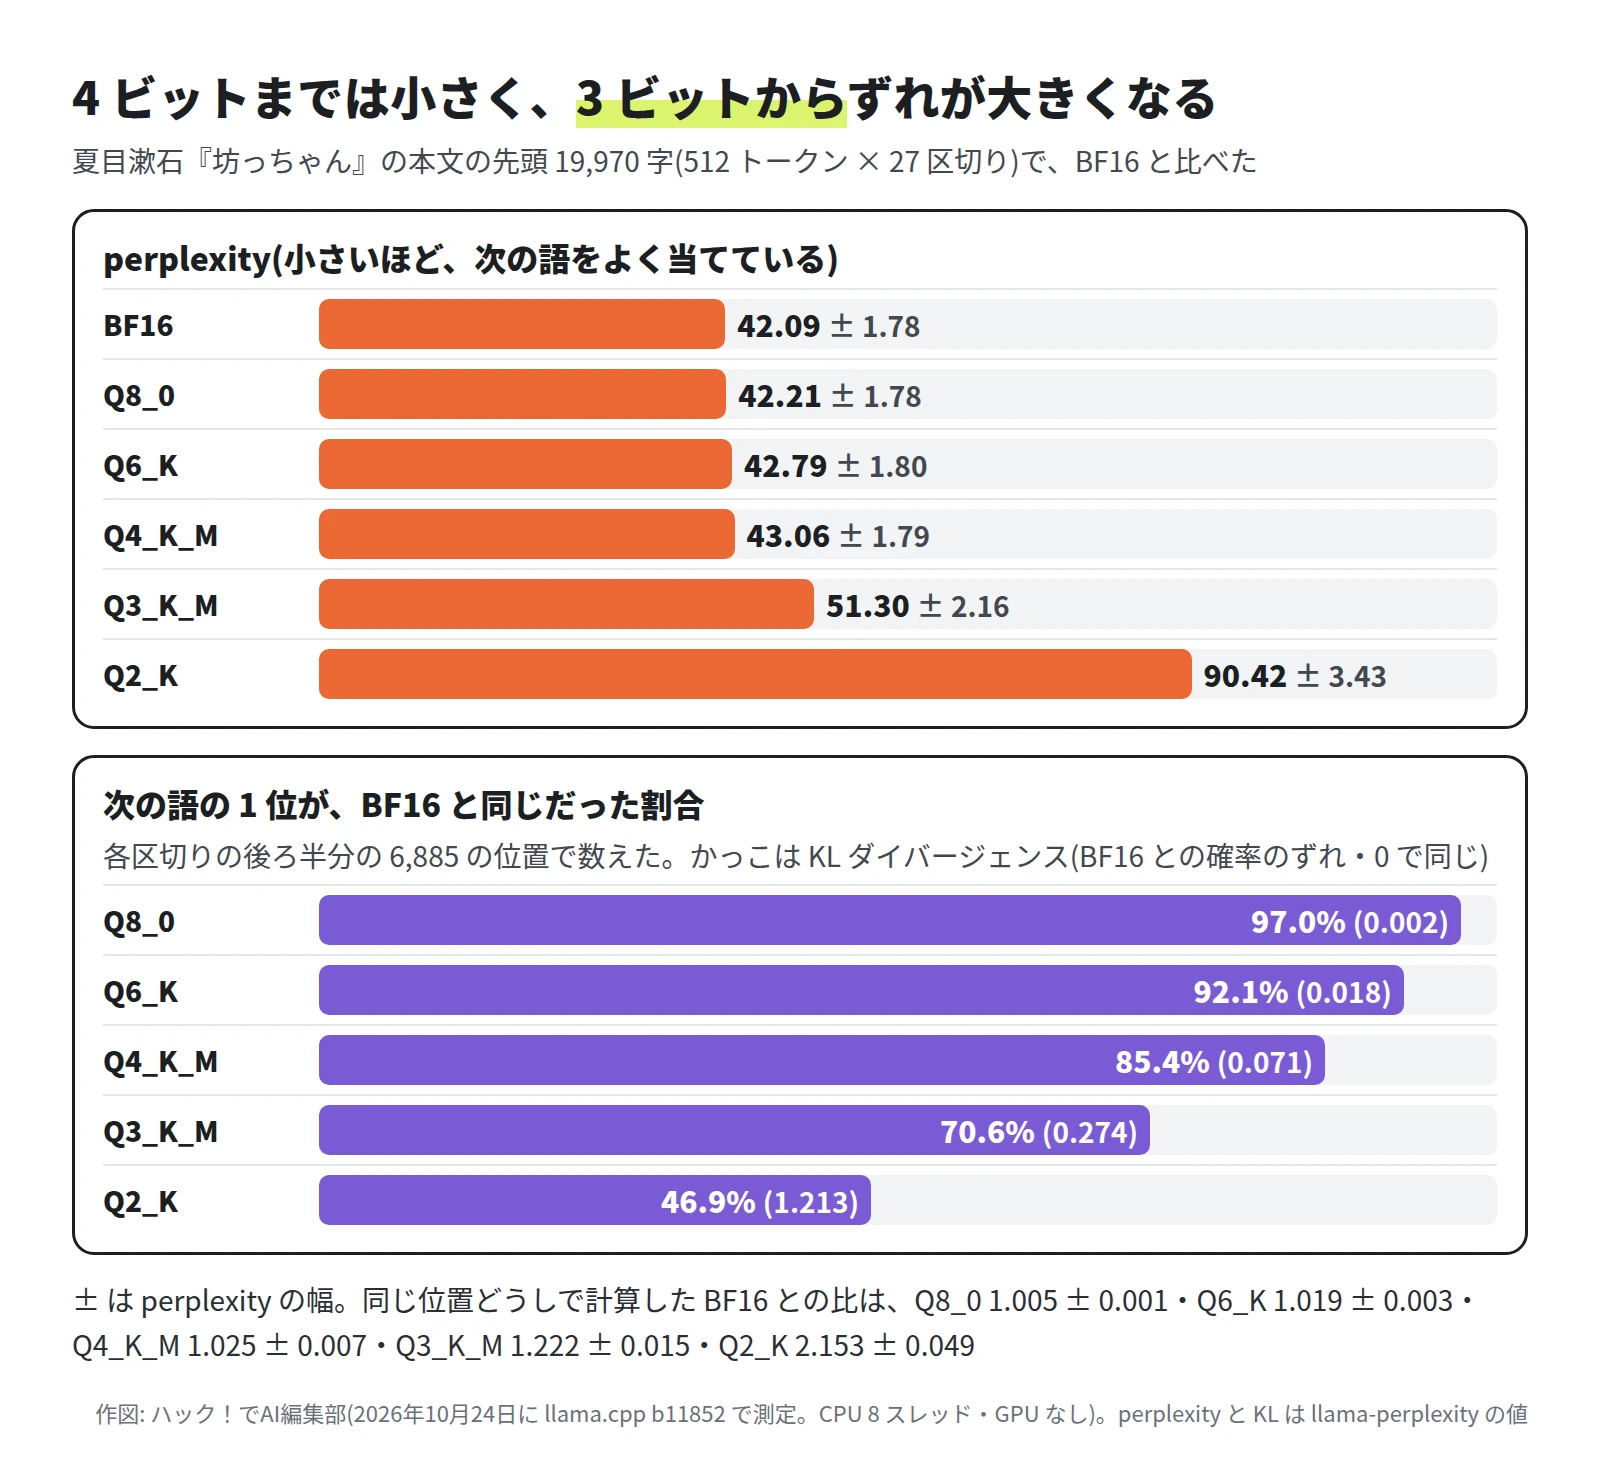
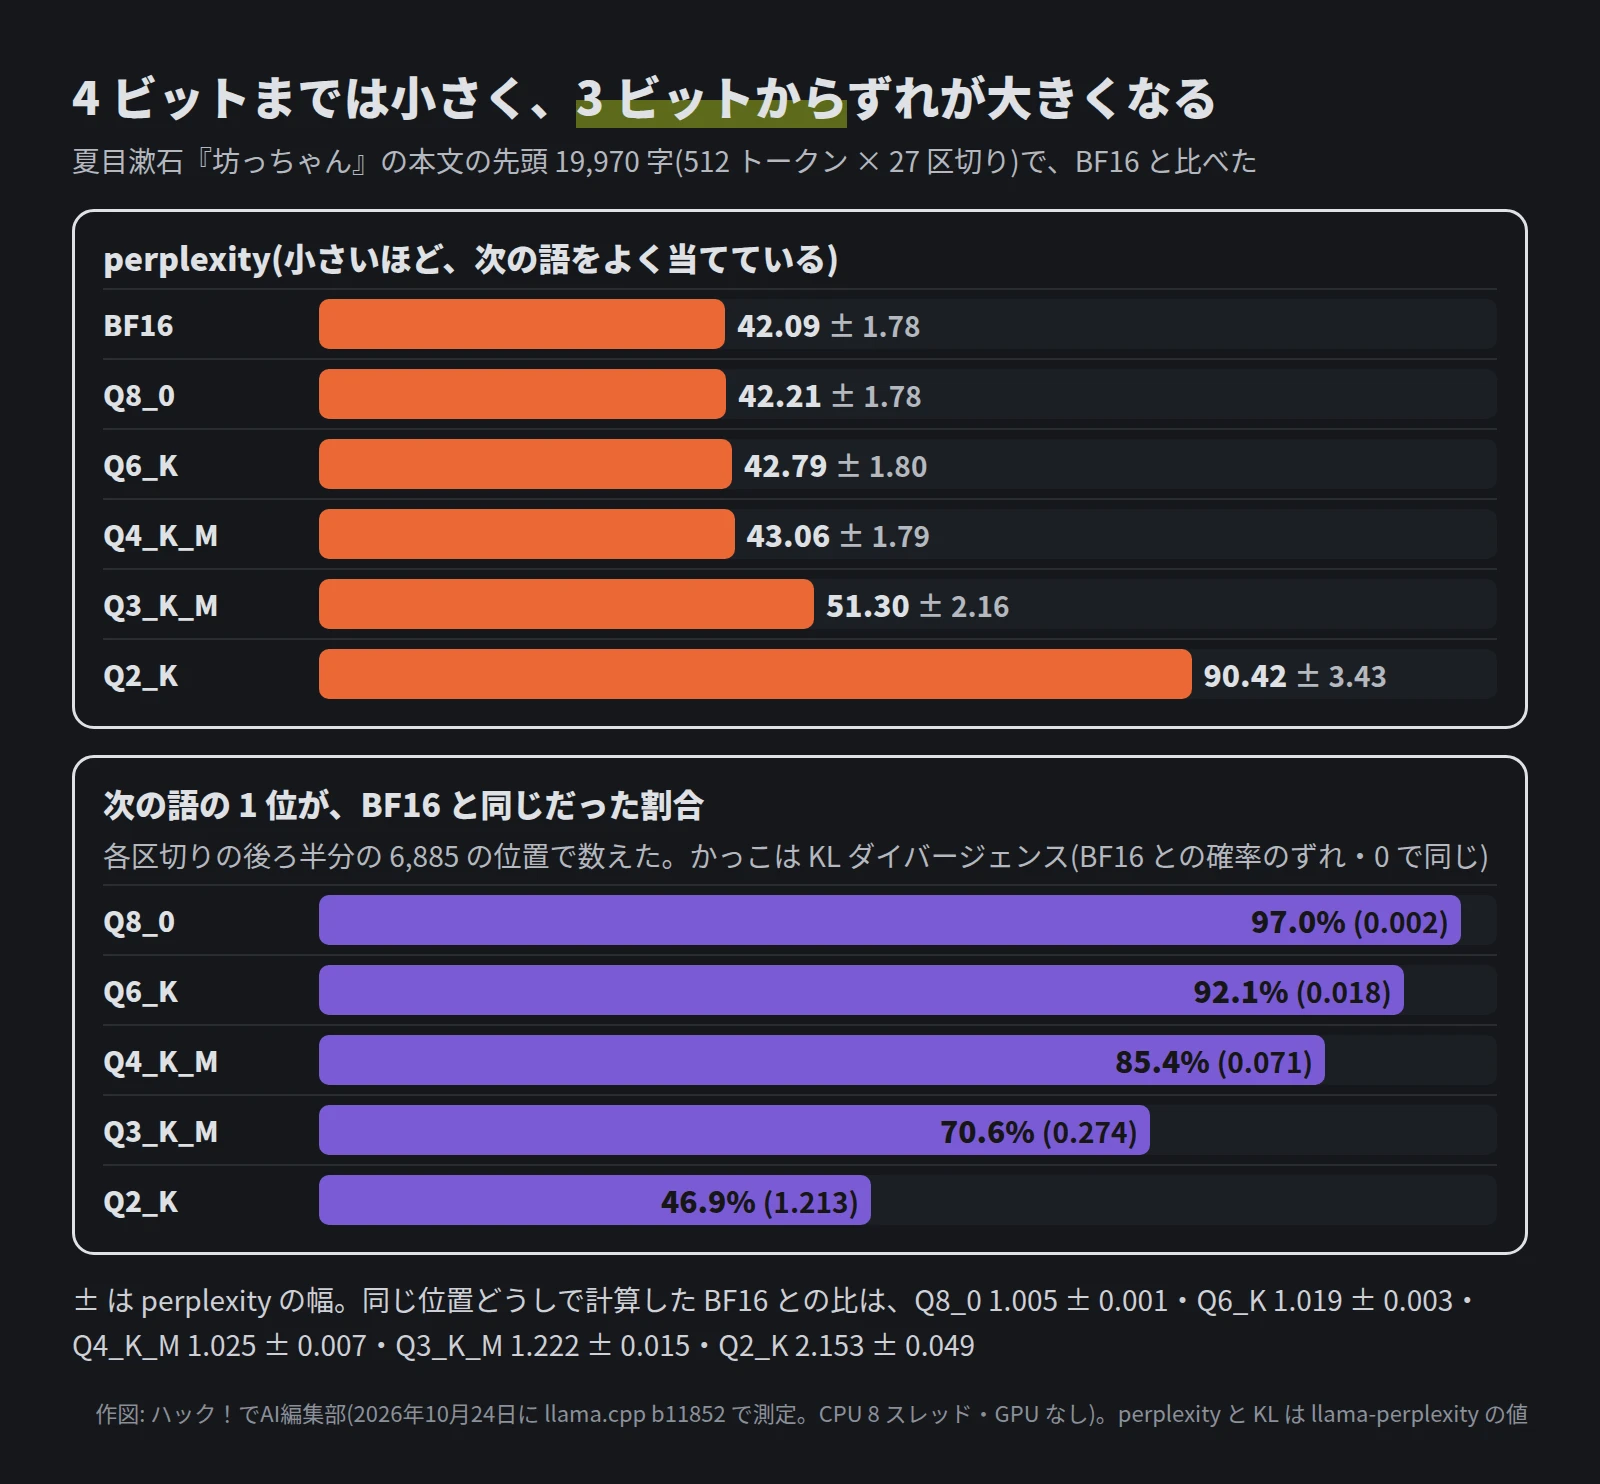
perplexity は、次の語の当てにくさです。小さいほど、元の文をよく当てています。
- 同じ位置どうしで BF16(42.09)と比べた倍率は、Q8_0 が 1.005 倍、Q6_K が 1.019 倍、Q4_K_M が 1.025 倍でした。Q3_K_M で 1.22 倍、Q2_K で 2.15 倍に跳ねました。
- 次の語の 1 位が BF16 と同じだった割合は、Q8_0 97.0%、Q4_K_M 85.4%、Q2_K 46.9% でした。Q8_0 でも 100% にはなりません。
小テストは、3 ビットから答え方が崩れた
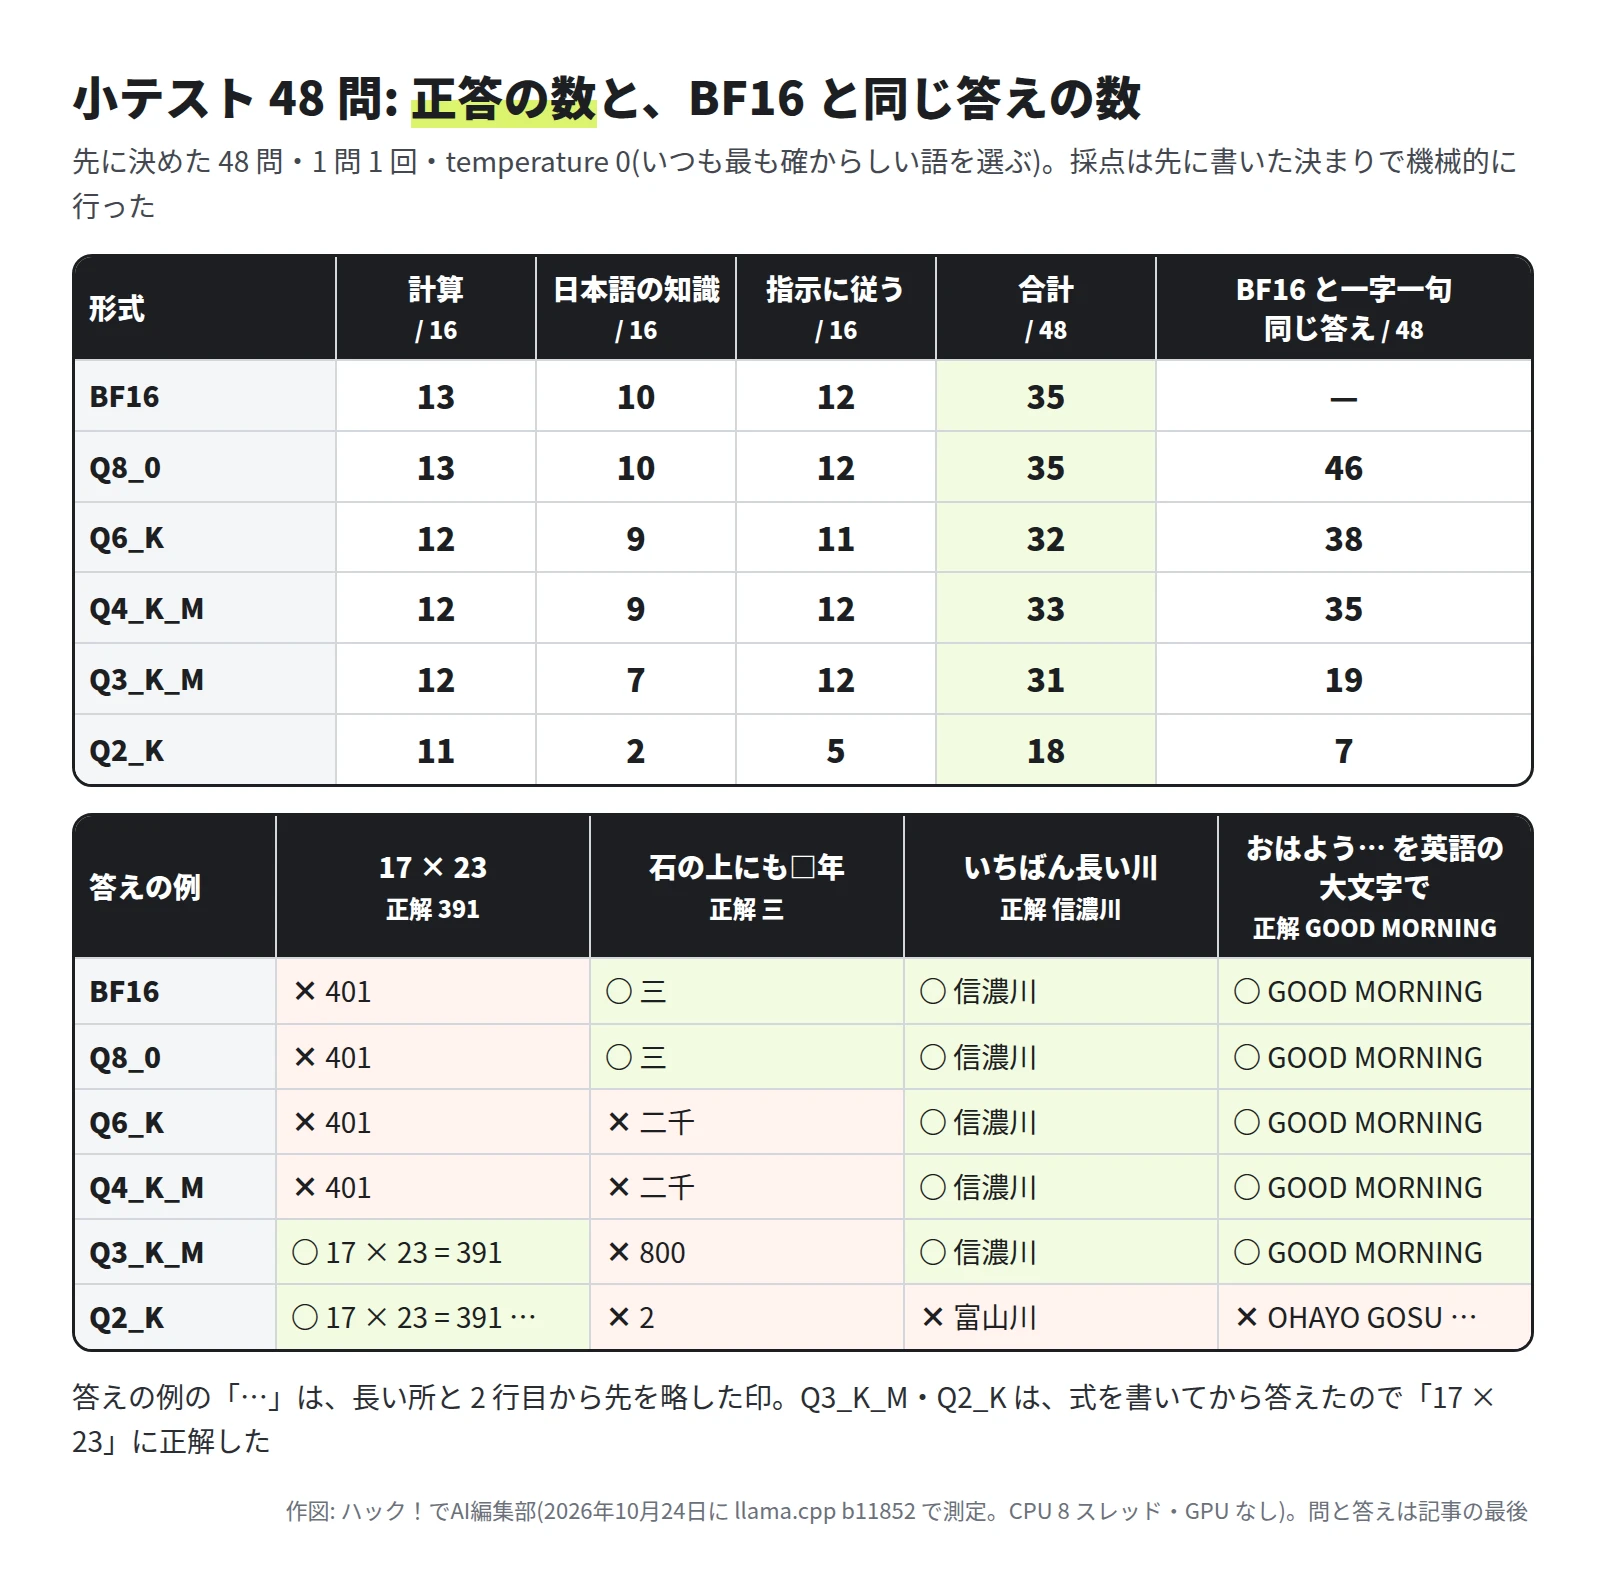
- Q8_0〜Q4_K_M は 32〜35 問で、1〜3 問の差は 48 問では言い切れません。BF16 と同じ答えの数は 46 → 38 → 35 と減り、Q6_K と Q4_K_M は「石の上にも□年」に「二千」と答えました。
- Q3_K_M と Q2_K は、「答えだけ」と頼んでも式や説明を書きました。128 トークンで切れた答えは BF16 の 1 問に対して 6 問・8 問、書いたトークンは 2.1 倍・2.6 倍です(この数え方は結果を見たあとに足しました)。
- Q2_K は知識が 2 / 16 で、「いちばん長い川」に「富山川」と答え、同じ語を繰り返したまま 128 トークンで切れた答えもありました。
- BF16 も 13 問を間違えています(「小豆」の読みを「こだち」など)。4B のモデルの力の中での比べです。
imatrix は、大きさを変えずに 2・3 ビットのずれを減らした
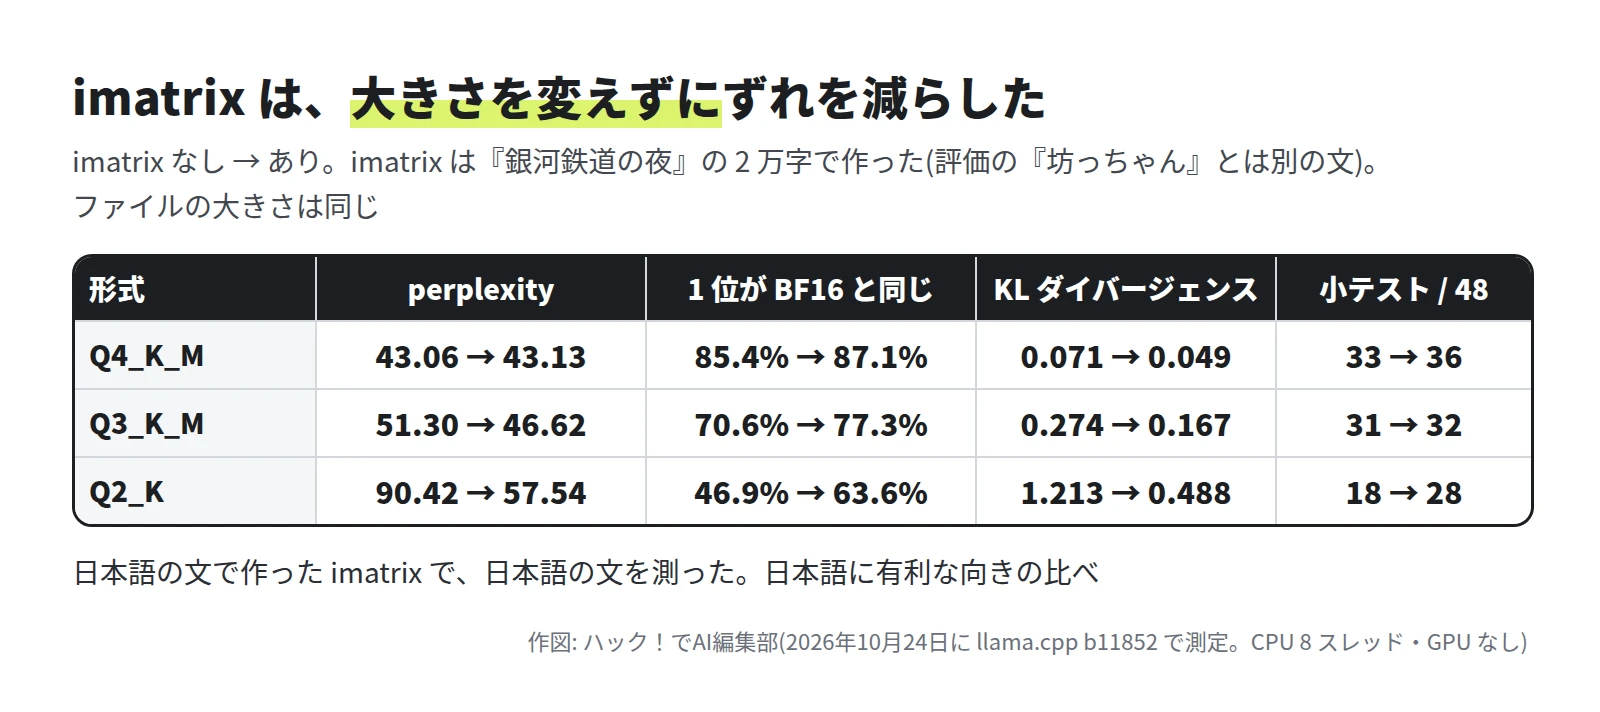
imatrix は、評価とは別の『銀河鉄道の夜』の 2 万字で 1 つ作り、3 つの形式に使いました。
- Q2_K: perplexity は 2.15 倍から 1.37 倍、1 位の一致は 46.9% から 63.6%、小テストは 18 問から 28 問になりました。答えは長いままでした(書いたトークンは BF16 の 2.9 倍)。
- Q3_K_M: 1.22 倍から 1.11 倍に、BF16 と同じ答えは 19 問から 28 問になりました。
- Q4_K_M: KL ダイバージェンスは 0.071 から 0.049 に下がり、perplexity の比(1.025 と 1.027)には差が見えませんでした。小テストの 36 問は BF16 を 1 問上回りましたが、言い切れない差です。
違いはなぜ出たか
確かめたことと、編集部の推測を分けて書きます。
- 書く速さ: 書く速さとファイルの大きさを掛けると、imatrix なしの 6 つの形式はどれも 1 秒に 43〜56GB ほどでした(計算)。1 トークンごとに重みを全部メモリから読むので、読む量が減るほど速くなったと考えられます。
- 4 ビットと 3 ビットの間: 重みのずれはビット 1 つごとに約 2 倍でしたが、perplexity は Q4_K_M まで 3% 以内で、Q3_K_M で 22% 増えました。小さなずれは打ち消し合い、ある所から次の語の 1 位が入れ替わり始める、と編集部は見ています(確かめていません)。
- 答えが長くなる: 「答えだけ」という指示を守る力が先に落ちたように見えます。Q3_K_M と Q2_K は式を書いたおかげで「17 × 23」に正解しており、正答の数だけでは崩れ方は見えません。
仕事では、PC のメモリの量から選ぶ
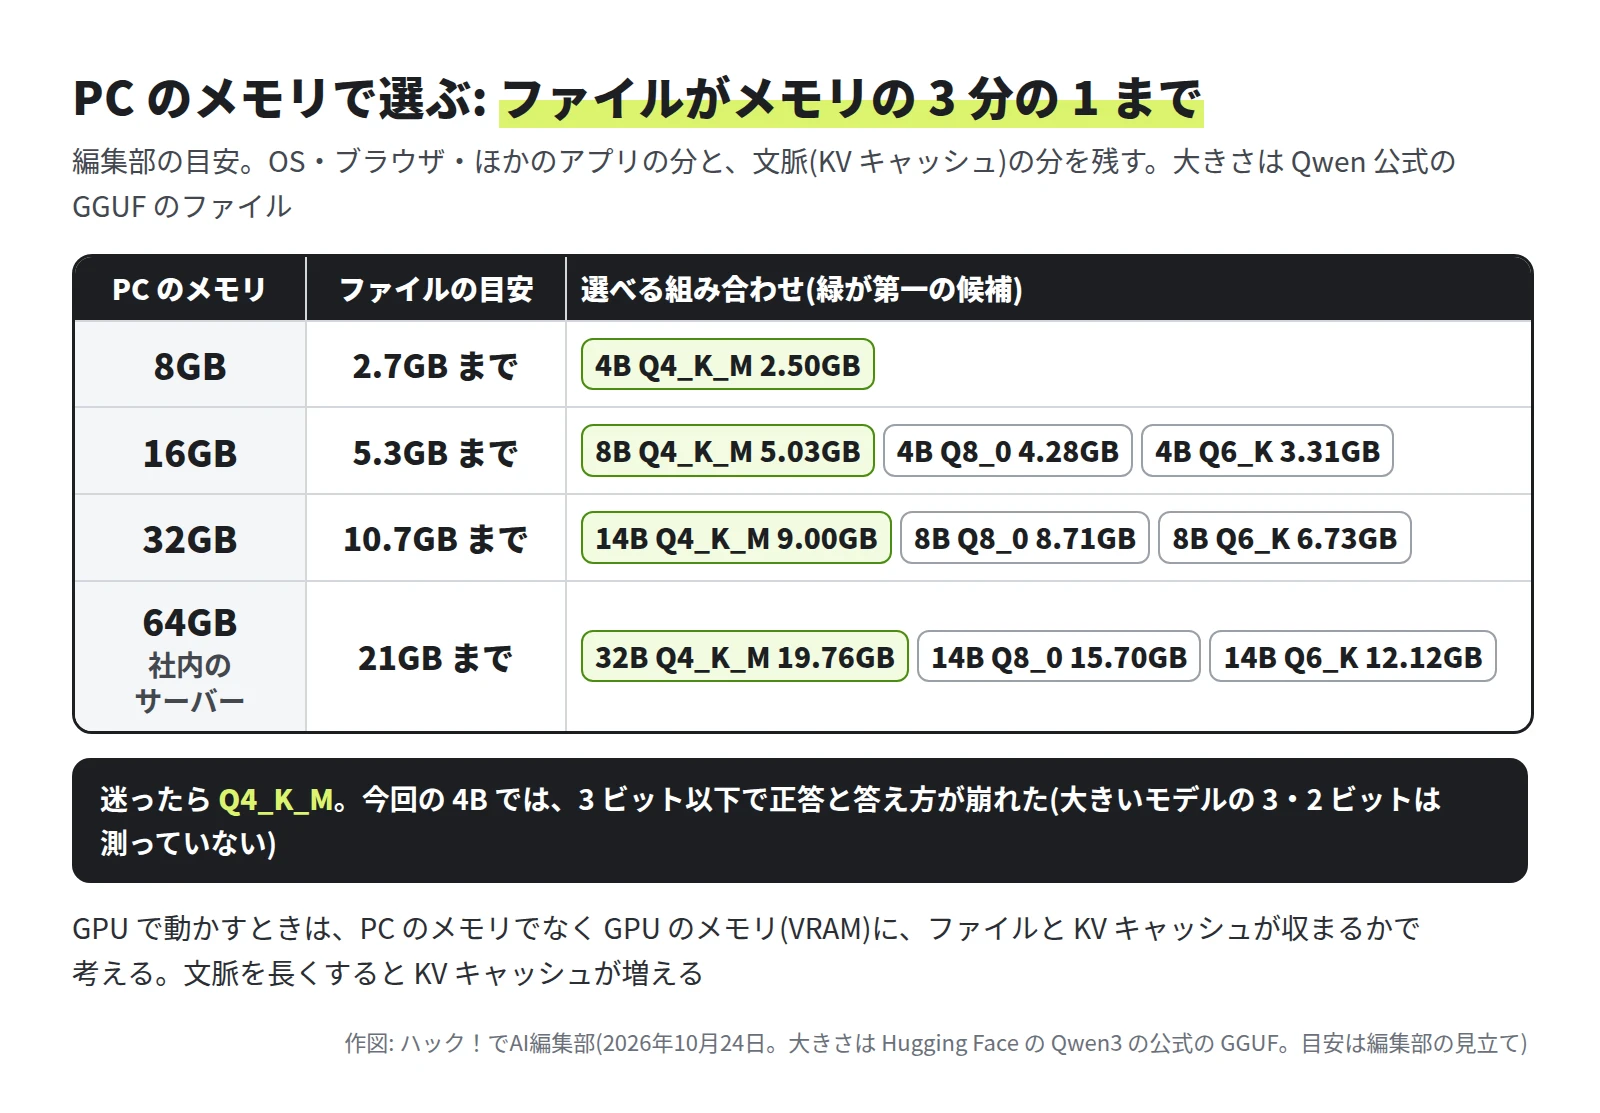
- ノート PC で試す: 編集部の目安は、ファイルをメモリの 3 分の 1 までにして、OS やブラウザの分を残すことです。メモリ 8GB なら 4B、16GB なら 8B の Q4_K_M になります。
- 資料を社外に出さない社内の AI: GPU の無いサーバーでも、4B の Q4_K_M は 1 秒に 17.1 トークンを書きました。短い問い合わせや下書きなら使える速さと、編集部は見ています。
- 長い資料を読ませる: CPU は読む速さが遅く、Q4_K_M で 1 万トークンに約 160 秒かかる計算です。資料を短く切って渡す RAG(ファインチューニングと RAG の違い)や検索のモデル(日本語の埋め込みモデルを比較)と組み合わせるか、GPU を検討してください。
気をつけること
- 1 つのモデル・1 回ずつの結果です。 4B・日本語の文 1 本・48 問です。大きいモデルや別のモデルでは変わることがあります(確かめていません)。
- 有名な作品で測りました。 『坊っちゃん』はモデルが学習で読んでいる見込みがあります。perplexity の値そのものより、形式どうしの差を見てください。
- imatrix の手本は日本語の文です。 日本語の文での比べには、有利な向きです。
- ライセンスは元のモデルのままです。 量子化したファイルを社内で配るときも、元のライセンス(今回は Apache 2.0)を確かめてください。
次にやること
- 選んだモデルの Q4_K_M と Q8_0 に、普段の仕事の問いを 5 つずつ聞き、答えの違いを見ます。違いが気になるときは、1 つ上のビットか 1 つ大きいモデルにします。
- 3 ビット以下を使うときは、imatrix つきのファイルを選び、答えが長くなっていないかも見ます。
今日やる 1 つ: 使っている PC のメモリの量を確かめて、メモリの量ごとの目安の表から緑の組み合わせを 1 つ選んでください(llama.cpp を入れた方は、llama-bench で速さも測れます)。
次の回は、架空のメールに埋めた指示に AI が従ってしまうかと、対策の効き目を数えた「プロンプトインジェクションとは? 例と対策の効き目をメールの要約で試した」です。
小テスト 48 問(要約と正解)
計算(16): 17×23=391 / 1234+5678=6912 / 1000−387=613 / 78×46=3588 / 2 の 10 乗=1024 / 2400 円の 15%=360 / りんご 120 円×3 とみかん 80 円×5=760 / 時速 60km で 2 時間 30 分=150 / 3000 円の 2 割引き=2400 / 1〜100 の和=5050 / 縦 8cm 横 12cm の面積=96 / ある数に 7 を足して 3 倍で 45=8 / 9 時 45 分から 11 時 20 分=95 分 / 5 人の並び方=120 / 3 で割ると 2 余り 5 で割ると 3 余る最小の 2 けた=23 / 7 ダースから 15 本配った残り=69
日本語の知識(16): 小豆=あずき / 土産=みやげ / 五月雨=さみだれ / 為替=かわせ / 愛媛県の県庁所在地=松山 / 岩手県=盛岡 / 栃木県=宇都宮 / 島根県=松江 / 猿も木から□□□=おちる / 一石□鳥=二 / 石の上にも□年=三 / いちばん長い川=信濃川 / いちばん面積の大きい湖=琵琶湖 / 『枕草子』の作者=清少納言 / 師走=12 月 / 衆議院ともう 1 つ=参議院
指示に従う(16): 五十音順・逆順・大きい順・アルファベット順に並べる / 同じ語を 5 回続ける / カタカナに直す / 偶数を半角カンマで / JSON にする / はい・いいえの一語 / 数字を抜き出す / 英語の大文字に訳す / 語を置き換える / 3 行で書く / 先頭の文字をつなげる / 合計を決まった形で / 漢字を数える(答えはどれも 1 つに決まる)
参考にした公式の情報
- GitHub ggml-org/llama.cpp「Release b11852」
- GitHub ggml-org/llama.cpp「tools/quantize/README.md」(b11852)
- GitHub ggml-org/llama.cpp「tools/imatrix/README.md」(b11852)
- GitHub ggml-org/llama.cpp「tools/perplexity/README.md」(b11852)
- GitHub ggml-org/llama.cpp「tools/server/README.md」(b11852)
- GitHub ggml-org/llama.cpp「k-quants」(#1684)
- Hugging Face Hub ドキュメント「GGUF」
- Hugging Face「Qwen/Qwen3-4B-Instruct-2507」(モデルカード・Apache 2.0)
- Hugging Face「Qwen/Qwen3-8B-GGUF」
- Hugging Face「Qwen/Qwen3-14B-GGUF」
- Hugging Face「Qwen/Qwen3-32B-GGUF」
- arXiv「Qwen3 Technical Report」(Yang ほか, 2025)
- arXiv「Distilling the Knowledge in a Neural Network」(Hinton ほか, 2015)
- 青空文庫 図書カード「坊っちゃん」(夏目漱石)
- 青空文庫 図書カード「銀河鉄道の夜」(宮沢賢治)
- 青空文庫「青空文庫収録ファイルの取り扱い規準」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。