 佐々木 航
この記事でわかること
- 金融機関の生成AIの利用率と、顧客に直接見せる先の少なさ
- 国産か海外か、閉域かクラウドか。金融と製造の各社の選び方
- 自社の機密業務にAIを入れるときに当てはめる4つの段階
確認した環境: 日本銀行・金融庁・総務省ほかの公的な調査と、各社の公式の発表 / 2026年10月25日に確認
「日本の金融機関は、生成 AI に慎重で、使い始めるのが遅い」。そう思っているなら、調査の数字は逆を示しています。日本銀行の 2026 年度の調査では、取引先の金融機関 150 先の 9 割強が生成 AI を利用・試行していました。ただし、AI の答えをそのまま顧客に見せている先はまだ少数で、多くは顧客の前に出す一歩手前で止めています。
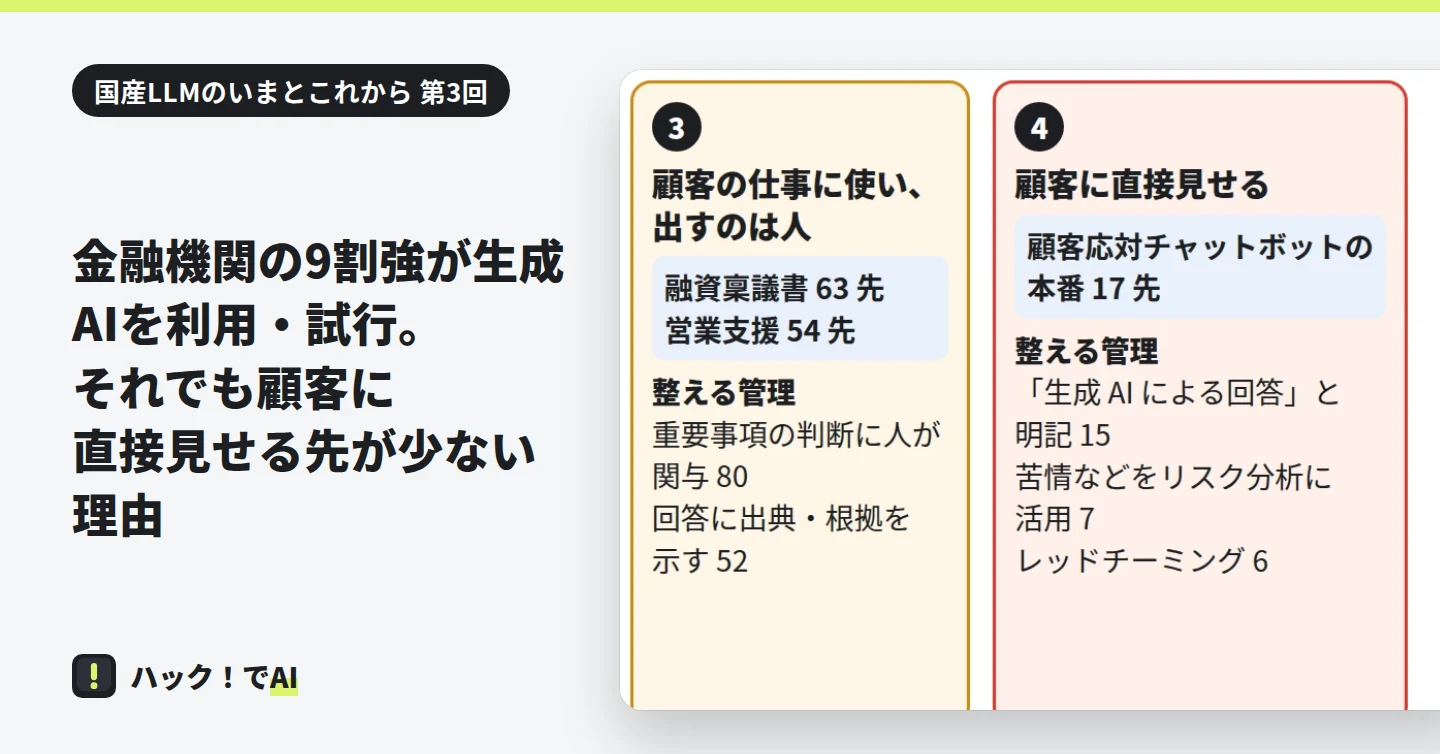
内訳は「利用中」が 79.3%、「試行中」が 11.3% です。合わせた割合は、2 年前(2024 年度)の 58.1% から大きく増えました。日銀によると、顧客に直接見せる使い方には「慎重なスタンスをとる金融機関がほとんど」で、そのための管理を実施している先は「僅少」です。AI による回答だと明記することや、攻撃する側に立って弱点を探すレッドチーミングがその例です。
この回は、自社の機密を扱う仕事に AI を入れたいが、どこまで進めてよいか迷っている方に向けて書きました。金融機関は顧客情報という機密を抱える業界で、どの段階まで進んだかが公的な調査の数字で分かります。金融と製造でよく聞く 5 つの思い込みを 1 つずつ確かめ、最後に自社に当てはめる 4 つの段階にまとめます。
連載「国産LLMのいまとこれから」の第 3 回です。LLM(大規模言語モデル。文章を読み書きする AI の本体)の「国産」にどんな作り方があるかは、第 1 回で整理しました。
1. 「日本の金融は AI が遅れている」は、2 年前の数字
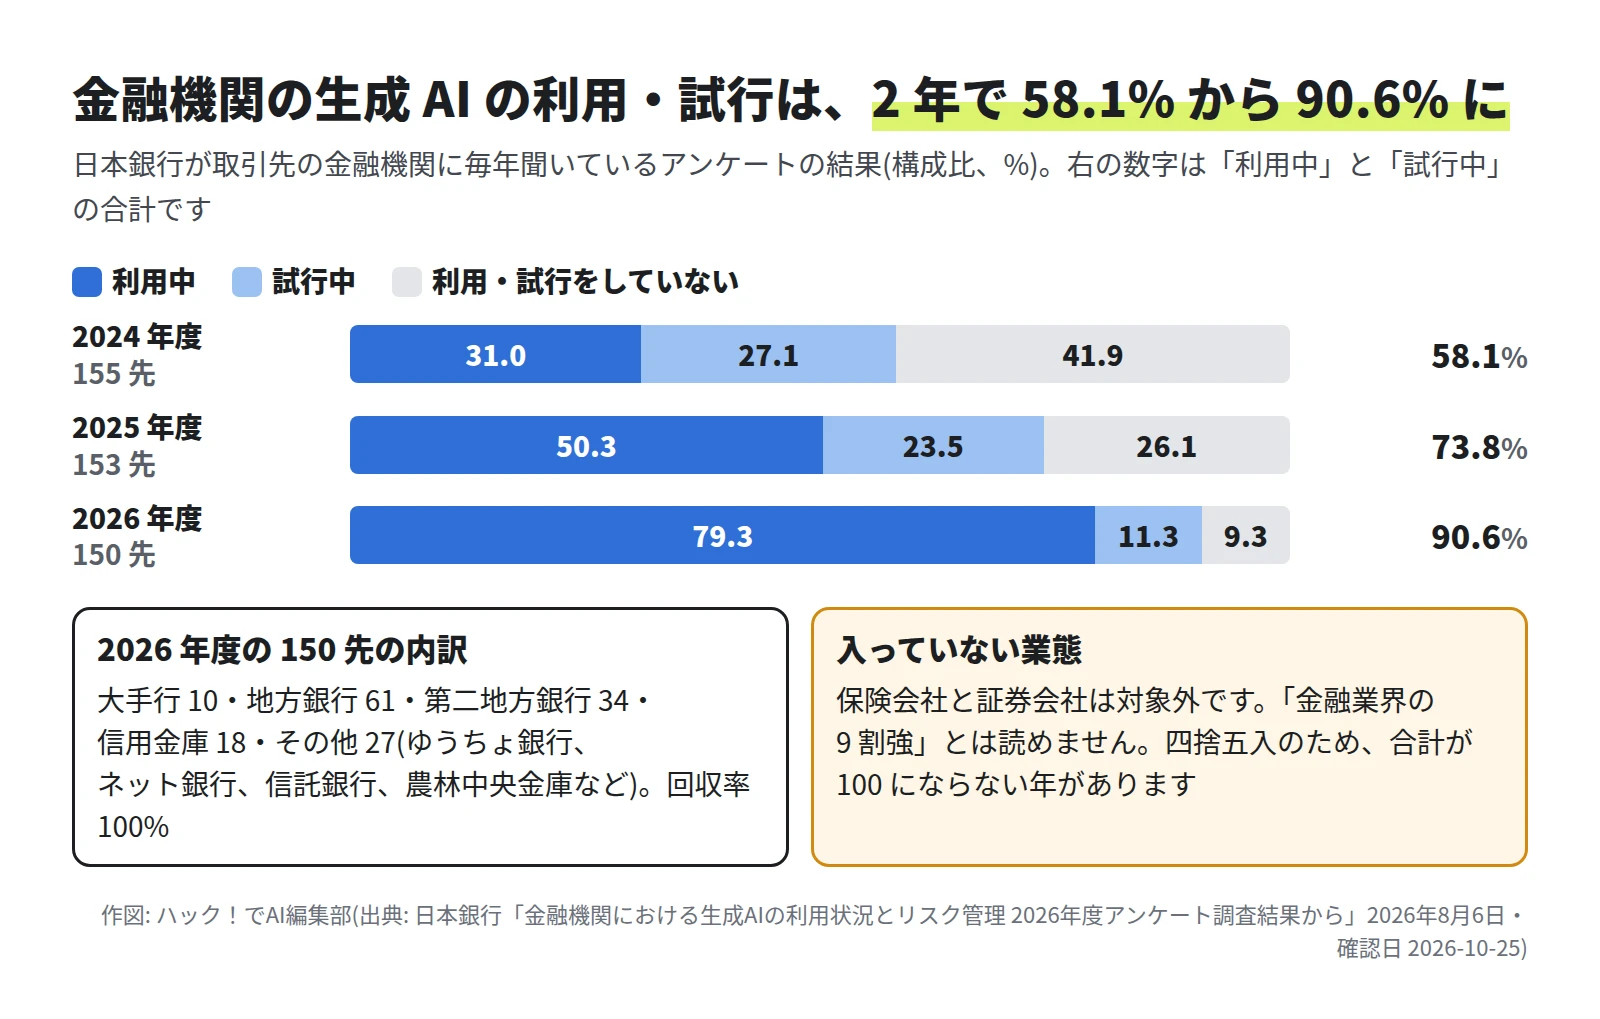
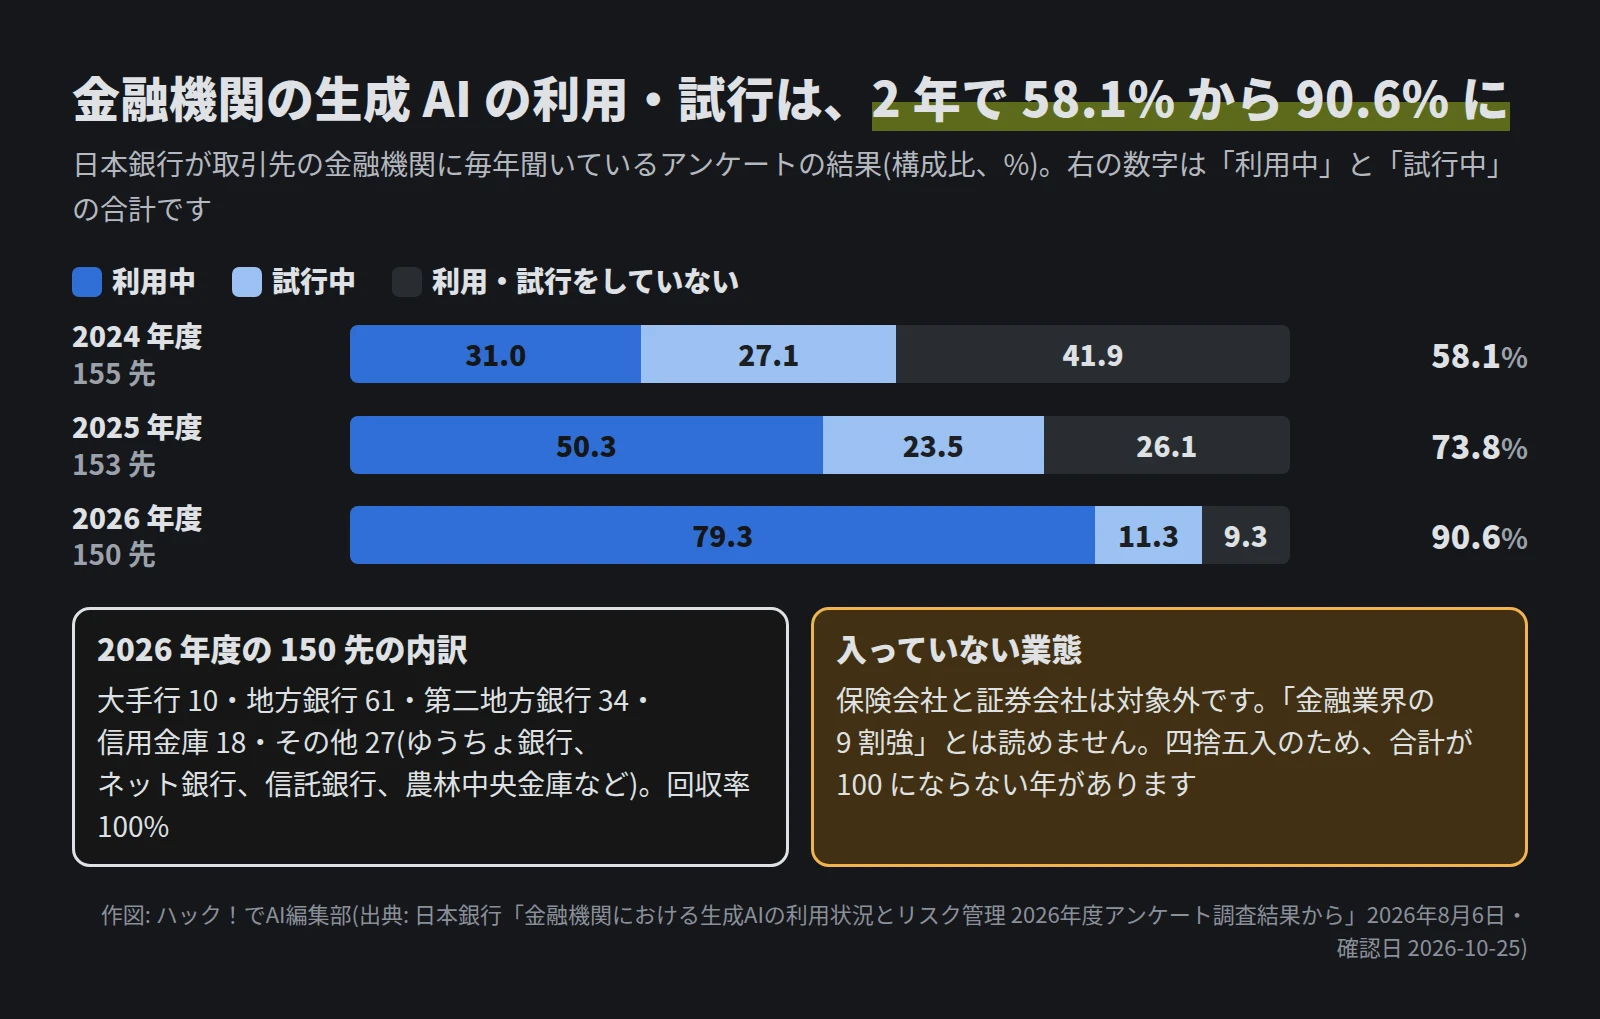
日銀の調査は 2024 年度から毎年行われ、今回が 3 回目です。対象は大手行・地方銀行・信用金庫など日銀の取引先 150 先で、回収率は 100% でした。保険会社と証券会社は入っていないので、「金融業界の 9 割強」とは読めません。
「利用中」は、2024 年度の 31.0% から 50.3%、79.3% と増えました。業態別では、利用・試行中の割合の増加が、この 1 年は特に第二地方銀行で目立ちます。
業種を問わない企業の調査でも、海外との差は縮みました。総務省の令和 8 年版 情報通信白書の 4 か国の企業調査では、生成 AI を 1 つ以上の業務で使う日本企業は 86.4%(前年 55.2%)で、米国の 90.9%、ドイツの 91.6% に近づいています。
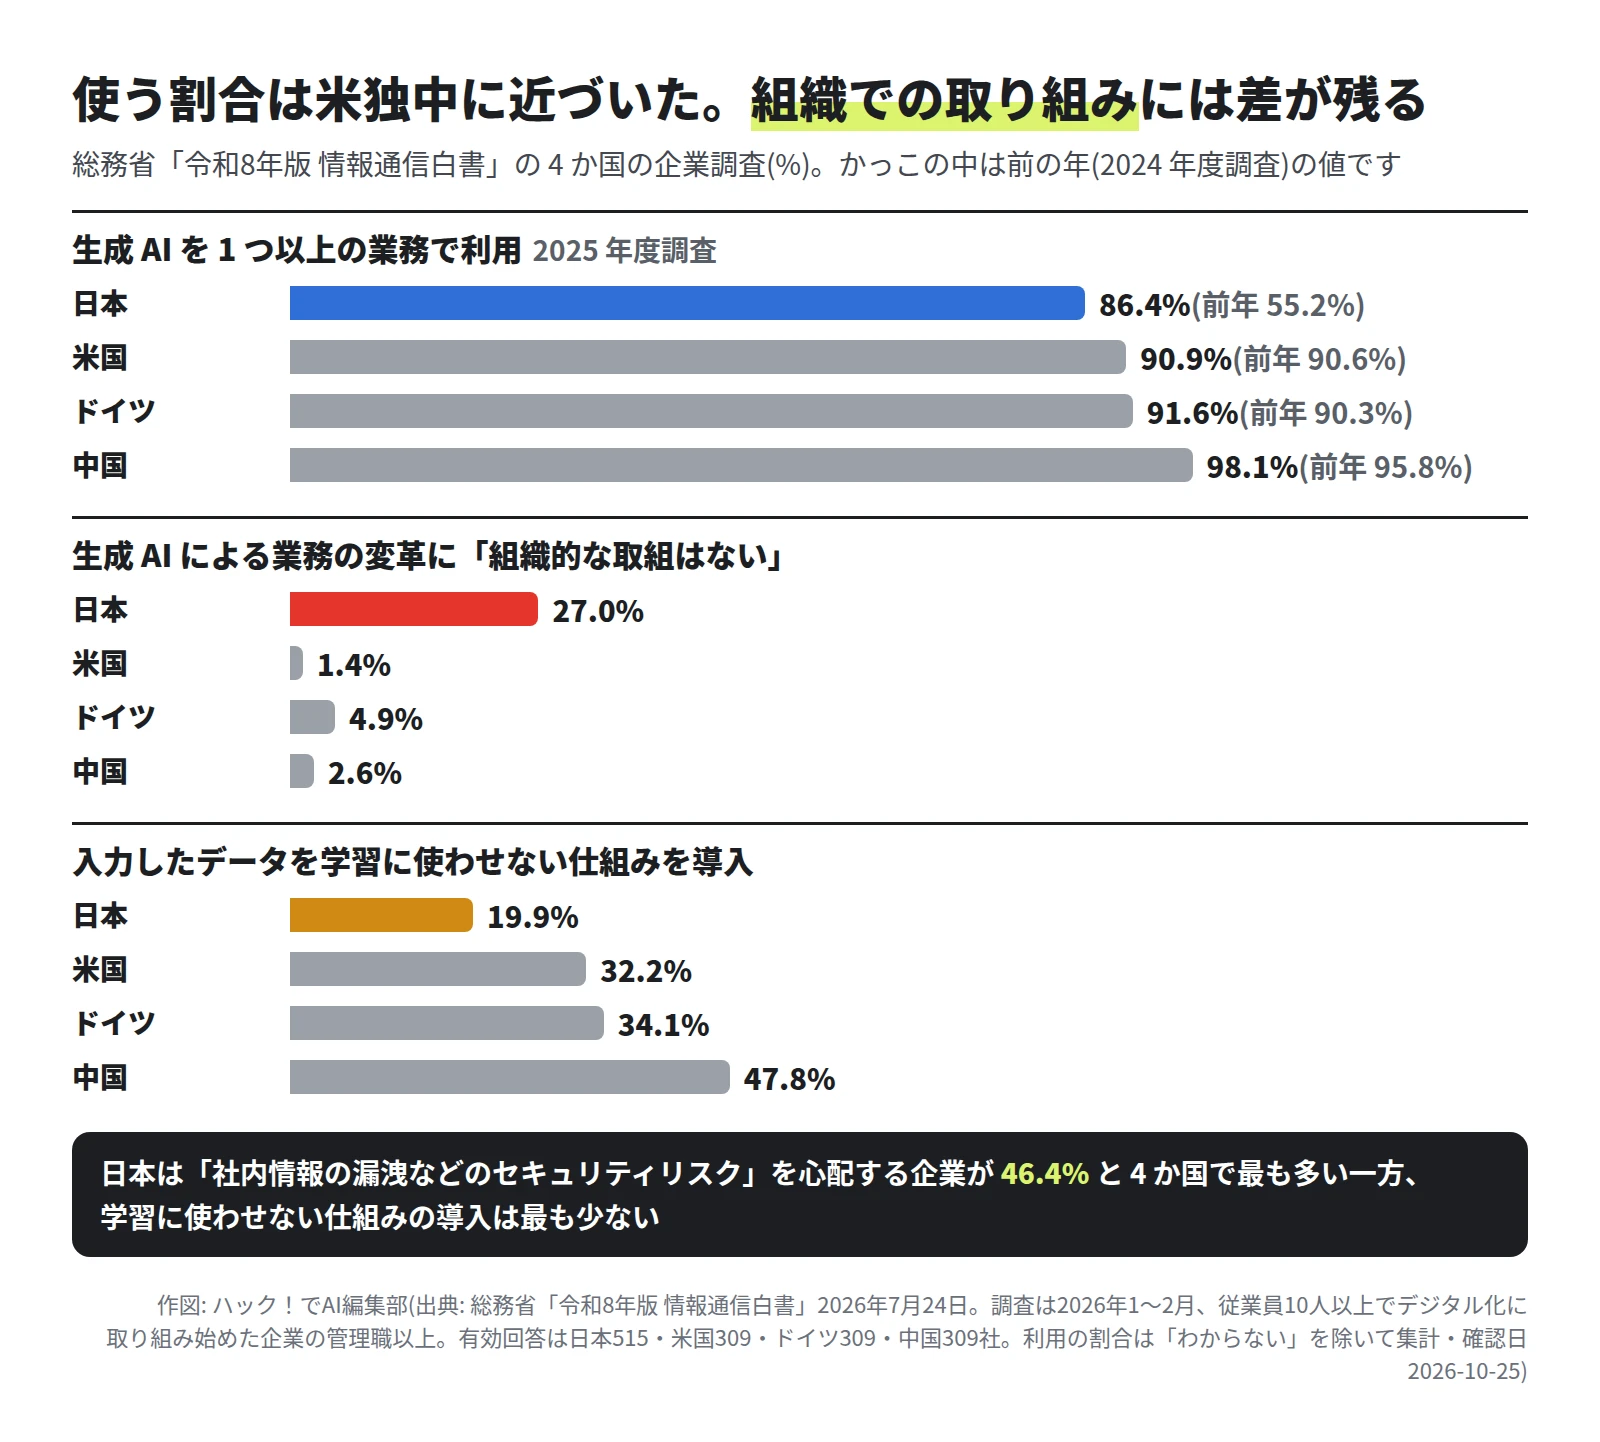
差が残るのは、組織としての取り組みです。生成 AI による業務の変革に「組織的な取組はない」と答えた企業は、日本が 27.0%、米国が 1.4% でした。社内情報の漏洩を心配する企業は日本が 46.4% と 4 か国でいちばん多いのに、入力したデータを学習に使わせない仕組みを入れた企業は 19.9% で、4 か国でいちばん少ない結果です。
そう思われやすいのは、調査ごとに数字が違うから
「遅れている」という印象は、1 年前の白書の調査の 55.2% のような古い数字や、対象の違う調査を並べたときに生まれやすいものです。国内の調査だけでも、生成 AI の導入率は 34.5% から 90.6% まで開きがあります。
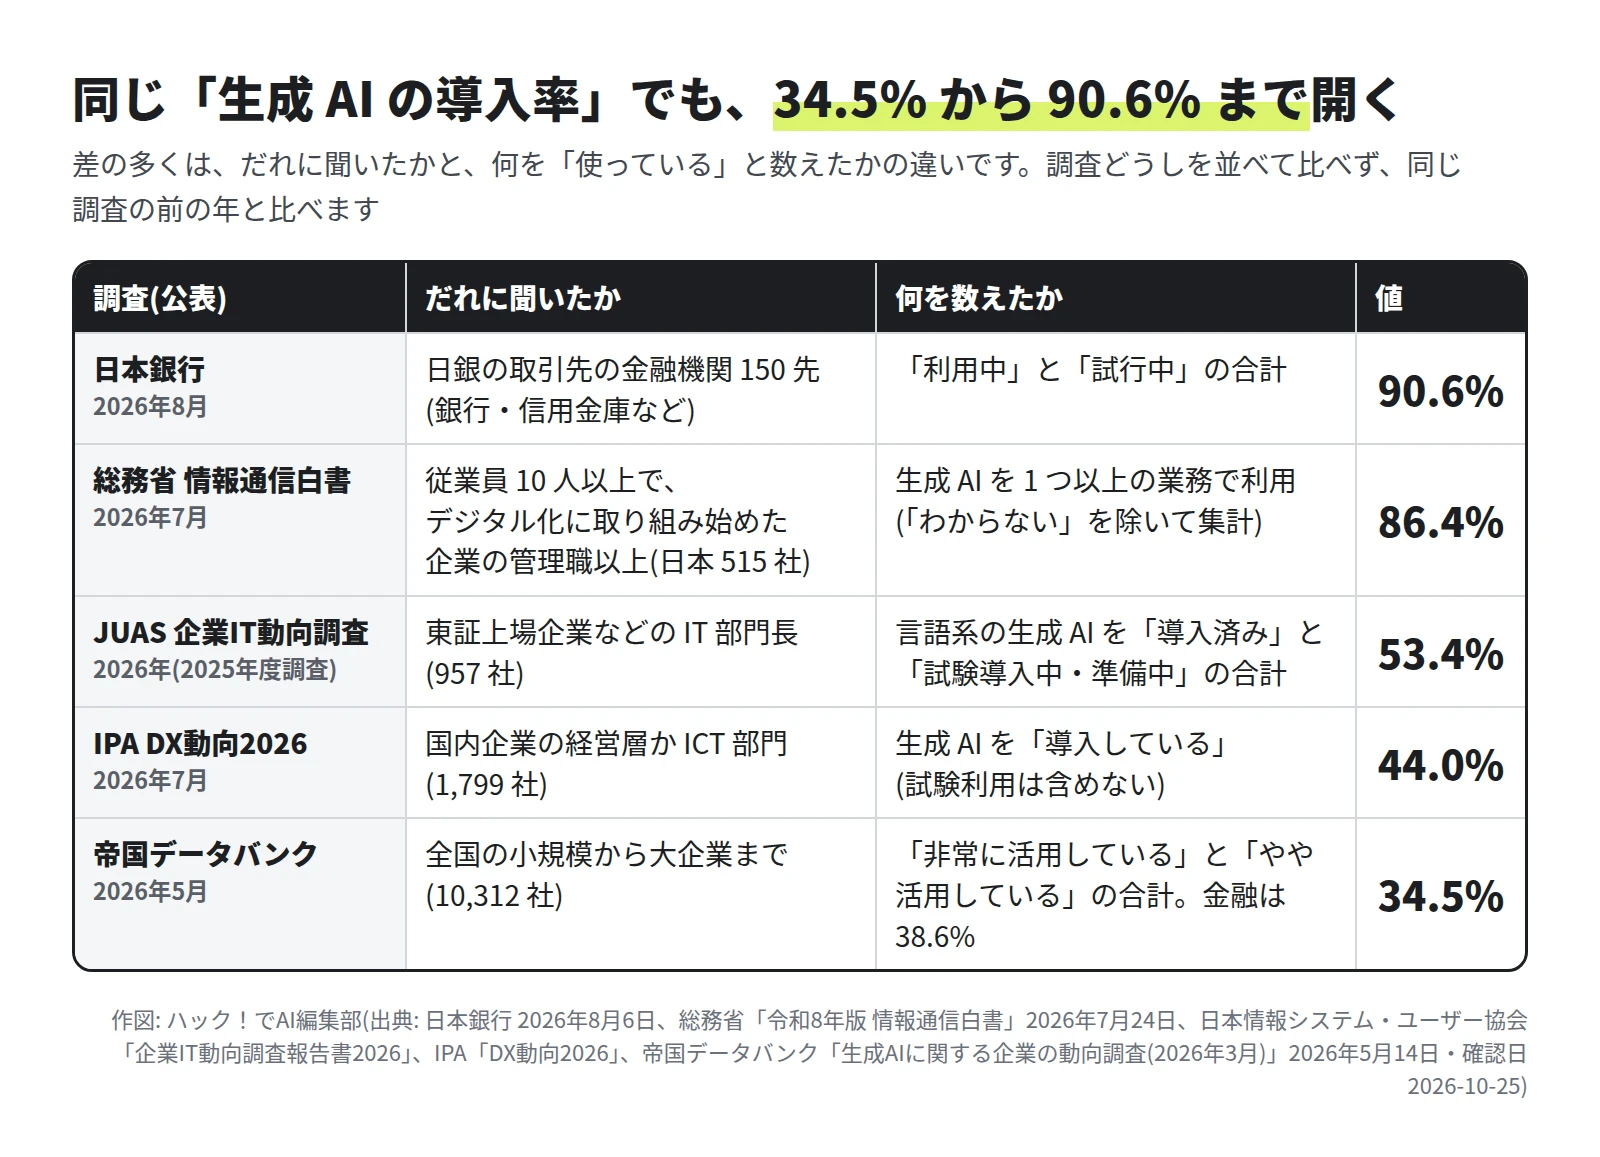
帝国データバンクの 34.5% は規模を問わず約 1 万社に聞いた値、白書の 86.4% はデジタル化に取り組み始めた企業の管理職以上に聞き、「わからない」と答えた企業を除いた値で、同じ物差しではありません。比べるなら、同じ調査の前年の値と比べます。
日銀の数字にも、読み違えやすい所があります。前年(2025 年度)の報告にも「9割強」という言葉がありますが、これは将来の利用を検討している先まで含めた数字でした。利用中と試行中の合計は、前年が 7 割強(73.8%)、今回が 9 割強(90.6%)です。
製造業については、業種ごとにそろった公的な数字を見つけられませんでした。参考になるのは IPA の「DX動向2026」です。生成 AI の導入や検討を進める企業に使っている部署を聞くと、「IT システム」が 71.9% だったのに対し、「製造(設計、生産管理を含む)」は 35.7% でした。現場に近い部署ほど、使っている割合が低い結果です。
2. 「使っている」は「顧客に出している」ではない
生成 AI を利用・試行中の先の多くは、まず社内の事務で使っています。136 先のうち、文書作成支援で使う先(試行を含む)は 132 先です。ただ、業務プロセスに組み込んだのは 6 先で、多くは業務を手伝うツールとして使っています。
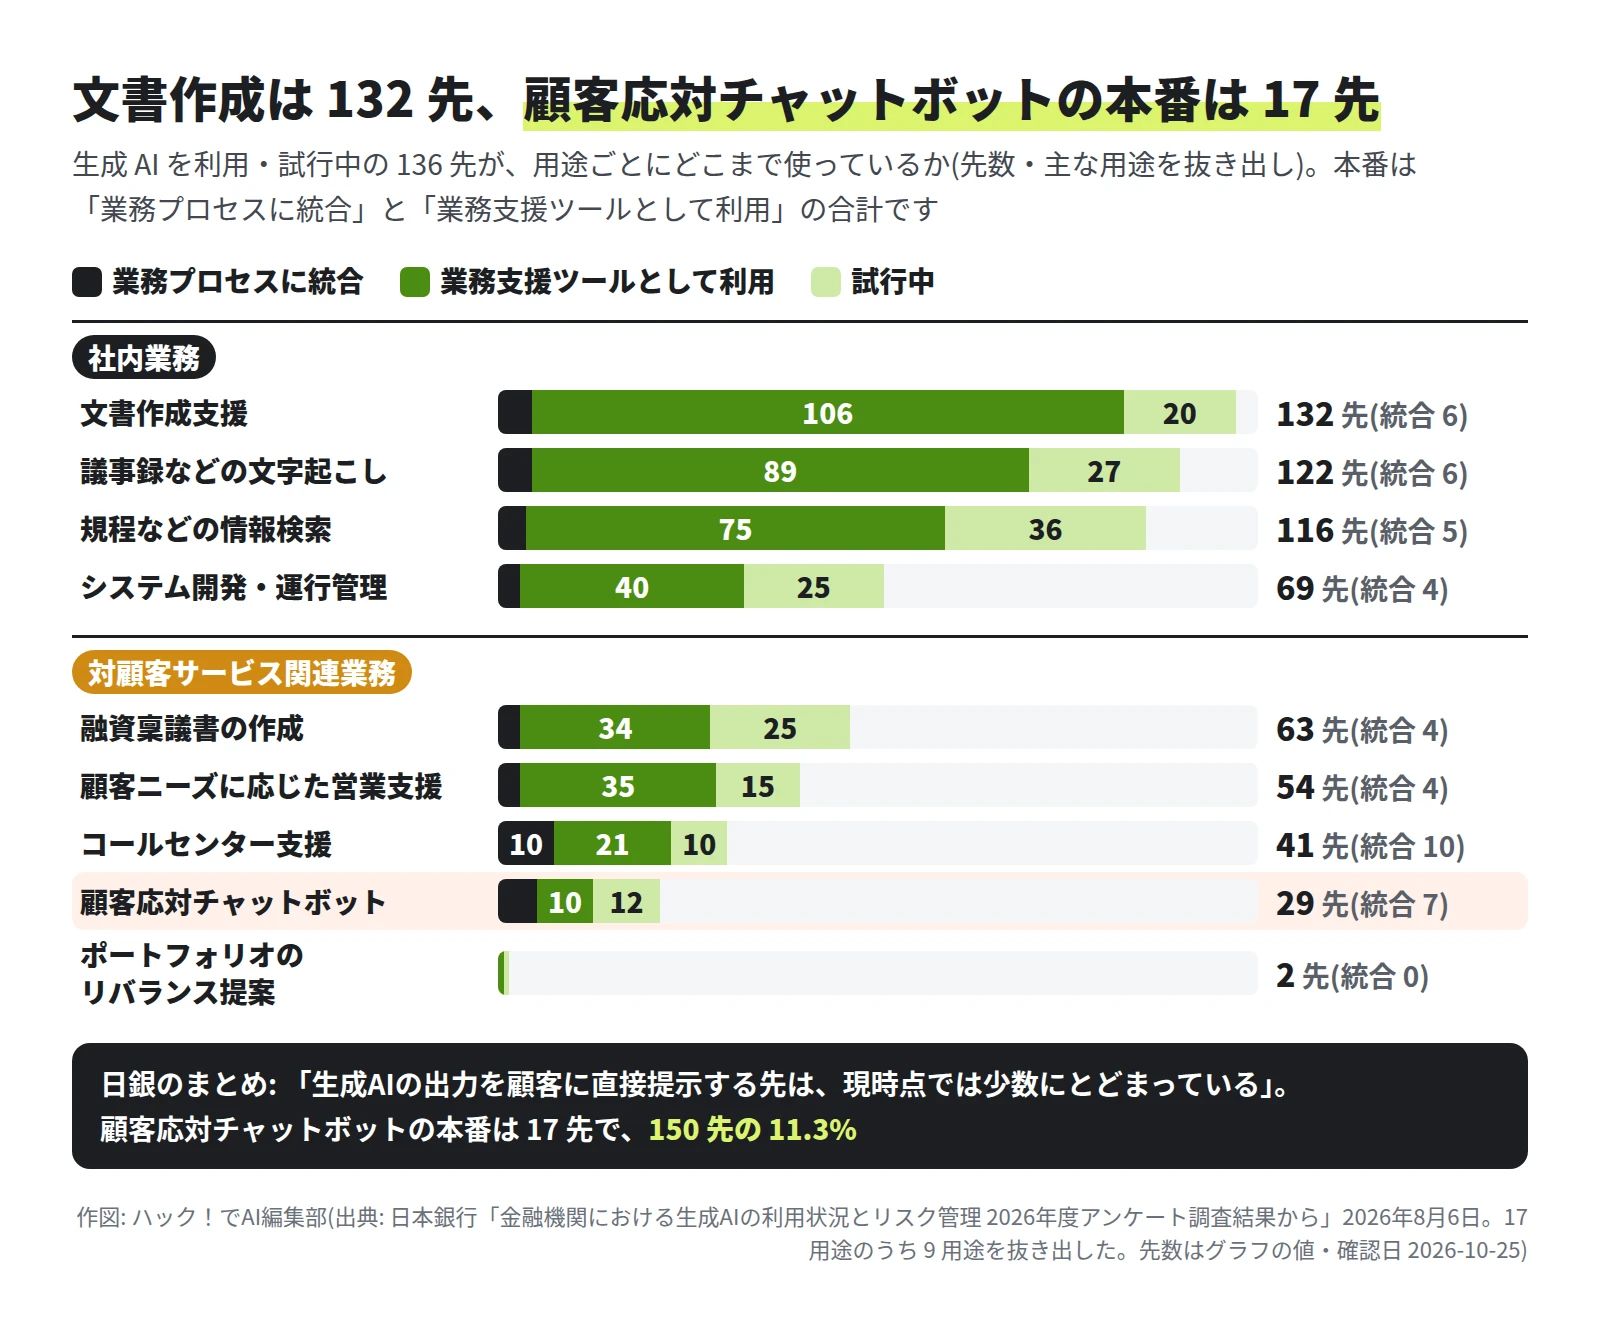
顧客の情報を使う業務にも広がっています。融資の稟議書(融資を決めるための社内の決裁書類)の作成は 63 先、顧客ニーズに応じた営業支援は 54 先です。ただ、どちらも AI の出力を受け取るのは行員で、顧客に届く前に人が読みます。
日銀は、AI の出力を顧客に直接見せている先の数そのものは出していません。まとめは「生成AIの出力を顧客に直接提示する先は、現時点では少数にとどまっている」で、意見交換でも「慎重な姿勢がみられた」とあります。
目安になるのは、顧客と直接やりとりする顧客応対チャットボットです。使う先は 29 先で、試行中を除くと 17 先(150 先全体の 11.3%・編集部の計算)でした。3 年後にチャットボットを業務プロセスに組み込んでいると見込む先は 37 先で、いまの 7 先を大きく上回ります。
顧客の前に出す例は、範囲を絞って始まった
金融庁は「AIディスカッションペーパー」第 1.1 版(2026年3月)で、2024年11月の実態調査では「ほとんど行われていなかった」顧客向けの利用が、「範囲・条件を絞ったサービス提供又はその検討が行われる段階に至っている」と書いています。
三井住友銀行の「SMBC AI オペレーター」(2026年2月25日開始)は、その一例です。電話で AI が顧客と会話しますが、対象は Olive のサービス内容や年会費、キャンペーンの概要など、本人確認が要らない一般的な照会に限っています。本人確認が要る手続きや複雑な相談は、有人のオペレーターに引き継ぎます。
そう思われやすいのは、「利用中」が用途を問わない数字だから
日銀の調査は、まず生成 AI を使っているかを聞き、用途ごとの使い方はそのあとで聞いています。「利用中」の数字だけでは、どの仕事に使っているかは分かりません。「9 割強が使う・試す」と「9 割強が顧客向けのサービスに AI を入れた」は、別の話です。
運転免許にたとえると、多くの金融機関は、教官が助手席に座る路上教習の段階にいます。AI が書いた稟議書の下書きは、行員という教官が確かめてから先へ進みます。ひとりで公道を走る段階、つまり顧客に直接見せる段階に進んだ先は、まだ一部です。
3. 日銀の調査で多かった課題は、誤回答より人とデータ
生成 AI の課題というと、ハルシネーション(事実と違う答えを作ること)や情報漏洩が真っ先に挙がりがちです。誤回答や権限の管理、監査、外部のサービスへの依存が課題だ、という説明もよく見かけます。日銀の調査の結果は、これとは違いました。
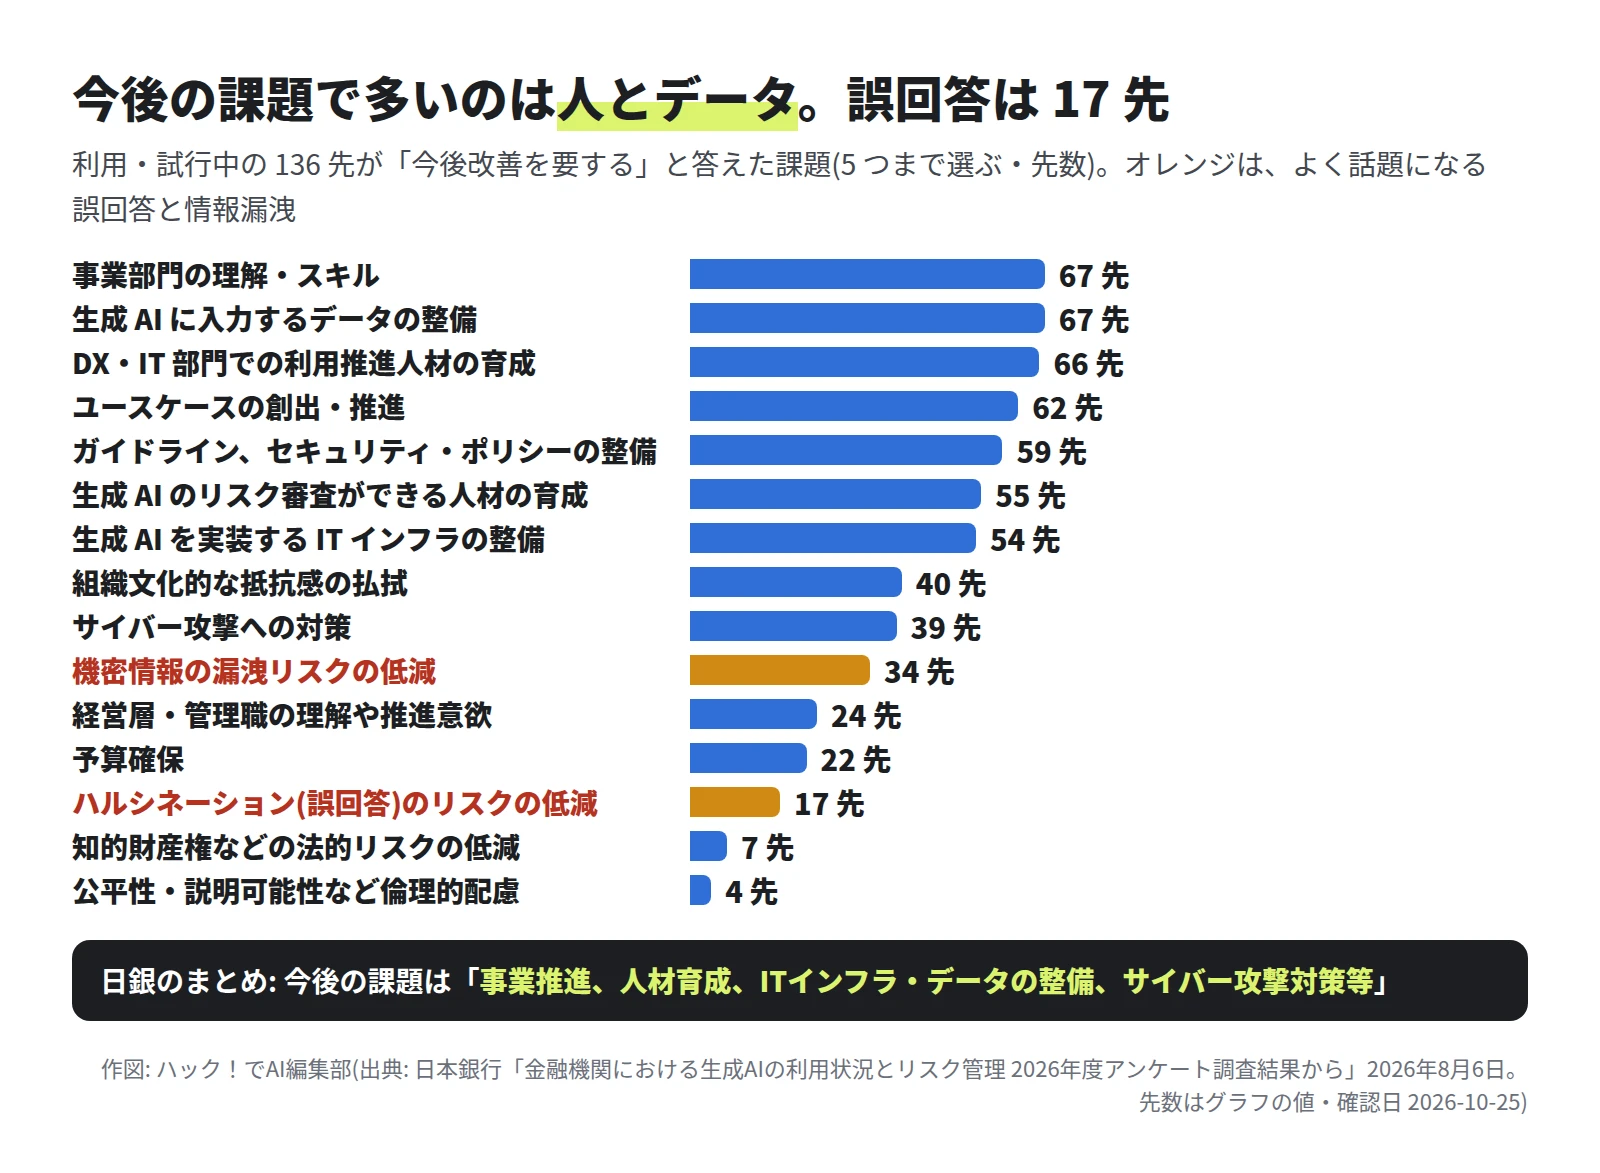
利用・試行中の 136 先が「今後改善を要する」と答えた課題(5 つまで)で多かったのは、事業部門の理解・スキルと、入力するデータの整備(どちらも 67 先)、DX・IT 部門の人材の育成(66 先)でした。ハルシネーションのリスクの低減は 17 先、機密情報の漏洩リスクの低減は 34 先です。日銀は今後の課題を「事業推進、人材育成、ITインフラ・データの整備、サイバー攻撃対策等」とまとめています。
機密を扱う準備は進んでいます。136 先のうち、機密性の高い情報を生成 AI で扱えると答えた先は 75 先(55.1%)です。入出力を管理できるシステム環境(90 先)、機密情報の入力を制限する社内規則(84 先)、権限に応じた情報の制限(76 先)も、多くの先が実施しています。
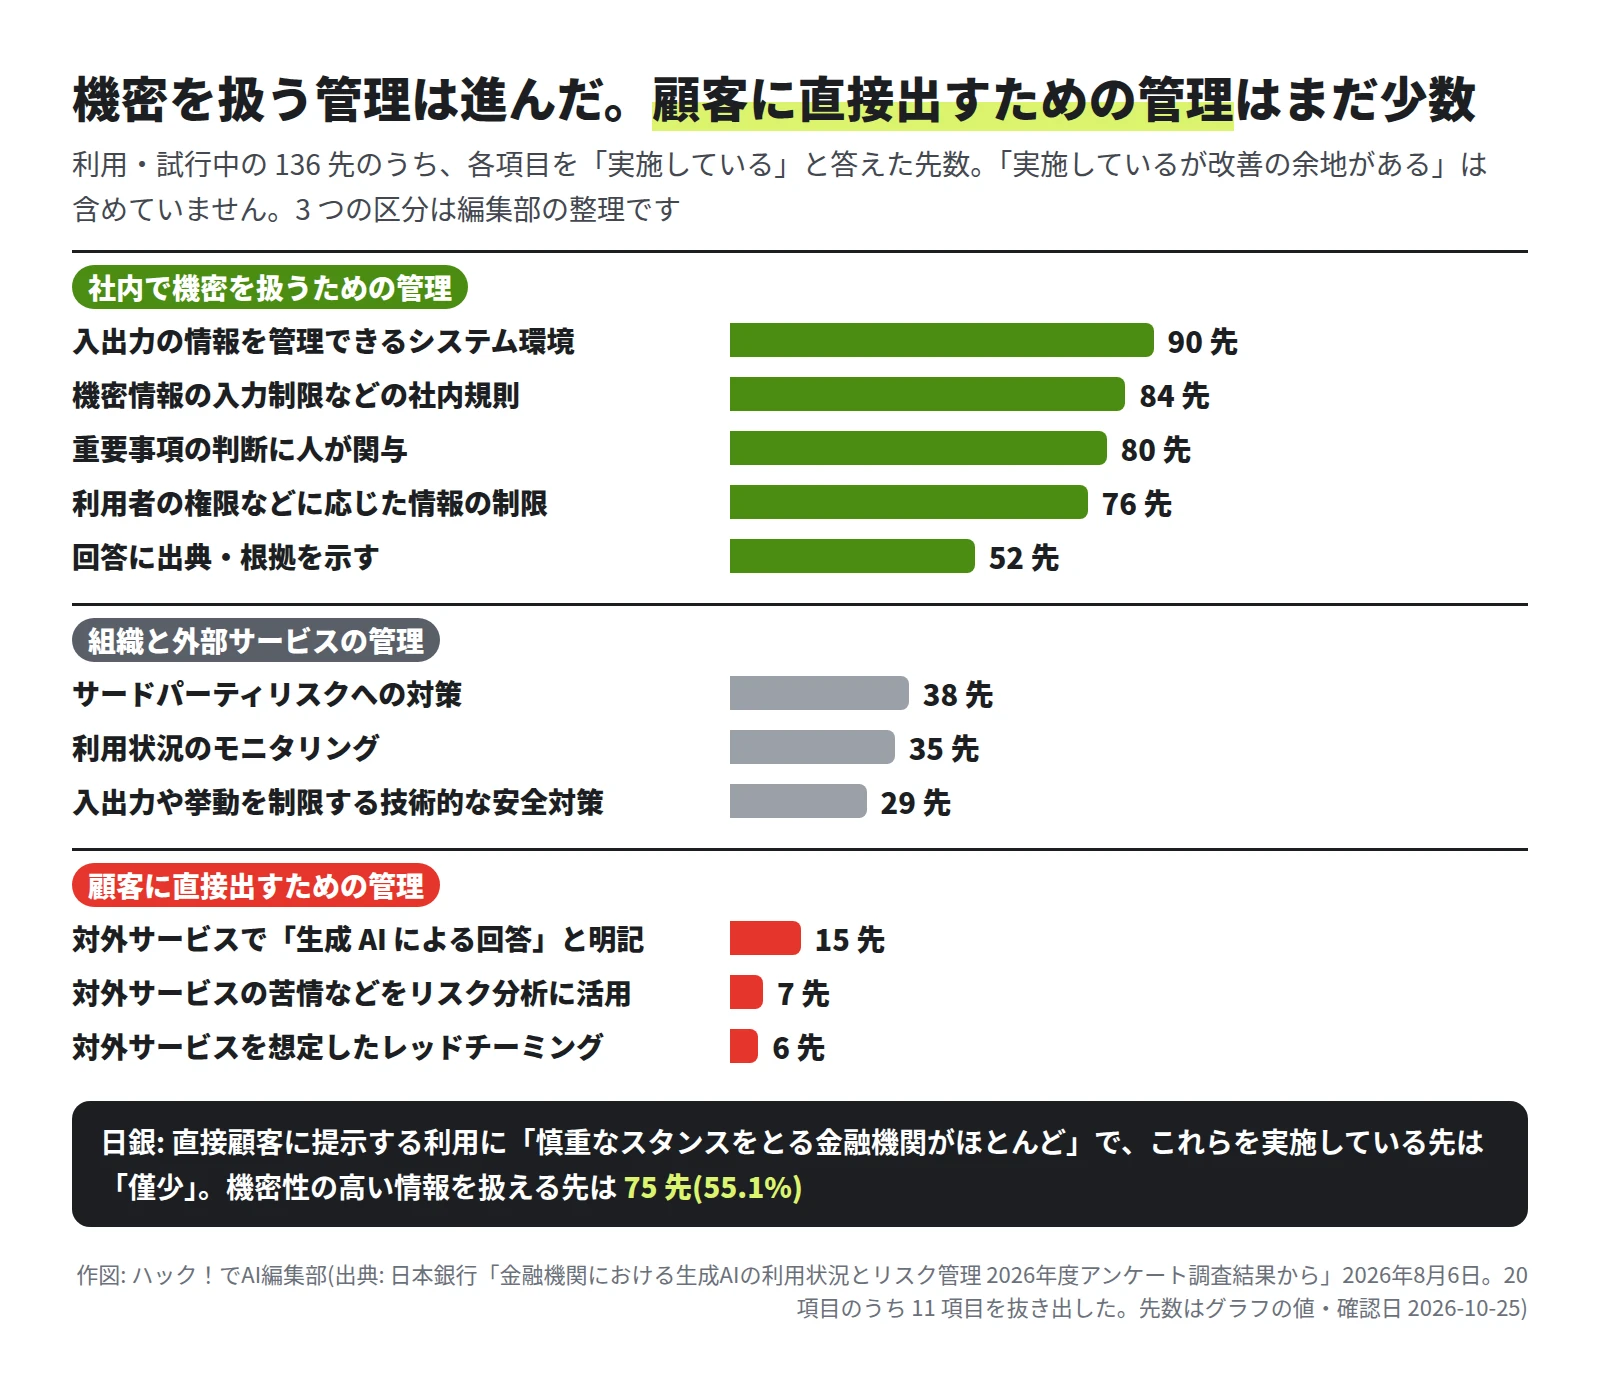
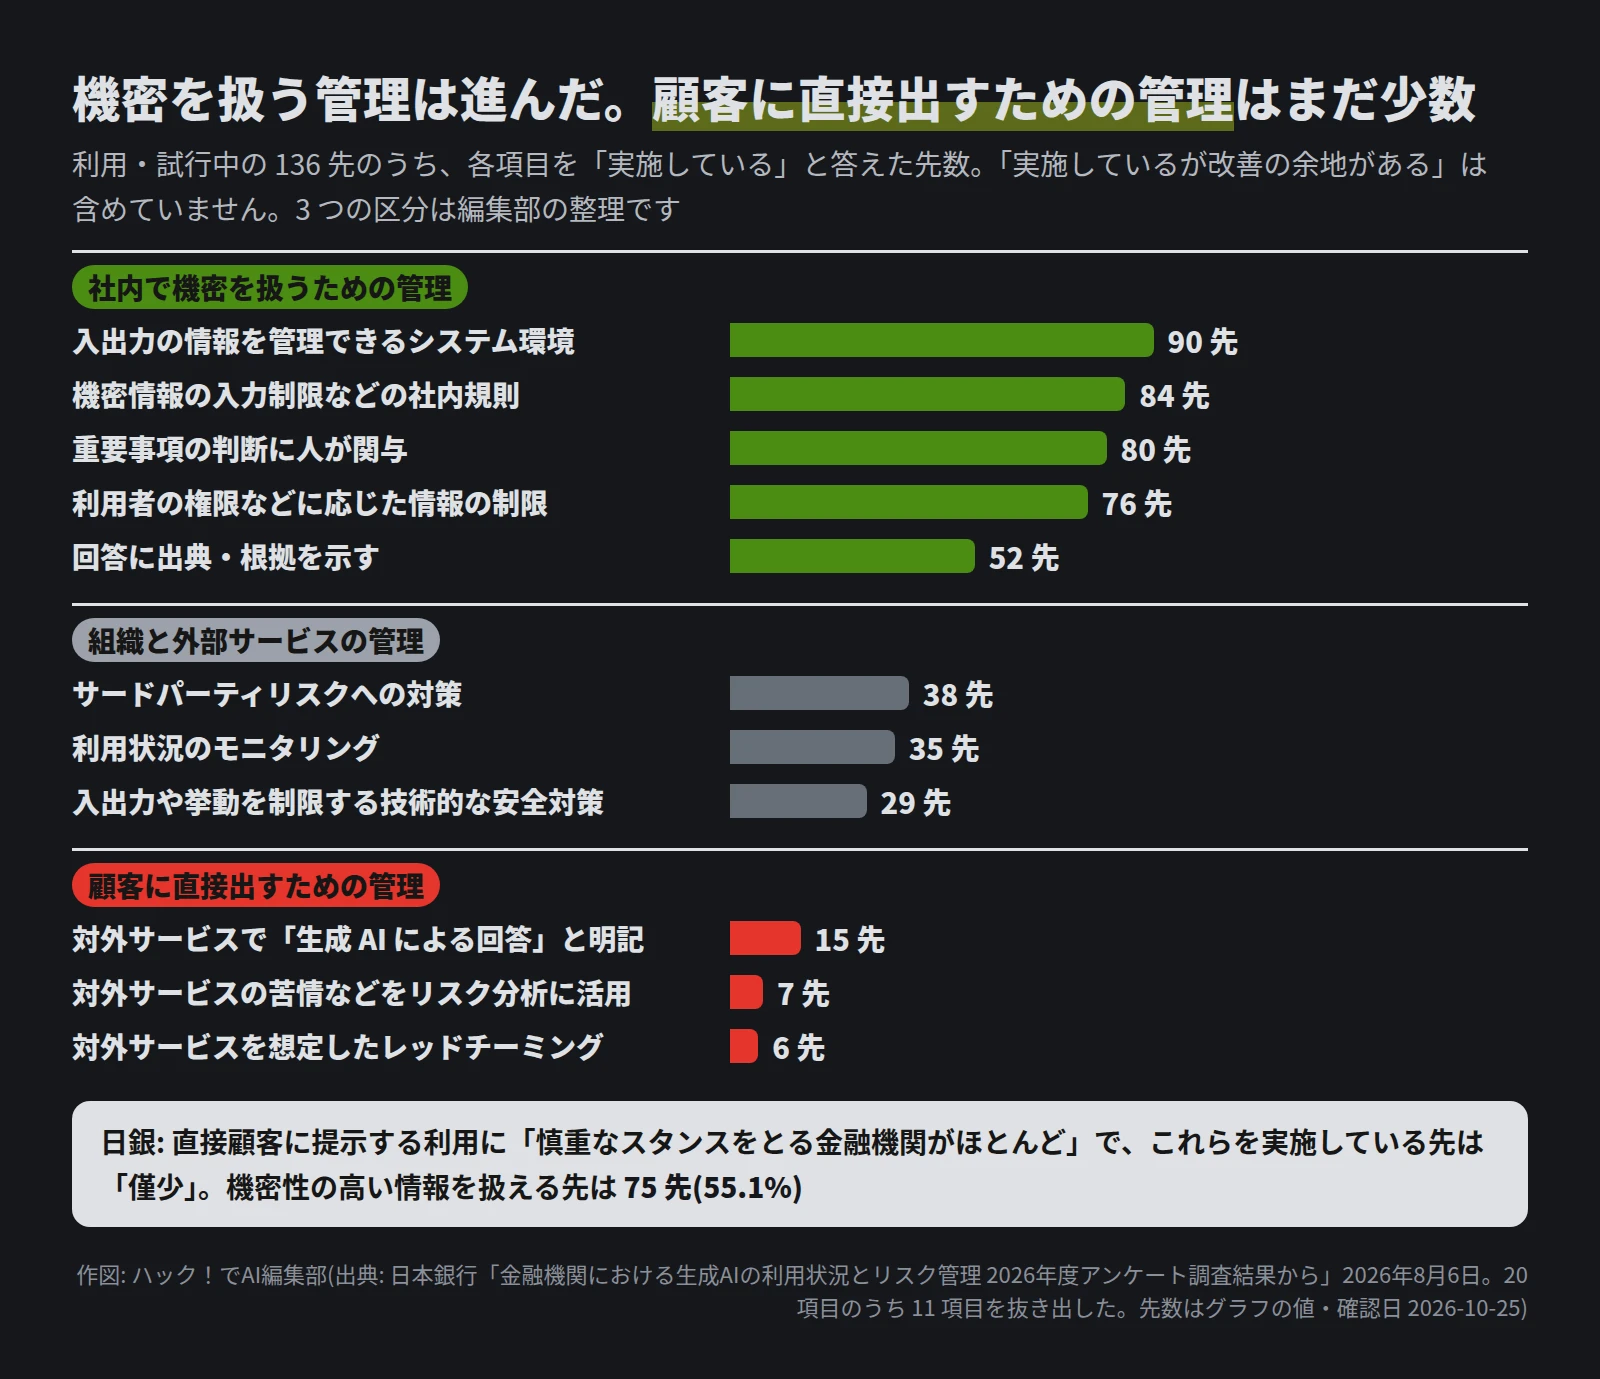
一方、顧客に直接出すための管理は、まだ少数です。対外サービスを想定したレッドチーミングを実施している先は 6 先、AI による回答だと明記している先は 15 先でした。ガバナンス、サードパーティ(外部のサービスや委託先)のリスク管理、セーフティ・セキュリティも、「改善の余地がある」「検討中」と答えた先が多い項目です。
編集部の見方: 誤回答が課題に挙がりにくいわけ
誤回答を課題に挙げた先が少ない理由を、日銀は書いていません。編集部は、人が確かめる使い方にとどめていることが大きいとみています。重要事項の判断に人が関与している先は 80 先あります。人が読んでから使う業務なら、誤回答は直す手間で済み、顧客に届く前に止まります。
顧客に直接見せる段階に進めば、同じ誤回答の重みが変わります。日銀も報告書のまとめで、顧客への直接提示や AI エージェント(自分で手順を考えて作業を進める AI)の導入には、リスク管理とガバナンスでの対応が重要になると書いています。段階が進めば、課題の順位も入れ替わるはずです。
4. 「国産モデルなら安全」? 日銀の調査はモデルの国籍を数えていない
日銀の 2025 年度と 2026 年度の報告書には、使っているモデルが海外のクラウドのものか、自前で動かすものか、国産かという集計がありません。数えているのは、入出力の管理や権限の制限のように、どのモデルにも当てはまる管理の項目です。初回(2024年10月)の報告には、7 割前後の先がクラウドの自社専用区画を使っている、という記述がありました。
金融庁は、ディスカッションペーパー第 1.1 版で、モデルを動かす環境の違いをこう書いています。
オープンソースとして提供されているLLM をオンプレミスサーバー内で利用している先や、専用線を通じてプロプライエタリな生成AI サービスを閉域環境で利用している先なども確認された。
オンプレミスは自社の建物やデータセンターに置いたサーバーで動かすこと、閉域はインターネットから切り離した専用の回線や網でつなぐことです。
そう思われやすいのは、「国産」と「国内で動く」が混ざるから
国産のモデルでも、開発会社のクラウドに API でつなげば、データはその会社のサーバーに届きます。逆に、海外の会社が重みを公開したモデルでも、自社のサーバーで動かせば、データは社外に出ません。次の節で見るみずほは、海外の公開モデルを元に作ったモデルを銀行内で運用できるとしています。
外に出るかどうかを決めるのは、モデルの作り手の国籍ではありません。どこで動かすか、だれが何を入力できるか、何を記録するか、の 3 つです。構成の 3 つの型と、それぞれに残る注意は第 4 回で、手元で動かす方法を含む 6 つの手段はそれでも機密を AI で扱いたいときの方法で説明しています。外に送らずに国産の公開モデルでどこまで答えられるかは、第 5 回で試しました。
5. 自社専用の LLM の元は、国産とは限らない
「自社専用の LLM を作るなら国産のモデルから」とは限りません。みずほフィナンシャルグループの「金融特化LLM」の元は、Qwen3-32B です。中国のアリババグループの Qwen チームが、Apache 2.0 のライセンスで公開している約 330 億パラメーターのモデルです。ただし、この名前が出てくるのは 2026年3月の発表だけで、みずほの 3 回の公式の発信は中身が少しずつ違います。日付で分けて読みます。
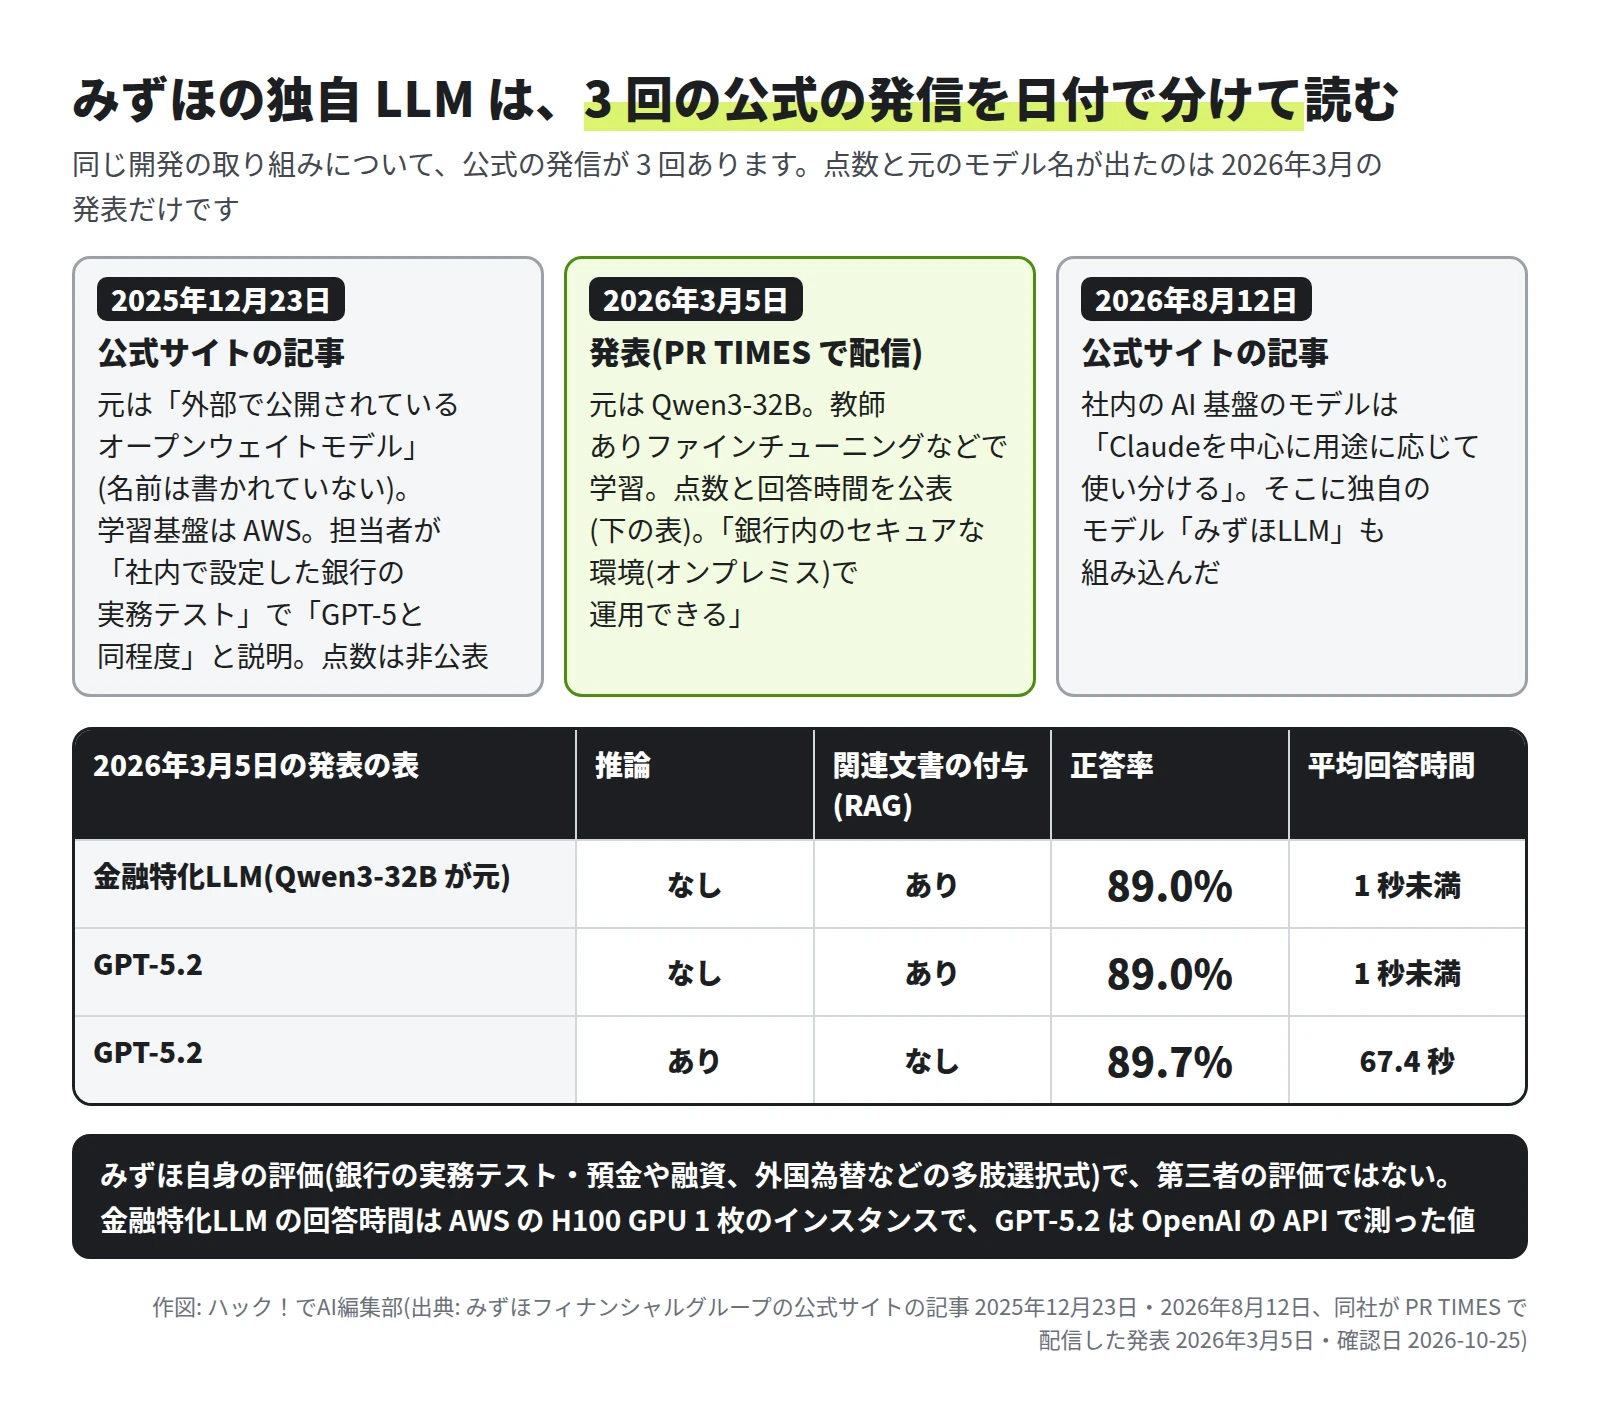
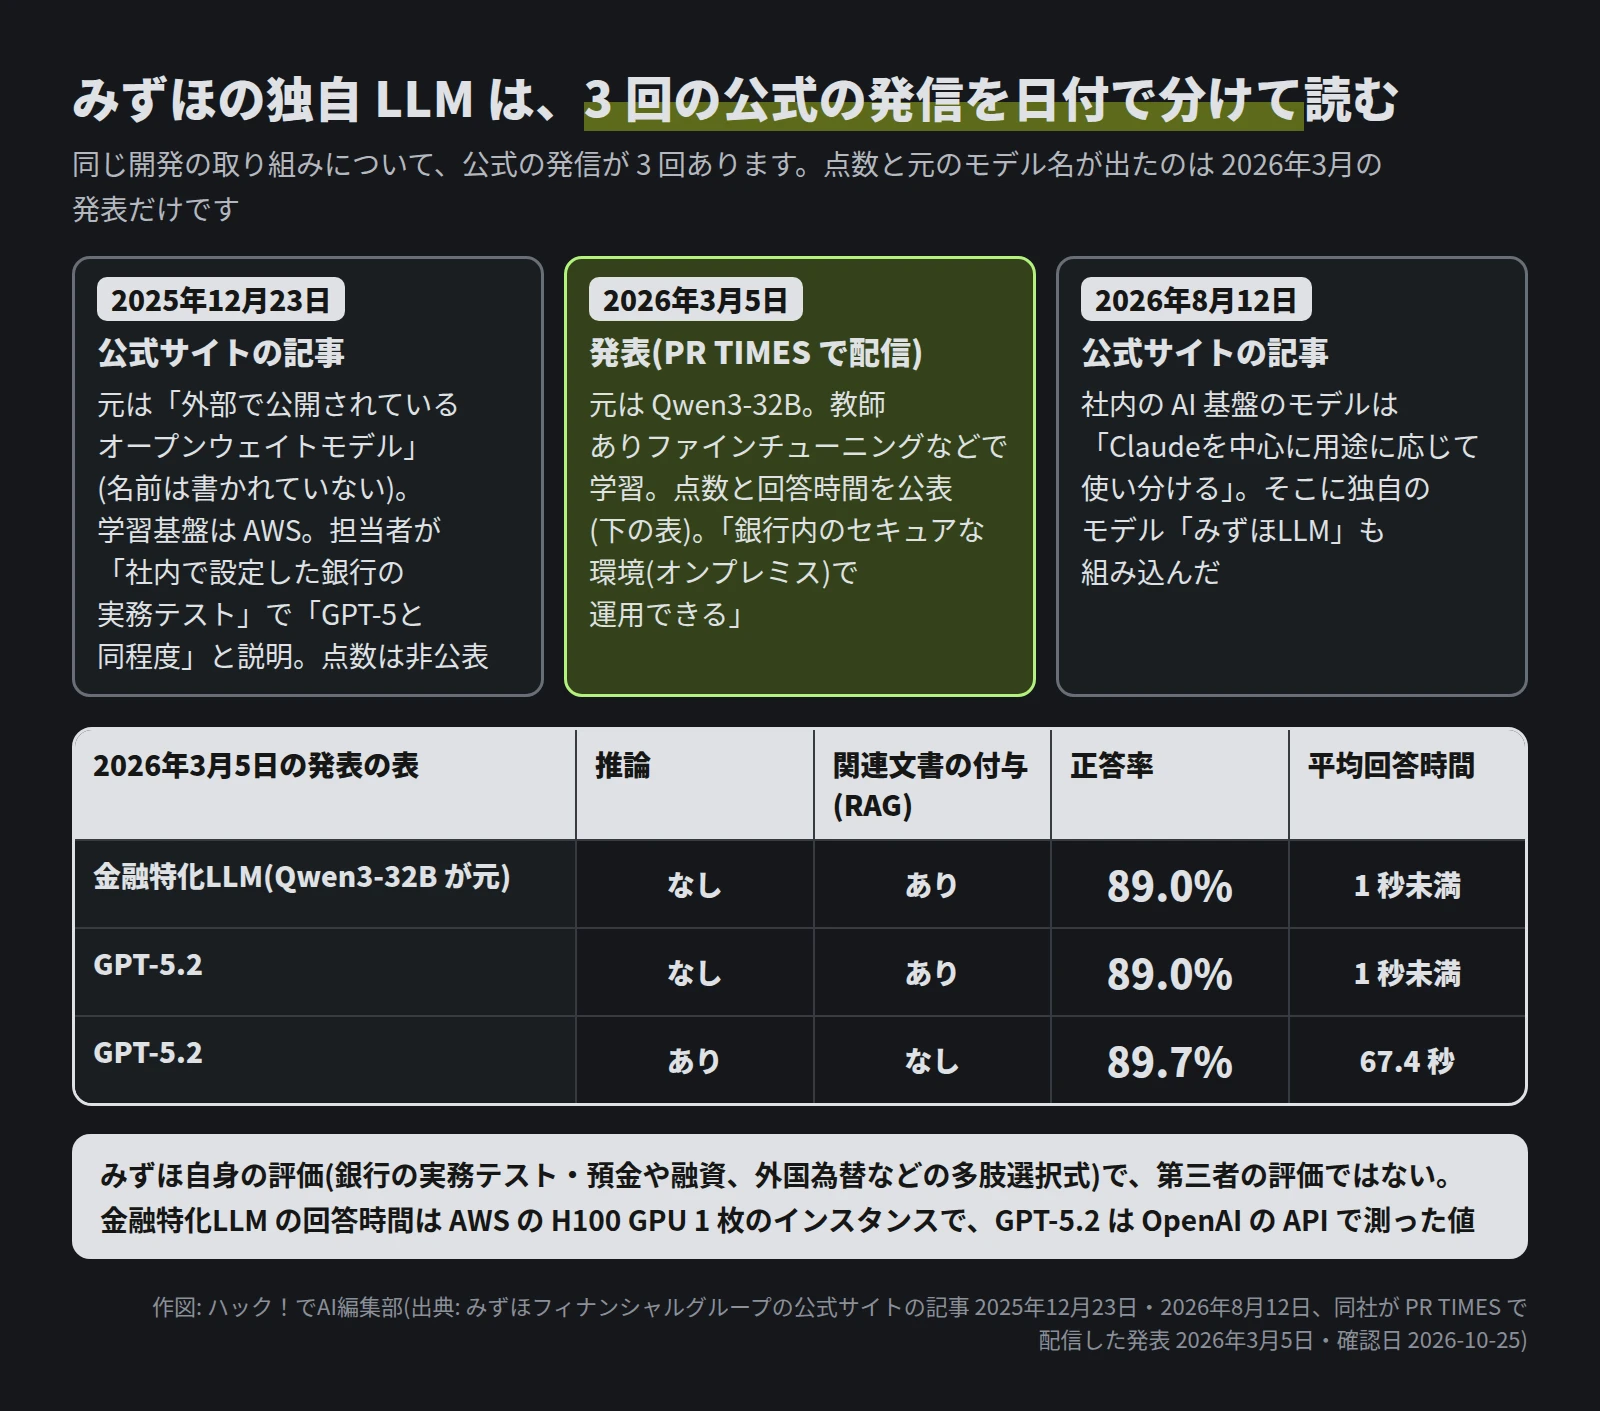
- 2025年12月23日(公式サイトの記事): 土台の「金融特化LLM」は、「外部で公開されているオープンウェイトモデル」が元で、名前と点数は書かれていません。担当者は、社内で設定した銀行の実務テストで「GPT-5と同程度の性能を確認」したと話しています。学習基盤は AWS です。
- 2026年3月5日(PR TIMES で配信した発表): 元のモデルを Qwen3-32B と明記し、教師ありファインチューニング(質問と模範解答の組で追加学習する方法)などで学習したと説明しています。銀行の実務テストで、推論を使わない条件の正答率は 89.0% で、同じ条件の GPT-5.2 と並びました。GPT-5.2 に推論を使わせ、関連文書を添えない設定では 89.7%・平均 67.4 秒です。
- 2026年8月12日(公式サイトの記事): 社内の AI 基盤のモデルは、「Claudeを中心に用途に応じて使い分ける」形です。そこに「みずほLLM」も組み込みました。
12 月の記事で比べた相手は GPT-5、3 月の発表は GPT-5.2 で、別のモデルです。12 月に評価したモデルが 3 月の Qwen3-32B と同じものかは、どちらにも書かれていません。3 月の点数も、みずほ自身の評価です。回答時間は AWS の H100 GPU 1 枚のインスタンスで測った値で、オンプレミスの本番環境の数字ではありません。
3 月の発表に書かれた、自社のモデルを作る理由は、機密性の高いデータを外部の API に送らずに使えること、推論で待たせないこと、汎用のモデルでは前提の解釈が揺れて品質が安定しにくいこと、の 3 つです。8 月の記事と合わせると、海外の会社のモデル(Claude)を中心に使いながら、自社のモデルも並べて育てている姿が見えます。どの仕事にどちらを使うかの線引きは、公表されていません。
金融: 自前の閉域も、海外のクラウドも
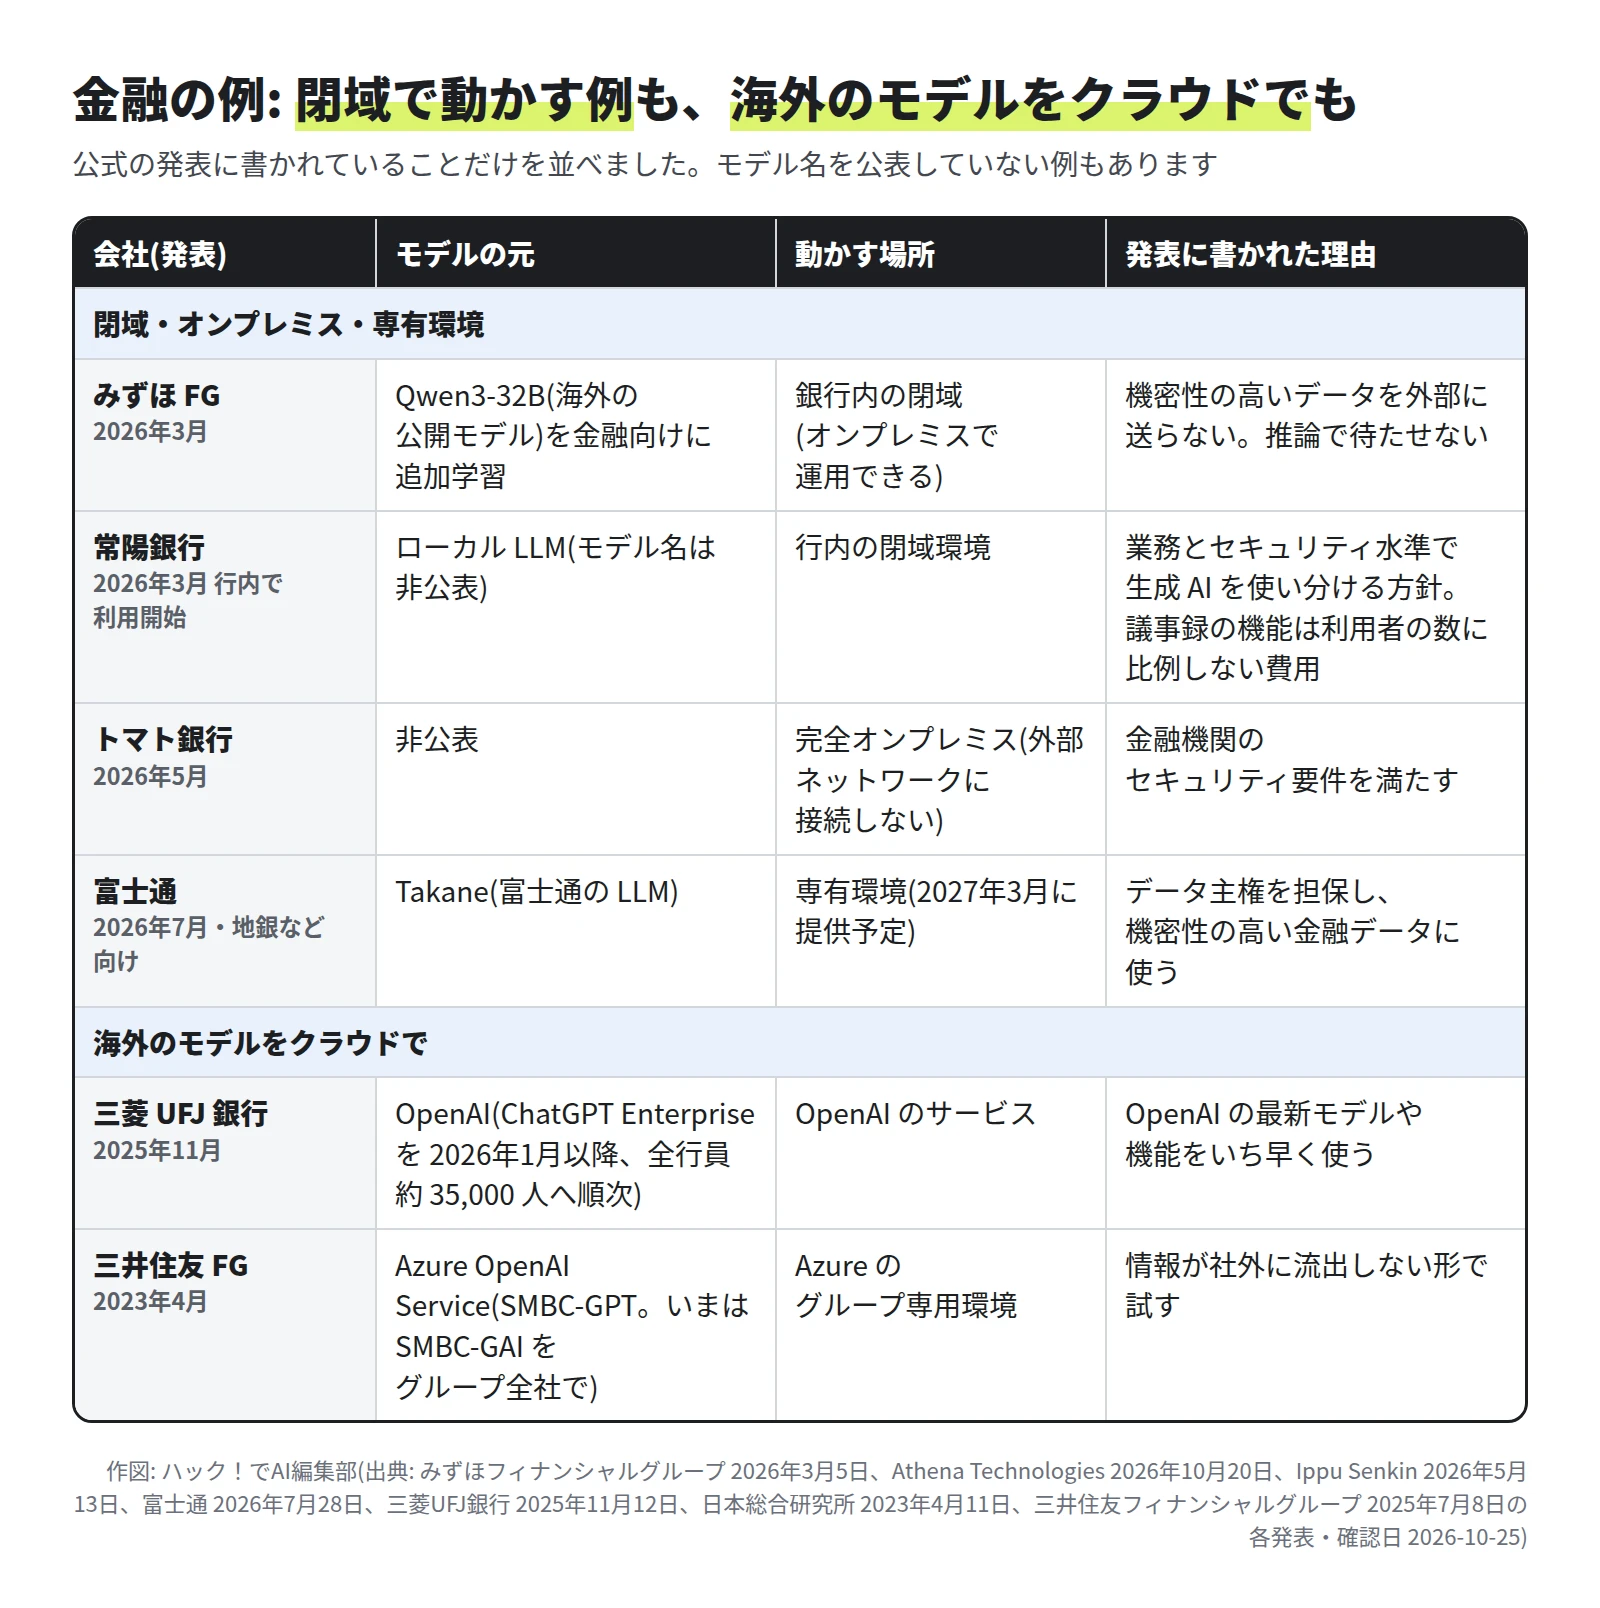
閉域や自前を選んだ例では、常陽銀行が 2026年3月から「JOYO AI AGENT」を使っています。行内の閉域環境で動く、ローカル LLM の基盤です(共同で開発した Athena Technologies の発表)。業務の性質や求められるセキュリティ水準に応じて、生成 AI を使い分ける方針です。2026年10月から使う予定の議事録の機能は、利用者の数が増えても費用が増えない構成にしました。
トマト銀行は 2026年5月から、完全オンプレミスの生成 AI を本部の全役職員で使い始めました。外部ネットワークにはつなぎません(導入した Ippu Senkin の発表)。富士通は、地方銀行などに向けて、自社の LLM「Takane」を専有環境で使う基盤を 2027年3月に提供する予定で、データ主権を担保できる点を打ち出しています。
海外のモデルを大きく使う例もあります。三菱 UFJ 銀行は 2025年11月、OpenAI との契約を発表し、2026年1月以降に全行員約 35,000 人へ ChatGPT Enterprise を順次広げるとしました。利点には、OpenAI の最新のモデルや機能をいち早く使えることを挙げています。
三井住友フィナンシャルグループは 2023年に「SMBC-GPT」の実証を始めました。Microsoft の Azure OpenAI Service をグループ専用の環境で使い、情報が社外に流出しない形にしていました(当時の発表)。その後、グループ全社で使える「SMBC-GAI」を開発・導入しました(2025年7月の発表)。
製造: 国内のモデルを元に育てる例と、海外のクラウドの例
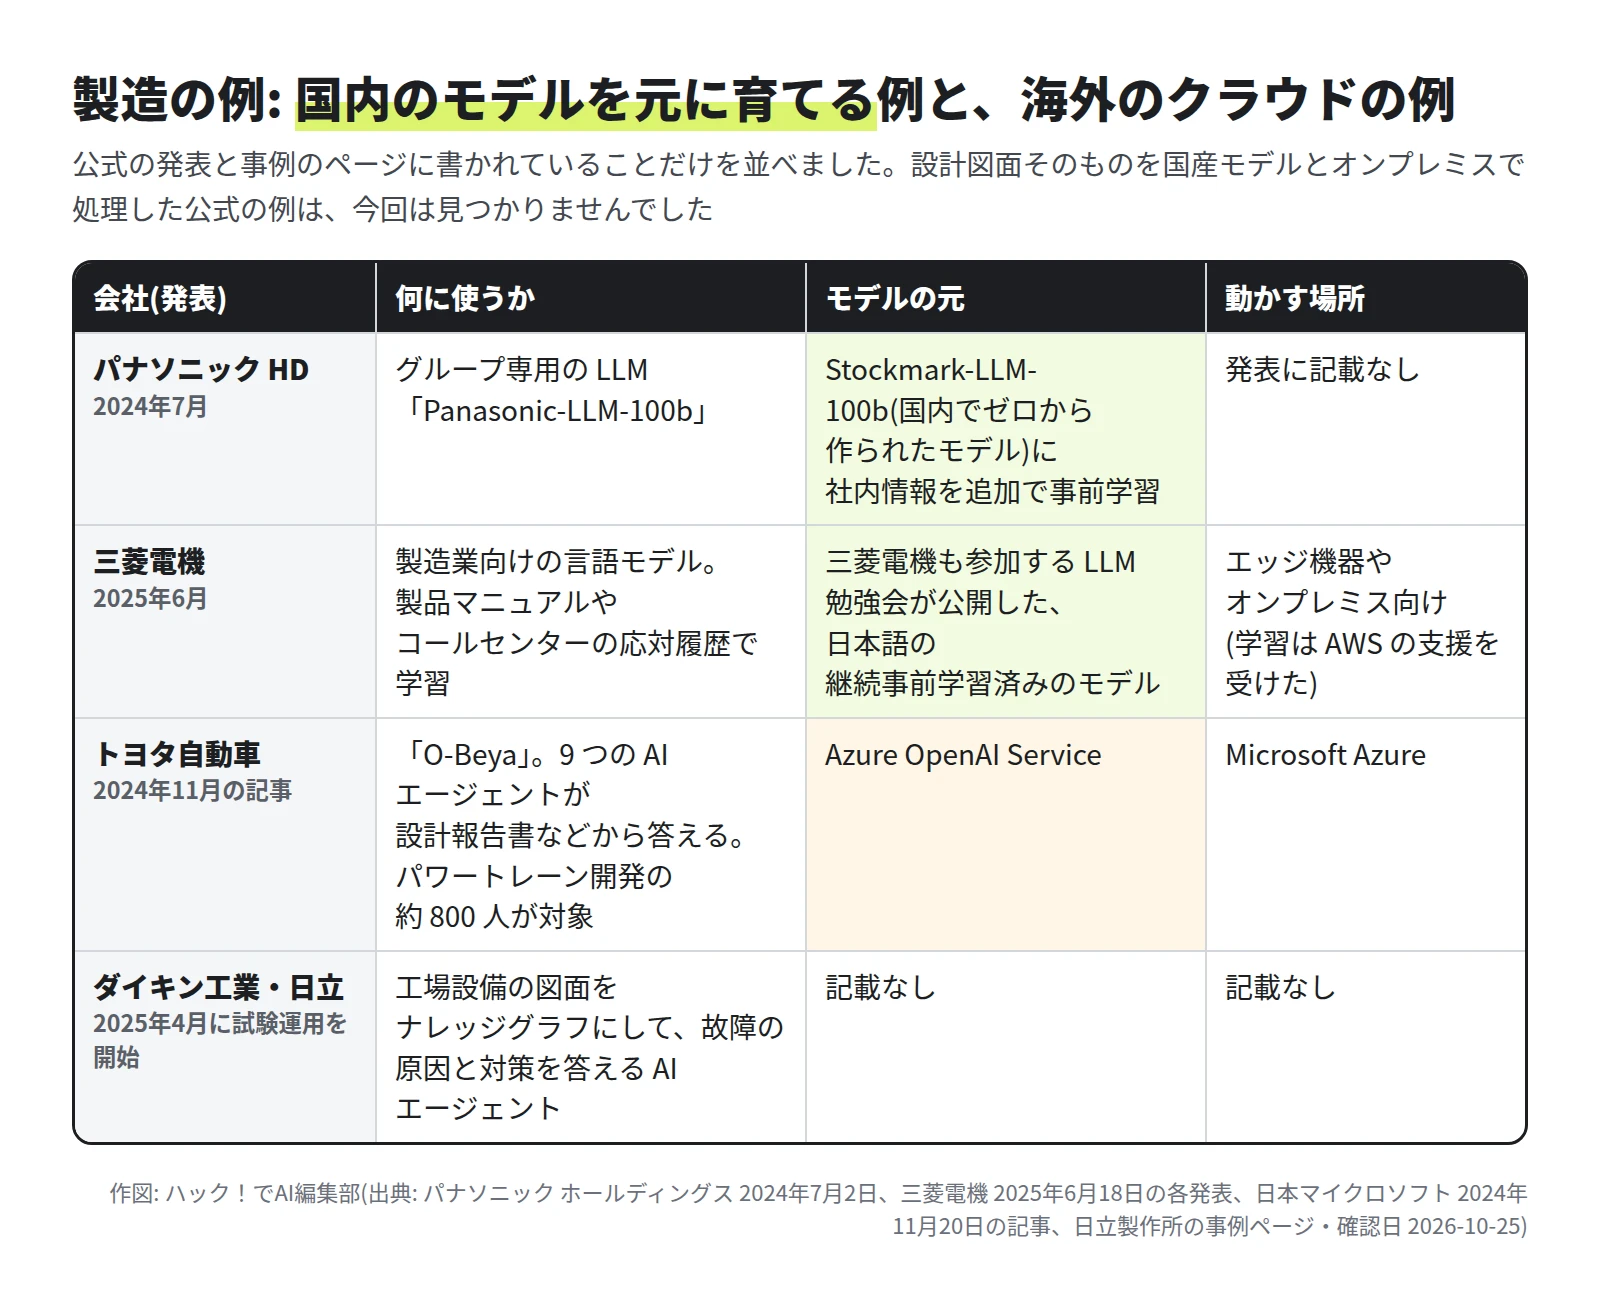
パナソニック ホールディングスは 2024年7月、ストックマークと組んで自社専用の「Panasonic-LLM-100b」を作ると発表しました。ストックマークがゼロから作った Stockmark-LLM-100b に、グループの社内情報を追加で事前学習させます。
三菱電機は 2025年6月、製造業向けの言語モデルを発表しました。元は、同社も参加する LLM 勉強会が公開しているモデルで、日本語の継続事前学習(公開済みのモデルに文章を追加で学ばせること)を済ませたものです。そこに製品マニュアルやコールセンターの応対履歴を学ばせて小さく軽くし、エッジ(工場の機器など現場の端末)や顧客情報を扱うオンプレミスの環境で動かせるようにしました。学習には AWS の支援を受けています。
トヨタ自動車は、Azure OpenAI Service で作った「O-Beya」を、パワートレーン開発の約 800 人が使えるようにしています(Microsoft の 2024年11月の記事)。9 つの AI エージェントが、過去の設計報告書やベテランの手書きの文書をもとに答えます。
ダイキン工業と日立製作所は、工場設備の図面をナレッジグラフ(情報どうしのつながりを表したデータ)にして、故障の原因と対策を答える AI エージェントの試験運用を、2025年4月に始めました。モデル名と置き場所は公表されていません。
設計図面そのものを、国産モデルで、しかもオンプレミスで処理したと公式に発表した例は、今回の調べでは見つかりませんでした。
編集部の見方: 選ぶ軸は「元のモデル」と「動かす場所」
並べてみると、閉域やオンプレミスで動かす例、海外の公開モデルを元に銀行内で運用できるようにした例、国内の会社のモデルを専有環境で使う計画、海外のモデルをクラウドで使う例が、どれも公式に発表されています。みずほのように、1 つの会社の中で自社のモデルと海外のクラウドのモデルを併用する例もあります。公表された理由を比べると、閉域を選んだ側は外にデータを出さないことと費用の形、クラウドを選んだ側は最新の機能をいち早く使えることでした。
金融庁のディスカッションペーパーには、特定のベンダーに頼りすぎないよう、オープンソースの基盤でモデルを作る例や、委託して作ったモデルの知的財産権を自社のものにする契約の例も載っています。モデルの国籍より先に、別のモデルに乗り換えられるか、育てたモデルの権利をだれが持つかを確かめる金融機関もあります。
自社の機密業務を、金融機関の 4 つの段階に当てはめる
金融機関の進め方を並べ直すと、顧客の前に出すまでに 4 つの段階が見えてきます。製造なら、図面や品質記録を社内で要約する段階(1・2)、取引先への回答案を担当者が確かめて出す段階(3)、取引先からの問い合わせに AI が直接答える段階(4)にあたります。
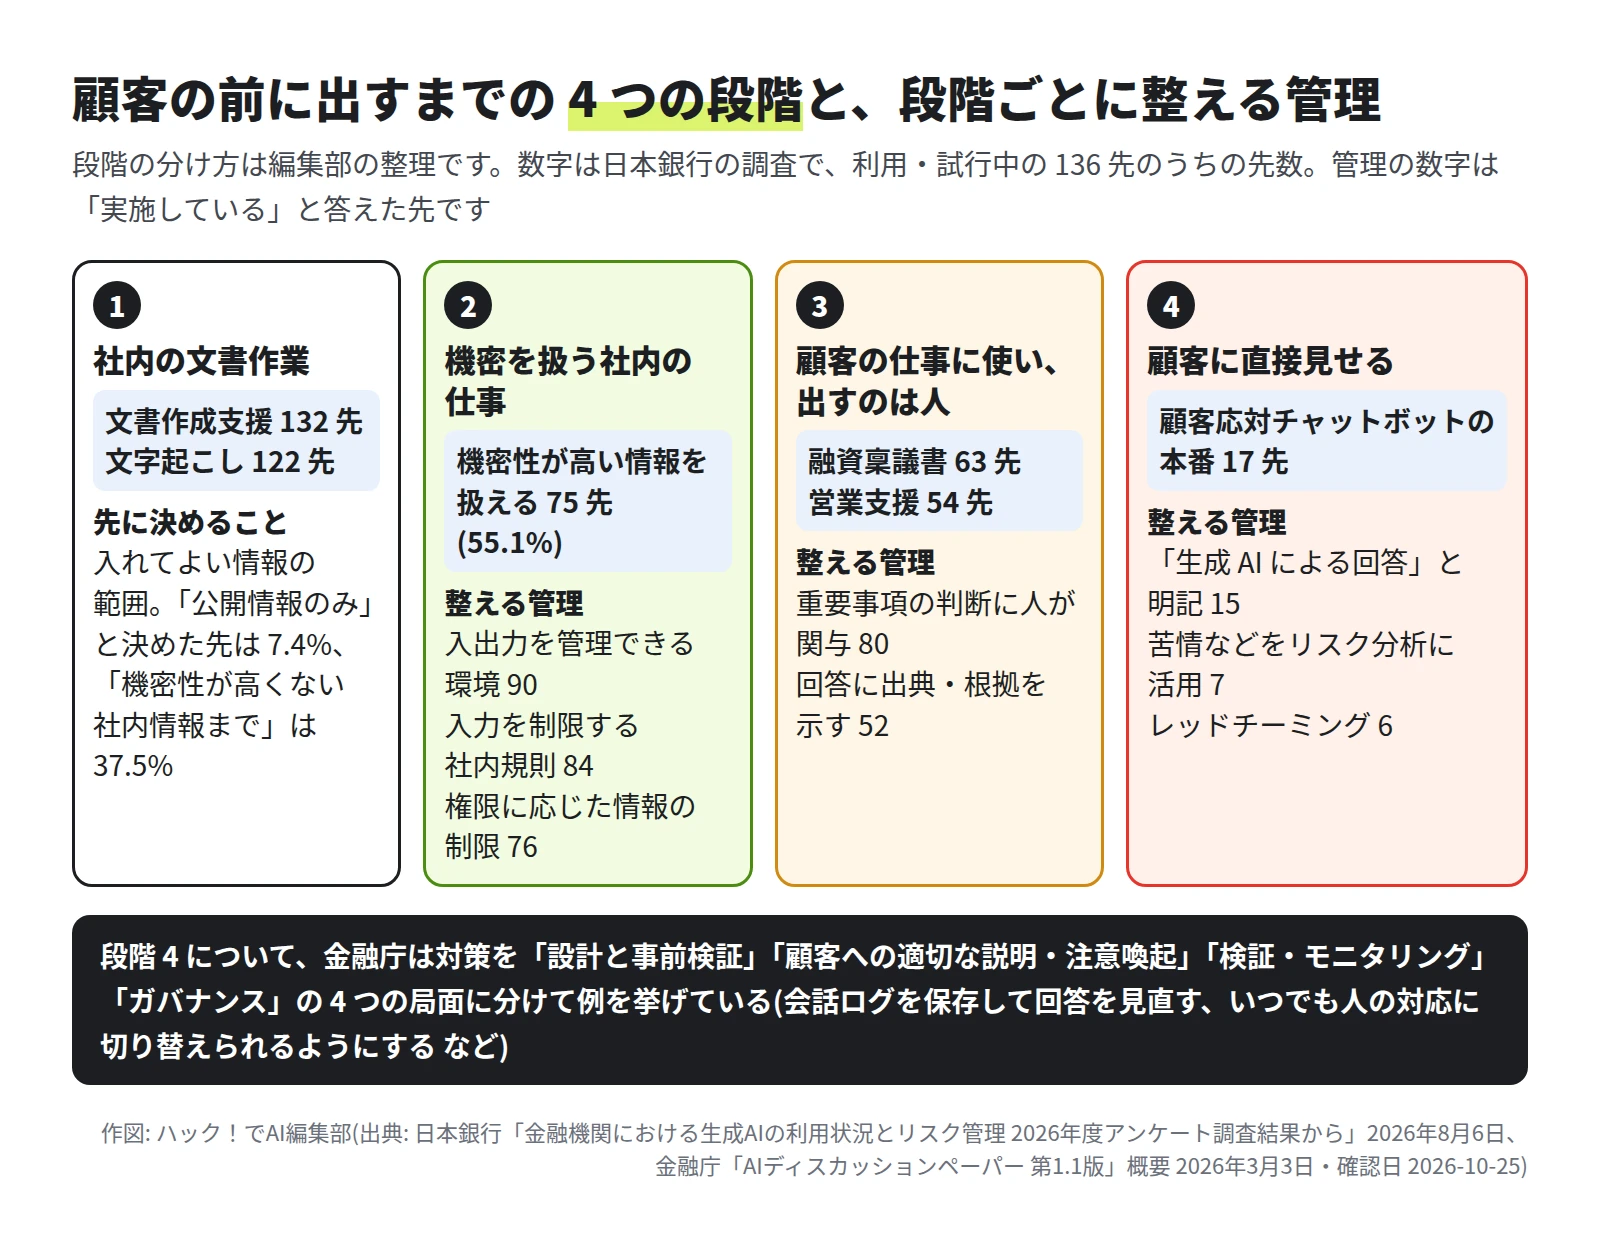
自社に当てはめるときは、次の順で決めていきます。
- 入れてよい情報を 3 つに分ける。日銀は「機密性が高い情報」「機密性が高くない社内情報」「公開情報のみ」の 3 つに分けて聞いています。まず、この 3 つのどこまでを AI に入れてよいかを決めます。法律と契約の面の確かめ方は、個人情報や機密を AI に貼るのは、本当にダメ?にまとめています。
- 機密を入れる前に、3 つの管理をそろえる。入出力を管理できる環境、入力してよい情報の社内規則、利用者の権限に応じた制限です。どれも 136 先のうち 76〜90 先が実施している、20 項目の中でも実施の多い管理です。
- 顧客に関わる仕事は、人が読んでから出す形で始める。答えに出典を示させ、重要な判断は人が下します。
- 顧客に直接見せるときは、範囲を絞る。答える質問の範囲を決め、AI による回答だと伝え、いつでも人に替われるようにします。会話のログを残して答えを見直す仕組みも、このときに用意します。金融庁は、こうした対策を 4 つの局面(設計と事前検証、顧客への適切な説明・注意喚起、検証・モニタリング、ガバナンス)に分けて、例を示しています。
ベンダーの製品を検討するときは、元のモデル、動かす場所、会話の記録の保存先と保存期間の 3 つを確かめます。総務省と経済産業省の AI 事業者ガイドライン(第 1.2 版)も、ログを記録・保存するときは、保存期間などを検討するよう求めています。
慎重さは遅れではなく、順番
冒頭の思い込みに戻ると、日本の金融機関は遅れているのではなく、段階を踏んでいます。9 割強が社内で使うか試し、半数ほどが機密も扱えるようにし、顧客に直接見せるのは一部です。顧客の前に出す段階で要る管理(回答の明記、苦情の分析、レッドチーミング)は、多くの先にとってこれから整える所です。
自社では、まず、いま AI を使っている仕事を 1 つ選び、4 つの段階のどこにあるかを決めます。次に、その段階と次の段階で要る管理のうち、まだ無いものを書き出します。「機密を入れてよいか」を議論する前に、どの段階の話をしているのかをそろえておくと、何を足せばよいかが具体的になります。
次の第 4 回は、機密を扱う生成 AI の構成を 3 つの型に分け、オンプレミスでも安全とは限らない理由を、製造の図面と金融の審査の場面で説明します。
参考にした公式の情報
- 日本銀行「金融機関における生成AIの利用状況とリスク管理 2026年度アンケート調査結果から」(2026年8月6日)
- 日本銀行「金融機関における生成AIの利用状況とリスク管理 2025年度アンケート調査結果から」(2025年9月30日)
- 日本銀行「金融機関における生成AIの利用状況とリスク管理 アンケート調査結果から」(2024年10月)
- 金融庁「AIディスカッションペーパー(第1.1版)」(2026年3月3日)
- 総務省「令和8年版 情報通信白書」生成AIの業務利用(2026年7月24日)
- 総務省「令和8年版 情報通信白書」付注(調査の概要)
- 帝国データバンク「生成AIに関する企業の動向調査(2026年3月)」(2026年5月14日)
- IPA「DX動向2026」
- 日本情報システム・ユーザー協会「企業IT動向調査報告書2026」
- 総務省「AI事業者ガイドライン(第1.2版)」
- みずほフィナンシャルグループ「『みずほLLM』開発プロジェクトが進行中。」(2025年12月23日)
- みずほフィナンシャルグループ「金融特化LLMで“推論に依存しない”『高精度』と『即答性』を両立」(PR TIMES・2026年3月5日)
- みずほフィナンシャルグループ「AWS Summit Japan 2026 講演レポート」(2026年8月12日)
- Hugging Face「Qwen/Qwen3-32B」(モデルカード)
- 日本総合研究所「SMBC AI オペレーター」の発表(2026年2月18日)
- 日本総合研究所「SMBC-GPT」の実証の発表(2023年4月11日)
- 三井住友フィナンシャルグループ ニュースリリース(2025年7月8日)
- 三菱UFJ銀行「OpenAIとの戦略的コラボレーション」(2025年11月12日)
- Athena Technologies「常陽銀行のローカルLLM基盤『JOYO AI AGENT』の機能拡充を支援」(PR TIMES・2026年10月20日)
- Ippu Senkin「トマト銀行に完全オンプレミス型生成AI『Local-Chat AI』を導入」(PR TIMES・2026年5月13日)
- 富士通「金融機関向けに専有型AIプラットフォームの開発を開始」(2026年7月28日)
- 日本マイクロソフト「トヨタ、AI エージェントでエンジニアの知恵を結集」(2024年11月20日)
- パナソニック ホールディングス「Panasonic-LLM-100b」の発表(2024年7月2日)
- 三菱電機「エッジデバイスで動作する製造業向け言語モデルを開発」(2025年6月18日)
- 日立製作所 事例「ダイキン工業 設備故障診断のAIエージェント」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。