 連載・極める生成AIの品質を突き詰める#3/ 全3回
画像生成で同じ顔・同じキャラを保つ 参照画像・LoRA・IP-Adapter を比べた
 佐々木 航
この記事でわかること
- 参照の画像・LoRA・IP-Adapter で、顔の近さと場面を守れた数
- IP-Adapter の重みと、LoRA の学習の画像で起きたこと
- 1 キャラ 100 枚の費用と、ComfyUI のノードの設定
確認した環境: YOBITSUGI AI で各モデルを実行・SDXL base 1.0 と ComfyUI 0.39.0 は RTX 5060 Ti 8GB で実行 / 2026年10月15日に確認
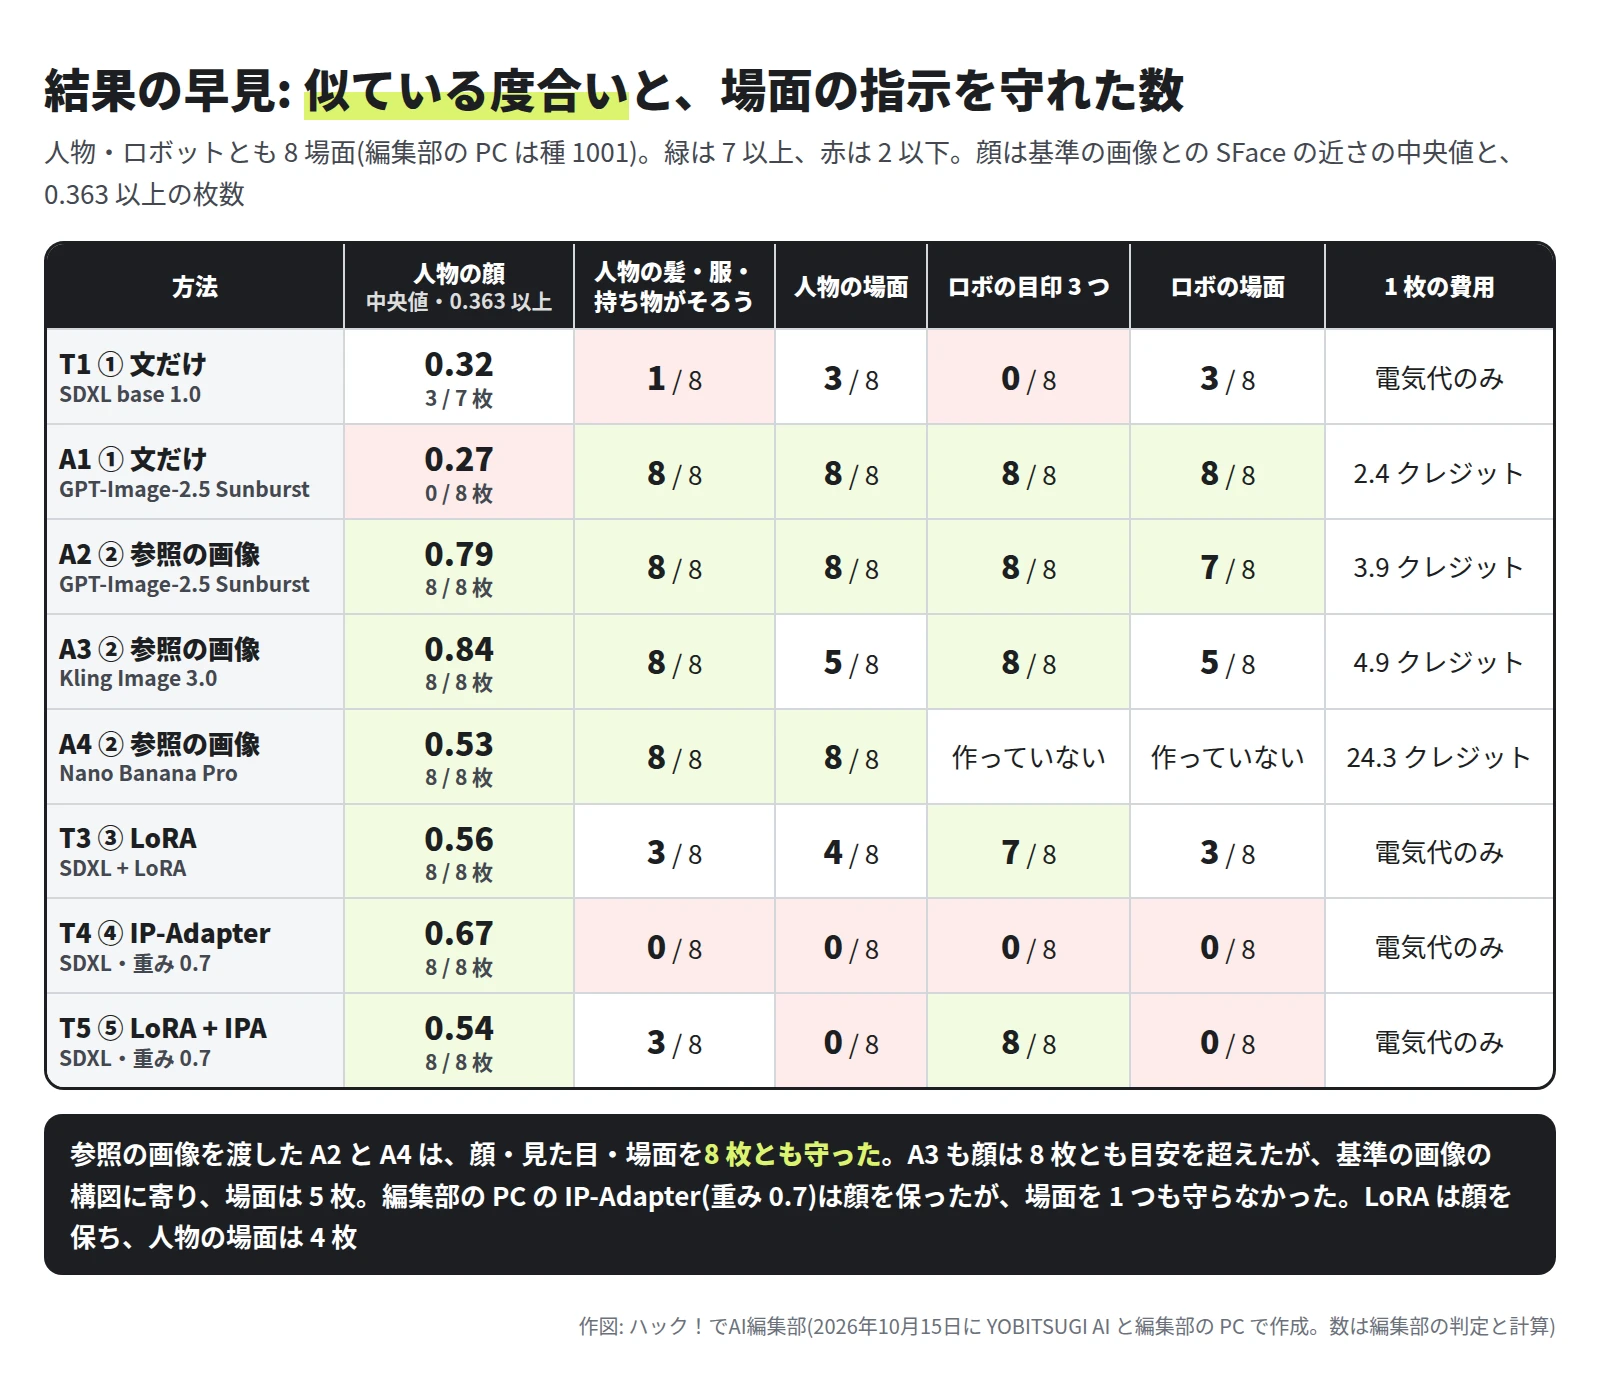
画像生成で同じ顔・同じキャラを保つ方法を、架空の人物とロボットの 8 場面で比べました。今回いちばん安定したのは、基準の画像を 1 枚渡す API の方法です。GPT-Image-2.5 Sunburst は 1 枚 3.9 クレジットで、8 枚とも顔の近さが同じ人の目安を超え、服と持ち物と場面の指示も 8 枚とも守りました。編集部の PC の SDXL では、IP-Adapter は顔を保つかわりに場面をまったく変えられず、LoRA は顔を保って人物の場面を半分守りましたが、学習の画像の向きと服に引っぱられました。
結果の早見
比べ方
キャラ 2 人と基準の画像
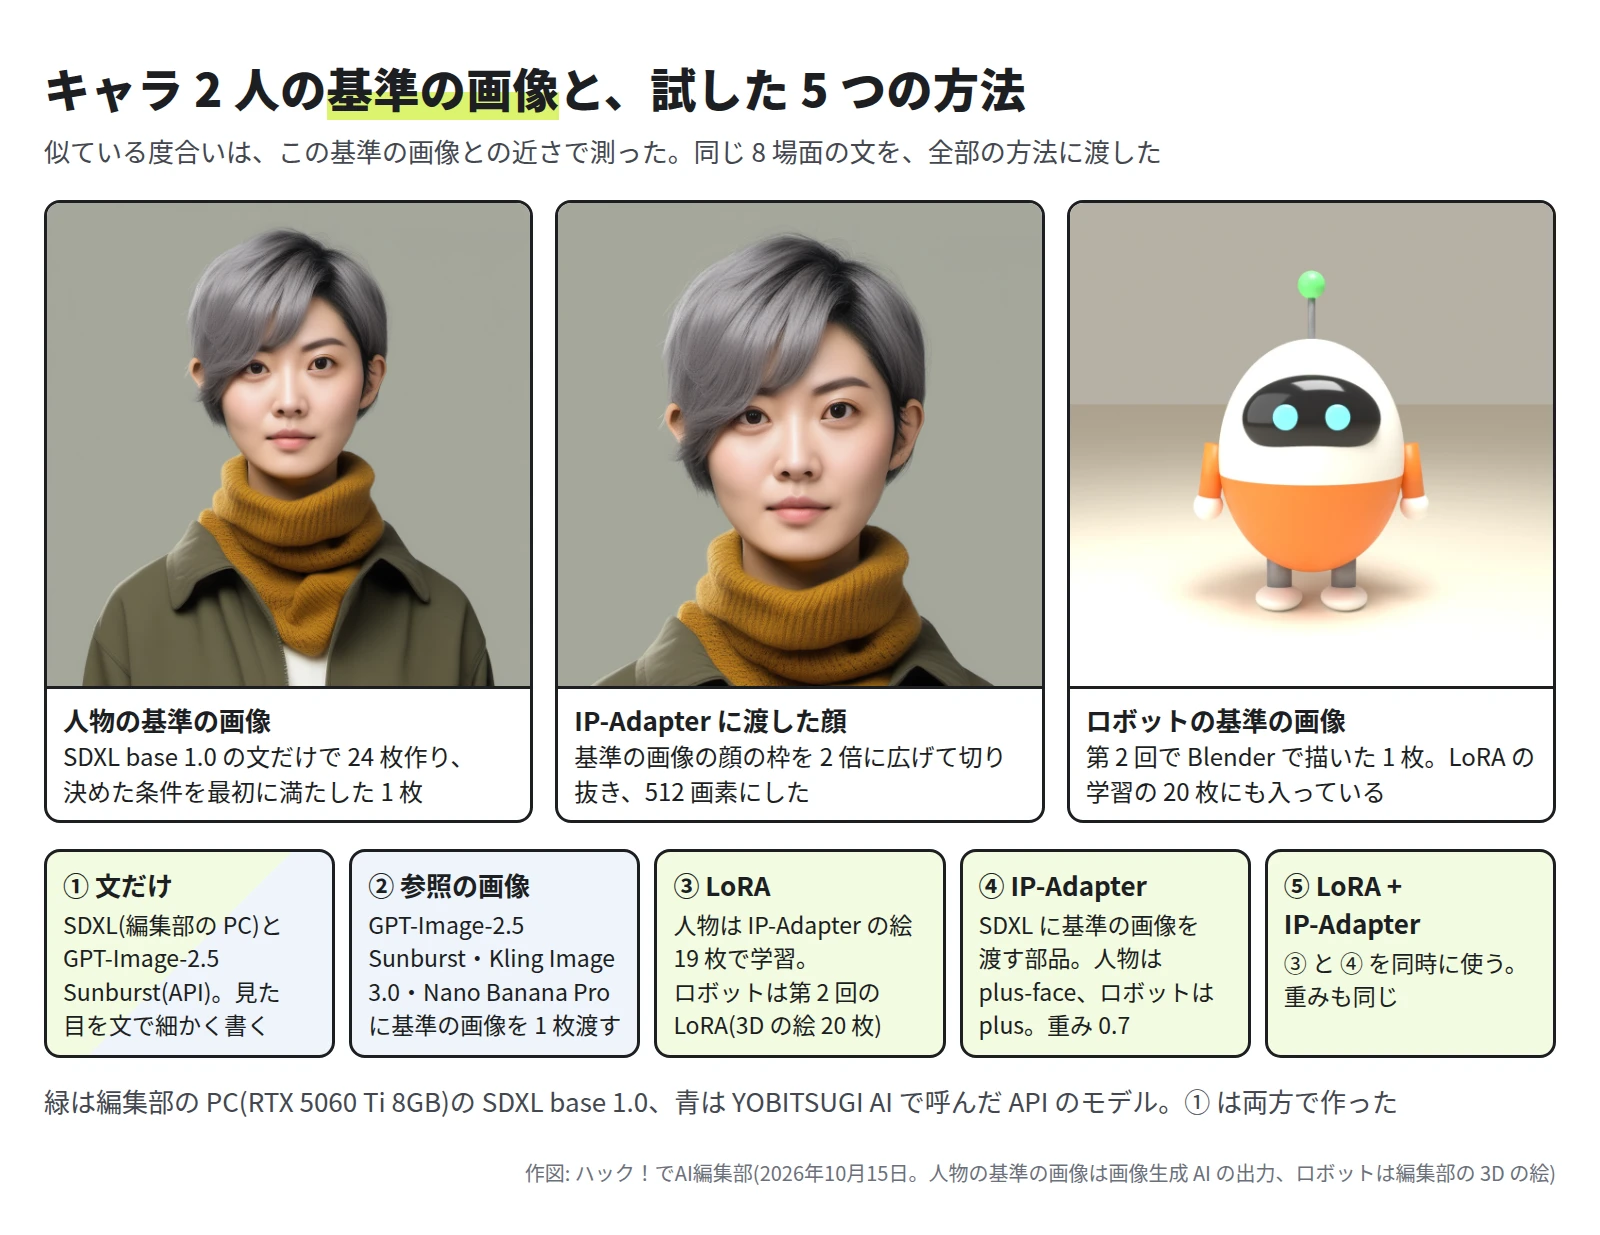
- 人物: 架空の 30 代前半の女性です。灰色のベリーショート、深緑の上着と白い T シャツ、からし色のマフラーを文で決めました。基準の画像は、編集部の PC の SDXL base 1.0 で文だけで 24 枚作り、決めた条件(髪・服・マフラーがそろい、顔が見つかり、崩れが無い)を最初に満たした 1 枚です。
- ロボット: 連載「AI技術大全」のLoRA の作り方 8GB の GPU で画像の LoRA を学習し、枚数と時間を測ったで、編集部が Blender で組んだ hdabot の正面の 1 枚です。LoRA の学習の 20 枚にも入っています。
- LoRA の学習には、編集部の PC で作った絵だけを使いました。各社の API で作った画像は使っていません。
8 つの場面
| 場面 | 人物に頼んだこと | ロボットに頼んだこと |
|---|---|---|
| S1 正面 | 上半身・無表情・明るい灰色の無地の背景 | 全身・立つ・同じ背景 |
| S2 横向き | 右を向く・昼の公園 | 右を向く・昼の公園 |
| S3 振り返り | 後ろから見て、肩越しに振り返る・夕方の歩道 | 後ろから見て、頭をこちらに向ける・夕方の歩道 |
| S4 寄り | 顔の寄り・口を開けて笑う・暖かい室内の光 | 頭と画面の寄り・楽しそうに首をかしげる |
| S5 カフェ | 木の机に座り、驚いた顔で白いカップを持つ | 木の机に座り、白いカップを持つ |
| S6 服を替える | いつもの服でなく、黒いスーツと白いシャツ・マフラーなし・オフィス | 赤いニットのマフラーを巻く・オフィス |
| S7 遠景 | 全身が小さく写る・夕日の浜を歩く | 同じ |
| S8 雨と傘 | 夜の雨の街で赤い傘を持つ・ネオン | 同じ |
文はすべて英語で、全部の方法に同じ文を渡しました(全文は記事の最後)。
方法と作った枚数
| 記号 | 方法 | モデル(記録に残った名前) | 人物 | ロボット |
|---|---|---|---|---|
| T1 | ① 文だけ | SDXL base 1.0(編集部の PC) | 8 | 8 |
| A1 | ① 文だけ | GPT-Image-2.5 Sunburst(gpt-image-2.5-sunburst) | 8 | 8 |
| A2 | ② 参照の画像 | GPT-Image-2.5 Sunburst(gpt-image-2.5-sunburst) | 8 | 8 |
| A3 | ② 参照の画像 | Kling Image 3.0(kling-v3) | 8 | 8 |
| A4 | ② 参照の画像 | Nano Banana Pro(gemini-3-pro-image) | 8 | 作っていない |
| T3 | ③ LoRA | SDXL base 1.0 + LoRA(重み 1.0) | 8 | 8 |
| T4 | ④ IP-Adapter | SDXL base 1.0 + IP-Adapter(重み 0.7) | 8 | 8 |
| T5 | ⑤ LoRA + IP-Adapter | T3 と T4 を両方 | 8 | 8 |
- API は 1 場面 1 枚です。Nano Banana Pro は 1 枚 24.3 クレジットなので、予算(400 クレジット)に収めるため人物だけにしました。Runway Gen-4 Image と Nano Banana 2.1 は、今回は作っていません。
- LoRA は、元の重みを固定して細い行列だけを学習する方法です(Hu ほか, 2021。仕組みは第 2 回)。IP-Adapter は、Ye ほかが 2023年に発表した、参照の画像を文とは別の注意の層で読ませる部品で、論文では学習する数値が 2,200 万個とされています。
- 編集部の PC の方法は、比べの主を種 1001 の 8 枚とし、種 1002・1003 の 16 枚は計算の数だけで見ました。IP-Adapter は重み 0.4 と 1.0 も作りました。
数え方
数える物は、絵を作る前に決めました。
- 人物の顔の近さ: OpenCV の YuNet(MIT ライセンス)で顔を探し、顔を見分ける SFace(Apache-2.0)で基準の顔との近さ(1 に近いほど似ている)を出しました。OpenCV の見本の台本(face_detect.py)は、この近さが 0.363 以上なら同じ人とみなすので、「同じ人の目安」として使います。ただし、超えても同じ人とは言い切れません。生成した絵に向けた値ではなく、今回も文だけの SDXL で、別の人に見える絵が超えました(後の節)。
- ロボットの近さ: OWLv2(Apache-2.0)でロボットを切り抜き、DINOv2(Apache-2.0)の画像の特徴の近さを出しました。人物の顔でも、DINOv2 の近さを 2 つめの物差しとして出しています。
- 目で数えた物: 人物は髪・服・持ち物(マフラー・S5 のカップ・S8 の傘)・場面・崩れ。ロボットは第 2 回と同じ目印 3 つ(①白とだいだい色のたまご形 ②黒い画面に水色の丸い目 2 つ ③先が緑の玉のアンテナ)と、持ち物・場面・崩れです。数えたのは編集部(Claude Code を使用)です。
方法ごとの結果
参照の画像を渡す(A2・A3・A4)と、文だけ(A1)
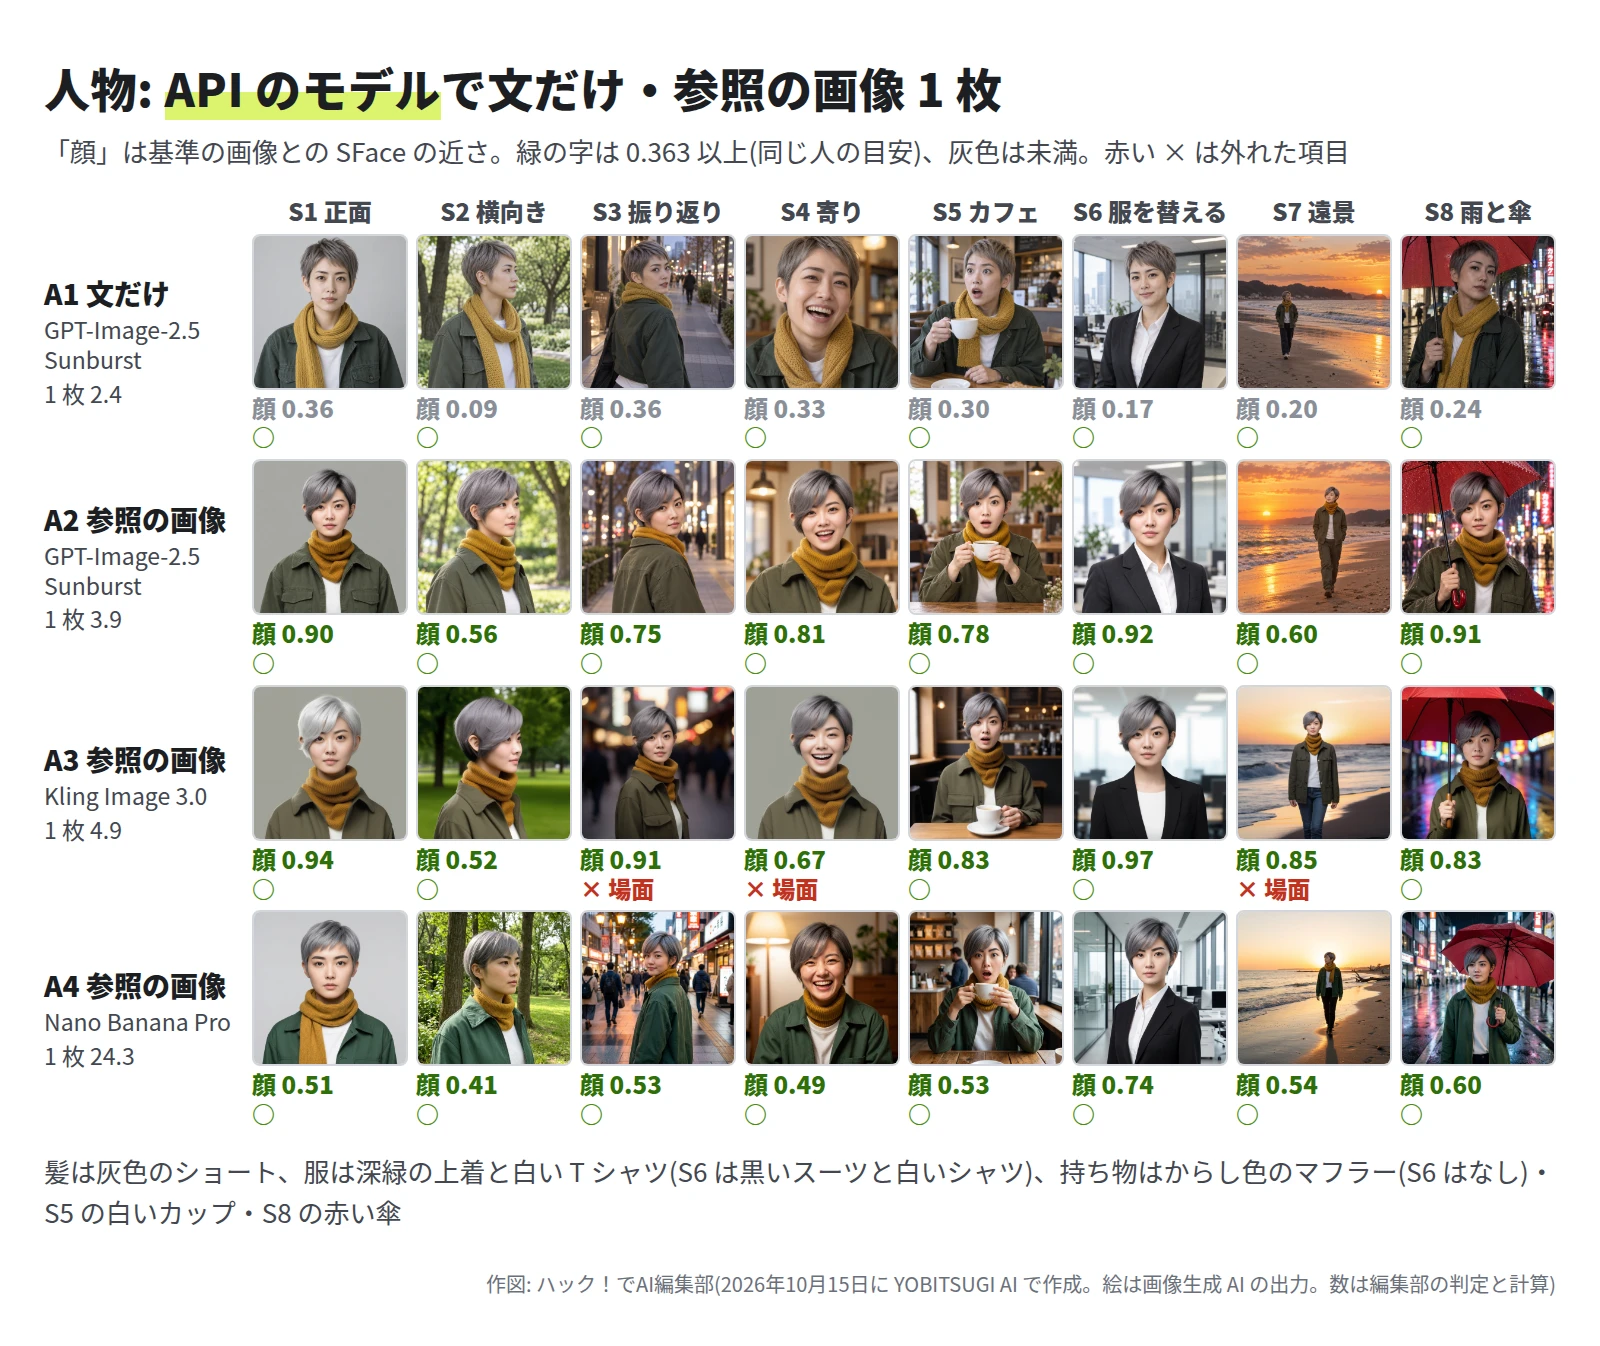
- A2 GPT-Image-2.5 Sunburst: 顔の近さは 0.56〜0.92(中央値 0.79)で、8 枚とも目安を超え、髪・服・持ち物・場面も 8 枚ともそろいました。S6 は黒いスーツに替わり、マフラーも外れました。
- A3 Kling Image 3.0: 顔の近さは 0.52〜0.97(中央値 0.84)で、8 枚とも目安を超えました。場面は 8 枚中 5 枚で、S3 は振り返らず、S4 は背景が無地、S7 は遠景になりませんでした。
- A4 Nano Banana Pro: 顔の近さは 0.41〜0.74(中央値 0.53)で、8 枚とも目安を超えましたが、A2・A3 より低めでした。見た目と場面は 8 枚ともそろいました。前髪が短く眉が太めの絵があり、A2 より基準の人から離れて見えました(編集部の見立て)。
- A1 文だけ: 見た目と場面は 8 枚ともそろいましたが、顔の近さは 0.09〜0.36 で、8 枚とも目安に届きませんでした。基準の画像を見ていないので、別の人の顔です。一方、8 枚の顔どうしの近さは中央値 0.54 で、28 組中 22 組が目安を超えました(計画の後で足した数)。
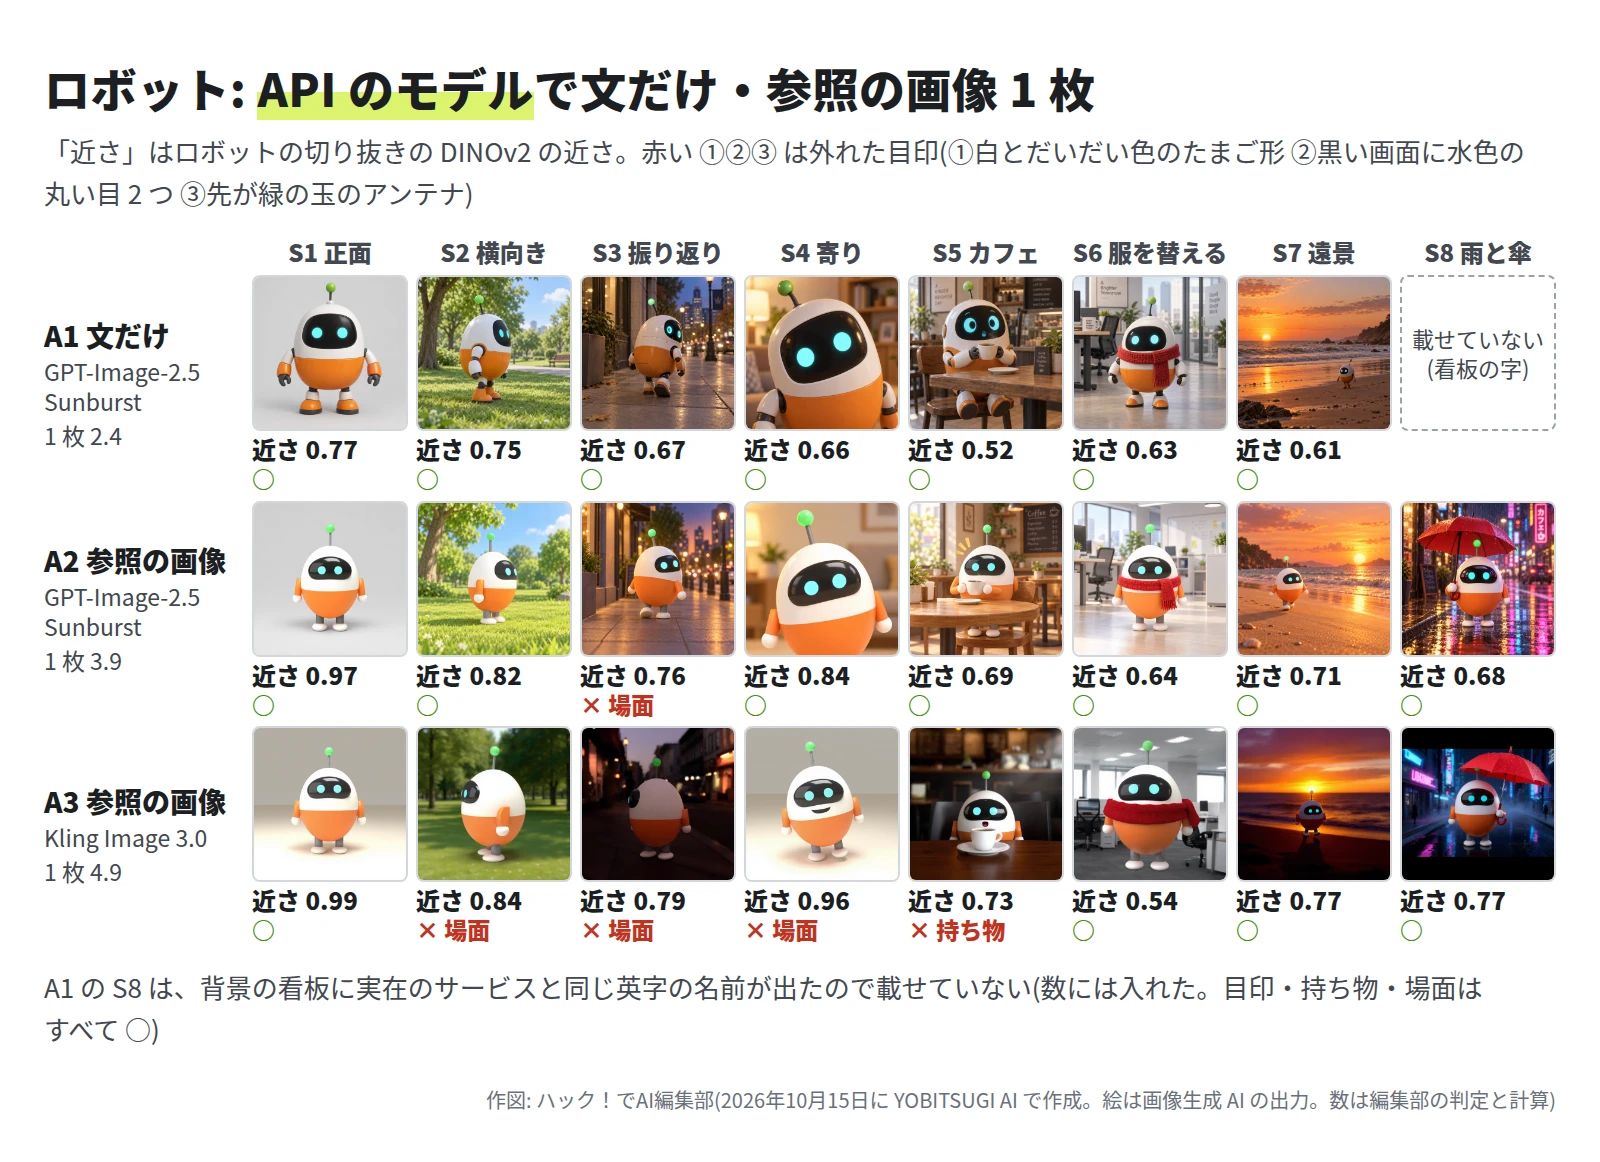
- ロボットは 3 つとも、目印 3 つが 8 枚すべてにそろいました。文で書くだけで伝わる単純な形だったためと見ています。ただし文だけ(A1)は、黒い手やだいだい色の足が付き、目印に入れていない所で別のロボットになりました。
- 場面は A1 が 8 枚、A2 が 7 枚、A3 が 5 枚でした。A3 は人物と同じく、基準の画像の正面の構図に寄りました。
編集部の PC: 文だけ・LoRA・IP-Adapter(T1・T3・T4・T5)
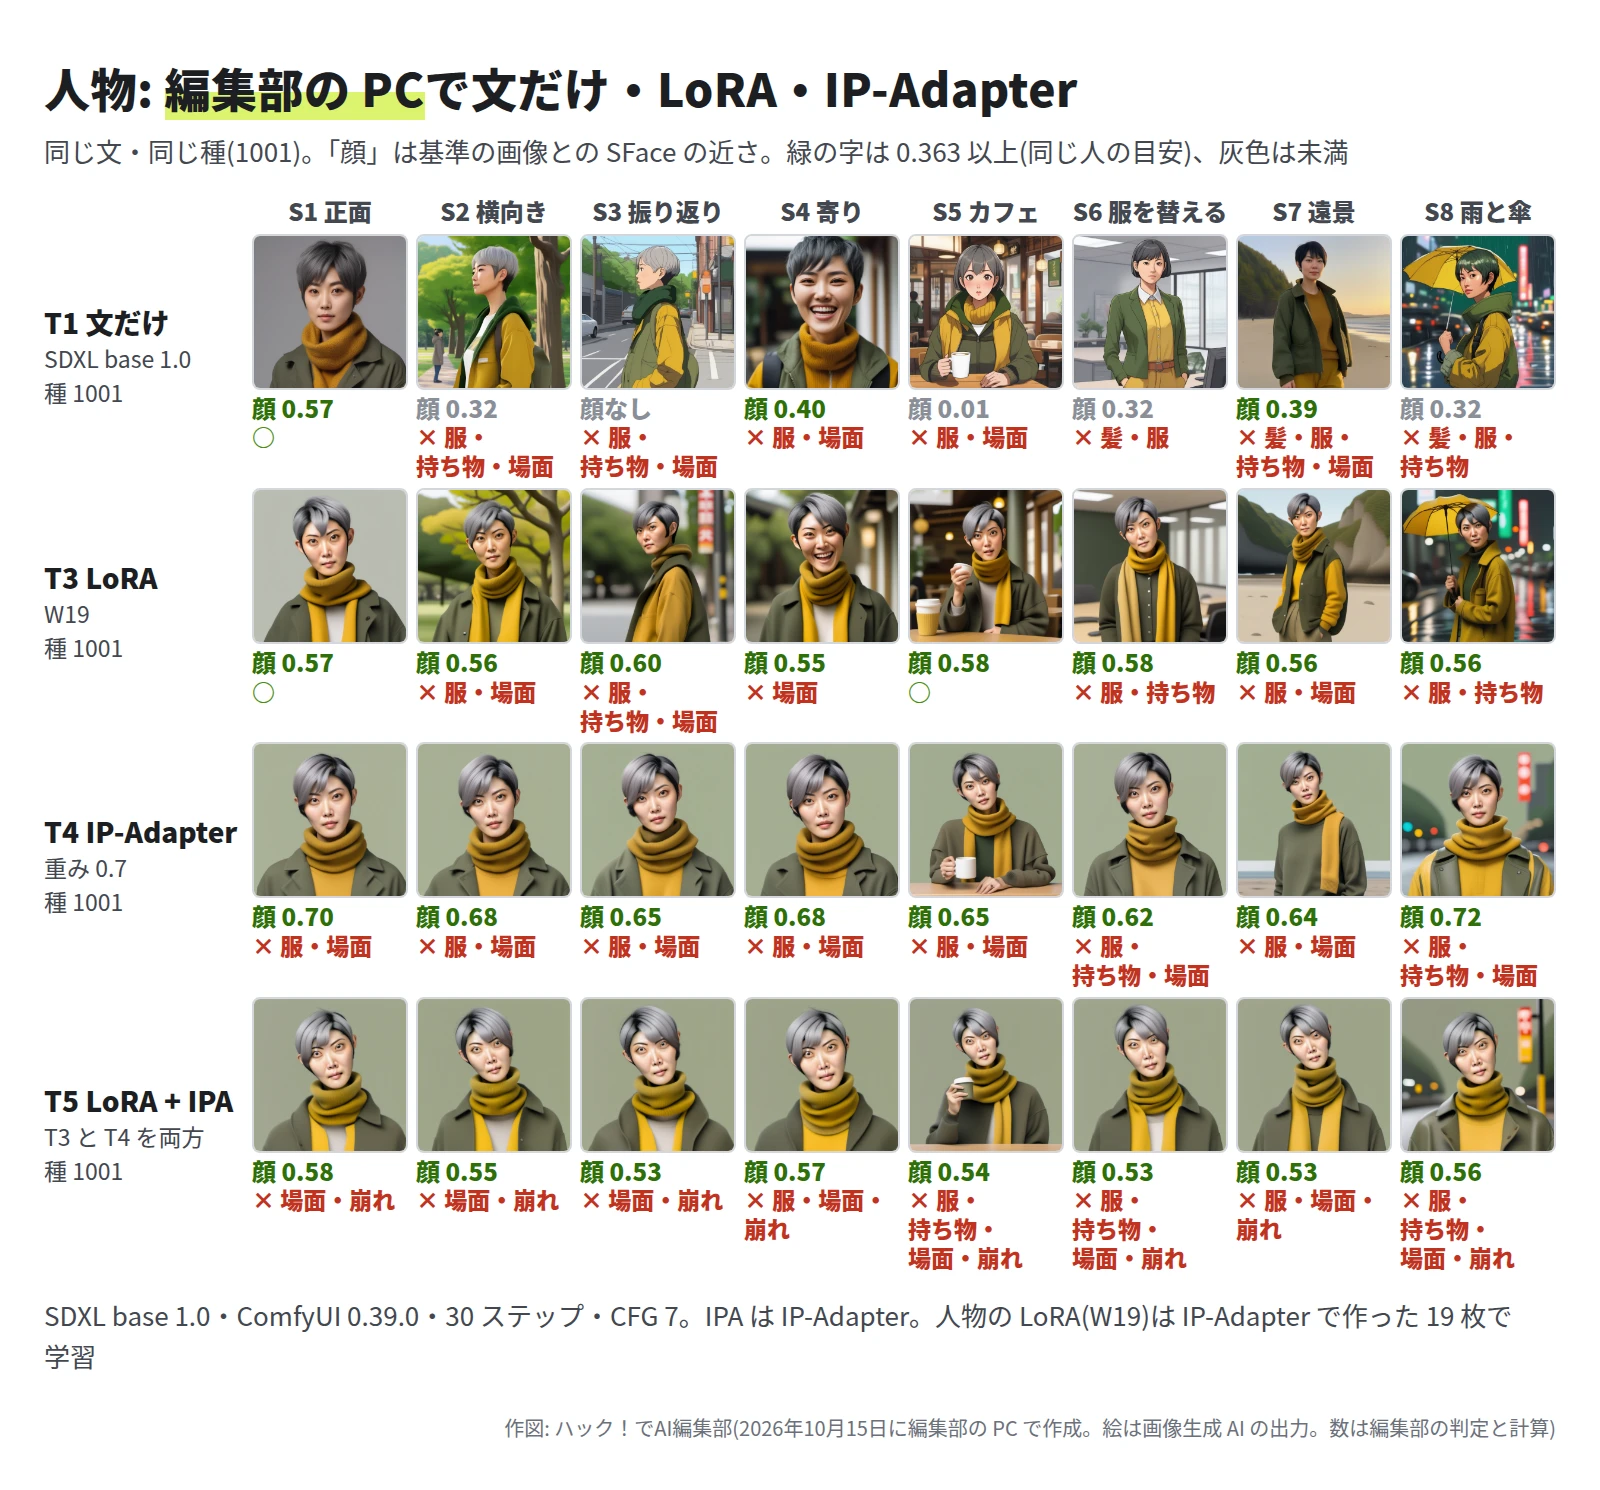
- T1 文だけ(SDXL base 1.0): 8 枚中 5 枚が、頼んでいないアニメ調になりました。髪が黒や緑の絵が 3 枚あり、髪・服・持ち物がそろったのは 1 枚、場面を守れたのは 3 枚です。顔の近さは中央値 0.32 で、目安を超えたのは 3 枚でした。
- T3 LoRA(W19): 顔の近さは 0.55〜0.60 で、8 枚とも目安を超えました。背景は公園・カフェ・オフィス・雨の街など、文に沿って変わりました。ただし向きはほぼ正面のままで、場面を守れたのは 4 枚、髪・服・持ち物がそろったのは 3 枚です。スーツに替わらず、傘は黄色でした。学習の 19 枚がすべて正面・同じ服だった偏りが出たと見ています(編集部の見立て)。
- T4 IP-Adapter(重み 0.7): 顔の近さは 0.62〜0.72 で 8 枚とも目安を超えましたが、8 枚とも基準の画像と同じ正面の上半身と灰緑の背景になり、場面は 1 つも守れませんでした。スーツも傘も出ず、上着の下の服は、多くがからし色でした。
- T5 LoRA + IP-Adapter: 8 枚とも基準の画像と同じ構図になり、場面は 0 枚でした。目が大きく顔の形がゆがみ、8 枚とも崩れに数えました。
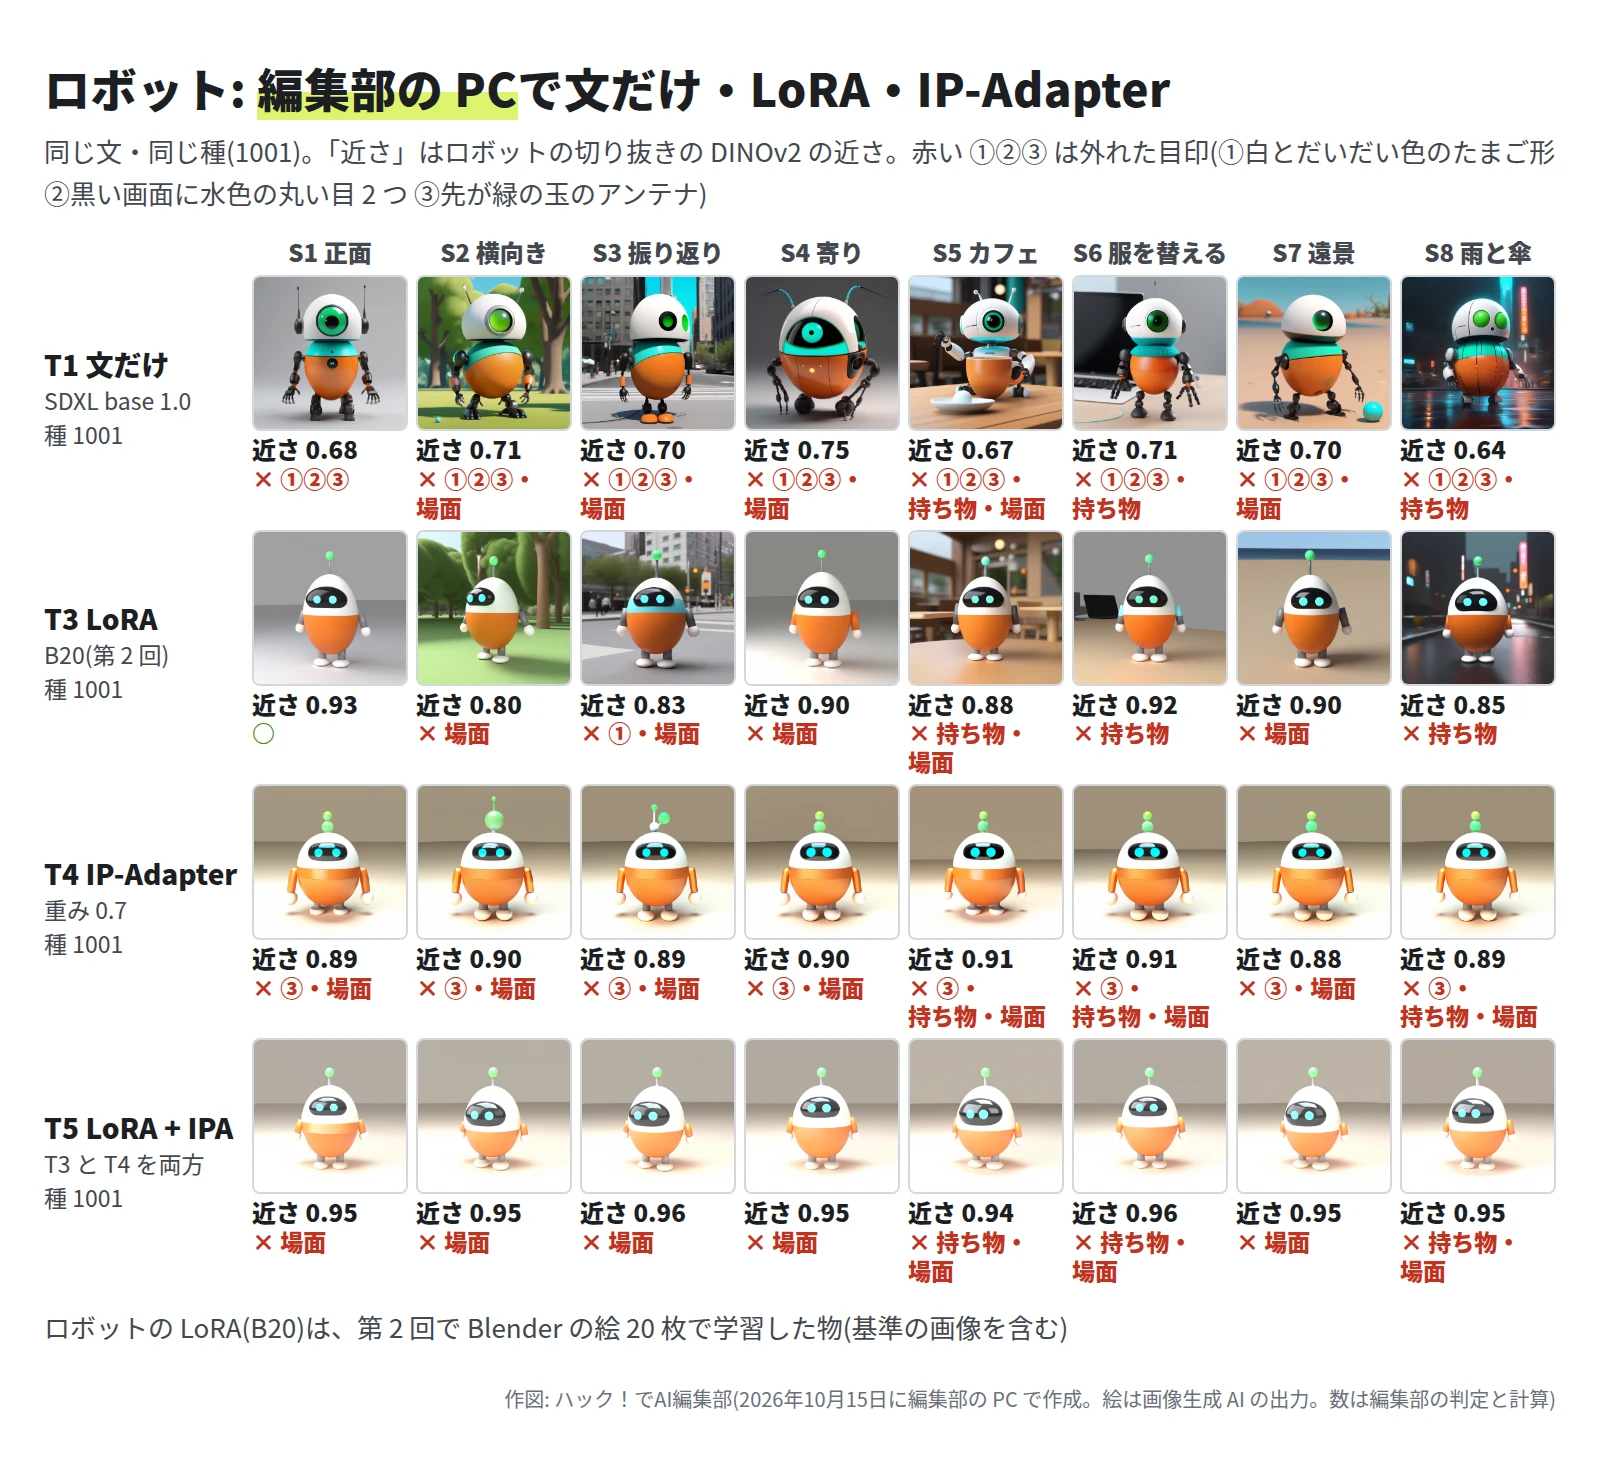
- T1 と T4: T1 は緑の大きな目が 1 つのロボットなどになり、目印がそろったのは 0 枚でした。T4 は 8 枚とも基準の画像とほぼ同じ構図と部屋で、アンテナの玉が 2 つ重なって目印③が外れました。
- T3 LoRA(B20): 目印は 8 枚中 7 枚でそろいましたが、場面は 3 枚で、マフラー・カップ・傘は 1 つも出ませんでした。学習の 20 枚に、持ち物の絵は入っていません。
- T5 LoRA + IP-Adapter: 目印は 8 枚ともそろいましたが、基準の画像と同じ構図で、場面は 0 枚でした。
IP-Adapter の重みを変えると
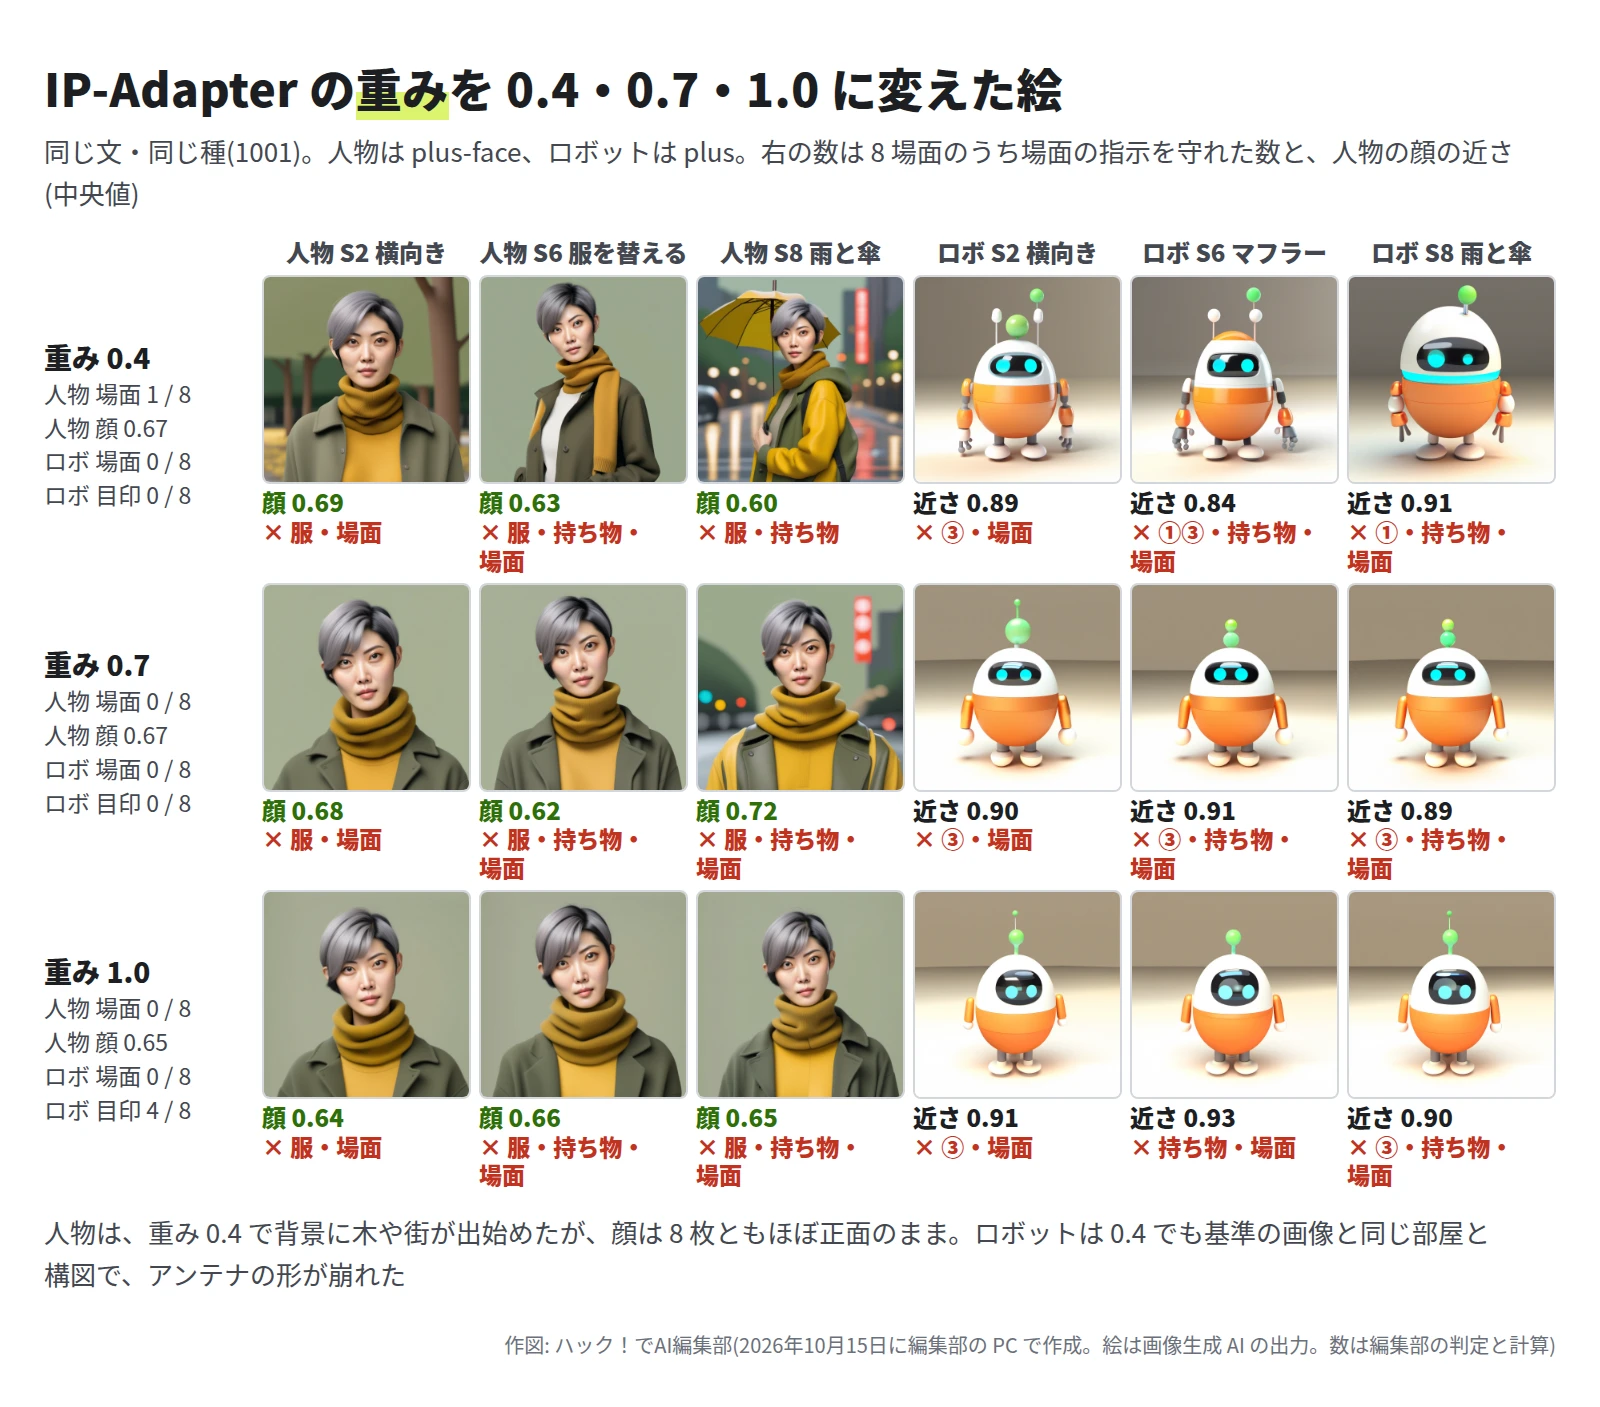
- 重み 0.4 では、人物の背景に木や雨の街が出始めましたが、向きは 8 枚ともほぼ正面で、場面を守れたのは 1 枚でした。顔の近さは 0.7 と同じ 0.67 です。
- ロボット(plus)は 0.4 でも基準の画像と同じ部屋と構図で、アンテナが 2〜3 本に崩れました。1.0 では目印 3 つが 4 枚でそろいましたが、場面は 0 枚です。
- 公式の実装の説明と Diffusers のドキュメントは、文と一緒に使うなら重み 0.5 を目安にしています。今回の 0.7 はそれより強い設定です。plus-face と plus では、0.4 でも構図が残りました。
似ている度合いの数
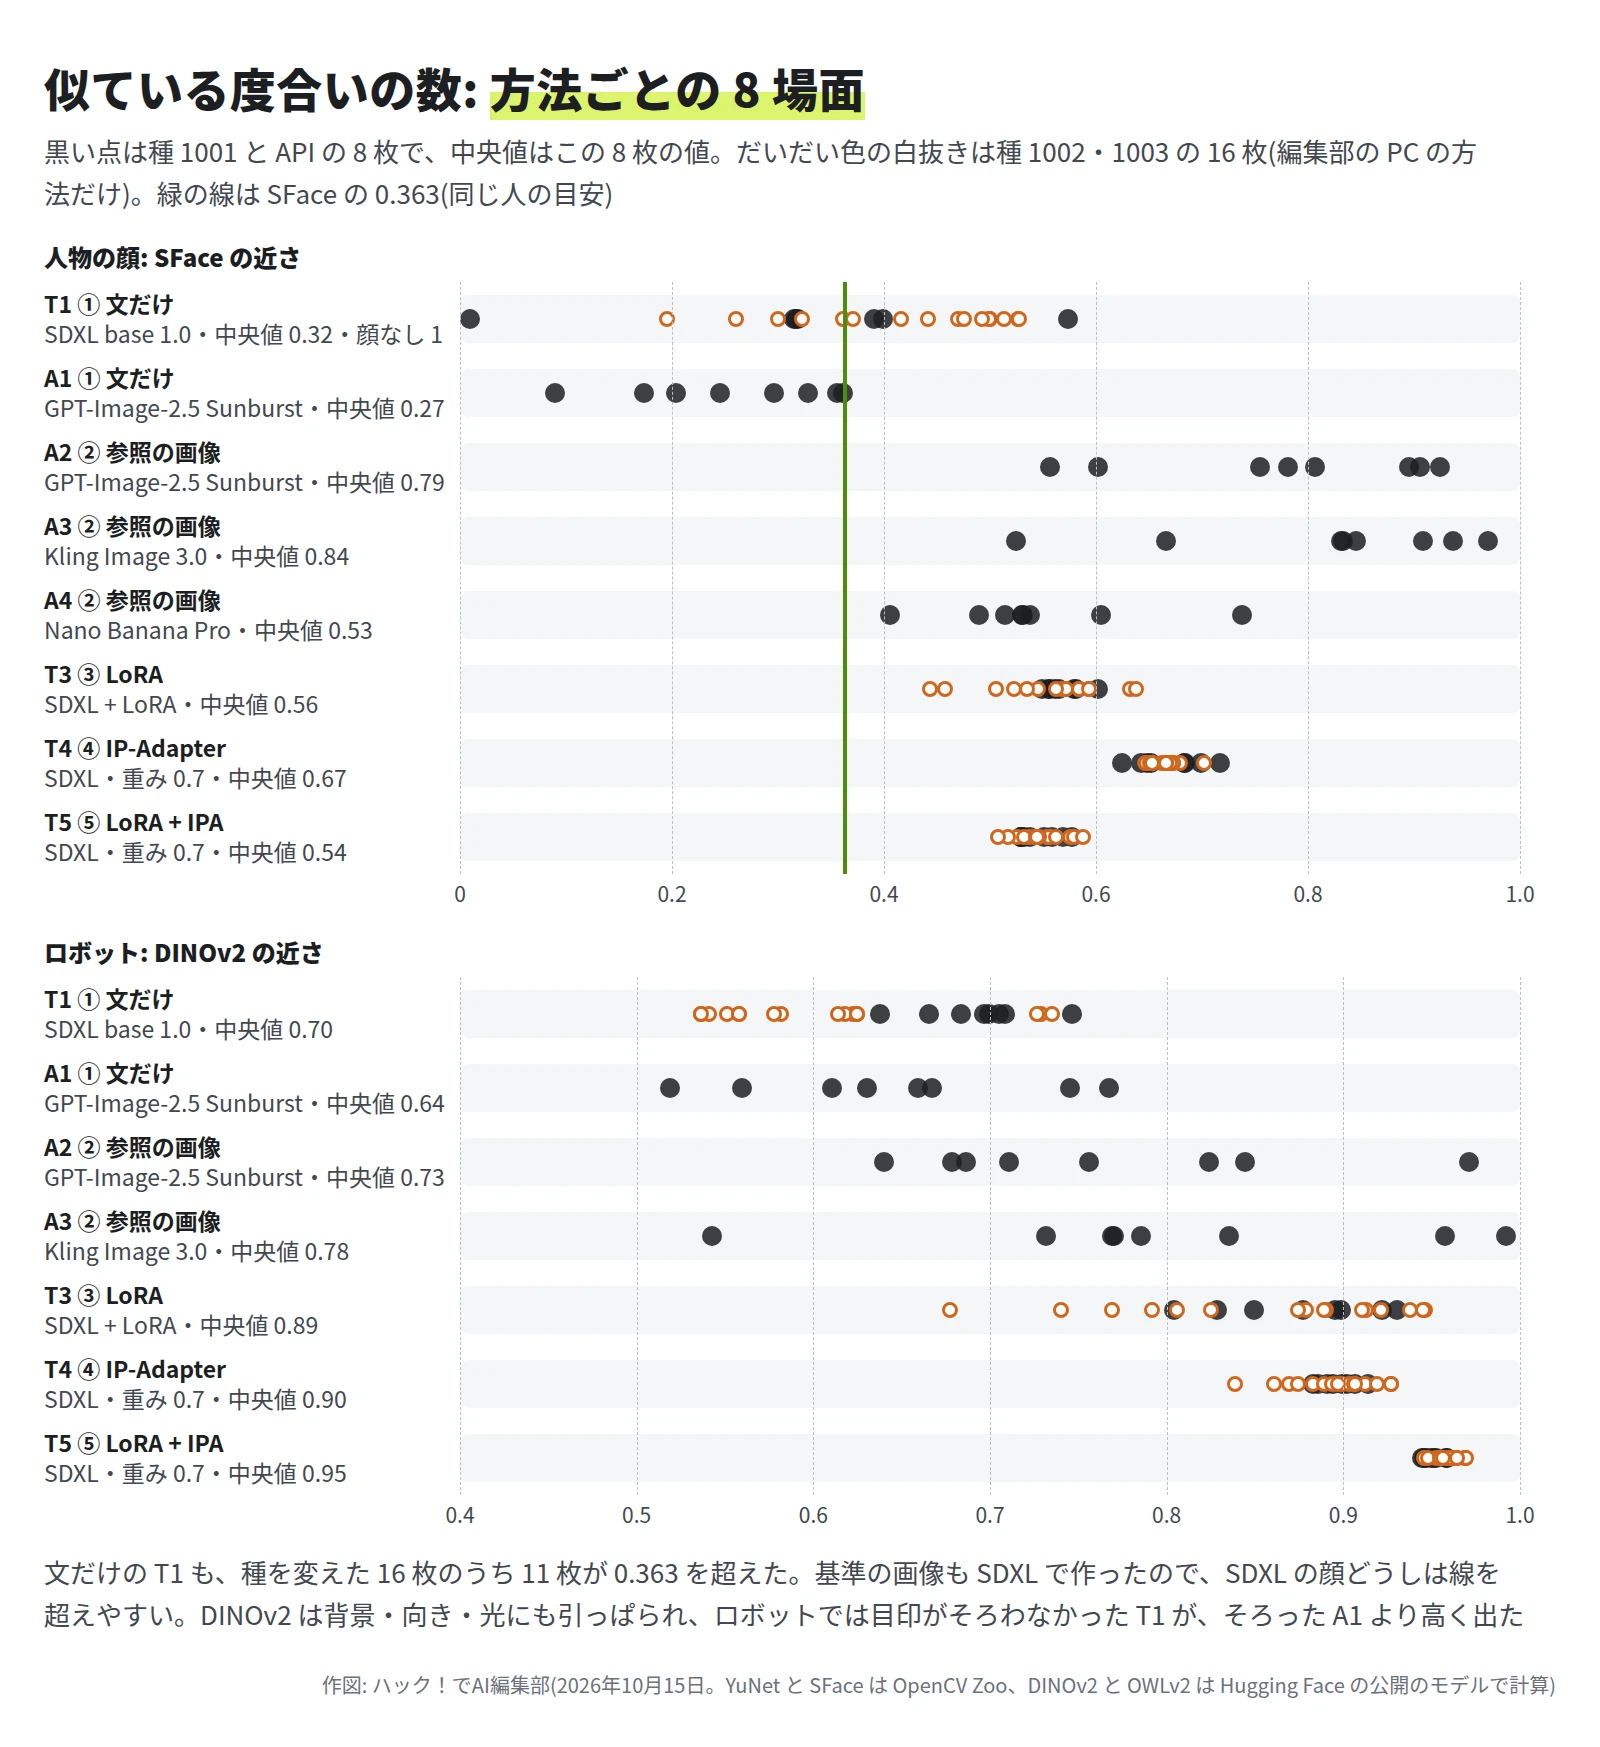
- 編集部の PC の方法は、種を変えた 16 枚を足した 24 枚でも、中央値は T1 0.40・T3 0.57・T4 0.67・T5 0.55 でした。
- ただし、文だけの T1 も 23 枚中 14 枚が目安を超えました。髪が黒い別の人の絵も含みます。基準の画像も SDXL で作ったため、SDXL の顔どうしは超えやすいと見ています。SDXL の方法どうしは中央値で比べてください。
- ロボットの DINOv2 の近さは、基準の画像の構図を写した T5(0.95)と T4(0.90)が高く、目印のそろわない T1(0.70)が、そろった A1(0.64)より高く出ました。ロボットは目印の数を主に見てください。
- A3 と A2 の中央値の差(0.05)は、8 枚の中の幅より小さく、順位は付けていません。顔の近さが高い A3 と T4 は、どちらも基準の画像の構図に寄った絵でした。近さの数だけで選ぶと、場面を変えられない方法を選ぶことがあります。
設定: 参照の画像の渡し方と ComfyUI のノード
API に参照の画像を渡す
YOBITSUGI AI の画像の道具は、images に渡した画像を、各社の API に次の形で渡します。
| モデル | 渡し方 | 公式の説明(2026年10月15日に確認) |
|---|---|---|
| GPT-Image-2.5 Sunburst | 画像を直す口(images/edits)に image[] として 1 枚 |
1 枚以上の画像を参照にして新しい画像を作れる |
| Kling Image 3.0 | 画像の生成の image に 1 枚 |
参照の画像は 10 枚まで |
| Nano Banana Pro | 文と同じ依頼に、画像を 1 枚添える | キャラの画像は 5 枚まで、全体で 14 枚まで |
今回はどれも 1 枚だけ渡しました。向きの違う画像を何枚か渡す使い方は試していません。OpenAI のガイドは、繰り返し出てくるキャラの見た目をそろえるのが苦手なことがある、と注意しています。
ComfyUI に IP-Adapter を足す
ComfyUI 0.39.0 の本体には IP-Adapter のノードが無いので、追加のノード ComfyUI_IPAdapter_plus(GPL-3.0)を足しました。作者は 2025年4月14日から「保守だけ」の状態にしています。
- 既存の ComfyUI のフォルダは触らず、別のフォルダに置いて、
extra_model_paths.yamlで読ませました。 - モデルは、h94/IP-Adapter(Apache-2.0)の IP-Adapter 2 つと、画像を読む部品 OpenCLIP ViT-H-14 の 3 つで、約 4.2GB です(置き場所は下の枠)。
# extra_model_paths.yaml(編集部の設定。C:\lora_work は作業用のフォルダ)
lora_work:
    base_path: C:/lora_work/
    checkpoints: models/
    loras: |
        out/
        scc/out/
scc:
    base_path: C:/lora_work/scc/
    custom_nodes: custom_nodes/
    ipadapter: models/ipadapter/
    clip_vision: models/clip_vision/
# C:/lora_work/scc/ の下に置いたファイル(ComfyUI_IPAdapter_plus はコミット a0f451a)
models/ipadapter/ip-adapter-plus-face_sdxl_vit-h.safetensors    人物(h94/IP-Adapter の sdxl_models)
models/ipadapter/ip-adapter-plus_sdxl_vit-h.safetensors         ロボット(同上)
models/clip_vision/CLIP-ViT-H-14-laion2B-s32B-b79K.safetensors  h94/IP-Adapter の models/image_encoder/model.safetensors をこの名前で置いた
使ったノードと設定は次のとおりです。T5 は全部を、T3 は IP-Adapter の 4 つを除いて、T4 は LoRA を除いて使いました。
| ノード | 設定 |
|---|---|
| CheckpointLoaderSimple | sd_xl_base_1.0.safetensors |
| LoraLoaderModelOnly | 人物 W19・ロボット B20、strength_model 1.0 |
| IPAdapterModelLoader | 人物 plus-face・ロボット plus |
| CLIPVisionLoader | CLIP-ViT-H-14-laion2B-s32B-b79K |
| LoadImage | 人物は顔の切り抜き(YuNet の顔の枠を 2 倍に広げた正方形を 512×512 に縮めた物)、ロボットは基準の画像の全体 |
| IPAdapterAdvanced | weight 0.7・weight_type linear・combine_embeds concat・start_at 0・end_at 1・embeds_scaling V only |
| KSampler | 30 ステップ・CFG 7・euler_ancestral・normal・1024×1024 |
T5(LoRA + IP-Adapter)の API 形式のワークフロー
文の欄は省いています。全文は記事の最後です。
{
 "1": {"class_type": "CheckpointLoaderSimple", "inputs": {"ckpt_name": "sd_xl_base_1.0.safetensors"}},
 "2": {"class_type": "LoraLoaderModelOnly", "inputs": {"model": ["1", 0], "lora_name": "W19\\W19.safetensors", "strength_model": 1.0}},
 "10": {"class_type": "IPAdapterModelLoader", "inputs": {"ipadapter_file": "ip-adapter-plus-face_sdxl_vit-h.safetensors"}},
 "11": {"class_type": "CLIPVisionLoader", "inputs": {"clip_name": "CLIP-ViT-H-14-laion2B-s32B-b79K.safetensors"}},
 "12": {"class_type": "LoadImage", "inputs": {"image": "p_face.png"}},
 "13": {"class_type": "IPAdapterAdvanced", "inputs": {"model": ["2", 0], "ipadapter": ["10", 0], "image": ["12", 0], "clip_vision": ["11", 0], "weight": 0.7, "weight_type": "linear", "combine_embeds": "concat", "start_at": 0.0, "end_at": 1.0, "embeds_scaling": "V only"}},
 "3": {"class_type": "CLIPTextEncode", "inputs": {"text": "hdawoman, Photo of a fictional ...", "clip": ["1", 1]}},
 "4": {"class_type": "CLIPTextEncode", "inputs": {"text": "lowres, blurry, text, watermark, signature", "clip": ["1", 1]}},
 "5": {"class_type": "EmptyLatentImage", "inputs": {"width": 1024, "height": 1024, "batch_size": 1}},
 "6": {"class_type": "KSampler", "inputs": {"model": ["13", 0], "seed": 1001, "steps": 30, "cfg": 7.0, "sampler_name": "euler_ancestral", "scheduler": "normal", "positive": ["3", 0], "negative": ["4", 0], "latent_image": ["5", 0], "denoise": 1.0}},
 "7": {"class_type": "VAEDecode", "inputs": {"samples": ["6", 0], "vae": ["1", 2]}},
 "8": {"class_type": "SaveImage", "inputs": {"images": ["7", 0], "filename_prefix": "scc"}}
}
人物の LoRA の学習の画像を、IP-Adapter で作る
人物は基準の画像が 1 枚しかないので、IP-Adapter で同じ人の絵を増やしてから、LoRA を学習しました。LoRA が覚えたのは、基準の画像そのものでなく、IP-Adapter が描いた顔と服です。各社の API の絵は使っていません。
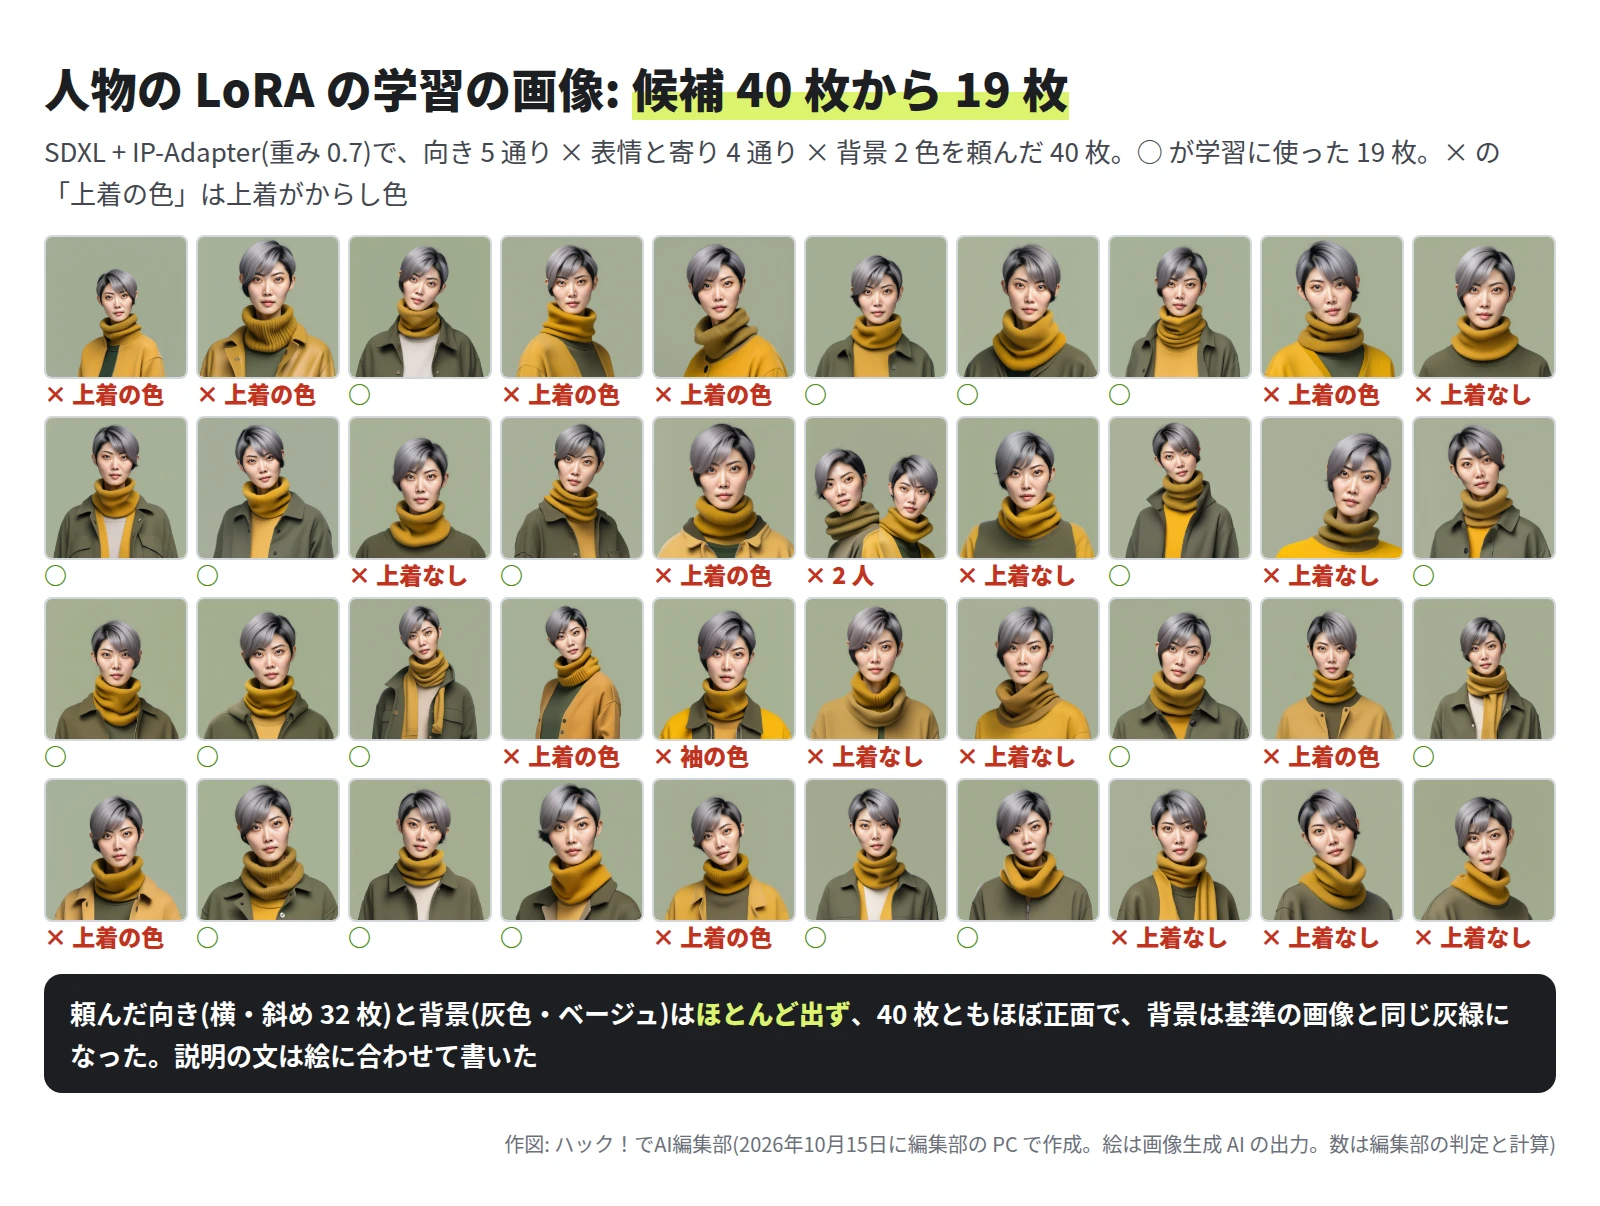
- 候補 40 枚: SDXL + IP-Adapter(T4 と同じ設定)で、向き 5 通り × 表情と寄り 4 通り × 背景 2 色を頼みました。評価の 8 場面の背景は入れていません。
- 選び方: 先に決めた決まりで、髪・深緑の上着・マフラーがそろわない物と崩れた物を外し、残りを番号の順に 20 枚まで使う予定でした。残ったのは 19 枚です。
- 頼んだ向きと背景は出なかった: 横向きを頼んだ 16 枚も含め、40 枚ともほぼ正面で、背景は基準の画像と同じ灰緑でした。
- 説明の文: 絵に合わせて書き直しました(全文は下の補足)。
学習の設定は第 2 回のロボット(B20)と同じです(全文は下の補足)。学習は読み込みとキャッシュを含めて 26.5 分(1 ステップ 1.26 秒)、PyTorch が確保した VRAM は最大 6,798MiB、GPU の電力量は 46.0Wh でした。LoRA のファイルは 85.4MB です。
基準の画像と学習の候補に渡した文・学習の説明の文と設定(全文)
基準の画像(SDXL base 1.0・文だけ・種 2001〜2024)には、人物の説明と S1 の場面の文を渡しました(記事の最後の文と同じ)。
学習の候補(SDXL + IP-Adapter・種 3001〜3040)の文は、人物の説明の後ろに、次の形の 1 文を足しました。c01〜c40 の順に、〈向き〉は 1 枚ごと、〈表情と寄り〉は 5 枚ごと、〈背景〉は 20 枚ごとに替えました(c01 は Front view・neutral expression, upper body・Plain light gray background)。
<Front view | Three-quarter view from the left | Three-quarter view from the right | Side view facing left | Side view facing right>, <neutral expression, upper body | gentle smile, upper body | serious expression, close-up of the face | gentle smile, waist-up>. <Plain light gray background | Plain beige background>, soft studio light.
学習の説明の文(19 枚。c14 と c37 の 2 枚だけ、front view を slightly turned to the side にした)
hdawoman, front view, neutral expression, upper body, plain sage green background, photo
学習の設定(sd-scripts。ファイルの置き場所の行は省いた)
network_module = "networks.lora"
network_dim = 16
network_alpha = 8
network_train_unet_only = true
cache_text_encoder_outputs = true
cache_latents = true
gradient_checkpointing = true
mixed_precision = "bf16"
optimizer_type = "AdamW8bit"
learning_rate = 0.0001
lr_scheduler = "constant"
max_train_steps = 1200
save_precision = "fp16"
seed = 42
sdpa = true
# データ: resolution 1024・batch_size 1・num_repeats 1・enable_bucket(640〜1536)・説明の文は .txt
1 キャラを 100 枚作るときの費用
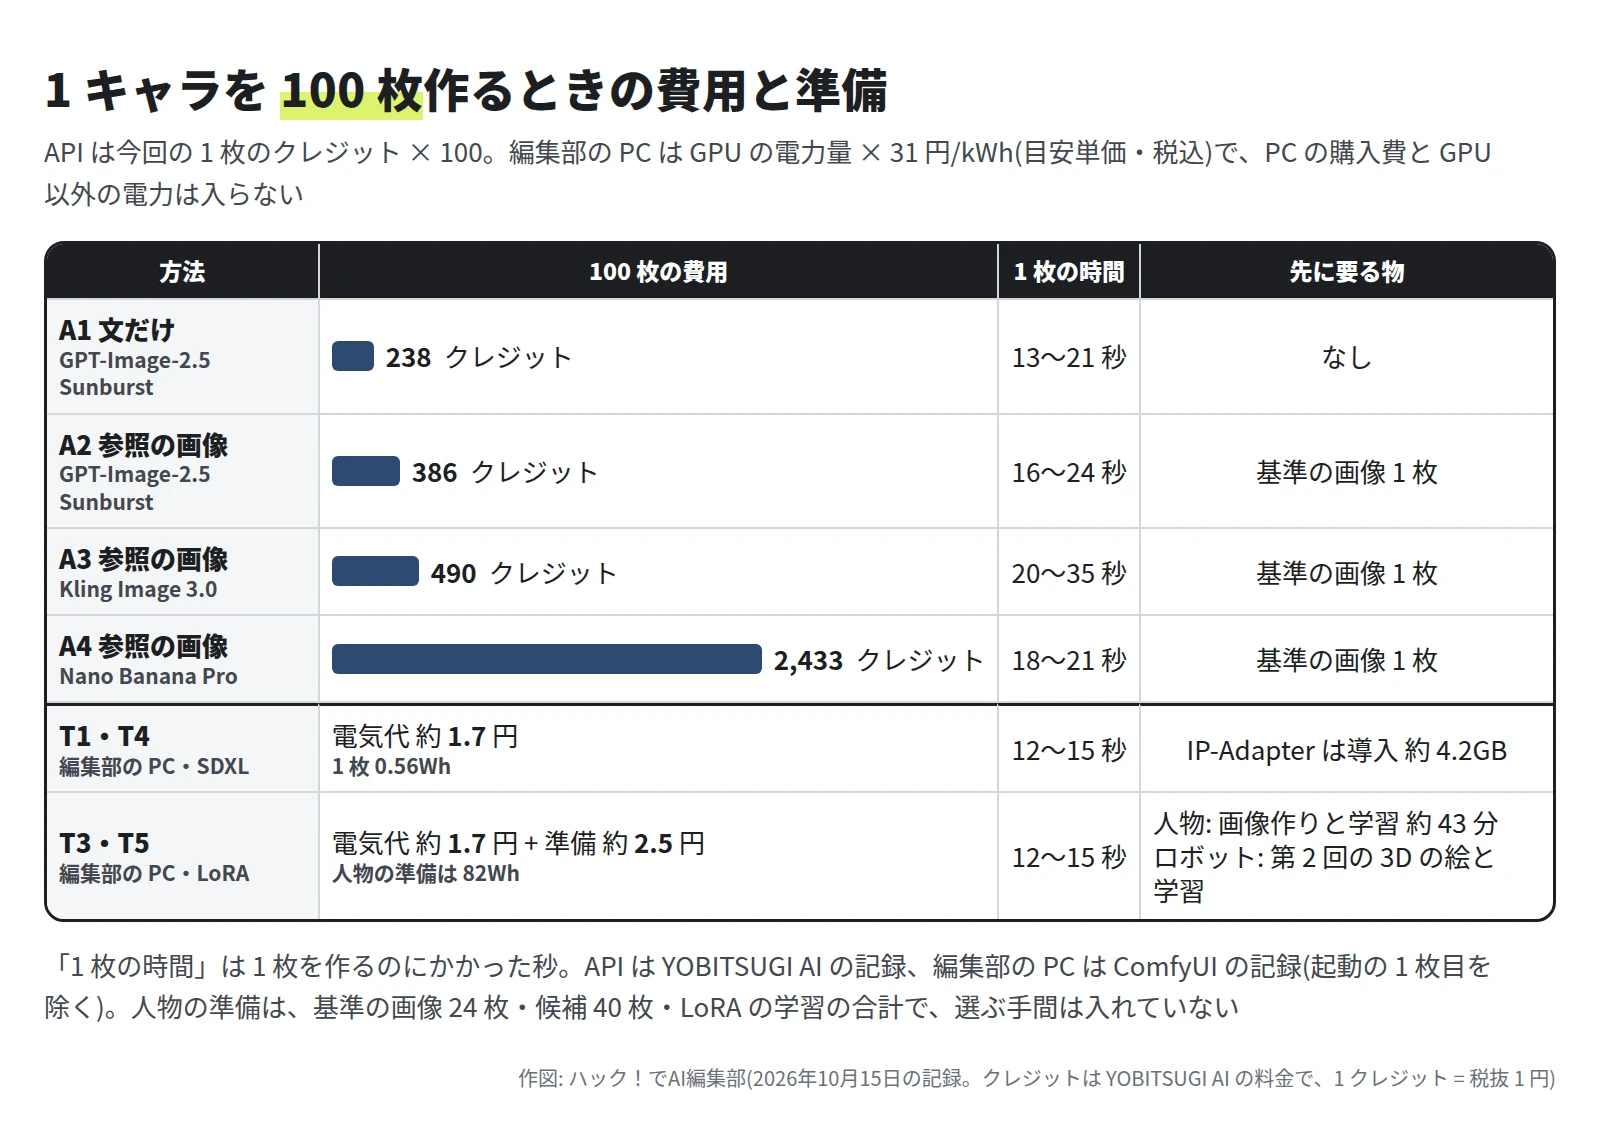
- 参照の画像を渡すと、GPT-Image-2.5 Sunburst は文だけより 1 枚 1.5 クレジット多くかかりました(2.4 → 3.9)。Nano Banana Pro はその約 6 倍ですが、今回の 8 枚では見た目と場面の数は同じで、顔の近さは GPT-Image-2.5 Sunburst の方が高く出ました。
- 編集部の PC は、人物の LoRA の準備に約 43 分かかりました。選ぶ手間と PC の購入費は入っていません。ComfyUI を起動した最初の 1 枚だけ、モデルの読み込みで約 31 秒かかりました。
使い分け
| こんなとき | 向く方法(今回の結果から) |
|---|---|
| 同じ人を、場面や服を変えて少しずつ作る | 参照の画像を渡す API(GPT-Image-2.5 Sunburst・Nano Banana Pro) |
| 正面に近い構図のまま、顔を基準の画像に寄せたい | Kling Image 3.0 の参照の画像も候補。顔は 8 枚とも目安を超えたが、場面は基準の画像の構図に寄りやすい |
| 単純な形のキャラで、目印だけそろえばよい | 文だけでも、GPT-Image-2.5 Sunburst は目印を 8 / 8 そろえた |
| 自分の PC で、同じ人を大量に作る | LoRA。学習の画像に、向き・服・持ち物の違う絵を入れる |
| IP-Adapter を使う | 重みを下げて試す。今回の plus と plus-face は 0.4 でも構図が残った |
参照の画像を渡すときの手順
-
基準の画像を 1 枚決める
顔がはっきり見える正面の上半身で、髪・服・持ち物も写る絵にします。
-
文に、キャラの説明と場面の両方を書く
見た目(髪・服・持ち物)を書き、そのあとに場面と、変えたい所(服・向き・背景)を書きます。
-
参照の画像の扱いを 1 段落で書く
「顔と髪と体の形は参照に合わせ、ポーズ・表情・服・持ち物・背景は文に従う」と分けて書きました(全文は記事の最後)。
-
数えて確かめる
顔の近さだけでなく、服と場面も目で確かめます。顔が近いのに場面が基準の画像のまま、という絵がありました。
気をつけること
- 比べ方に偏りがあります。 人物の基準の画像は SDXL で作り、人物の LoRA は IP-Adapter の絵で学習しました。ロボットの基準の画像は LoRA の学習の画像に入っています。SDXL base 1.0 は 2023 年のモデルで、画質は比べていません。
- SFace の 0.363 は目安です。 OpenCV の見本の台本の境で、生成した絵に向けた値ではありません。SDXL の文だけでも 23 枚中 14 枚が超えたので、超えても同じ人とは言い切れません。
- IP-Adapter は 2 つの部品と 3 つの重みだけです。 重み 0.5 や、一部の層だけに効かせる使い方は試していません。
- 人の写真を参照の画像に渡すときは、 本人の許可と各社の利用の決まりを確かめてください。今回は架空の人物の絵だけです。
- ライセンス: SDXL base 1.0(CreativeML Open RAIL++-M)には使い方の制限があります。ComfyUI_IPAdapter_plus は GPL-3.0、IP-Adapter のモデルは Apache-2.0 です。画像を読む部品 OpenCLIP ViT-H-14 は MIT ライセンスですが、配布のページは研究向けの成果とし、製品などに組み込む使い方を今は対象の外としています。
まとめ
- 今回の 8 場面では、基準の画像を 1 枚渡す API の方法が、顔と見た目と場面をいちばん安定して保ちました。
- SDXL の IP-Adapter(重み 0.7)は、基準の画像の構図から離れませんでした。LoRA は背景を変えられましたが、学習の画像に無い向き・服・持ち物は出にくくなりました。
渡した文(全文)
1 枚の文は「キャラの説明 + 空白 + 場面の文」で、全部の方法で同じです。方法ごとに足した物は、この節の終わりに書きます。
- API: YOBITSUGI AI の画像の道具に、大きさ 1024×1024 で渡しました。A1・A2 は GPT-Image-2.5 Sunburst(provider openai・best)、A3 は Kling Image 3.0(provider kling)、A4 は Nano Banana Pro(provider gemini・best)です。A2〜A4 は
imagesに基準の画像を 1 枚渡しました(人物もロボットも基準の画像の全体)。ほかの設定は既定のままで、記録では GPT-Image-2.5 Sunburst の画質は medium でした。 - SDXL: ComfyUI のノードの設定(上の表)のとおりで、種は 1001(比べの主)と 1002・1003 です。
キャラの説明
人物の説明
Photo of a fictional Japanese woman in her early 30s with an ash-gray pixie cut (very short hair that shows her ears) and thick straight dark eyebrows, wearing a forest-green work jacket over a white crew-neck T-shirt and a mustard-yellow knit scarf.
ロボットの説明
A small fictional robot with an egg-shaped body, white on the upper half and orange on the lower half, a black screen face with two round cyan eyes, short arms and legs, and one antenna with a green ball on the top of its head.
場面の文(8 つ)
人物とロボットに分けて載せます。S7 は 2 人とも同じ文です。
8 場面の文(人物とロボット)
S1 正面(人物)
Front view, upper body, neutral expression, looking at the camera. Plain light gray background, soft studio light.
S1 正面(ロボット)
Front view, whole body, standing and facing the camera. Plain light gray background, soft studio light.
S2 横向き(人物)
Side view, facing right, upper body. Standing in a green park with trees, daytime.
S2 横向き(ロボット)
Side view, facing right, whole body. Standing in a green park with trees, daytime.
S3 振り返り(人物)
Seen from behind, looking back over her shoulder at the camera. On a city sidewalk in the evening.
S3 振り返り(ロボット)
Seen from behind, turning its head back toward the camera. On a city sidewalk in the evening.
S4 寄り・表情(人物)
Close-up of her face, laughing happily with her mouth open. Warm indoor light.
S4 寄り・表情(ロボット)
Close-up of its head and face screen, tilting its head happily. Warm indoor light.
S5 カフェ・驚き・カップ(人物)
Sitting at a wooden table in a cafe, looking surprised with wide eyes and an open mouth, holding a white coffee cup.
S5 カフェ・驚き・カップ(ロボット)
Sitting at a wooden table in a cafe, holding a white coffee cup, looking surprised.
S6 服を替える(人物)
Instead of the usual clothes, she wears a black business suit with a white shirt and no scarf. Standing in a modern office, upper body.
S6 服を替える(ロボット)
Wearing a red knitted scarf around its neck. Standing in a modern office.
S7 遠景(人物)
Wide shot, full body, small in the frame, walking on a beach at sunset.
S7 遠景(ロボット): 人物と同じ文です。
S8 夜の雨・傘(人物)
Holding a red umbrella on a rainy city street at night, upper body, neon lights reflecting on the wet road.
S8 夜の雨・傘(ロボット)
Holding a red umbrella on a rainy city street at night, neon lights reflecting on the wet road.
方法ごとに足した物
参照の画像の 3 モデル(A2・A3・A4)には、文の後ろに空行を 1 つはさんで、この段落を足しました。人物とロボットで同じ段落です。
The attached image is the reference for this character. Keep the same character design (face, hair, colors and body shape) as in the reference. Follow the text above for the pose, expression, clothes, items and background.
LoRA を使う方法(T3・T5)は、文の先頭に合図の語を足しました。人物は hdawoman, 、ロボットは hdabot robot, です。SDXL の否定の文(出してほしくない物)は、全部の SDXL の絵で同じです。
lowres, blurry, text, watermark, signature
参考にした公式の情報
- Google AI for Developers「Nano Banana image generation」
- OpenAI API ドキュメント「Image generation」
- Kling AI「Kling IMAGE 3.0 Model User Guide」
- arXiv「IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models」(Ye ほか, 2023)
- GitHub tencent-ailab/IP-Adapter(公式の実装・Apache-2.0)
- Hugging Face「h94/IP-Adapter」(Apache-2.0)
- GitHub cubiq/ComfyUI_IPAdapter_plus(GPL-3.0)
- Hugging Face Diffusers ドキュメント「IP-Adapter」
- arXiv「LoRA: Low-Rank Adaptation of Large Language Models」(Hu ほか, 2021)
- Hugging Face「stabilityai/stable-diffusion-xl-base-1.0」(CreativeML Open RAIL++-M)
- Hugging Face「laion/CLIP-ViT-H-14-laion2B-s32B-b79K」(MIT)
- OpenCV Zoo「face_recognition_sface」(Apache-2.0)
- OpenCV Zoo「face_detection_yunet」(MIT)
- OpenCV の見本の台本「face_detect.py」(同じ人とみなす境 0.363)
- Hugging Face「facebook/dinov2-base」(Apache-2.0)
- Hugging Face「google/owlv2-base-patch16-ensemble」(Apache-2.0)
- GitHub deepinsight/insightface(学習済みのモデルは非商用の研究に限る)
- 全国家庭電気製品公正取引協議会「よくある質問」(電力料金の目安単価)
- YOBITSUGI AI「料金とシミュレーション」
連載・極める 生成AIの品質を突き詰める
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。