AI技術大全 第2回
LoRA の作り方 8GB の GPU で画像の LoRA を学習し、枚数と時間を測った
 佐々木 航
この記事でわかること
- 8GB の GPU で SDXL の LoRA が学習できる設定と、遅くなる設定
- 学習 1 本の時間・VRAM・ファイルの大きさ・電気代
- 画像の枚数・ステップ数・ランク・重みと、効き方・写し過ぎ
確認した環境: kohya-ss sd-scripts v0.12.0・SDXL base 1.0・ComfyUI 0.39.0 / RTX 5060 Ti 8GB(Windows 11)で計測 / 2026年10月15日に確認
LoRA(ローラ)は、画像の生成 AI に、特定のキャラクターや画風を少ない計算で覚えさせる方法です。編集部は、家庭用の GPU(RTX 5060 Ti 8GB)で SDXL の LoRA を 6 本学習し、枚数・ステップ数・ランク・重みで効き方がどう変わるかを数えました。勧められた設定なら、1 本(1,200 ステップ)は 24〜26 分、PyTorch が確保した VRAM は最大 6,798MiB で収まり、20 枚で学習したロボットは 12 枚中 9 枚で目印がそろいました。勧められた設定から 1 か所変える(gradient checkpointing を外すなど)と、エラーは出ないまま 1 ステップが 69〜203 倍の秒数になりました(30 ステップの試し)。
結果の早見
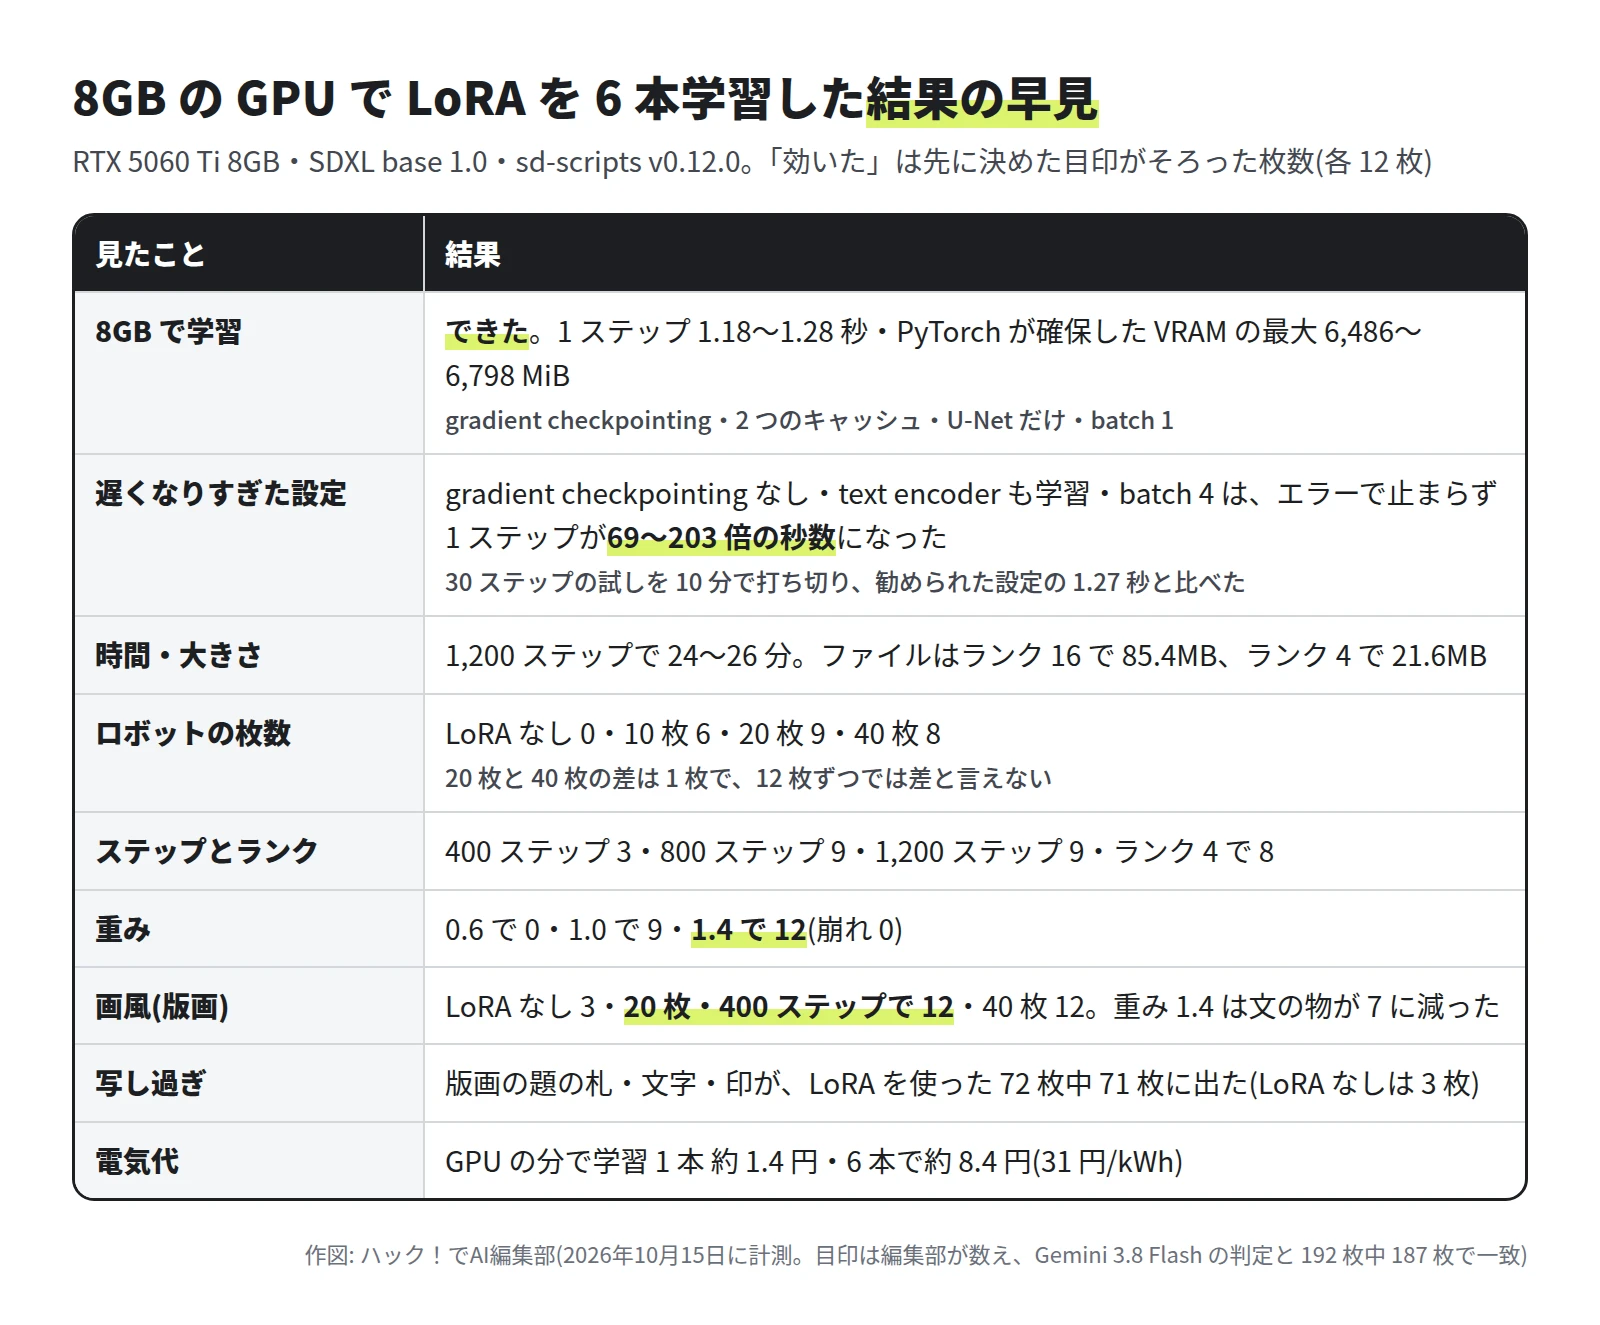
- 8GB で学習できました。gradient checkpointing・2 つのキャッシュ・U-Net だけの設定で、1 ステップ 1.18〜1.28 秒でした。
- 枚数: ロボットは 10 枚で 6/12、20 枚で 9/12、40 枚で 8/12 でした。20 枚と 40 枚の差は 1 枚で、12 枚ずつの数では差と言えません。
- ステップ数: 20 枚のロボットは 800 ステップで 1,200 ステップと同じ 9/12 でした。版画は 400 ステップで 12/12 でした。
- 重み: ロボットは 0.6 で 0/12、1.4 で 12/12 でした。版画は 1.4 で、文の物が描かれた絵が 7/12 に減りました。
- 写し過ぎ: 版画の題の札や印が、LoRA を使った 72 枚中 71 枚に出ました。
- 電気代: GPU の分だけなら、学習 1 本 約 1.4 円でした。
LoRA の仕組み
LoRA は、Hu ほかが 2021年に発表した、大きなモデルを少ない計算で調整する方法です。論文には、元の重み(モデルが覚えている数値)を固定し、各層に「細い 2 枚の行列」を足して、その 2 枚だけを学習すると書かれています。GPT-3 175B での比べでは、学習する数値が 1 万分の 1、GPU のメモリが 3 分の 1 になり、使うときの遅れも増えないとされています。
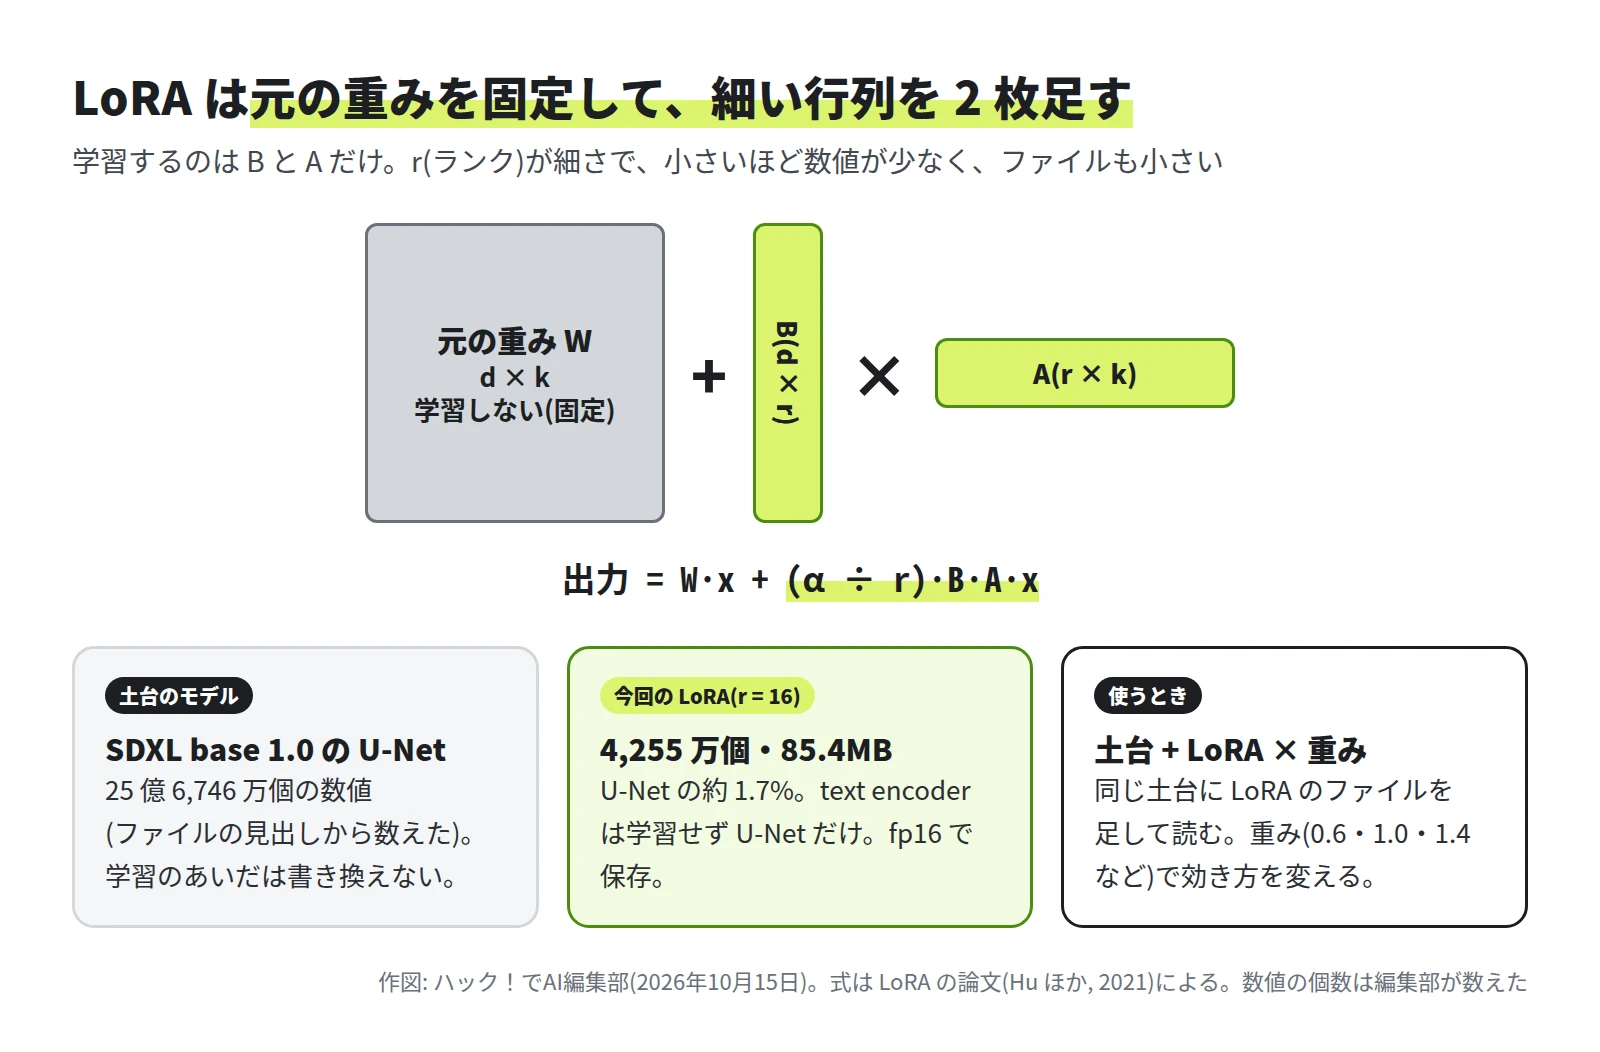
今回は、絵を描く本体の U-Net(ユーネット。ノイズから絵を作る部品)に LoRA を足しました。編集部が数えたところ、SDXL base 1.0 の U-Net は 25 億 6,746 万個の数値で、ランク(細さ)16 の LoRA は 4,255 万個(約 1.7%)、ファイルは 85.4MB でした。土台のモデル(6.9GB)はそのままで、LoRA のファイルだけを差し替えて使えます。
使うときは、土台のモデルに LoRA を足して読み、重み(効かせる強さ)を 0.6・1.0・1.4 のように変えます。
試した PC と道具
| 項目 | 中身 |
|---|---|
| PC | Windows 11 Home・Ryzen 7 5700X・メモリ 32GB |
| GPU | GeForce RTX 5060 Ti 8GB(NVIDIA の仕様で消費電力 180W)・ドライバー 616.92 |
| 学習 | kohya-ss sd-scripts v0.12.0(2026年9月24日)・PyTorch 2.8.0(CUDA 12.8)・Python 3.12.1 |
| 土台のモデル | Stable Diffusion XL base 1.0(Stability AI・CreativeML Open RAIL++-M) |
| 生成(評価) | ComfyUI 0.39.0 |
sd-scripts は、LoRA の学習によく使われる道具です。README は、RTX 50 シリーズには PyTorch 2.8.0 と CUDA 12.8 か 12.9 を使うように書いています。手順は Python 3.10 が前提で、3.11 と 3.12 は「動くが試していない」とされています。編集部は 3.12.1 で動かし、途中で止まることはありませんでした。
ほかの作業と別のフォルダと仮想環境(venv。その道具専用の Python の置き場)に、次の手順で入れました。
# C:\lora_work に sd-scripts と専用の venv を入れる(編集部の手順)
mkdir C:\lora_work; cd C:\lora_work
git clone https://github.com/kohya-ss/sd-scripts.git
cd sd-scripts
git checkout 690ea7f    # 編集部が使った版(v0.12.0)。最新の版を使うなら、この行は要らない
python -m venv C:\lora_work\venv    # 編集部は Python 3.12.1 で作った
C:\lora_work\venv\Scripts\python.exe -m pip install --upgrade pip
C:\lora_work\venv\Scripts\python.exe -m pip install torch==2.8.0 torchvision==0.23.0 --index-url https://download.pytorch.org/whl/cu128
C:\lora_work\venv\Scripts\python.exe -m pip install --upgrade -r requirements.txt
C:\lora_work\venv\Scripts\python.exe -c "import torch; print(torch.__version__, torch.version.cuda, torch.cuda.is_available())"
最後に True と出れば GPU が使えます。土台のモデル(sd_xl_base_1.0.safetensors)は Hugging Face から C:\lora_work\models に置きました。
学習に使った画像と説明の文
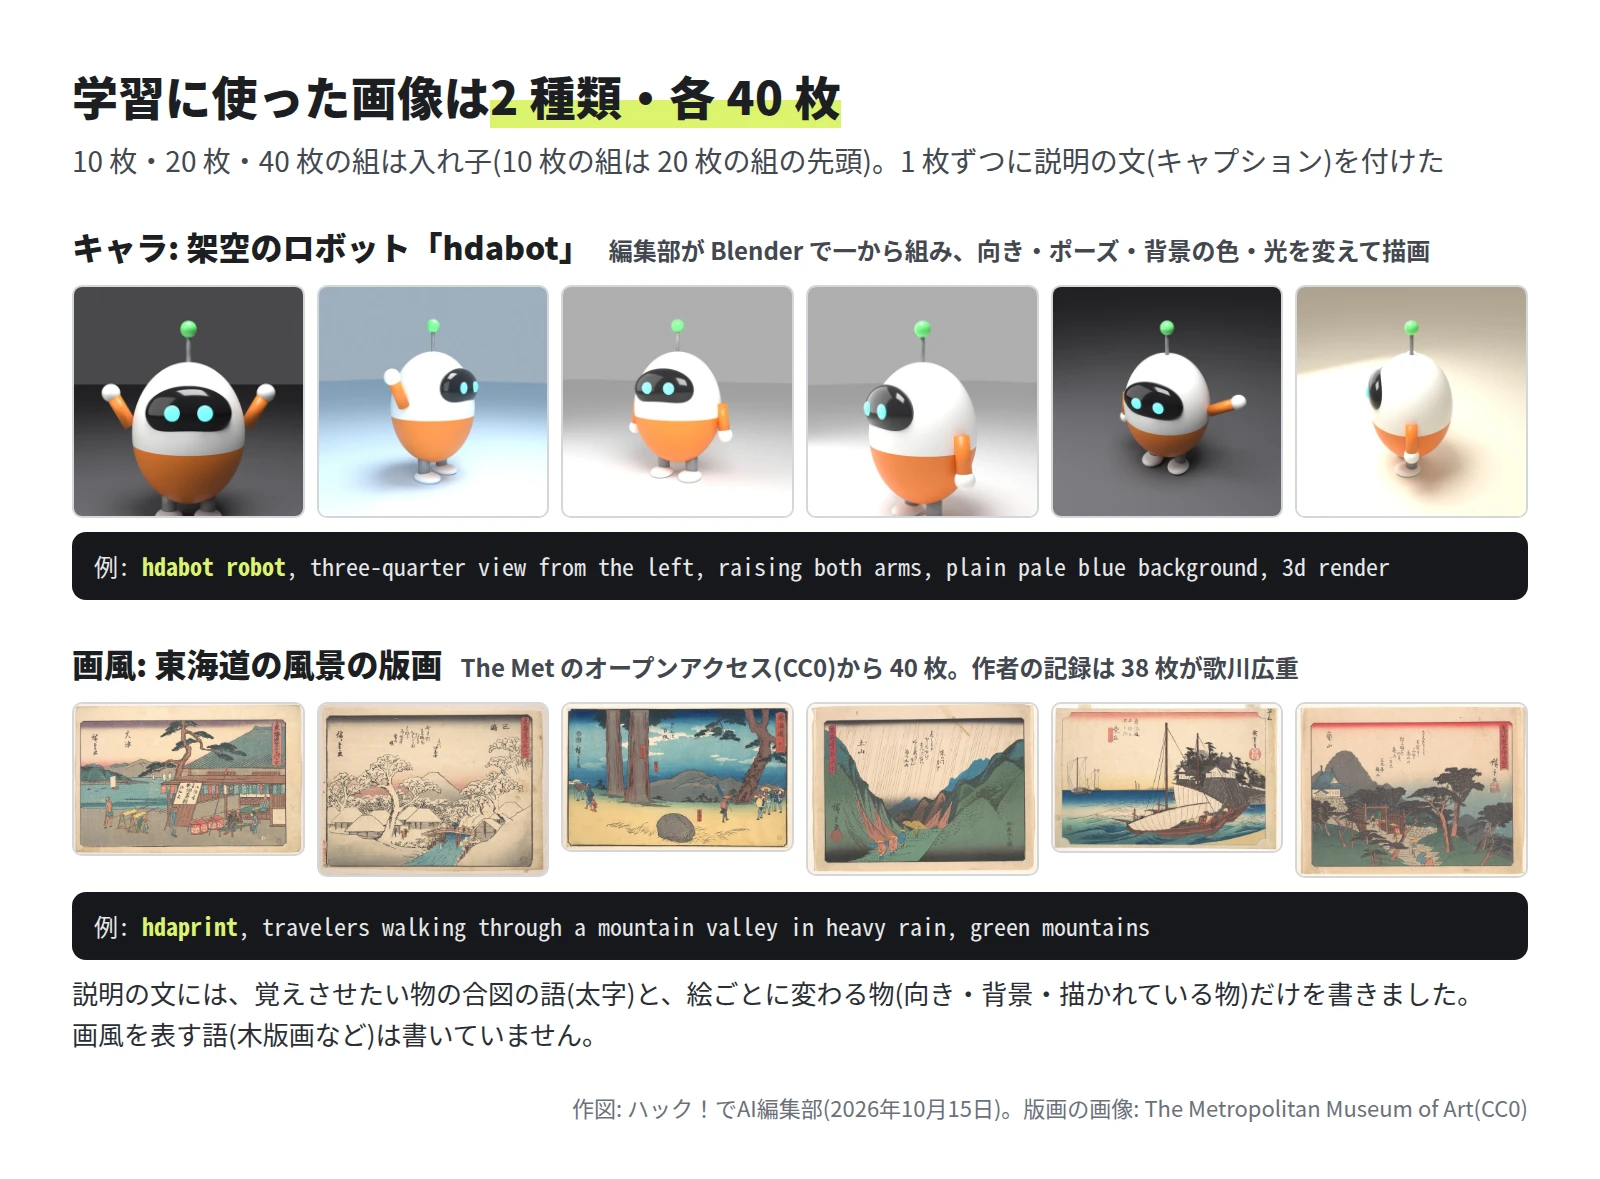
覚えさせる物は 2 種類にしました。
- キャラ(ロボット): 編集部が Blender で一から組んだ、架空のロボット「hdabot」です。白とだいだい色のたまご形の体に、黒い画面の顔と水色の目、先が緑の玉のアンテナを付けました。向き・ポーズ・背景の色(4 色)・光を変えて 40 枚描きました。
- 画風(版画): The Met(メトロポリタン美術館)が所蔵する、歌川広重の「東海道五十三次」の連作の版画 40 枚です(行書東海道・隷書東海道などを含み、18 枚は 20 世紀初めの摺り)。API の記録で作者は 38 枚が歌川広重、2 枚が空欄です。The Met は、パブリックドメインと判断した作品の画像を CC0(権利を放棄して誰でも使える形)で公開していて、記録で isPublicDomain が true の物だけを選びました。
版画は長い辺を 1,536 画素に縮めています。どちらも、10 枚・20 枚・40 枚の組は入れ子です(10 枚の組は 20 枚の組の先頭)。
説明の文(キャプション)は 1 枚ずつ英語で書き、先頭に合図の語(hdabot robot・hdaprint)、そのあとに絵ごとに変わる物(向き・背景・描かれている物)を置きました。画風を表す語(木版画など)は書いていません。書かなかった特徴を、合図の語に覚えさせるためです。
学習に使った 80 枚の説明の文(全文)
ロボット(hdabot)の 40 枚
b01: hdabot robot, close-up of upper body, front view, raising both arms, plain dark gray background, 3d render
b02: hdabot robot, three-quarter view from the left, raising both arms, plain pale blue background, 3d render
b03: hdabot robot, three-quarter view from the left, arms slightly spread, plain dark gray background, 3d render
b04: hdabot robot, three-quarter view from the right, standing with arms down, plain light gray background, 3d render
b05: hdabot robot, three-quarter view from the left, raising one arm, plain light gray background, 3d render
b06: hdabot robot, close-up of upper body, three-quarter view from the right, standing with arms down, plain light gray background, 3d render
b07: hdabot robot, front view, standing with arms down, plain beige background, 3d render
b08: hdabot robot, three-quarter view from the right, waving one arm, plain dark gray background, 3d render
b09: hdabot robot, close-up of upper body, three-quarter view from the right, arms slightly spread, plain pale blue background, 3d render
b10: hdabot robot, side view, raising one arm, plain beige background, 3d render
b11: hdabot robot, front view, raising both arms, plain dark gray background, 3d render
b12: hdabot robot, three-quarter view from the right, arms slightly spread, plain pale blue background, 3d render
b13: hdabot robot, three-quarter view from the right, waving one arm, plain dark gray background, 3d render
b14: hdabot robot, three-quarter view from the left, standing with arms down, plain beige background, 3d render
b15: hdabot robot, three-quarter view from the left, standing with arms down, plain light gray background, 3d render
b16: hdabot robot, close-up of upper body, three-quarter view from the right, arms slightly spread, plain dark gray background, 3d render
b17: hdabot robot, side view, waving one arm, plain dark gray background, 3d render
b18: hdabot robot, three-quarter view from the left, raising one arm, plain light gray background, 3d render
b19: hdabot robot, three-quarter view from the right, raising one arm, plain light gray background, 3d render
b20: hdabot robot, side view, arms slightly spread, plain dark gray background, 3d render
b21: hdabot robot, front view, raising one arm, plain beige background, 3d render
b22: hdabot robot, three-quarter view from the right, raising one arm, plain beige background, 3d render
b23: hdabot robot, three-quarter view from the right, raising one arm, plain light gray background, 3d render
b24: hdabot robot, close-up of upper body, three-quarter view from the left, waving one arm, plain pale blue background, 3d render
b25: hdabot robot, close-up of upper body, three-quarter view from the right, raising one arm, plain beige background, 3d render
b26: hdabot robot, back view, arms slightly spread, plain pale blue background, 3d render
b27: hdabot robot, close-up of upper body, front view, raising both arms, plain pale blue background, 3d render
b28: hdabot robot, three-quarter view from the left, raising both arms, plain dark gray background, 3d render
b29: hdabot robot, three-quarter view from the right, raising one arm, plain light gray background, 3d render
b30: hdabot robot, front view, standing with arms down, plain light gray background, 3d render
b31: hdabot robot, front view, raising one arm, plain light gray background, 3d render
b32: hdabot robot, three-quarter view from the right, raising both arms, plain pale blue background, 3d render
b33: hdabot robot, side view, waving one arm, plain pale blue background, 3d render
b34: hdabot robot, side view, standing with arms down, plain beige background, 3d render
b35: hdabot robot, rear three-quarter view, raising one arm, plain beige background, 3d render
b36: hdabot robot, close-up of upper body, side view, raising one arm, plain light gray background, 3d render
b37: hdabot robot, side view, raising both arms, plain pale blue background, 3d render
b38: hdabot robot, rear three-quarter view, waving one arm, plain pale blue background, 3d render
b39: hdabot robot, three-quarter view from the left, raising one arm, plain light gray background, 3d render
b40: hdabot robot, back view, raising one arm, plain beige background, 3d render
版画の 40 枚
p01: hdaprint, a roadside tea house under a large pine tree by a lake, travelers resting, sailboats on the water, mountains
p02: hdaprint, a snowy village with thatched houses, a small bridge over a stream, snow covered trees, a mountain in the distance
p03: hdaprint, travelers with a horse walking under snowy trees, falling snow, gray sky
p04: hdaprint, travelers on a mountain road beside tall cedar trees and a large round stone, hills in the distance
p05: hdaprint, people inside an open wooden inn with a blossoming plum tree and a veranda
p06: hdaprint, a row of wooden shops on a village street, travelers walking, trees and a gray sky
p07: hdaprint, travelers and porters with horses at a roadside rest house under trees, misty green background
p08: hdaprint, a snowy mountain village at night, people walking in deep snow with umbrellas
p09: hdaprint, travelers crossing a wooden bridge, women in kimono, mountains behind
p10: hdaprint, a crowd of merchants and travelers at a bridge by a river, white warehouses, a distant mountain
p11: hdaprint, porters carrying a palanquin running along a field road, wind blowing the trees, hills
p12: hdaprint, a busy roadside inn with yellow thatched roofs, horses and travelers, wind blown trees
p13: hdaprint, travelers walking through a mountain valley in heavy rain, green mountains
p14: hdaprint, a long wooden bridge over a river with a castle, a boat on the water, mountains
p15: hdaprint, travelers bowing beside a stone wall and a roadside post, willow trees, a fence
p16: hdaprint, large sailing boats on the sea near a castle on the shore, waves
p17: hdaprint, a procession crossing a wooden arched bridge in the morning, fish sellers, lanterns on poles
p18: hdaprint, travelers on a mountain road beside a tea house, green hills, blue sky
p19: hdaprint, travelers hurrying in the rain past a roadside stall, a tall pine tree, wooded hills
p20: hdaprint, a castle gate on a hill with pine trees, travelers climbing stone steps
p21: hdaprint, a busy street with shops, merchants cooking at a stall, travelers
p22: hdaprint, travelers on a mountain path below steep rocky cliffs, pine trees
p23: hdaprint, travelers with torches walking at night under large pine trees, smoke
p24: hdaprint, people on a road by a stone bridge over a small river, blossoming trees, rice fields
p25: hdaprint, a village street with shops selling cloth, travelers on horseback, a green hill
p26: hdaprint, a village among tall trees under a full moon, travelers with a horse
p27: hdaprint, a shrine gate and snowy trees at night, people walking in the snow
p28: hdaprint, an inn at dawn with curtains bearing round crests, porters preparing a palanquin, flags
p29: hdaprint, a procession of travelers with umbrellas crossing a bridge in heavy rain, a rushing stream, trees
p30: hdaprint, a huge snow capped mountain above green hills and a calm lake, pine trees
p31: hdaprint, travelers and merchants in a town street, porters carrying bales, plum blossoms
p32: hdaprint, a road on a hill above the sea at sunset, pine trees, a tea house with a yellow roof
p33: hdaprint, travelers crossing a red wooden bridge in the rain, a city with warehouses, a distant mountain
p34: hdaprint, two travelers walking along a path through rice fields, a tall snow capped mountain, birds in the sky
p35: hdaprint, a snow capped mountain behind a long gray mountain range, a river with reeds
p36: hdaprint, a castle by a river, a bridge with travelers, boats, a sunset sky
p37: hdaprint, porters carrying palanquins on a bridge by thatched houses and a willow tree
p38: hdaprint, a traveler on a horse in deep snow, snow covered trees, falling snow
p39: hdaprint, a snowy plain and hills at night, rows of houses covered with snow
p40: hdaprint, a long wooden bridge with travelers over a river, a city and red tinged mountains
版画 40 枚の The Met の記録(番号・題・作者・年)
The Met の API の検索で出た 55 件から、絵本・別の作者・別の連作の 5 件を除いて 50 件を候補にしました。そこから、色見本の帯が写った物・縁に色の枠がある物・同じ図柄の物・別の連作(近江八景)の 4 件を外し、残りから乱数(種 42)で 6 件を落として 40 件にしました。題・作者・年は API の記録のままです。番号は The Met のサイトの作品のページ(metmuseum.org/art/collection/search/番号)の番号です。
p01  37031  Ōtsu / Utagawa Hiroshige / 1841–44
p02  36556  Mishima / Utagawa Hiroshige / ca. 1838
p03  37024  Gyosho Tokaido: Ishikushi / Utagawa Hiroshige / ca. 1842
p04  37220  Nissaka / Utagawa Hiroshige / ca. 1848–49
p05  55699  Ishibe / Utagawa Hiroshige / early 20th century
p06  55698  Mizukuchi / Utagawa Hiroshige / early 20th century
p07  55692  Ishiyakushi / Utagawa Hiroshige / early 20th century
p08  56915  Evening Snow at Kanbara / Utagawa Hiroshige / ca. 1833–34
p09  37249  The Great Bridge at Sanjō (Taibi, Kyō, Sanjō Ōhashi) / Utagawa Hiroshige / ca. 1847–52
p10  37195  Nihon bashi / Utagawa Hiroshige / ca. 1848–49
p11  55693  Shōno / Utagawa Hiroshige / early 20th century
p12  55687  Chiryūshuku / Utagawa Hiroshige / early 20th century
p13  55697  Tsuchiyama / Utagawa Hiroshige / early 20th century
p14  55686  Okazaki / Utagawa Hiroshige / early 20th century
p15  56906  Station Thirty-Eight: Fujikawa, Scene at the Border / Utagawa Hiroshige / ca. 1833–34
p16  55587  Station Forty-Three: Kuwana, Seven-Ri Ferry at the Port / Utagawa Hiroshige / ca. 1833–34
p17  36922  Stations One: Morning View of Nihonbashi / Utagawa Hiroshige / ca. 1833–34
p18  37027  Okabe / Utagawa Hiroshige / ca. 1842
p19  55681  Futakawa / Utagawa Hiroshige / early 20th century
p20  55694  Kameyama / Utagawa Hiroshige / early 20th century
p21  55690  Kuwana / Utagawa Hiroshige / early 20th century
p22  55696  Sakanoshita / Utagawa Hiroshige / early 20th century
p23  37205  Hakone / Utagawa Hiroshige / ca. 1848–49
p24  55691  Yokkaichi / Utagawa Hiroshige / early 20th century
p25  55688  Narumi / Utagawa Hiroshige / early 20th century
p26  55684  Akasaka / Utagawa Hiroshige / early 20th century
p27  37242  Seki / (作者の欄は空) / ca. 1848–49
p28  56910  Station Forty-Eight: Seki, Early Departure from the Headquarters Inn / Utagawa Hiroshige / ca. 1833–34
p29  36971  Spring Rain at Tsuchiyama / Utagawa Hiroshige / 1834–35
p30  37208  Hara / Utagawa Hiroshige / 1847–52
p31  37248  Ōtsu / (作者の欄は空) / 1847–52
p32  55680  Shirasuka / Utagawa Hiroshige / early 20th century
p33  36977  Sunshower at Nihonbashi / Utagawa Hiroshige / 1833–34
p34  36935  Hara: Mount Fuji in the Morning (Hara, Asa no Fuji) / Utagawa Hiroshige / ca. 1833–34
p35  55989  Numazu / Utagawa Hiroshige / 1847–52
p36  55682  Yoshida / Utagawa Hiroshige / early 20th century
p37  55683  Goyu / Utagawa Hiroshige / early 20th century
p38  55685  Fujikawa / Utagawa Hiroshige / early 20th century
p39  37215  Mariko / Utagawa Hiroshige / ca. 1840
p40  36976  Kyoto: The Great Bridge at Sanjō (Taibi, Keishi, Sanjō Ōhashi) / Utagawa Hiroshige / ca. 1833–34
学習の設定
設定は、sd-scripts の公式の説明で SDXL に勧められている、VRAM を減らす設定を入れています。20 枚・ランク 16 の設定のファイルは次のとおりです。
# train_B20.toml(sdxl_train_network.py --config_file で読む)
pretrained_model_name_or_path = "C:/lora_work/models/sd_xl_base_1.0.safetensors"
dataset_config = "C:/lora_work/cfg/ds_bot20.toml"
output_dir = "C:/lora_work/out/B20"
output_name = "B20"
save_model_as = "safetensors"
save_precision = "fp16"
network_module = "networks.lora"
network_dim = 16                  # ランク
network_alpha = 8                 # ランクの半分
network_train_unet_only = true    # U-Net だけを学習
cache_text_encoder_outputs = true # 説明の文の計算結果を先に作っておく
cache_latents = true              # 画像を圧縮した形(latent)を先に作っておく
gradient_checkpointing = true     # 途中の計算を捨てて、あとで計算し直す
mixed_precision = "bf16"
optimizer_type = "AdamW8bit"
learning_rate = 0.0001
lr_scheduler = "constant"
max_train_steps = 1200
save_every_n_steps = 400
seed = 42
sdpa = true
max_data_loader_n_workers = 0
# ds_bot20.toml(画像の置き場と解像度。bot20 には b01.jpg と b01.txt のように、画像と説明の文を同じ名前で置く)
[general]
caption_extension = ".txt"
shuffle_caption = false

[[datasets]]
resolution = 1024
batch_size = 1
enable_bucket = true
min_bucket_reso = 640
max_bucket_reso = 1536
bucket_reso_steps = 64

  [[datasets.subsets]]
  image_dir = 'C:\lora_work\data\bot20'
  num_repeats = 1
cd C:\lora_work\sd-scripts
..\venv\Scripts\python.exe sdxl_train_network.py --config_file C:/lora_work/cfg/train_B20.toml
値の選び方は次のとおりです。
- network_alpha: 公式の説明で「network_dim の半分ほどが勧められる」とあるので、ランクの半分にしました。
- learning_rate: 公式の説明(train_network_advanced.md)では、U-Net の学習率は 1e-4〜4e-5 あたりから始めるのが一般的とされています。上の端の 1e-4 です。
- ステップ数: どの組も 1,200 ステップ(batch 1 なので絵を 1,200 回見る)にそろえました。10 枚なら 1 枚を 120 回、40 枚なら 30 回です。400 ステップごとに途中の LoRA も保存しました。
- text encoder(文を数字にする部品)は学習していません。説明の文の計算結果を先に作っておく設定(cache_text_encoder_outputs)は、text encoder を学習しないときだけ使えます。
8GB で実用になる設定・遅くなりすぎる設定
本番の前に、ロボットの 20 枚で、設定を 5 通りに変えて 30 ステップずつ流しました。1 回 10 分で打ち切る決まりです。
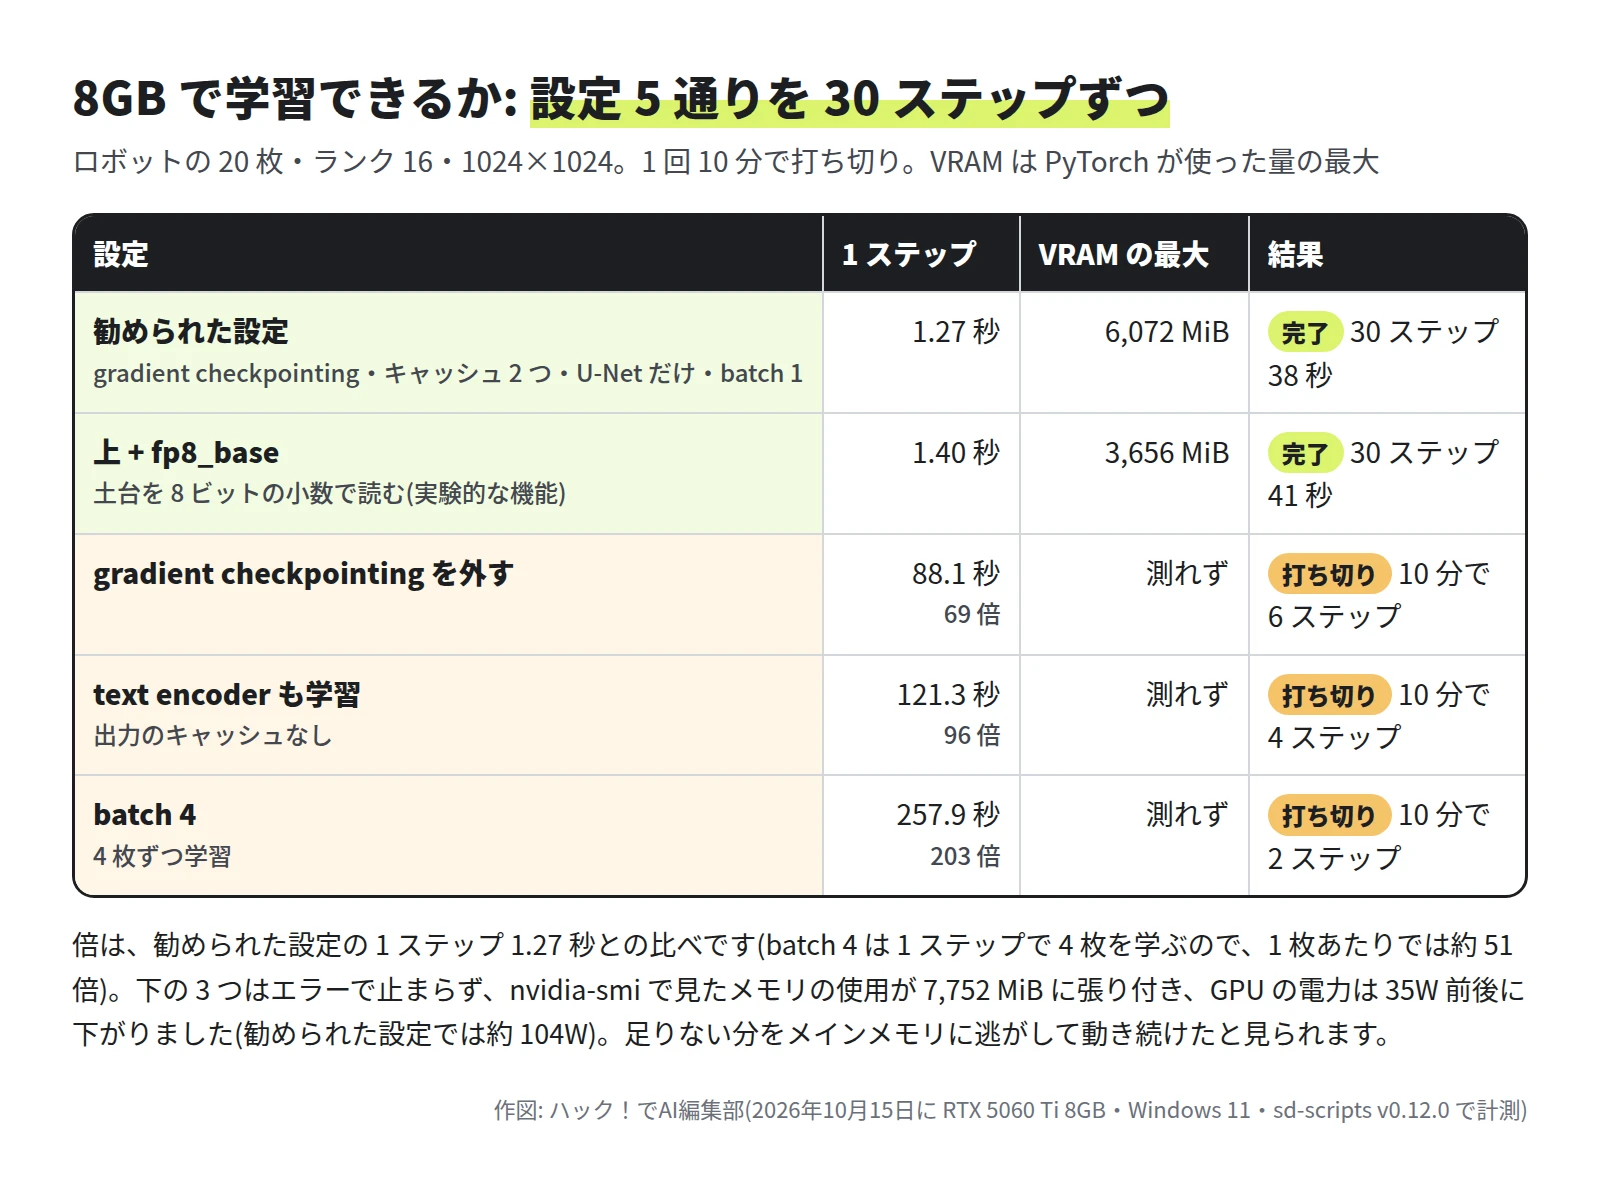
- 勧められた設定は、1 ステップ 1.27 秒、PyTorch が確保した VRAM は最大 6,798MiB(使った量は 6,072MiB)でした。nvidia-smi で見た GPU 全体の使用は最大 7,706MiB で、画面などがはじめから約 0.6〜0.7GB 使っていました。
- fp8_base(土台のモデルを 8 ビットの小数で読む、公式の説明で「実験的」とされる機能)を足すと、使った量は 3,656MiB(確保した量は 4,202MiB)に減り、1 ステップは 1.40 秒になりました。
- gradient checkpointing を外す・text encoder も学習する・4 枚ずつ学習する(batch 4) の 3 つは、エラーで止まりませんでした。10 分で進んだのは 6・4・2 ステップで、1 ステップは 88.1・121.3・257.9 秒と、勧められた設定の 69・96・203 倍です(batch 4 は 1 ステップで 4 枚を学ぶので、1 枚あたり約 51 倍)。このままなら 1,200 ステップに 29〜86 時間かかり、実用になりません。
見分け方は 2 つありました。1 ステップの秒数が急に数十倍になること、GPU の使用率が 95% 前後のまま、消費電力が 35W 前後に下がることです(勧められた設定では約 104W)。このとき、GPU のメモリの使用は 7,752MiB に張り付いていました。
学習の時間・VRAM・ファイルの大きさ
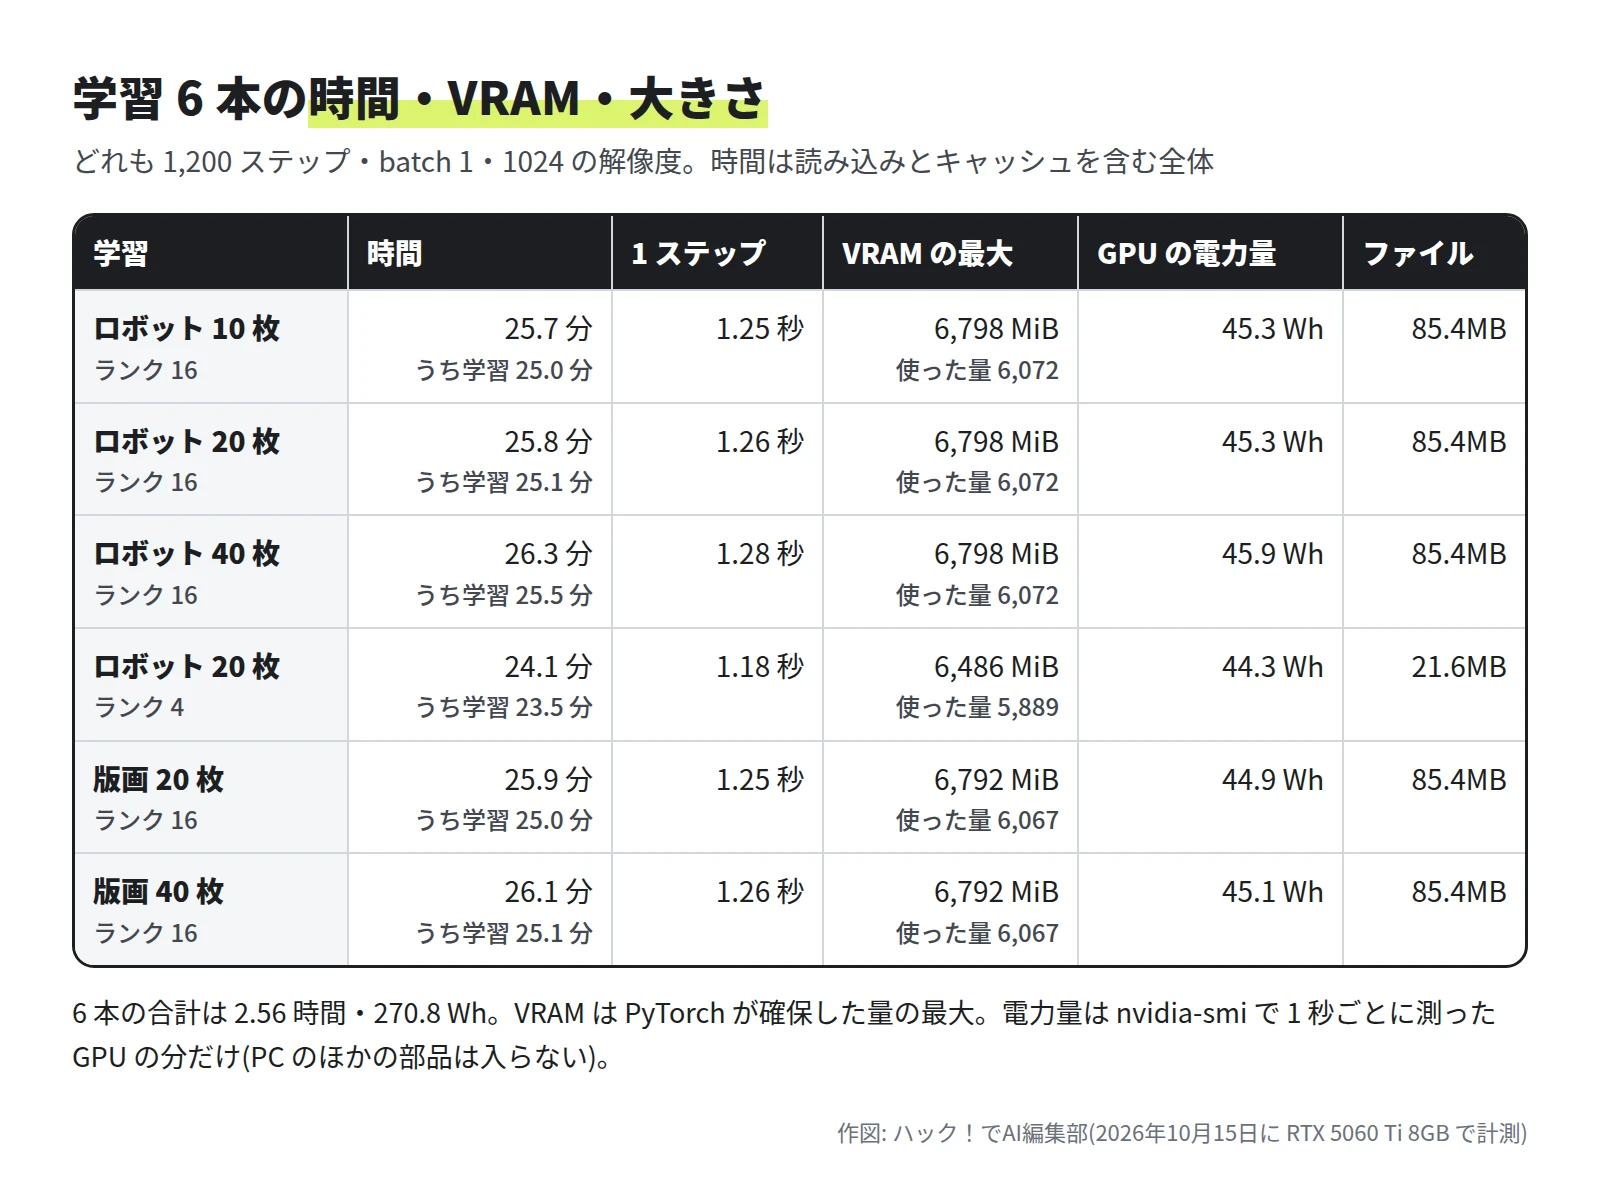
6 本とも、1 ステップは 1.18〜1.28 秒で、1,200 ステップの学習は、読み込みとキャッシュを含めて 24.1〜26.3 分でした。ステップ数をそろえたので、枚数を 10 枚から 40 枚にしても、時間は 25.7 分から 26.3 分でした。
GPU の電力は、学習中の平均で 106〜112W でした(NVIDIA の仕様の上限は 180W)。1 本あたり 44.3〜45.9Wh で、6 本の合計は 2.56 時間・270.8Wh でした。
効き方の数え方
学習した LoRA ごとに、同じ文・同じ種(乱数の元)で 12 枚ずつ作り、LoRA なしの 12 枚と比べました。文は 4 つ、種は 1001・1002・1003 の 3 つです。
- 生成: ComfyUI 0.39.0(追加のノードなし)・30 ステップ・CFG 7(文に従う強さ)・euler_ancestral・normal。LoRA は LoraLoaderModelOnly のノードで足し、重みは strength_model です。ロボットは 1024×1024、版画は 1216×832。
- LoRA なしも、同じ文(合図の語を含む)をそのまま渡しました。
ロボットに渡した文(全文)です。
hdabot robot standing in a forest, morning light
hdabot robot sitting on a wooden bench in a city park
hdabot robot walking on a beach at sunset
hdabot robot on a kitchen table next to a cup of coffee, close-up photo
版画(画風)に渡した文(全文)です。
hdaprint, a modern train crossing a bridge over a river
hdaprint, a convenience store at night in the rain
hdaprint, people walking in a snowy mountain village
hdaprint, a cat sleeping on a windowsill
否定の文(出してほしくない物。全部の絵で同じ)です。
lowres, blurry, text, watermark, signature
目印は、絵を作る前に決めました。
- ロボット: ①白とだいだい色の 2 色のたまご形の体 ②黒い画面に水色の丸い目が 2 つ ③先が緑の玉のアンテナ。3 つがそろったら「効いた」。ほかに、背景が文のとおりか、崩れ(形が溶ける・目や手足の数が狂う・色が焼ける・ノイズ)があるか。
- 版画: ①黒か濃い色の輪郭線 ②平らな色の塗り(写真のような陰影がない)。2 つがそろったら「効いた」。ほかに、文の物が描かれているか、題の札や文字・印のような四角が出たか(学習の画像の写し過ぎの目印)、崩れ。
数えたのは編集部です。Gemini 3.8 Flash にも同じ目印を 6 枚ずつ尋ね(渡した文は記事の最後)、「効いた」の判定が 192 枚中 187 枚で一致しました。
枚数で効き方はどう変わるか(ロボット)
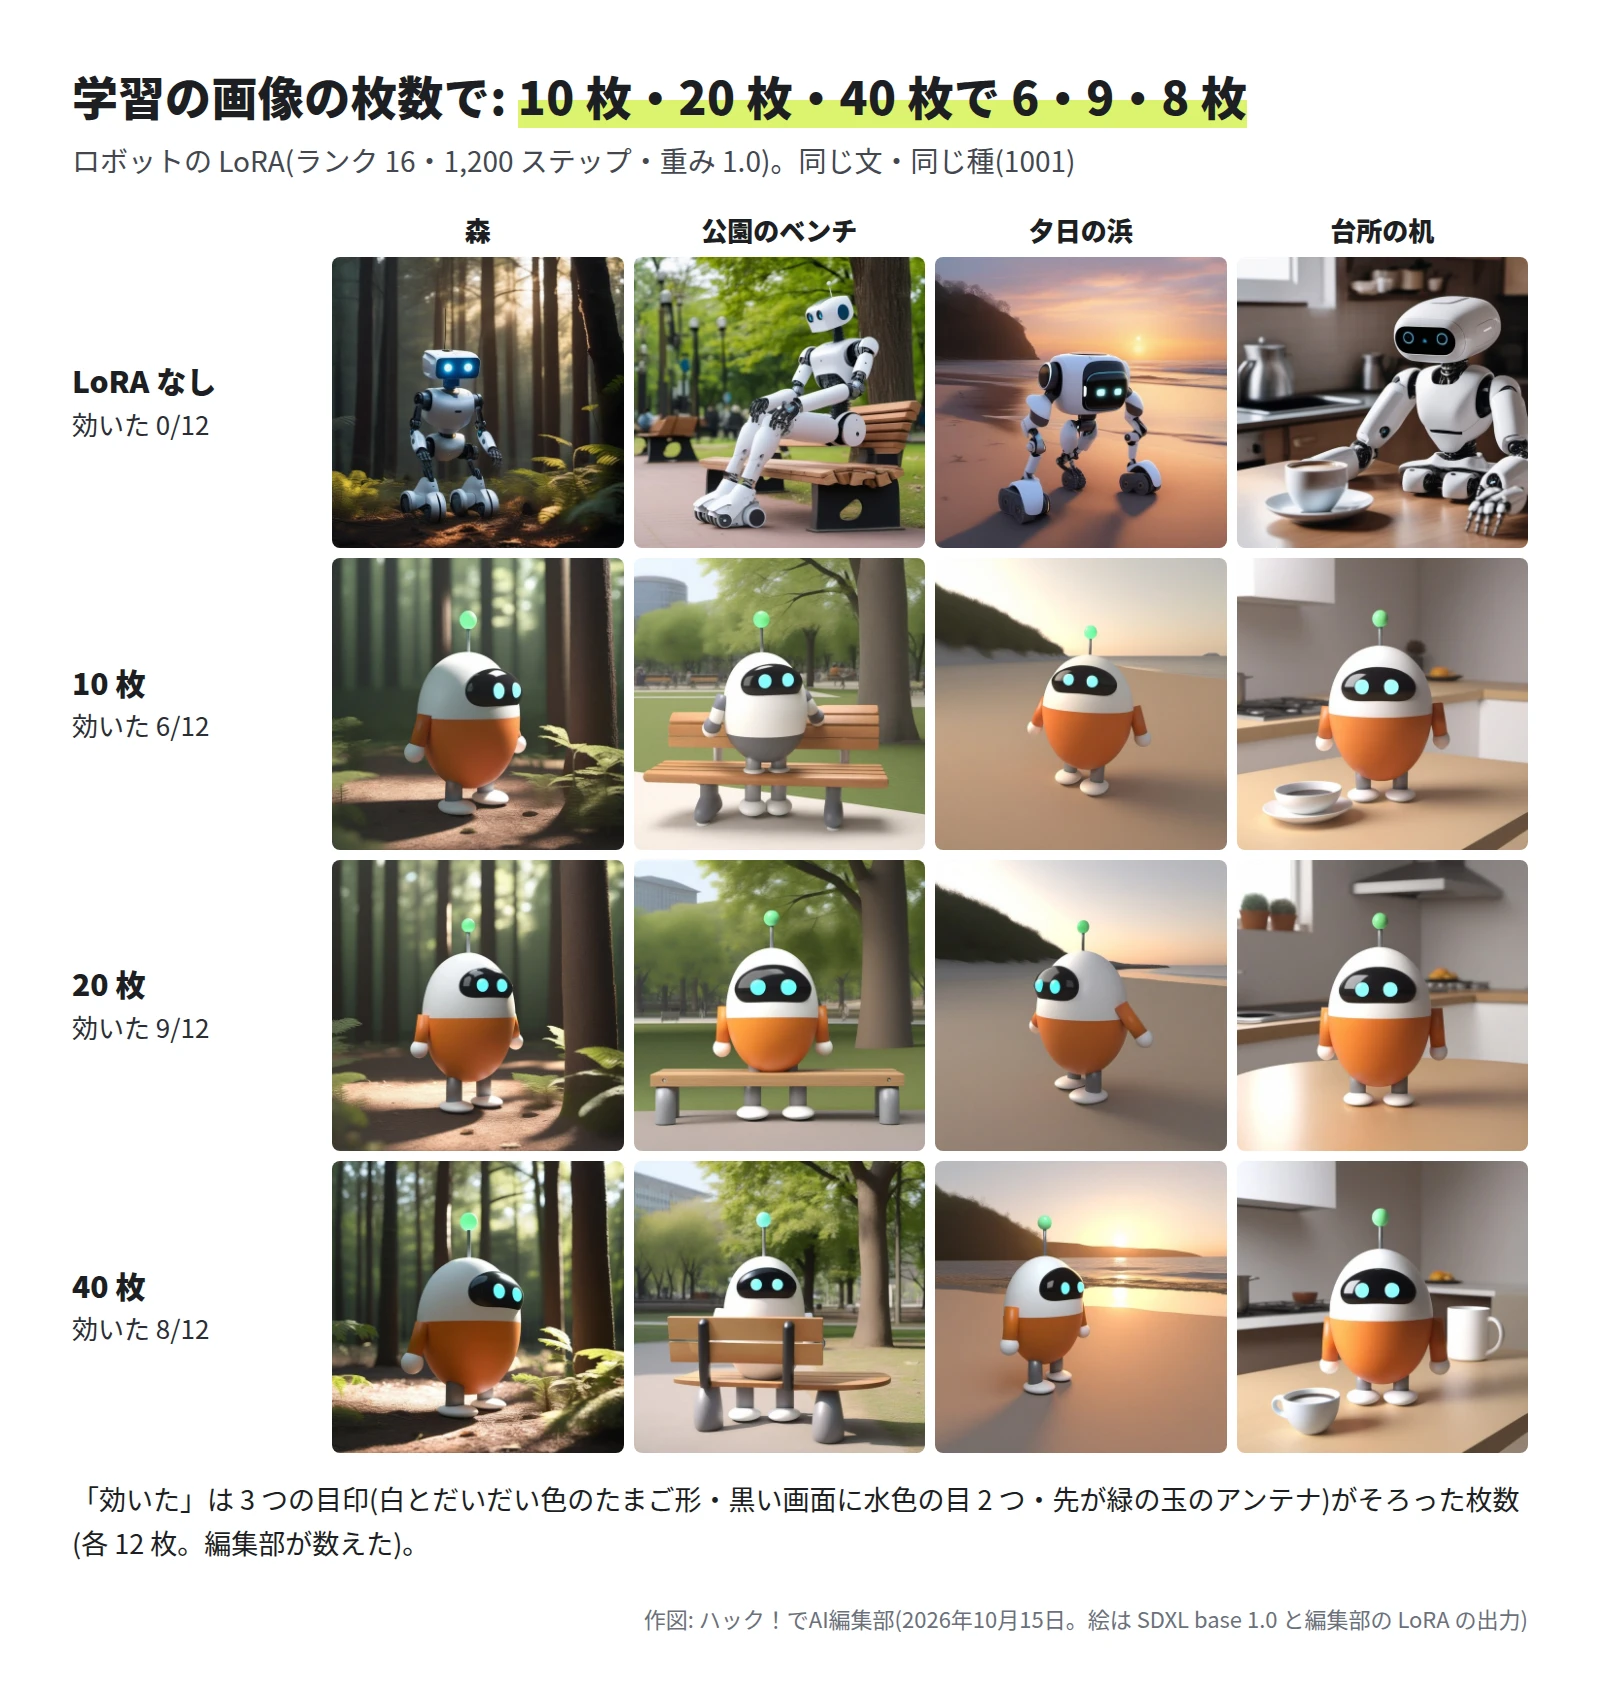
| 枚数 | 効いた | ①体の 2 色 | ②黒い画面と目 | ③緑の玉のアンテナ | 崩れ |
|---|---|---|---|---|---|
| なし | 0/12 | 0/12 | 4/12 | 0/12 | 0/12 |
| 10 枚 | 6/12 | 7/12 | 12/12 | 11/12 | 0/12 |
| 20 枚 | 9/12 | 11/12 | 11/12 | 11/12 | 1/12 |
| 40 枚 | 8/12 | 9/12 | 12/12 | 10/12 | 0/12 |
10 枚でも、黒い画面と水色の目は 12 枚すべてに、緑の玉のアンテナは 11 枚に出ました。足りなかったのは体の 2 色です。10 枚では、体の下が灰色の絵が 3 枚、だいだい色が腕だけの絵が 1 枚、白だけの絵が 1 枚でした。20 枚にすると、体の 2 色は 12 枚中 11 枚に増えました。
40 枚は 8/12 で、20 枚(9/12)と 1 枚違いです。12 枚ずつの比べでは、この差で順位は決められません。また、ステップ数をそろえたので、40 枚の組は 1 枚を 30 回しか見ていません(20 枚の組は 60 回)。枚数とステップ数を一緒に増やす比べは、試していません。
LoRA なしの絵は、白い人型や車輪のついたロボットで、②の「黒い画面と水色の目」だけが 4 枚に出ました。
ステップ数とランク(ロボット)
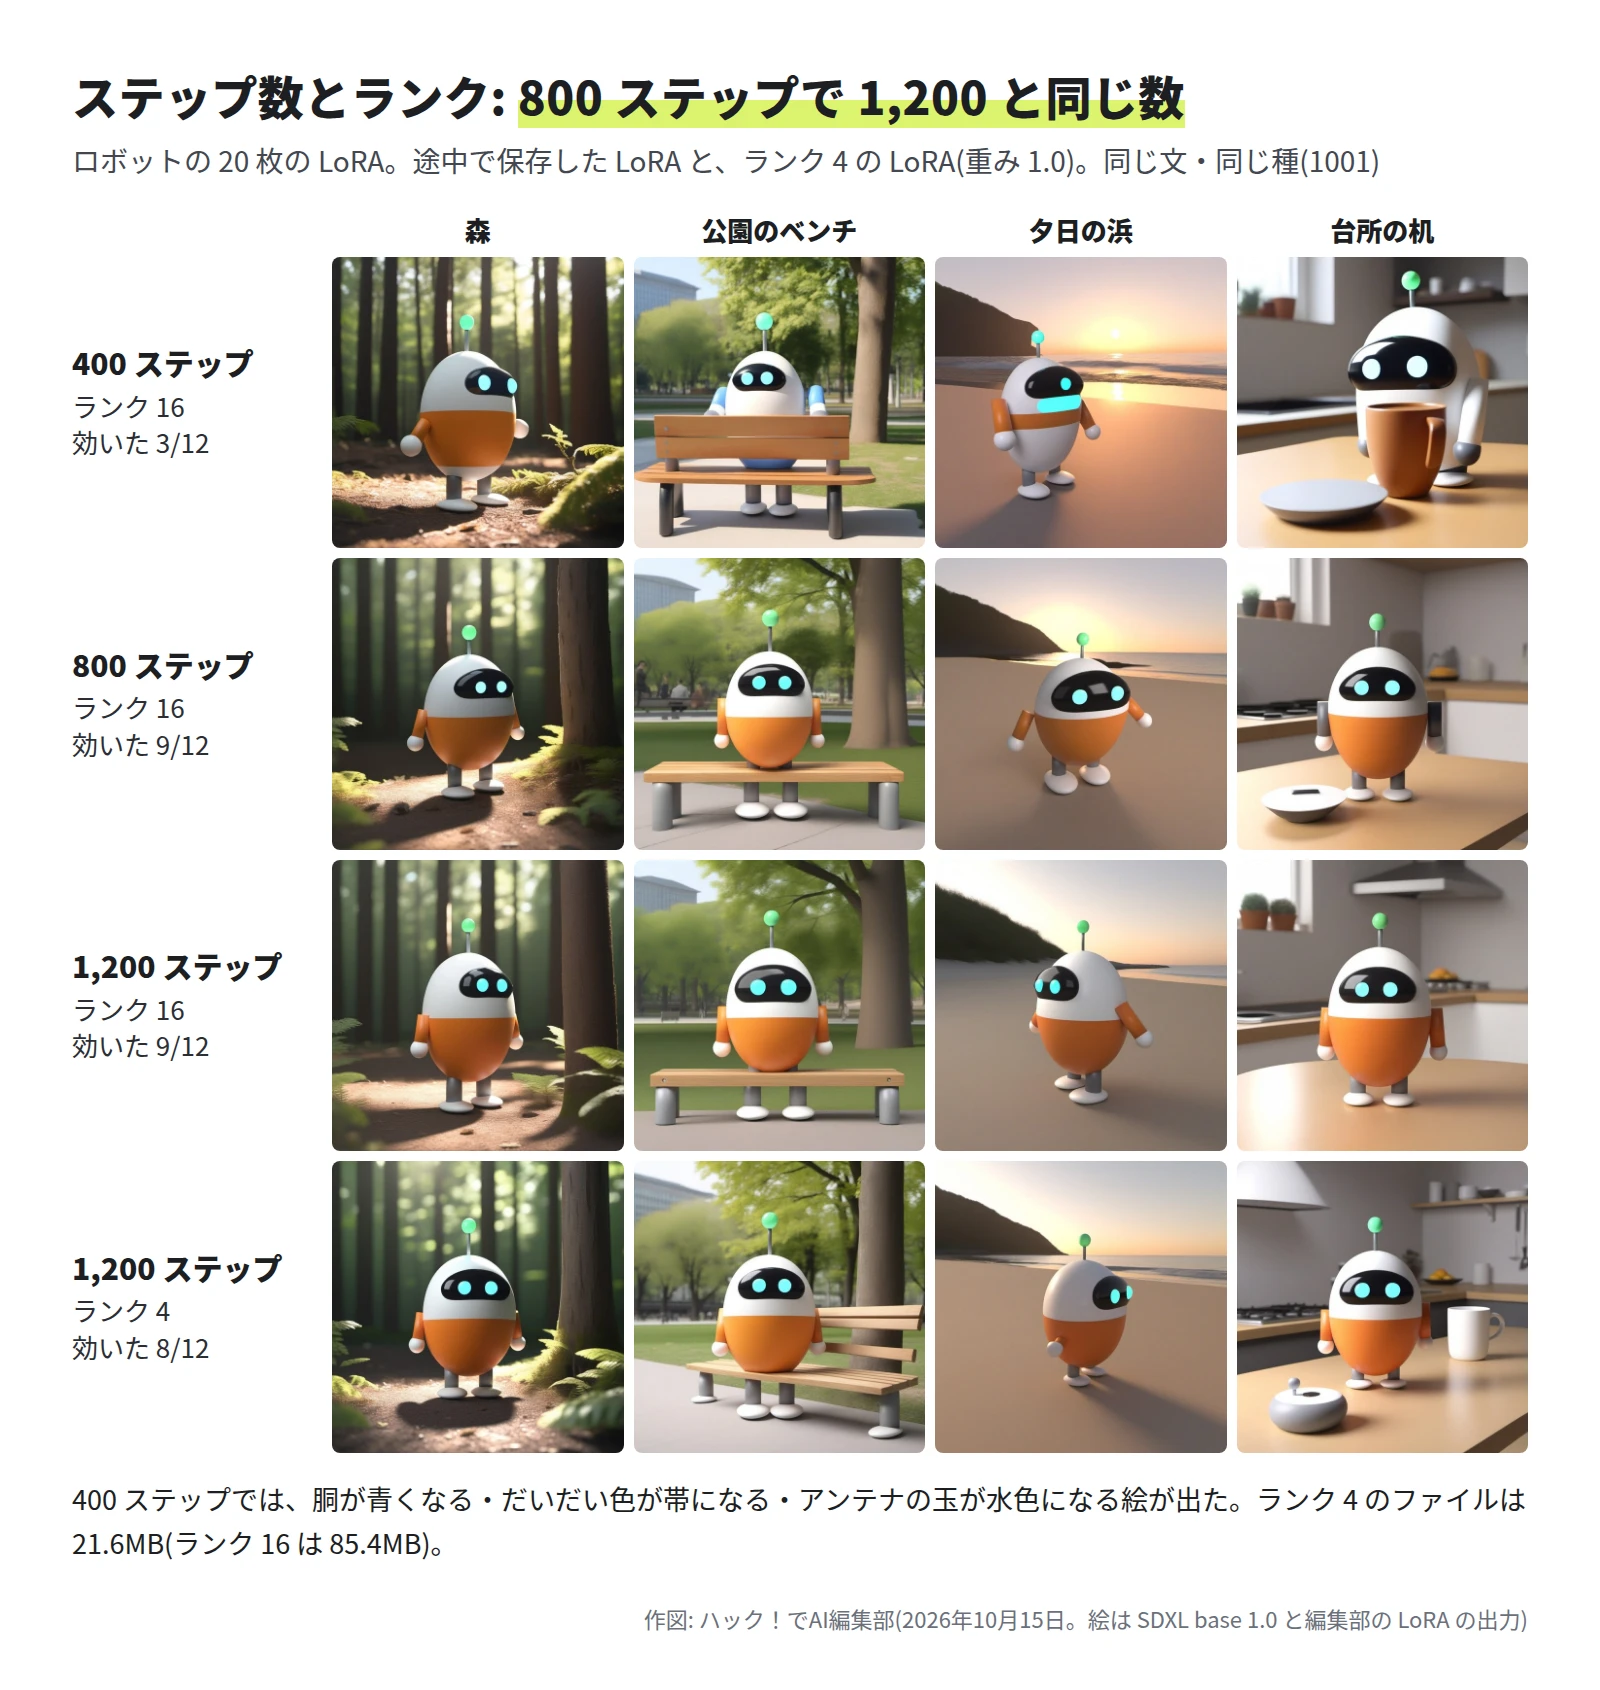
| 条件 | 効いた | ファイル | 1 ステップ | 学習の時間 |
|---|---|---|---|---|
| ランク 16・400 ステップ(途中) | 3/12 | 85.4MB | 1.26 秒 | (途中の保存) |
| ランク 16・800 ステップ(途中) | 9/12 | 85.4MB | 1.26 秒 | (途中の保存) |
| ランク 16・1,200 ステップ | 9/12 | 85.4MB | 1.26 秒 | 25.8 分 |
| ランク 4・1,200 ステップ | 8/12 | 21.6MB | 1.18 秒 | 24.1 分 |
400 ステップでは、胴が青くなる、だいだい色が帯になる、アンテナの玉が水色になる絵が出て、3 つがそろったのは 3 枚でした。800 ステップで 9 枚になり、1,200 ステップと同じ数でした。12 枚の数では、800 ステップ(学習の部分で約 17 分)と 1,200 ステップの差は見えません。
ランク 4 は 8/12 で、ランク 16 の 9/12 と 1 枚違いです。ファイルは 21.6MB で、ランク 16 の約 4 分の 1 でした。1 ステップは 1.18 秒で、ランク 16 より約 6% 速く、PyTorch が確保した VRAM は 6,486MiB(ランク 16 は 6,798MiB)でした。
重みと崩れ(ロボット)
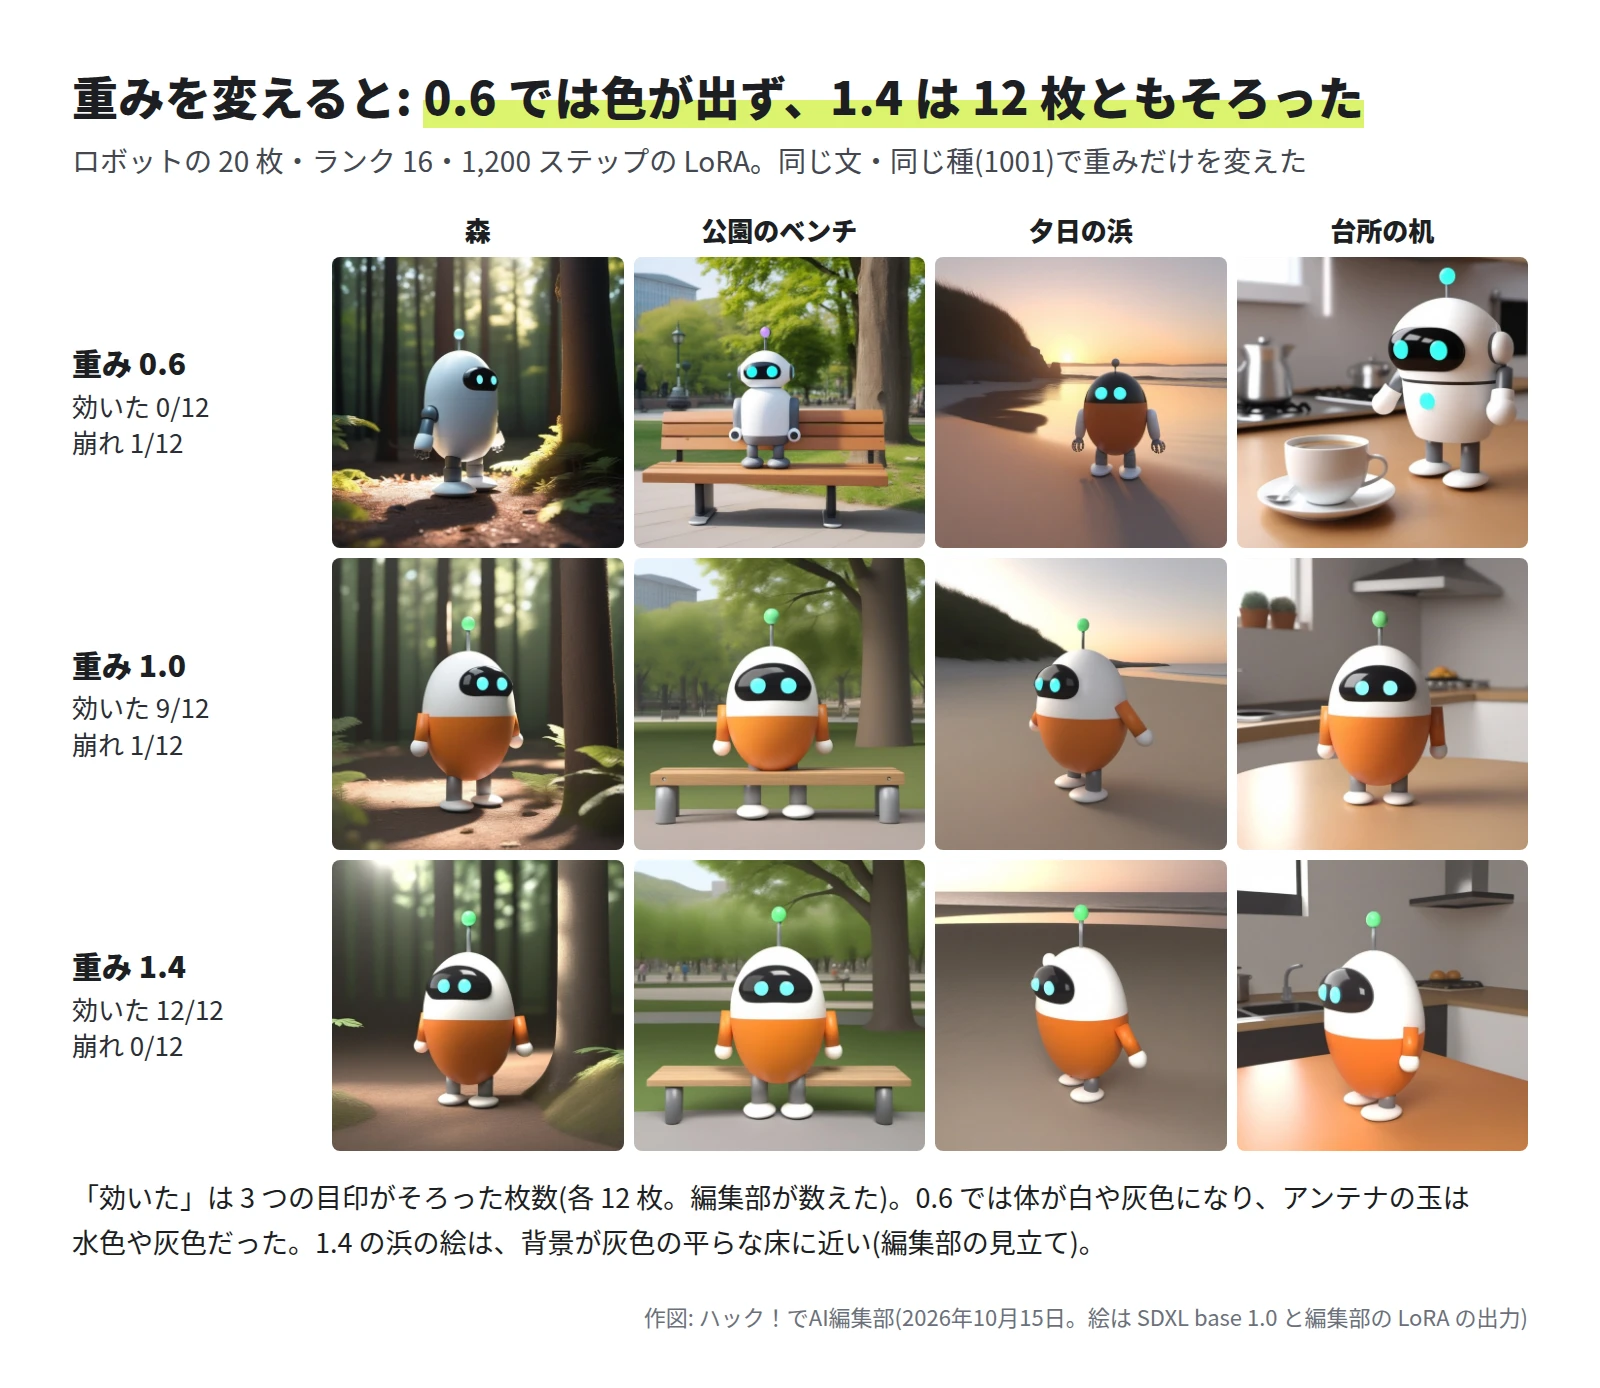
| 重み | 効いた | 背景が文のとおり | 崩れ |
|---|---|---|---|
| なし(LoRA なし) | 0/12 | 12/12 | 0/12 |
| 0.6 | 0/12 | 12/12 | 1/12 |
| 1.0 | 9/12 | 12/12 | 1/12 |
| 1.4 | 12/12 | 12/12 | 0/12 |
重み 0.6 では、黒い画面と水色の目は 12 枚中 11 枚に出ましたが、白とだいだい色の体は 1 枚も出ませんでした。体は白や灰色になり、アンテナの玉は水色や灰色でした。重み 1.4 では 12 枚とも 3 つがそろい、崩れも出ませんでした。崩れは、1.0 の台所の 1 枚で体に目のような黒い丸が 2 つ増えたもの、0.6 の台所の 1 枚で胴にもう 1 つ顔が出たものです。
画風の LoRA(版画)
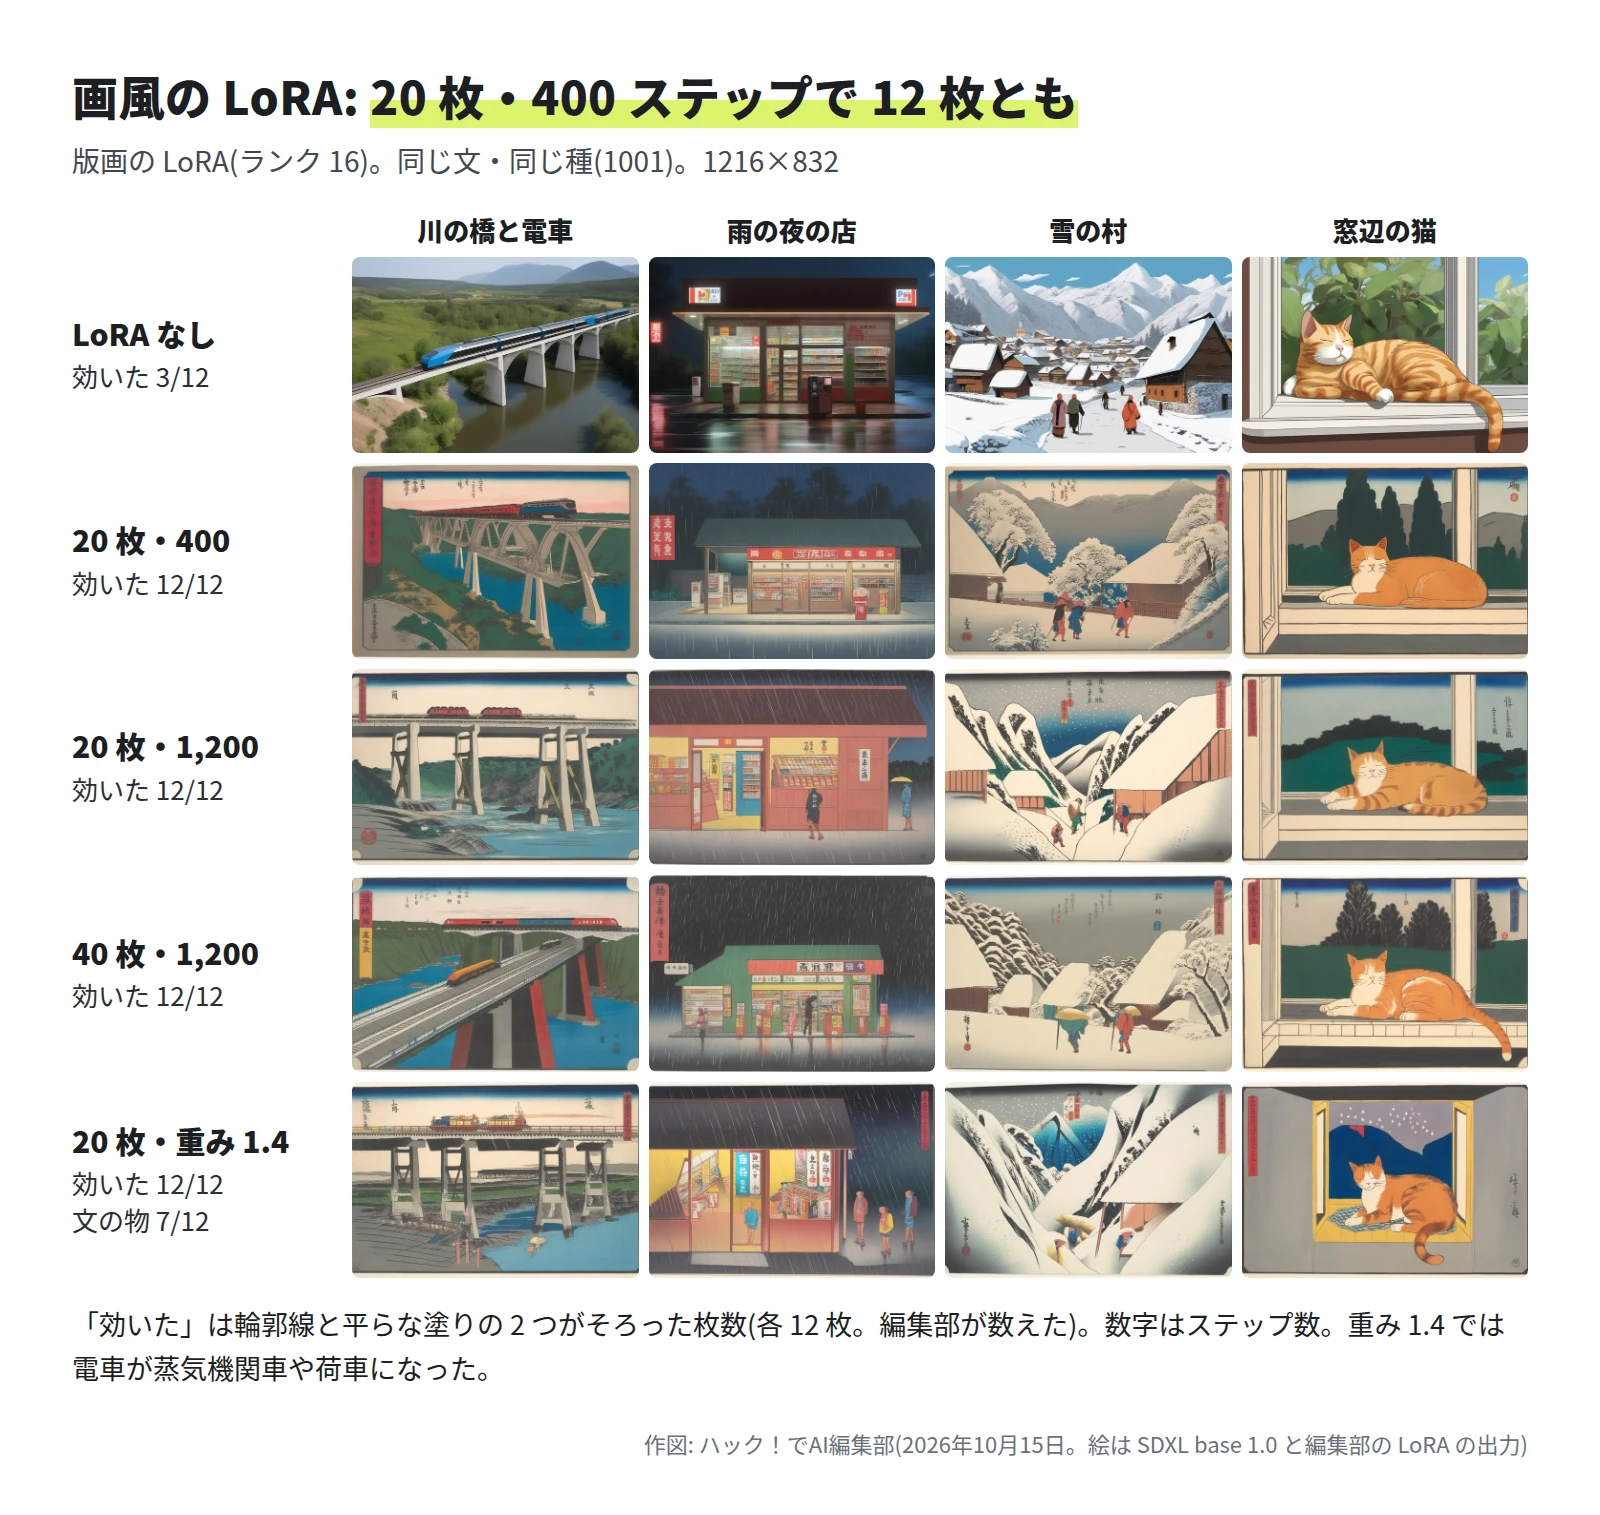
| 条件 | 効いた | 文の物 | 題の札や文字・印 |
|---|---|---|---|
| なし | 3/12 | 12/12 | 3/12(店の看板の文字) |
| 20 枚・400 ステップ | 12/12 | 12/12 | 12/12 |
| 20 枚・800 ステップ | 12/12 | 11/12 | 12/12 |
| 20 枚・1,200 ステップ | 12/12 | 11/12 | 12/12 |
| 20 枚・重み 0.6 | 9/12 | 12/12 | 11/12 |
| 20 枚・重み 1.4 | 12/12 | 7/12 | 12/12 |
| 40 枚・1,200 ステップ | 12/12 | 12/12 | 12/12 |
画風の 2 つの目印は、20 枚・400 ステップの時点で 12 枚ともそろいました。LoRA なしでも、雪の村と猫の絵の一部は輪郭線のあるイラストになり、3 枚が「効いた」に入りました。
学習の画像の写し過ぎ
LoRA が覚えるのは、覚えさせたい物だけではありません。今回は 3 つの形で出ました。
- 題の札・文字・印: 版画の LoRA は、重み 1.0 以上ではどの条件でも 12 枚すべてに、縦長の題の札や文字のような線、赤い印が入りました。学習の版画のほぼすべてにある札と印を説明の文に書かなかったため、合図の語といっしょに覚えたと見られます。
- 描く物が昔に寄る: 重み 1.4 では、「今の電車」の文で 3 枚とも蒸気機関車や荷車が描かれました。眠る猫の文でも、目を開けた猫が出ました。
- 背景と姿勢: ロボットの重み 1.4 では、浜と台所の背景が、学習の画像のような灰色の平らな床に近づきました(編集部の見立て。数には表れていない)。ベンチの絵では、座らずに座面に立つロボットもいました(学習の画像に座った姿はない)。
LoRA なしの絵では、合図の語「hdaprint」が店の看板の文字(HDAPRINT など)として描かれました。一方、学習の版画の構図をそのまま写した絵は、LoRA を使った 72 枚には見当たりませんでした(編集部の見立て)。
編集部が次に試すなら、写したくない物を説明の文に書く(例: title cartouche, seal)、学習の画像から札や印を切り取る、の 2 つです。今回はどちらも試していません。
費用: 自分の PC とクラウドの GPU
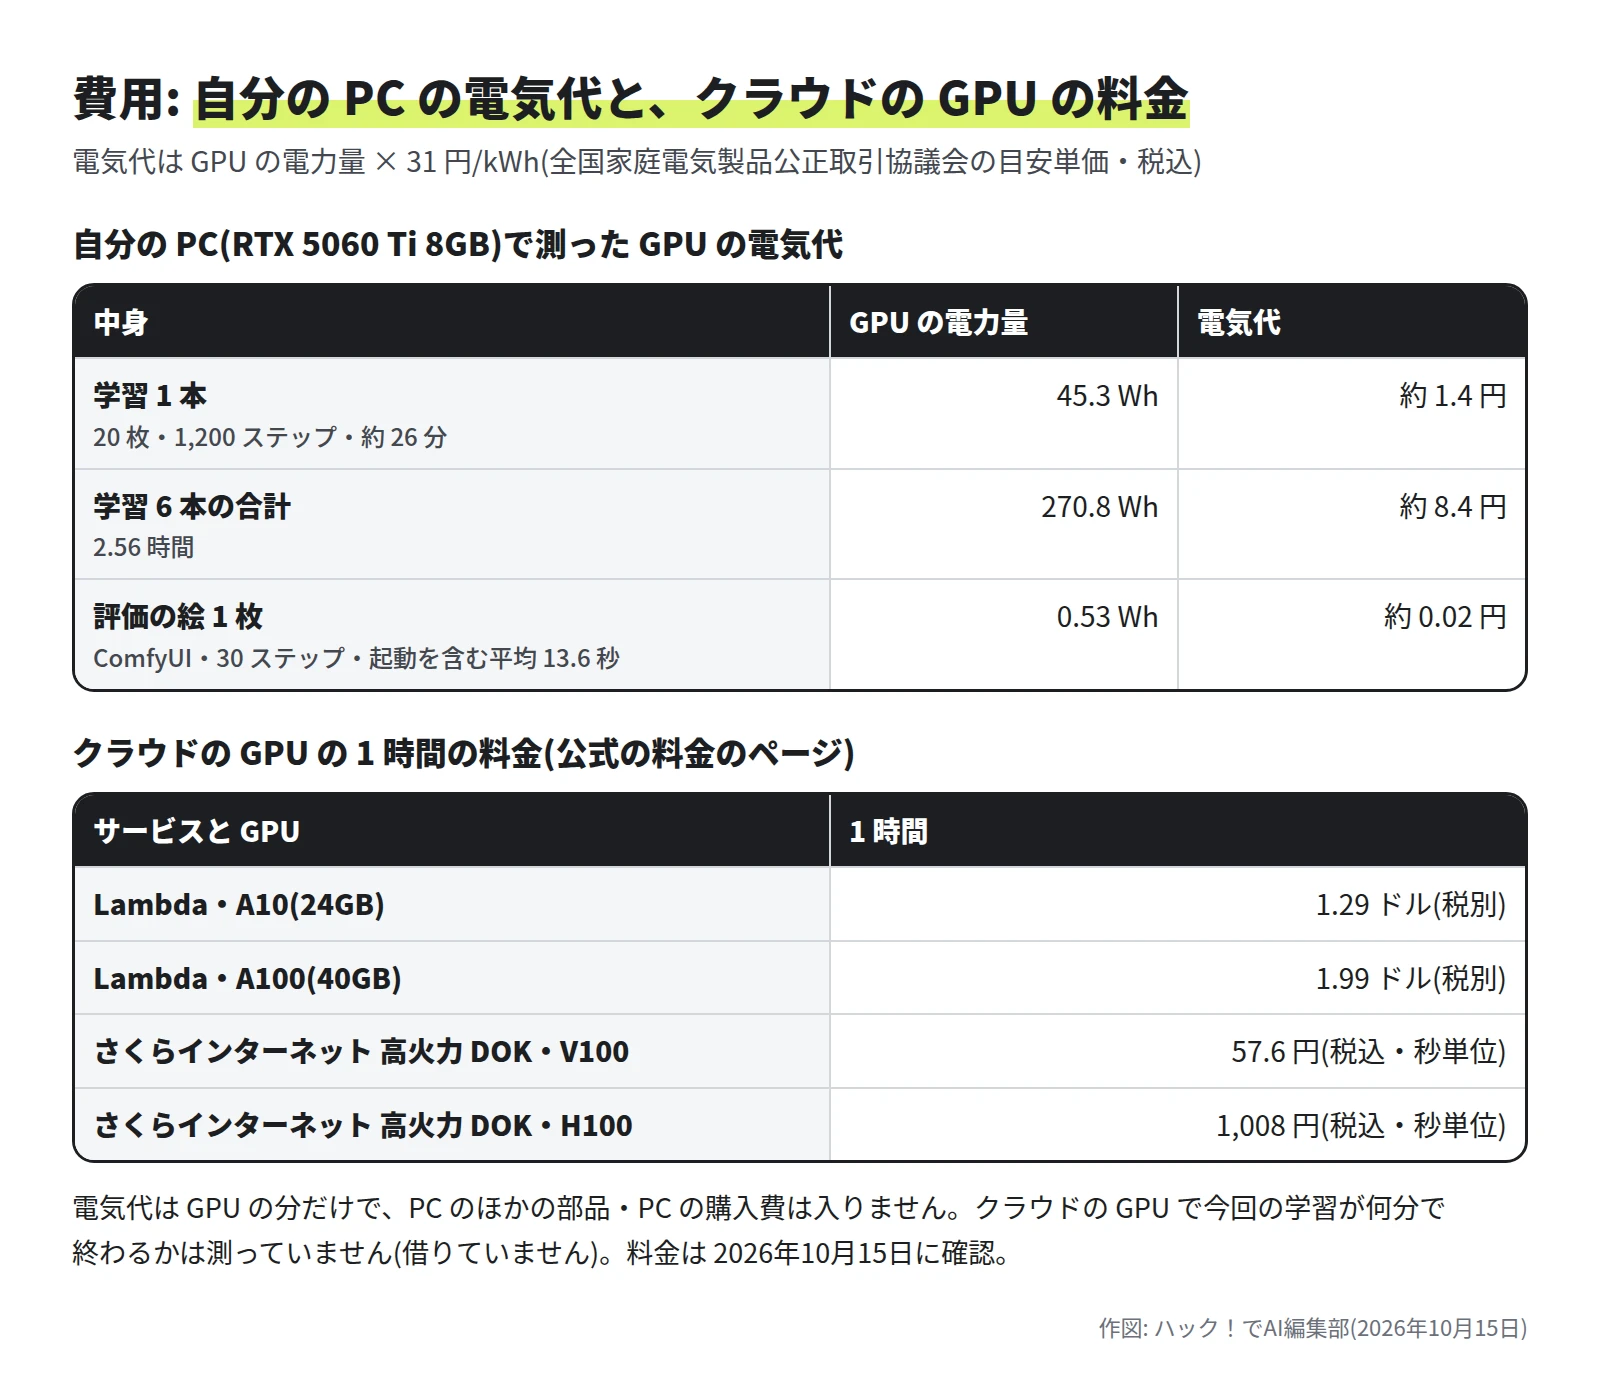
GPU の電力量に、全国家庭電気製品公正取引協議会の目安単価 31 円/kWh(税込)を掛けました。学習 1 本は約 1.4 円、6 本で約 8.4 円です。評価の絵は 1 枚 0.53Wh(ComfyUI の起動を含む平均)で、約 0.02 円でした。PC のほかの部品の電力と、PC の購入費は入っていません。
クラウドの GPU の料金は、公式の料金のページで確かめた値です(高火力 DOK はプランごとに最低の利用時間あり)。借りていないので、同じ学習が何分で終わるかは分かりません。
8GB の GPU の PC がすでにあるなら、GPU の電気代は 1 本 2 円未満でした。text encoder も学習するなど、8GB では遅くなりすぎた設定を試すなら、VRAM の大きいクラウドの GPU を時間で借りる方法があります。
LLM の LoRA(QLoRA)
LoRA の論文は、もともと GPT-3 のような文章のモデル(LLM)のための方法です。LLM 向けの方法の 1 つに、2023年に Dettmers ほかが発表した QLoRA があります。論文によると、土台のモデルを 4 ビットに縮めて固定し、LoRA だけを学習します。この方法で、650 億個の数値のモデルを 48GB の GPU 1 枚で調整できたとされています。今回、文章のモデルの LoRA は試していません。
気をつけること
- 1 回ずつの学習です。各条件は 12 枚で数えています。1〜2 枚の差で順位を決めないでください。
- Windows ではメモリ不足でも止まらないことがあります。1 ステップの秒数と GPU の消費電力を見てください。
- 土台は SDXL base 1.0 だけです。SD 3.5 Medium など、ほかの土台のモデルは試していません。
- 土台のモデルの決まり: SDXL base 1.0 の CreativeML Open RAIL++-M には、使い方の制限(法に反する用途などの禁止)があります。使う前に読んでください。
- 学習の画像の権利: 自分で作った物か、使ってよいと確かめた物にしてください。今回は自社で作った 3D の絵と、CC0 の版画だけです。
まとめ
- 8GB の GPU でも、gradient checkpointing・2 つのキャッシュ・U-Net だけ・batch 1 なら、SDXL の LoRA は 1 本 24〜26 分で学習できました。gradient checkpointing を外す・text encoder も学習する・batch 4 にする、のどれでも、エラーは出ないまま 1 ステップが 69〜203 倍の秒数になりました(30 ステップの試し)。
- 今回のロボットでは、20 枚・800 ステップから枚数やステップを増やしても効いた数は増えず(差は 0〜1 枚)、ランク 4(21.6MB)も 1 枚差でした。
- 画風は 400 ステップで出ましたが、題の札や印まで写りました。写したくない物は、学習の画像と説明の文の側で手当てが要ります。
採点に渡した文(全文)
Gemini 3.8 Flash には、6 枚の絵に番号 1〜6 を付けた 1 枚のシートを、32 回渡しました(YOBITSUGI AI の ask_ai・tier は既定)。シートごとに替えたのは「各絵の指示」の行だけです。
ロボットのシート(18 回)です。
番号 1〜6 の 6 枚の絵が並んでいます。1 枚ずつ、次の 5 つに yes か no で答えてください。
M1: 体がたまご形のロボットで、体の上の側が白、下の側がだいだい色(オレンジ)の 2 色に分かれている
M2: ロボットの顔に黒い画面があり、その中に水色の丸い目が 2 つある
M3: ロボットの頭のてっぺんから、先に緑の玉がついたアンテナが 1 本立っている
BG: 背景が、その絵の指示の場所になっている(各絵の指示は下のとおり)
BROKEN: 形が溶けている・目や手足の数がおかしい・色が焼けたように飛んでいる・ノイズが多い、のどれかがある
各絵の指示: 1: 朝の光の森 / 2: 朝の光の森 / 3: 朝の光の森 / 4: 街の公園の木のベンチ / 5: 街の公園の木のベンチ / 6: 街の公園の木のベンチ
返事は JSON だけ。形: {"1":{"M1":"yes","M2":"no","M3":"yes","BG":"yes","BROKEN":"no"}, … "6":{…}}
版画のシート(14 回)です。
番号 1〜6 の 6 枚の絵が並んでいます。1 枚ずつ、次の 5 つに yes か no で答えてください。
S1: 黒か濃い色の輪郭線で、物の形が描かれている
S2: 色が平らに塗られていて、写真のような陰影や質感がない
SUB: その絵の指示の物が描かれている(各絵の指示は下のとおり)
CART: 絵の中に、題の札・文字・印(はんこ)のような四角い区画がある
BROKEN: 形が溶けている・色が焼けたように飛んでいる・ノイズが多い、のどれかがある
各絵の指示: 1: 川にかかる橋を渡る今の電車 / 2: 川にかかる橋を渡る今の電車 / 3: 川にかかる橋を渡る今の電車 / 4: 雨の夜のコンビニ / 5: 雨の夜のコンビニ / 6: 雨の夜のコンビニ
返事は JSON だけ。形: {"1":{"S1":"yes","S2":"no","SUB":"yes","CART":"no","BROKEN":"no"}, … "6":{…}}
「各絵の指示」の行は、次の 4 通りです。
各絵の指示: 1: 朝の光の森 / 2: 朝の光の森 / 3: 朝の光の森 / 4: 街の公園の木のベンチ / 5: 街の公園の木のベンチ / 6: 街の公園の木のベンチ
各絵の指示: 1: 夕日の浜辺 / 2: 夕日の浜辺 / 3: 夕日の浜辺 / 4: 台所の机の上 / 5: 台所の机の上 / 6: 台所の机の上
各絵の指示: 1: 川にかかる橋を渡る今の電車 / 2: 川にかかる橋を渡る今の電車 / 3: 川にかかる橋を渡る今の電車 / 4: 雨の夜のコンビニ / 5: 雨の夜のコンビニ / 6: 雨の夜のコンビニ
各絵の指示: 1: 雪の山の村を歩く人たち / 2: 雪の山の村を歩く人たち / 3: 雪の山の村を歩く人たち / 4: 窓辺で眠る猫 / 5: 窓辺で眠る猫 / 6: 窓辺で眠る猫
参考にした公式の情報
- arXiv「LoRA: Low-Rank Adaptation of Large Language Models」(Hu ほか, 2021)
- arXiv「QLoRA: Efficient Finetuning of Quantized LLMs」(Dettmers ほか, 2023)
- GitHub kohya-ss/sd-scripts(README・v0.12.0)
- sd-scripts ドキュメント「train_network.md」(LoRA の学習)
- sd-scripts ドキュメント「sdxl_train_network.md」(SDXL の LoRA)
- sd-scripts ドキュメント「train_network_advanced.md」(VRAM を減らす設定・学習率)
- Hugging Face「stabilityai/stable-diffusion-xl-base-1.0」(CreativeML Open RAIL++-M)
- NVIDIA「System Memory Fallback for Stable Diffusion」
- The Met Collection API(isPublicDomain の説明)
- The Met「Image and Data Resources」(Open Access・CC0)
- GitHub Comfy-Org/ComfyUI
- NVIDIA GeForce RTX 5060 ファミリー(仕様表)
- 全国家庭電気製品公正取引協議会「よくある質問」(電力料金の目安単価)
- Lambda「Pricing」
- さくらインターネット「高火力 DOK」
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
AI技術大全全 2 回の目次
- 1RAG の精度を上げるには? チャンク・ハイブリッド検索・リランクを順に足して測った
- 2LoRA の作り方 8GB の GPU で画像の LoRA を学習し、枚数と時間を測った(この記事)