 佐々木 航
この記事でわかること
- 104万通りの答えを全部数えて分かった、診断の偏りの原因
- 絵柄をそろえるために、4体を1枚に描かせた理由
- 結果の文を、誰にでも当てはまる言い方にしない書き方
確認した環境: Claude Codeで作成(HTMLとJavaScript、全通りの判定はNode.js 24.22)/ 絵はYOBITSUGI AI(gpt-image-2.5-flare)/ 2026年10月28日
10問・4択の診断を作り、答え方1,048,576通りをすべて判定すると、4つのタイプのうち「下書き派」が31.5%、「しくみ派」は17.5%でした。問いの数はどのタイプにも同じだけあるのに、同点のときの決め方ひとつで、結果がここまで偏ります。
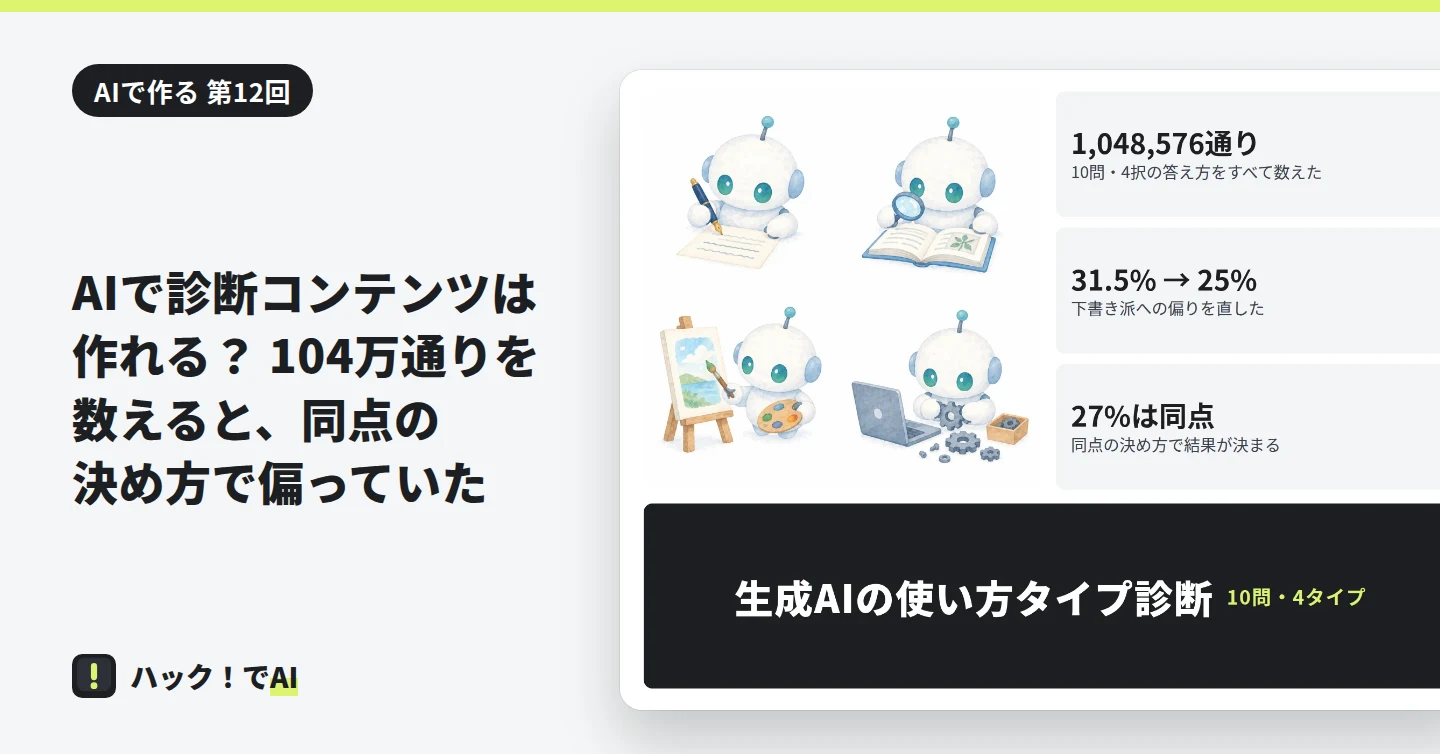
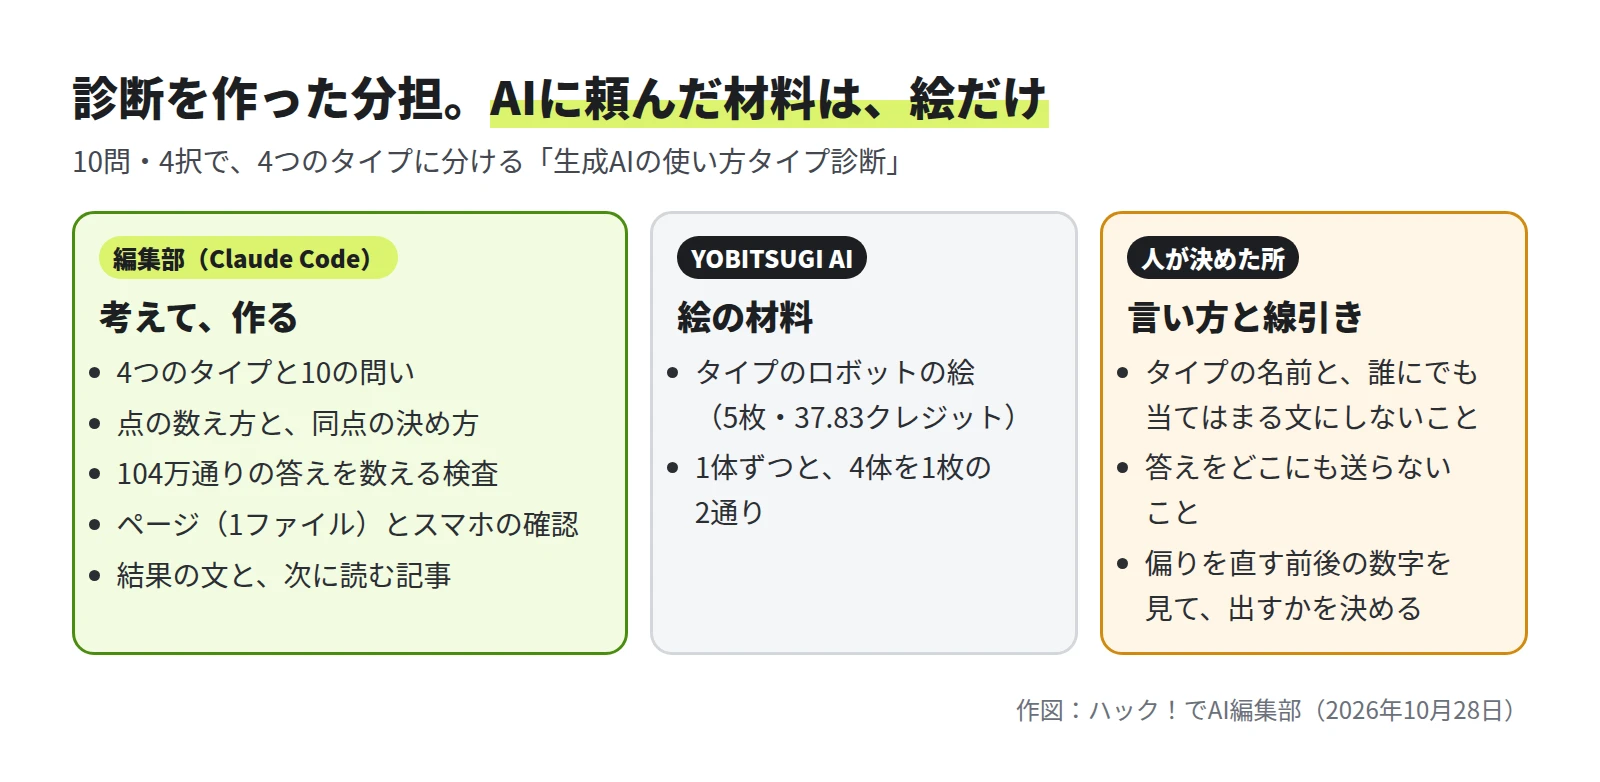
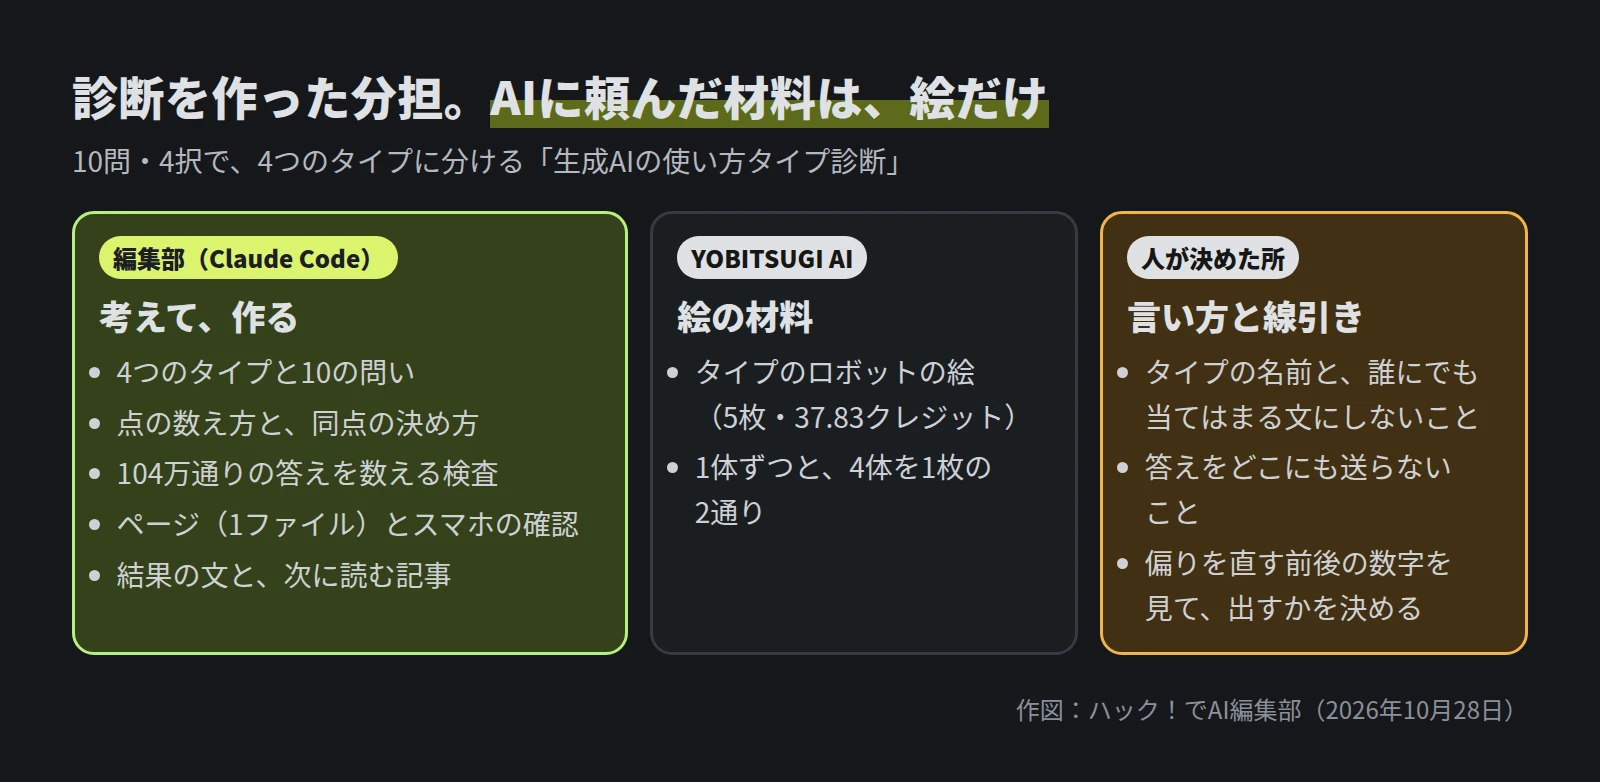
作ったのは「生成AIの使い方タイプ診断」です。問いと点の数え方、ページ、偏りの検査は編集部がClaude Codeと作り、タイプの絵だけをYOBITSUGI AIで描きました。直したあとの診断は、下のページで遊べます。
YOBITSUGI AI(複数のAIをまとめて使えるサービス)とハック!でAIは、どちらも株式会社Gameが運営しています。絵の5枚で使ったのは37.83クレジットです。
10問・4択で、4つのタイプに分けた
診断は、SNSで結果を見せ合う形でよく回ってきます。作るだけなら、問いと答えを並べるだけで済みそうに見えます。けれど実際に作ると、「タイプが偏っていないか」と「結果が当たっていると感じられるか」の2つで手が止まりました。
タイプは、生成AIの使い方で4つに分けました。
| タイプ | どんな使い方か | 結果で案内する記事 |
|---|---|---|
| 下書き派 | メールや報告書のたたき台を作らせる | 頼み方のコツ、4つのAIに同じ仕事を頼んだ比べ |
| 調べもの派 | 資料を読ませて、要点と出典をまとめさせる | 生成AIの使い分け、プロンプト集のまとめ |
| つくる派 | 絵や動画や音を作って人に見せる | 年賀状の回、ショート動画の回 |
| しくみ派 | くり返しの作業をClaude CodeやCopilotに任せる | Claude Codeとは、Copilotのエージェントモード |
問いは10個で、どれも4つの答えから選びます。「AIを開いて、最初にすることが多いのは?」に「書きかけの文章を貼る」と答えれば下書き派に1点、「気になることを質問する」なら調べもの派に1点、という作りです。10問の点を足して、いちばん多いタイプが結果になります。
104万通りを全部数えると、1版目は下書き派に寄っていた
10問・4択の答え方は、4の10乗で1,048,576通りしかありません。乱数で答えを作って試すより、全部の答え方を判定したほうが確かです。Node.jsで数えると、1回1.3秒ほどで終わりました。
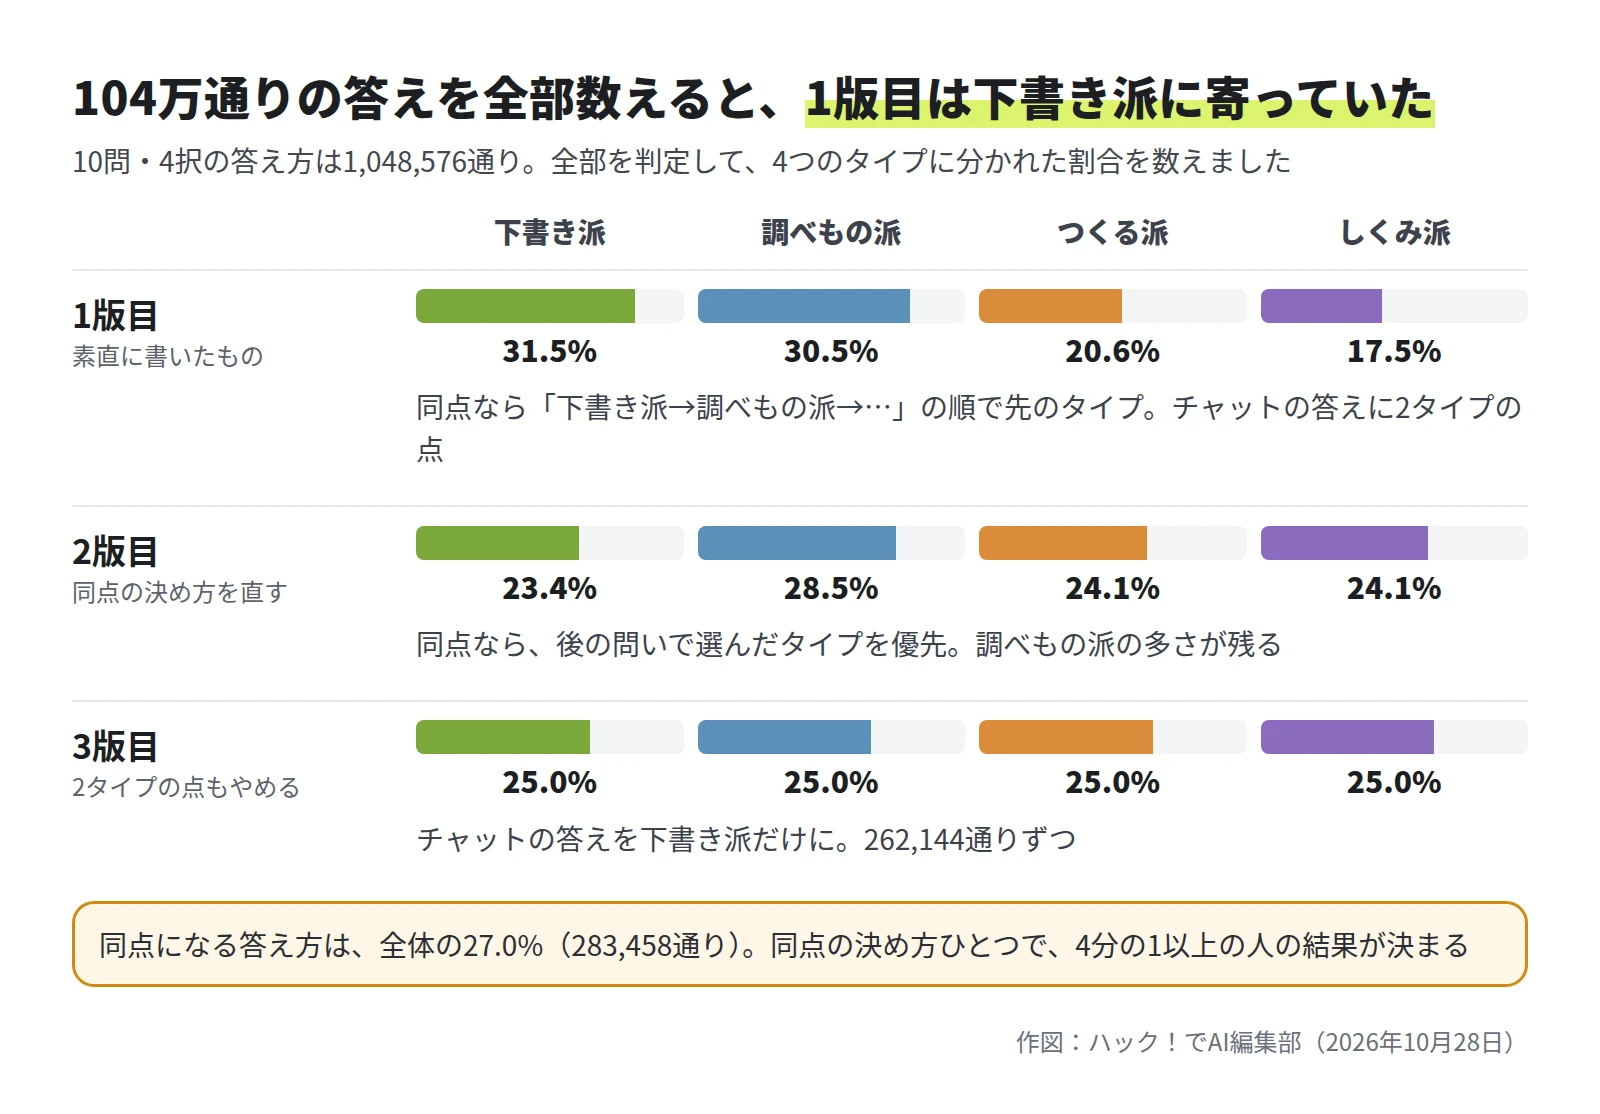
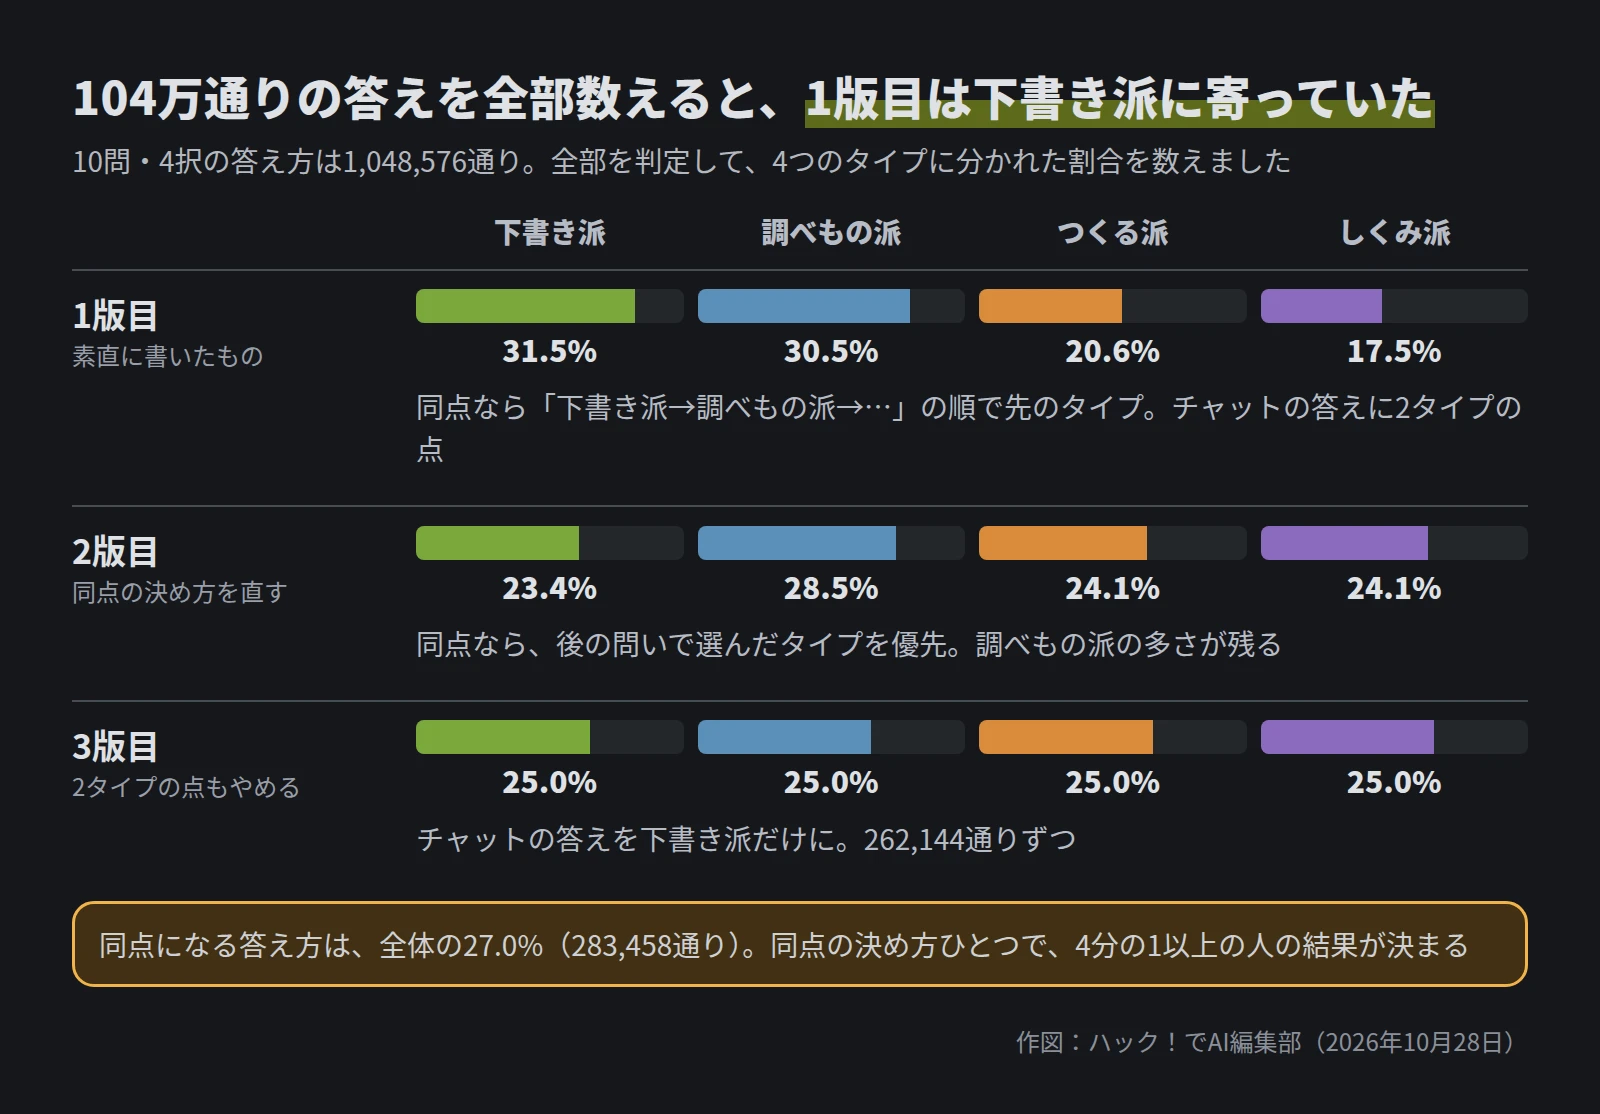
素直に書いた1版目は、下書き派31.5%、調べもの派30.5%、つくる派20.6%、しくみ派17.5%でした。原因は2つありました。
1つ目は同点です。10問の点を4つのタイプに分けると、いちばん多い点が2つ以上のタイプで並ぶ答え方が283,458通りあり、全体の27.0%でした。1版目は、同点なら「下書き派→調べもの派→つくる派→しくみ派」の順で先のタイプを選ぶ書き方で、プログラムでいちばん素直に書くとこうなります。並びの先にある下書き派と調べもの派が、同点の分をまとめて受け取っていました。
2版目では、同点なら「同点のタイプのうち、後の問いで選んだもの」を結果にしました。順番に意味のない決め方をやめ、答えの並びで決める形です。下書き派は23.4%まで下がりましたが、調べもの派だけ28.5%と多いまま残りました。
2つ目の原因は、1つの答えに2つのタイプの点を入れていたことです。「よく使う、または使ってみたいのは?」の「ChatGPTやClaudeのチャット」に、下書き派と調べもの派の1点ずつを入れていました。チャットはどちらの使い方にも当てはまると考えたのですが、調べもの派は合わせて2つの答えで点がもらえる形になっていました。3版目でこの答えを下書き派だけにすると、4つのタイプがちょうど262,144通りずつ、25%に分かれました。ページに入れたのは、この3版目です。
ここで気をつけたいのは、25%ずつの意味です。どの答え方にも同じ重さで分かれる、というだけで、遊んだ人が25%ずつに分かれるわけではありません。人の答えには癖があり、たとえば「チャット」を選ぶ人は多いと考えられます。実際の分かれ方は遊んだ人の結果を数えないと分かりませんが、このページは答えを外に送らないので、編集部も数えていません。
絵柄をそろえるなら、4体を1枚に描かせて切り分ける
結果の画面には、タイプごとにロボットの絵を置きました。同じロボットが、ペン・虫めがね・絵筆・歯車を持っている4枚です。
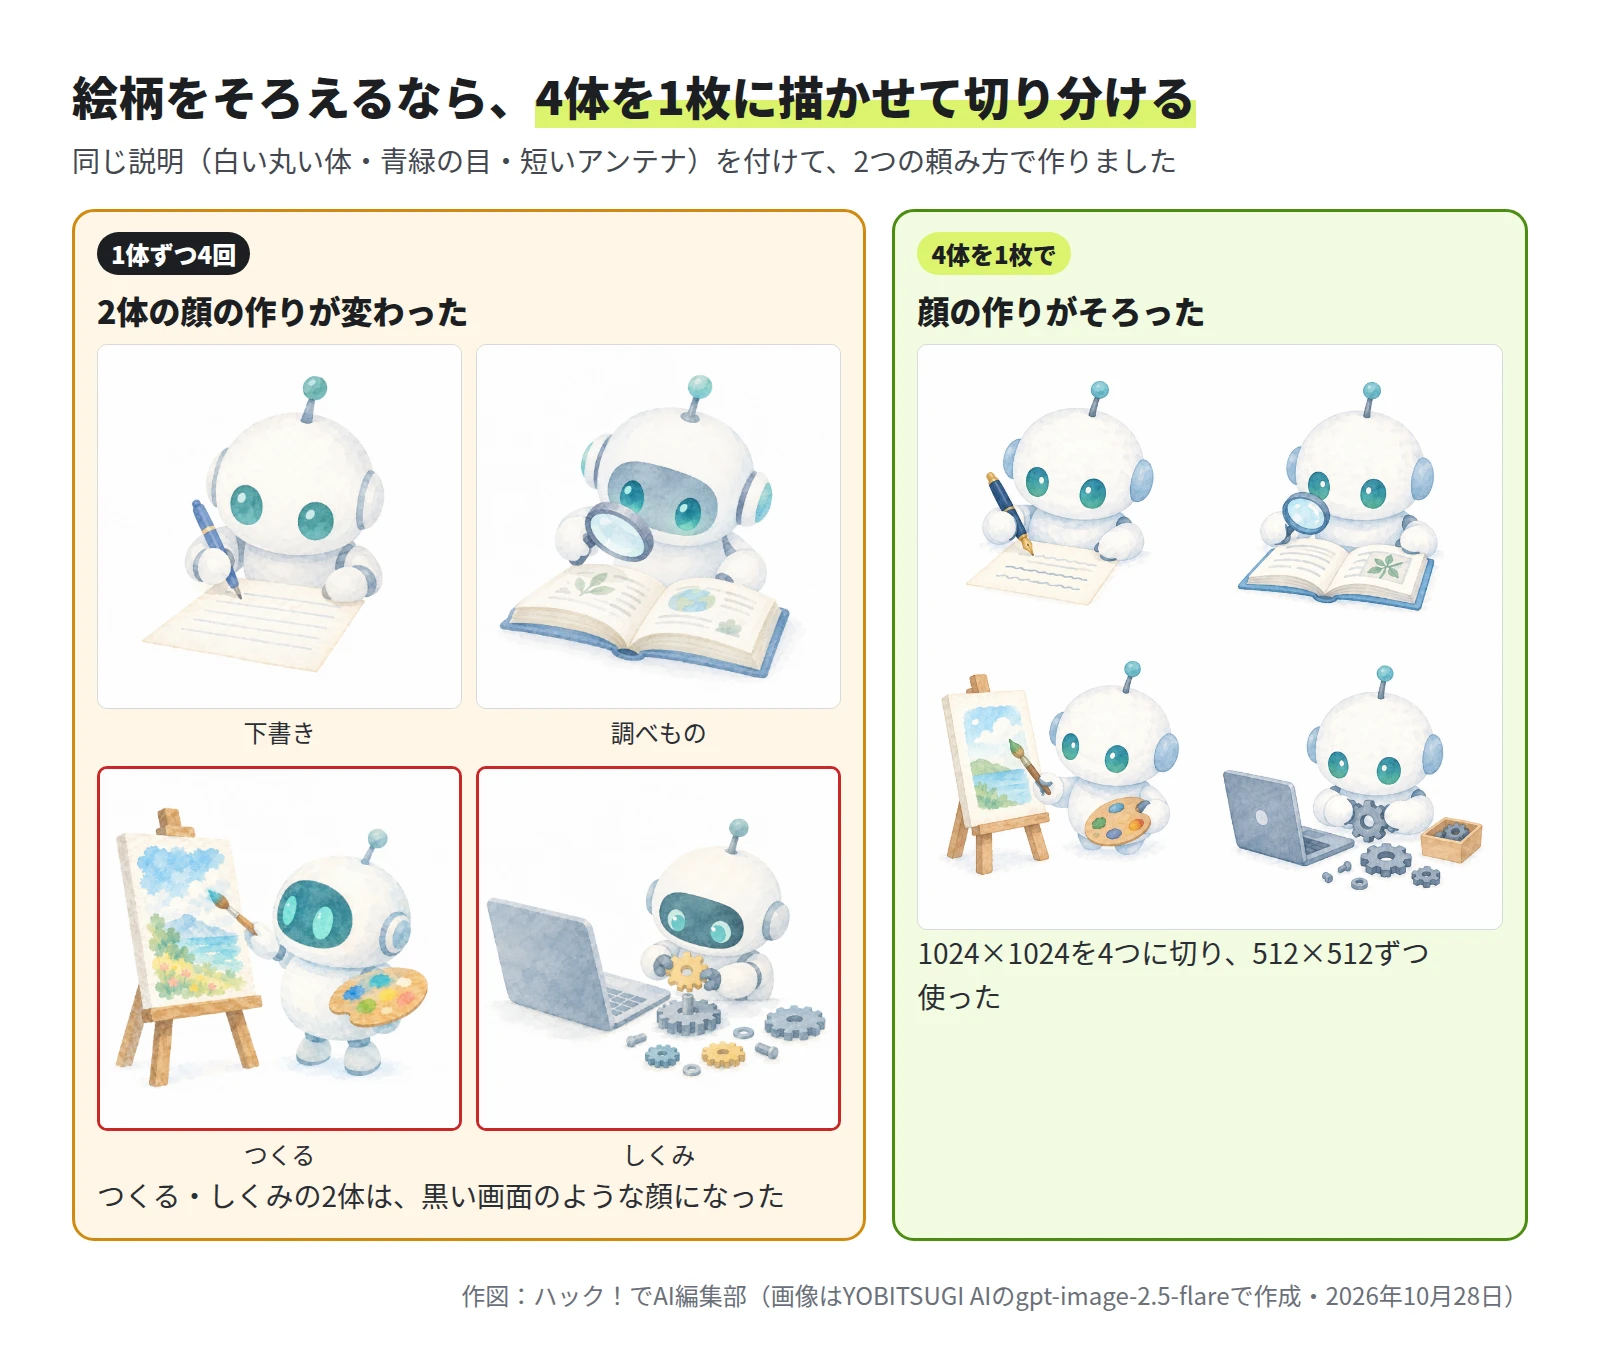
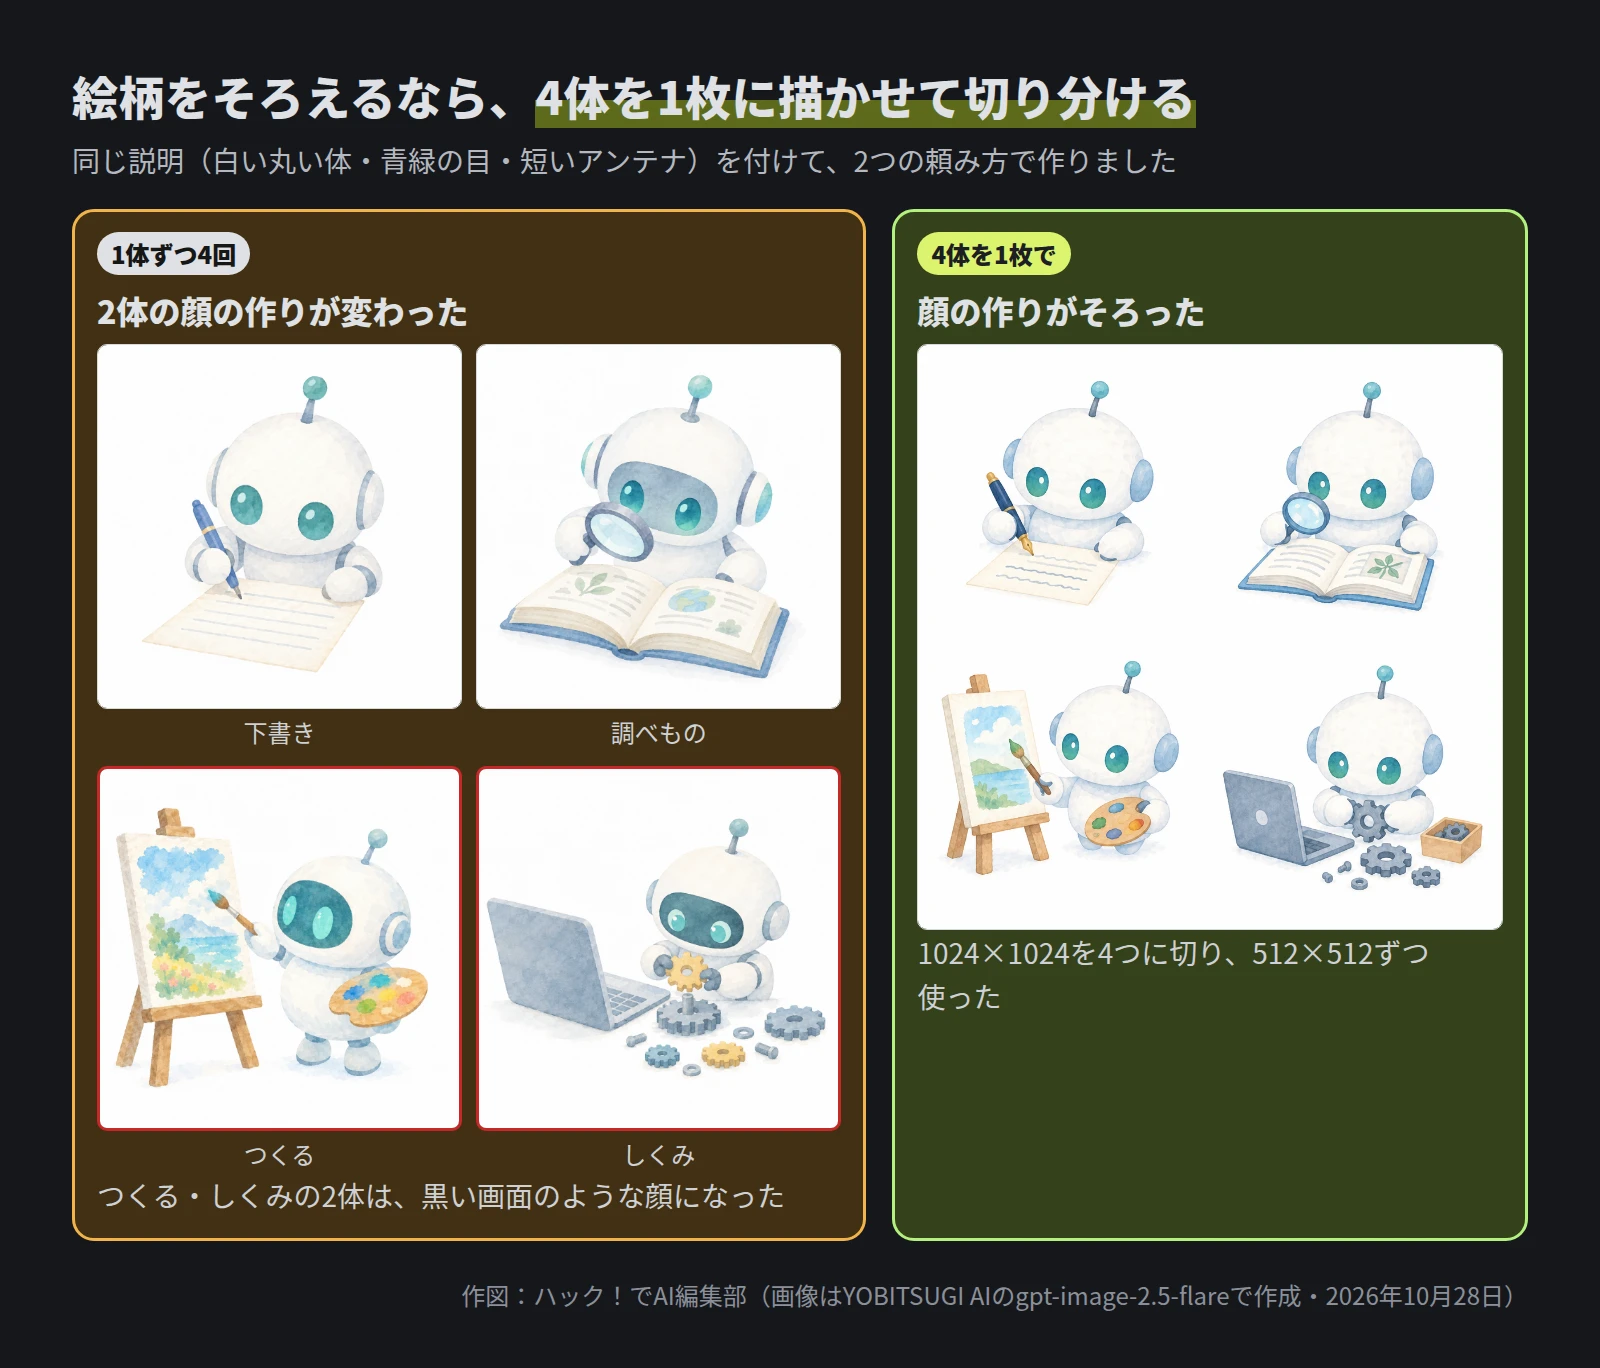
最初は、同じ説明(白い丸い体、青緑の目、頭に短いアンテナ)を付けて、1体ずつ4回頼みました。下書き派と調べもの派の2体は白い顔に目がある作りでしたが、つくる派としくみ派の2体は、顔が黒い画面のような作りに変わりました。並べると、別のロボットに見えます。
そこで、4体を2行2列に並べた1枚の絵として頼みました。1枚の中では、4体とも白い顔に青緑の目の同じ作りになりました。1024×1024ピクセルの絵を4つに切り、512×512ピクセルずつ結果の画面に使っています。
別々に頼むと、説明が同じでも1回ごとに描き直すので、言葉にしていない細かい所が変わるのだと考えています。キャラクターを何体もそろえたいときは、まとめて1枚に描かせ、あとで切り分けるのが手早い方法です。
結果の文は、誰にでも当てはまる言い方にしない
診断の結果には、誰が読んでも当たっていると感じる文がよく使われます。「あなたは人の気持ちを大事にする一面があります」のような文で、こうした感じ方はバーナム効果と呼ばれます。当たっている気はしても、読んだ人が次に何をすればよいかは分かりません。
そこで、結果は具体的な行動だけで書きました。どのタイプも「向いている使い方」「気をつけること」「次に読む記事」の3つで、しくみ派なら「Claude CodeやCopilotに、手順と『できたかの確かめ方』まで書いて頼む」「AIに渡す権限と、秘密の情報の扱いを先に決める」です。4つのタイプの点も棒で見せるので、ほかのタイプとどれだけ近かったかも分かります。
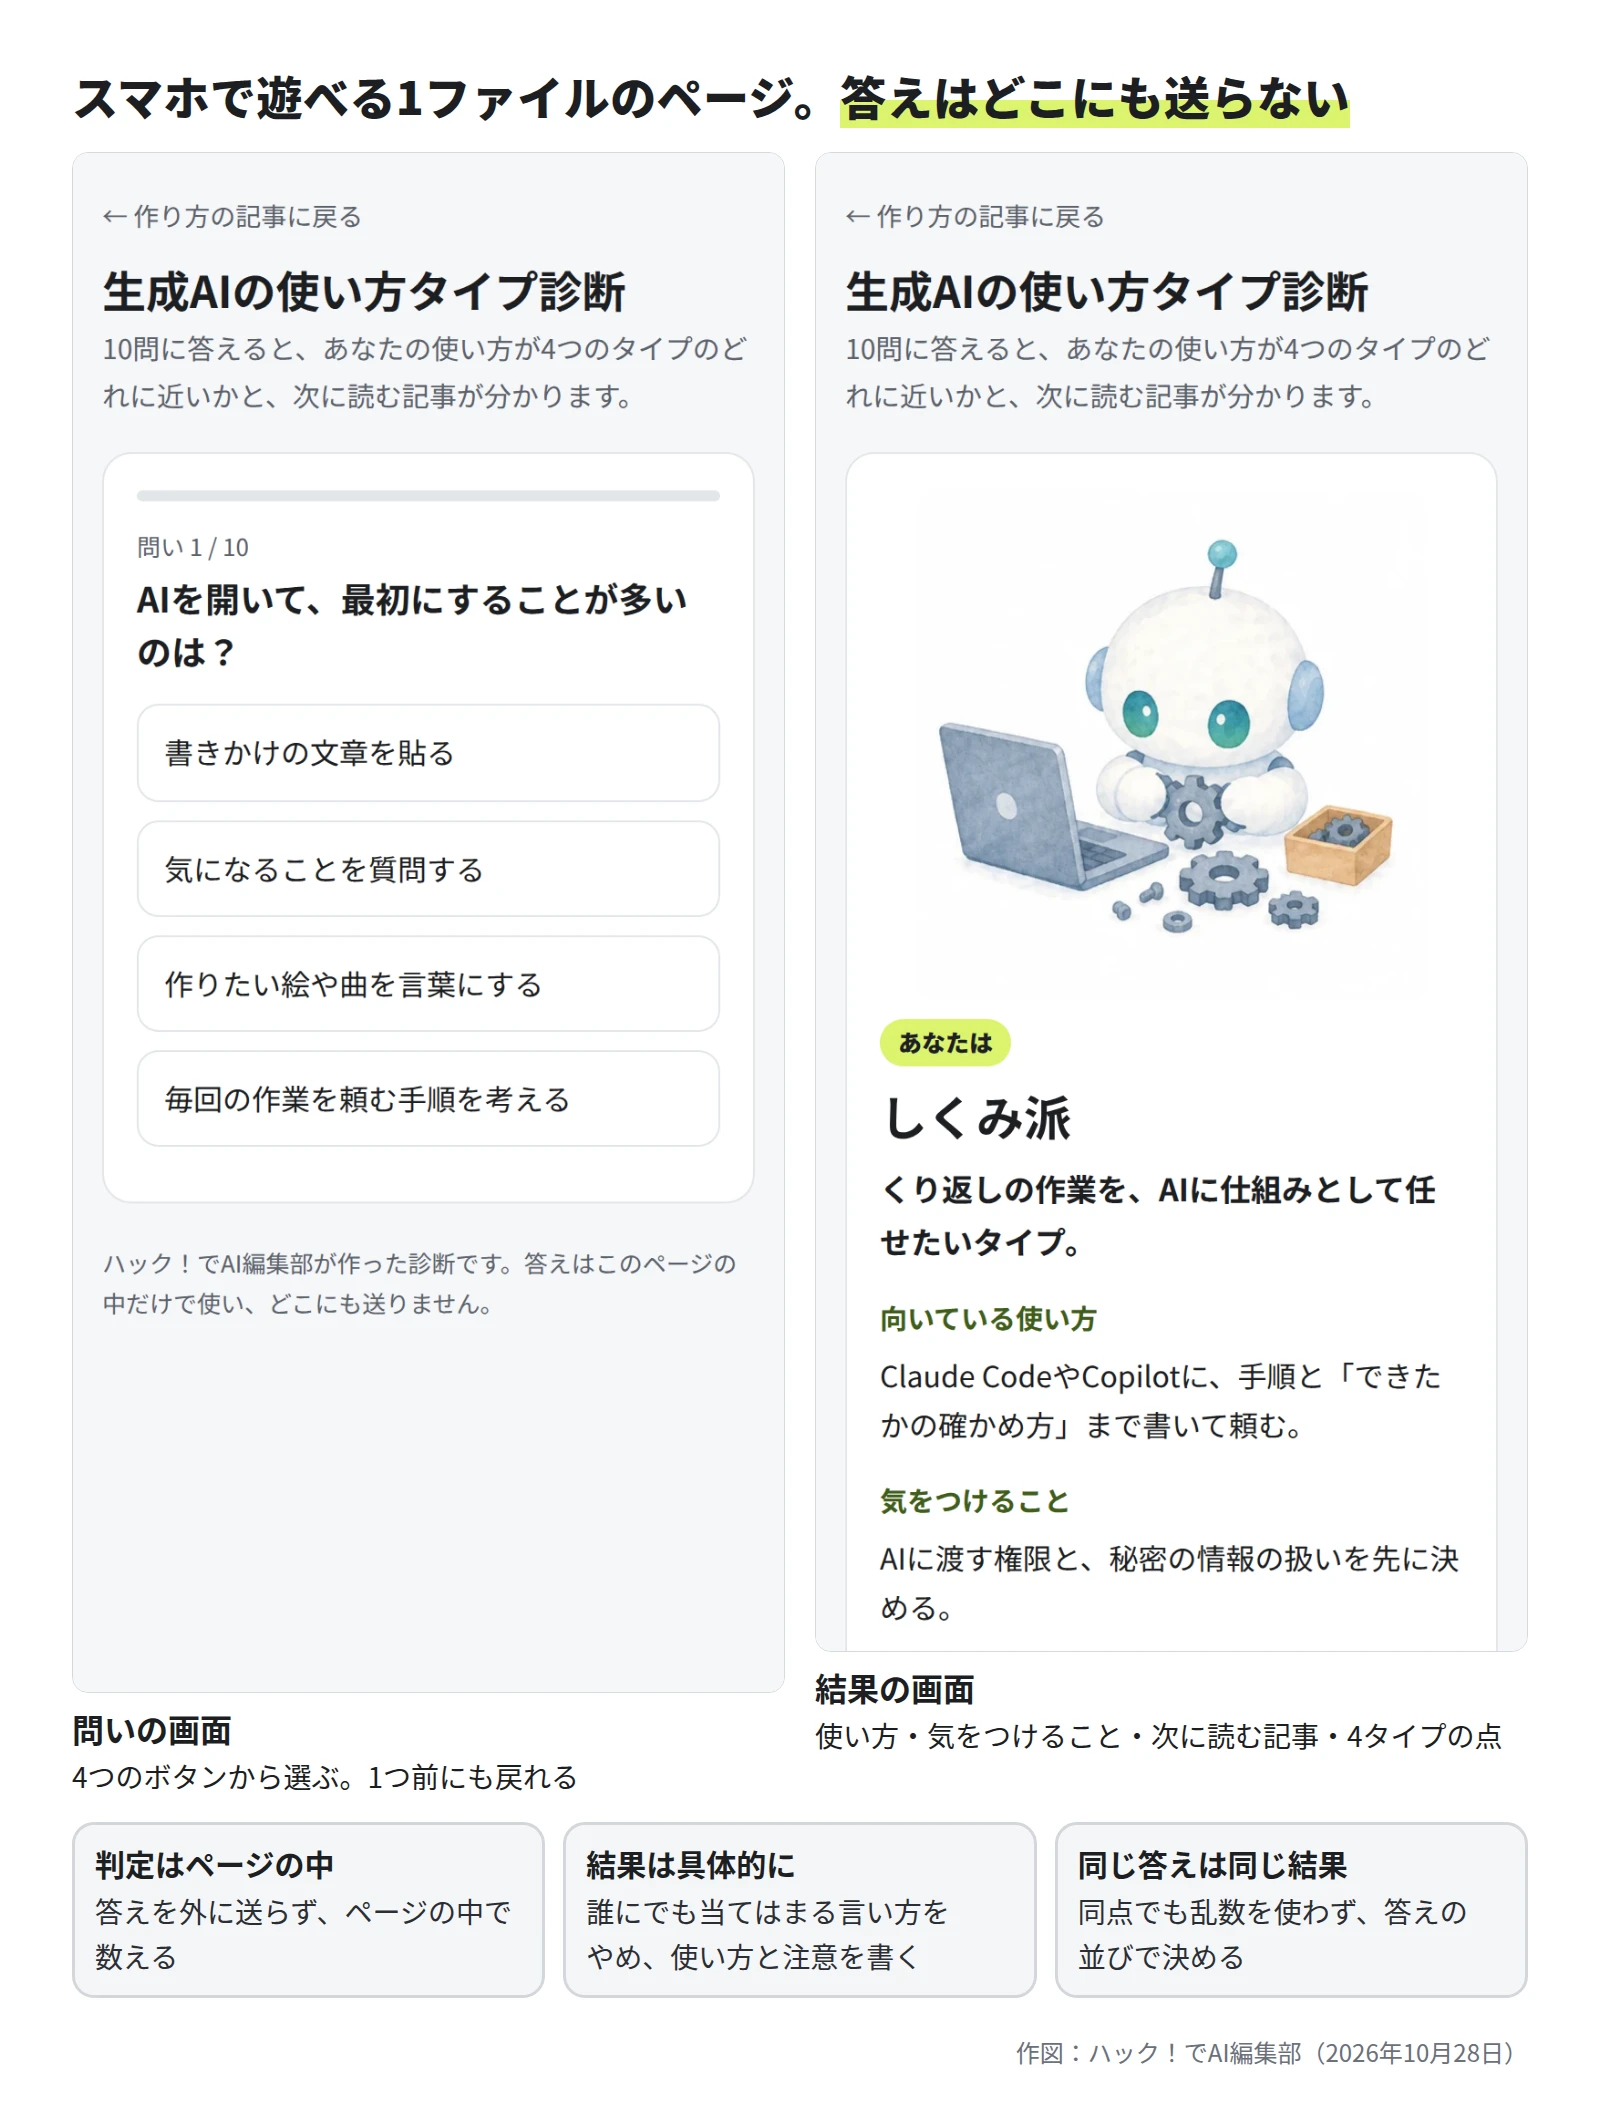
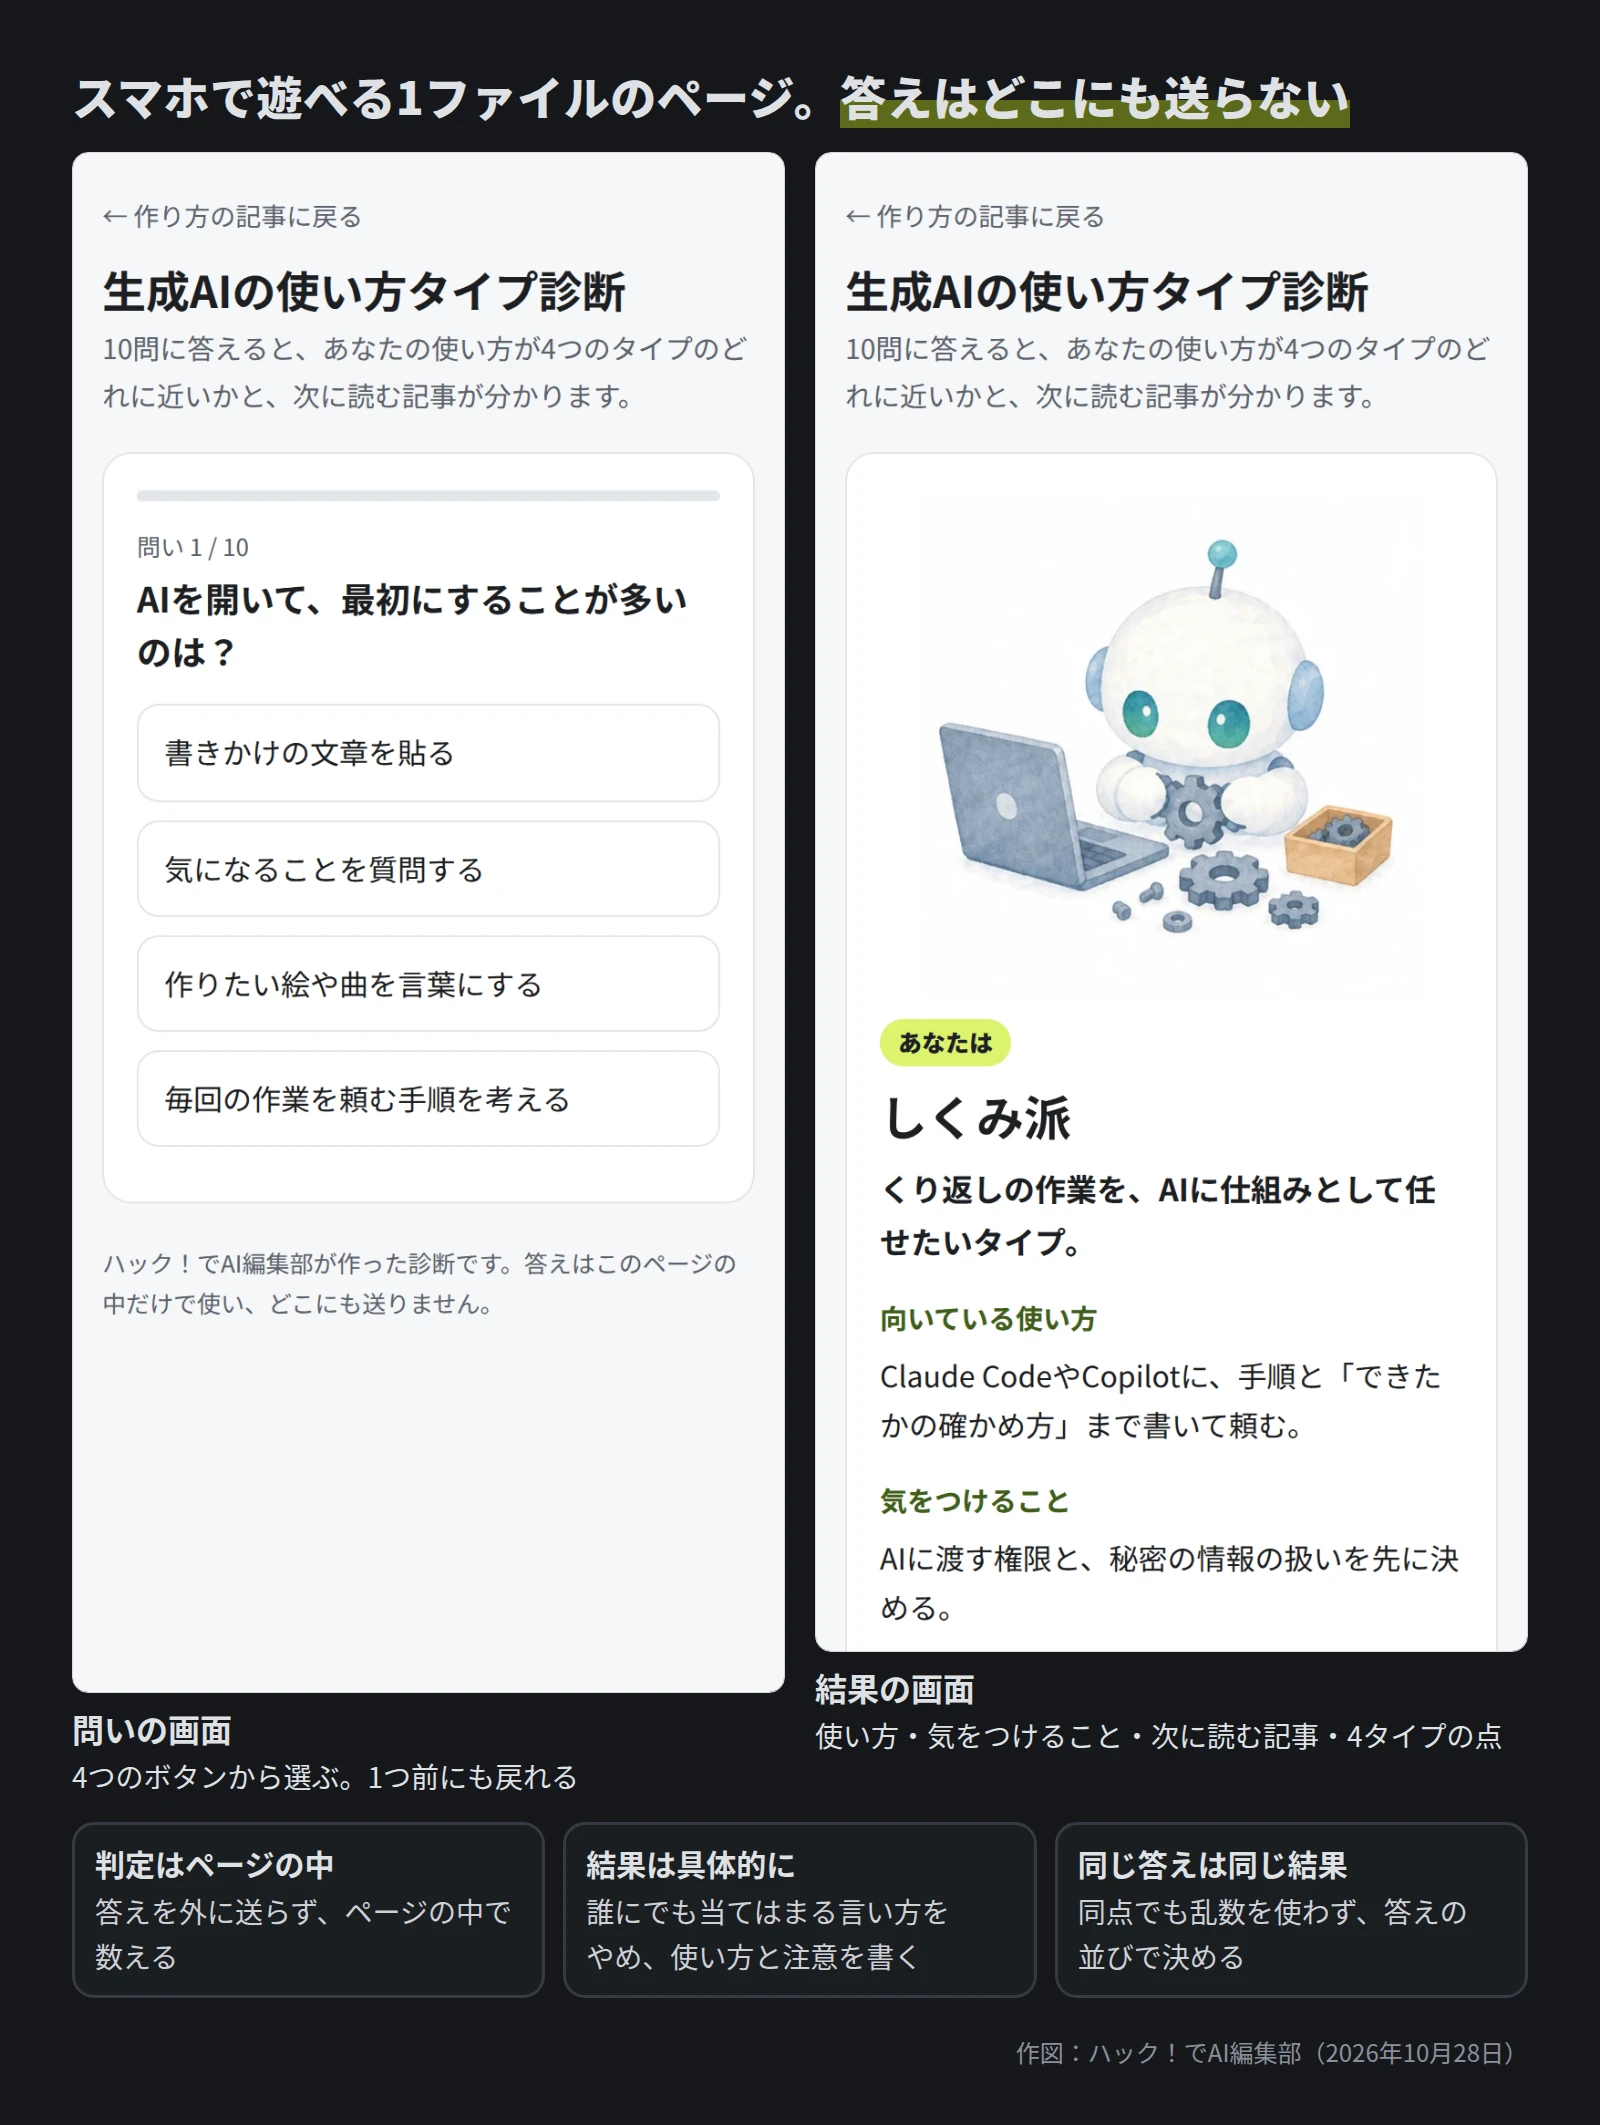
ページは、HTMLとJavaScriptの1ファイルです。点を数えて結果を出すまでをページの中だけで済ませ、答えはどこにも送りません。同点のときも乱数は使わないので、同じ答え方なら何度遊んでも同じ結果になります。スマホの幅で問いから結果まで答えて、ボタンの押しやすさと文の折り返しを確かめました。
費用は絵の5枚で37.83クレジット
YOBITSUGI AIに頼んだのは絵だけで、1体ずつの4枚と、4体を1枚に描いた1枚の計5枚です。依頼の合計は37.83クレジットで、絵を作らせる取りまとめのAIの分を含みます。5枚が届くまでは54秒でした。使ったのは4体を1枚に描いた絵だけなので、最初から1枚で頼めば、もう少し安く済んでいたはずです。
問いと点の数え方、全通りの検査、ページは、編集部がClaude Codeと作っています。
自分で診断を作るなら、出す前に4つ数える
10問・4択の小さな診断でも、出す前に数えておくことがありました。
- 全部の答え方で、タイプの割合を数える。答え方が多すぎる診断なら、乱数で十万回ほど答えさせて数える。
- 同点になる割合と、同点の決め方を確かめる。今回は1版目で全体の27.0%、3版目で28.2%が同点だった。
- 1つの答えに2つのタイプの点を入れるなら、入れる前と後で数える。
- 絵は1枚にまとめて描かせ、切り分けてそろえる。
結果の言い方と、答えを外に送るかどうかは、人が決めます。診断で答えを集めて数えたいなら、そのことを先に書いておく必要があります。
まずは診断を遊んで、結果の下の4つのタイプの点を見てください。同点で決まった人は、最後のほうの問いで選んだタイプになっています。
参考にした公式の情報
連載・作ってみた AIで作る
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。