AI技術大全 第1回
RAG の精度を上げるには? チャンク・ハイブリッド検索・リランクを順に足して測った
 佐々木 航
この記事でわかること
- 5 つの段階ごとの Recall@5・上位 1 件・答えの正答の変わり方
- 効いた所と効かなかった所、外れた答えの実例と原因
- 1 問の費用と秒、準備の手間から見た「どこまでやるか」
確認した環境: sentence-transformers 6.1.0・faiss-cpu 1.15.1・SudachiPy 0.7.0 を CPU で実行、答えは YOBITSUGI AI で Claude Haiku 5.5・GPT-6 Luna / 2026年10月15日に確認
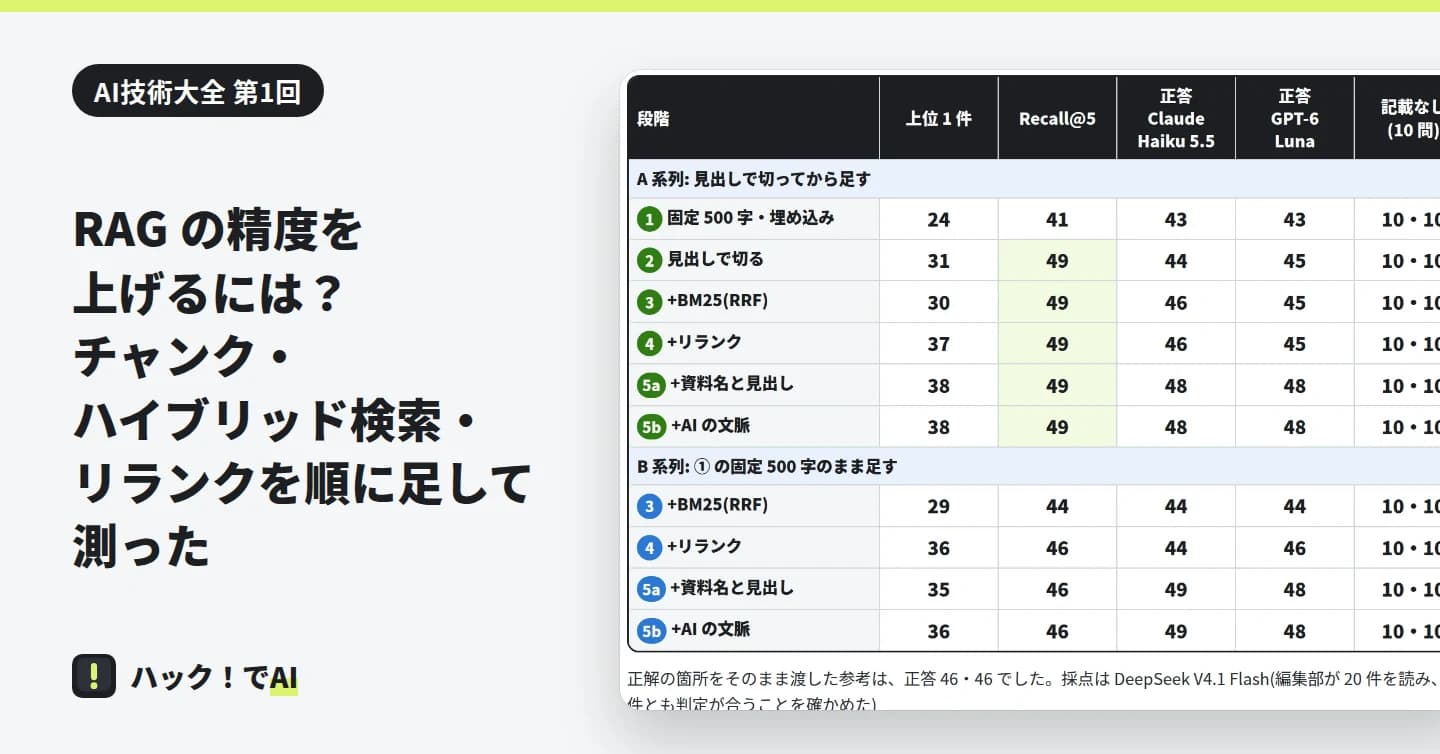
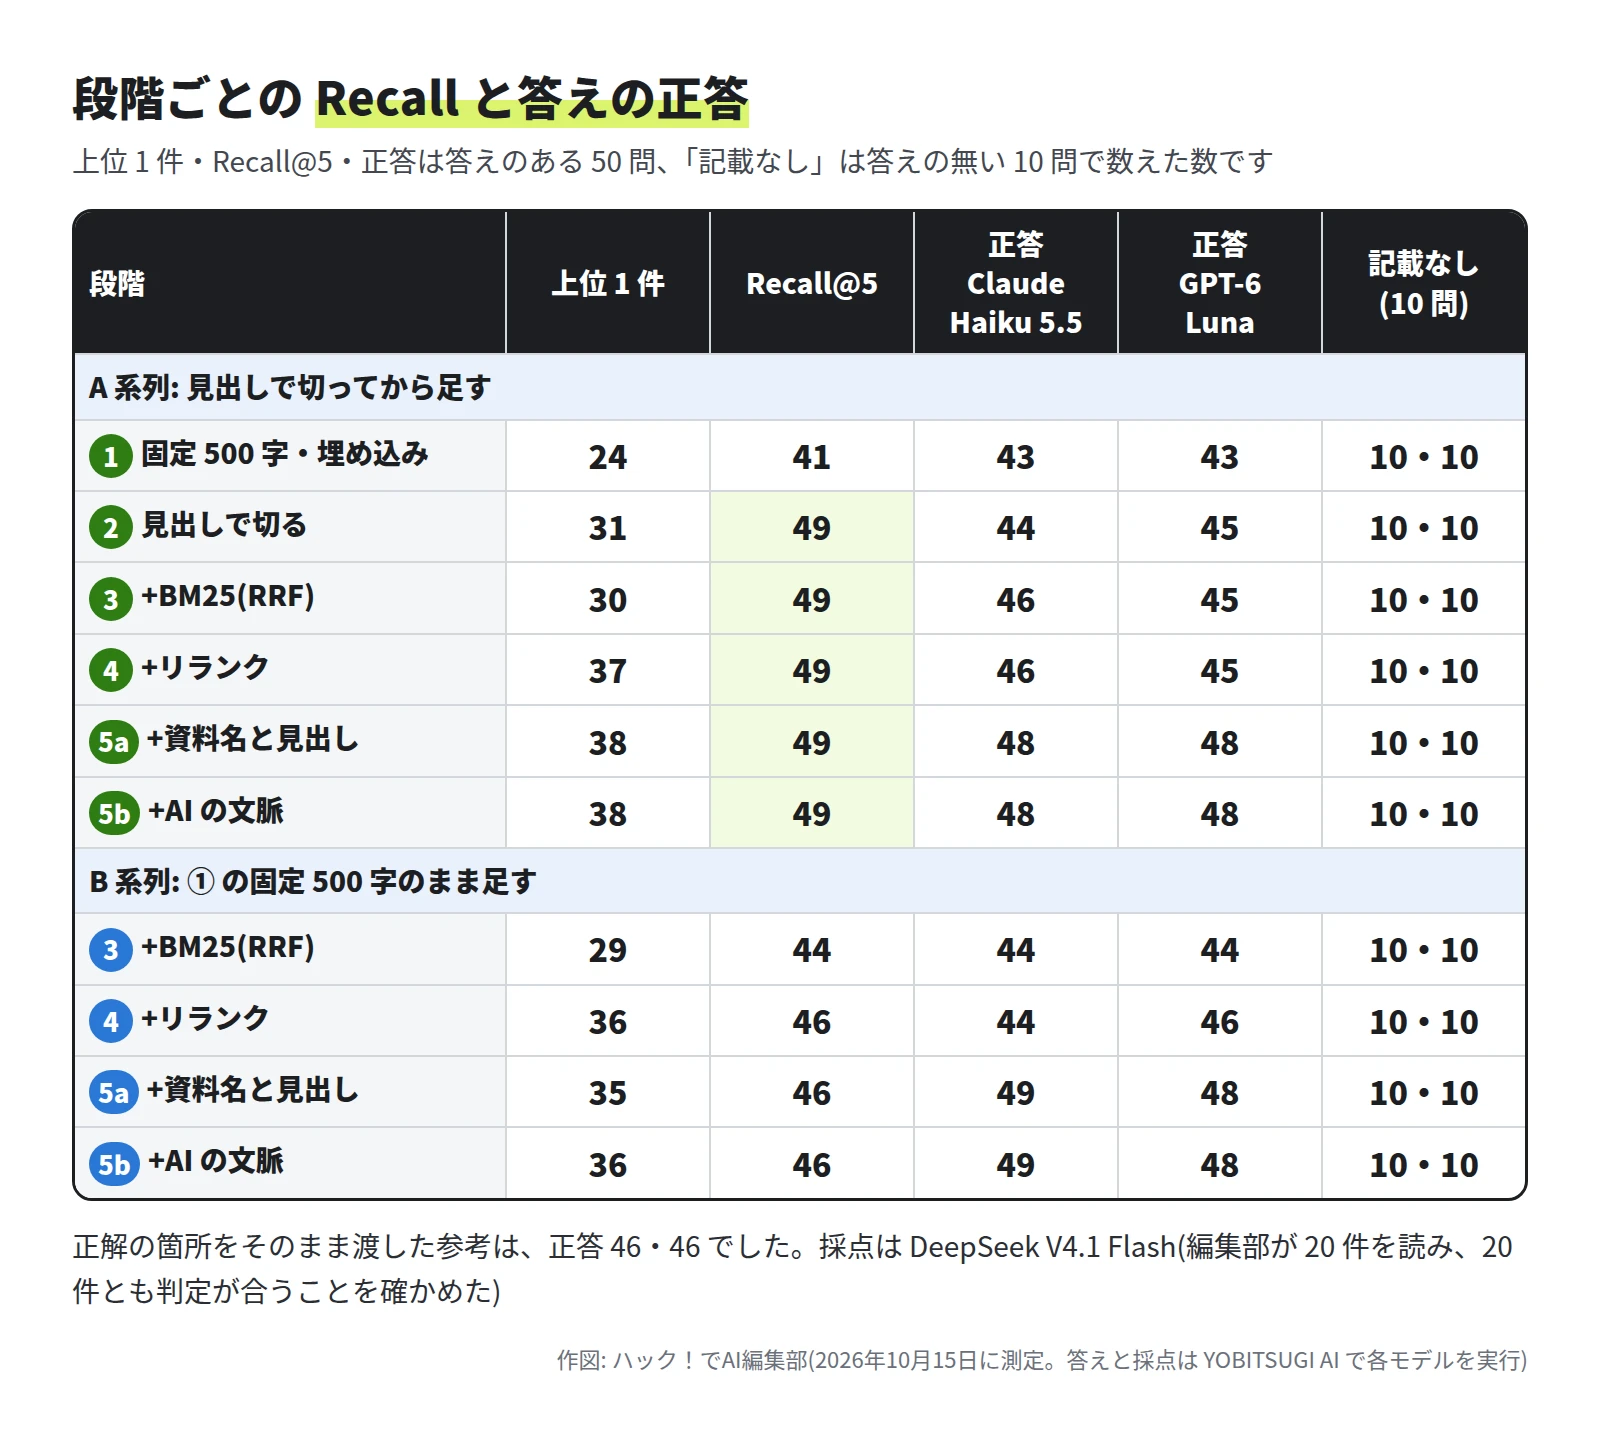
RAG の精度は、何を足すと上がるのか。架空の会社の社内資料 36 ページと 60 問で、チャンクの切り方・BM25 とのハイブリッド検索・リランク・文脈の付与を 1 つずつ足して測りました。いちばん効いたのはチャンクを見出しで切ることで、答えに要る箇所が上位 5 件に入った問は 50 問中 41 から 49 になりました。答えの正答(50 問)は、① の 43 から、チャンクの先頭に「どの資料のどこか」を足した ⑤ で 2 モデルとも 48 になりました。ただし 1 段階ずつの差は 1〜3 問で、言い切れる差ではありません。
結果の早見
RAG と、今回足した 5 つの段階
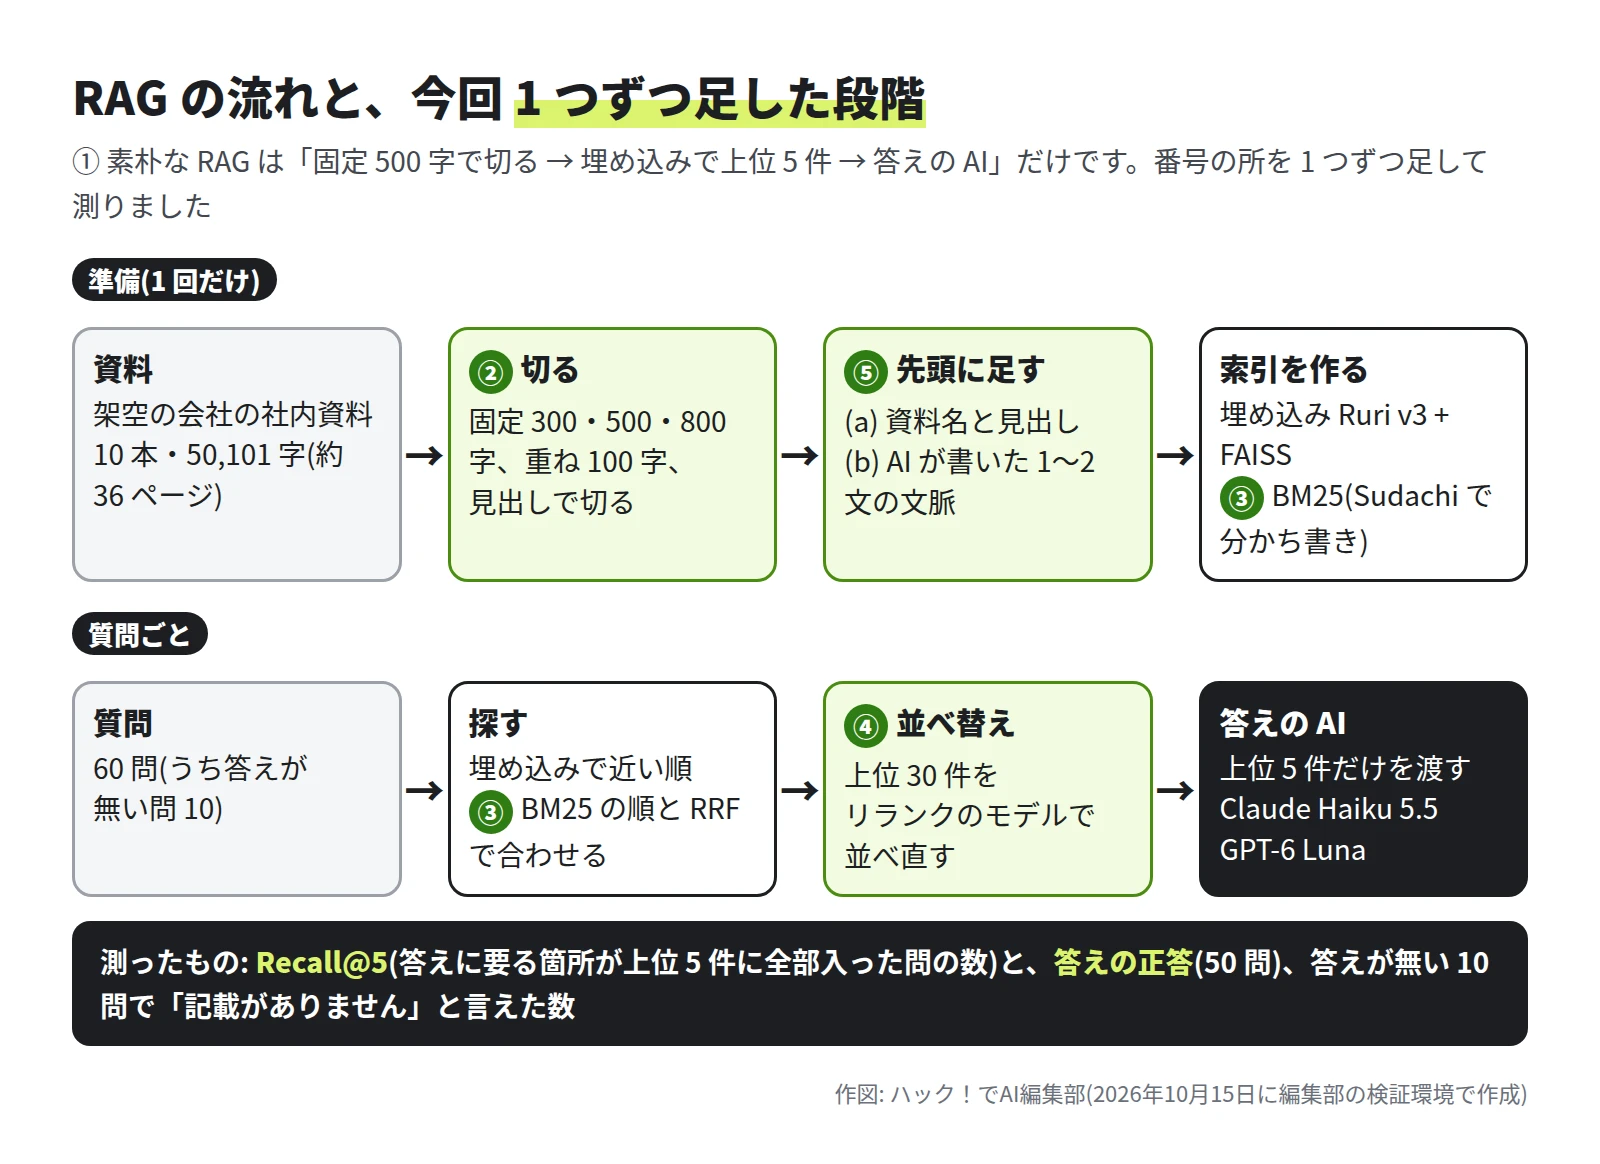
RAG(検索で補った生成)は、質問に近い部分を資料から探し、その部分だけを AI に渡して答えさせる仕組みです。資料は「チャンク」と呼ぶ小さな部分に切っておき、文の意味を数の並び(ベクトル)にする「埋め込み」で、質問に近いチャンクを探します。AI が読むのは探した上位の数件だけなので、探す所で外すと正しく答えられません。この記事では、探す精度と答えの精度の両方を測りました。
作った物と測り方
架空の社内資料 10 本
- 架空の会社「株式会社ソラマド計測」(計測機器のメーカー)の資料です。正社員就業規則・契約社員とパートタイマーの就業規則・給与と手当・旅費と出張・経費精算・情報システム・情報セキュリティ・製品 FAQ・クラウドの利用案内・購買の 10 本で、合わせて 50,101 字(1 ページ 1,400 字で約 36 ページ)です。Markdown の見出し(## と ###)が付いています。
- 数字や条件は編集部が先に決め、文章は Claude Sonnet 5.5 に 1 本を前半と後半に分けて書かせました(20 回・131.1 クレジット)。できた 10 本を全部読み、決めた数字と合うことを確かめました。
- わざと紛らわしい組を入れました。正社員と契約社員で特別休暇や在宅勤務の日数が違う、国内と海外の出張、会議費と交際費、製品の S1 と S2、クラウドの 3 つのプラン、購買の承認と立替の上限です。
問題 60 問
- 資料を読んで編集部が作りました。AI には作らせていません。
| 種類 | 問の数 | 例 |
|---|---|---|
| 言い換えなし | 10 | 経費は、使った月のいつまでに申請しますか |
| 言い換え | 15 | 妻が出産するとき、正社員は休みを何日もらえますか(資料は「配偶者の出産」) |
| 数字 | 15 | 自転車で片道 12 km を通勤しています。通勤手当は月いくらですか |
| 複数の箇所 | 10 | 税抜 50 万円の測定器を発注します。承認するのは誰で、見積もりは何社から取りますか |
| 答えが無い | 10 | ソラマド ロガー S2 で記録の間隔を 1 分にすると、電池はどのくらい持ちますか(1 分のときの値は S1 だけが資料にある) |
- 1 問ごとに、答えの決め手になる短い文(証拠)を資料から抜き出し、位置を記録しました。複数の箇所の問は、要る箇所を全部記録しました。紛らわしい組に当たる問は 22 問です。
道具と設定
| 部品 | 使った物 | 設定 |
|---|---|---|
| 埋め込み | Ruri v3(cl-nagoya/ruri-v3-310m・Apache 2.0)を sentence-transformers 6.1.0 で | 問に「検索クエリ: 」、チャンクに「検索文書: 」を付ける・768 次元 |
| ベクトルの置き場 | FAISS の IndexFlatIP(faiss-cpu 1.15.1・MIT) | 正規化して内積で比べる(コサイン類似度)・全件を比べる |
| BM25 | rank-bm25 0.2.2 と SudachiPy 0.7.0(辞書は SudachiDict core 20260723.1・どれも Apache 2.0) | モード A・正規化形・助詞と助動詞と記号を外す・k1 = 1.2・b = 0.75 |
| ハイブリッド | RRF | 埋め込みと BM25 の上位 50 件ずつ・k = 60 |
| リランク | Ruri v3 のリランカー(cl-nagoya/ruri-v3-reranker-310m・Apache 2.0) | ハイブリッドの上位 30 件を並べ直す |
| 答えの AI | Claude Haiku 5.5・GPT-6 Luna | 上位 5 件を渡す・既定の設定 |
| 採点の AI | DeepSeek V4.1 Flash | 答えの AI と別の会社の物 |
| 計算の場所 | 編集部の検証環境のサーバー(CPU 24 コア・GPU なし・ほかの作業と共用) |
モデルの名前は、YOBITSUGI AI の記録に残った名前(claude-haiku-5-5・gpt-6-luna・deepseek-flash)で確かめました。
下のコードは、次の版で動かしました(Python 3.12・PyTorch 2.14.1 の CPU 版)。SudachiPy の 0.7 系は、小さな版の上げでも変更が入ることがあると PyPI に書かれているので、版を固定してください。
pip install "sentence-transformers==6.1.0" "transformers==5.19.0" "faiss-cpu==1.15.1" \
  "rank-bm25==0.2.2" "sudachipy==0.7.0" "sudachidict-core==20260723.1" "numpy==2.5.4"
数え方
- Recall@5: 答えのある 50 問のうち、要る箇所が全部、上位 5 件のチャンクに丸ごと入った問の数です。上位 1 件と上位 20 件でも数えました。
- 答えの正答: 50 問の答えを、採点の AI が「正答・一部・誤り・記載なし」に分けました。正答の数を数えます。答えの無い 10 問は、「記載なし」と答えた数です。
- 差の幅: 前の段階との差を、問ごとの対で 10,000 回ブートストラップ(問を選び直して計算し直す方法)して、95% の幅を出しました。幅の下の端が 0 以下の差は「効いたとは言えない」と書きます。
- 採点の確かめ: 編集部(Claude Code を使用)が問・正解・答えを見比べました。決まった種で選んだ 20 件と、校閲で選んだ 20 件(AI が正答とした 10 件・④ 以降と B 系列で正答以外にした 10 件)は、40 件とも AI の判定と同じでした。① から ③ と参考で正答以外になった 47 件では 2 件が分かれ、答えの無い問を「正答」にした 1 件は決まりどおり「記載なし」に直しました。参考の N10 の 1 件(8,800 円と答えつつ「ロガー専用の料金の記載は無い」と添えた答え)は、AI は一部、編集部は正答と見ましたが、直していません。
① 素朴な RAG: 固定 500 字で切る
10 本を 500 字ずつ 103 個に切り、埋め込みの上位 5 件を渡しました。Recall@5 は 41 / 50、答えの正答は 2 モデルとも 43 / 50 でした。
from pathlib import Path
import faiss
from sentence_transformers import SentenceTransformer

docs = {p.stem: p.read_text() for p in sorted(Path("corpus").glob("D*.md"))}   # 資料 10 本(Markdown)

# ① 固定 500 字(重ねなし)で切る。(資料, 始まり, 終わり) の位置も持っておく
spans = [(d, s, min(s + 500, len(t))) for d, t in docs.items() for s in range(0, len(t), 500)]
chunks = [docs[d][s:e] for d, s, e in spans]

emb = SentenceTransformer("cl-nagoya/ruri-v3-310m", device="cpu")

def build(chunks):
    X = emb.encode(["検索文書: " + c for c in chunks], batch_size=16, normalize_embeddings=True)
    index = faiss.IndexFlatIP(X.shape[1])   # 正規化したので、内積 = コサイン類似度
    index.add(X)
    return index

index = build(chunks)

def dense(q, k):
    v = emb.encode(["検索クエリ: " + q], normalize_embeddings=True)
    return index.search(v, k)[1][0]          # 近い順のチャンクの番号
外した 9 問のうち 4 問は、答えの文がチャンクの境目で割れた問でした。
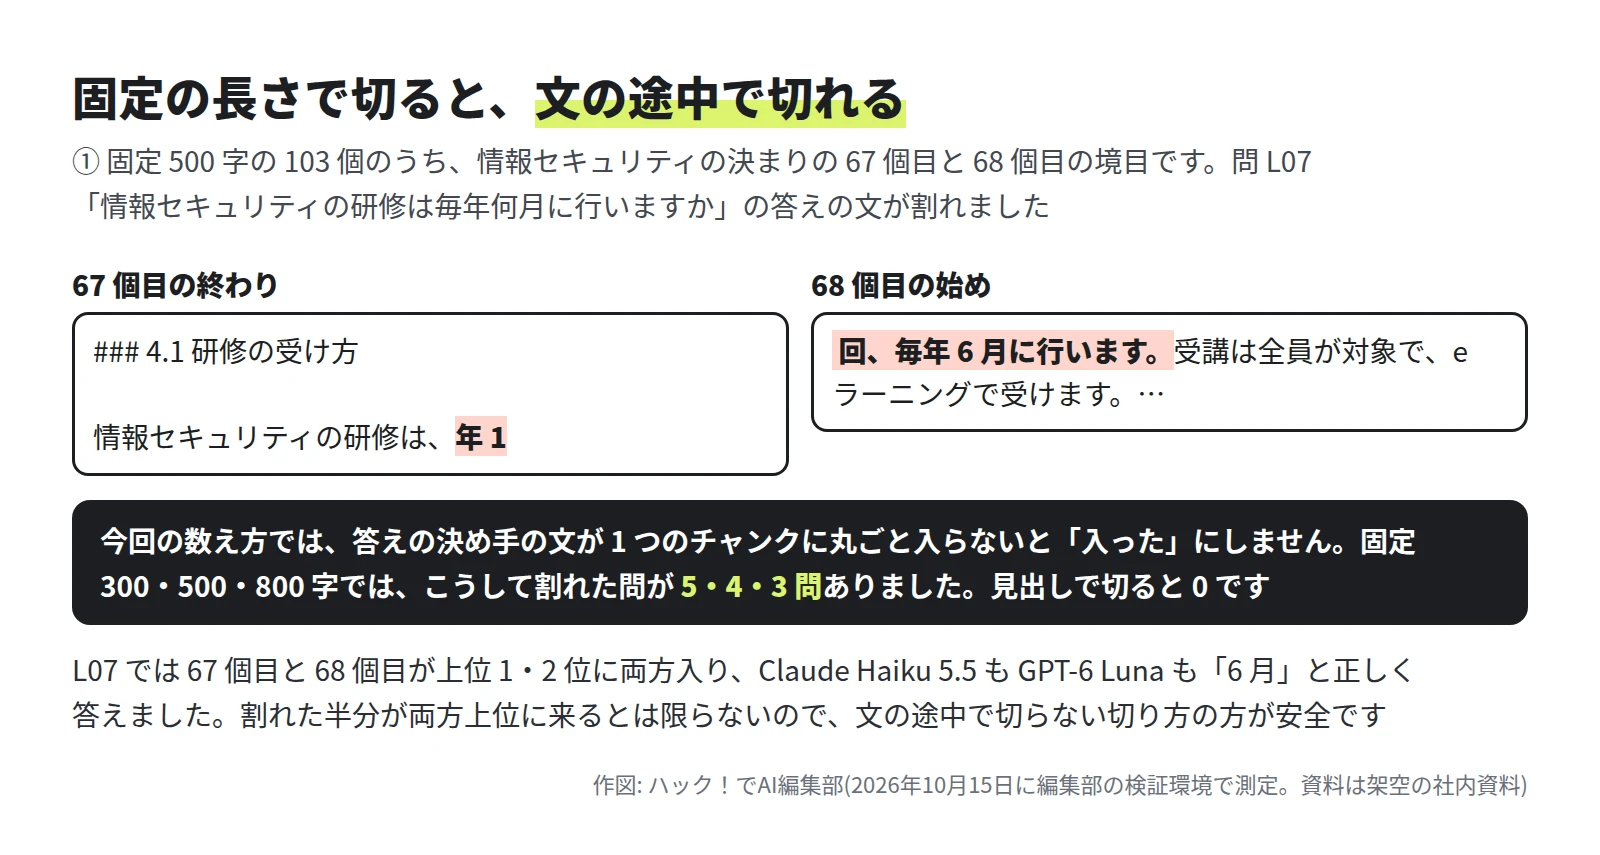
- L07 は割れた 2 つが上位 1・2 位に入り、答えは合っていました。この数え方は、割れた文に厳しめです。
- 割れていない問でも外れました。「無料のお試しは何日間ですか」(L05)は、上位 5 件にお試しの部分が入らず、2 モデルとも「資料に記載がありません」と答えました。
② チャンクの切り方を変える
固定の長さ 3 通り、重ね、見出しで切る方法を、埋め込みだけの検索で比べました。
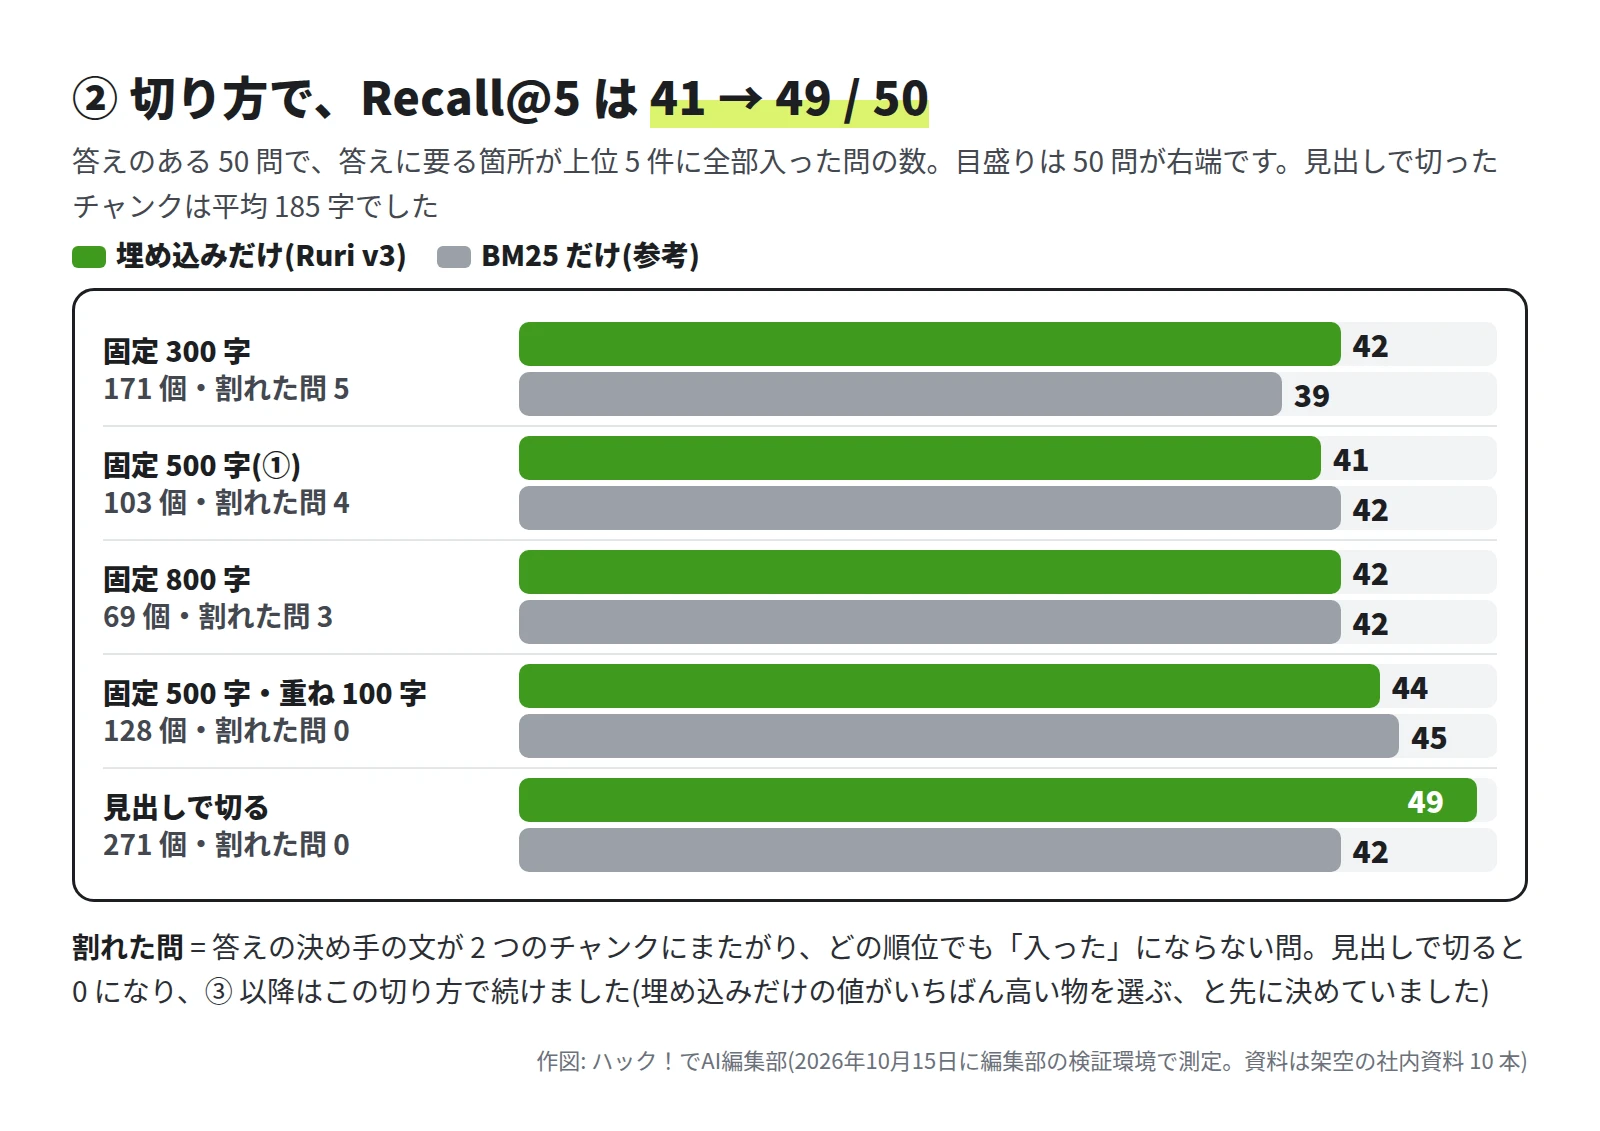
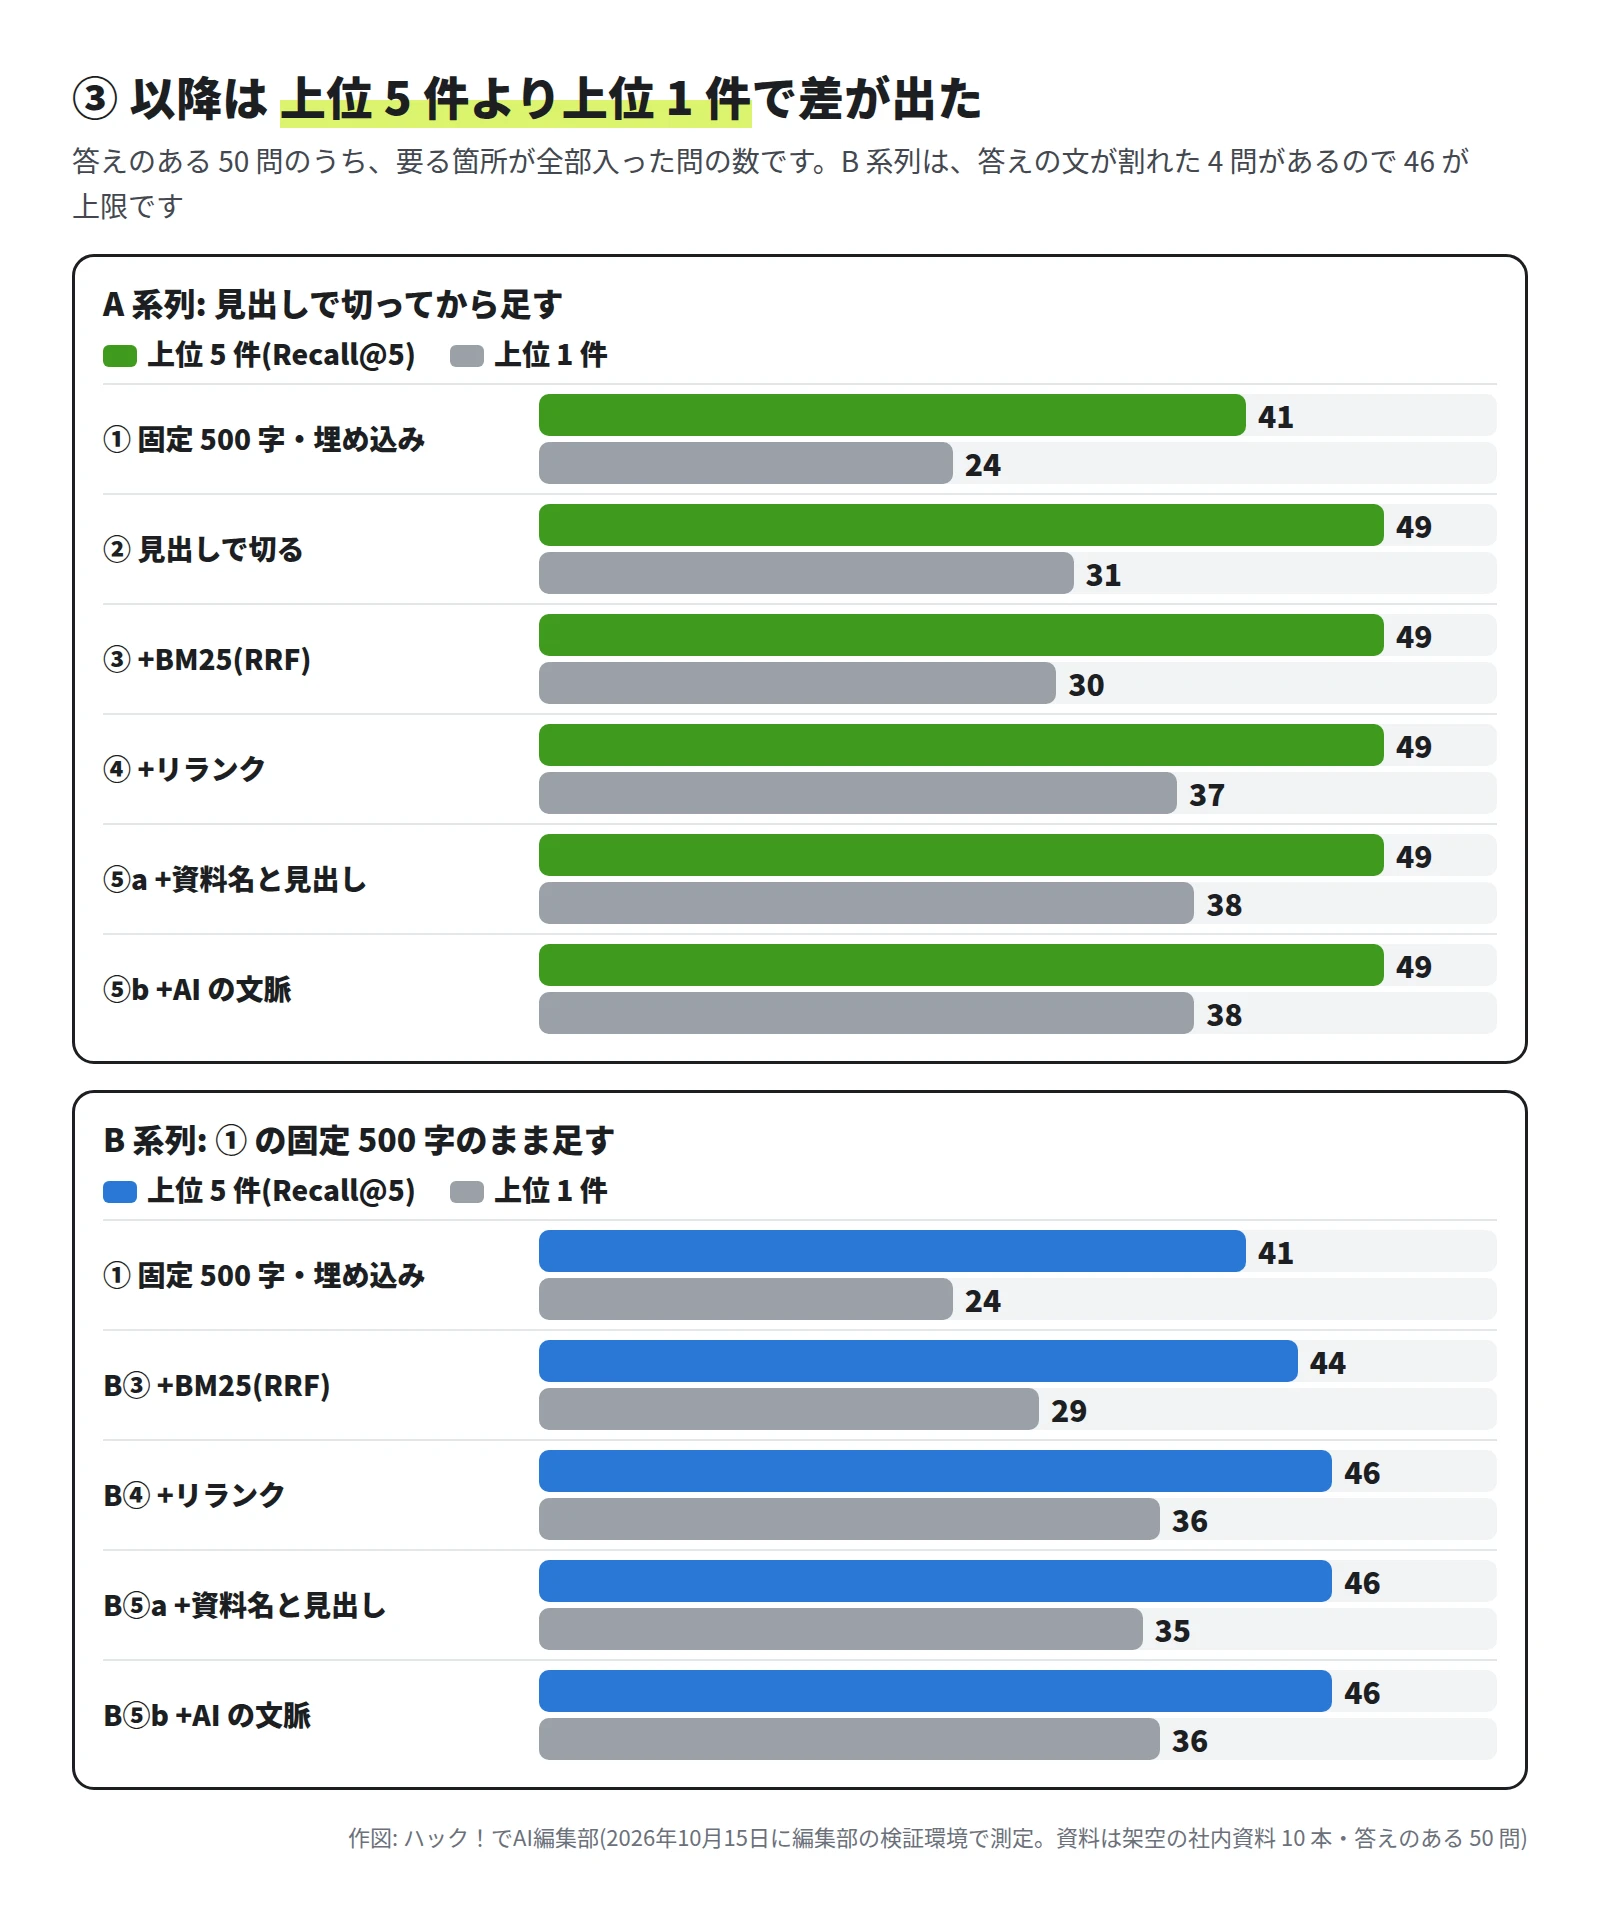
- 見出しで切ると、Recall@5 は 49 / 50 になりました(① との差 +8、95% の幅 +2〜+14)。上位 1 件に入った問も 24 から 31 になりました。
- 固定の長さを 300 字や 800 字にしても 42 で、① と変わりませんでした。重ねを 100 字付けると割れた問は 0 になり、44 でした。
- 見出しで切ったチャンクは平均 185 字と小さく、答えの AI に渡すプロンプトも 1 問あたり平均 2,737 字から 1,433 字に減りました。答えの正答は 43 から 44・45 で、差の幅は 0 をまたぎました。
import re

def heading_chunks(text, maxlen=800):
    # 「## 」「### 」の行で節に分け、(始まり, 終わり) を返す(題と前書きは最初の節に入る)
    heads = [m.start() for m in re.finditer(r"^#{2,3} ", text, re.M)]
    bounds = sorted(set([0] + heads + [len(text)]))
    out = []
    for s, e in zip(bounds, bounds[1:]):
        if e - s <= maxlen:
            out.append((s, e))
            continue
        # 長い節は、空行(段落の切れ目)で maxlen 以内に分ける
        cur, last = s, s
        for p in [s + m.end() for m in re.finditer(r"\n\n", text[s:e])] + [e]:
            if p - cur > maxlen and last > cur:
                out.append((cur, last))
                cur = last
            last = p
        while e - cur > maxlen:          # 1 段落が maxlen を超えるときは字数で切る
            out.append((cur, cur + maxlen))
            cur += maxlen
        out.append((cur, e))
    return [(s, e) for s, e in out if text[s:e].strip()]

spans = [(d, s, e) for d, t in docs.items() for s, e in heading_chunks(t)]
chunks = [docs[d][s:e] for d, s, e in spans]
index = build(chunks)                    # 埋め込みの索引を作り直す
決まりどおり、③ 以降はこの切り方で続けました(A 系列)。比べるため、① の固定 500 字のまま ③〜⑤ を足す B 系列も作りました。
③ BM25 を足す(ハイブリッド検索)
BM25 は、問とチャンクに同じ語がどれだけあるかで並べる検索です。日本語は語の切れ目が無いので、Sudachi で語に分けてから数えました。
import numpy as np
from sudachipy import Dictionary, SplitMode
from rank_bm25 import BM25Okapi

tk = Dictionary(dict="core").create()
DROP = {"助詞", "助動詞", "補助記号", "記号", "空白"}
def toks(s):
    return [m.normalized_form() for m in tk.tokenize(s, SplitMode.A)
            if m.part_of_speech()[0] not in DROP]

bm25 = BM25Okapi([toks(c) for c in chunks], k1=1.2, b=0.75)

def bm25_top(q, n):
    return np.argsort(-bm25.get_scores(toks(q)), kind="stable")[:n]

def hybrid(q, k, n=50, rrf_k=60):
    # RRF: 埋め込みの上位 n と BM25 の上位 n を、1 / (rrf_k + 順位) の和で合わせる
    score = {}
    for ranks in (dense(q, n), bm25_top(q, n)):
        for r, i in enumerate(ranks, 1):
            score[i] = score.get(i, 0) + 1 / (rrf_k + r)
    return sorted(score, key=lambda i: -score[i])[:k]
- BM25 だけで探すと、言い換えの問に弱く(見出しで切ったとき 10 / 15。埋め込みは 15 / 15)、数字の問は埋め込みと同じくらいでした(14 / 15 と 15 / 15)。
- 2 つを RRF で合わせると、A 系列では Recall@5 は 49 のまま、上位 1 件は 31 から 30 でした。B 系列(固定 500 字)では、Recall@5 が 41 から 44(差の幅 -1〜+7)、上位 1 件が 24 から 29 でした。答えの正答は、A 系列で 44・45 から 46・45、B 系列で 43・43 から 44・44 でした。どれも差の幅の下の端は 0 以下でした。
④ リランク
③ の上位 30 件を、問とチャンクを一緒に読むモデル(クロスエンコーダー)で並べ直し、上位 5 件を渡しました。
from sentence_transformers import CrossEncoder

rr = CrossEncoder("cl-nagoya/ruri-v3-reranker-310m", device="cpu")

def rerank(q, k=5, n=30):
    cand = hybrid(q, n)
    sc = rr.predict([(q, chunks[i]) for i in cand], batch_size=8)
    return [cand[j] for j in np.argsort(-sc, kind="stable")][:k]
- 上位 1 件に入った問は 30 から 37 に増えました(差 +7、95% の幅 +3〜+12)。Recall@5 は 49 のままでした。B 系列では、Recall@5 が 44 から 46(割れた 4 問を除いた上限)、上位 1 件が 29 から 36 でした。
- 答えの正答は、A 系列で 46・45(③ と同じ)、B 系列で 44・46 でした。
- 悪くなった問もありました。 M04(税抜 50 万円の測定器)は、③ では「承認者は金額で決まる」の節が上位 5 件に入っていましたが、並べ直すと「分割とみなされやすい例」などが上に来て、この節が落ちました。2 モデルとも、③ までは正答、④ では承認者を答えられませんでした。
- 時間: CPU(スレッド 4 本)で 1 問 11.4 秒、固定 500 字のチャンクでは 23.5 秒でした。CPU が混んでいた本番の実行では 35〜71 秒です。GPU は試していません。
- 参考に、Claude Haiku 5.5 に ③ の上位 20 件から 5 件を選ばせると、上位 1 件は 30 から 39、Recall@5 は 50 / 50 でした。60 問で 6.8 クレジット、1 問 3.0 秒でした。
⑤ 文脈を付ける(Contextual Retrieval)
Anthropic が 2024年9月に発表した方法です。資料 1 本の全文とチャンクを AI に渡して「このチャンクは資料のどこの何か」を短く書かせ、チャンクの先頭に足して、埋め込みと BM25 の索引を作り直します。
- ⑤b AI の文脈: Claude Haiku 5.5 に、Anthropic が公開したプロンプトを日本語にした文(記事の最後に全文)で書かせました。見出しで切った 271 個で 25.1 クレジット、6 件ずつ同時に頼んで 113 秒でした。文脈は平均 96 字です。
- ⑤a 資料名と見出し: AI を使わず、「正社員就業規則 > 第3章 休日と休暇 > 特別休暇」のように、資料名と章と節の見出しを先頭に足しました。費用は 0 です。
② の docs と spans を使って、次のように足しました。
def heading_path(d, pos):
    # pos を含む節の見出しを「資料名 > 章(##) > 節(###)」の形にする
    t = docs[d]
    title = t.splitlines()[0].lstrip("# ").strip()
    h2 = h3 = ""
    for m in re.finditer(r"^(#{2,3}) (.+)$", t, re.M):
        if m.start() > pos:
            break
        if m.group(1) == "##":
            h2, h3 = m.group(2).strip(), ""
        else:
            h3 = m.group(2).strip()
    return " > ".join(x for x in (title, h2, h3) if x)

body = [docs[d][s:e] for d, s, e in spans]
# ⑤a: 資料名と見出しを先頭に足す(AI を使わない)
chunks = [heading_path(d, s) + "\n" + b for (d, s, e), b in zip(spans, body)]
# ⑤b: AI が書いた文脈を先頭に足す(contexts[i] は、i 番のチャンクについて文脈を書く AI が返した文)
# chunks = [contexts[i] + "\n" + b for i, b in enumerate(body)]
# どちらも、足した文ごと埋め込みと BM25 の索引を作り直し(index = build(chunks) と bm25 = …)、③ と ④ の流れで上位 5 件を探す
- Recall@5 は 49 のままでした。 上位 1 件は ⑤a・⑤b とも 38 でした(④ は 37)。
- 答えの正答は、2 モデルとも 48 / 50 になりました(④ から +2・+3)。⑤a と ⑤b で同じ数です。差の幅は Claude Haiku 5.5 で 0〜+5、GPT-6 Luna で -1〜+7 で、50 問では「効いた」と言い切れない幅です。
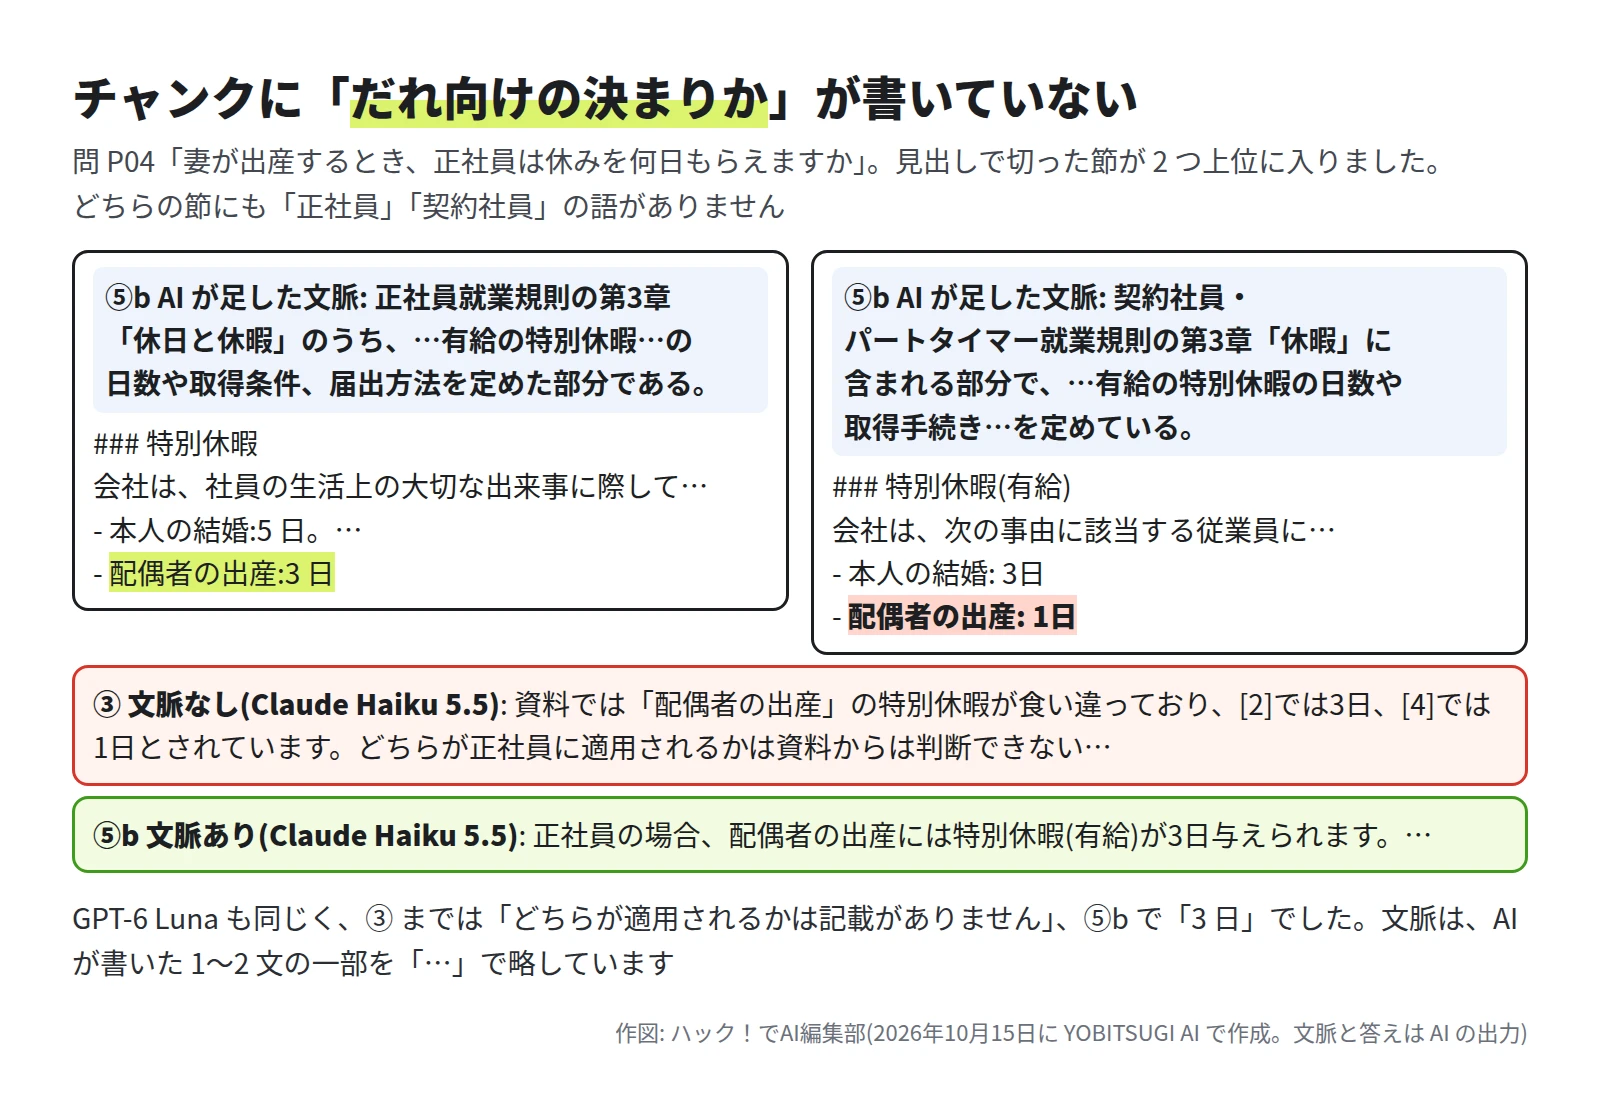
- 変わった問ははっきりしています。正社員と契約社員の節が両方上位に入った P04(妻の出産)と M01(結婚の特別休暇の差)は、① から ④ まで 2 モデルとも外し、⑤a と ⑤b では 2 モデルとも正答でした。
- B 系列(固定 500 字)でも、⑤a と ⑤b はどちらも答えの正答が 49・48 でした(B④ は 44・46)。Claude Haiku 5.5 の差は +5 で、95% の幅は +1〜+9 と、0 をまたぎませんでした。GPT-6 Luna は +2(幅 -2〜+6)です。
Anthropic の数字と比べる
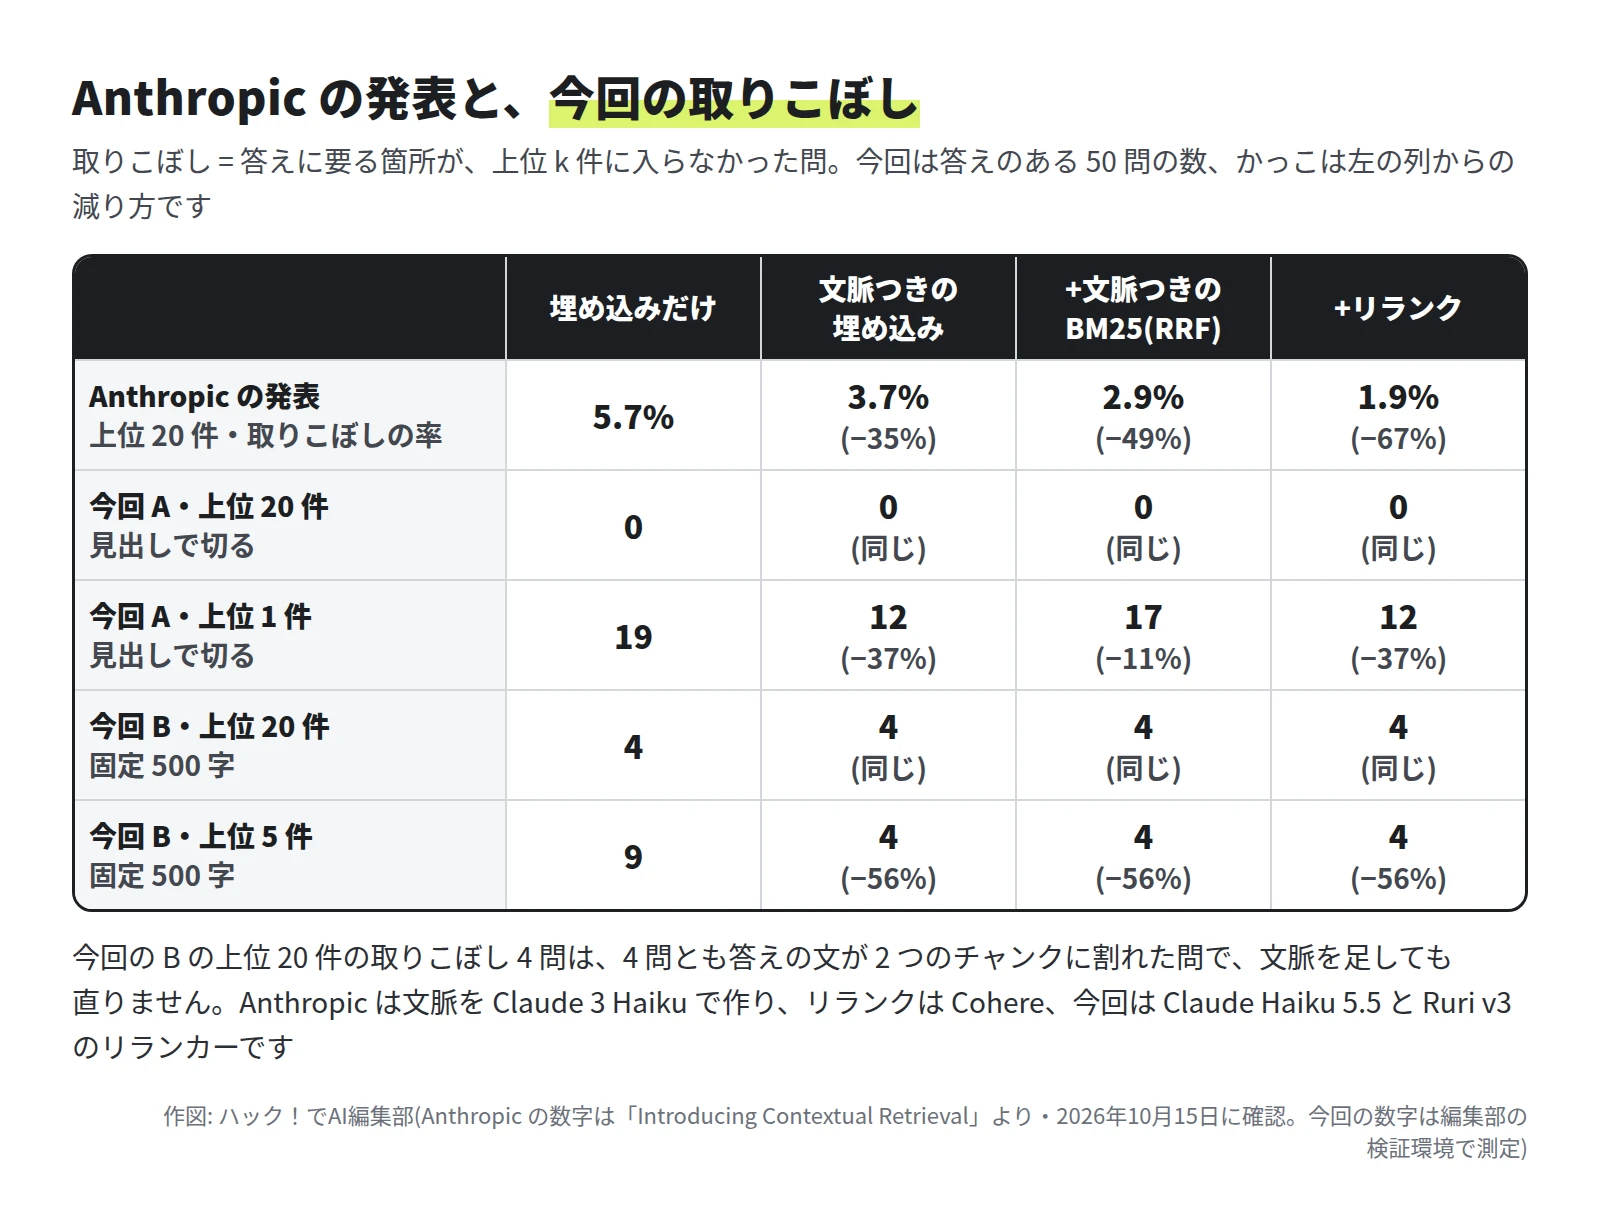
- Anthropic は、上位 20 件の取りこぼし(1 − Recall@20)が文脈で 35%、文脈つきの BM25 で 49%、リランクで 67% 減ったと書いています。
- 今回の資料は小さく、A 系列は埋め込みだけで上位 20 件の取りこぼしが 0 でした。B 系列の上位 20 件の取りこぼし 4 問は、どれも「割れた問」で、文脈を前に足しても直りません。上位 20 件の数字で、Anthropic と同じ傾向かどうかは確かめられませんでした。
- 確かめられたのは上位 5 件と上位 1 件だけです。B 系列の上位 5 件の取りこぼしは 9 問から 4 問(残りは割れた問)、A 系列の上位 1 件は 19 問から 12 問に減りました(埋め込みだけと文脈つきの埋め込みの比べ。95% の幅は +1〜+9 と +3〜+12)。減る向きは同じですが、数える件数も資料の量も Anthropic とは違います。
答えの正答はどう変わったか
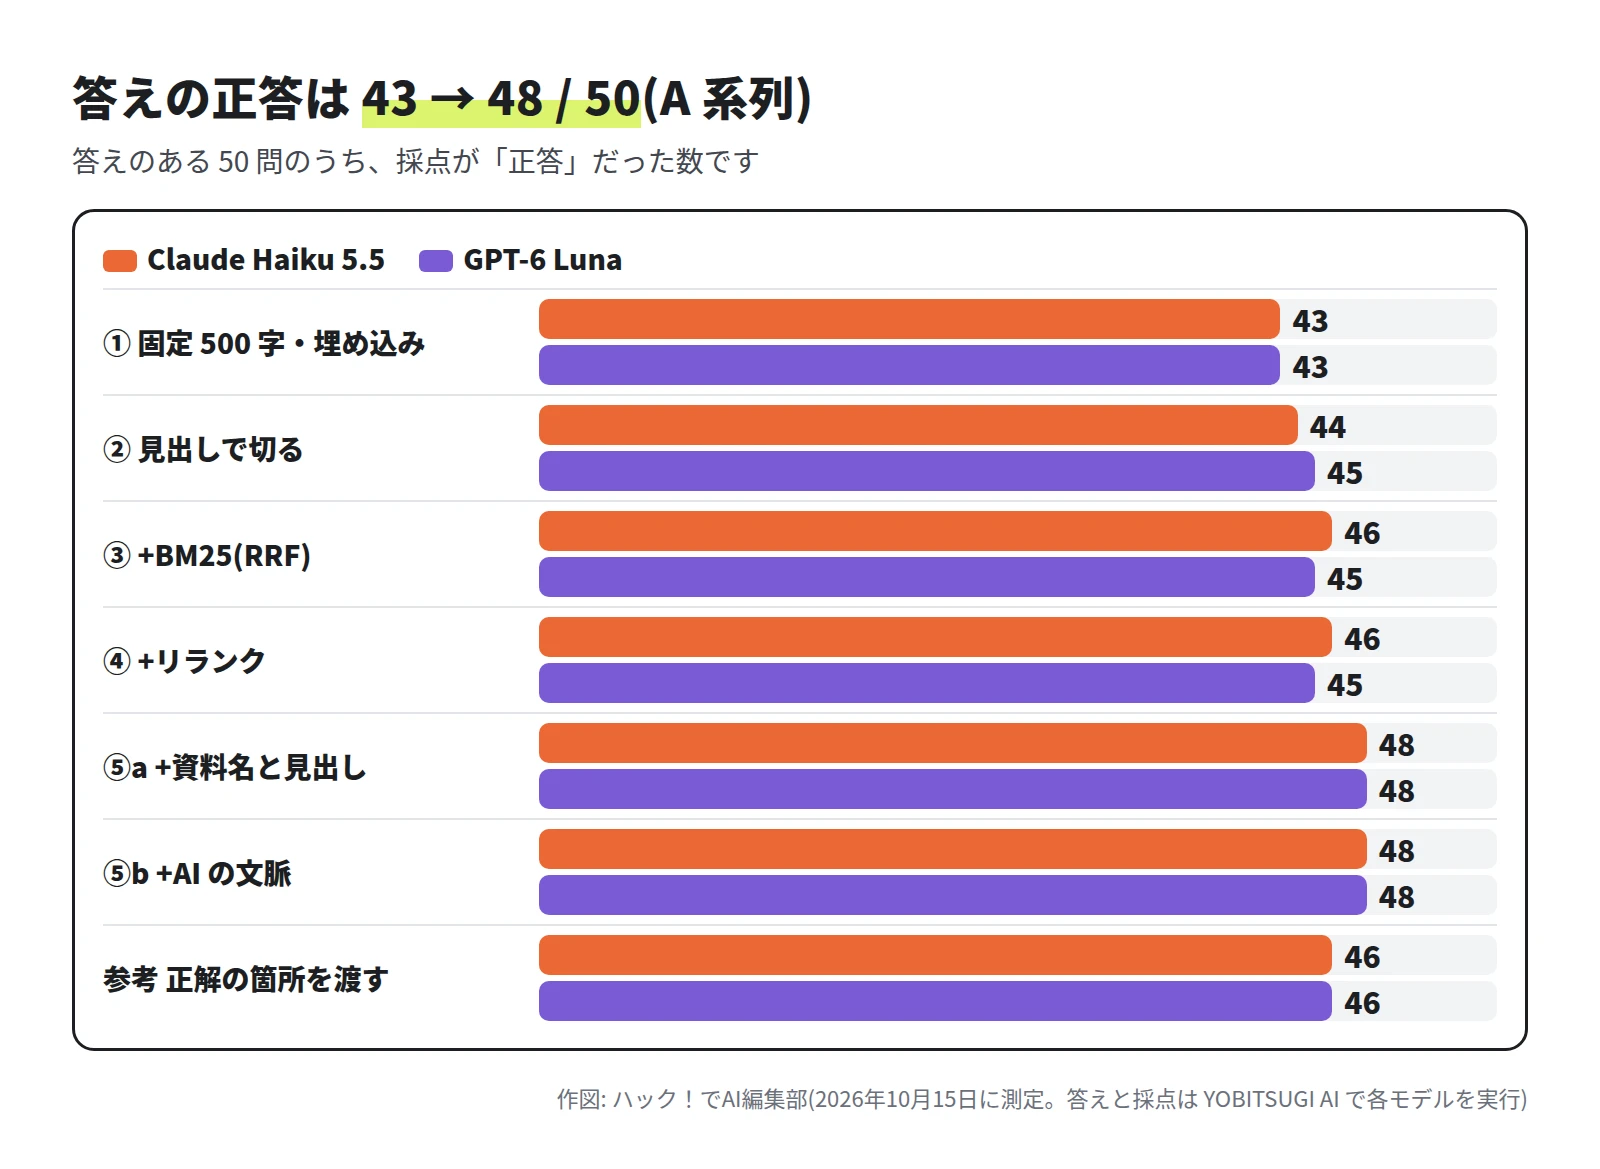
- 外れのほとんどは、採点が「一部」か「記載なし」でした。「誤り」は 1 件だけで、B③ の GPT-6 Luna が P04 で、契約社員の「1 日」を正社員の答えとして言い切った物です。資料にある答えを「記載がありません」と言ったのは、① で 4・3 問、⑤a で 0・0 問でした。
- ⑤ でも残ったのは、リランクで節が落ちた M04 と、消費税率が要る M07 でした。
- 参考に、答えの決め手の節そのものを渡すと 46・46 で、⑤ より少なくなりました。節だけでは「だれ向けか」「どの製品か」が分からない問がありました。たとえば校正サービスの費用(N10)は、「ロガー」の語が無い節だけを渡すと、GPT-6 Luna は「資料に記載がありません」と答えました。
費用と手間: どこまでやると見合うか
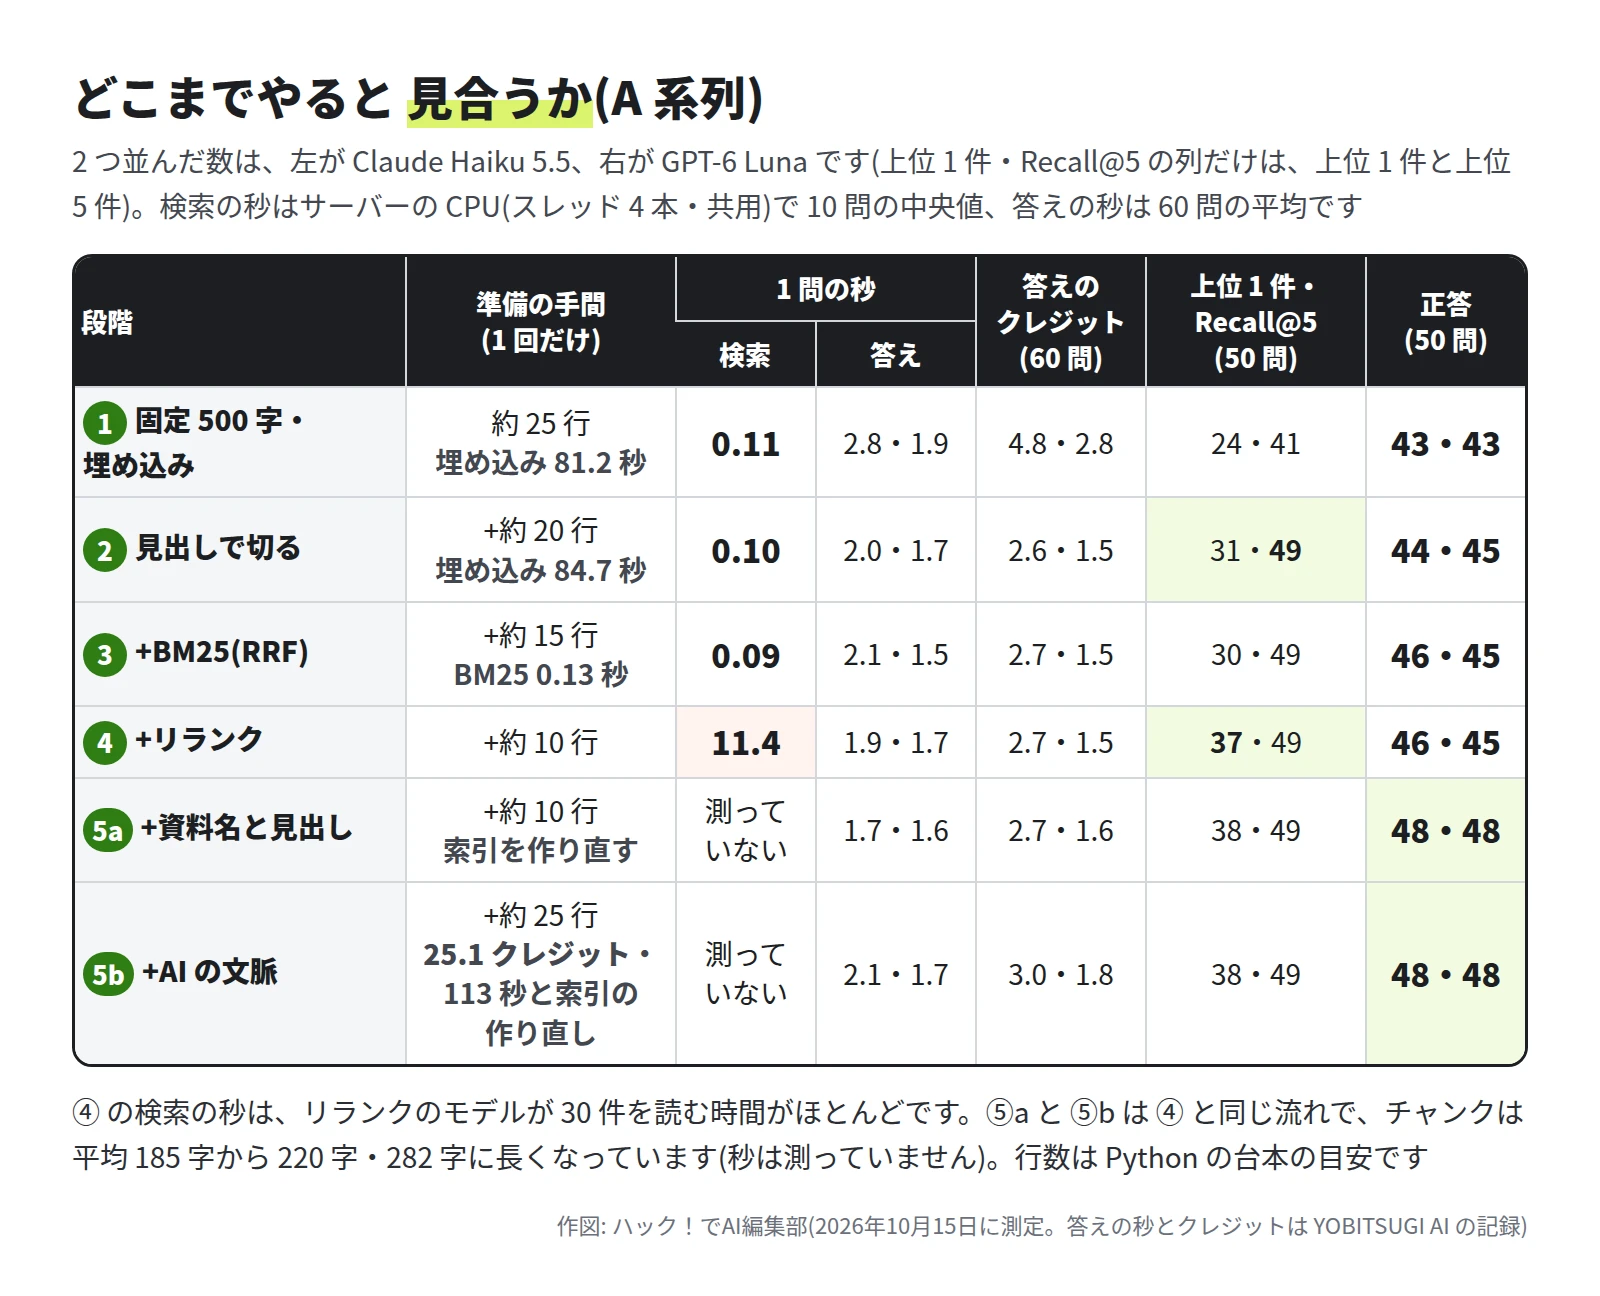
- ② 見出しで切る: 約 20 行、費用 0 で、1 問の秒も ① と同じくらいです。Recall@5 が +8 で、今回いちばん効きました。見出しの付いた資料なら、最初にやる価値があります。
- ⑤a 資料名と見出しを足す: 約 10 行、費用 0 で、答えの正答は ⑤b と同じ 48 でした。
- ⑤b AI の文脈: 約 25 行と、AI を 271 回呼ぶ 25.1 クレジットです(資料が変わったら、その分を作り直す)。今回は ⑤a と同じ結果でした。見出しの無い資料では ⑤a が使えないので、⑤b を試すことになります(今回は確かめていません)。
- ③ ハイブリッド: 約 15 行、費用 0、1 問 0.09 秒です。上位 5 件は A 系列では変わらず、B 系列では 41 から 44 でした(差の幅は 0 をまたぐ)。
- ④ リランク: 約 10 行です。上位 1 件は上がりましたが、CPU で 1 問 11.4 秒と、答えの AI の 2 秒前後より長くかかります。A 系列の答えの正答は変わりませんでした。
- 答えの AI は、1 問 2 秒前後、60 問で 1.5〜4.8 クレジットでした。渡す字数が多い ① と B 系列で高くなりました。
編集部の見立てでは、見出しの付いた資料なら、まず費用 0 の「② 見出しで切る」と「⑤a 資料名と見出しを足す」です。ただし ⑤a の答えは ③ と ④ も入れた形で測りました(③ と ④ を抜いた形は検索だけ測り、上位 5 件は 49 / 50、上位 1 件は 37)。③ と ④ は、資料が増えて上位 5 件に入らない問が出てきたら、測って決めるのがよいと考えます。
先行の解説と比べて
- FP16 の Zenn の記事(2026年2月): 日本語の資料と 4 言語の 2,000 問で、Ruri v3 などにスパース検索(bge-m3 の sparse)を足すと「P@1は微増だがP@3は下がる」とし、「ハイブリッド検索は銀の弾丸ではない」と書いています。足し方は違いますが(今回は BM25 と RRF)、今回も A 系列の上位 5 件は変わらず、上位 1 件は 31 から 30 でした。
- Microsoft の評価を紹介した Qiita の記事(2023年9月): 「チャンク間の重複を 25%, 512 トークン」で Recall@50 がいちばん高く、品質は「セマンティックハイブリッド>ハイブリッド>ベクトル>キーワード」の順だったと紹介しています。今回も重ねを付けると固定 500 字の 41 が 44 になりましたが、差の幅は -2〜+8 で言い切れません。ハイブリッドとリランクは、A 系列の上位 5 件を変えませんでした。
気をつけること
- 資料が小さい: 36 ページ・271 個のチャンクです。数千ページになると、上位 5 件に入らない問が増え、ハイブリッドやリランクが効く余地が出るかもしれません。今回は確かめていません。
- 1 回ずつの結果: 答えの AI は、同じプロンプトでも答えが少し変わります。差が 1〜3 問の所は、幅の下の端が 0 以下です。
- 採点は AI: 読んで確かめたのは一部です(上の「採点の確かめ」)。「コアタイムの時刻は資料に無い」のような留保を添えた答えは、正答と一部の境目になります。
- 見出しのある Markdown で試した: PDF やスキャンの資料では、見出しが取れないことがあります。見出しを使わない B 系列は、その場合を想定して作りました。
- 時間は共用の CPU の値: ほかの作業と CPU を分け合っていたので、秒は目安です。
まとめ
- 今回の 36 ページの資料では、見出しで切ると Recall@5 が 41 から 49 / 50 になり、チャンクの先頭に資料名と見出しを足すと、答えの正答が 48 / 50 になりました。
- 見出しで切った A 系列では、ハイブリッド検索とリランクは上位 5 件を変えず、リランクは上位 1 件を上げた代わりに、CPU で 1 問 11 秒ほどかかりました。
- 自分の資料で試すときは、問を作って答えの箇所を先に決めてから、1 段階ずつ足して測ってください。
渡した文(全文)
答えを書く AI(Claude Haiku 5.5・GPT-6 Luna)
全段階・2 モデルに同じ文を渡しました(YOBITSUGI AI の ask_ai・tier は fast・system は使わない。ほかの指示も同じ)。{1 位のチャンク} などには、上位 5 件のチャンクの文(⑤ は先頭に足した文を含む)が入ります。
あなたは株式会社ソラマド計測の社内の問い合わせ窓口です。下の「資料」だけを根拠に、「質問」に日本語で答えてください。

決まり:
- 資料に書いてあることだけで答える。書いていないことを推測で補わない。
- 資料に答えが無いときは「資料に記載がありません。」とだけ答える。
- 数字・期限・条件は資料の書き方のまま書く。
- 3 文以内で答え、最後に根拠にした資料の番号を [1] のように書く。

資料:
[1]
{1 位のチャンク}

[2]
{2 位のチャンク}

[3]
{3 位のチャンク}

[4]
{4 位のチャンク}

[5]
{5 位のチャンク}

質問: {問}
採点の AI(DeepSeek V4.1 Flash)
答え 1 件ごとに 1 回渡しました(1,304 回)。
あなたは採点係です。社内の資料についての「質問」への「答え」を、「正解」と比べて判定してください。

質問: {問}
正解: {正解の文}
採点の要点: {採点の要点}

答え: {答え}

判定の決まり:
- 正答: 採点の要点がすべて合っていて、要点と食い違うことを書いていない。言い回しの違いは問わない。
- 一部: 要点の一部だけ合っている。または要点は合っているが、要点と食い違う誤りが混じる。
- 誤り: 要点が合っていない。
- 記載なし: 「資料に記載が無い」という趣旨の答えで、要点を答えていない。
答えの無い質問(正解が「資料に記載が無い」)では、「資料に記載が無い」と答えていれば「記載なし」、何かを言い切っていれば「誤り」にする。

出力は次の形の JSON 1 行だけにしてください。
{"判定": "正答|一部|誤り|記載なし", "理由": "30字以内"}
文脈を書く AI(Claude Haiku 5.5・⑤b)
Anthropic が公開したプロンプトを、編集部が日本語にしました。{資料 1 本の全文} にはチャンクのある資料の全文が、{チャンク} には先頭に何も足していないチャンクの文が入ります。
<document>
{資料 1 本の全文}
</document>
この資料の中の、次のチャンクの位置づけを説明してください。
<chunk>
{チャンク}
</chunk>
検索でこのチャンクを見つけやすくするために、資料全体の中でこのチャンクが何についての部分かを、短い文脈として 1〜2 文で書いてください。文脈の文だけを答え、ほかには何も書かないでください。
Anthropic の発表にある元の英語のプロンプトです。
<document>
{{WHOLE_DOCUMENT}}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{{CHUNK_CONTENT}}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else.
並べ替えの AI(参考・Claude Haiku 5.5)
次の「質問」に答えるのに役立つ資料を、下の 20 件から 5 件選び、役立つ順に番号を並べてください。

質問: {問}

[1]
{③ の 1 位のチャンク}

[2]
{③ の 2 位のチャンク}

(… [20] まで)

出力は番号をカンマで区切った 1 行だけにしてください(例: 3,1,12,7,5)。
資料を書かせた文(Claude Sonnet 5.5・20 回のうち 1 回目の全文)
ask_ai の tier は standard です。20 回とも同じ形で、資料の題・書く部分・文体・入れる事実だけを替えました(後半の 10 回は、最初の行に題を書かせない指示に替えた)。
架空の会社「株式会社ソラマド計測」(計測機器のメーカー・社員 約 180 人)の社内資料を書いてください。実在の会社・製品・サービスの名前は使わないでください。

資料の題: 正社員就業規則
今回書く部分: 前半(第1章 総則、第2章 勤務時間(所定の勤務時間・勤怠の記録・フレックスタイム・時間外勤務・遅刻と早退))

書き方:
- Markdown で書く。最初の行に「# 正社員就業規則」と書き、そのあと今回の部分の見出しは「## 」(章)と「### 」(節)を使う。
- 文体は である調。
- 下の「入れる事実」は、数字と条件を変えずに、すべて本文に入れる。入れる事実に無い数字・制度・手当・休暇・期限を新しく足さない。
- 節の中では「本規程」「この場合」「前項」のように、資料の名前をくり返さない書き方でよい。
- 長さは 2,500〜3,000 字。表は使わず、文と箇条書きで書く。
- 資料の本文だけを出力する(前置き・あとがき・コードの枠は書かない)。

入れる事実:
- この規則は株式会社ソラマド計測の正社員に適用する。契約社員とパートタイマーには別の規則を定める。
- 所定の勤務時間は 9 時から 17 時 45 分。休憩は 12 時から 13 時の 60 分。所定の労働時間は 1 日 7 時間 45 分。
- 始業と終業は勤怠システム「ソラマド勤怠」で打刻する。打刻を忘れたときは、翌営業日までに修正を申請する。
- フレックスタイム制の対象は、入社して 6 か月以上たち、所属長が認めた正社員。コアタイムは 11 時から 14 時。フレキシブルタイムは 7 時から 11 時と 14 時から 21 時。清算期間は 1 か月。
- 時間外勤務は、事前に所属長の承認を受ける。時間外勤務は月 45 時間・年 360 時間を超えないようにする。
- 遅刻と早退は 30 分単位で記録する。
参考にした公式の情報
- Anthropic「Introducing Contextual Retrieval」
- Hugging Face「cl-nagoya/ruri-v3-310m」(モデルカード)
- Hugging Face「cl-nagoya/ruri-v3-reranker-310m」(モデルカード)
- Faiss wiki「Faiss indexes」
- Cormack, Clarke, Buettcher「Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods」(SIGIR 2009)
- PyPI「SudachiPy」
- Zenn(株式会社FP16)「日本語RAGのEmbeddingモデル、結局どれが最強なのか?6構成で2000問ベンチマークした」
- Qiita(@nohanaga)「Microsoft が Azure Cognitive Search による RAG システムの定量評価結果を公表」
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
AI技術大全全 2 回の目次
- 1RAG の精度を上げるには? チャンク・ハイブリッド検索・リランクを順に足して測った(この記事)
- 2LoRA の作り方 8GB の GPU で画像の LoRA を学習し、枚数と時間を測った