AI技術大全 第5回
日本語の埋め込みモデルを比較 社内資料の検索で 7 つを測った
 佐々木 航
この記事でわかること
- 7 つの Recall@5 と MRR@10、差が言えた組と言えない組
- 半角カナ・前置き・binary で、検索の正しさがどれだけ落ちるか
- 1 万件・100 万件を埋め込む CPU の時間と API の費用
確認した環境: sentence-transformers 6.1.0・faiss-cpu 1.15.1 を CPU で実行、API は YOBITSUGI AI で text-embedding-3-large・gemini-embedding-2 / 2026年10月15日に確認
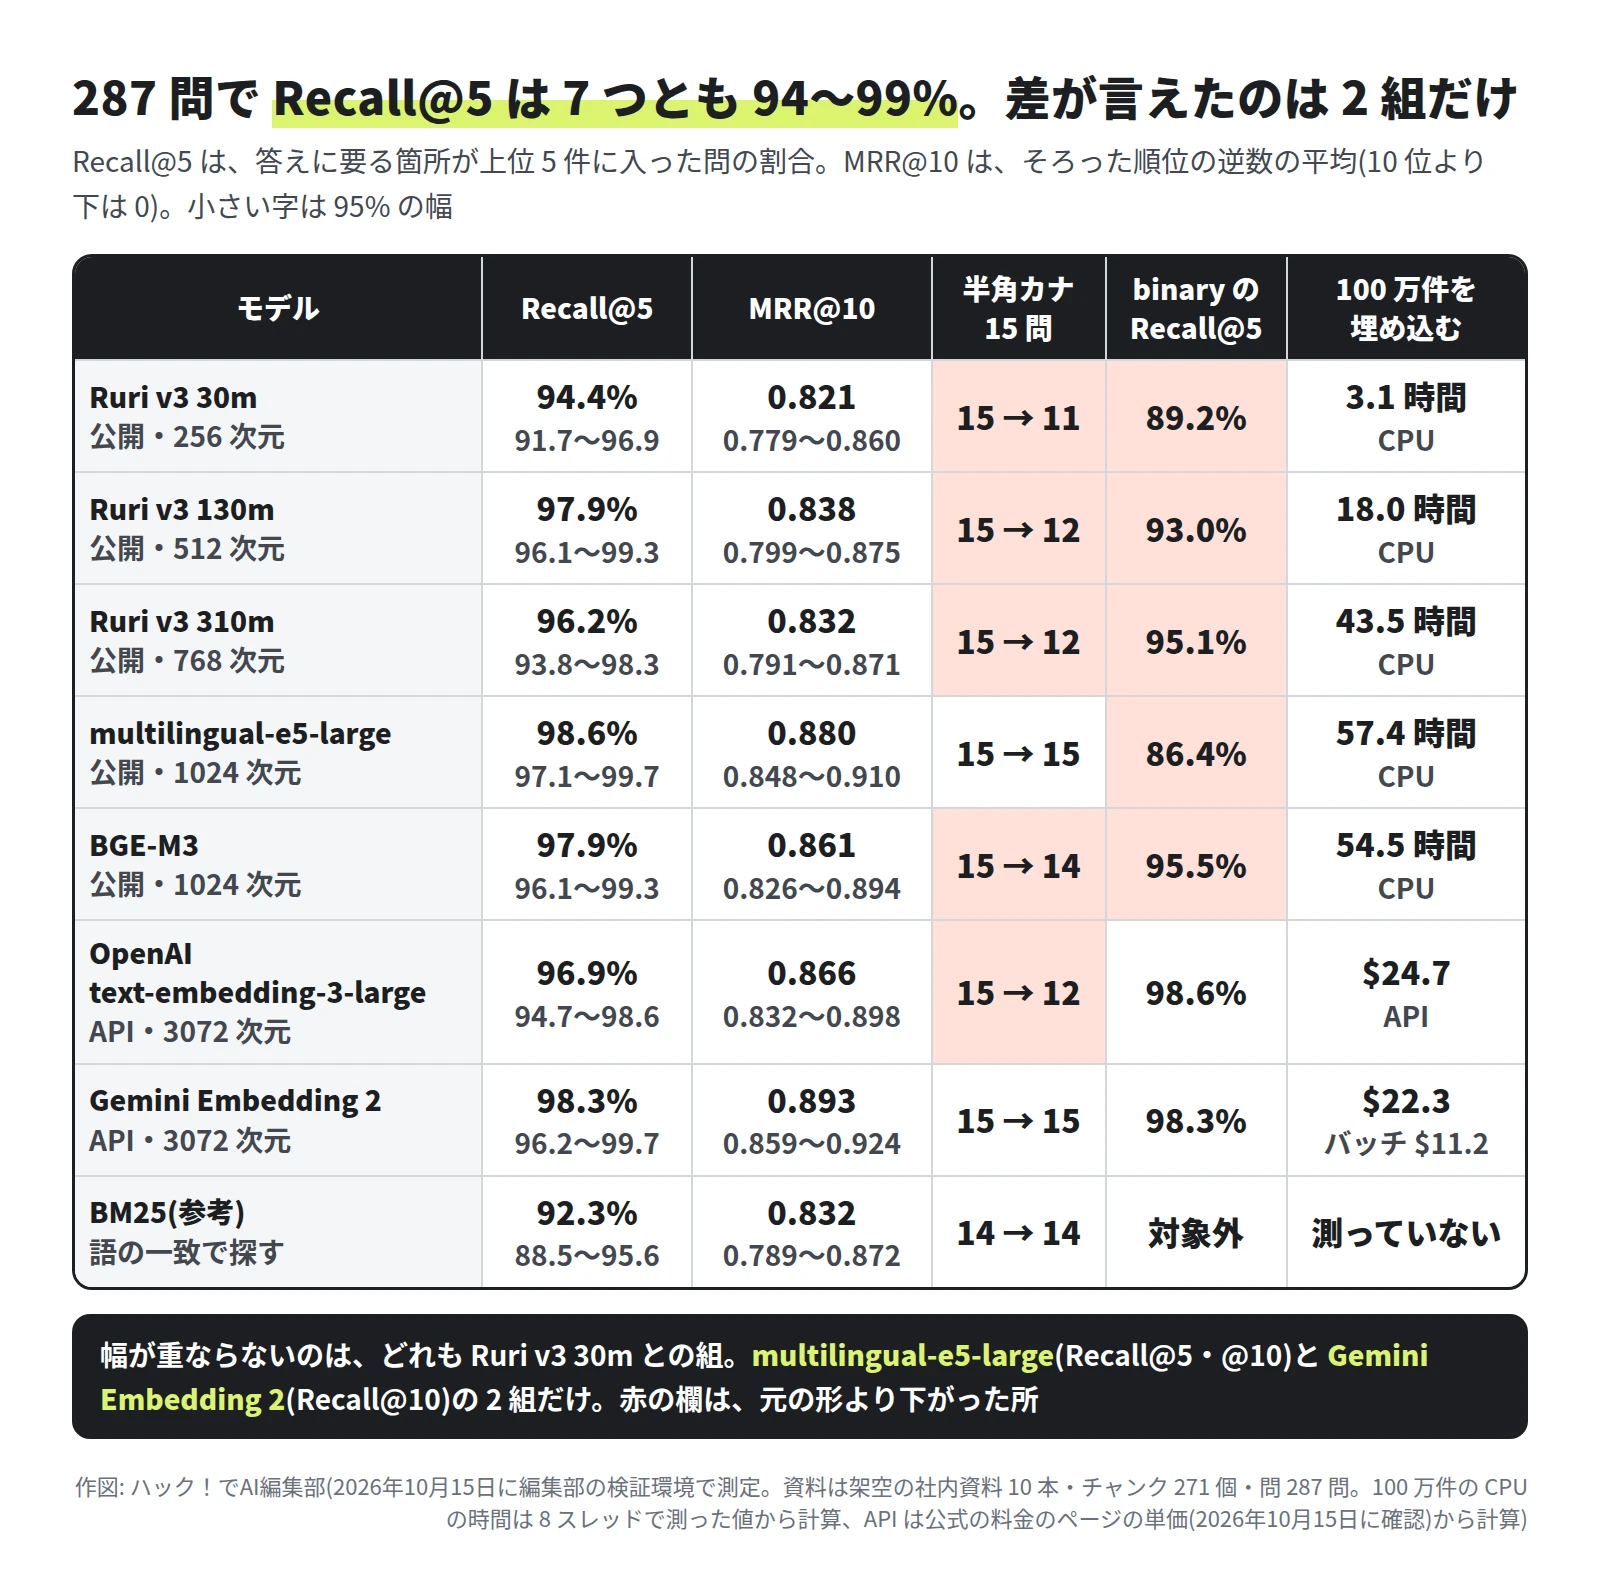
日本語の社内資料を検索するとき、埋め込みモデルはどれを選べばよいのか。架空の会社の社内資料と 287 問で、公開のモデル 5 つと API 2 つを測ると、答えの箇所が上位 5 件に入った割合(Recall@5)は 94.4〜98.6% で、95% の幅が重ならずに差が言えたのは、Ruri v3 30m との 2 組だけでした。はっきり差が出たのはモデルより使い方の所で、半角カナで聞くと Ruri v3 と OpenAI は 15 問中 3〜4 問を落とし、binary に縮めると multilingual-e5-large は Recall@5 が 12.2 ポイント下がりました。
結果の早見
埋め込みとベクトル検索
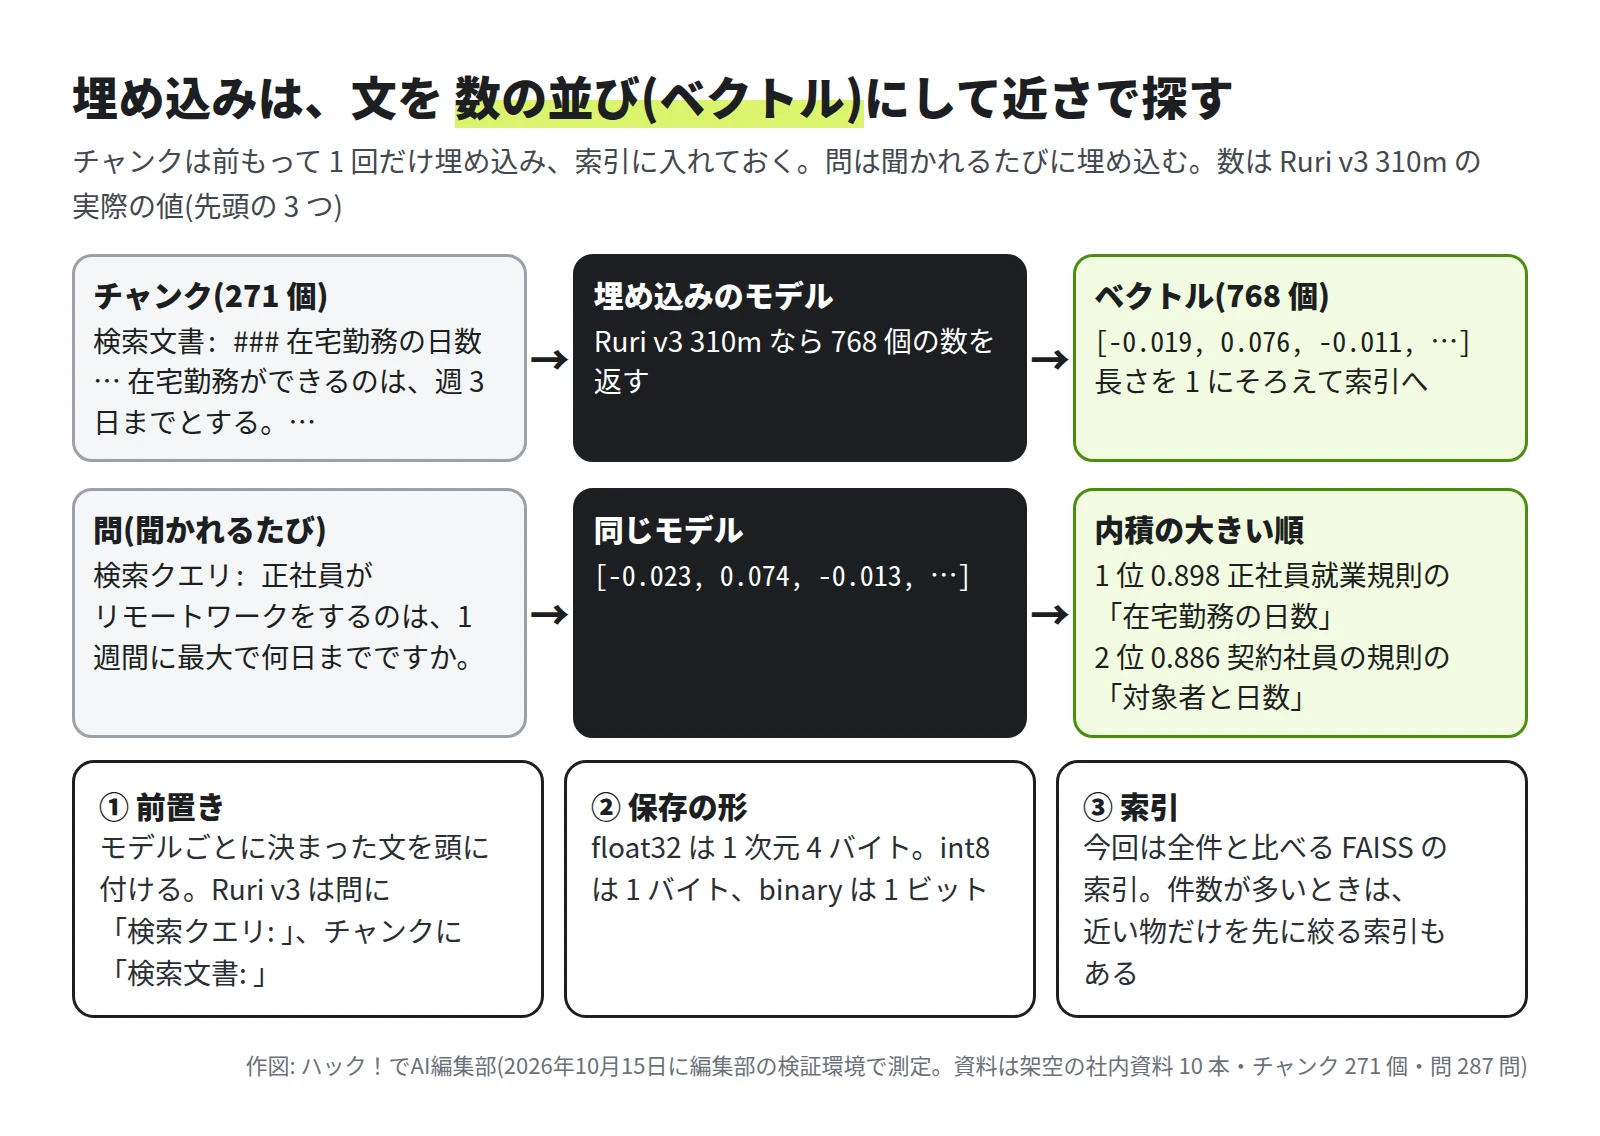
埋め込みは、文を数百から数千個の数の並び(ベクトル)に変える処理です。意味の近い文ほど、ベクトルの向きが近くなるように学習されています。資料を切った小さな部分(チャンク)は前もって埋め込んで索引に入れておき、問はそのつど埋め込んで、内積の大きい順に並べます。第1回の RAG の記事で使った Ruri v3 310m を、今回はほかのモデルと入れ替えて比べます。
作った物と測り方
資料とチャンク
- 第1回と同じ、架空の会社「株式会社ソラマド計測」の社内資料 10 本(就業規則・経費・製品 FAQ など・合わせて 50,101 字)です。
- 第1回でいちばん良かった「見出しで切る」切り方で、271 個のチャンク(平均 185 字)にし、7 つに同じ文を渡しました。
問 287 問
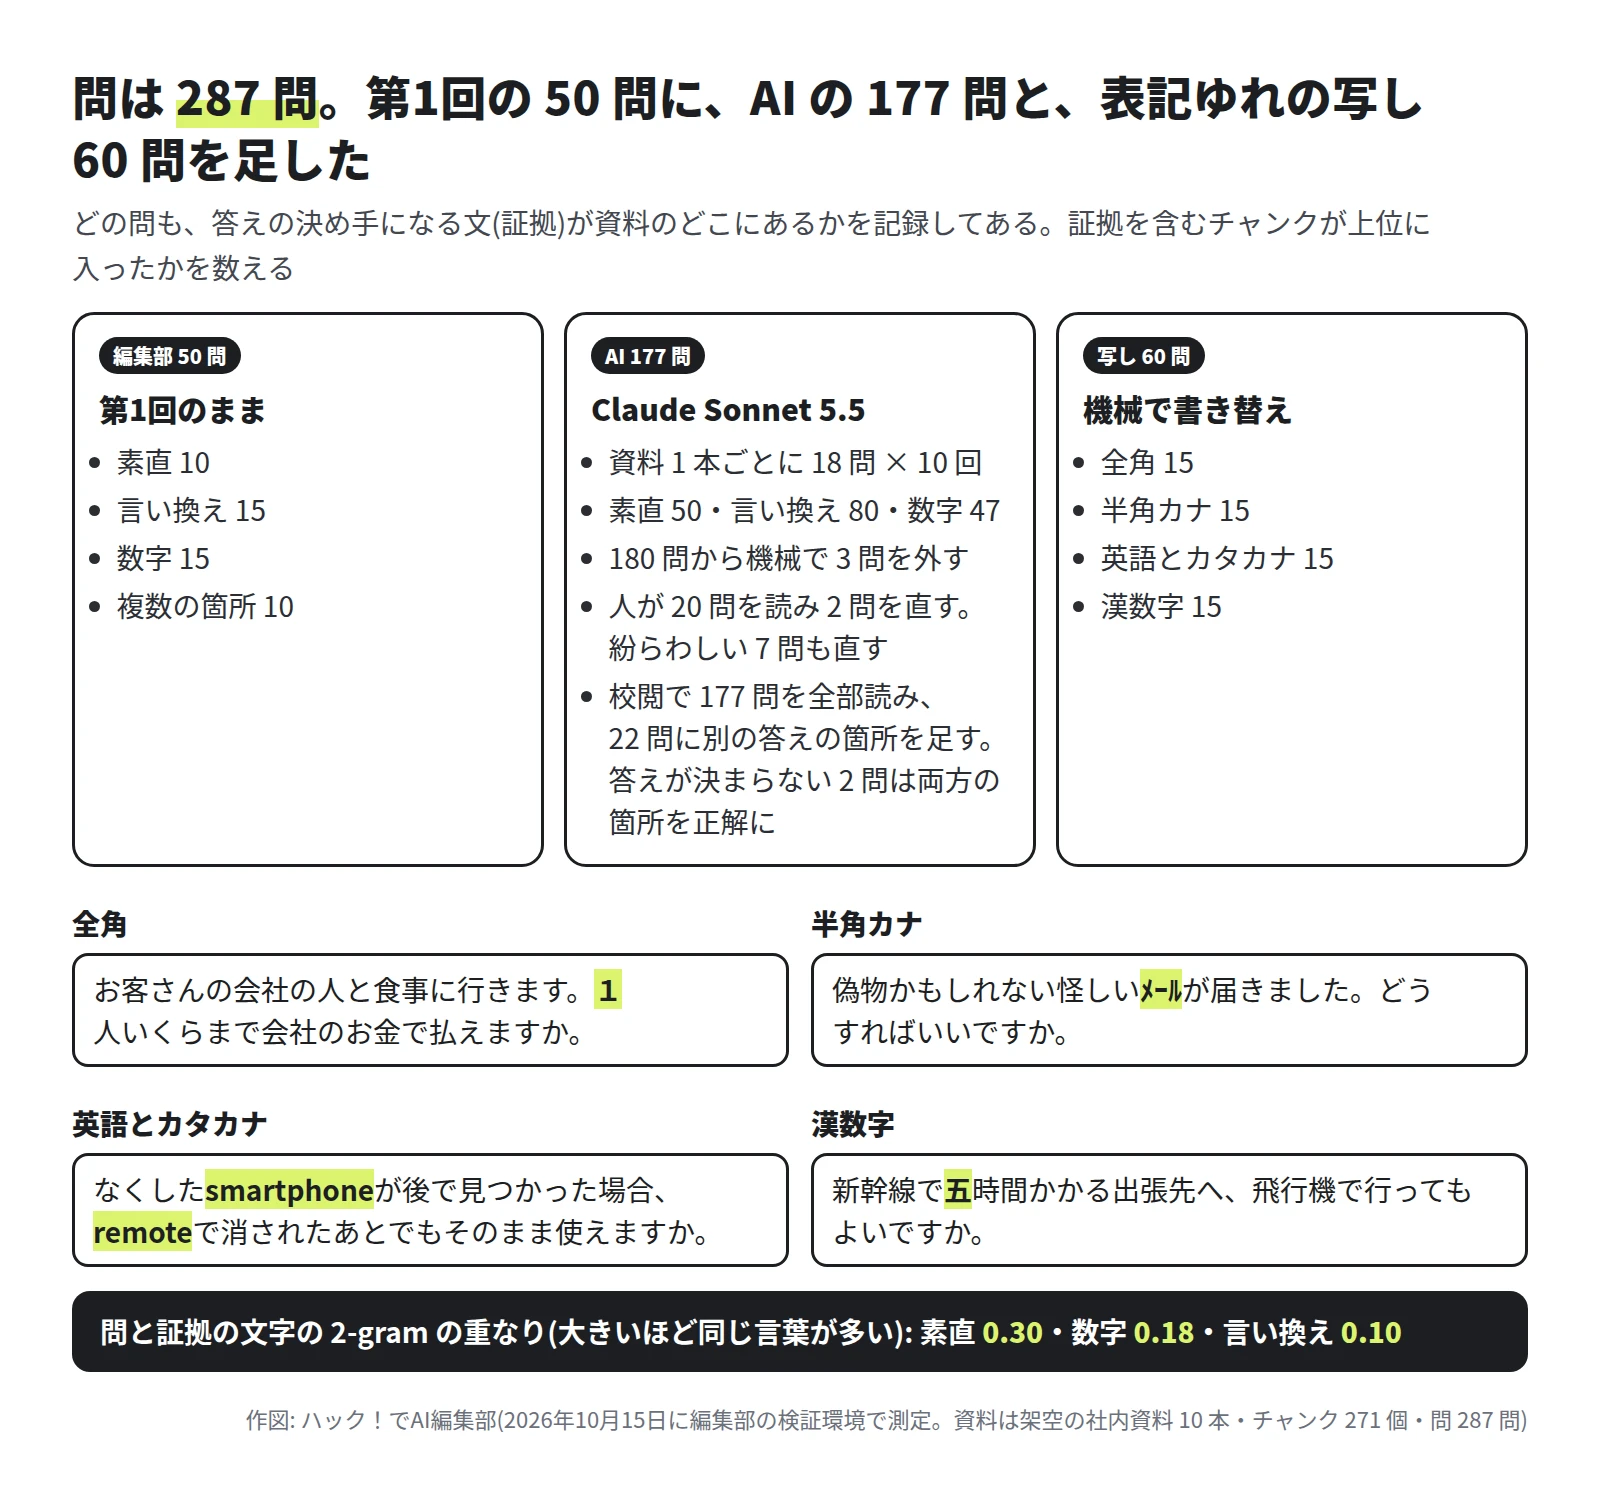
- 編集部の 50 問: 第1回の 60 問のうち、答えのある 50 問です。
- AI の 177 問: 資料 1 本ずつ、Claude Sonnet 5.5 に 18 問を作らせました(10 回・131.1 クレジット・プロンプトは記事の最後)。答えの決め手の文(証拠)を資料から写させ、資料にそのままあるかを機械で確かめ、すでにある問と同じ箇所の 3 問を外しました。
- 人の確かめ: 決まった種で選んだ 20 問を編集部(Claude Code を使用)が資料と見比べ、正社員か契約社員かが問に無く答えが 1 か所に決まらない 2 問を直しました。同じ型の 7 問も直しました。
- 校閲の見直し: 結果を見たあと、校閲で AI の 177 問を全部資料と照らし、同じ答えが別の所にもある 22 問は、その箇所も正解に足しました(写しを含め 28 問)。国内か海外か、正社員か契約社員かが問に無く答えが決まらない 2 問は、文を変えると API の埋め込みを作り直すことになるので、どちらの読み方の箇所も正解にしました(写しを含め 3 問)。7 つに同じく当てています。
- 表記ゆれの写し 60 問: 元の問を機械で全角・半角カナ・英語とカタカナ(ロガーを logger に など)・漢数字に書き替えた写しを、15 問ずつ作りました。
モデルと設定
| モデル | ライセンスなど | 次元 | 前置き(問 / チャンク) | 長さの上限 |
|---|---|---|---|---|
| Ruri v3 30m・130m・310m(cl-nagoya) | Apache 2.0 | 256・512・768 | 「検索クエリ: 」/「検索文書: 」 | 8,192 トークン |
| multilingual-e5-large(intfloat) | MIT | 1,024 | 「query: 」/「passage: 」 | 512 トークン |
| BGE-M3(BAAI・密なベクトルだけ) | MIT | 1,024 | なし | 8,192 トークン |
| OpenAI text-embedding-3-large | API(各社の規約) | 3,072 | なし | 8,192 トークン |
| Gemini Embedding 2(gemini-embedding-2) | API(各社の規約) | 3,072 | 「task: search result | query: 」/「title: none | text: 」 | 8,192 トークン |
- ライセンス・次元・前置き・長さの上限は、各モデルのカードと公式のドキュメントで確かめました(2026年10月15日)。multilingual-e5-large のカードは前置きを付けないと性能が落ちると書き、BGE-M3 のカードは問に指示は要らないと書いています。
- 長さの上限で切れたチャンクはありませんでした。CPU は AMD EPYC-Milan(スレッド 8 本・ほかの作業と共用)です。
次の版で動かしました(Python 3.12・PyTorch 2.14.1 の CPU 版)。BGE-M3 は重みが pytorch_model.bin だけなので、safetensors だけを取る設定では読み込めませんでした。
pip install "sentence-transformers==6.1.0" "transformers==5.19.0" "faiss-cpu==1.15.1" "numpy==2.5.4"
import faiss
from sentence_transformers import SentenceTransformer

# モデルごとの前置き(問, チャンク)。各モデルのカードの決まり
PREFIX = {
    "cl-nagoya/ruri-v3-30m":  ("検索クエリ: ", "検索文書: "),
    "cl-nagoya/ruri-v3-130m": ("検索クエリ: ", "検索文書: "),
    "cl-nagoya/ruri-v3-310m": ("検索クエリ: ", "検索文書: "),
    "intfloat/multilingual-e5-large": ("query: ", "passage: "),
    "BAAI/bge-m3": ("", ""),          # 問に指示は要らない。密なベクトルだけを使う
}

name = "cl-nagoya/ruri-v3-130m"
qp, dp = PREFIX[name]
model = SentenceTransformer(name, device="cpu")

# chunks はチャンクの文のリスト(271 個)
D = model.encode([dp + c for c in chunks], batch_size=16, normalize_embeddings=True)
index = faiss.IndexFlatIP(D.shape[1])   # 長さ 1 にしたので、内積 = コサイン類似度
index.add(D)

def search(q, k=10):
    v = model.encode([qp + q], normalize_embeddings=True)
    return index.search(v, k)[1][0]      # 近い順のチャンクの番号
API の 2 つは、YOBITSUGI AI の中継から各社の API の形(OpenAI は embeddings、Gemini は batchEmbedContents)のまま、64 件ずつ送りました。上が OpenAI、下が Gemini の形です(Gemini はチャンクと問を別の回で送った)。
{"model": "text-embedding-3-large", "input": ["チャンク 1 の文", "チャンク 2 の文"], "encoding_format": "float"}
{"requests": [
  {"model": "models/gemini-embedding-2", "content": {"parts": [{"text": "title: none | text: チャンク 1 の文"}]}},
  {"model": "models/gemini-embedding-2", "content": {"parts": [{"text": "task: search result | query: 問の文"}]}}
]}
数え方
- Recall@k: 答えに要る箇所が全部、上位 k 件のチャンクに入った問の割合です。k は 1・5・10 です。複数の箇所の問(10 問)は 2 つ以上のチャンクが要るので、上位 1 件には入りません。
- MRR@10: 要る箇所が全部そろった最初の順位 r の、1/r の平均です。1 位なら 1、2 位なら 0.5 で、10 位までにそろわなければ 0 です。
- 95% の幅: 問を選び直して計算し直すブートストラップ(10,000 回・乱数の種 20261015)で出しました。表記ゆれの写しは、元の問とひとまとまりにして選び直しています。幅が重なる差では順位を付けず、前置きや量子化の差は同じ問の対で幅を出しました。
7 つの結果: 差が言えたのは 2 組
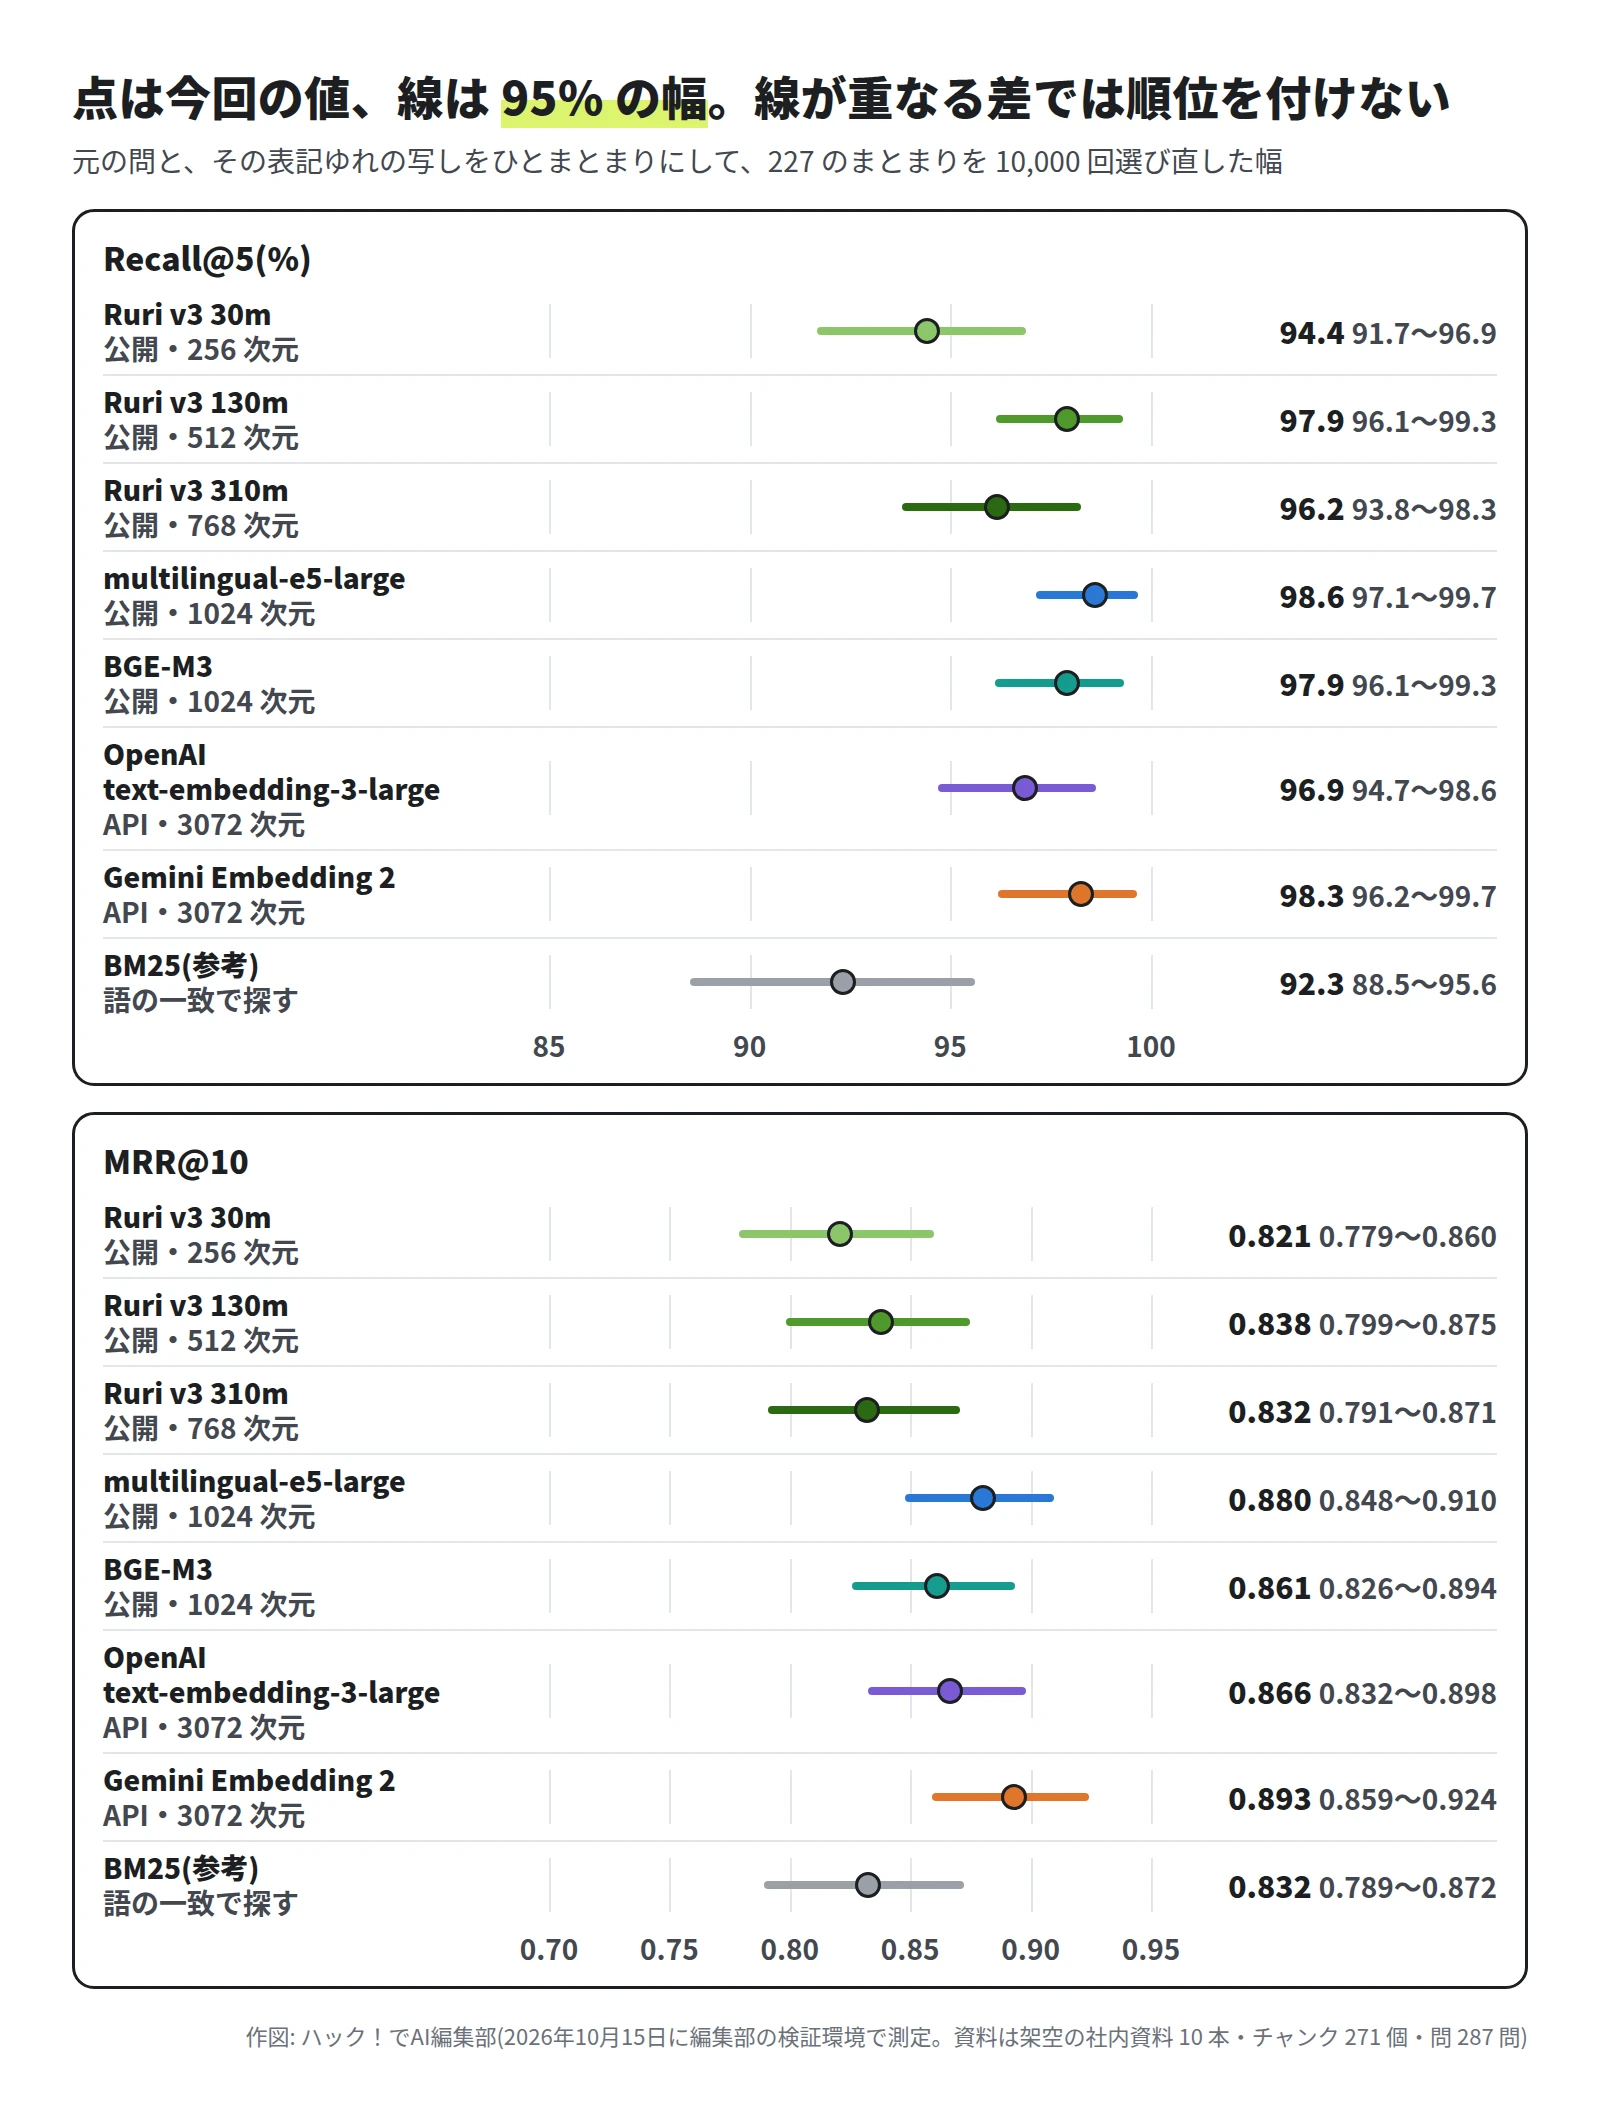
- Recall@10 は 96.5〜99.7% で、どのモデルでも答えの箇所が上位 10 件にほぼ入りました。幅が重ならないのは、Ruri v3 30m と multilingual-e5-large・Gemini Embedding 2 の組です。
- Recall@1 は 73.2%(Ruri v3 30m)から 82.2%(Gemini Embedding 2)まででしたが、どの組も幅が重なりました。
- Ruri v3 30m との組のほかは、130m と 310m の差も、API と公開のモデルの差も言えませんでした。参考の BM25(語の一致で探す方法)は、Recall@5 が 92.3% でした。
6 つ以上が上位 5 件を外したのは、要る箇所が 3 つある M10(海外出張の支度金と日当)と、言い換えの G10-13(承認の前に、注文の意思を取引先へ伝えてよいか)でした。
問の種類ごとの差
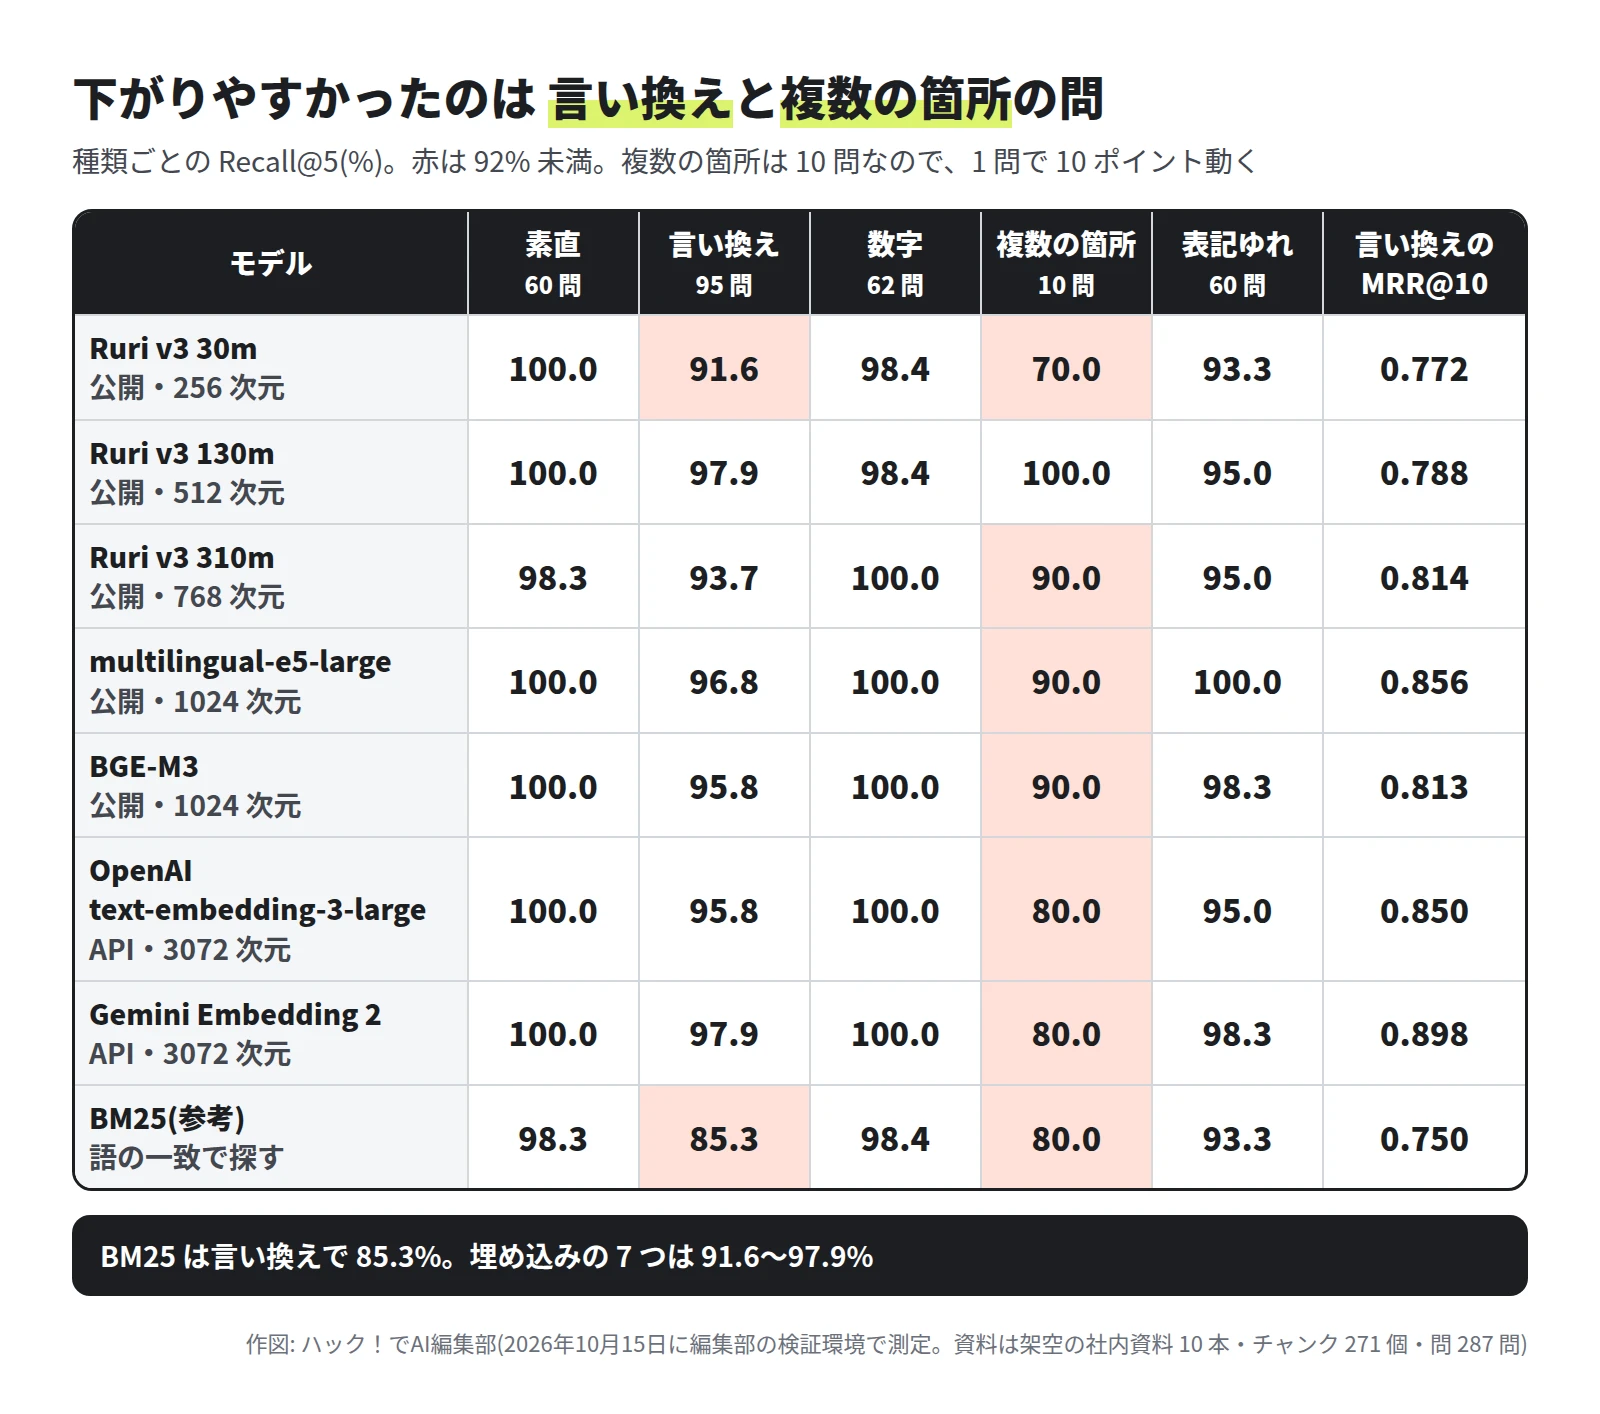
- 素直と数字の問は、7 つとも 98〜100% でした。
- 言い換えは 91.6〜97.9% で、BM25 は 85.3% でした。言い換えの MRR@10 は 0.772〜0.898 で、幅が重ならないのは Gemini Embedding 2(0.898)と Ruri v3 30m(0.772)の組だけです。
- 複数の箇所は 70〜100% ですが、10 問なので 1 問で 10 ポイント動きます。
- 出どころで分けると、編集部の問(1 か所で決まる 40 問)の Recall@1 は 77.5〜90.0% で、AI の 177 問(72.3〜84.7%)より低くはありませんでした。
表記ゆれ: 半角カナで落ちた
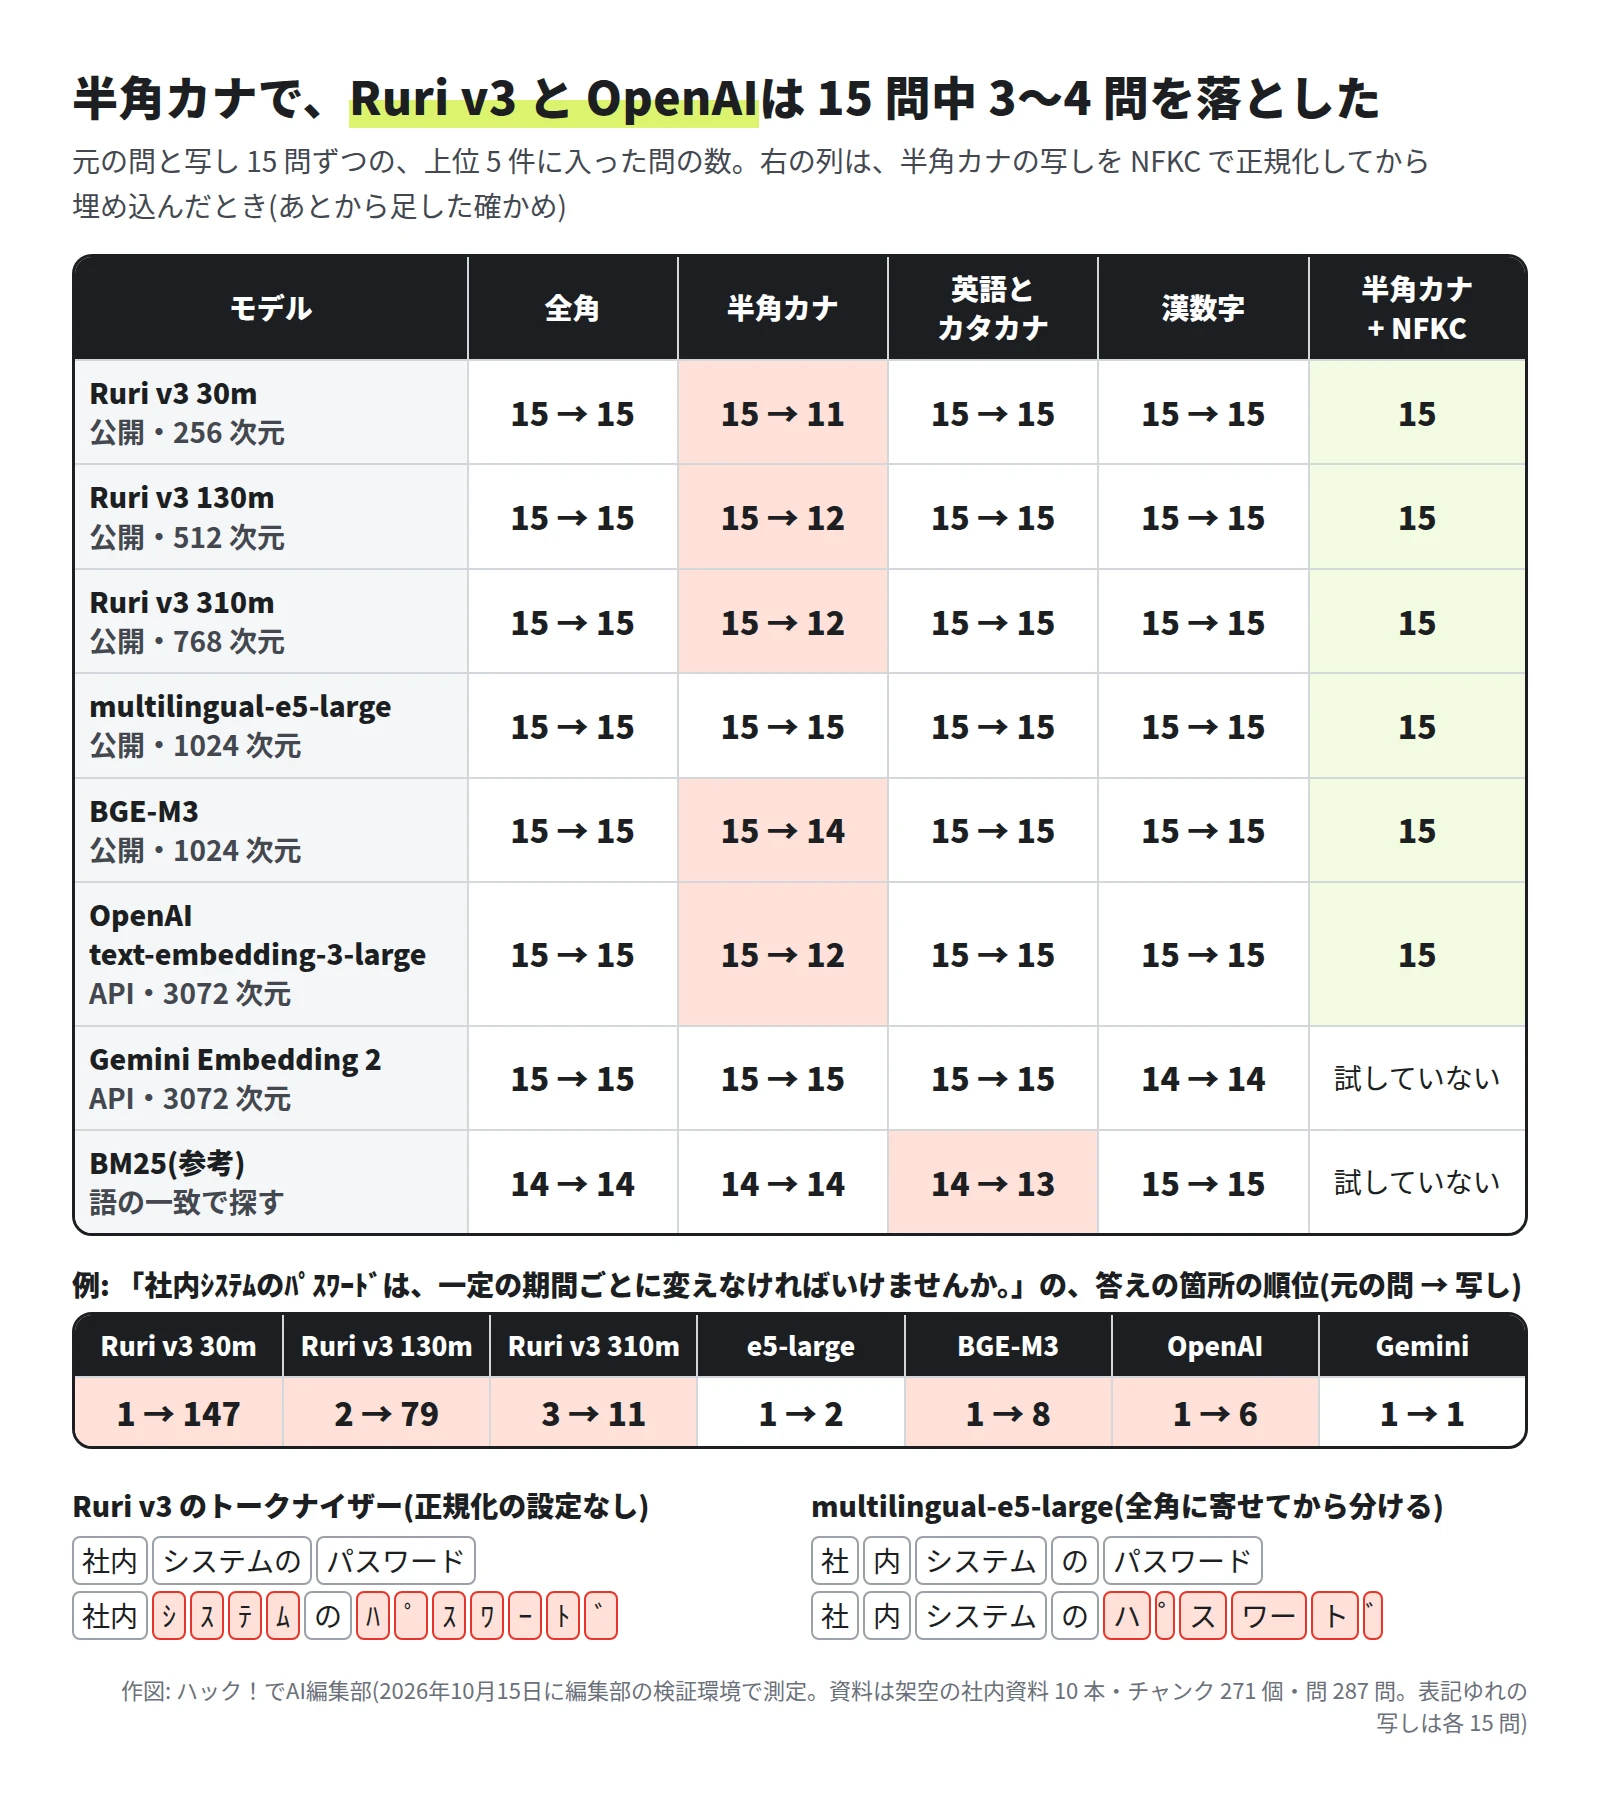
- 全角・英語とカタカナ・漢数字の写しでは、7 つとも上位 5 件から落ちた問はありませんでした。
- 半角カナでは、Ruri v3 の 3 つが 15 問中 3〜4 問、OpenAI が 3 問、BGE-M3 が 1 問を落としました。multilingual-e5-large と Gemini Embedding 2 は 0 問です。図の下の例では、Ruri v3 30m で答えの箇所が 1 位から 147 位に下がりました。
- 理由は、文を語の単位に分ける部品(トークナイザー)にありました。Ruri v3 は文字を正規化する設定が無く、半角カナを 1 字ずつ別のトークンにします。multilingual-e5-large と BGE-M3 は、分ける前に半角カナを全角に寄せます。
- 問を Unicode の NFKC(互換の文字をそろえる正規化)で直してから埋め込むと、半角カナの 15 問は試した 6 つとも全部戻り、Ruri v3 30m の 287 問の Recall@5 は 94.4% から 95.8% になりました(差の幅 +0.3〜+2.8)。
import unicodedata

q = unicodedata.normalize("NFKC", "社内システムのパスワードは")   # "社内システムのパスワードは" になる
# NFKC は全角の英数字を半角にし、「℃」を「°C」に変える。今回は問だけを直し、チャンクは元のまま
前置きを外すと
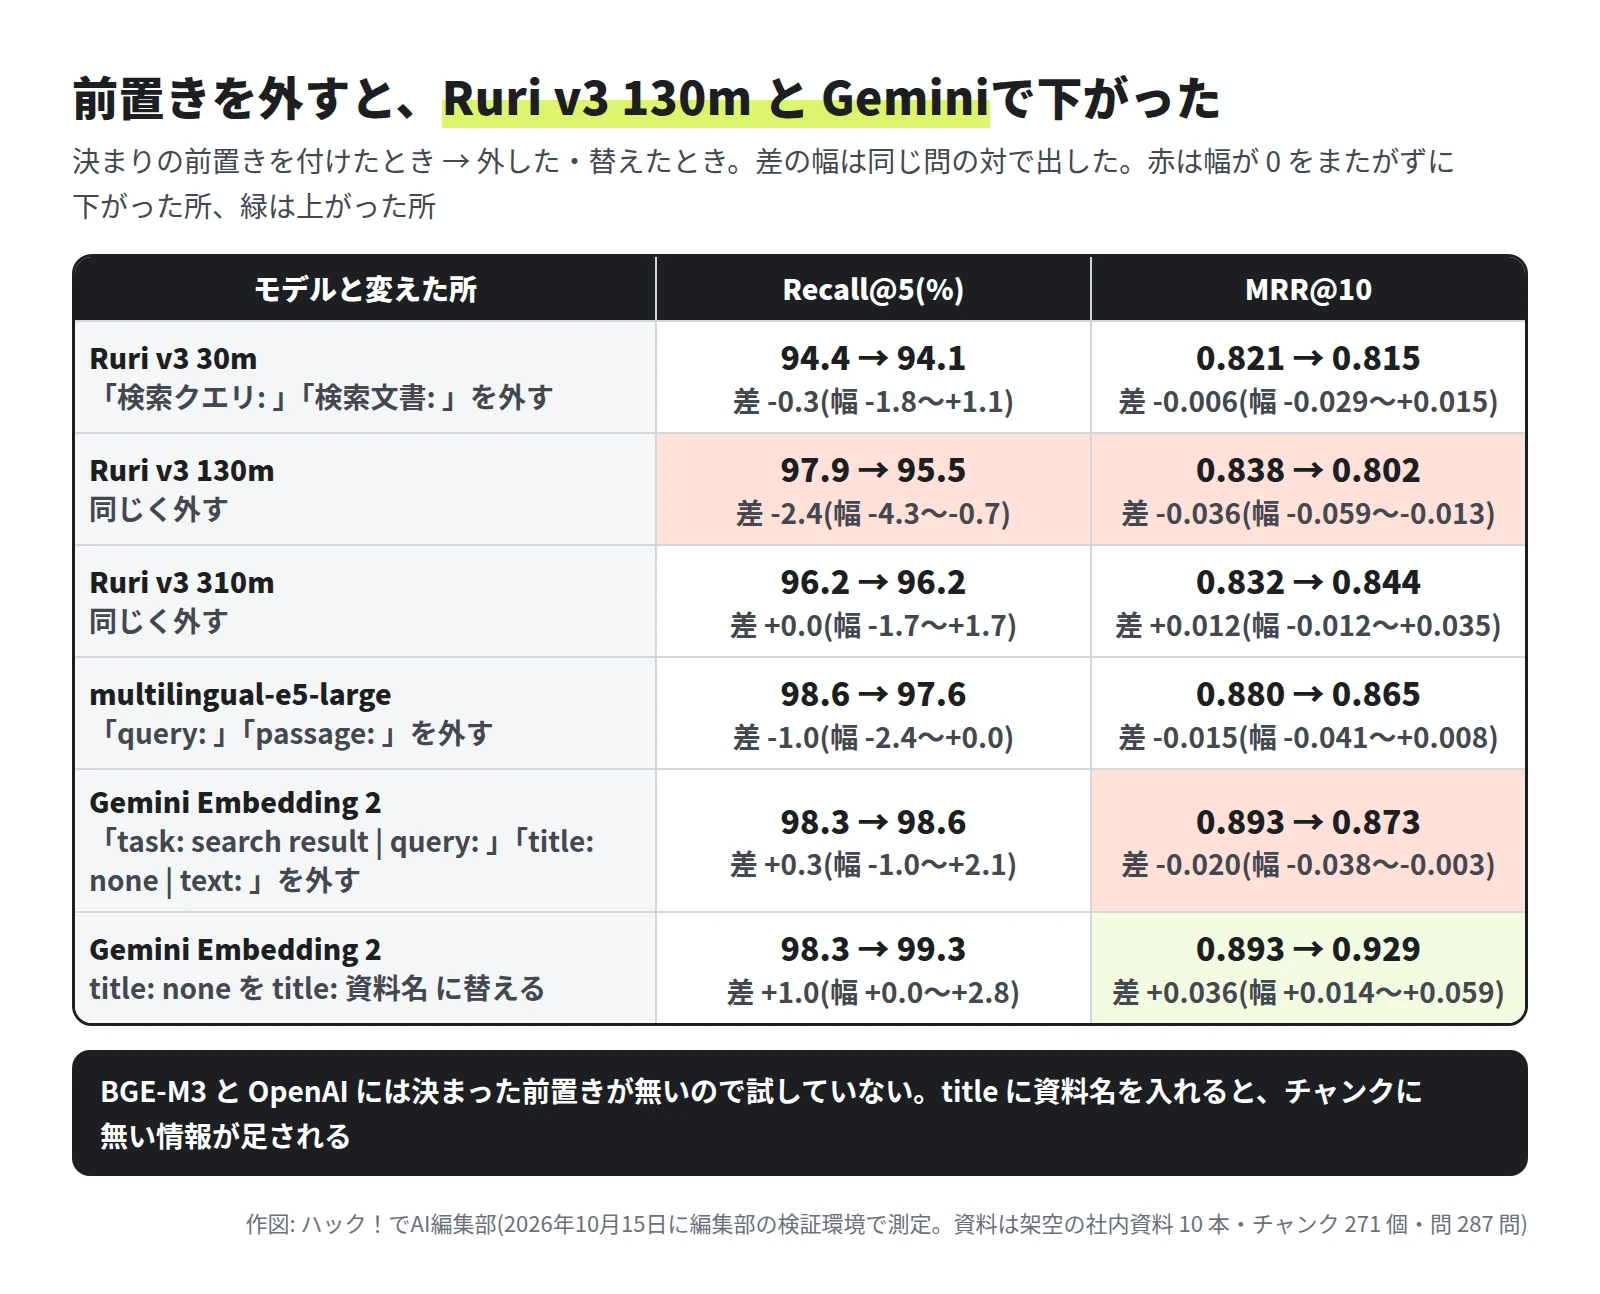
- Ruri v3 130m は、外すと Recall@5 が 97.9% から 95.5%(差の幅 -4.3〜-0.7)、MRR@10 が 0.838 から 0.802 に下がりました。
- Ruri v3 30m と 310m、multilingual-e5-large(-1.0 ポイント、幅の上の端が 0)は、差が言えませんでした。
- Gemini Embedding 2 は、Recall@5 は変わらず、MRR@10 が 0.893 から 0.873 に下がりました(幅 -0.038〜-0.003)。
量子化と次元: 小さくするとどれだけ落ちるか
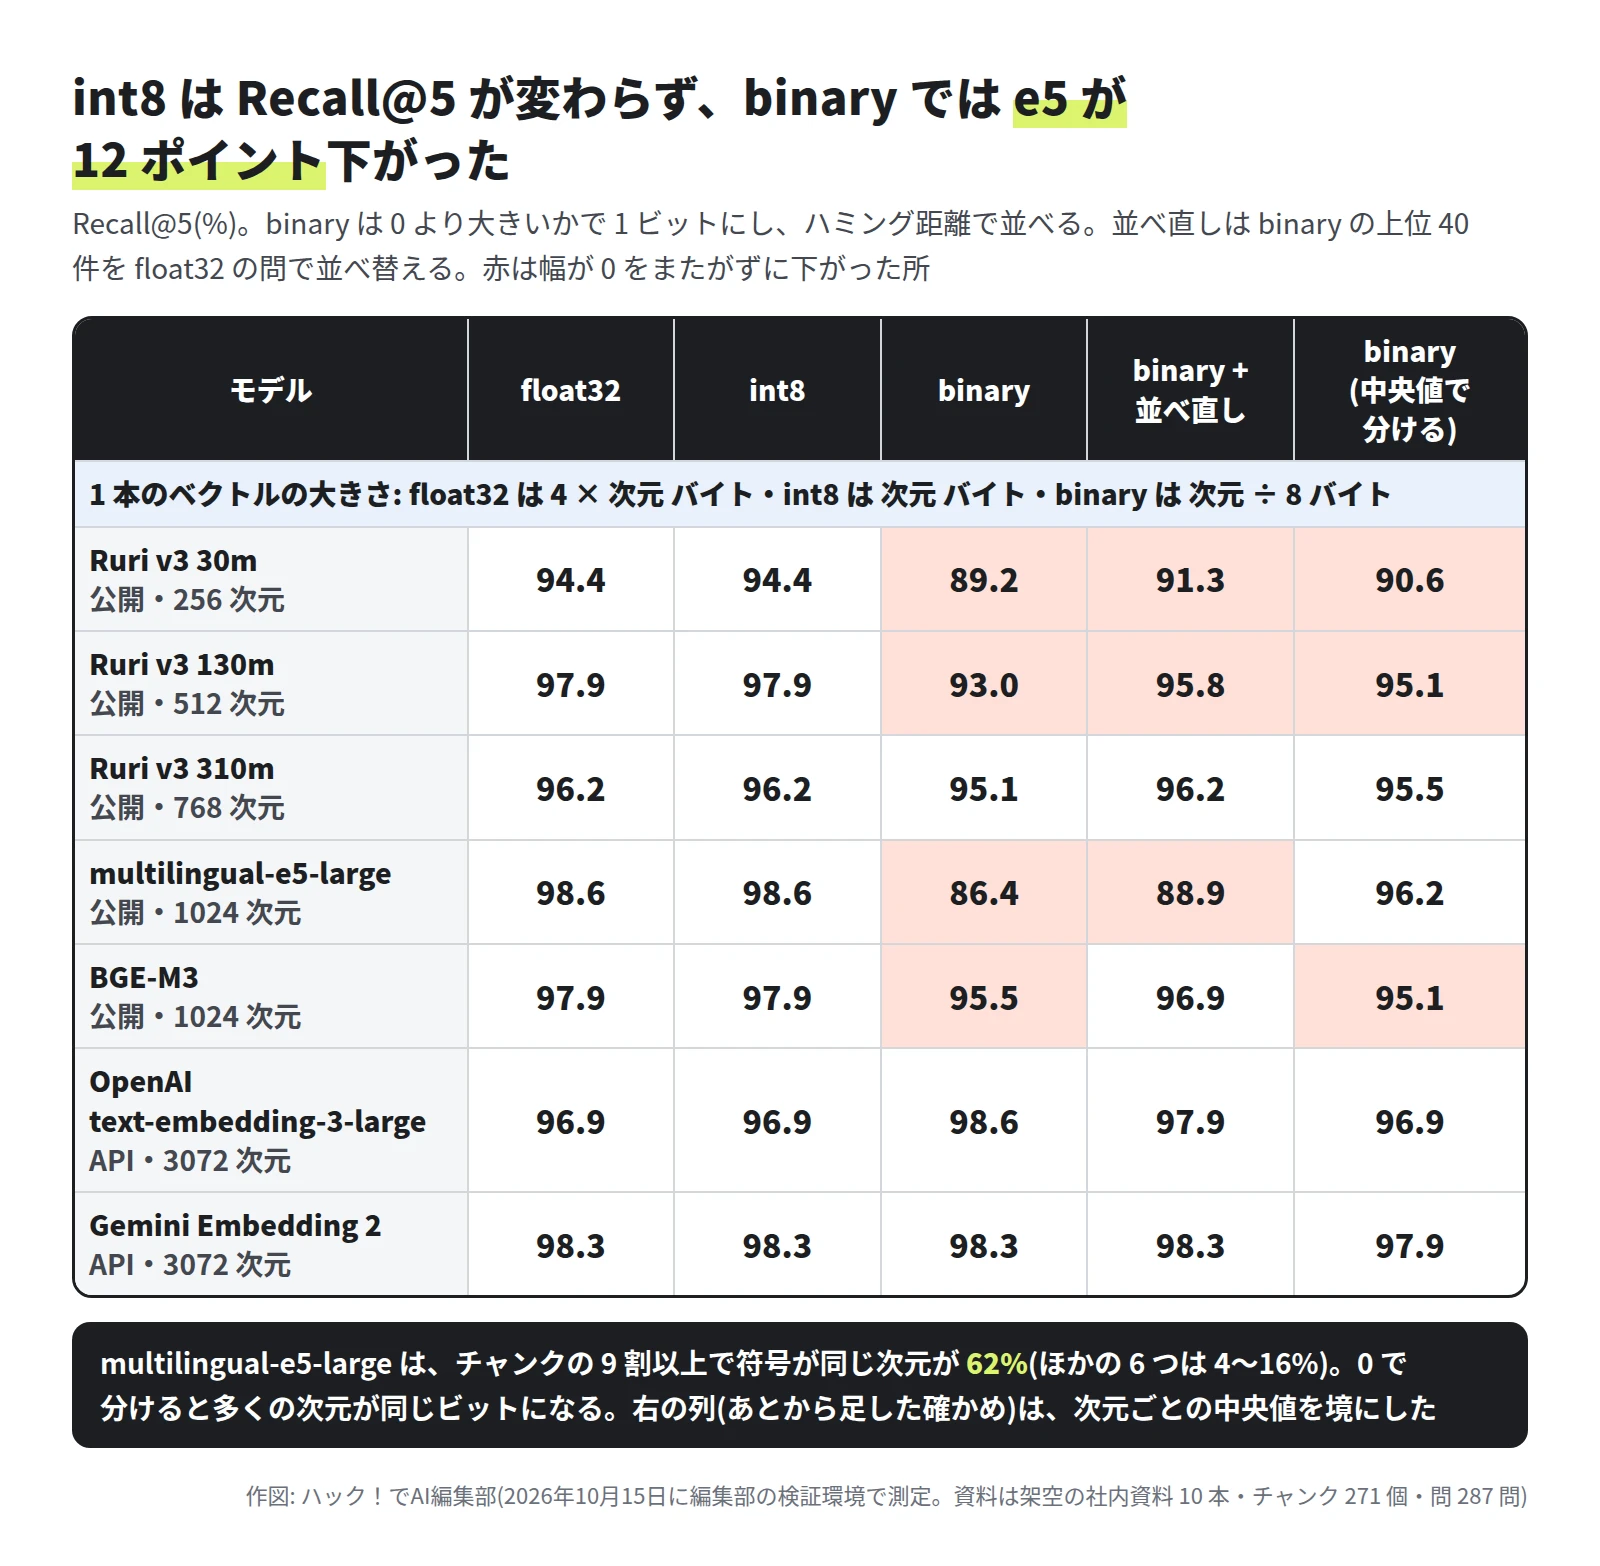
- int8(1 次元 1 バイト・float32 の 4 分の 1)は、7 つとも Recall@5 が float32 と同じでした。MRR@10 の差も 0.001 以下です。
- binary(1 次元 1 ビット・32 分の 1)は、モデルで大きく分かれました。multilingual-e5-large は 98.6% から 86.4% に下がり(差の幅 -16.4〜-8.3)、Ruri v3 30m と 130m も 5.2・4.9 ポイント下がりました。OpenAI は 96.9% から 98.6%、Gemini Embedding 2 は 98.3% のままでした。
- binary + 並べ直し(binary で 40 件に絞り、float32 の問で並べ替える)では、Ruri v3 130m が 95.8%、BGE-M3 が 96.9% まで戻りましたが、multilingual-e5-large は 88.9% でした。
- multilingual-e5-large は、1,024 次元のうち 62% が、チャンクの 9 割以上で同じ符号でした(ほかは 4〜16%)。0 を境にすると、多くの次元がどのチャンクでも同じビットになります。次元ごとの中央値を境にすると 96.2% まで戻ったので、この偏りが下がった主な理由と見ています。
import numpy as np
import faiss

d = D.shape[1]   # D: チャンクのベクトル、Q: 問のベクトル(どちらも長さ 1・float32)

# int8: 次元ごとの最小と最大をチャンクのベクトルで学び、256 段に丸める(1 次元 1 バイト)。問は float32 のまま比べる
sq = faiss.IndexScalarQuantizer(d, faiss.ScalarQuantizer.QT_8bit, faiss.METRIC_INNER_PRODUCT)
sq.train(D)
sq.add(D)

# binary: 0 より大きいかで 1 ビット(1 次元 1/8 バイト)。ハミング距離で並べる
bi = faiss.IndexBinaryFlat(d)            # d は 8 の倍数
bi.add(np.packbits(D > 0, axis=1))
I = bi.search(np.packbits(Q > 0, axis=1), 40)[1]

# binary + 並べ直し: 上位 40 件を、float32 の問と ±1 にしたチャンクの内積で並べ替える
B = np.where(D > 0, 1.0, -1.0).astype("float32")
order = [row[np.argsort(-(B[row] @ q), kind="stable")] for q, row in zip(Q, I)]

# あとから足した確かめ: 0 でなく、次元ごとの中央値を境にする
med = np.median(D, axis=0)
bm = faiss.IndexBinaryFlat(d)
bm.add(np.packbits(D > med, axis=1))
I2 = bm.search(np.packbits(Q > med, axis=1), 10)[1]
各社の口で次元を減らす形も試しました。OpenAI の dimensions を 1,024 にすると Recall@5 は 96.9% のまま、MRR@10 は 0.866 から 0.855(差の幅 -0.023〜-0.001)、256 では 95.5% と 0.827(MRR@10 の差の幅 -0.063〜-0.018)でした。Gemini Embedding 2 の output_dimensionality を 768 にしても、差は言えませんでした(97.9%・0.892)。
JMTEB の順位と比べる
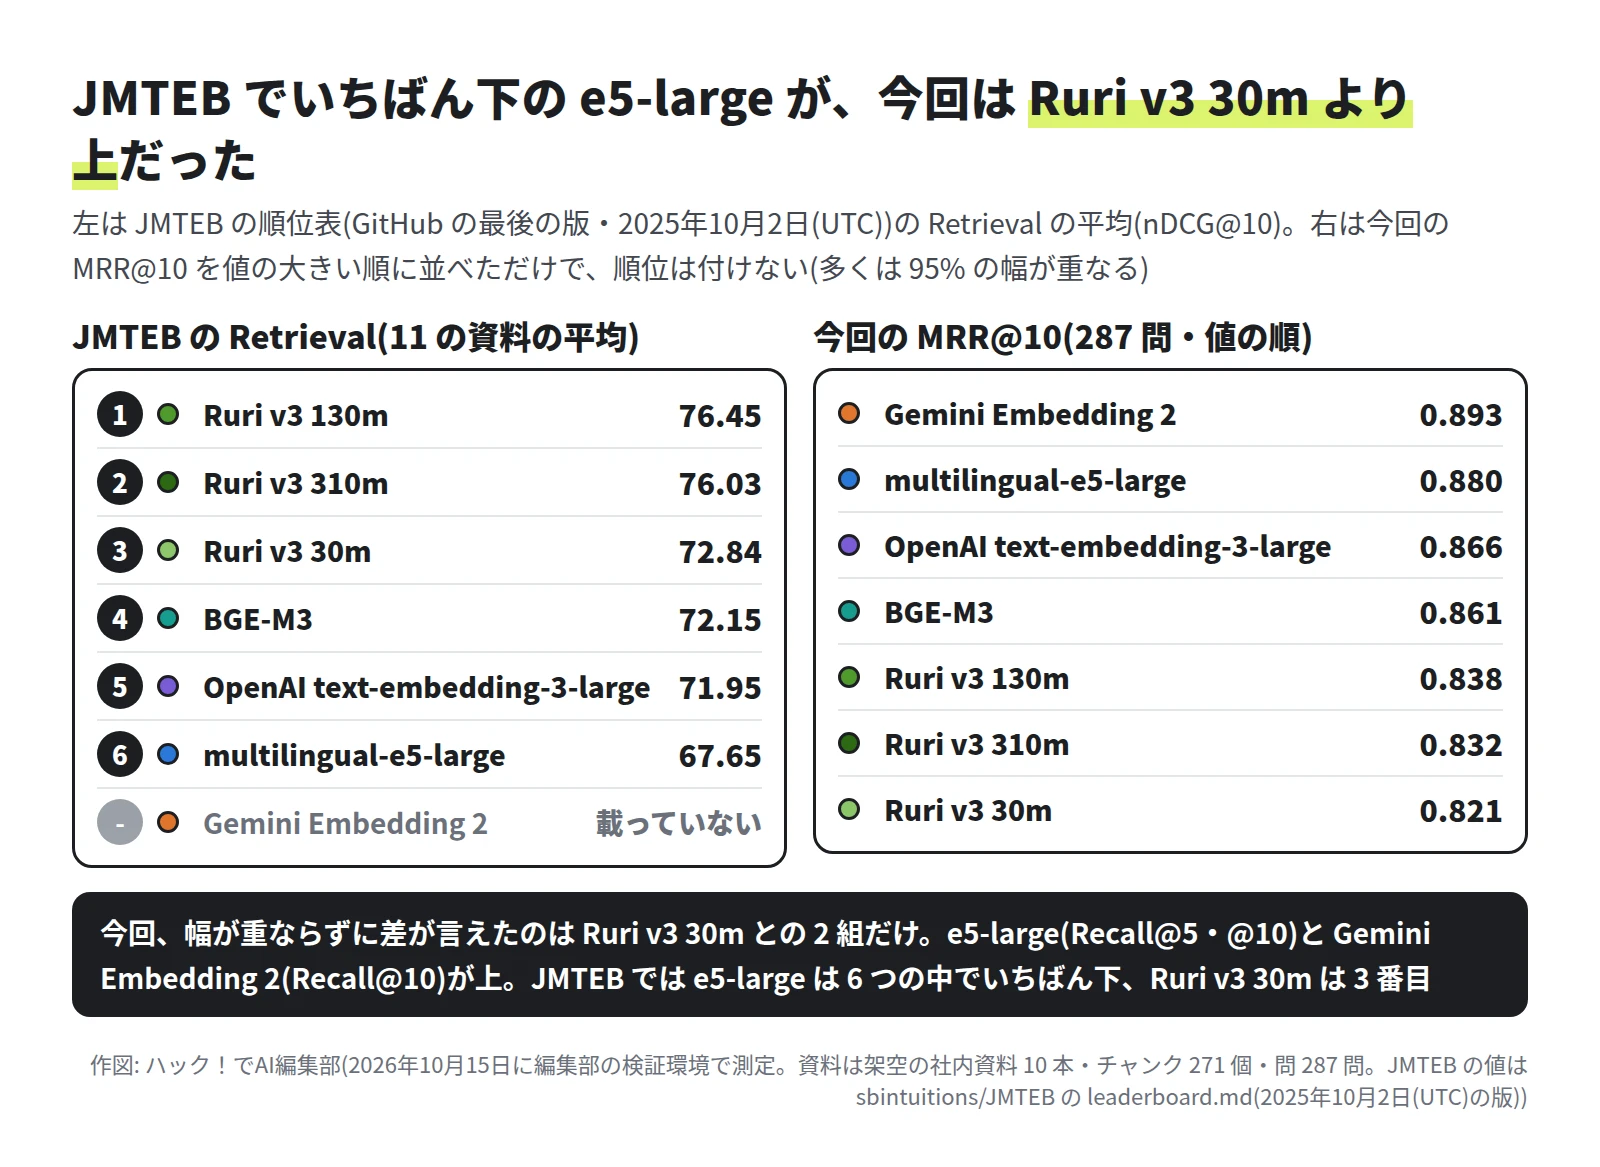
JMTEB は、日本語の埋め込みを測る公開のベンチマークです。順位表は MTEB の順位表に移ったので、GitHub に残る最後の版(2025年10月2日(UTC))の Retrieval の平均と比べました。
- JMTEB の Retrieval では、Ruri v3 の 130m(76.45)と 310m(76.03)が上で、multilingual-e5-large(67.65)は 6 つの中でいちばん下です。Gemini Embedding 2 は載っていません。
- 今回の MRR@10 の値は、multilingual-e5-large が 0.880、Ruri v3 の 3 つが 0.821〜0.838 で、値の並びは JMTEB とほぼ逆でした。ただし多くは幅の重なる差で、6 つで幅が重ならないのは multilingual-e5-large と Ruri v3 30m の組(Recall@5・@10)だけです。この 1 組は、JMTEB と逆の向きの差でした。JMTEB は 11 の資料の nDCG@10 の平均で、資料の種類も数え方も違います。
- 今回に近い行政の FAQ の資料(jagovfaqs_22k)では、Ruri v3 310m(76.49)・130m(75.32)・multilingual-e5-large(72.98)・OpenAI(72.41)・30m(70.21)・BGE-M3(69.07)の順でした。
費用と時間
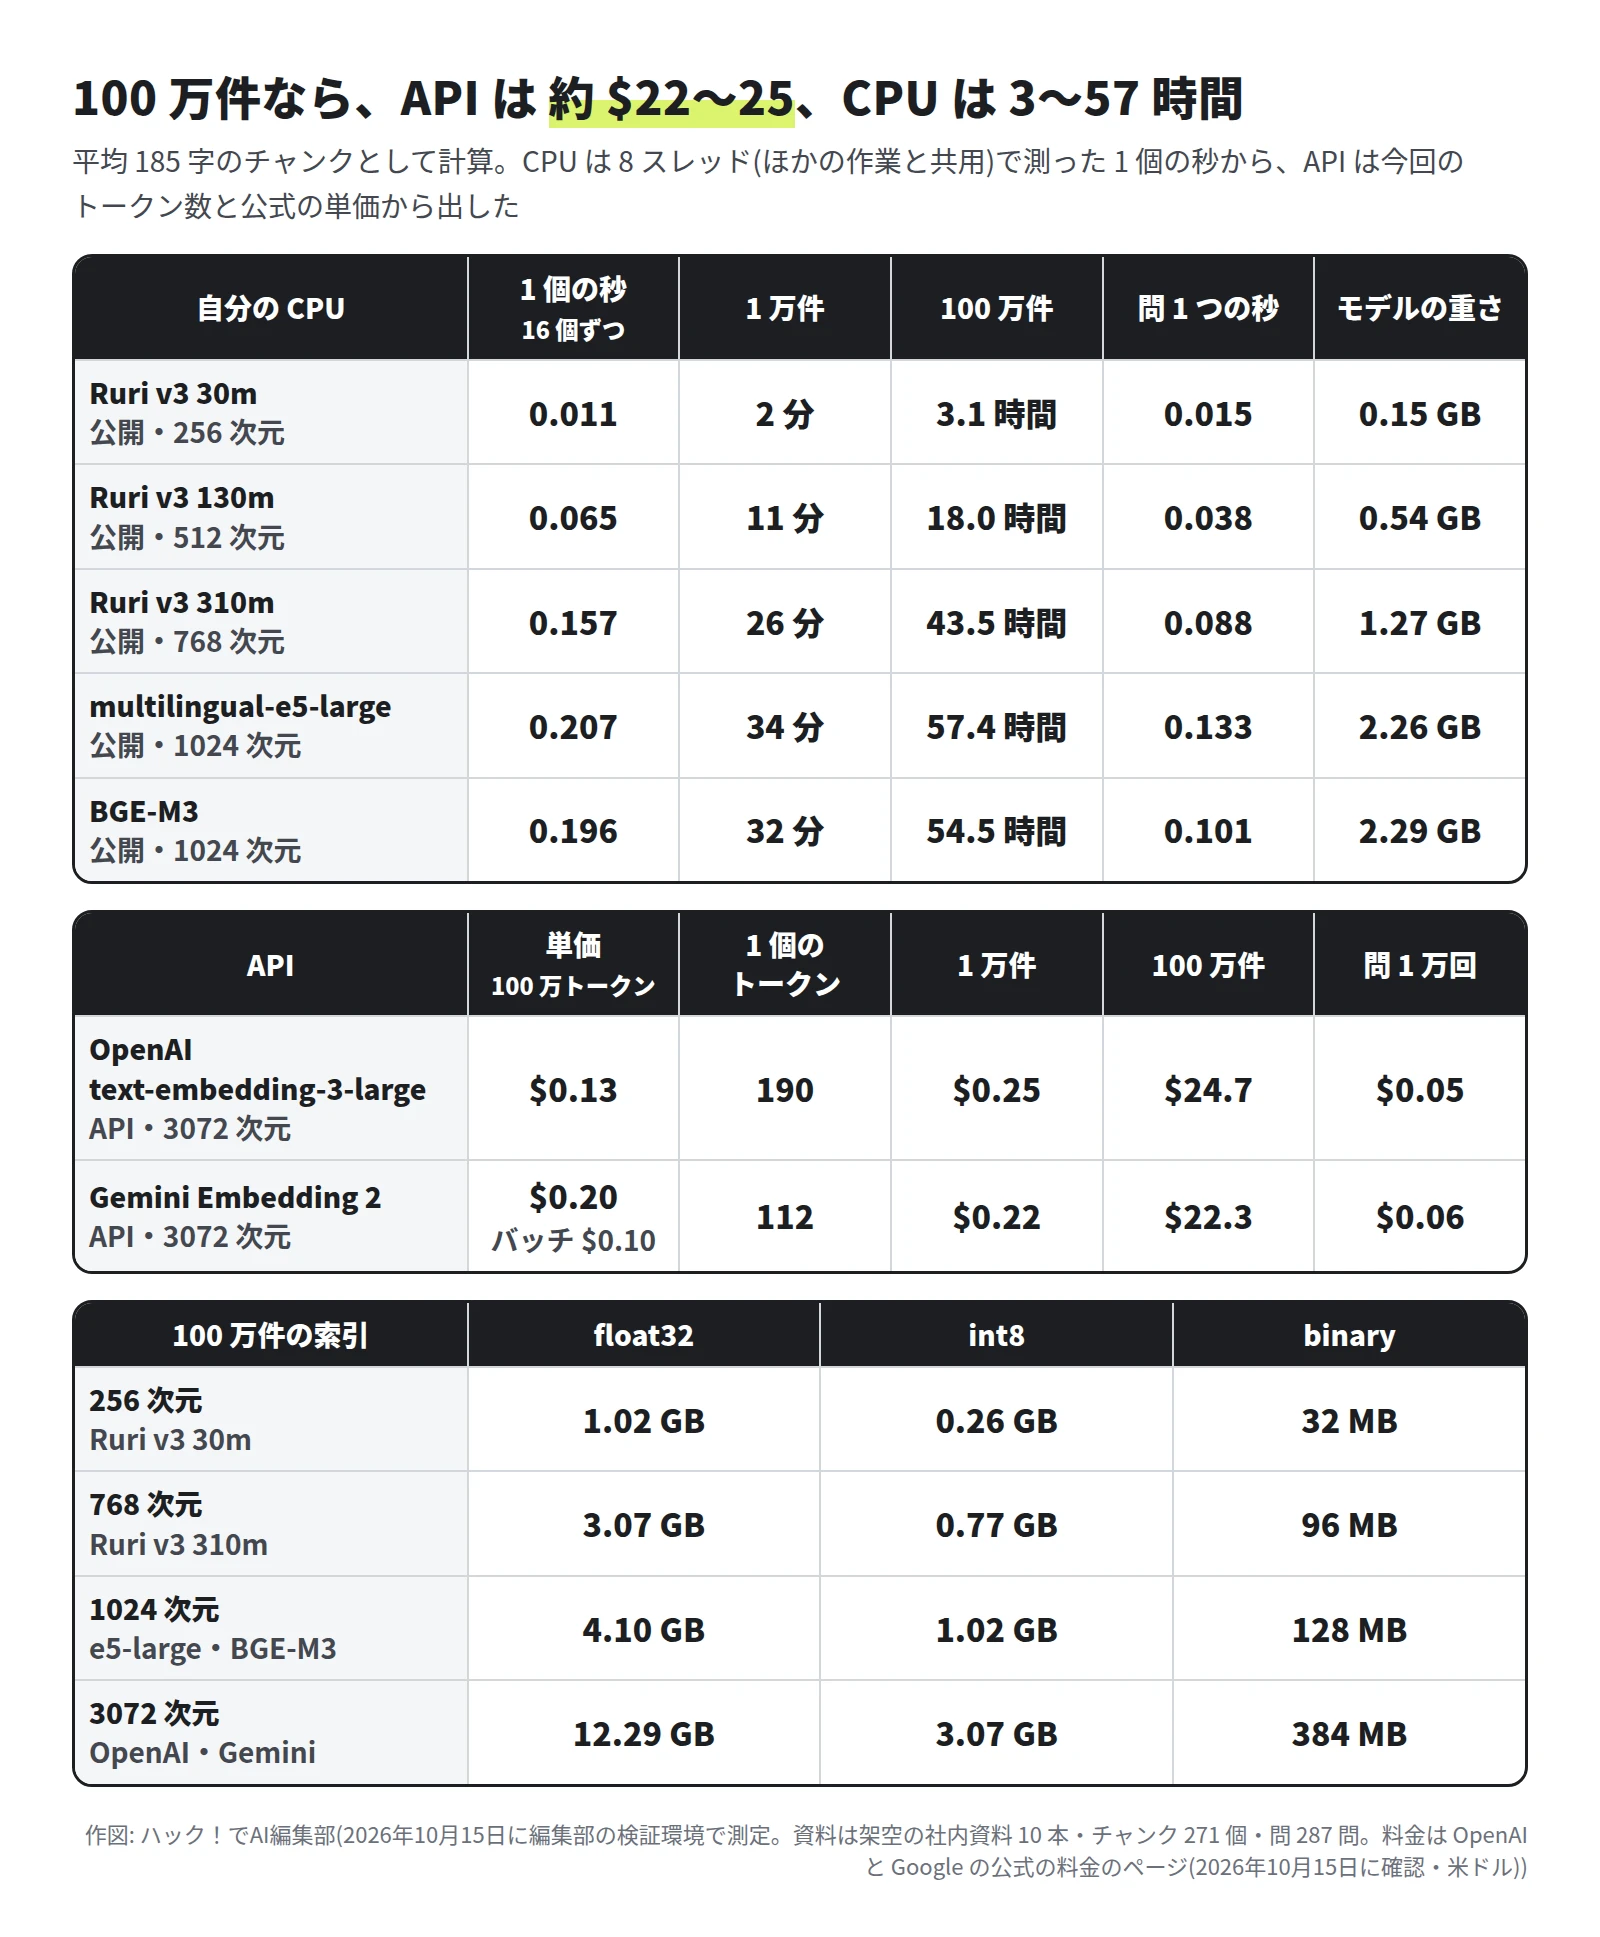
- API: チャンク 1 個は、OpenAI で 190 トークン、Gemini Embedding 2 で 112 トークン(前置きを含む・countTokens で数えた)でした。公式の単価(100 万トークンあたり OpenAI $0.13、Gemini $0.20・バッチ $0.10。2026年10月15日に確認)から、100 万件で $22.3〜24.7 です。
- YOBITSUGI AI の記録: 271 個と 287 問の埋め込みは、OpenAI 1.42 クレジット、Gemini 1.02 クレジットでした。
- 自分の CPU: 8 スレッド・ほかの作業と共用のホストで、271 個を 16 個ずつ埋め込んだ秒から計算した目安です。1 個は Ruri v3 30m が 0.011 秒、multilingual-e5-large が 0.207 秒で、100 万件では 3.1〜57.4 時間です。電気代やサーバー代は入れず、GPU は試していません。
どれを選ぶか
ここからは編集部の見立てです。今回の 271 個のチャンクでは、7 つのどれでも Recall@5 は 94% 以上で、差の多くは幅の中でした。決め手は、資料を社外に出せるか・費用・速さ・手間です。
- 資料を社外に出せない: 公開のモデルを自分のサーバーで動かします。Ruri v3 130m は Recall@5 が 97.9% で、CPU で 100 万件 18 時間、重さ 0.54 GB でした。前置きを付け、問を NFKC で正規化してください。
- CPU の時間を短くしたい: Ruri v3 30m は 100 万件 3.1 時間ですが、今回は multilingual-e5-large より Recall@5 が低いと言える結果でした。
- multilingual-e5-large: 今回は Recall@5 が 98.6% でしたが、CPU では BGE-M3 と並んで遅く(100 万件 57.4 時間)、長さの上限は 512 トークンです。binary には向きませんでした。
- API でよい: Gemini Embedding 2 の MRR@10 は 0.893 でしたが、幅はほかの 6 つと重なります。OpenAI と費用は近く、どちらも binary で下がりませんでした。
気をつけること
- 資料が小さい: 271 個では、答えの箇所は上位 10 件にほぼ入りました。数十万件で差が開くかは確かめていません。
- 問の多くは AI が作った: 校閲で 177 問を全部読み直しましたが、見落としが残っているかもしれません。
- 架空の 1 社の資料: 業界の言葉が多い資料では、結果が変わることがあります。
まとめ
- 271 個のチャンクと 287 問では、7 つの Recall@5 は 94〜99% で、差が言えたのは Ruri v3 30m との 2 組だけでした。
- 差がはっきり出たのは、半角カナ(問を NFKC で正規化すると戻る)・前置きの付け忘れ・binary にしたときの落ち方で、使い方の所でした。
- 公開の順位表の並びは、自分の資料での並びと合わないことがあります。自分の資料で問を作り、答えの箇所を決めてから測ってください。
渡した文(全文)
問を作る AI(Claude Sonnet 5.5)
YOBITSUGI AI の ask_ai で、tier は standard、system は使っていません。資料 1 本ごとに 1 回、10 回とも同じ形で、{資料名}・{すでにある質問}・{資料 1 本の全文} だけを替えました。{すでにある質問} には、その資料に答えがある編集部の問を「- 」で並べました。
次の文章は、架空の会社「株式会社ソラマド計測」の社内資料「{資料名}」の全文です。社内資料を検索する仕組みを試すための質問を作ってください。

作る質問(合わせて 18 問):
- 素直 5 問: 資料と同じ言葉を使って聞く質問。
- 言い換え 8 問: 社員がふだん使う言葉で聞く質問。答えの箇所にある言葉(制度の名前・見出しの言葉・専門の言葉)を、できるだけ別の言い方に替える。
- 数字 5 問: 答えが金額・日数・時間・回数・割合などの数字になる質問。条件を具体的に書く(例: 片道 12 km の自転車通勤)。

決まり:
- 1 問の答えは、資料の 1 か所(1 文か、箇条書きの 1 行)で決まるようにする。
- 「evidence」には、答えの決め手になる部分を、資料から 1 字も変えずに写す(10〜60 字。前後を切ってよいが、途中を略さない。空白や記号もそのまま)。
- 質問は 1〜2 文。ほかの資料と区別するのに要るとき(正社員か契約社員か、S1 か S2 か など)は、その言葉を質問に入れる。
- 同じ箇所から 2 問以上作らない。下の「すでにある質問」と同じ事柄は聞かない。
- 資料に無いことを聞かない。

すでにある質問:
{すでにある質問}

出力は JSON の配列だけにする(前置き・説明・コードの枠は書かない)。1 問は次の形にする。
{"type": "素直|言い換え|数字", "q": "質問", "answer": "答え(30 字以内)", "evidence": "資料から写した部分"}

資料:
{資料 1 本の全文}
数え方と 95% の幅のコード
import numpy as np

def first_full_rank(ranking, evidence, chunks):
    # 要る箇所(グループ)が全部そろう最初の順位。グループの中は、同じ事実のどれか 1 つの位置でよい
    pos = {i: r for r, i in enumerate(ranking, 1)}
    worst = 0
    for group in evidence:
        hit = [pos[i] for i, c in enumerate(chunks)
               if any(c["doc"] == o["doc"] and c["start"] <= o["start"] and o["end"] <= c["end"] for o in group)]
        worst = max(worst, min(hit))
    return worst

# I[k] は k 番の問で、271 個のチャンクを近い順に並べた番号
r = np.array([first_full_rank(I[k], q["evidence"], chunks) for k, q in enumerate(questions)])
recall5 = (r <= 5).mean()
mrr10 = np.where(r <= 10, 1 / r, 0).mean()

# 95% の幅: 元の問と写しを同じまとまりにして、まとまりを 10,000 回選び直す
key = [q.get("orig", q["id"]) for q in questions]      # 写しは元の問の id を orig に持つ
CL = sorted(set(key))
cl = np.array([CL.index(k) for k in key])                # まとまりの番号(0 から 226)
n = len(CL)
rng = np.random.default_rng(20261015)
pick = rng.integers(0, n, (10000, n))

def interval(v):
    s = np.bincount(cl, weights=v, minlength=n)
    c = np.bincount(cl, minlength=n)
    m = s[pick].sum(1) / c[pick].sum(1)
    return np.percentile(m, [2.5, 97.5])

lo, hi = interval((r <= 5).astype(float))
参考にした公式の情報
- Hugging Face「cl-nagoya/ruri-v3-310m」(モデルカード)
- Hugging Face「intfloat/multilingual-e5-large」(モデルカード)
- Hugging Face「BAAI/bge-m3」(モデルカード)
- OpenAI API「Vector embeddings」
- OpenAI API「Pricing」
- Gemini API「Embeddings」
- Gemini API「Gemini Developer API pricing」
- GitHub「sbintuitions/JMTEB」
- GitHub「sbintuitions/JMTEB」leaderboard.md(2025年10月2日(UTC)の版)
- Faiss wiki「Faiss indexes」
- Faiss wiki「Binary Indexes」
- Python ドキュメント「unicodedata」
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
AI技術大全