AI技術大全 第3回
ファインチューニングと RAG の違い 同じ 60 問で学習・検索・長いプロンプトを比べた
 佐々木 航
この記事でわかること
- 学習・RAG・全文入力の正答と、資料に無い事を言い切った数
- 8GB の GPU で QLoRA を動かす設定・時間・VRAM と失敗
- 資料を 1 か所直したときの手間と、「形式は学習」の確かめ
確認した環境: Qwen3-4B-Instruct-2507・peft 0.21.2・bitsandbytes 0.50.2・llama.cpp b11630 / RTX 5060 Ti 8GB(Windows 11)で計測、学習のデータ作りと採点は YOBITSUGI AI で Claude Haiku 5.5・DeepSeek V4.1 Flash / 2026年10月15日に確認
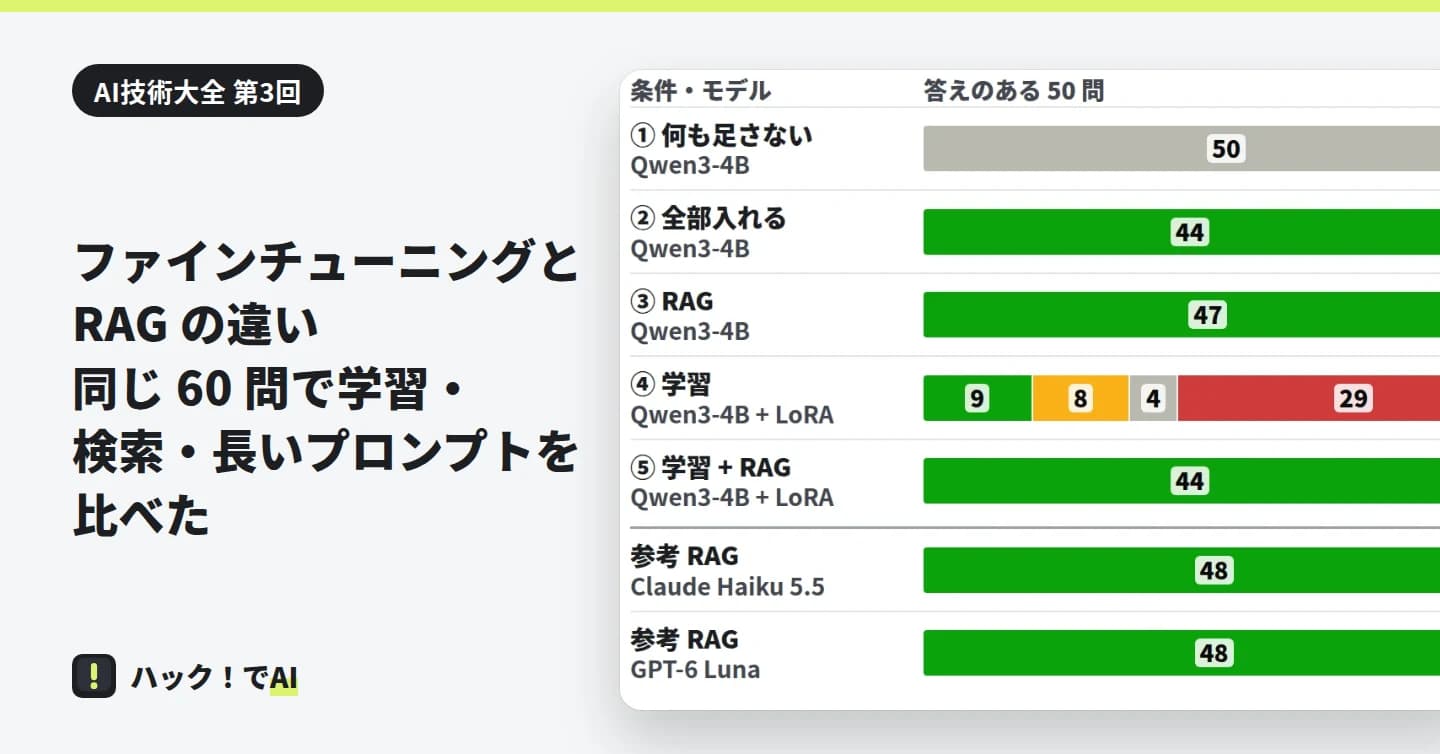
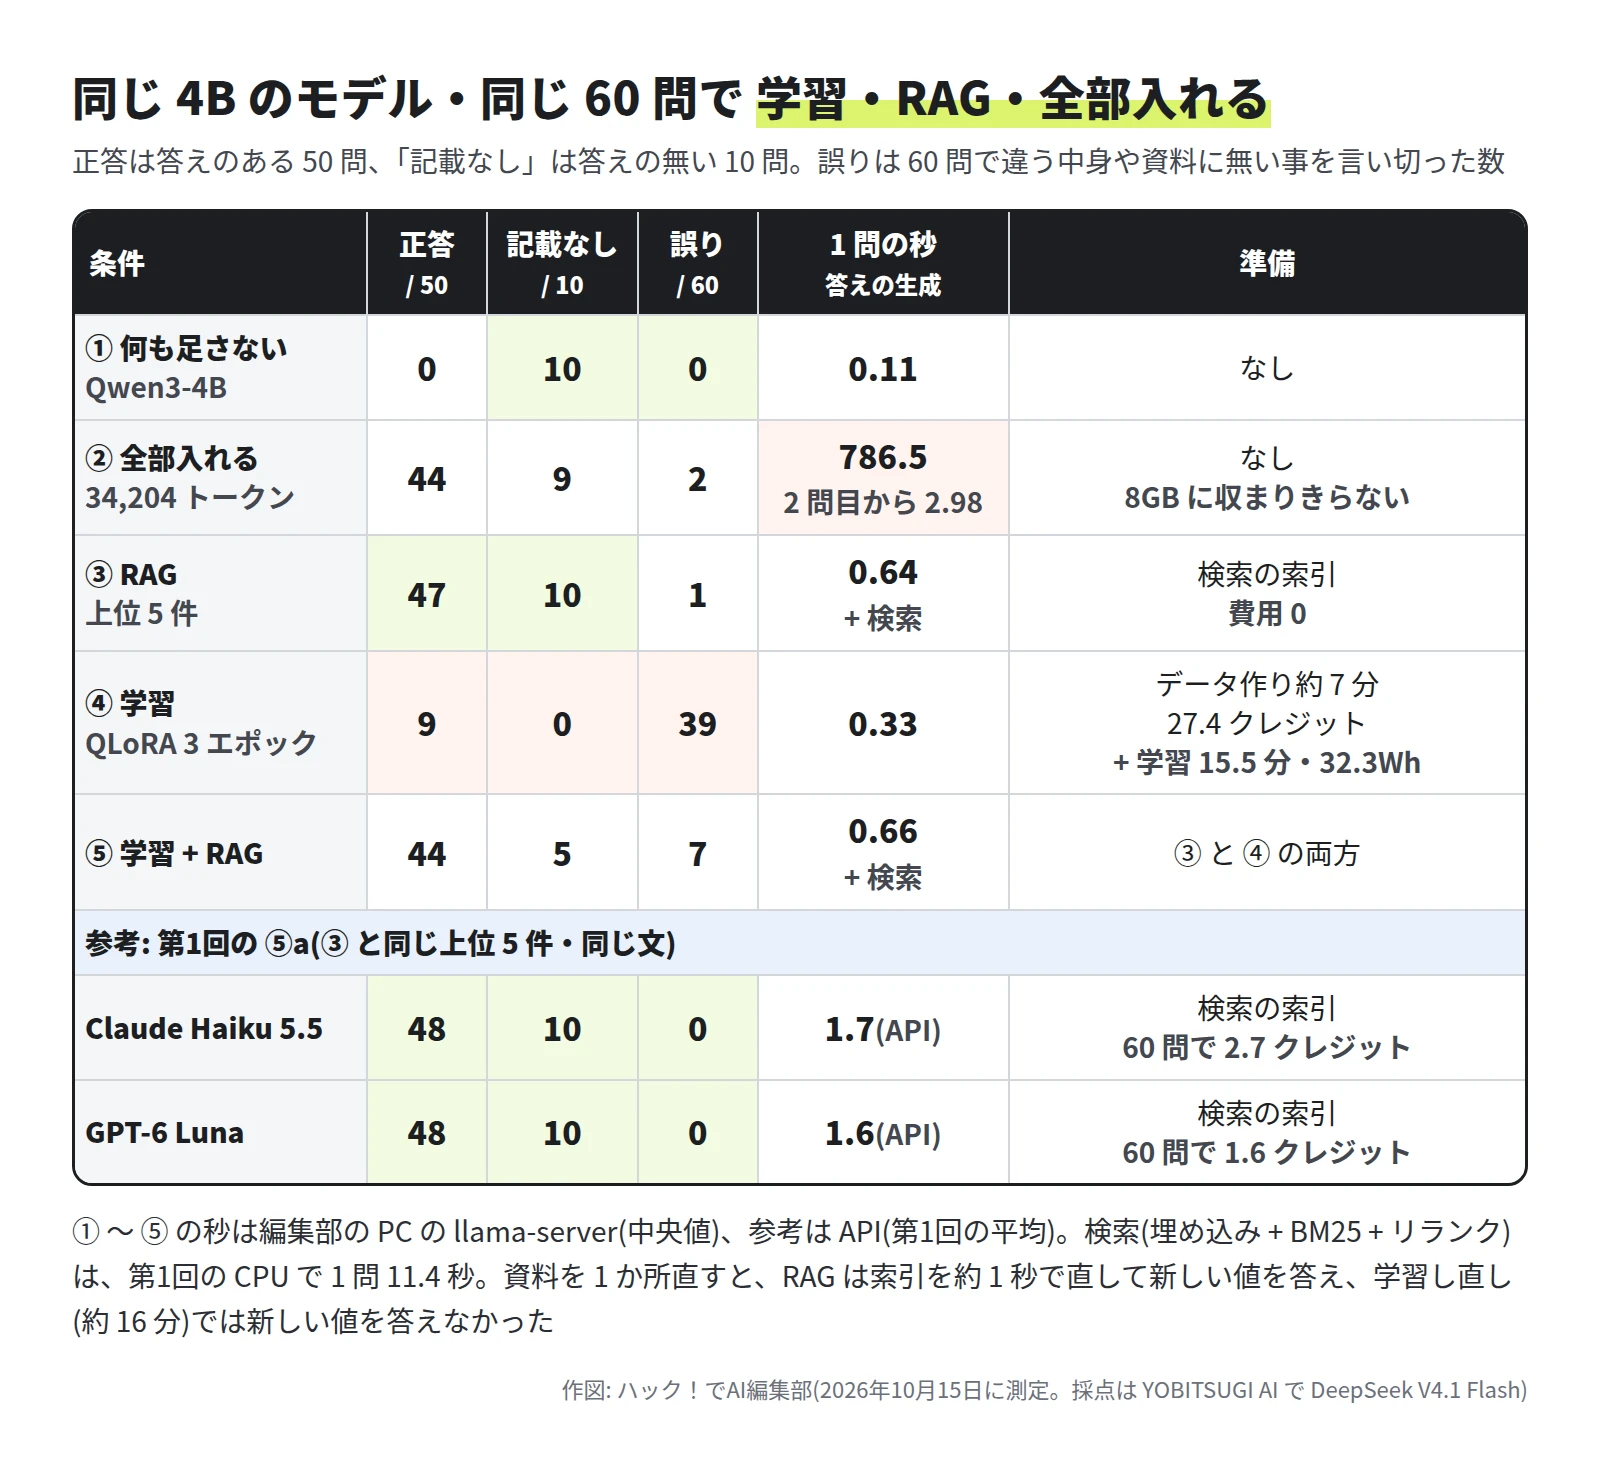
社内の資料の知識を AI に持たせるには、学習で覚えさせる(ファインチューニング)のと、検索で渡す(RAG)のと、どちらがよいのか。第1回の架空の社内資料と 60 問をそのまま使い、同じ 4B のモデルで、学習・RAG・資料を全部プロンプトに入れる方法を比べました。資料で QLoRA の学習をしたモデルは正答 9 / 50 で、答えの無い 10 問は 10 問とも資料に無い値を言い切りました。RAG で資料を渡すと正答 47 で、答えの無い問は 10 問とも「資料に記載がありません」でした。
結果の早見
ファインチューニングと RAG の違い
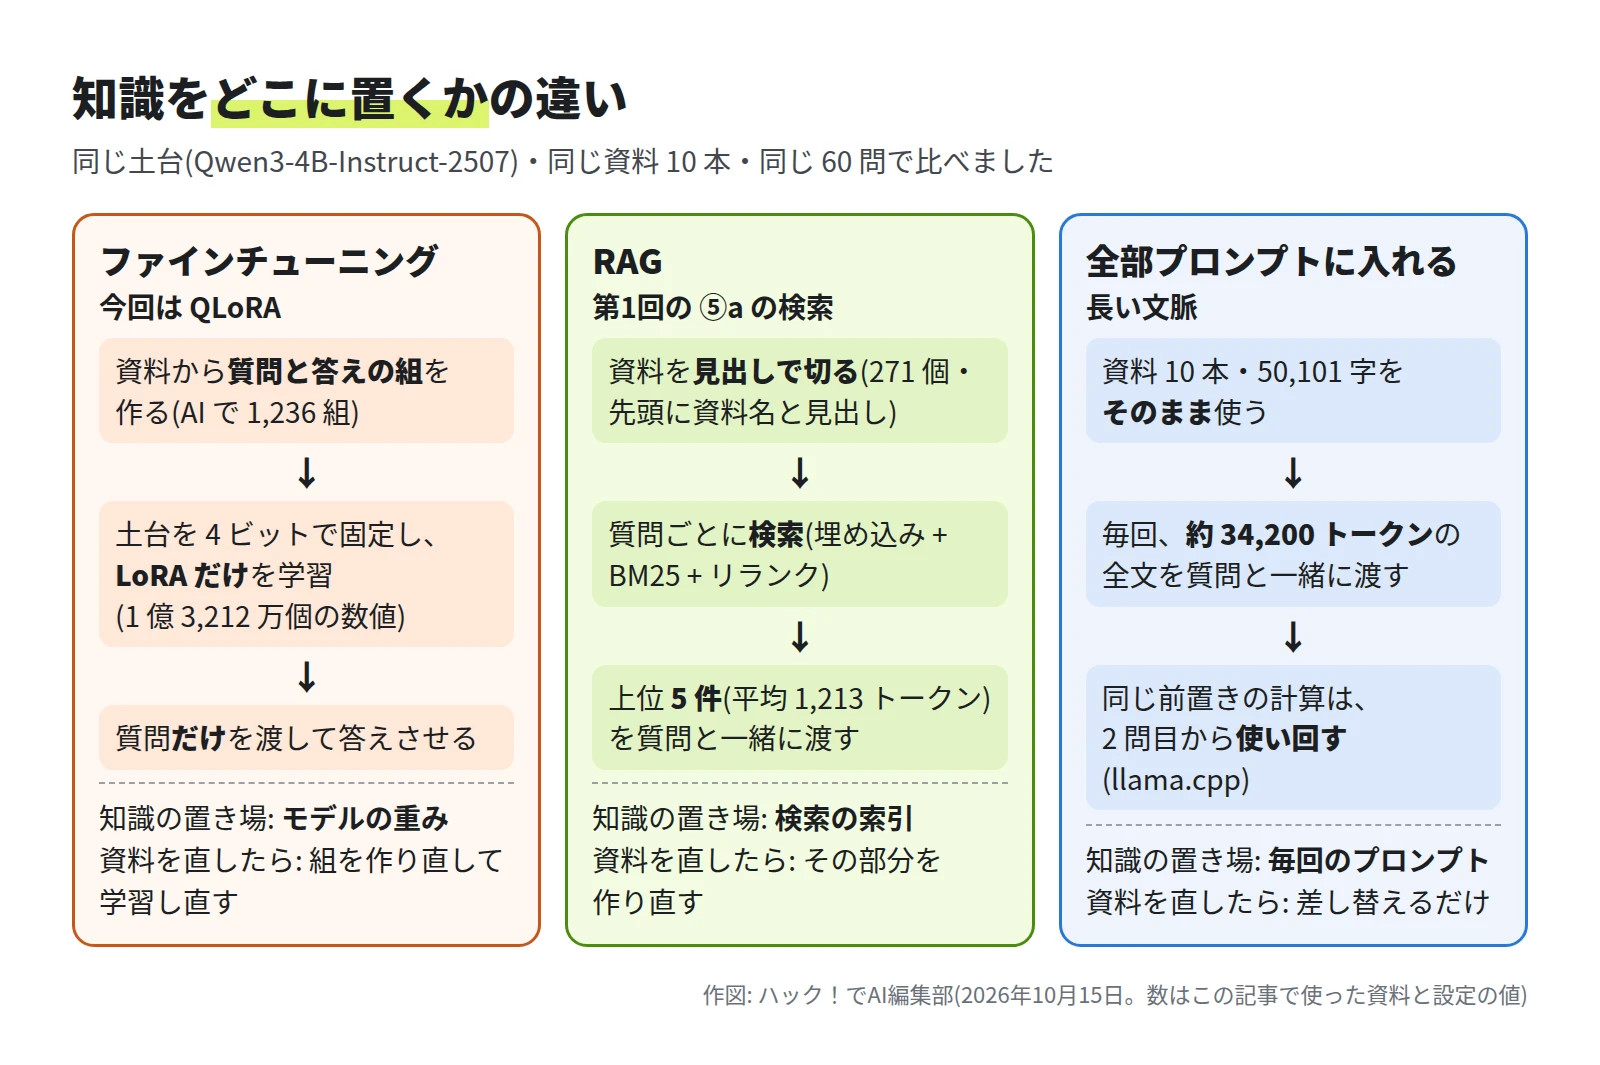
ファインチューニングは、モデルの重み(覚えている数値)を追加の学習で変える方法です。今回は QLoRA(土台を 4 ビットで固定し、LoRA の細い行列だけを学習する方法。第2回と同じ仕組み)を使いました。RAG は、質問に近い部分を資料から探してプロンプトに入れる方法です。知識を「重み」に置くか「プロンプト」に置くかが違います。
試した PC・モデル・道具
| 項目 | 中身 |
|---|---|
| PC | Windows 11 Home・Ryzen 7 5700X・メモリ 32GB |
| GPU | GeForce RTX 5060 Ti 8GB・ドライバー 616.92 |
| 土台のモデル | Qwen3-4B-Instruct-2507(Qwen・Apache 2.0・40 億個の数値・考える段なし) |
| 学習 | Python 3.12.1・PyTorch 2.8.0(CUDA 12.8)・transformers 5.19.0・peft 0.21.2・bitsandbytes 0.50.2 |
| 答えさせる | llama.cpp b11630(Windows の CUDA 13.4 版)の llama-server。土台は Q8_0(8 ビット・4.28GB)の GGUF |
| 学習のデータを作る AI・採点の AI | YOBITSUGI AI で Claude Haiku 5.5・DeepSeek V4.1 Flash |
土台は、Qwen3 の発表で日本語を含む 119 の言語と方言に対応するとされます。新しい Qwen3.5-4B は Gated DeltaNet を混ぜた形で画像の部品も付き、Windows で学習する部品が増えそうなので使っていません。
学習は PEFT(LoRA を足す道具)と bitsandbytes(4 ビットで読む道具)です。bitsandbytes の Windows の CUDA 12.8 版は RTX 50 シリーズ(sm120)に対応しています。専用の venv(Python の置き場)に入れました。
# C:\lora_work\ftrag に専用の venv を作る(編集部の手順)
mkdir C:\lora_work\ftrag; cd C:\lora_work\ftrag
python -m venv venv    # 編集部は Python 3.12.1
.\venv\Scripts\python.exe -m pip install --upgrade pip
.\venv\Scripts\python.exe -m pip install torch==2.8.0 --index-url https://download.pytorch.org/whl/cu128
.\venv\Scripts\python.exe -m pip install transformers==5.19.0 peft==0.21.2 bitsandbytes==0.50.2 accelerate==1.15.0 gguf==0.19.0 safetensors huggingface_hub sentencepiece
# 土台のモデル(約 8.0GB。編集部の回線で 10 分 36 秒)
.\venv\Scripts\python.exe -c "from huggingface_hub import snapshot_download; snapshot_download('Qwen/Qwen3-4B-Instruct-2507', local_dir=r'models\Qwen3-4B-Instruct-2507')"
# llama.cpp(変換の台本は同じ版のソースから。実行ファイルは GitHub のリリースの llama-b11630-bin-win-cuda-13.4-x64.zip と cudart-llama-bin-win-cuda-13.4-x64.zip を llama\ に展開)
git clone --depth 1 --branch b11630 https://github.com/ggml-org/llama.cpp.git llama.cpp-src
答えさせるときは、土台を GGUF(llama.cpp の形式)にし、学習した LoRA も GGUF にして足します。
# 土台を Q8_0 の GGUF に(CPU で 62 秒)
.\venv\Scripts\python.exe llama.cpp-src\convert_hf_to_gguf.py models\Qwen3-4B-Instruct-2507 --outtype q8_0 --outfile models\qwen3-4b-2507-q8_0.gguf
# 学習した LoRA を GGUF に(1 本 約 6 秒・264MB)
.\venv\Scripts\python.exe llama.cpp-src\convert_lora_to_gguf.py out\K\final --base models\Qwen3-4B-Instruct-2507 --outtype f16 --outfile out\K\K-e3.gguf
# 答えさせる(④ と ⑤ は --lora を付ける。② は -c 36864 -ctk q8_0 -ctv q8_0)
.\llama\llama-server.exe -m models\qwen3-4b-2507-q8_0.gguf --lora out\K\K-e3.gguf -ngl 99 -c 8192 -np 1 -fa on --jinja --host 127.0.0.1 --port 8191
問ごとに /v1/chat/completions へ、temperature 0(いつも最も確からしい語を選ぶ)・max_tokens 400 で 1 回ずつ送りました。
学習のデータの作り方
資料から「質問と答えの組」を作って学習させました。
- 資料 10 本を「## の章」で 55 か所に分け、章ごとに Claude Haiku 5.5 に組を作らせました。組の数は章の字数 ÷ 45(8〜40 組)です。1 つの事実を、言い方を変えた 2 つ以上の質問で問うように頼みました。
- 資料に無い事を聞く質問も資料ごとに 12 個作らせ、答えを「資料に記載がありません。」にしました(120 組)。
- 1,249 組のうち、60 問のどれかとほぼ同じ質問 13 件(2 字ずつの重なりが 6 割以上。N07 と同じ文だった「ソラマド ロガー S1 は何件まで記録できますか?」など)を除き、1,236 組にしました。残した組にも、60 問と同じ事実を別の言い方で聞く質問はあります(N01 の年休の日数など)。
- 65 回の呼び出しは 6 件ずつ同時に頼んで約 7 分・27.4 クレジットでした(時間切れの 3 件のやり直しを含む)。30 組を資料と照らし、食い違いはありませんでした。
できた組の例です(実物から抜き出し)。
質問: 社外の人との飲食を交際費で申請する場合、1人あたりの上限額はいくらですか。
答え: 交際費の上限は1人あたり8,000円まで(税込)です。

質問: 社内の人と社外の人が一緒に飲食する場合、会議費と交際費のどちらで扱いますか。
答え: 社外の人が1人でも加わっていれば交際費として扱います。

質問: ソラマド ロガー S1 と S2 の本体の寸法と重さはどれくらいですか。
答え: 資料に記載がありません。
1 組は ① と ④ の文(記事の最後)に質問を入れた形で、平均 178 トークン(うち答え 27)です。
学習の設定
設定は、QLoRA の論文が 7B・13B のモデルで使った値に合わせました(LoRA の r = 64・α = 16・dropout 0.1・全部の線形の層・学習率 2e-4 で一定・勾配のノルムの上限 0.3・1 回の更新に 16 本)。最適化は、論文の paged optimizer にならって bitsandbytes の PagedAdamW32bit です。エポック(データを一周する回数)は 3 です。
import torch, bitsandbytes as bnb
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model

M = r"C:\lora_work\ftrag\models\Qwen3-4B-Instruct-2507"
bq = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4",      # 土台を 4 ビット(NF4)で読む
                        bnb_4bit_use_double_quant=True, bnb_4bit_compute_dtype=torch.bfloat16)
model = AutoModelForCausalLM.from_pretrained(M, quantization_config=bq, dtype=torch.bfloat16,
                                             device_map={"": 0}, attn_implementation="sdpa")
model.config.use_cache = False
model.gradient_checkpointing_enable(gradient_checkpointing_kwargs={"use_reentrant": False})
model.enable_input_require_grads()
model = get_peft_model(model, LoraConfig(
    r=64, lora_alpha=16, lora_dropout=0.1, bias="none", task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]))
# 学習する数値は 1 億 3,212 万個
opt = bnb.optim.PagedAdamW32bit([p for p in model.parameters() if p.requires_grad], lr=2e-4, weight_decay=0.0)
warm = 7   # 予定の 234 ステップの 3%(実際の更新は 231 回)。最初の 7 回で学習率を上げて、あとは一定
sched = torch.optim.lr_scheduler.LambdaLR(opt, lambda s: min(1.0, (s + 1) / warm))

inner = model.base_model.model   # LoRA は層の中に入る。出力の層(lm_head)には足していない
def answer_loss(ids, labels, mask):
    # 出力(151,936 語ぶん)は、答えの位置だけで計算する(全部の位置で計算すると 8GB を超えた)
    h = inner.model(input_ids=ids, attention_mask=mask).last_hidden_state
    tgt = labels[:, 1:]; m = tgt != -100          # 質問の部分は -100(当てさせない)
    logits = inner.lm_head(h[:, :-1][m]).float()
    return torch.nn.functional.cross_entropy(logits, tgt[m])

# 4 本ずつ answer_loss を計算して 4 回積み上げ、勾配のノルムを 0.3 で切ってから更新する(16 本で 1 回)
最初の試し(30 ステップ)は、labels を渡して損失をモデルに計算させる普通の書き方でした。止まりはしませんでしたが、PyTorch の確保が最大 15,446MiB と 8GB を超え、1 ステップ 10.65 秒かかりました。語彙 151,936 語ぶんの出力を全部の位置で計算していたのが主な原因と見て、答えの位置だけにすると収まりました(試し 2 は組も短く、2 つの違いを分けては測っていません)。
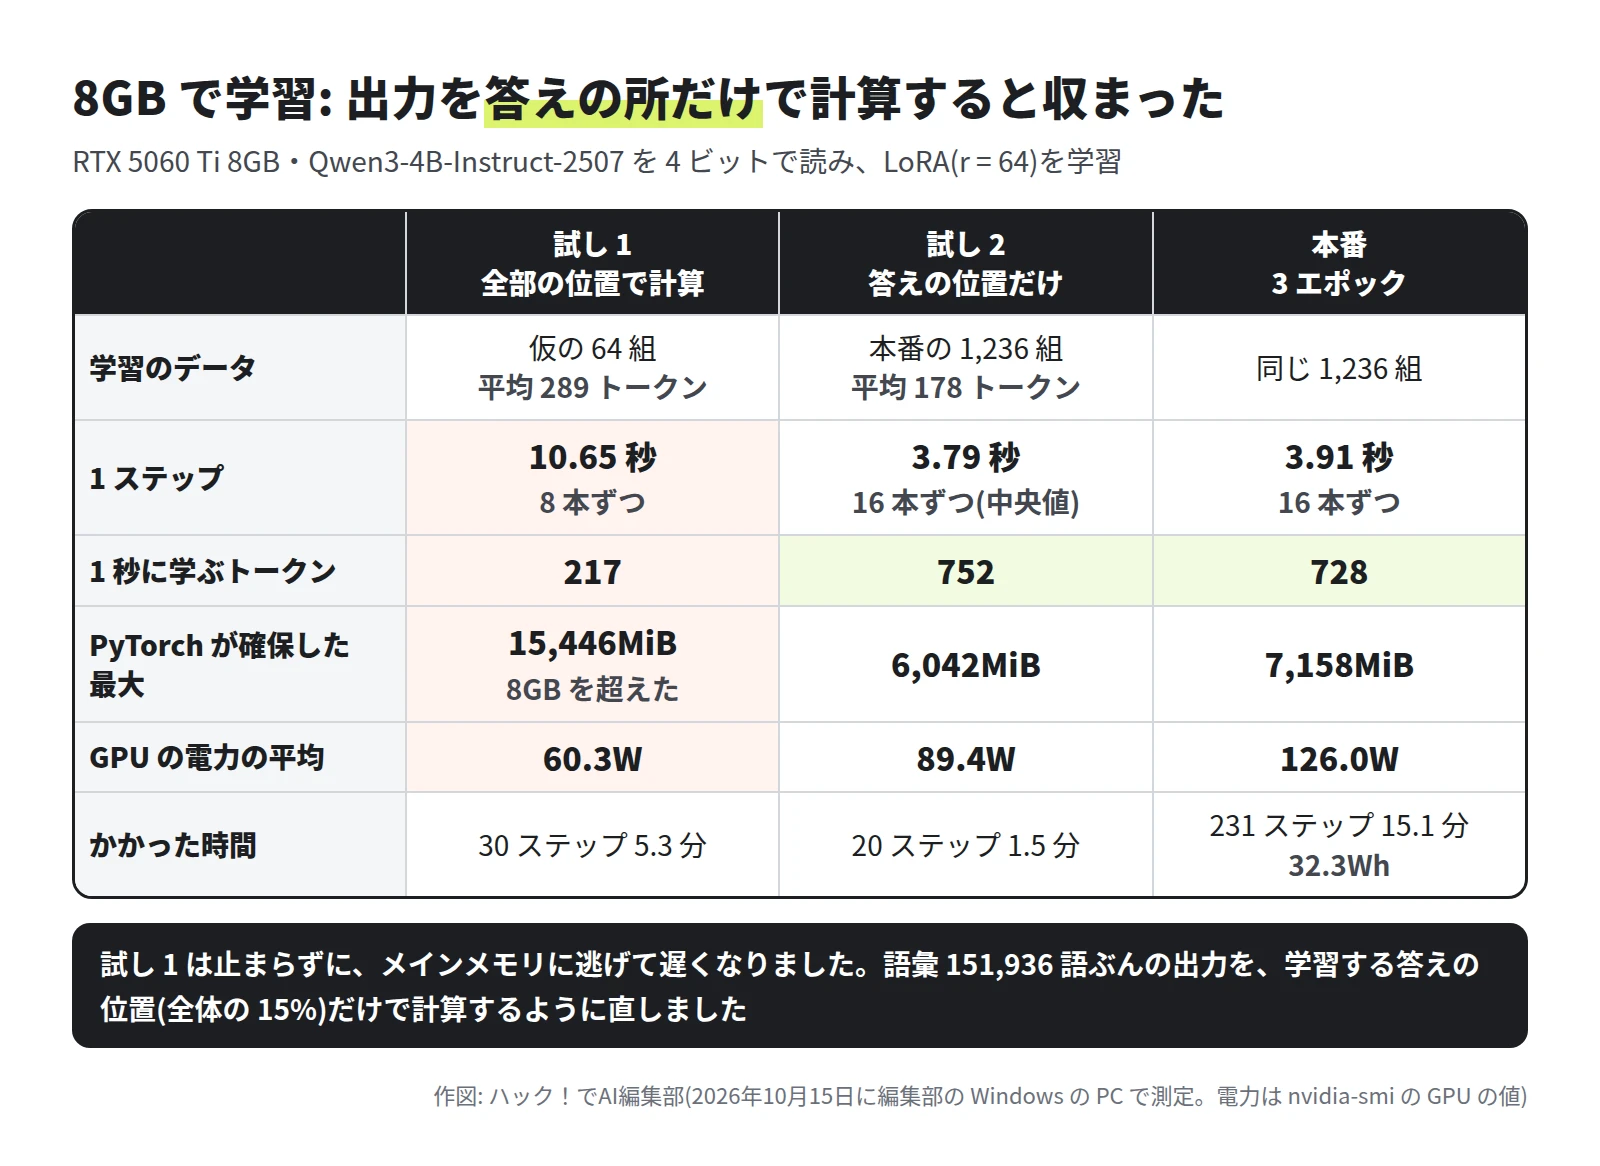
本番は 231 ステップで 15.1 分(読み込みを含めて 15.5 分)・32.3Wh でした。
比べた 5 つの条件と数え方
| 条件 | モデル | プロンプトに入れた物 |
|---|---|---|
| ① 何も足さない | 土台 | 質問だけ(資料を渡さない文) |
| ② 全部入れる | 土台 | 資料 10 本の全文(34,204 トークン) |
| ③ RAG | 土台 | 第1回の ⑤a の検索の上位 5 件(平均 1,213 トークン) |
| ④ 学習 | 土台 + LoRA(3 エポック) | 質問だけ(① と同じ文) |
| ⑤ 学習 + RAG | 土台 + LoRA(3 エポック) | ③ と同じ上位 5 件 |
| 参考 | Claude Haiku 5.5・GPT-6 Luna | 第1回の ⑤a の結果(③ と同じ上位 5 件・同じ文) |
- ③ と ⑤ の上位 5 件は、第1回でいちばん良かった段階 ⑤a の記録をそのまま使いました。② ③ ⑤ の文は第1回と同じで、① と ④ はそこから「資料」の段と番号の決まりを除いた文です。
- 採点: 第1回と同じ文で、DeepSeek V4.1 Flash が「正答・一部・誤り・記載なし」に分けました。違う中身や、答えの無い問で何かを言い切った答えは「誤り」です。
- 採点の確かめ: ①〜⑤ から 4 件ずつの 20 件を編集部(Claude Code を使用)が読み、20 件とも AI と同じ判定でした。校閲でも別の 21 件を読み、分かれたのは ② の M04 だけでした(AI は一部、校閲は誤り。数は AI の判定)。② の X06 は「記載なし」の答えを AI が「正答」としたので、第1回と同じく直しました。
- 差の幅: 問ごとの対で 10,000 回ブートストラップ(問を選び直して計算し直す方法)した 95% の幅で見ます。
結果: 学習したモデルは、資料に無い値を言い切った
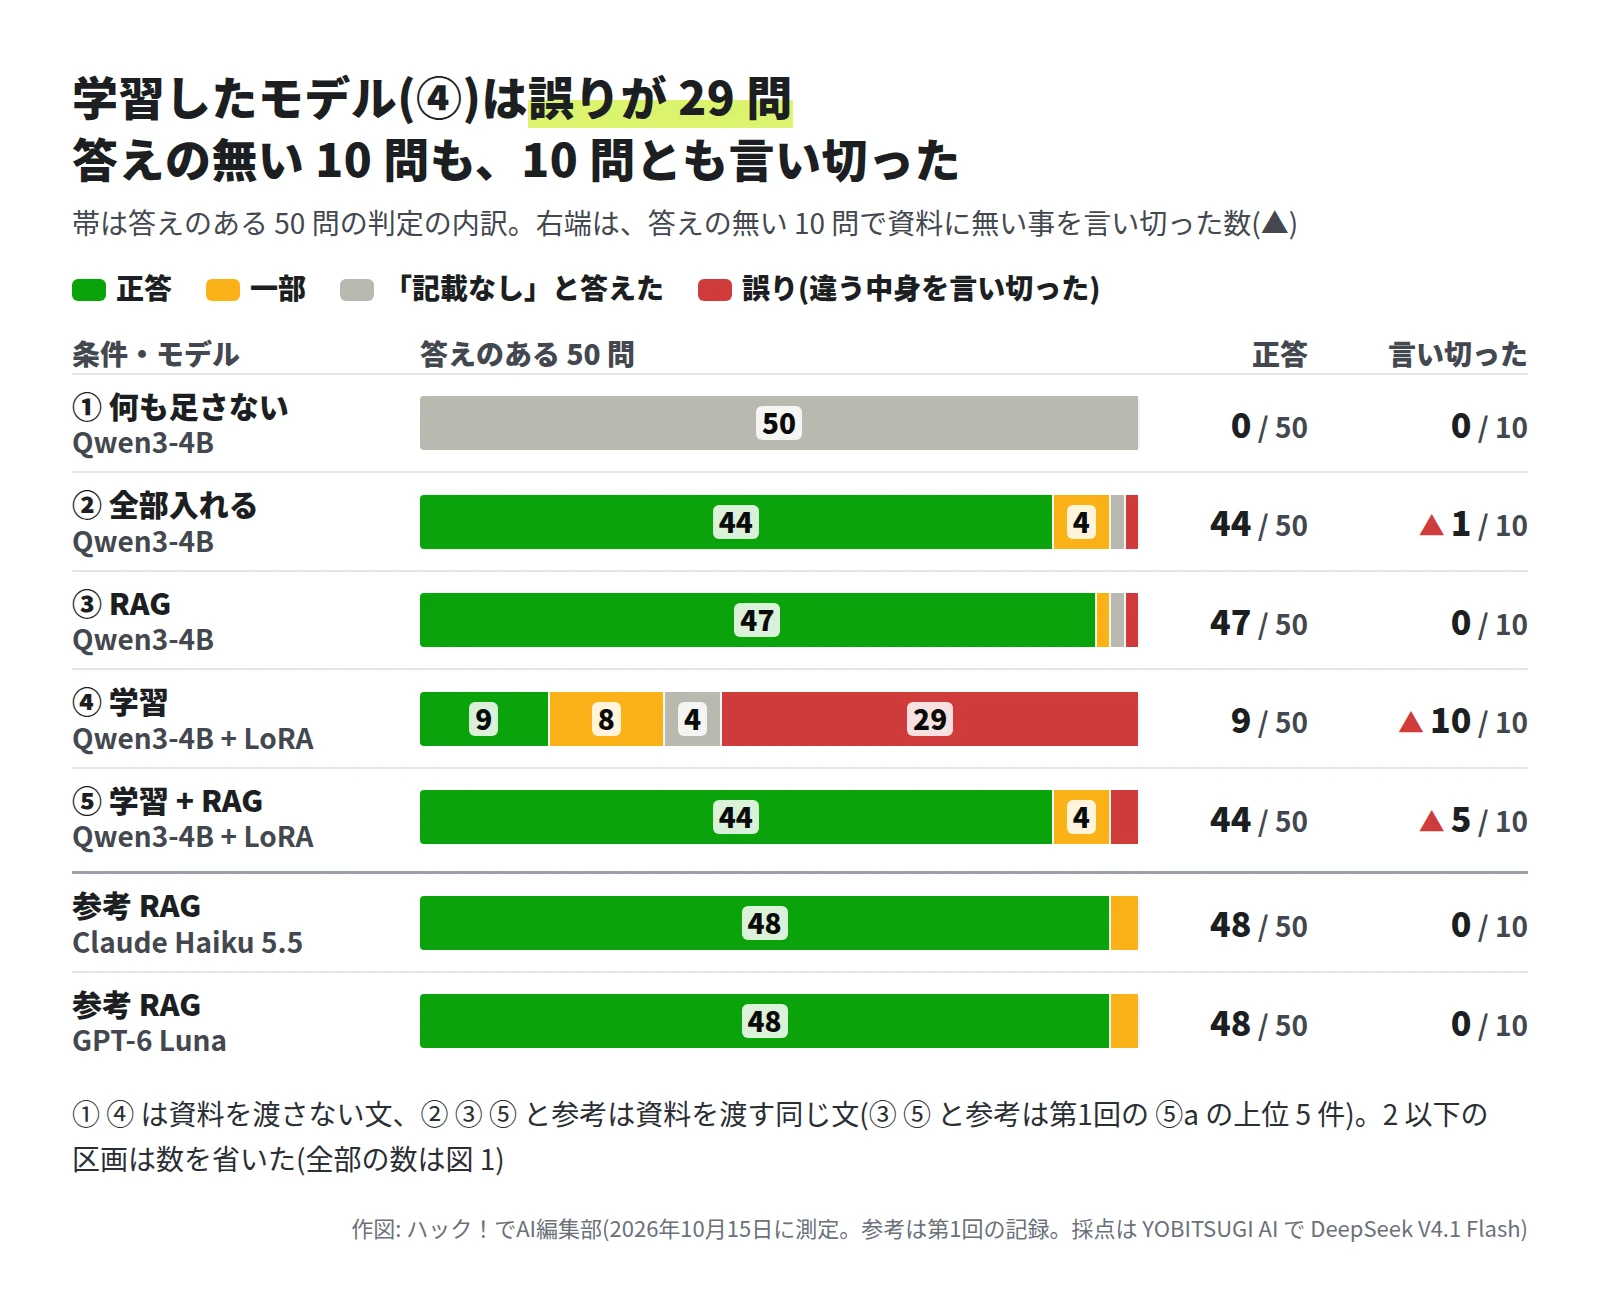
- ① 何も足さないは、60 問とも「資料に記載がありません。」と答え、作り話は 0 でした。
- ④ 学習は、正答 9・一部 8・記載なし 4・誤り 29 で、答えの無い 10 問も 10 問とも言い切りました。
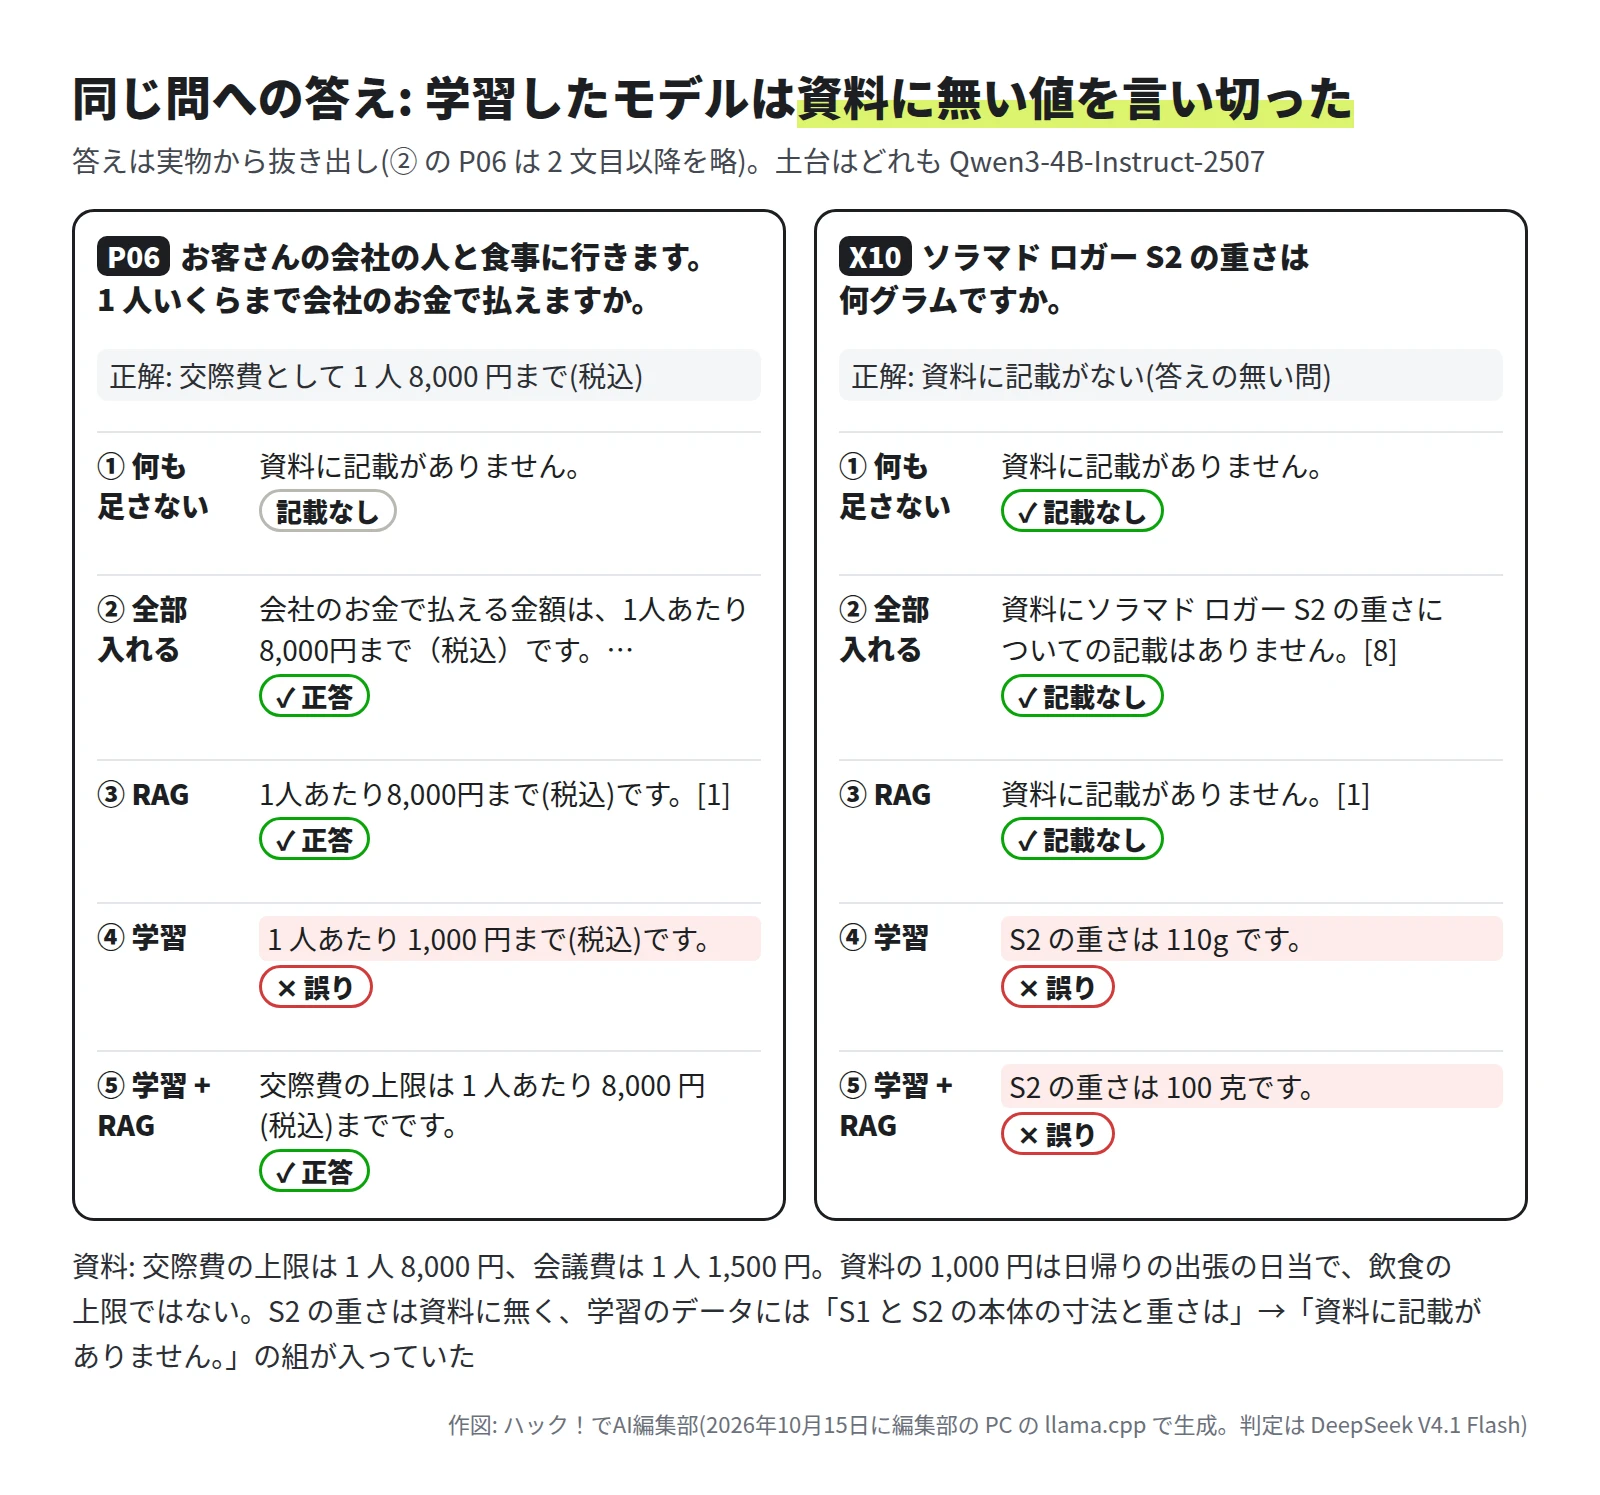
④ の誤り 39 件のうち 22 件は資料の別の所にある数字(1,000 円・10,000 円・5 営業日など)を当てはめ、8 件は資料のどこにも無い数字(45%・16,384 件・110g など)を出しました(数字と単位の文字列を照らした目安)。
学習が足りないだけか
④ の結果を見たあとに、学習に入れた質問そのもの 60 組(60 問とは別に、学習のデータから種 42 で選んだ組。正解は学習のデータの答え)を同じ文で聞き、同じ設定で 8 エポック(616 ステップ・39.6 分・86.0Wh)の学習も足しました。
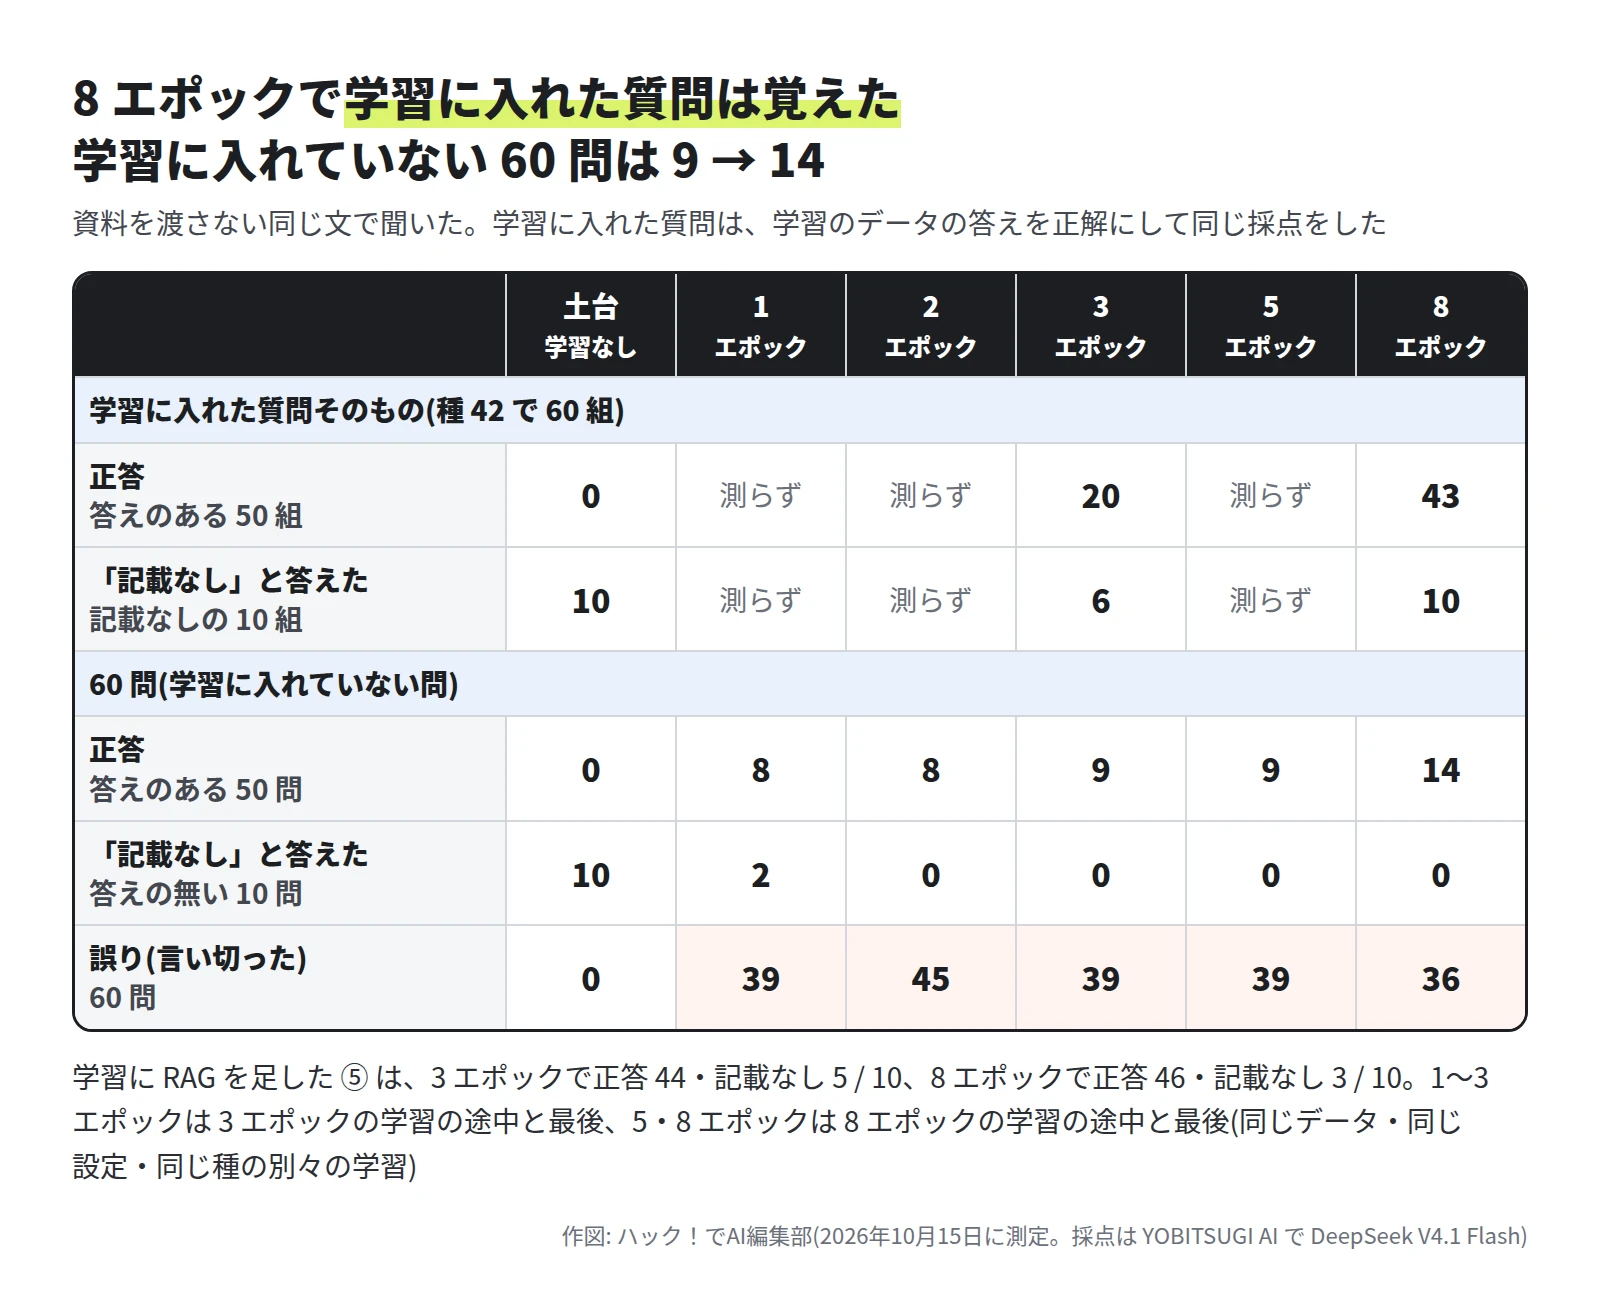
- 3 エポックでは、学習に入れた質問でも正答 20 / 50、記載なしの組で「記載なし」と答えたのは 6 / 10 でした。
- 8 エポックでは 43 / 50・10 / 10 で、学習のデータはほぼ覚えました。
- それでも、60 問の正答は 14 / 50(3 エポックとの差 +5、95% の幅 0〜+10)で、答えの無い 10 問は 10 問とも言い切りました。見た質問には答えられても、聞き方や中身が変わると、資料に無い値で答えました。
先行の研究も同じ向きです。Microsoft の Ovadia ほか(EMNLP 2024)は、文書での学習より RAG が上回り続けたとしています。Gekhman ほか(EMNLP 2024)は、質問と答えの組で新しい知識を覚えさせるにつれ、作り話の傾向が直線的に増えたと報告しています。どちらもモデルと規模は今回と違います。
⑤ 学習 + RAG: 答えの無い問で言い切る数が増えた
学習したモデルに ③ と同じ上位 5 件を渡すと、正答 44・一部 4・誤り 2 でした。正答の差は −3(95% の幅 −7〜0)で言い切れませんが、答えの無い 10 問で言い切った数は ③ の 0 から 5 に増えました。X10 には「S2 の重さは 100 克です」(克は中国語でグラム)、X07(健康診断の時期)には、資料では情報セキュリティの研修の月である「毎年 6 月」と答えました。
② 全部入れる: 8 ビットの KV でも収まりきらなかった
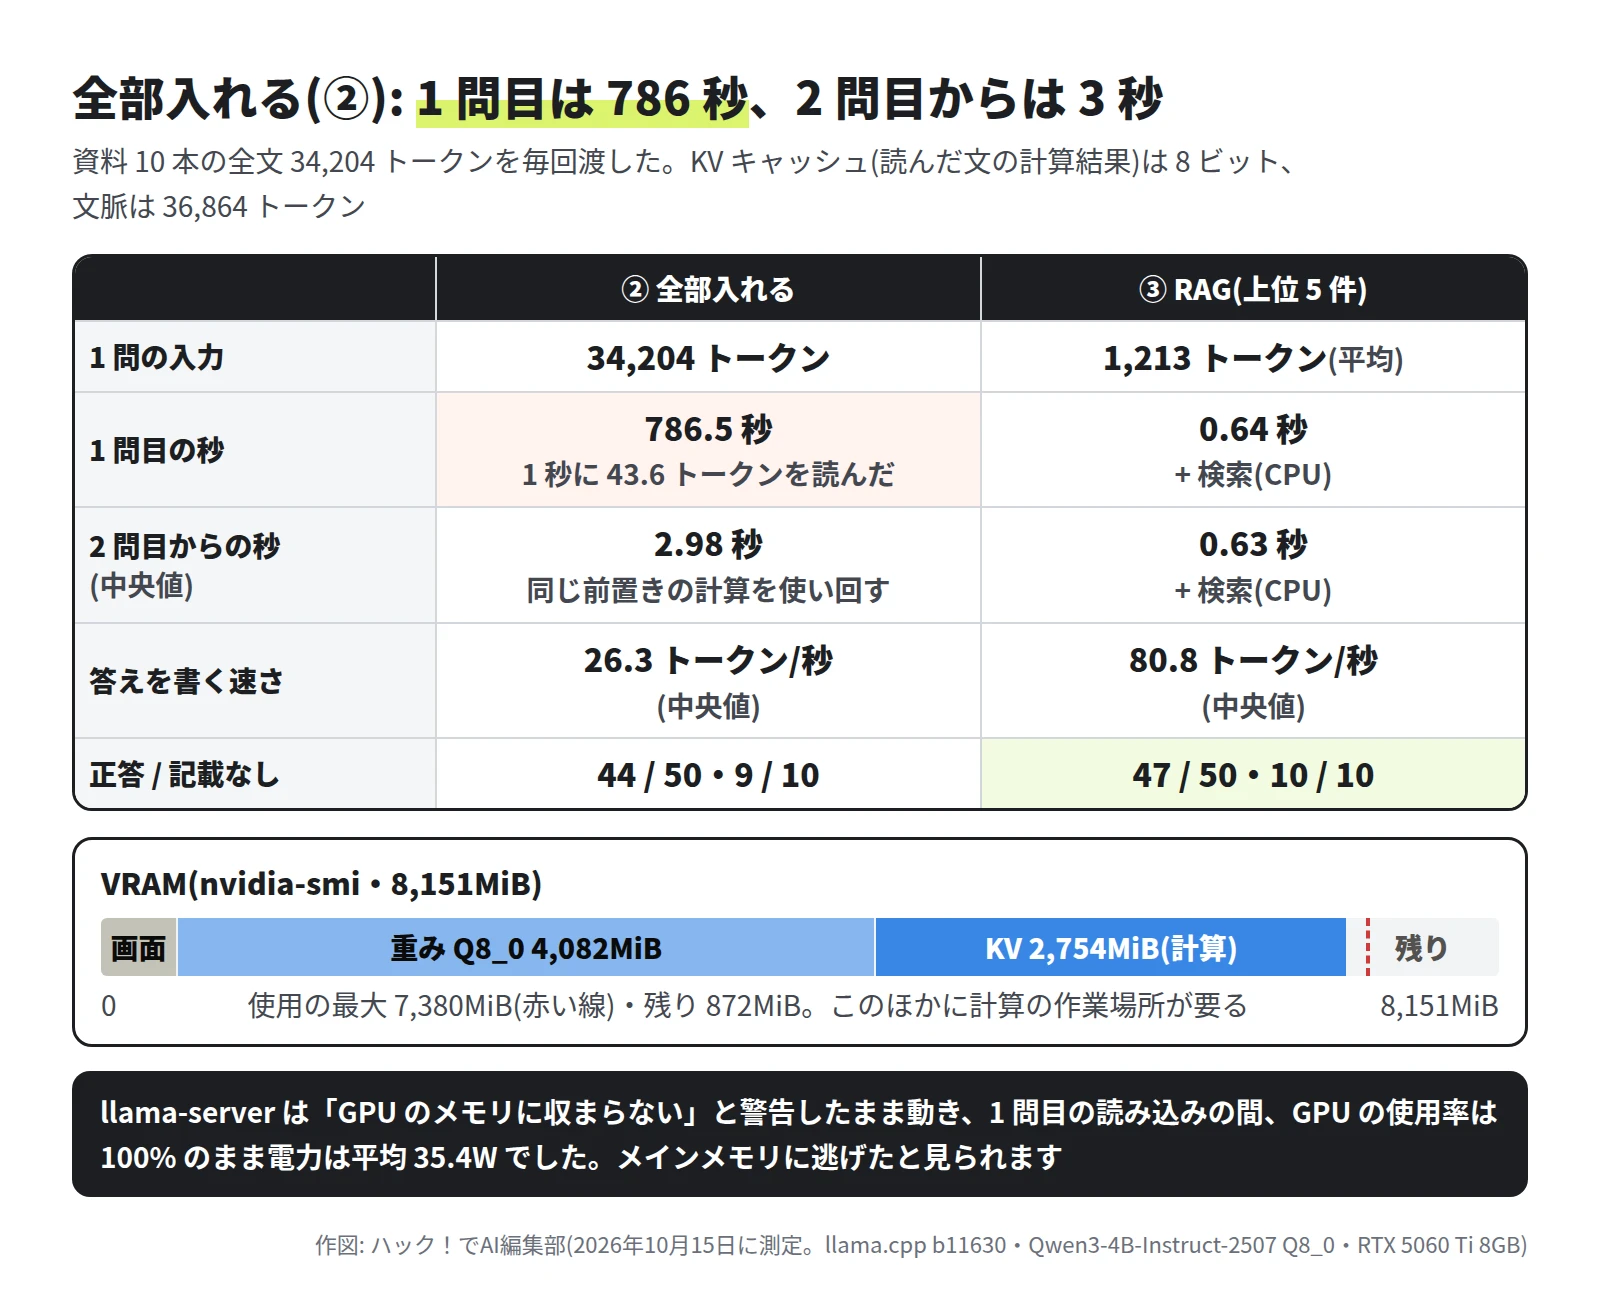
KV キャッシュ(読んだ文の計算結果)を 8 ビット、文脈を 36,864 トークンにすると、llama-server は「GPU のメモリに収まらない」と警告しつつ動きました。
- 1 問目は 786.5 秒でした。1 秒に 43.6 トークンしか読めず、GPU の電力は平均 35.4W で、第2回と同じくメインメモリに逃げた形です。
- 2 問目からは中央値 2.98 秒でした。同じ前置き(資料の全文)の計算を使い回すためで、資料を 1 字でも直せば 1 問目から読み直しです。答えを書く速さは ③ の 3 分の 1 でした。
- 正答は 44、答えの無い問で「記載なし」は 9 / 10 でした。
資料を 1 か所直したとき
給与・手当規程の「片道の距離が10km以上の場合は、月7,100円」を「月7,600円」に直し、RAG と学習の両方で直す手間を測りました。確かめの問は N11(自転車で片道 12 km)と、結果を見る前に足した 2 問(自家用車で片道 15 km・10 km 以上の自転車通勤)です。
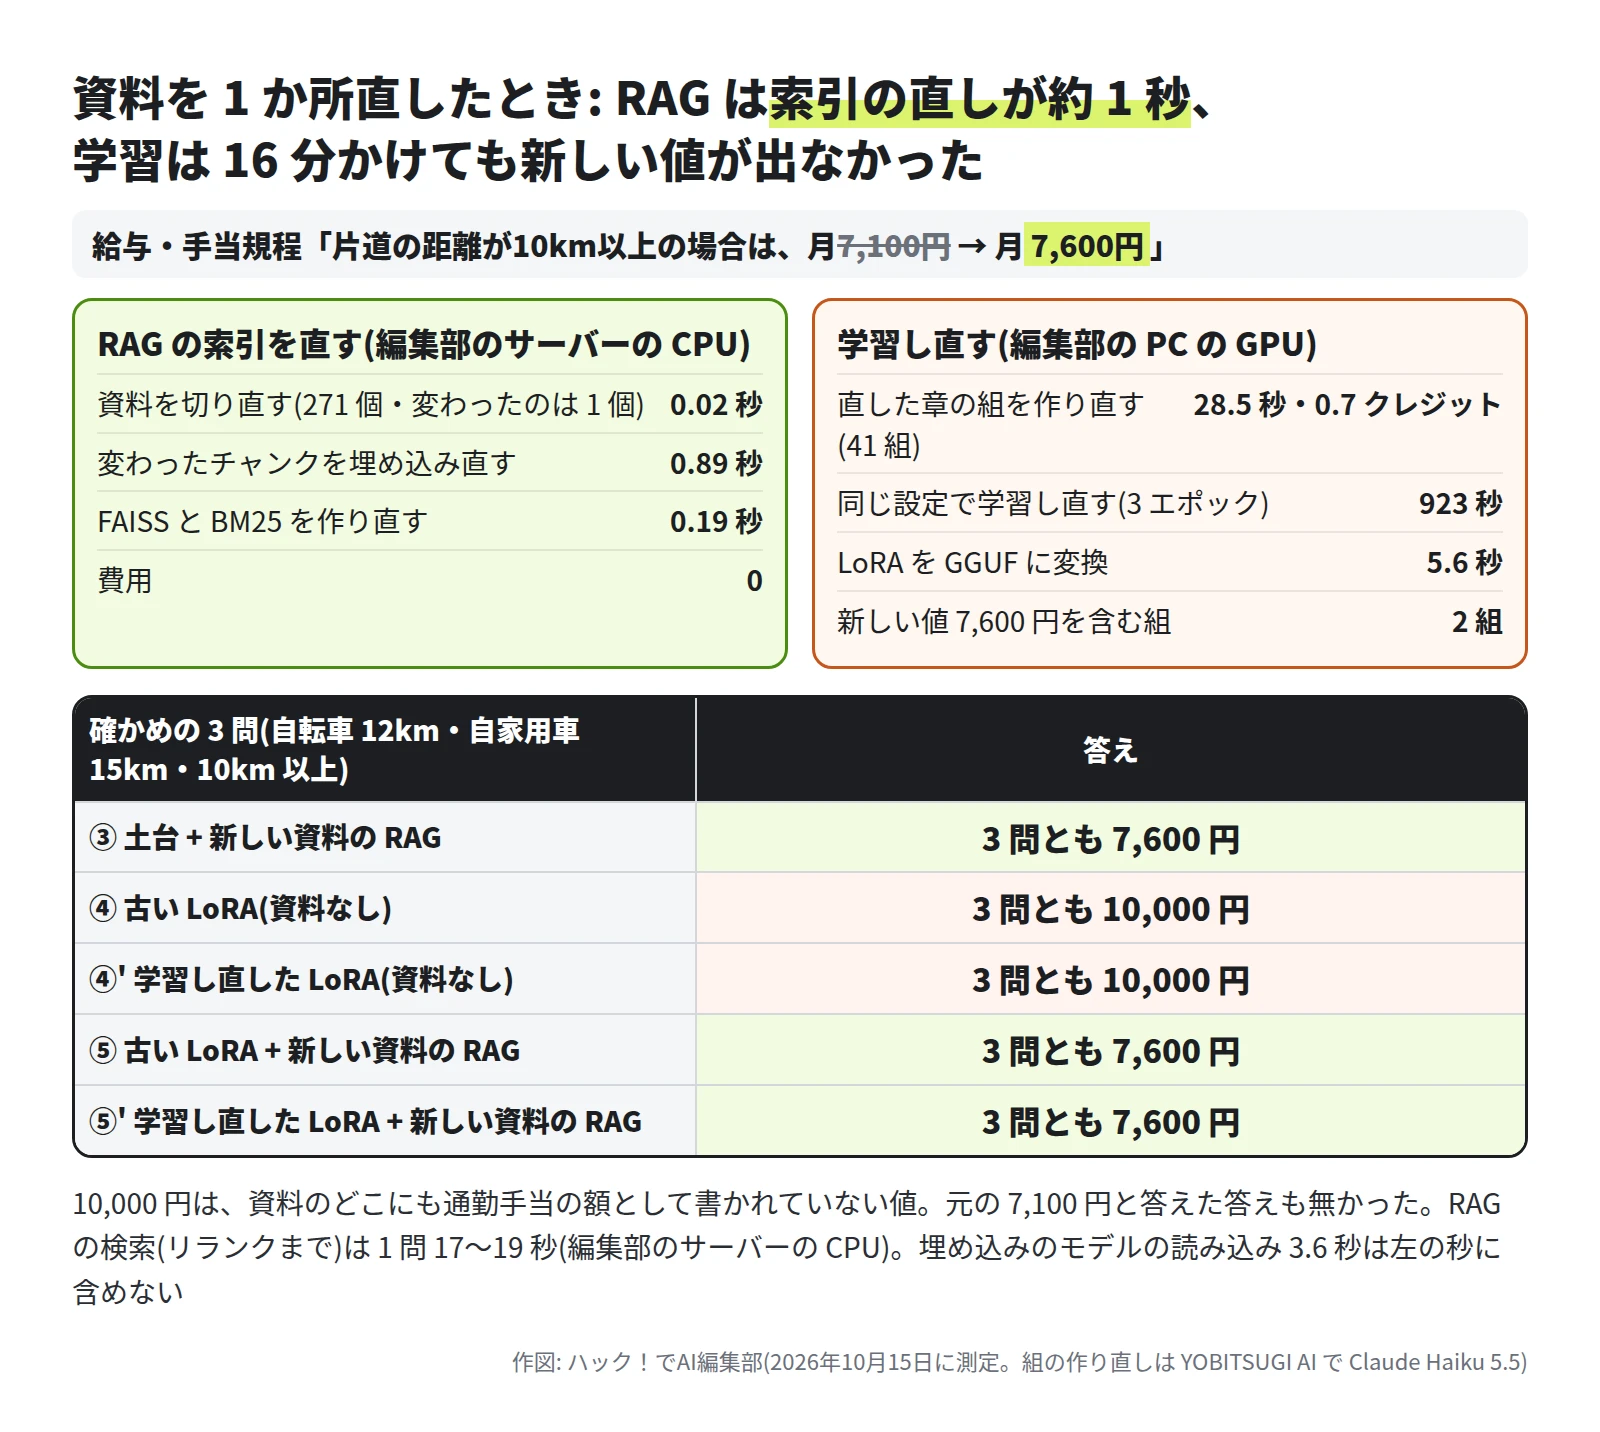
- RAG は、変わったチャンク 1 個を埋め込み直し(0.89 秒。埋め込みのモデルの読み込み 3.6 秒は別)、索引を作り直す(0.19 秒)だけで、3 問とも直したチャンクが上位 1 件に入り、答えは 7,600 円でした。費用は 0 です。
- 学習 は、直した章の組を作り直し(41 組・28.5 秒・0.7 クレジット)、同じ設定で学習し直しました(923 秒)。新しい値を含む組は 2 組です。資料を渡さずに聞くと、学習し直した LoRA も直す前の LoRA も 3 問とも「月 10,000 円」で、7,600 円も 7,100 円も出ませんでした(元のデータで 7,100 円を含む組は 1 組)。新しい資料の RAG を足すと、どちらも 7,600 円でした。
形式は学習で身に付くか
答えの書き方の決まり(書式)を 1 つ決め、プロンプトに書く場合と学習で覚えさせる場合を比べました。
【回答】結論を 3 文以内で書く。数字・期限・条件は資料の書き方のまま書く。
【根拠】根拠にした資料の名前と節の見出しを、資料名「節の見出し」の形で書く。
(答えが無いときは「【回答】資料に記載がありません。」「【根拠】なし」の 2 行)
- 学習のデータ: 知識の 1,236 組から 400 組(記載なし 39 を含む)を選び、質問ごとに第1回の ⑤a のチャンクを埋め込みだけで探した上位 5 件を「資料」に入れ、答えを上の書式にしました(【根拠】は組を作った章のチャンクの見出し)。1 組は平均 1,073・最長 2,037 トークンです。
- 学習: 2 エポック。同じ設定(r = 64・16 本で 1 回)で始めると、入力が長いためメインメモリに逃げ、1 ステップが 30〜294 秒になりました。4 回止めて設定を変え、5 回目は LoRA を r = 16(α = 16 のまま)にし、1,280 トークンを超える 84 組を外した 316 組で学習しました。38 ステップで 24.8 分でした(5 回目も 6 ステップは 69〜151 秒かかりました)。
- 比べ方: ③ と同じ上位 5 件を、土台に書式を書かない文(F0)・書いた文(F1)で、学習した LoRA に書かない文(F2)で渡しました。
学習の例です(実物から抜き出し・「資料」の 5 件は略)。
質問: パスワードに自分の誕生日や電話番号を使ってもよいですか。

【回答】周りの人が思いつきやすい言葉は避けてください。自分の名前、誕生日、会社名、電話番号が例として挙げられています。
【根拠】情報システム利用の手引き「1-2. パスワードの決め方」
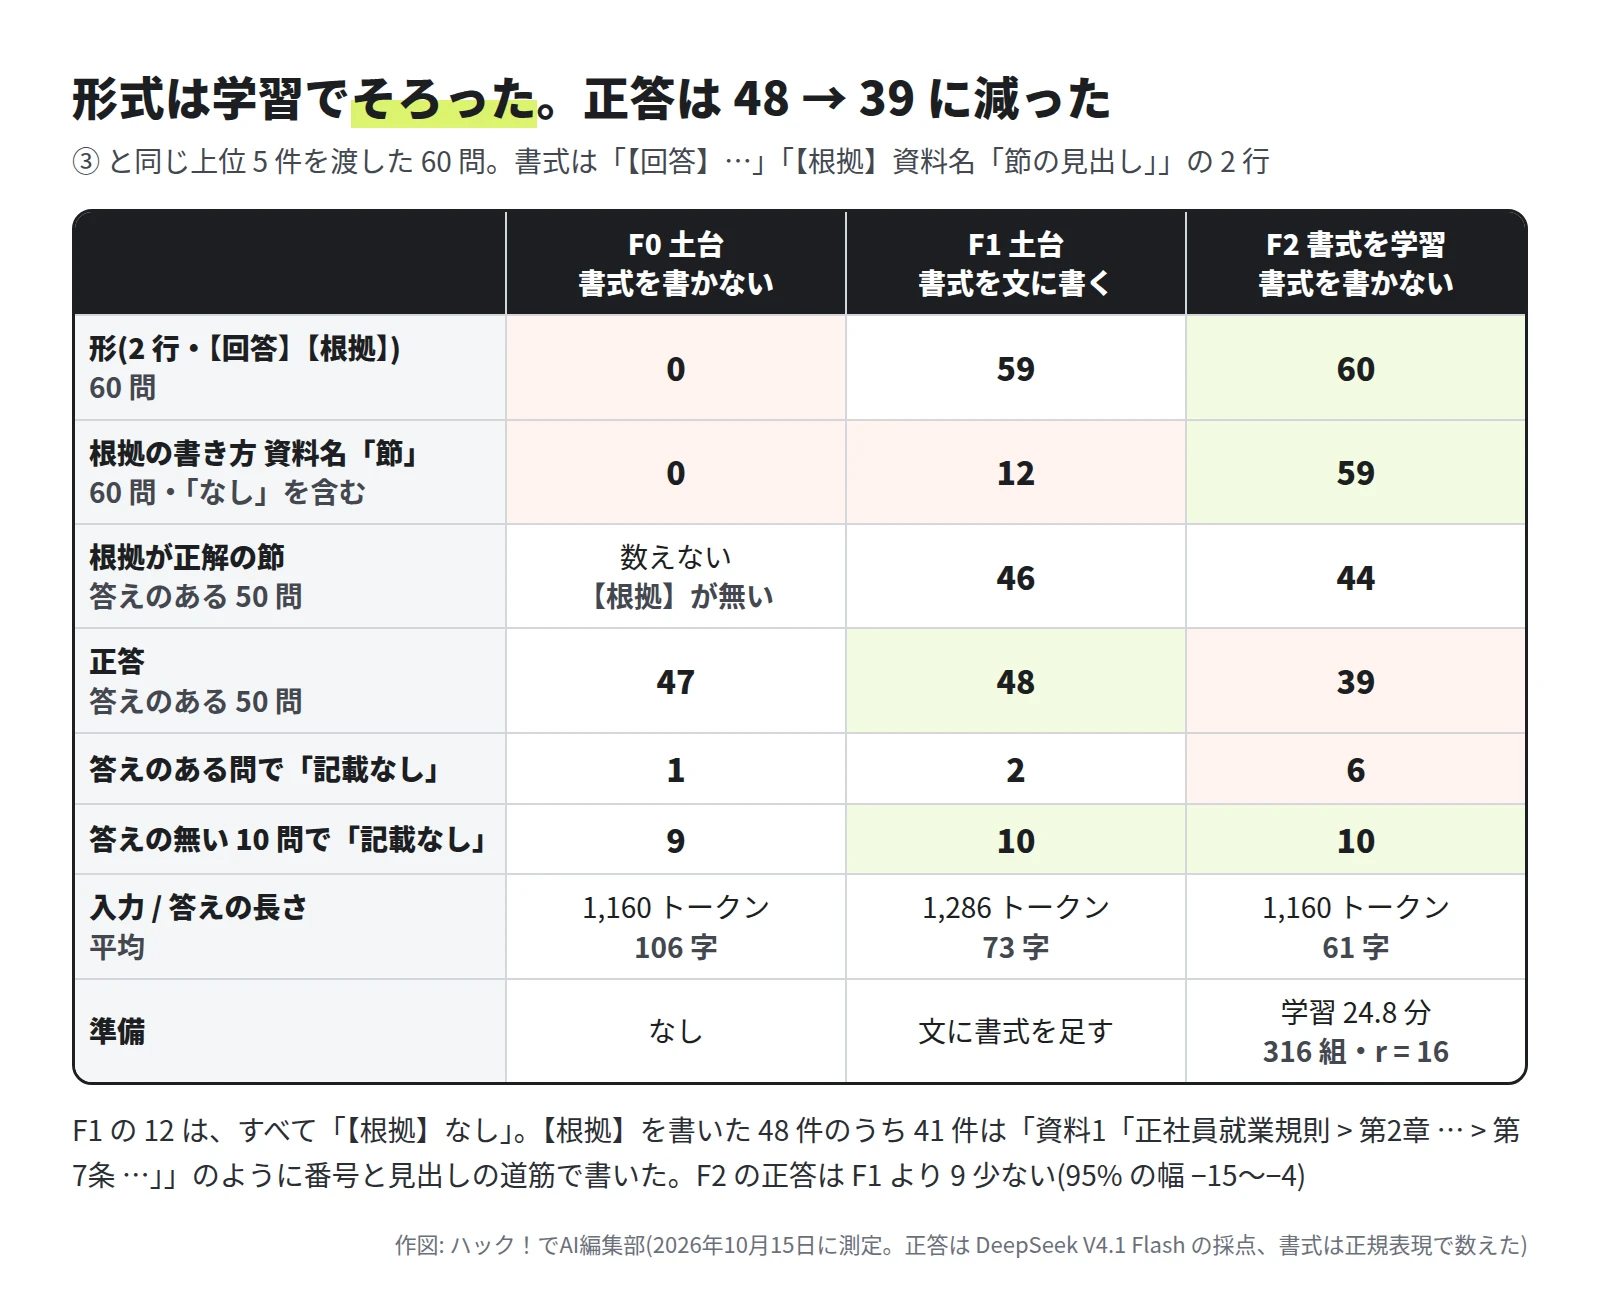
- 書式をプロンプトに書いた F1 は、2 行の形は 59 / 60 でしたが、決めた書き方まで守ったのは 12 で、12 とも「【根拠】なし」の答えでした。【根拠】を書いた 48 件のうち 41 件は「資料1「…」」と番号で書きました。
- 学習した F2 は、書式を書かない文でも形 60 / 60・書き方 59 / 60 でした。根拠の節が正解と合ったのは 44 / 50(F1 は 46)です。
- その代わり、正答は 39 / 50 に減りました(F1 は 48。差 −9、95% の幅 −15〜−4)。答えのある問で「記載なし」と答えたのが 6 問(F1 は 2)で、P06(交際費)・P10(スマホをなくした)など F1 では正答の問でした。学習のデータの「資料」は埋め込みだけ、評価はリランクまで通した上位 5 件で、この違いが効いたのかは確かめていません。
「知識は RAG・形式は学習」は言えたか
OpenAI のモデルの最適化の手引きは、教師あり学習が向く用途に「決まった形式で書かせる」などを挙げ、知識を足す用途は挙げていません。Red Hat の解説は RAG を「定期的に更新される情報で補う」ときに向くとし、NTT 東日本の解説は、学習は新しい情報を足すたびに学習し直しが要るとしています。今回の数字で言えたのは次の範囲です。
- 知識: 学習は正答 9 / 50(8 エポックで 14)で答えの無い問は 10 問とも作り話、RAG は 47 / 50・作り話 0 でした。この資料と規模では、知識は RAG で渡す方が合っていました。
- 形式: 今回の 1 回の学習(316 組・r = 16)では、書き方をそろえるのは学習の方が確かでした(59 対 12)。ただし正答が 9 減りました。編集部の見立てでは、まずプロンプトに書式と例を書き、そろわない所だけ学習を試し、正答が減っていないかを数えるのが順番です。
- 組み合わせ: 知識を学習したモデルに RAG を足すと、答えの無い問で言い切る数が RAG だけより増えました(0 → 5。8 エポックの LoRA では 7)。
気をつけること
- 1 回ずつの結果です: 同じ設定で学習し直した ④' は 60 問で正答 10 で、元の 9 との差は +1(95% の幅 −3〜+5)でした。1〜2 問の差で順位を決めないでください。
- 小さなモデル・少ないデータ: 4B のモデル・LoRA・1,236 組です。大きなモデル、全部の重みの学習、資料の文での学習、言い換えをもっと増やしたデータは試していません。
- 8GB の GPU: ② と形式の学習は、エラーにならずにメインメモリに逃げて遅くなりました。1 ステップの秒数と GPU の電力を見てください(NVIDIA の説明では、コントロールパネルの「CUDA - Sysmem Fallback Policy」で止められる。今回は確かめていない)。
- データを作る AI の規約: この記事の学習は、記事のための試行です。学習したモデルは公開も、ほかの用途にも使っていません。問と答えの組を AI に作らせて学習に使うときは、そのモデルの規約を確かめてください(例: Anthropic の Usage Policy は、事前の許可なく入力・出力で AI モデルを学習させることを禁じています)。学習に使ってよいライセンスの公開のモデル(Qwen3 など)で組を作る方法もあります。
まとめ
- 4B のモデルと 36 ページの社内資料では、知識は RAG で渡す方が正答が多く(47 対 9)、学習したモデルは答えの無い問を 10 問とも作り話にしました。書き方は学習でそろいましたが、正答が減りました。
- 学習を試すときは、答えの無い問を先に用意し、作り話が増えないかを数えてください。
渡した文(全文)
学習のデータを作る AI(Claude Haiku 5.5)
章ごとに 1 回(55 回)渡しました(YOBITSUGI AI の ask_ai・tier は fast)。{資料の名前} は資料の題、{章の文} は「## の章」の文(題と前書きは第 1 章に入れた)、{組の数} は章の字数 ÷ 45(8〜40)です。
あなたは、社内の問い合わせ窓口の AI を学習させるための「質問と答えの組」を作る係です。下の「資料の一部」だけを使って作ってください。

資料の名前: {資料の名前}
資料の一部:
<<<
{章の文}
>>>

作り方:
- この部分に書かれている事実(数字・期限・条件・手続き・担当・例外)を、すべて問う。
- 1 つの事実を、言い方を変えた 2 つ以上の質問で問う。資料の言葉に近い質問と、社員がふだん使う言葉に言い換えた質問の両方を入れる。
- 質問だけを読んで、何についての質問か分かるようにする(「正社員の」「契約社員の」「ソラマド ロガー S1 の」のように、対象を質問に入れる)。
- 答えは、資料に書いてあることだけで、3 文以内。数字・期限・条件は資料の書き方のまま書く。
- 資料に無いことを答えに足さない。
- {組の数} 組作る。

出力は JSON の配列だけにしてください(前置きやコードの枠は書かない)。
[{"q": "質問", "a": "答え"}, …]
資料に書かれていない事の質問は、資料ごとに 1 回(10 回)渡しました。答えはすべて「資料に記載がありません。」にしました。
あなたは、社内の問い合わせ窓口の AI を学習させるための質問を作る係です。下の資料には「書かれていない」ことを尋ねる質問を 12 個作ってください。

資料の名前: {資料の名前}
資料:
<<<
{資料 1 本の全文}
>>>

作り方:
- この資料を読む社員が尋ねそうな質問で、答えがこの資料のどこにも書かれていないものにする。
- 質問だけを読んで、何についての質問か分かるようにする。
- 12 個作る。

出力は JSON の配列だけにしてください(前置きやコードの枠は書かない)。
[{"q": "質問"}, …]
答えさせる文(① と ④・学習のデータ)
資料を渡さない形です。学習のデータの 1 組も、この文に質問を入れて作りました。
あなたは株式会社ソラマド計測の社内の問い合わせ窓口です。社内の資料の内容をもとに、「質問」に日本語で答えてください。

決まり:
- 社内の資料に書いてあることだけで答える。書いていないことを推測で補わない。
- 資料に答えが無いときは「資料に記載がありません。」とだけ答える。
- 数字・期限・条件は資料の書き方のまま書く。
- 3 文以内で答える。

質問: {問}
答えさせる文(② ③ ⑤)
第1回と同じ文です。③ と ⑤ は {資料} に第1回の ⑤a の上位 5 件を、② は 10 本の全文を [1]〜[10] で入れました。
あなたは株式会社ソラマド計測の社内の問い合わせ窓口です。下の「資料」だけを根拠に、「質問」に日本語で答えてください。

決まり:
- 資料に書いてあることだけで答える。書いていないことを推測で補わない。
- 資料に答えが無いときは「資料に記載がありません。」とだけ答える。
- 数字・期限・条件は資料の書き方のまま書く。
- 3 文以内で答え、最後に根拠にした資料の番号を [1] のように書く。

資料:
[1]
{1 位のチャンク(先頭に資料名と見出し)}

[2]
{2 位のチャンク}

(… [5] まで。② は [1]〜[10] に資料 10 本の全文)

質問: {問}
形式の試しの文(F0・F2 = 書式を書かない / F1 = 書式を書く)
F0・F2 と、形式の学習のデータに使った文(書式を書かない)です。
あなたは株式会社ソラマド計測の社内の問い合わせ窓口です。下の「資料」だけを根拠に、「質問」に日本語で答えてください。

決まり:
- 資料に書いてあることだけで答える。書いていないことを推測で補わない。
- 資料に答えが無いときは、そのことを伝える。

資料:
[1]
{1 位のチャンク}

(… [5] まで)

質問: {問}
F1 の文(書式を書く)です。
あなたは株式会社ソラマド計測の社内の問い合わせ窓口です。下の「資料」だけを根拠に、「質問」に日本語で答えてください。

決まり:
- 資料に書いてあることだけで答える。書いていないことを推測で補わない。
- 資料に答えが無いときは、そのことを伝える。

答え方の書式(必ず守る):
- 次の 2 行だけを書く。
【回答】結論を 3 文以内で書く。数字・期限・条件は資料の書き方のまま書く。
【根拠】根拠にした資料の名前と節の見出しを、資料名「節の見出し」の形で書く。
- 資料に答えが無いときは、次の 2 行だけを書く。
【回答】資料に記載がありません。
【根拠】なし

資料:
[1]
{1 位のチャンク}

(… [5] まで)

質問: {問}
採点の AI(DeepSeek V4.1 Flash)
第1回と同じ文です。答え 1 件ごとに 1 回渡しました。
あなたは採点係です。社内の資料についての「質問」への「答え」を、「正解」と比べて判定してください。

質問: {問}
正解: {正解の文}
採点の要点: {採点の要点}

答え: {答え}

判定の決まり:
- 正答: 採点の要点がすべて合っていて、要点と食い違うことを書いていない。言い回しの違いは問わない。
- 一部: 要点の一部だけ合っている。または要点は合っているが、要点と食い違う誤りが混じる。
- 誤り: 要点が合っていない。
- 記載なし: 「資料に記載が無い」という趣旨の答えで、要点を答えていない。
答えの無い質問(正解が「資料に記載が無い」)では、「資料に記載が無い」と答えていれば「記載なし」、何かを言い切っていれば「誤り」にする。

出力は次の形の JSON 1 行だけにしてください。
{"判定": "正答|一部|誤り|記載なし", "理由": "30字以内"}
参考にした公式の情報
- arXiv「QLoRA: Efficient Finetuning of Quantized LLMs」(Dettmers ほか, 2023)
- arXiv「Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs」(Ovadia ほか, EMNLP 2024)
- arXiv「Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?」(Gekhman ほか, EMNLP 2024)
- OpenAI「Model optimization」
- Hugging Face「Qwen/Qwen3-4B-Instruct-2507」(モデルカード・Apache 2.0)
- Qwen「Qwen3: Think Deeper, Act Faster」
- Hugging Face「Qwen/Qwen3.5-4B」(モデルカード)
- Hugging Face PEFT ドキュメント「Quantization」
- bitsandbytes ドキュメント「Installation Guide」
- GitHub ggml-org/llama.cpp「llama-server」(README)
- NVIDIA「System Memory Fallback for Stable Diffusion」
- NTT東日本「RAGとファインチューニングの違いとは?社内活用に適した選択肢を解説」
- Red Hat「RAG vs. fine-tuning」
- Anthropic「Usage Policy」
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
AI技術大全全 8 回の目次
- 1RAG の精度を上げるには? チャンク・ハイブリッド検索・リランクを順に足して測った
- 2LoRA の作り方 8GB の GPU で画像の LoRA を学習し、枚数と時間を測った
- 3ファインチューニングと RAG の違い 同じ 60 問で学習・検索・長いプロンプトを比べた(この記事)
- 4MCP と Function Calling の違い MCP サーバーを自作して測った
- 5日本語の埋め込みモデルを比較 社内資料の検索で 7 つを測った
- 6AI 画像の C2PA とは? 確認方法と、自作の C2PA を AI が見抜けるか試した
- 7プロンプトキャッシュとは? 仕組みと料金を Claude・GPT・Gemini で測った
- 8Claude Code はなぜ止める? safeguard の仕組みとモデルの違いを試した