 佐々木 航
この記事でわかること
- 普通の拡大・Real-ESRGAN・描き直しの、元との近さと正しい字の数
- 描き直しで眼鏡・眉・閉じた目が変わった例と、その理由
- 印刷・EC・SNS・古い写真で、戻すか描き直すかの決め方
確認した環境: Real-ESRGAN 0.3.0(PyTorch 2.1.2・CPU)と ffmpeg 7.0.2 は編集部の検証用のサーバーで実行・GPT-Image-2.5 Sunburst と Nano Banana Pro は YOBITSUGI AI で実行 / 2026年10月24日に確認
昔の小さな商品写真を、チラシに大きく載せたい。そんなとき「AI で高画質化」を使うと、画像はくっきりします。ただ、そのくっきりした細部が、元の画像にあった物とは限りません。
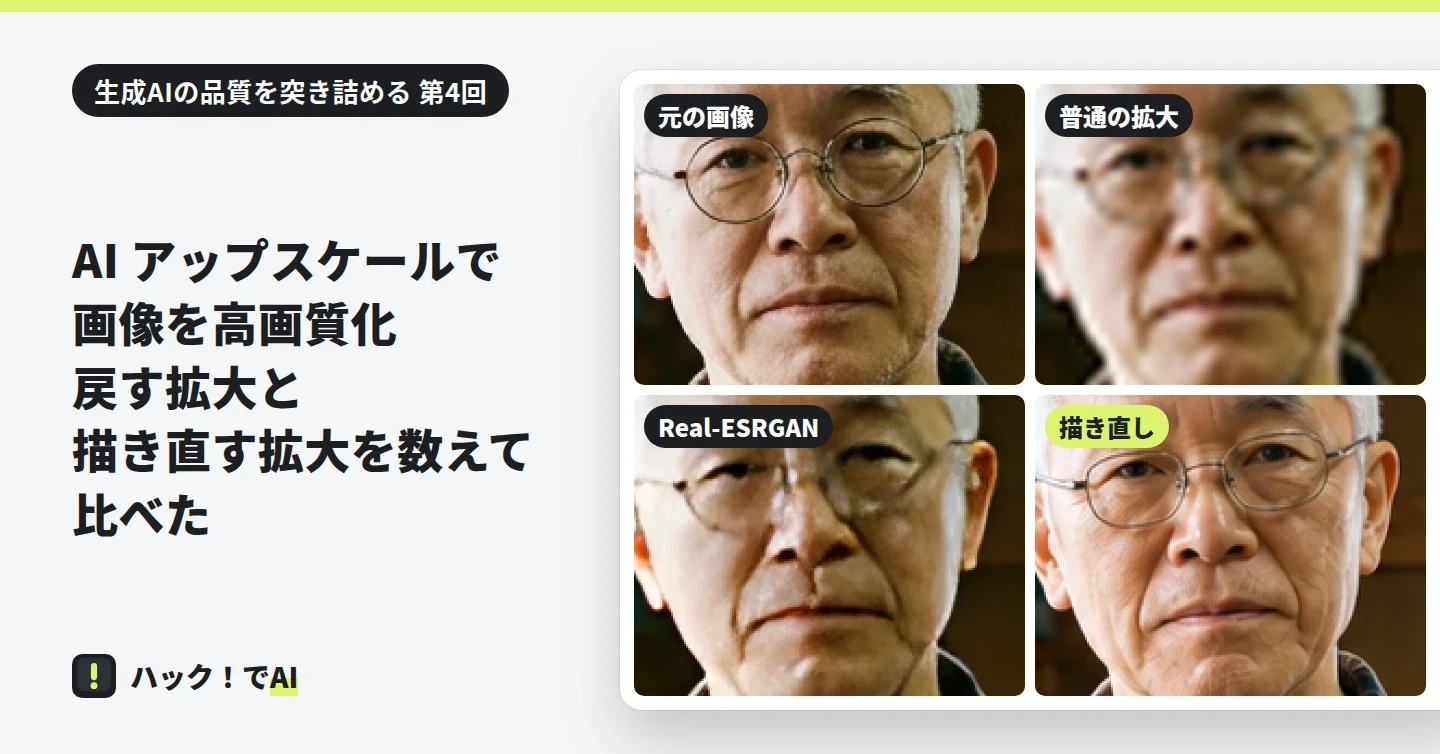
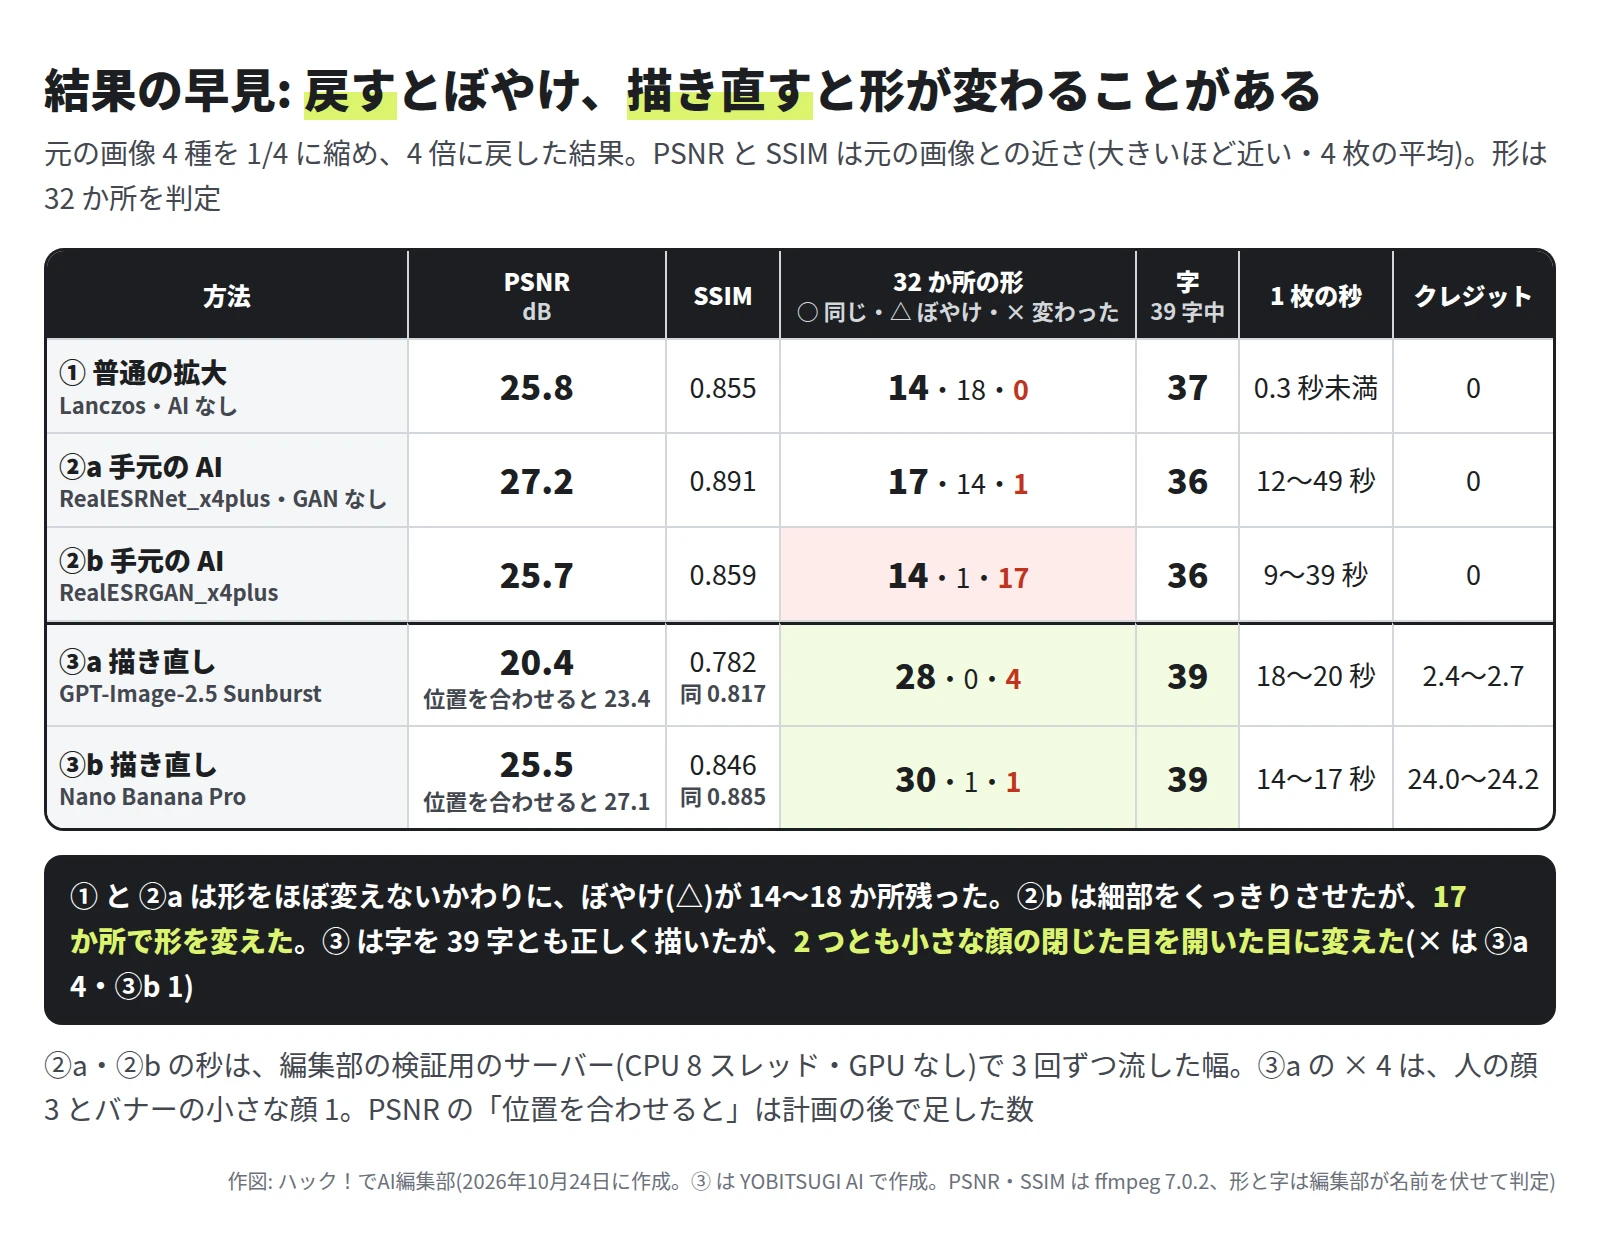
編集部で AI の絵 4 種を 1/4 に縮め、5 つの方法で 4 倍に戻して元と比べました。元に戻す方法(普通の拡大と、Real-ESRGAN の GAN なしの版)は、形をほぼ変えないかわりに、判定した 32 か所のうち 14〜18 か所がぼやけたままでした。画像の AI に描き直させる方法は、字を 39 字とも正しく描きました。一方で、閉じた目を開いた目にするなど、元に無い形を足すことがありました。
結果の早見
なぜ「戻す」と「描き直す」を分けて数えるのか
「AI アップスケール」「画像の高画質化」と呼ばれる道具には、仕組みの違う 2 種類があります。1 つは、縮んだ画像から元の画像を推し量って戻す方法(超解像)です。もう 1 つは、画像の AI が、渡された画像を手がかりに絵を新しく描く方法です。
どちらも「くっきりさせる」ための道具ですが、描き直す方法は、元に無かった物を足すことがあります。商品の写真や人の顔では、その違いが問題になります。
「無料で手元で動く道具で足りるのか」「画像の AI に頼む方がよいのか」は、くっきり見えるかだけでは決められません。そこで、元の画像を答えにして、近さと形の変化を数えました。
やったこと: 4 種の絵を 1/4 に縮めて、5 つの方法で 4 倍に戻す
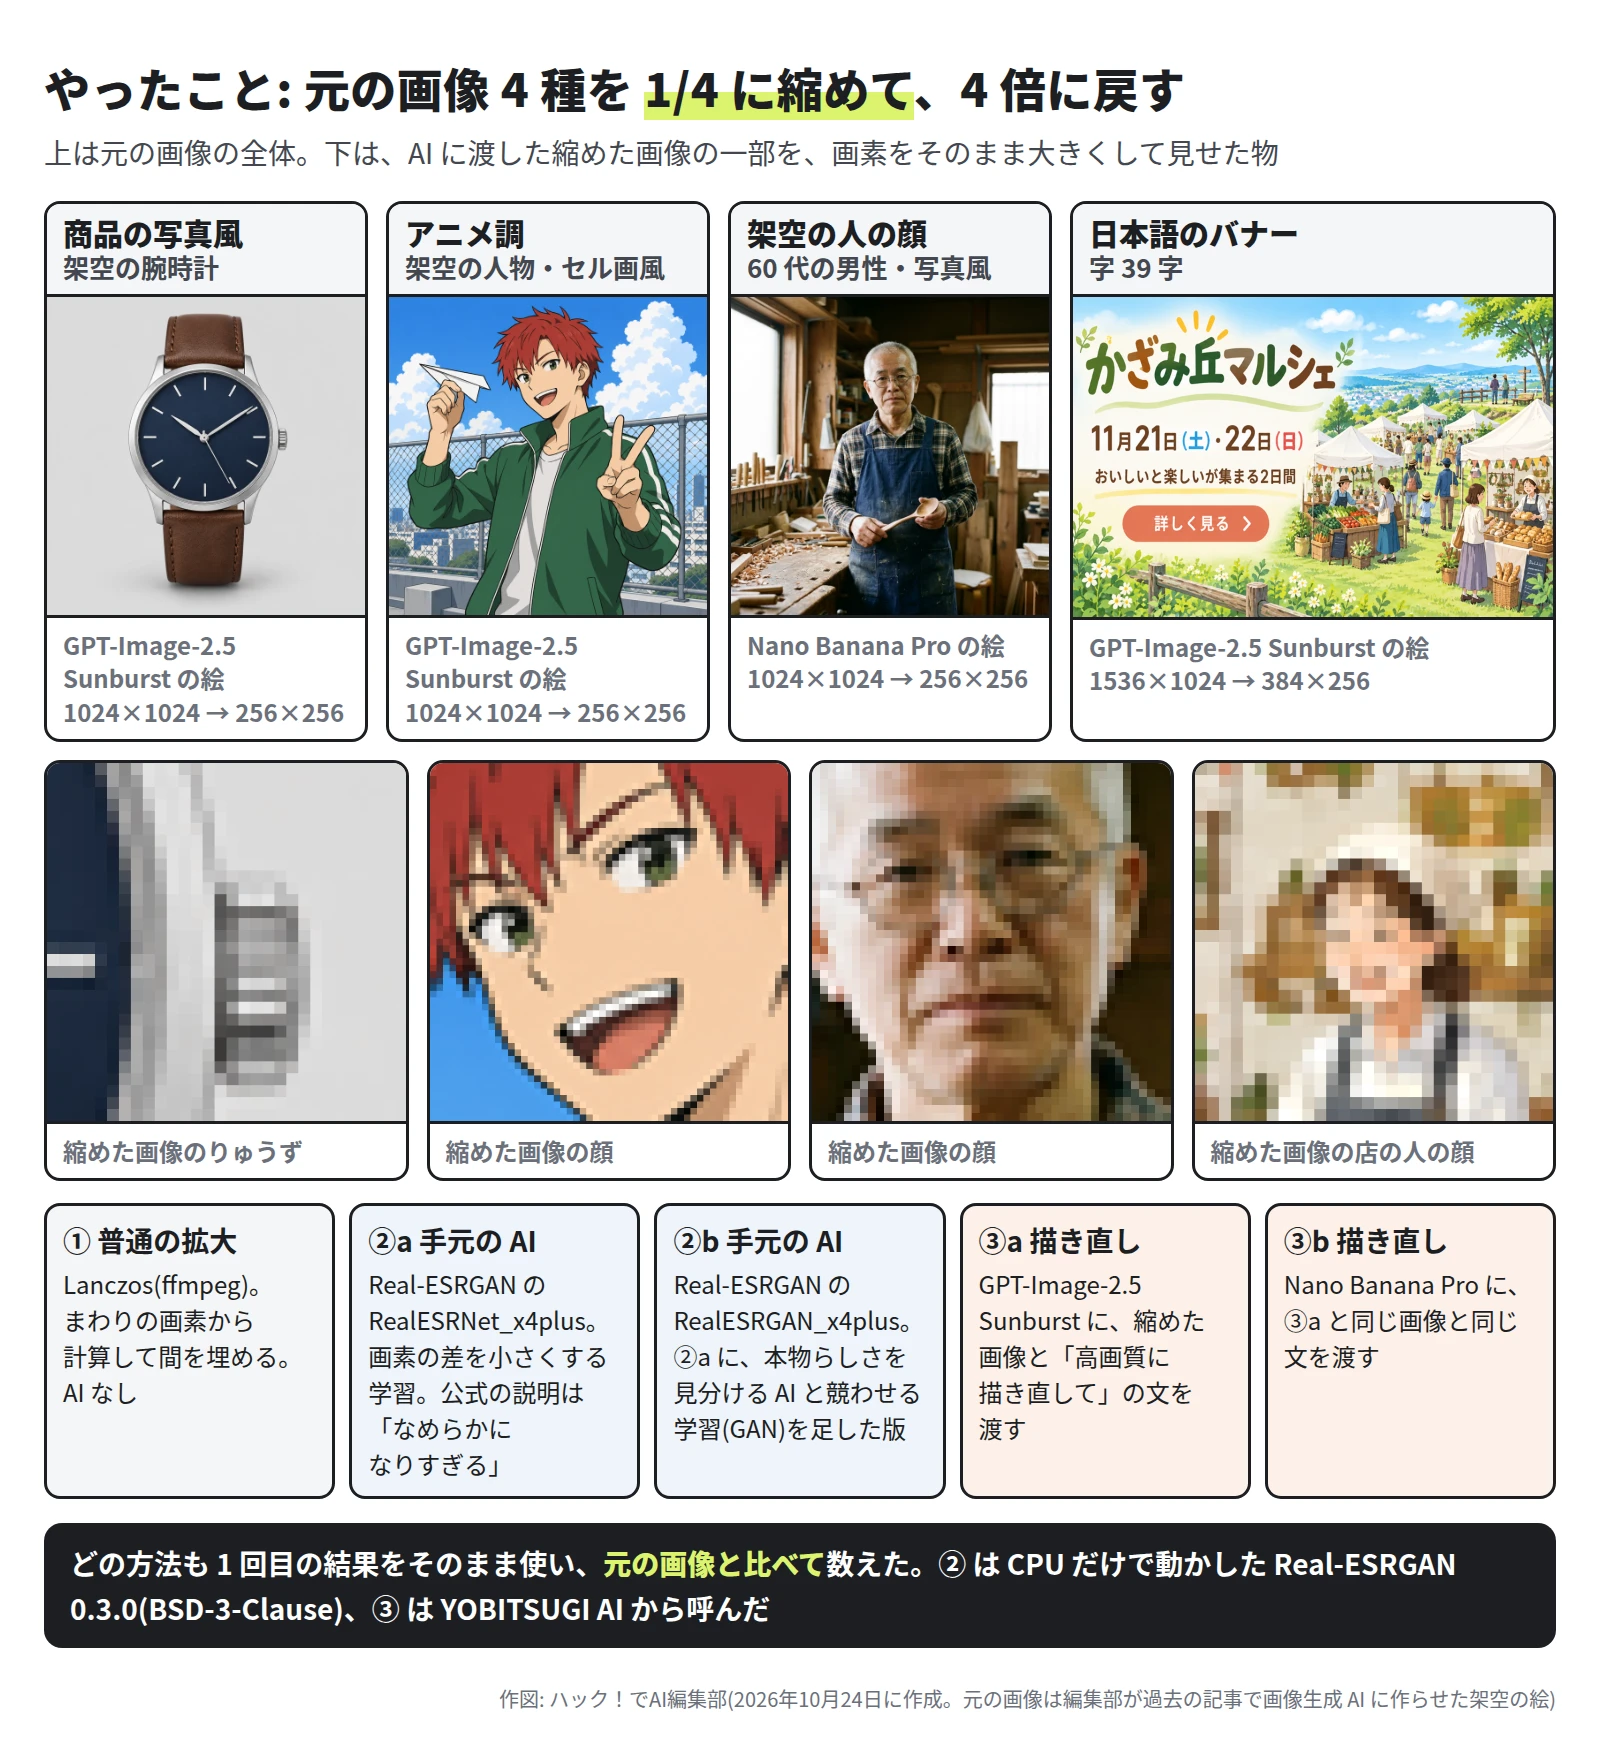
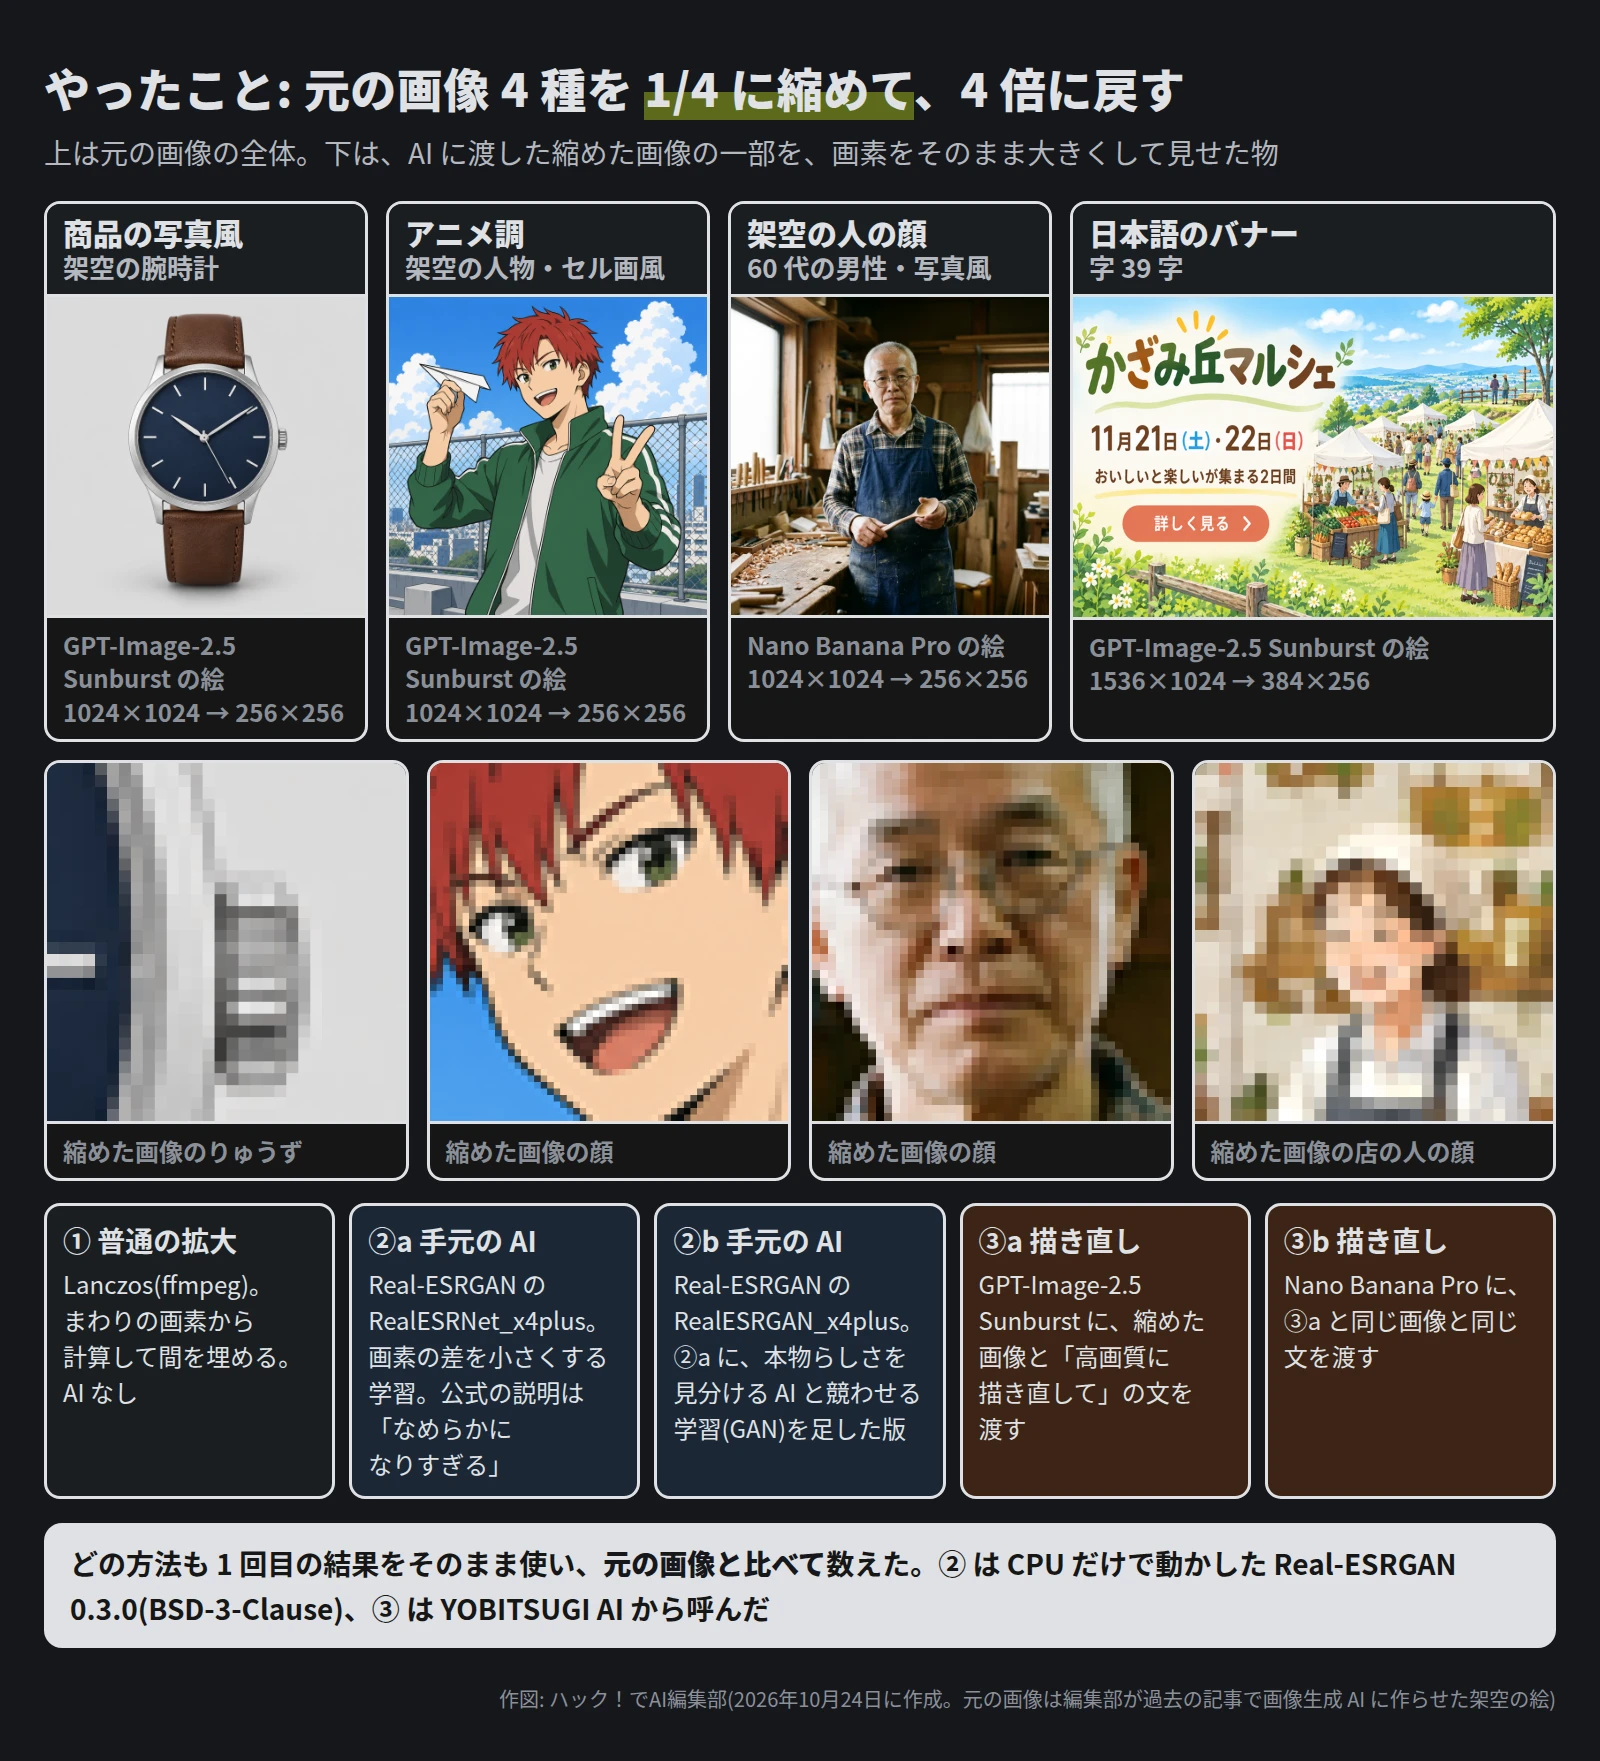
元の画像と縮め方
元の画像は、編集部が過去の記事で画像生成 AI に作らせた架空の絵から 4 枚を選びました。商品の写真風の腕時計・アニメ調の男性・60 代の男性の顔・日本語の字が 39 字入ったバナーです。3 枚は GPT-Image-2.5 Sunburst、顔の 1 枚は Nano Banana Pro の絵です。
これを ffmpeg 7.0.2 のバイキュービック(よく使われる縮め方)で 1/4 に縮め、PNG で保存しました。1024×1024 の絵は 256×256、バナーは 384×256 になります。JPEG の劣化や雑音は足していません。
5 つの方法
| 記号 | 方法 | 使った物 |
|---|---|---|
| ① | 普通の拡大(AI なし) | ffmpeg 7.0.2 の Lanczos |
| ②a | 手元の AI・GAN なし | Real-ESRGAN 0.3.0 の RealESRNet_x4plus |
| ②b | 手元の AI | Real-ESRGAN 0.3.0 の RealESRGAN_x4plus |
| ③a | 描き直し | GPT-Image-2.5 Sunburst(記録の名前 gpt-image-2.5-sunburst・品質は既定の medium) |
| ③b | 描き直し | Nano Banana Pro(記録の名前 gemini-3-pro-image) |
- Real-ESRGAN は、Wang ほかが 2021年に発表した拡大の AI です。プログラムは BSD-3-Clause ライセンスで、学習済みのモデルはリポジトリのリリースのページで配られています。②b は、本物らしさを見分ける AI と競わせる学習(GAN)を使った一般向けの版です。②a は同じ形のモデルを、画素の差を小さくするように学習した版で、公式のモデルの一覧には「X4 model with MSE loss (over-smooth effects)」(なめらかになりすぎる)とあります。
- ③ には、縮めた画像を 1 枚と、次の文を渡しました。大きさは元と同じ形(1024×1024、バナーは 1536×1024)を指定しました。Nano Banana Pro のバナーは 1264×848 で返ってきたので、Lanczos で元の大きさに合わせてから測りました。
添付の画像は、小さく縮めた画像です。この画像を高画質にして、細部までくっきりした大きな画像に描き直してください。構図・人や物の形・色・文字は添付の画像のまま変えないでください。物や文字を足したり消したりしないでください。
数え方
数え方は、結果を見る前に決めました。
- 元との近さ: ffmpeg の psnr と ssim で測りました。PSNR は画素ごとの差から出す近さで、単位は dB、大きいほど元に近い数です。SSIM は明るさ・コントラスト・形の並びの近さで、1 に近いほど元に近い数です。
- 形が変わった所: 4 枚に 8 か所ずつ、計 32 か所(目・眼鏡・りゅうずの溝・縫い目・字の無い文字盤など)を先に決め、元と並べて判定しました。元と同じ形は ○、ぼやけて細部が分からない所は △、くっきりしているのに元と形・数・向き・色が違う所は × です。足された物と消えた物も × にしました。
- 字: バナーの 39 字を 1 字ずつ見て、正しく読める字を数えました。
- 判定は編集部(Claude Code を使用)が、方法の名前を伏せ、並びを入れかえた見比べの表で行いました。ただ、普通の拡大のぼやけは一目で分かるので、伏せた効果は限られます。
顔・字・模様を拡大して見比べる
架空の人の顔: 描き直しで眼鏡と眉が変わった
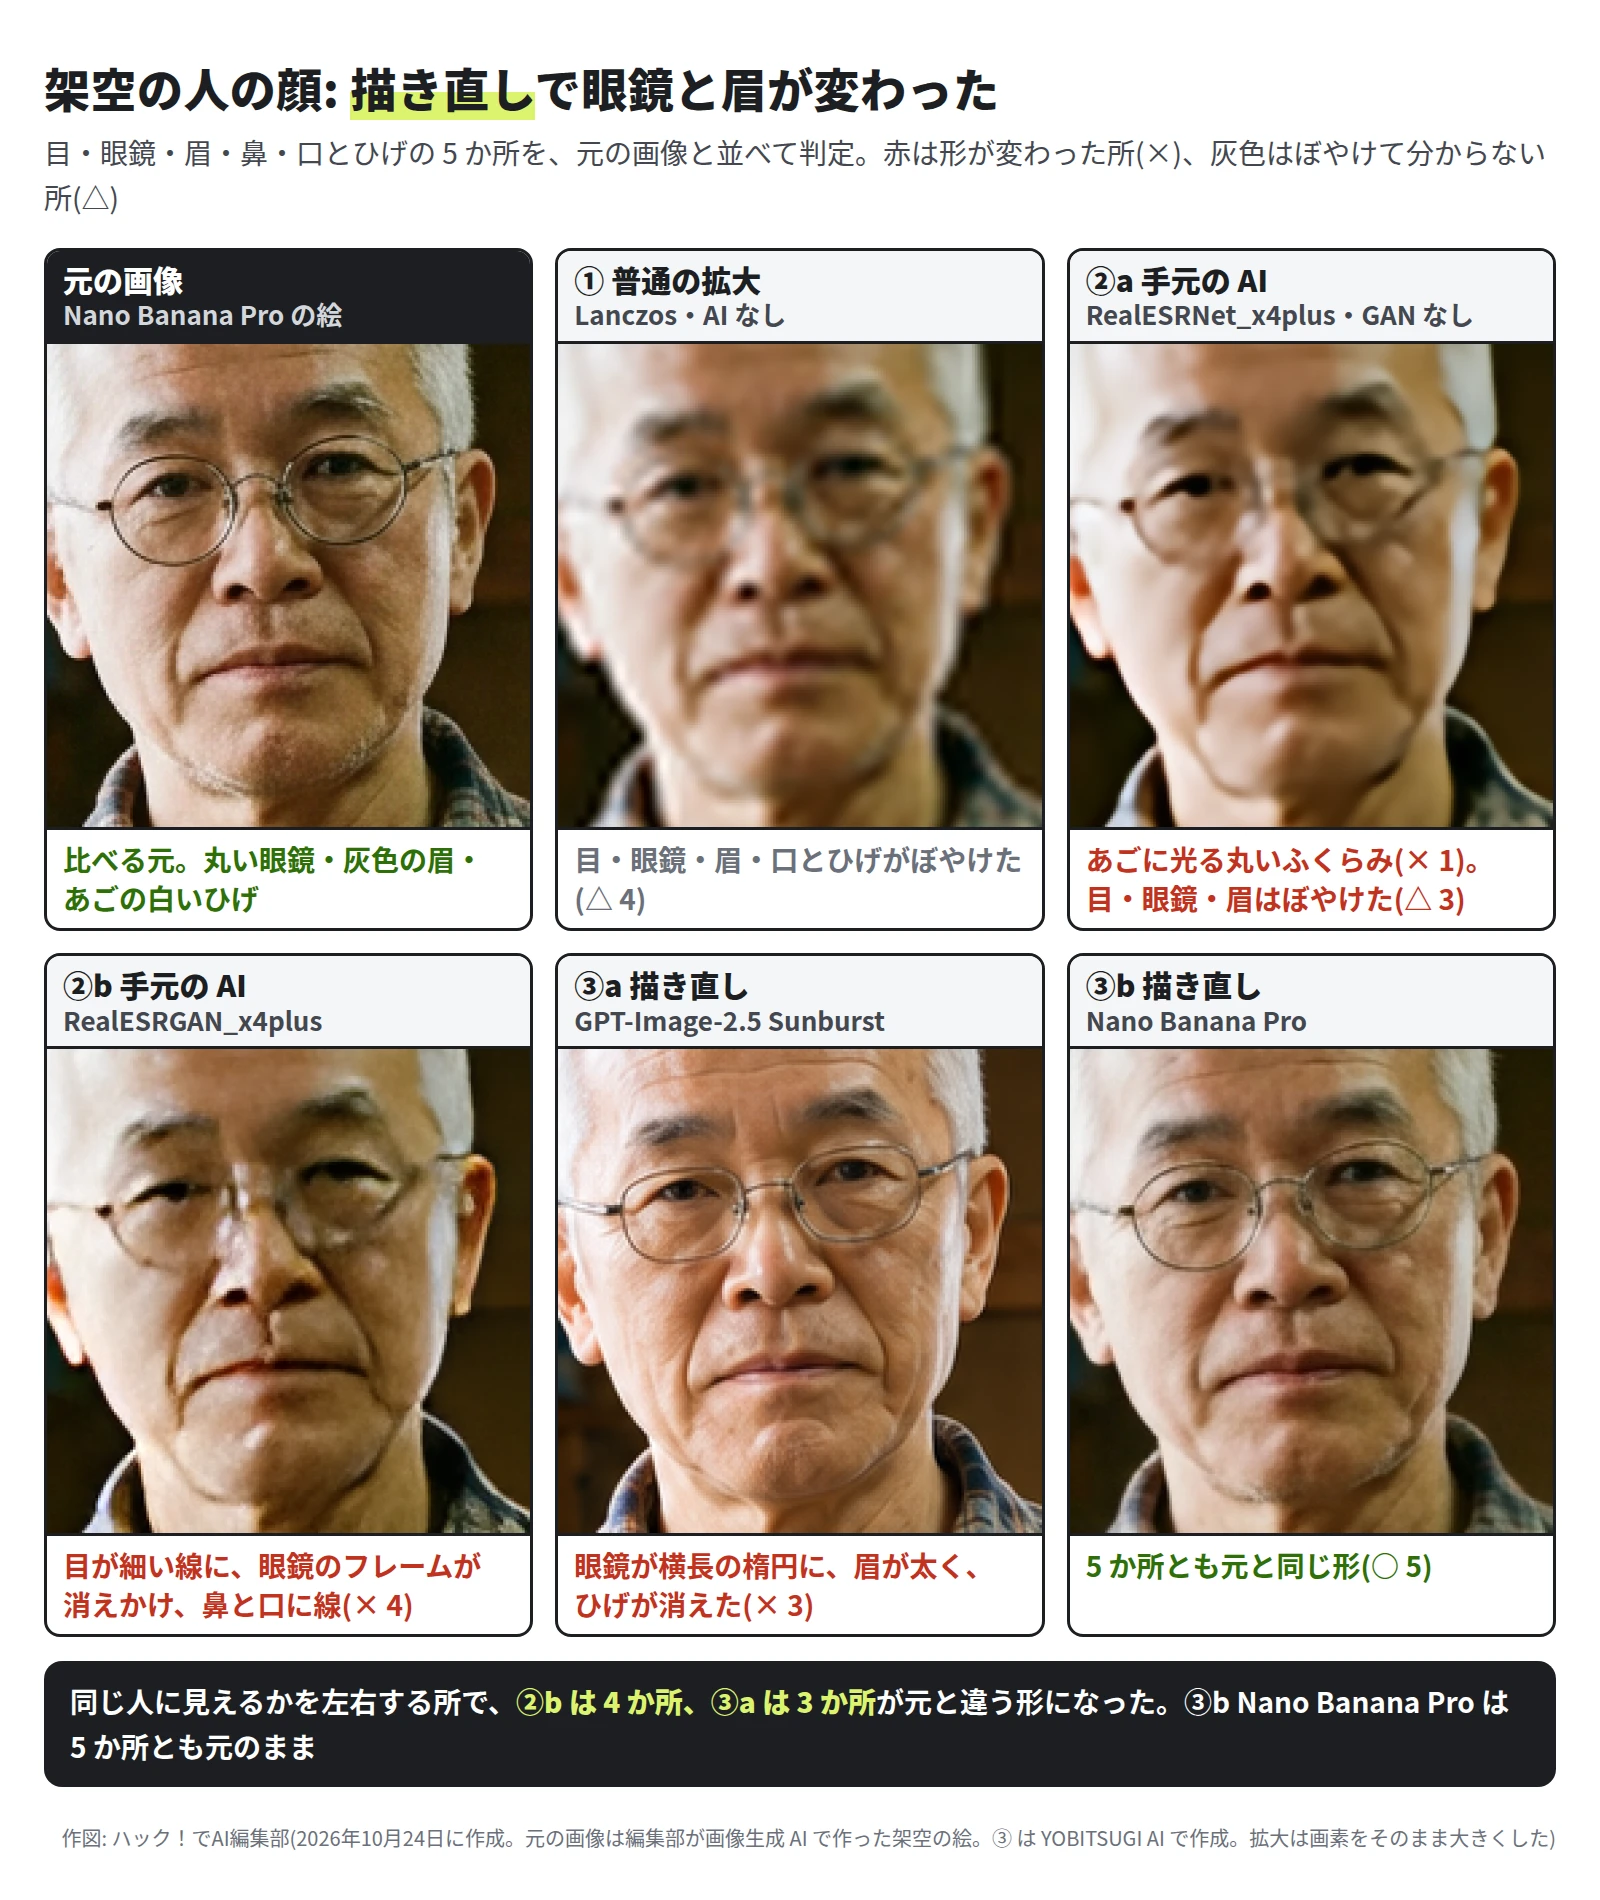
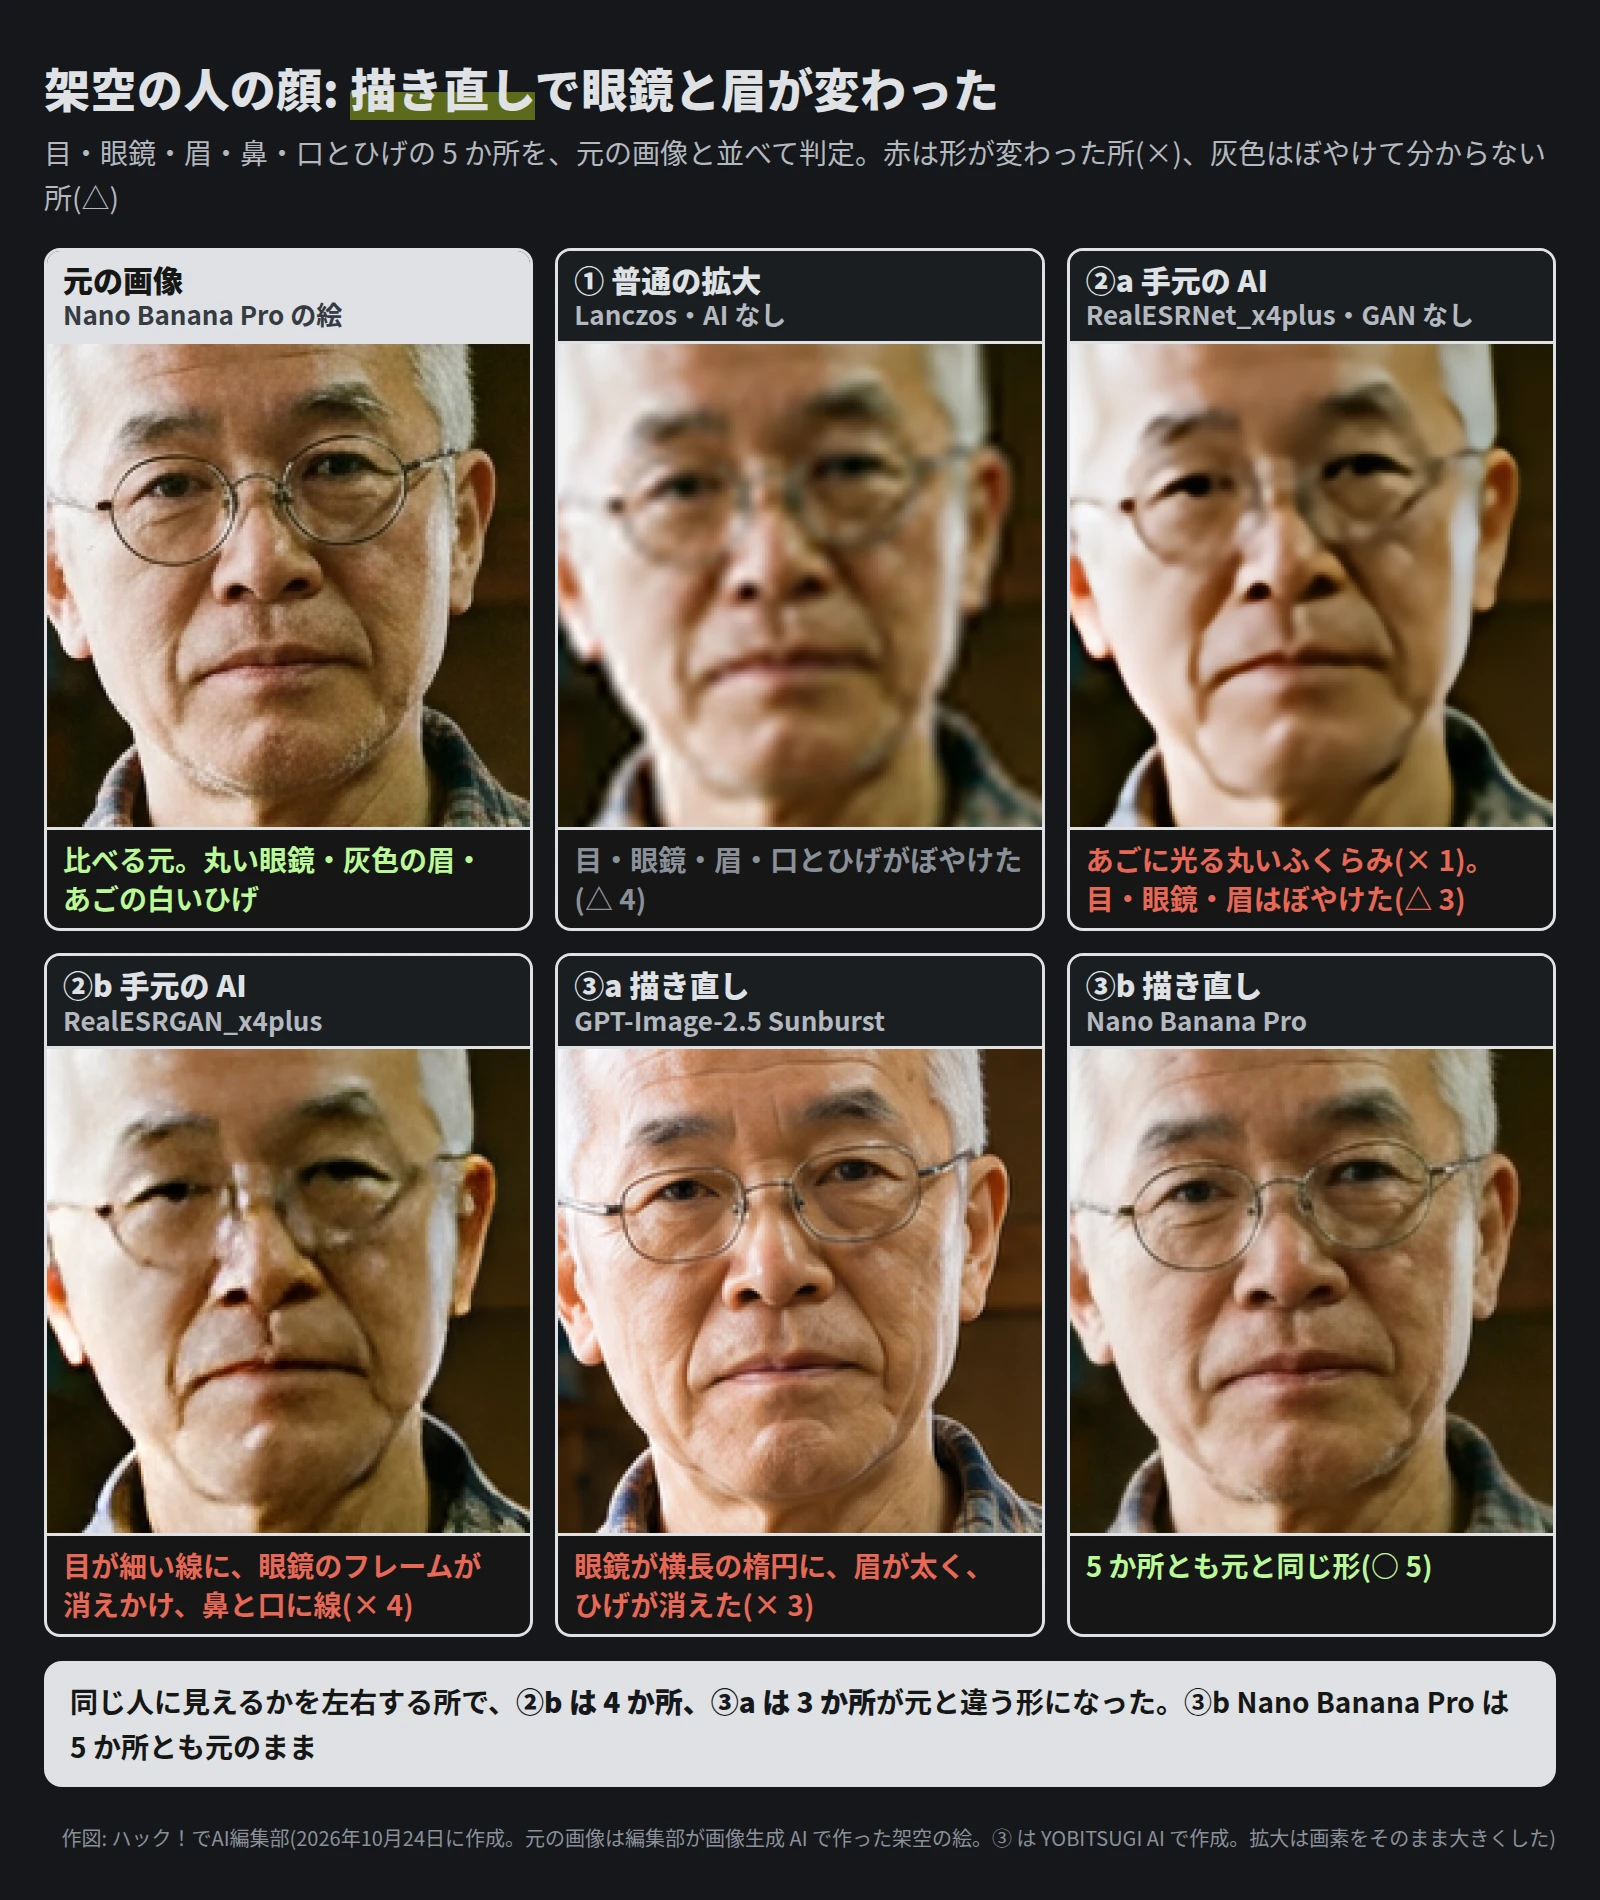
- ③a GPT-Image-2.5 Sunburst は、肌のしわまでくっきり描きましたが、丸い眼鏡が横長の楕円に、灰色の眉が太く濃くなり、あごのひげが消えました。顔の 5 か所(目・眼鏡・眉・鼻・口とひげ)のうち 3 か所が × です。
- ②b RealESRGAN_x4plus は、目が細い線になり、眼鏡のフレームが消えかけ、鼻から口へ線が入り、あごのひげも消えました(× 4)。
- ③b Nano Banana Pro は、5 か所とも元と同じ形でした。
アニメ調: Real-ESRGAN は目と歯の形を変えた
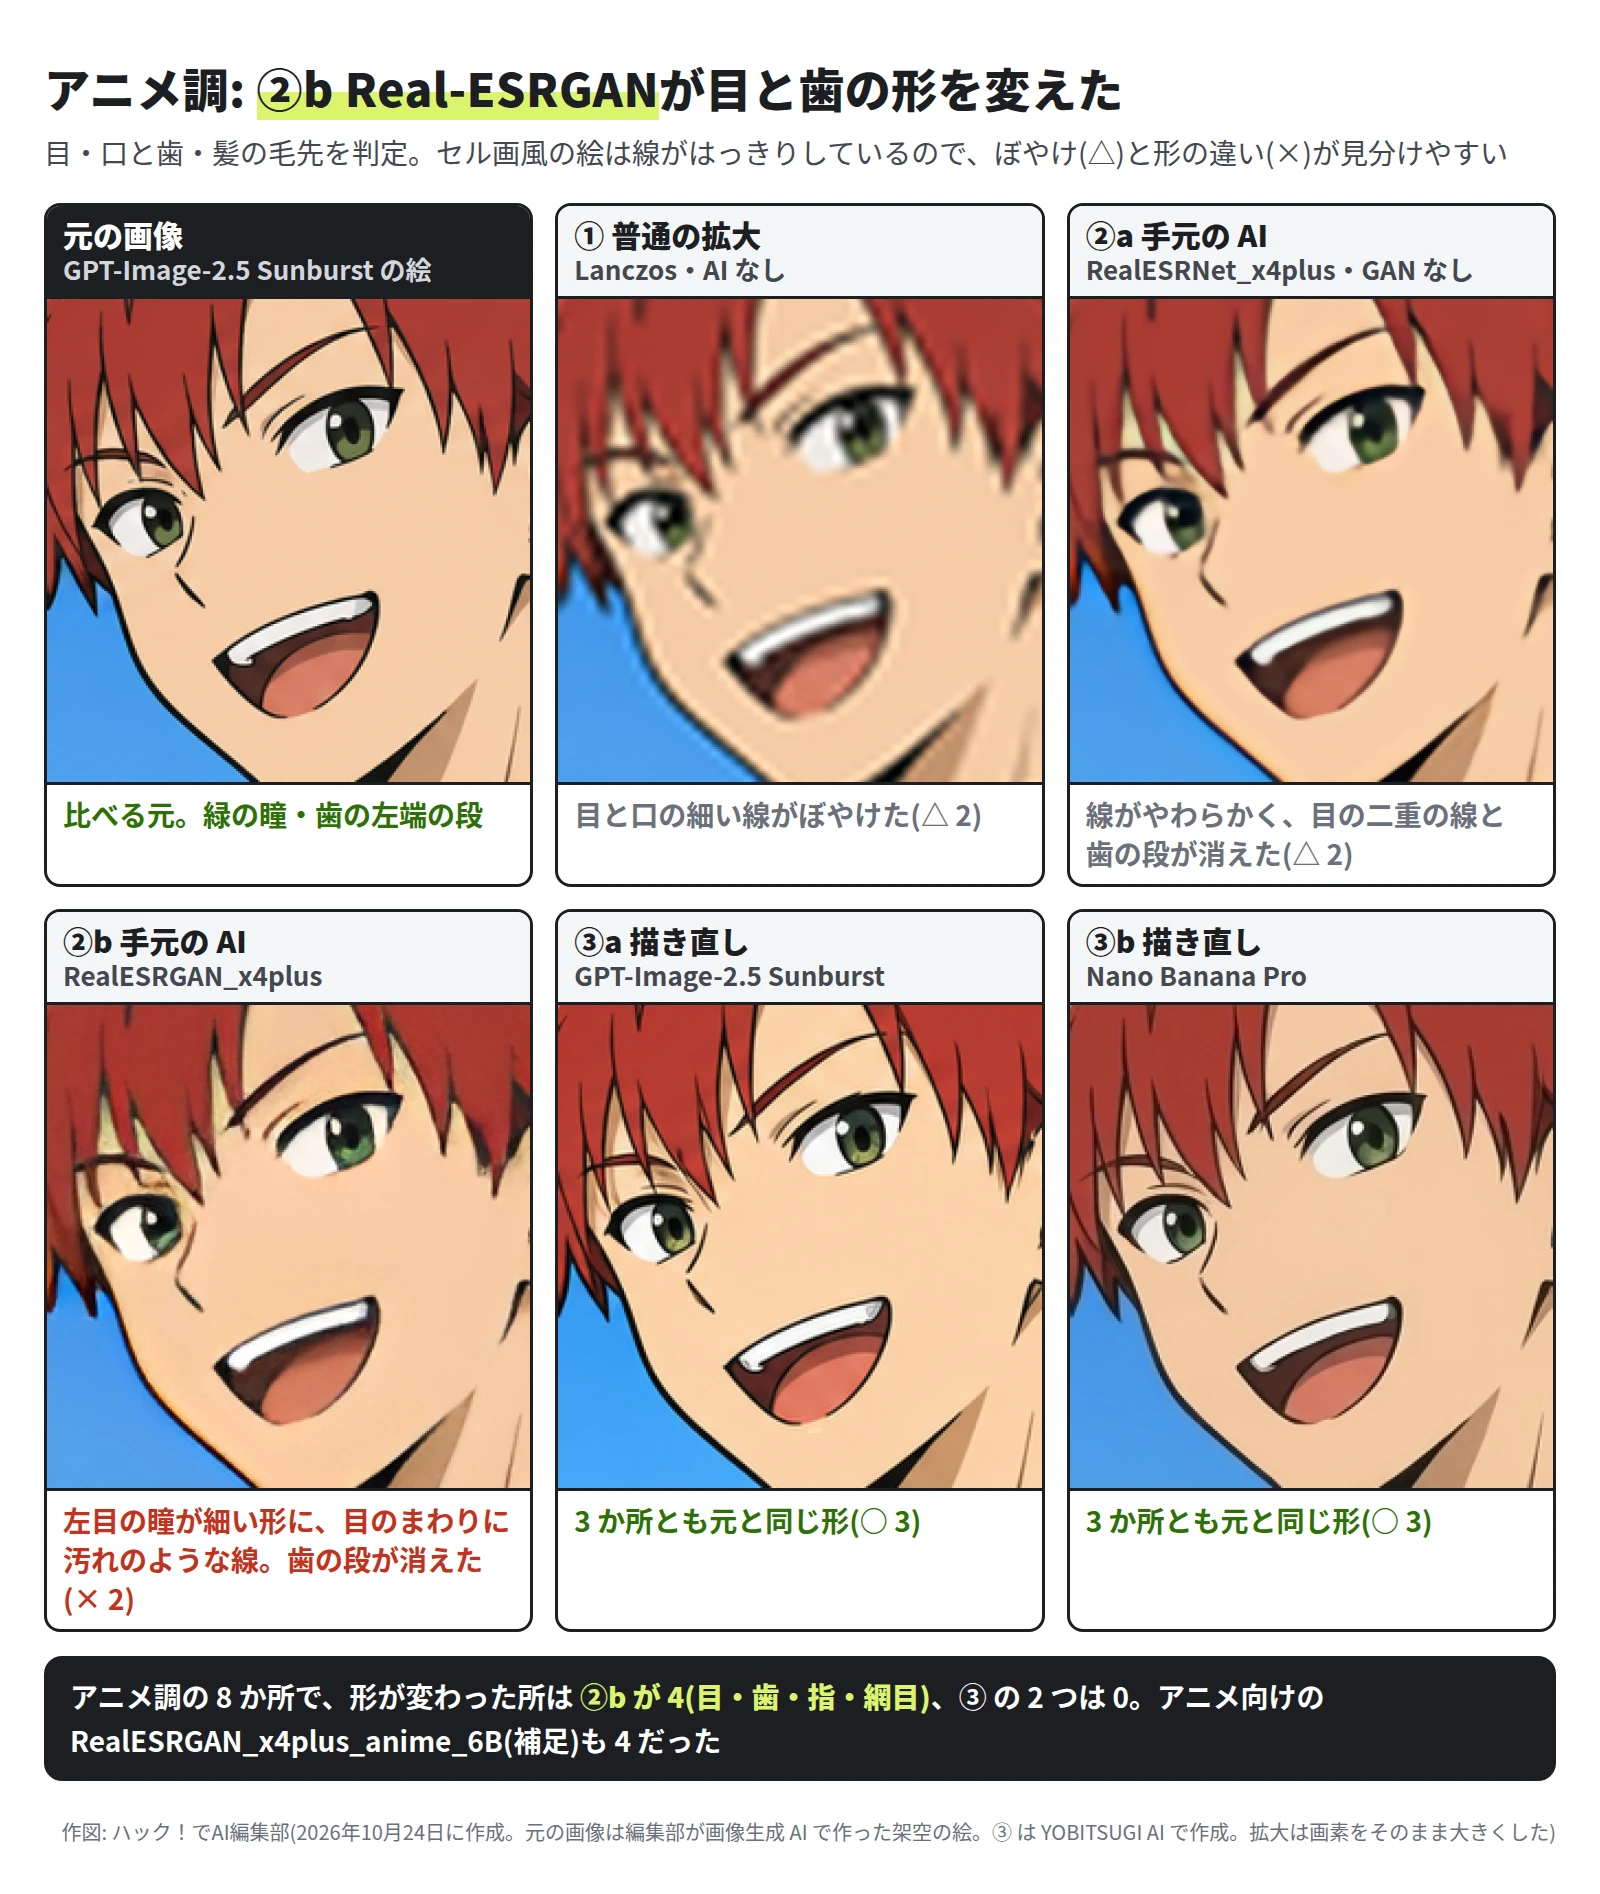
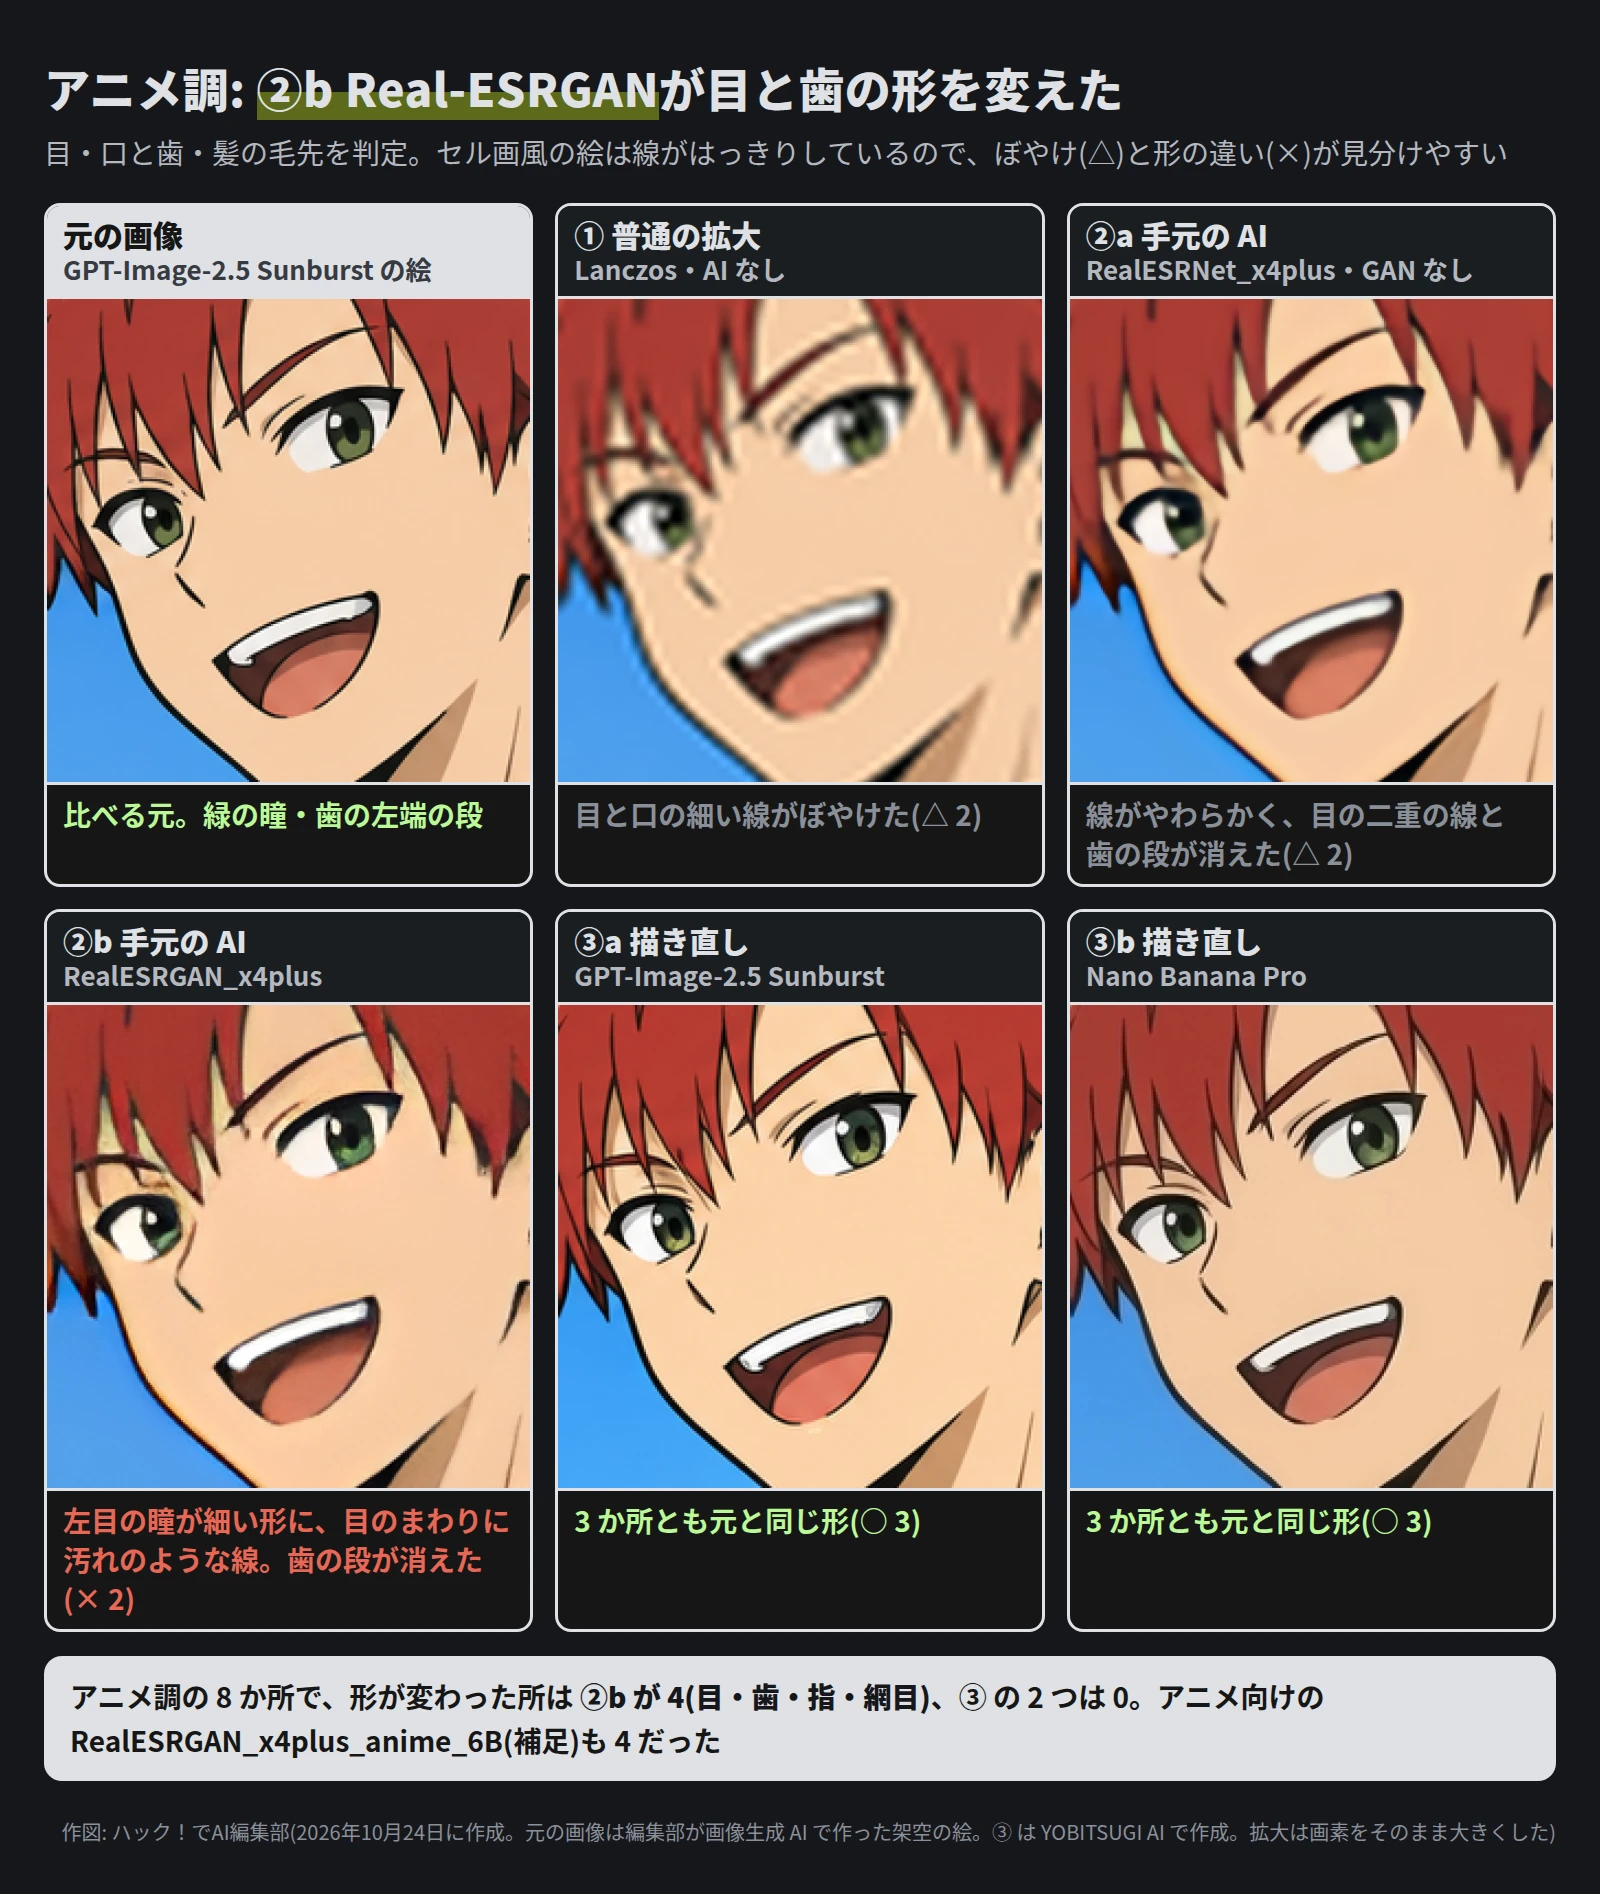
- セル画風の絵は線がはっきりしているので、ぼやけと形の違いが見分けやすい題材です。
- ②b は 8 か所中 4 か所(目・歯・指・フェンスの網目)が × でした。③ の 2 つは × が 0 です。
- 補足として、アニメ向けの RealESRGAN_x4plus_anime_6B も試しました(名前を伏せずに判定)。線はなめらかになりましたが、同じく 8 か所中 4 か所が × でした。
日本語の字: 描き直しは 39 字とも正しかった
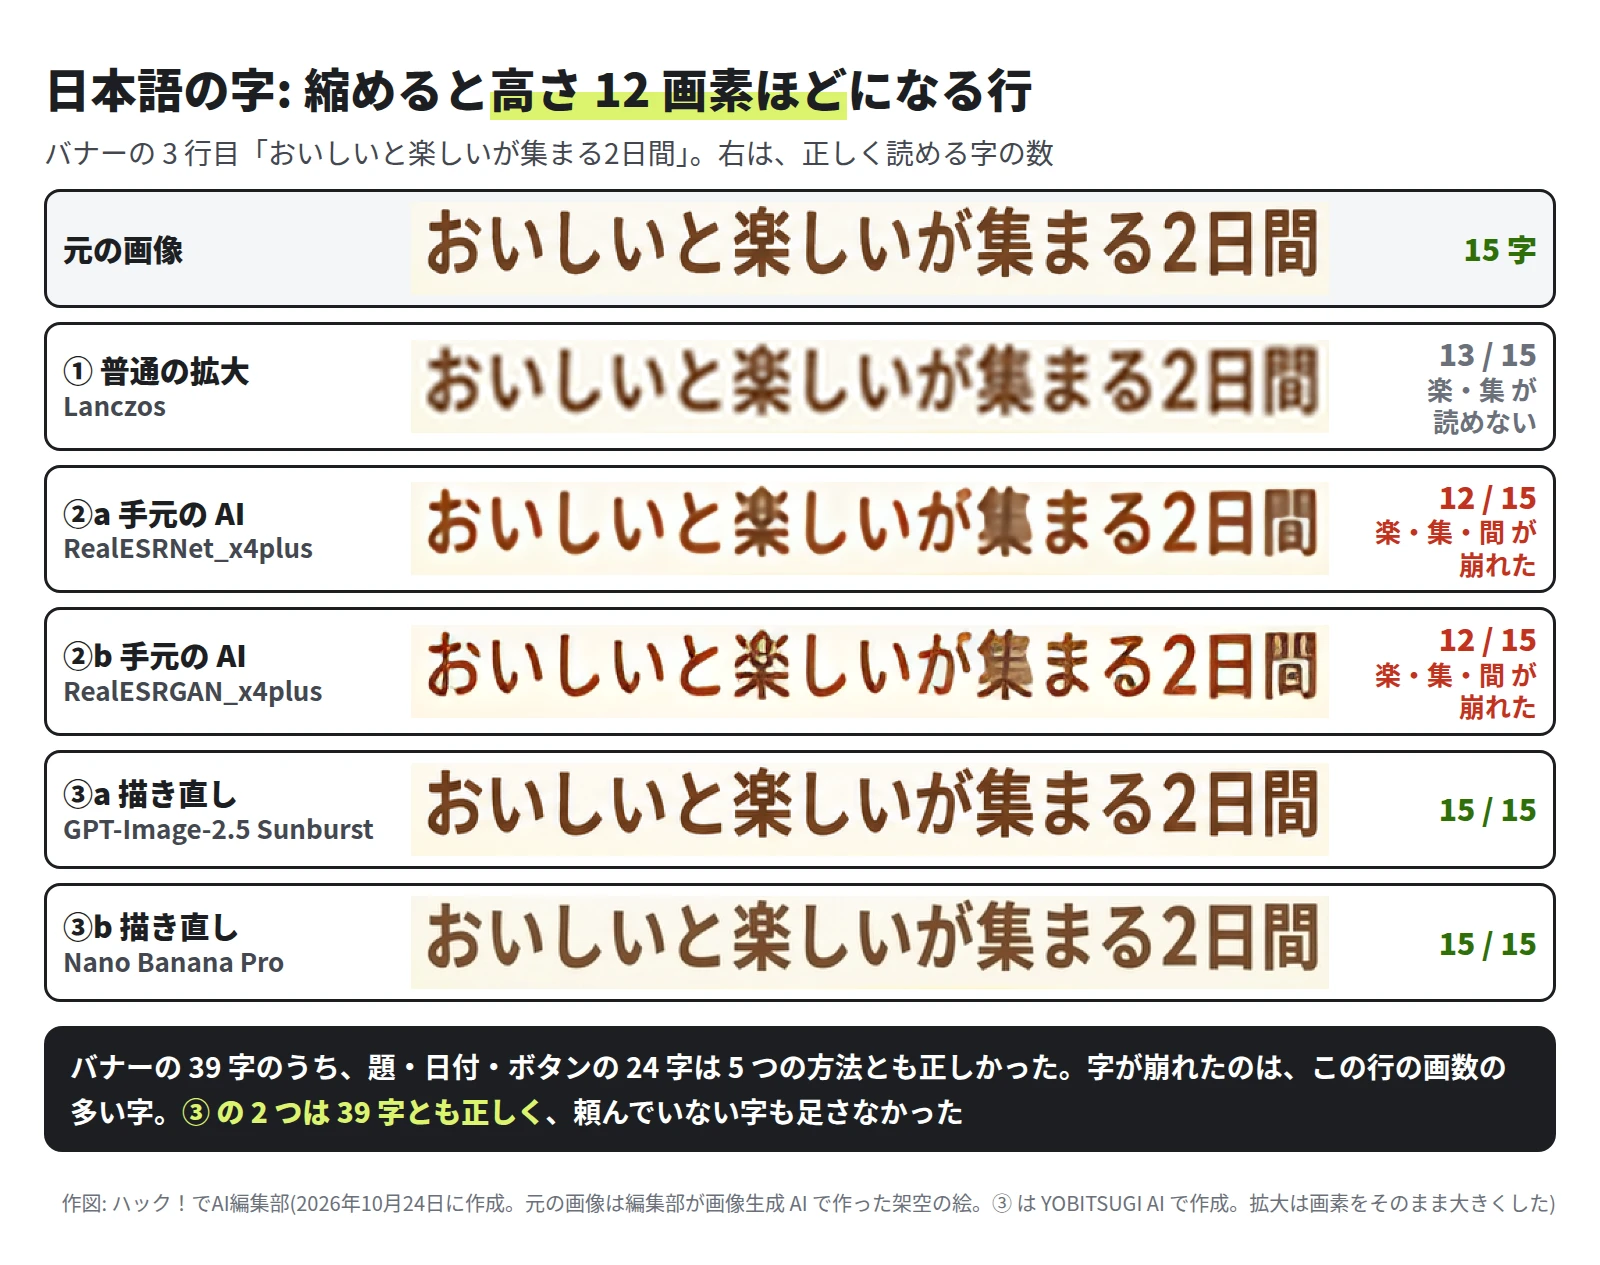
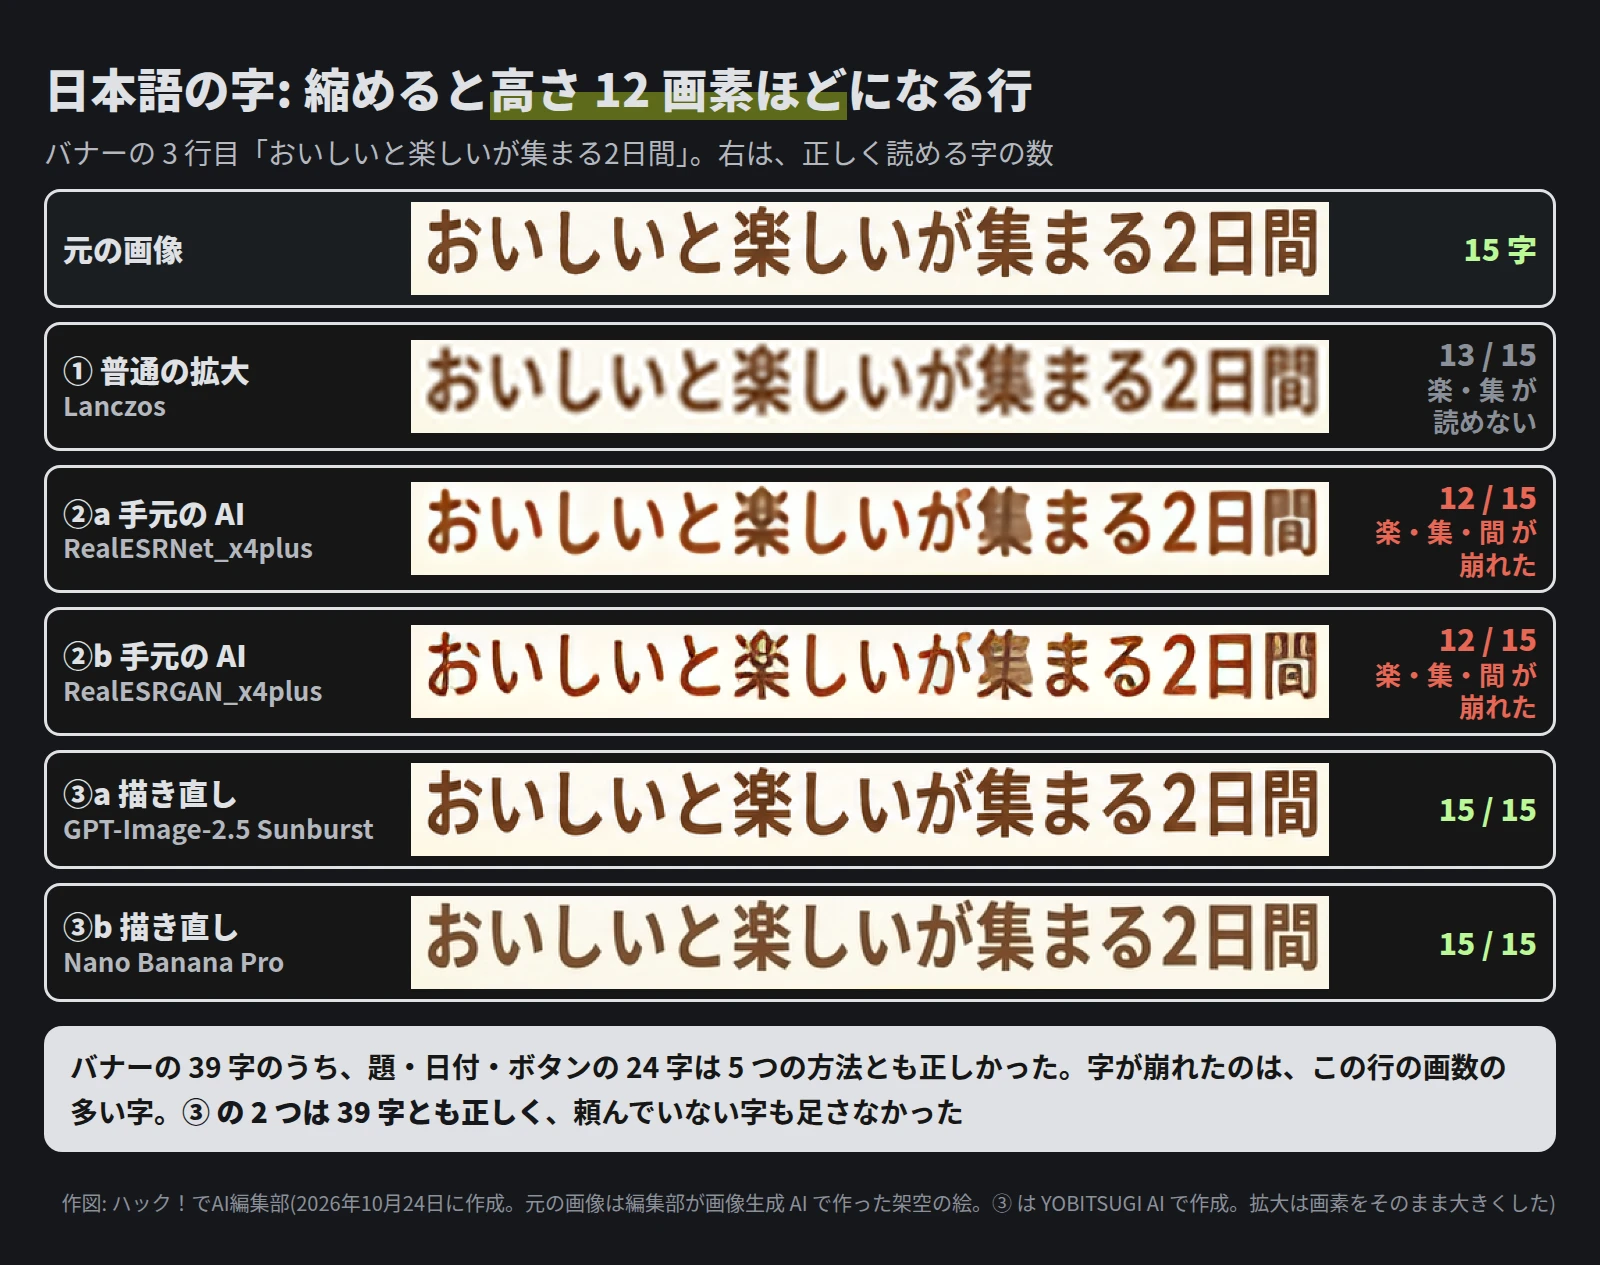
- 題「かざみ丘マルシェ」・日付・ボタンの 24 字は、5 つの方法とも正しく読めました。崩れたのは、縮めると高さ 12 画素ほどになる 3 行目の、画数の多い字です。
- ②a と ②b は、「楽」「集」の中を黒い塊やまだらで埋め、「間」の中の線も崩しました。
- ③ の 2 つは 39 字とも正しく、頼んでいない字も足しませんでした。
小さな顔: 描き直すと閉じた目が開いた
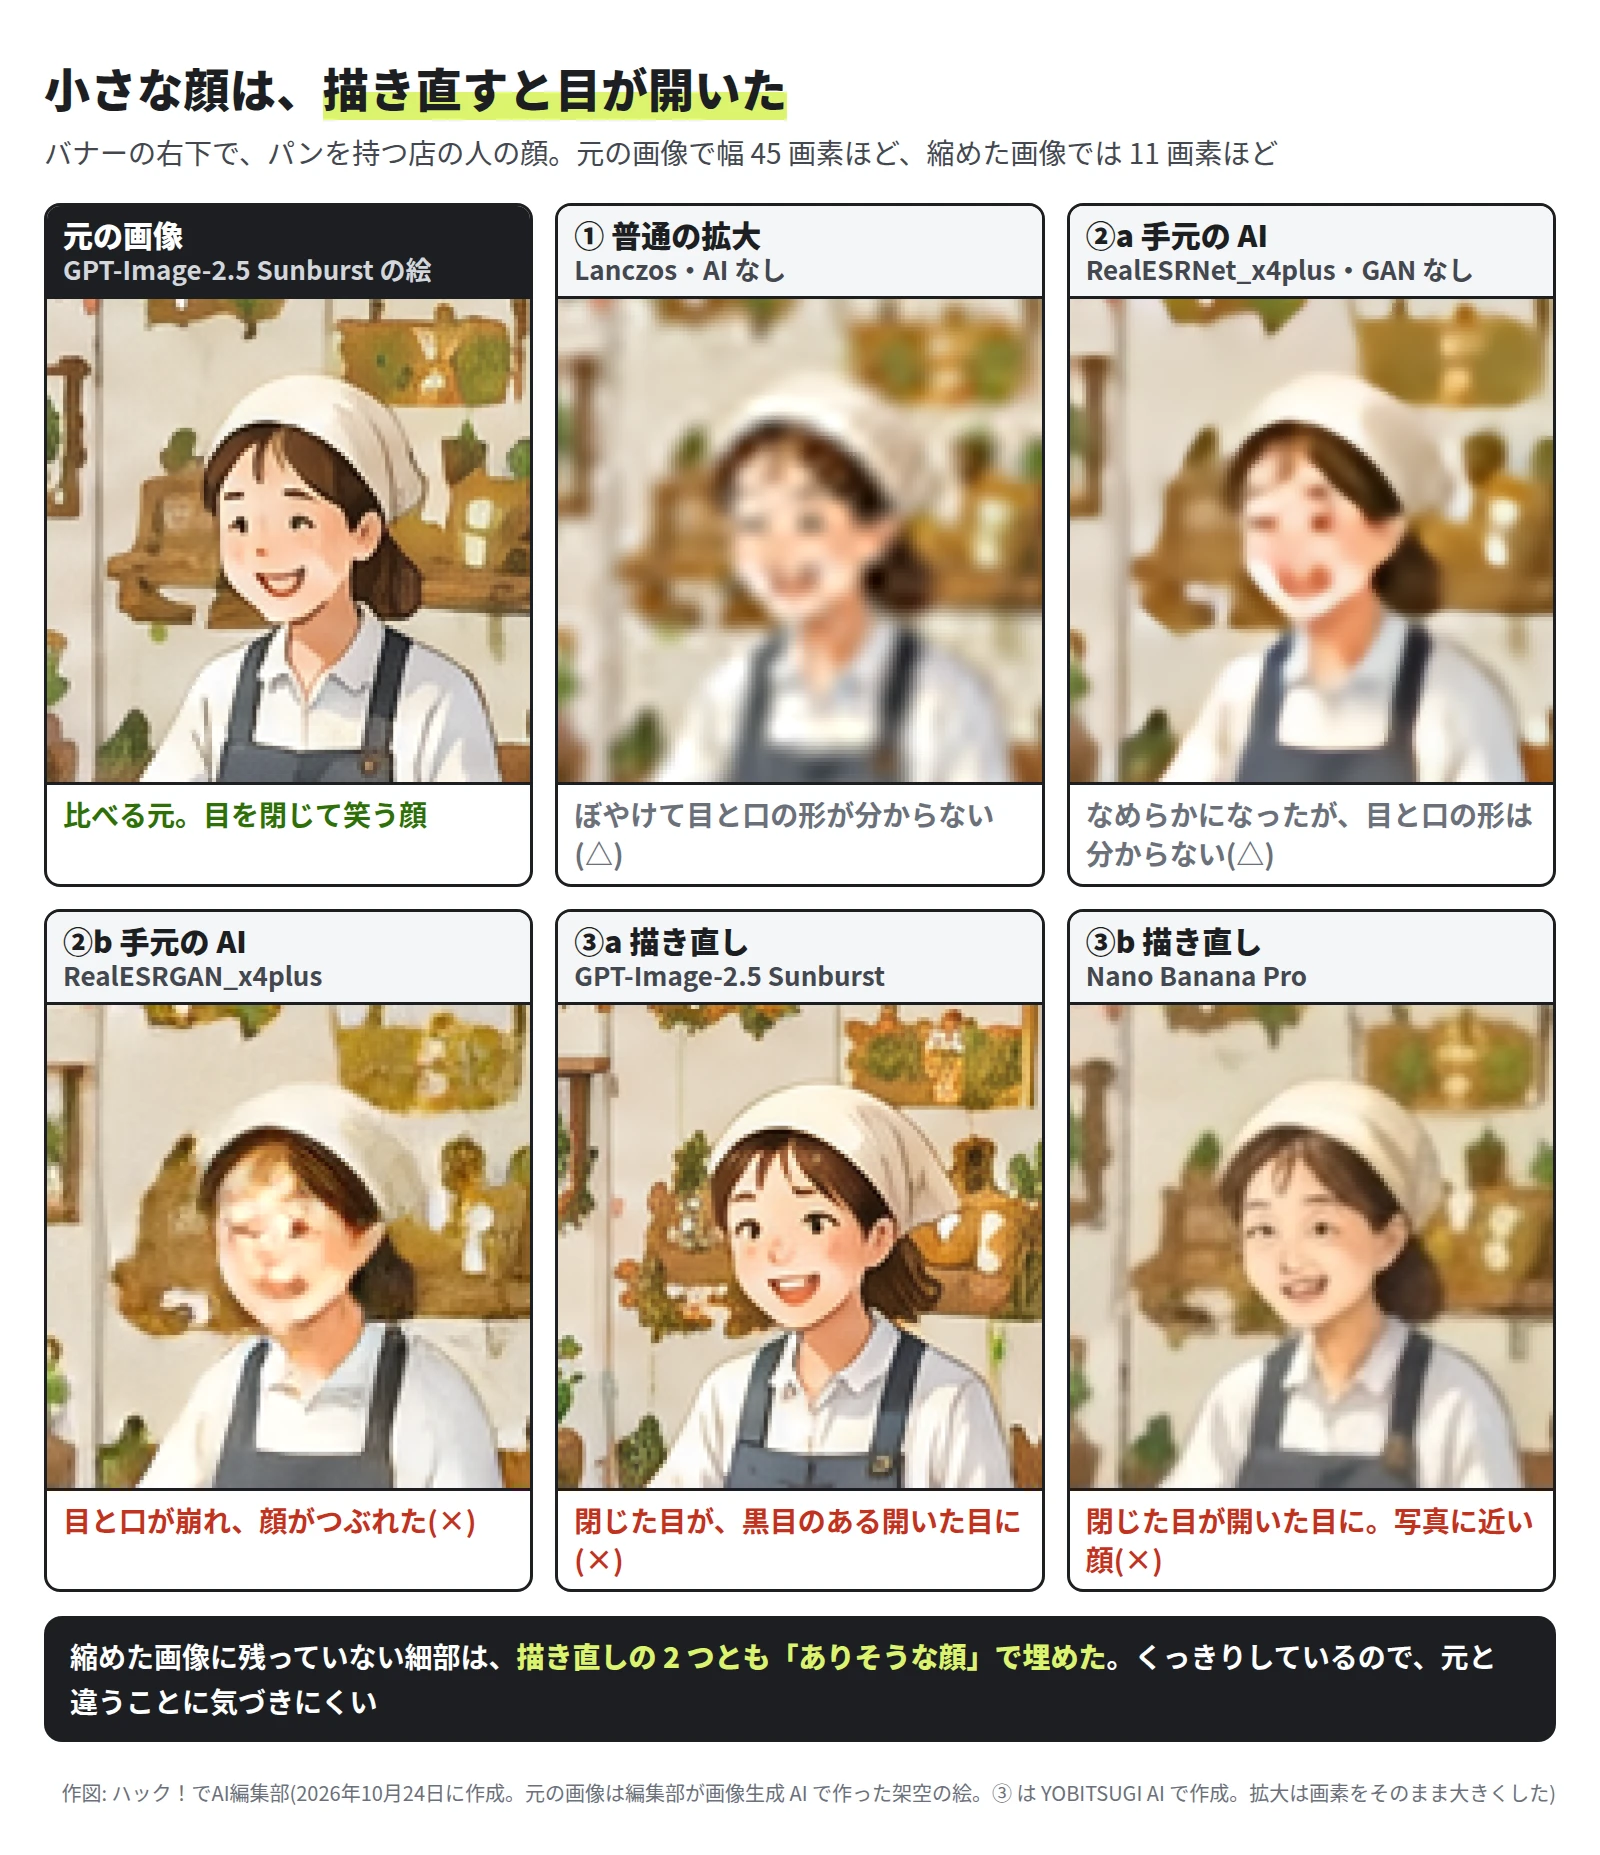
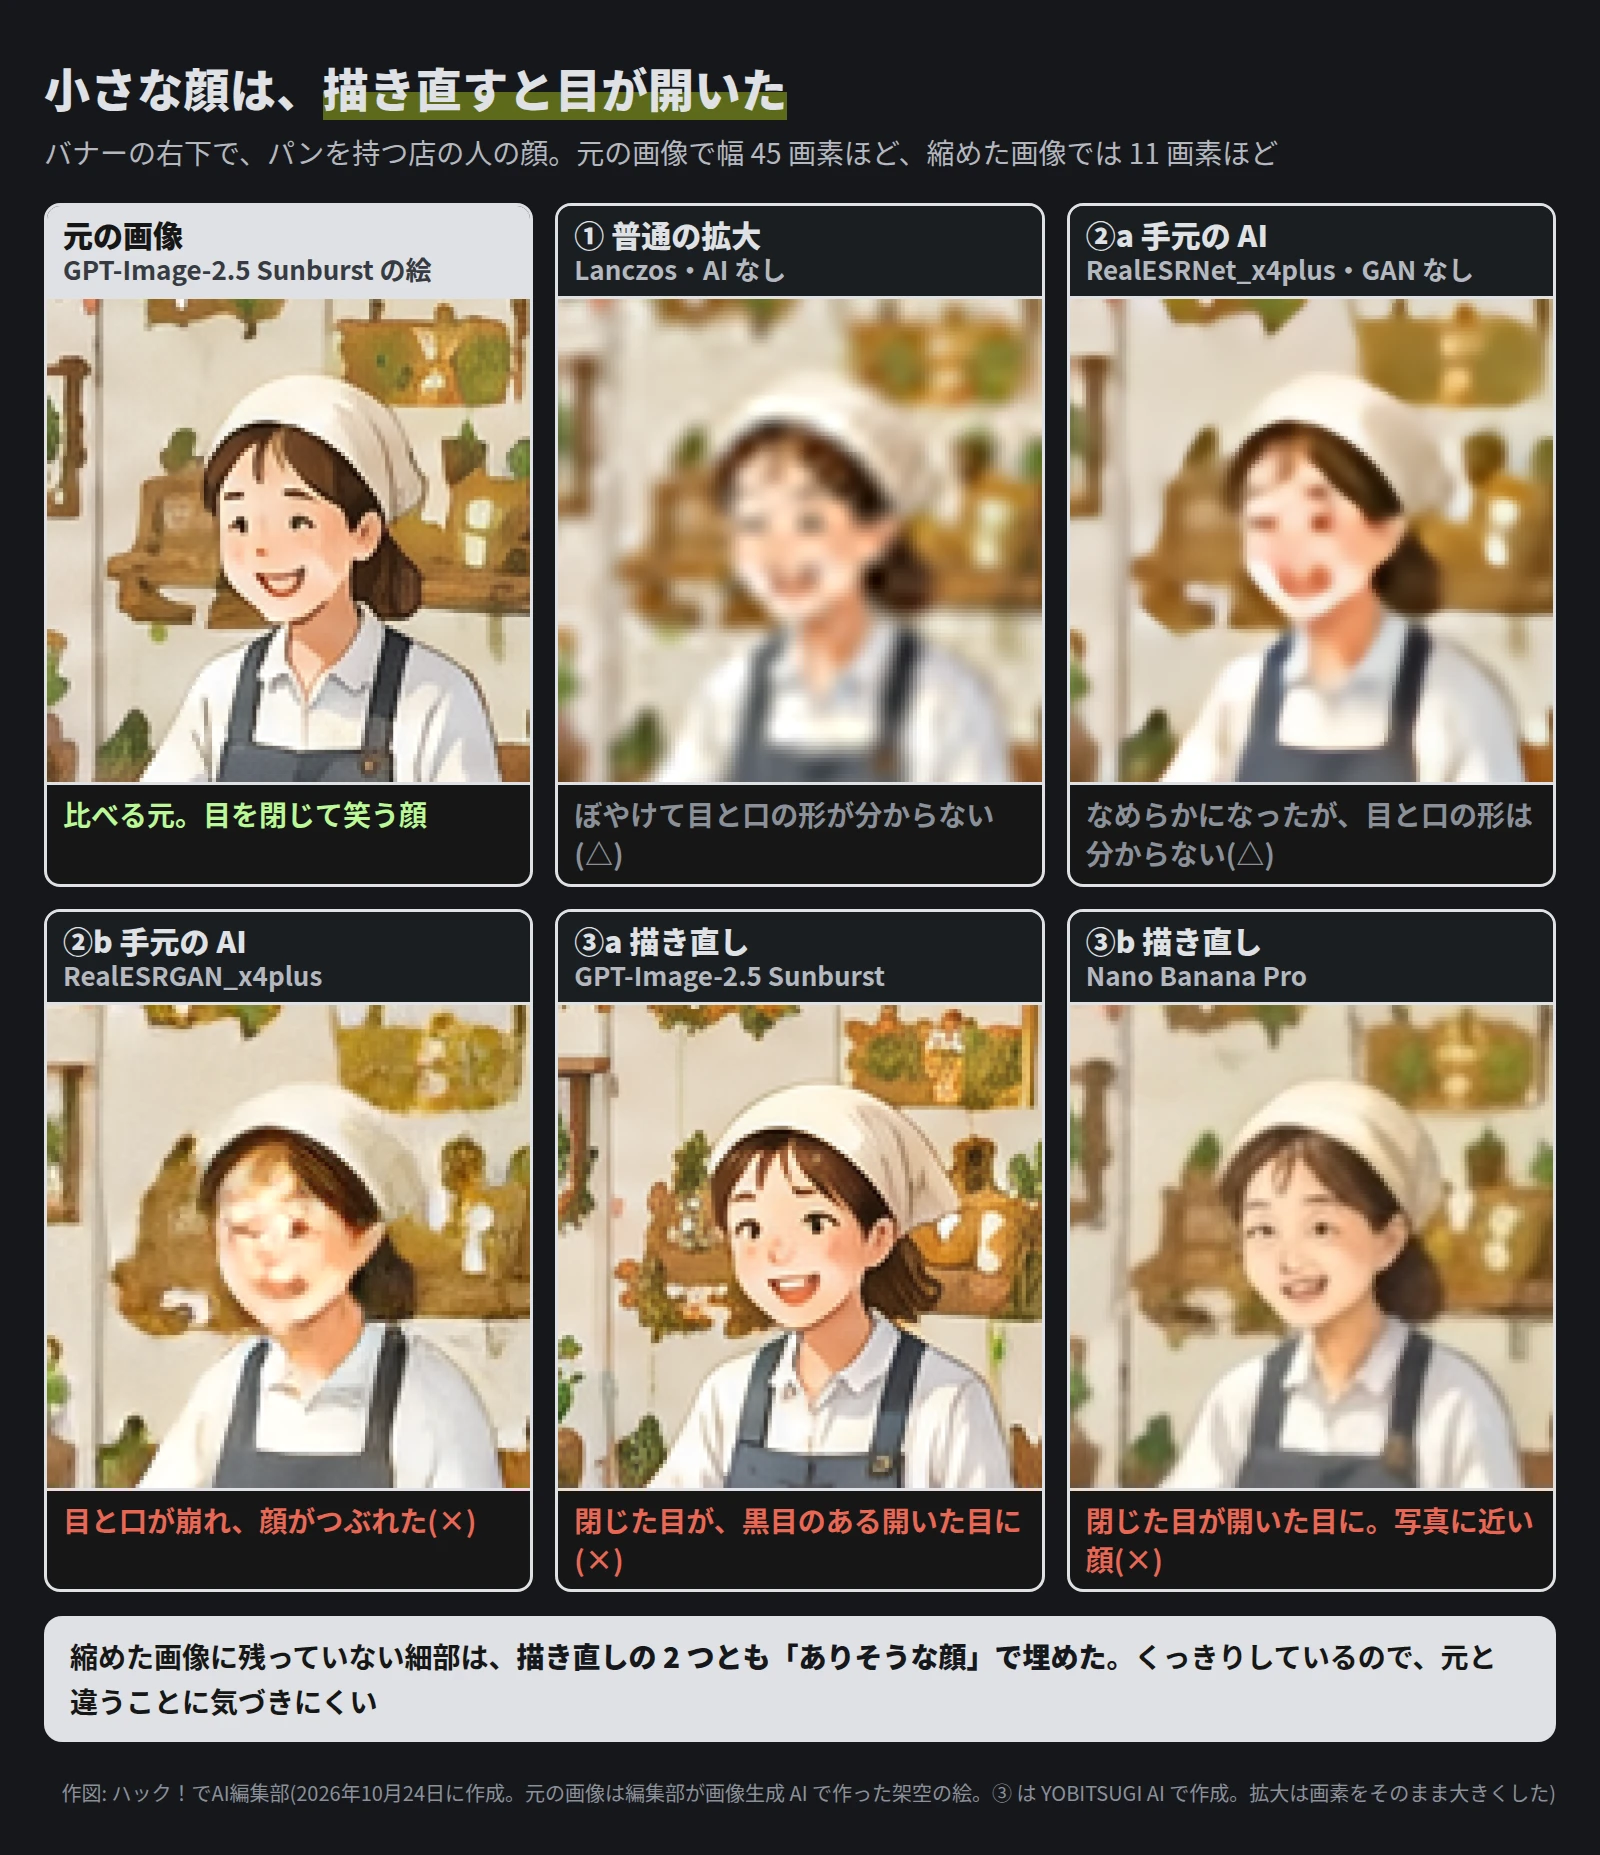
元の画像で幅 45 画素ほど、縮めた画像では 11 画素ほどの顔です。③ の 2 つは、どちらも閉じた目を開いた目に描きました。くっきりしているので、元を知らなければ違いに気づきにくくなります。
腕時計: GPT-Image-2.5 Sunburst は時計を 1.09 倍に描いた
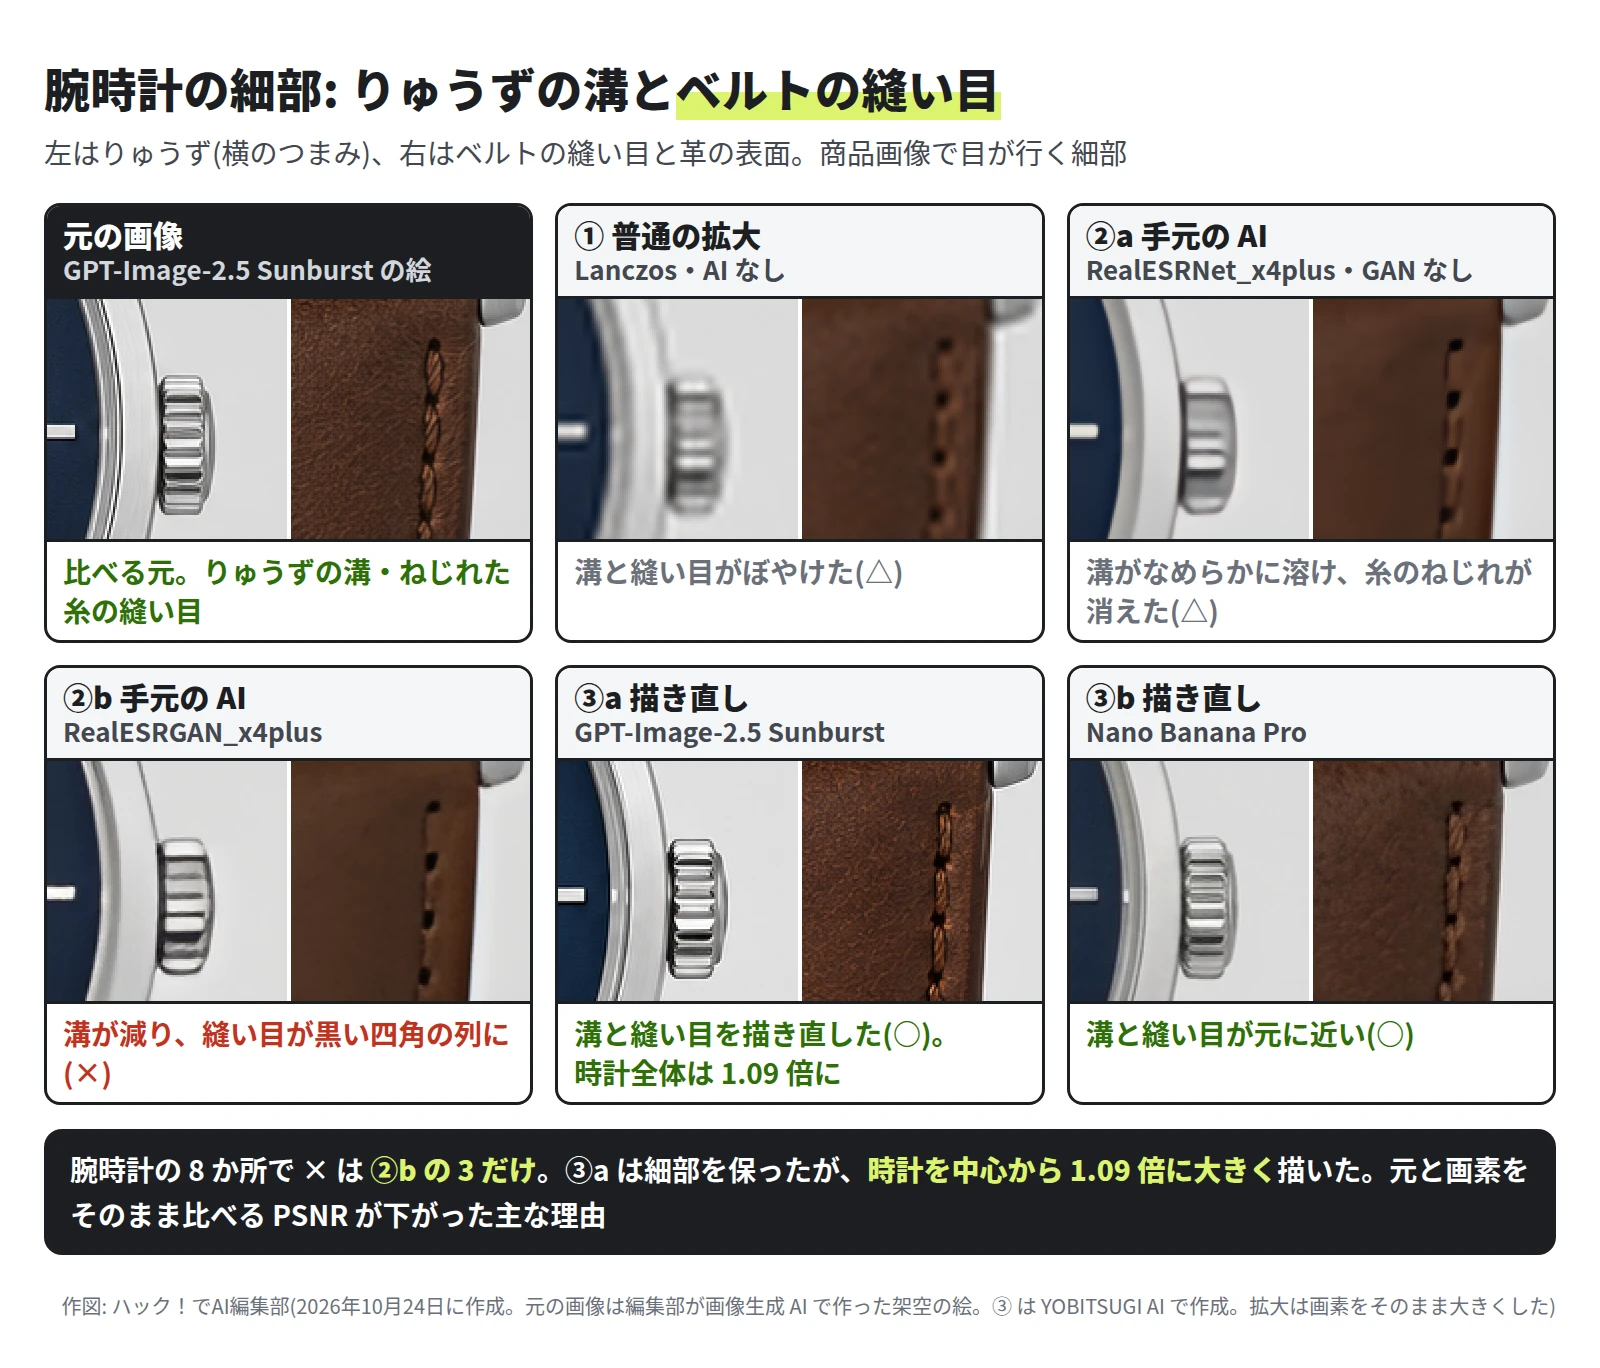
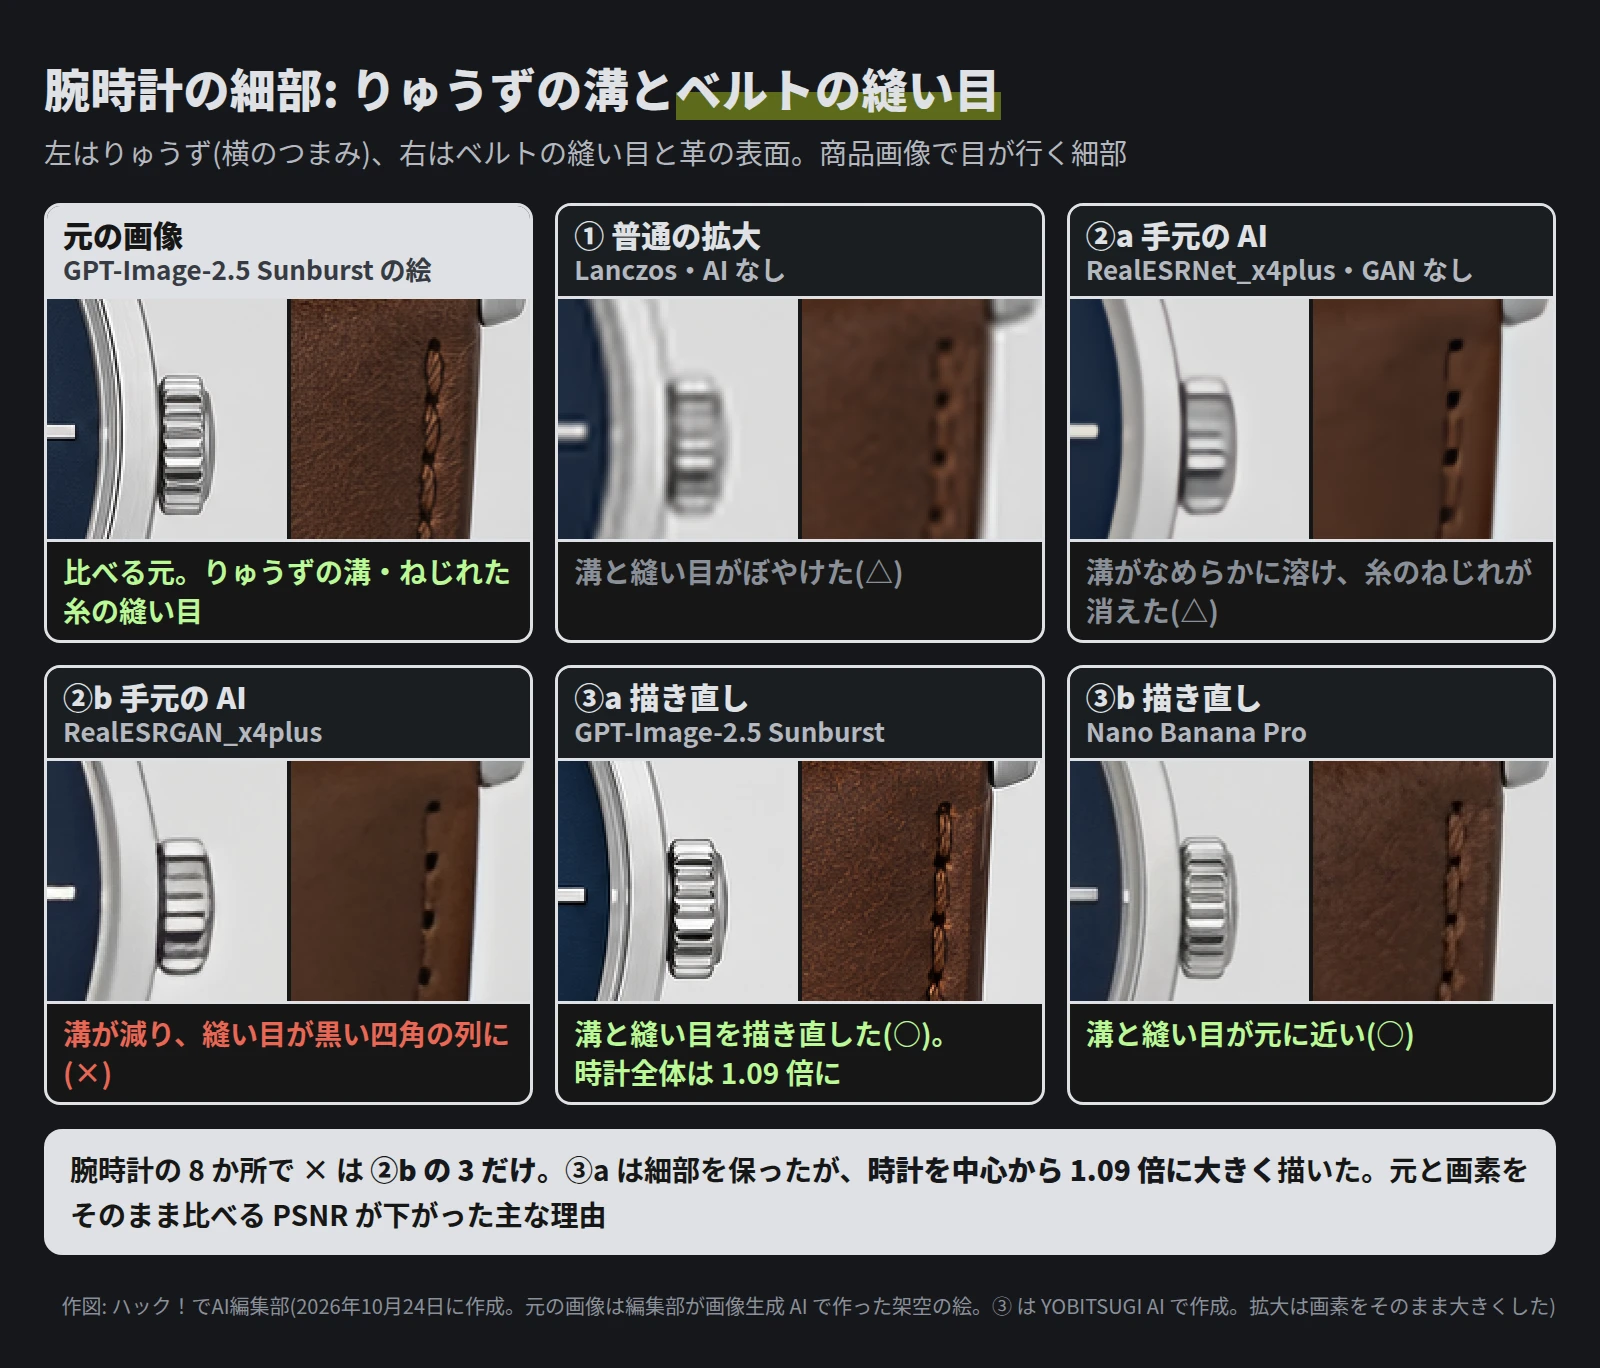
- 腕時計の 8 か所で × が付いたのは、②b の 3 か所(針の軸・りゅうずの溝・縫い目)だけです。目盛り 12 本と、字の無い文字盤は、5 つの方法とも守りました。
- ③a は細部を保ちましたが、時計全体を 1.09 倍に大きく描きました。構図は文で「変えない」と頼んでいます。
細かい模様: 別の模様になるか、同じ種類で描き直すか
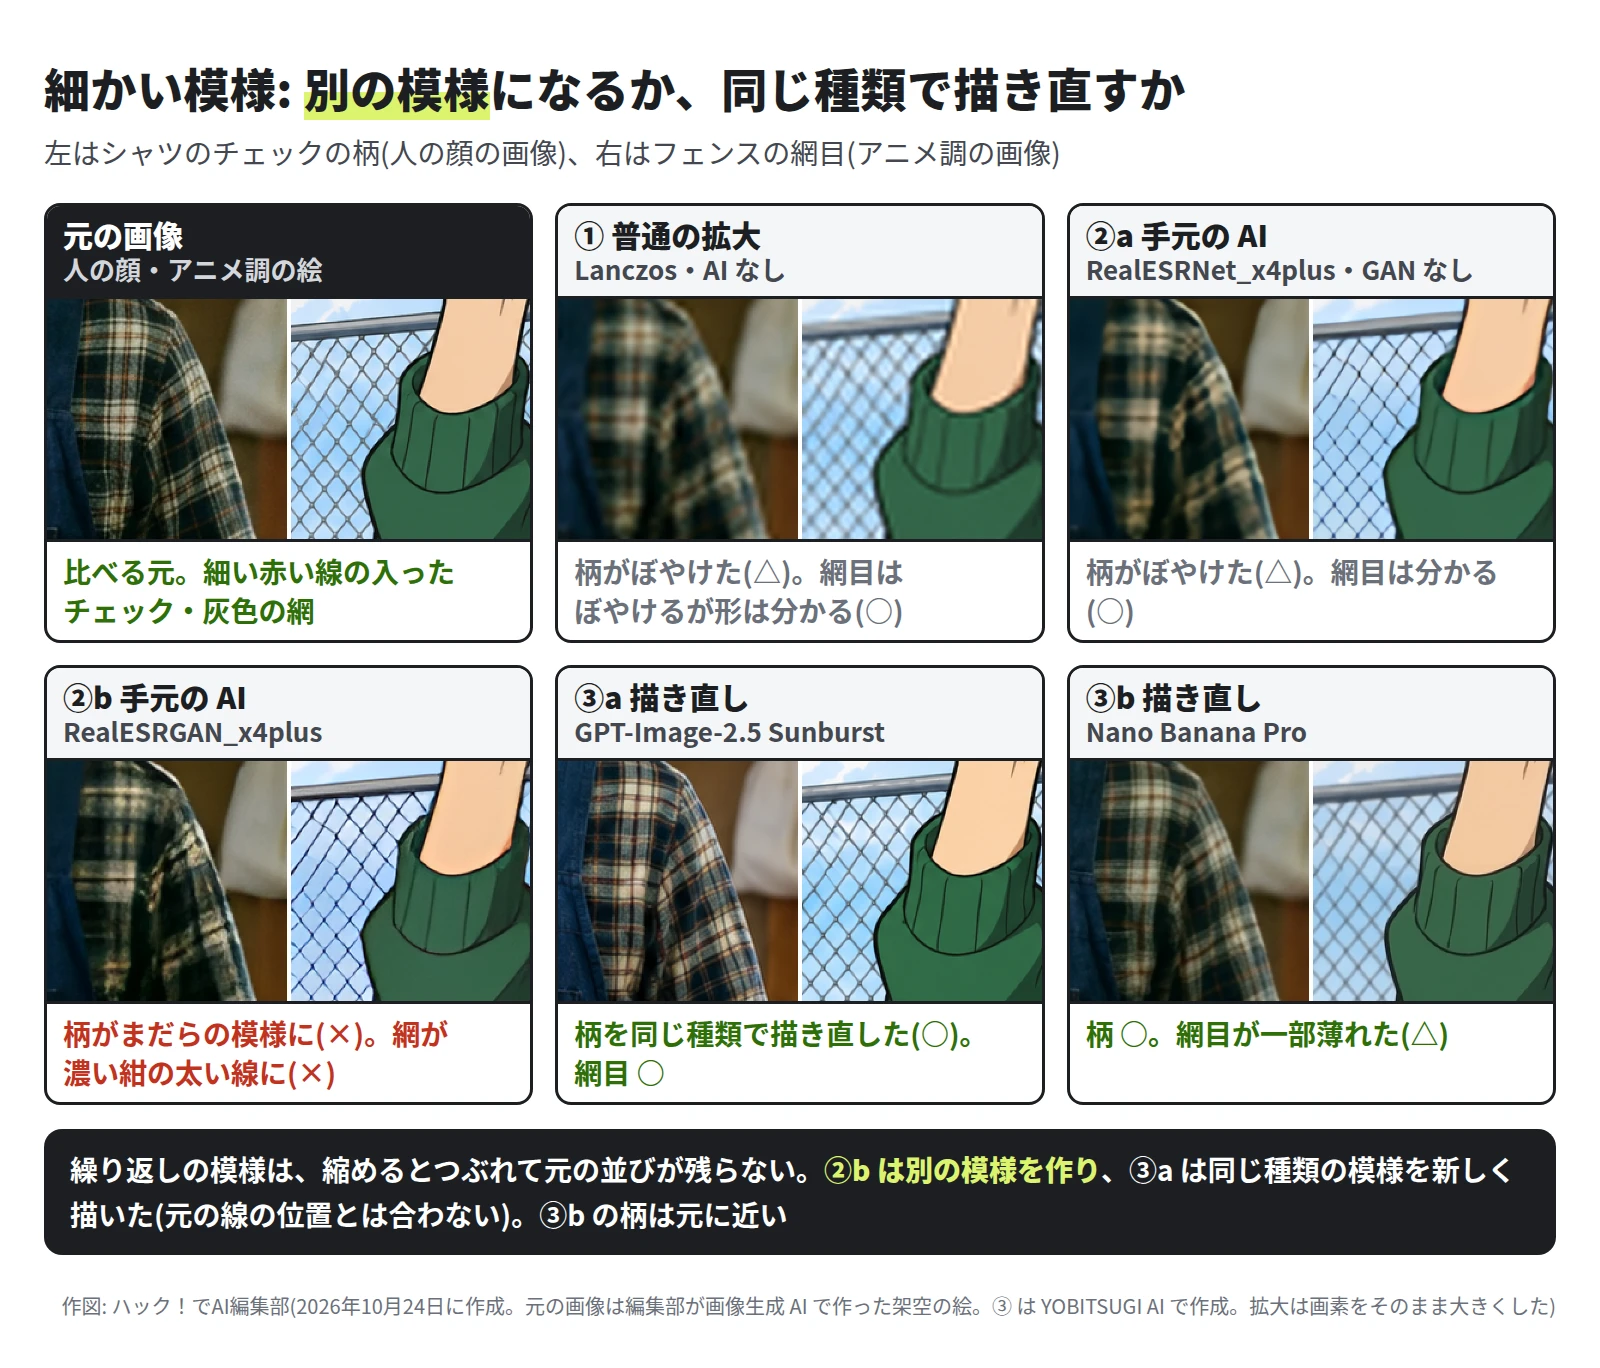
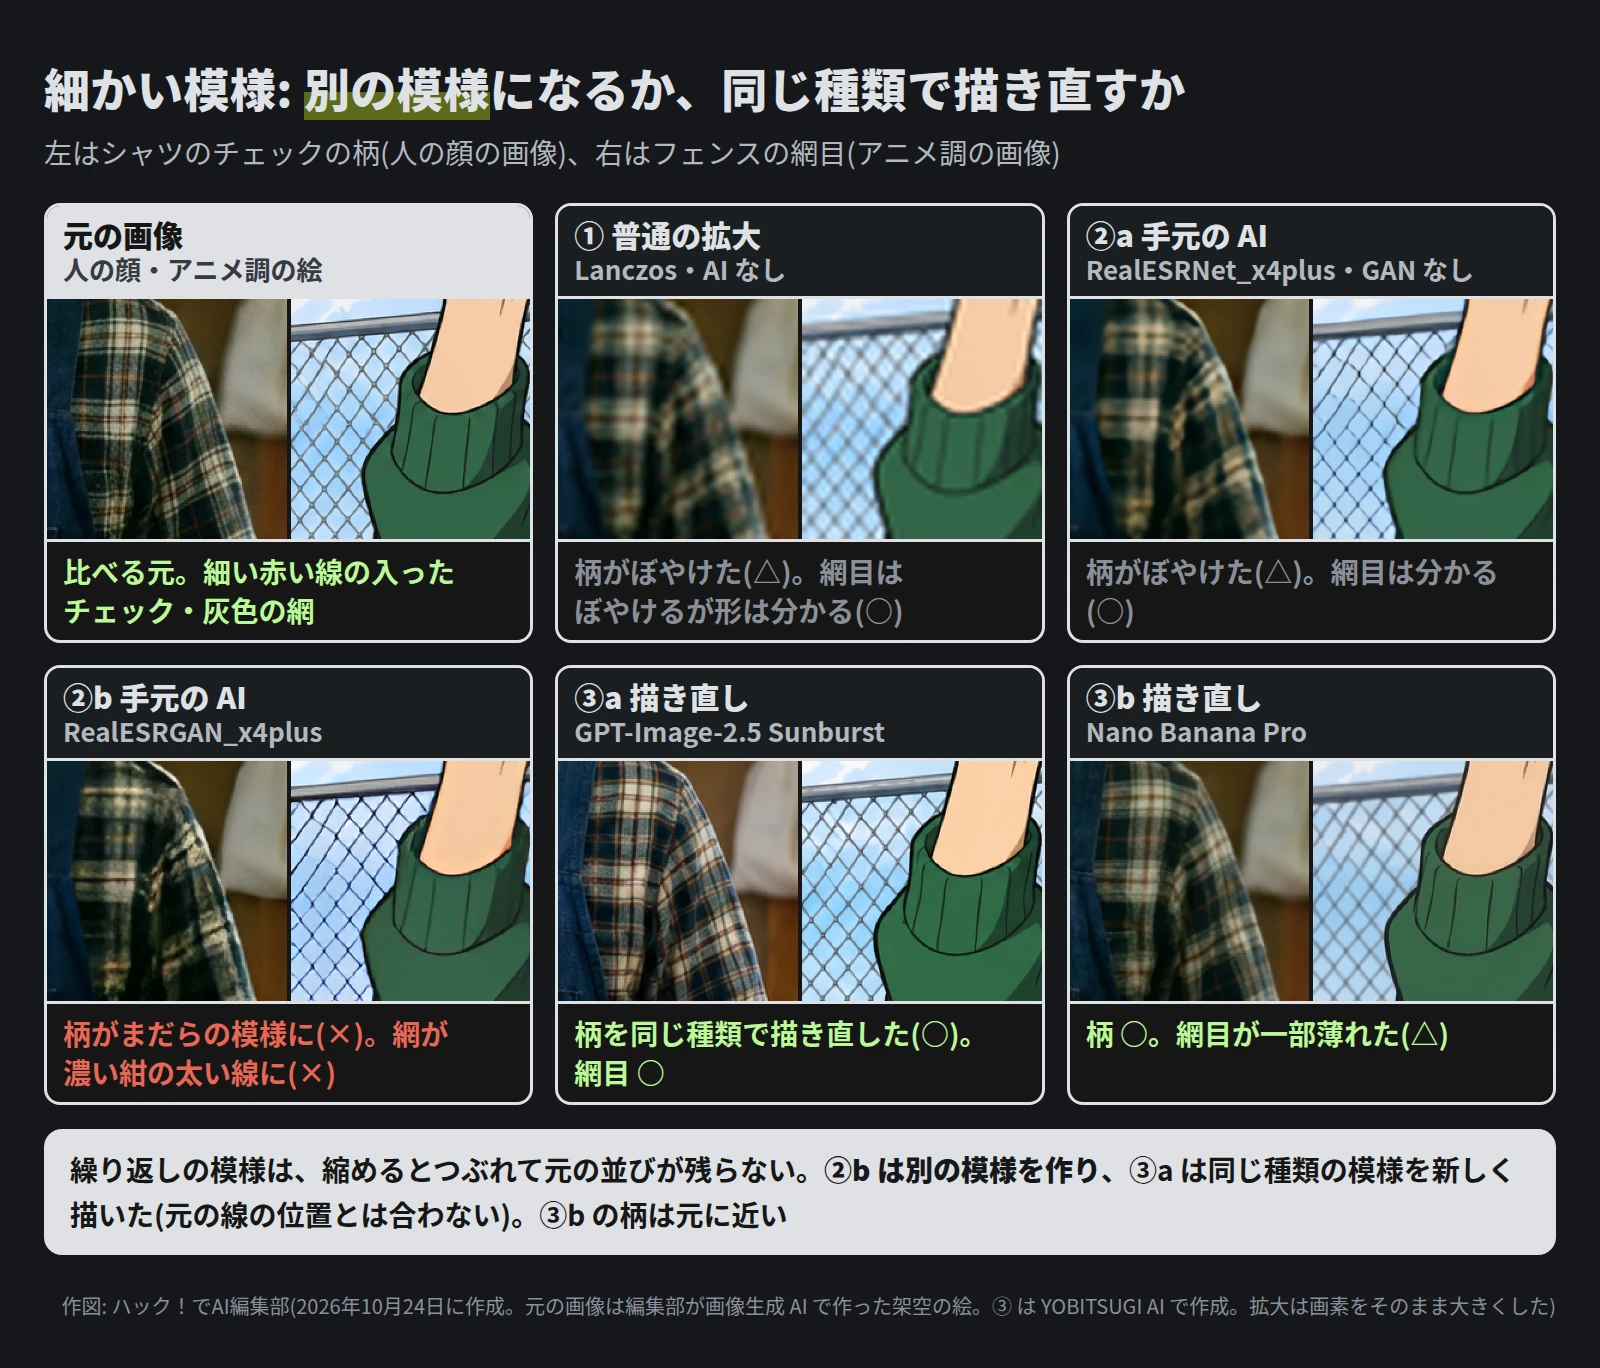
チェックや網目のような繰り返しの模様は、縮めるとつぶれて、元の線の並びが残りません。②b はそこに別の模様を作りました。③a は同じ種類の模様を新しく描きましたが、線の位置は元と合いません。③b のチェックは、元に近い並びでした。
近さの数は、くっきり見えるかと一致しない
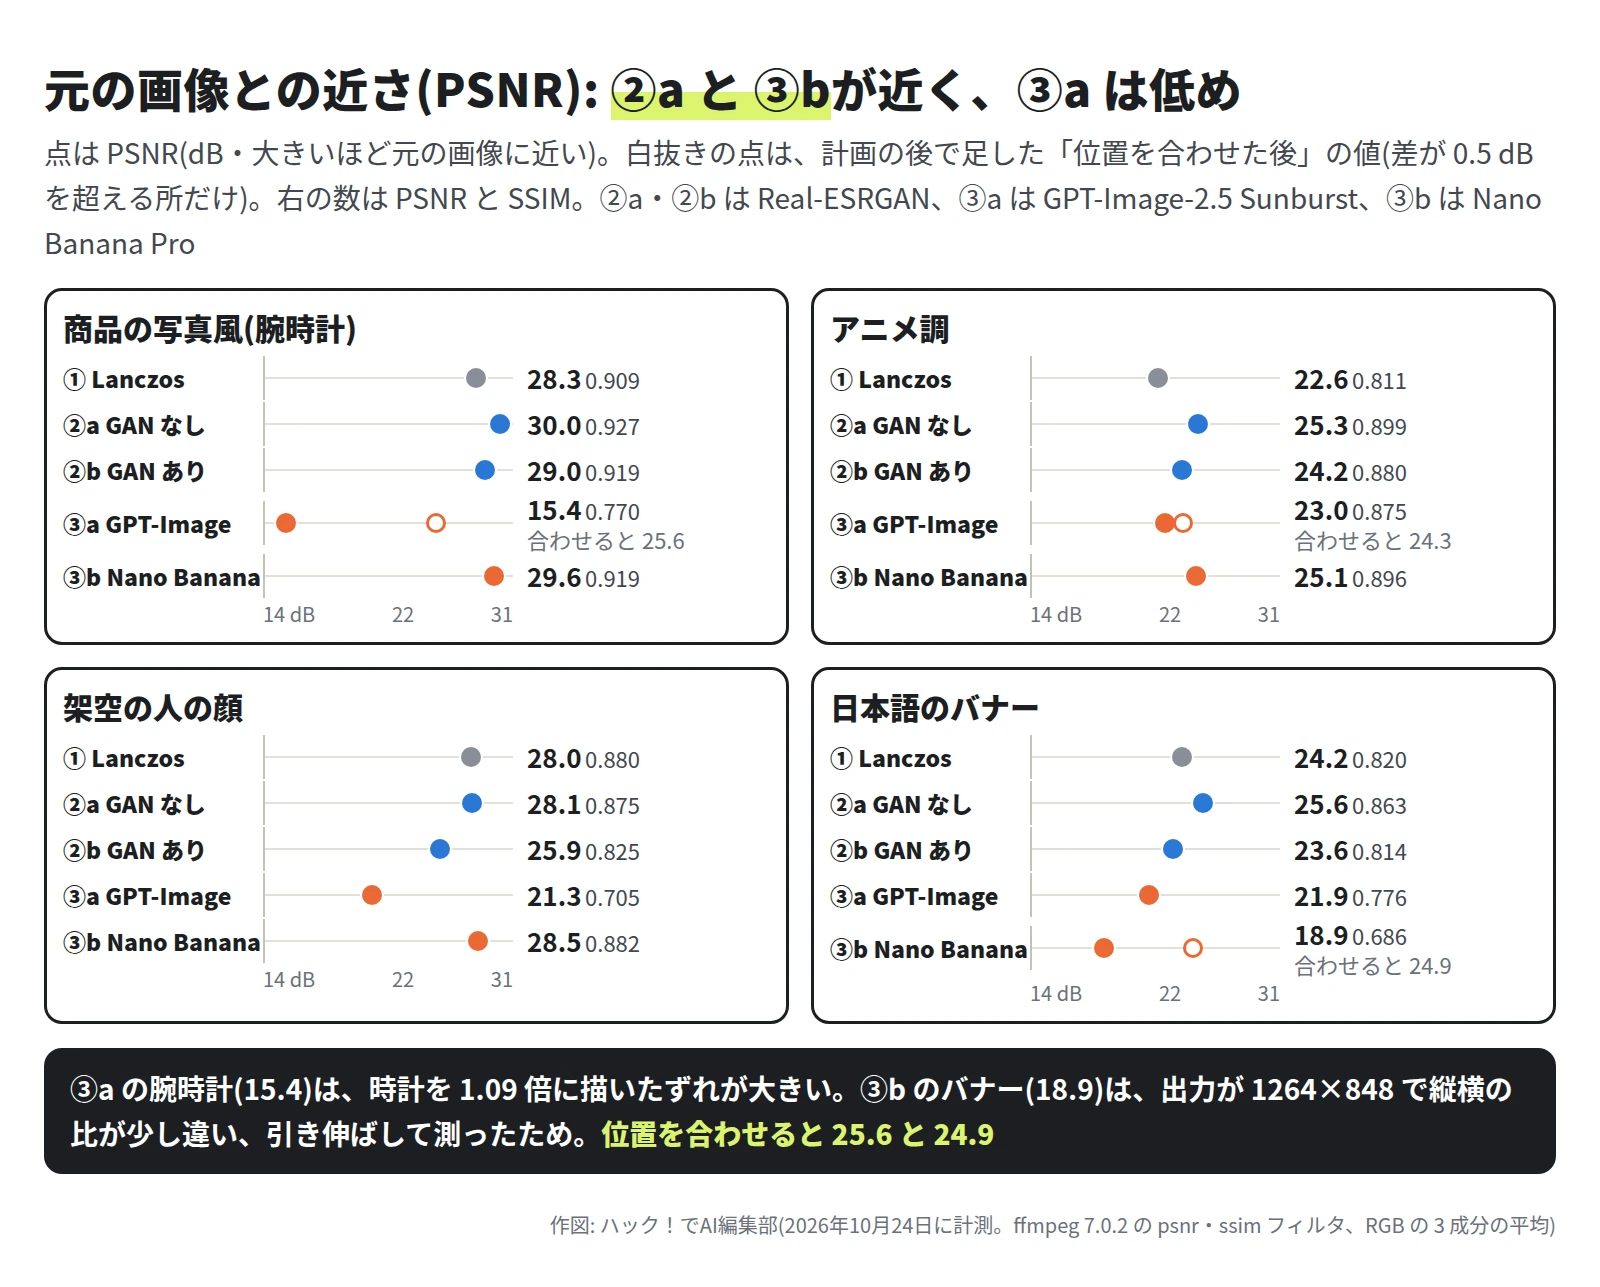
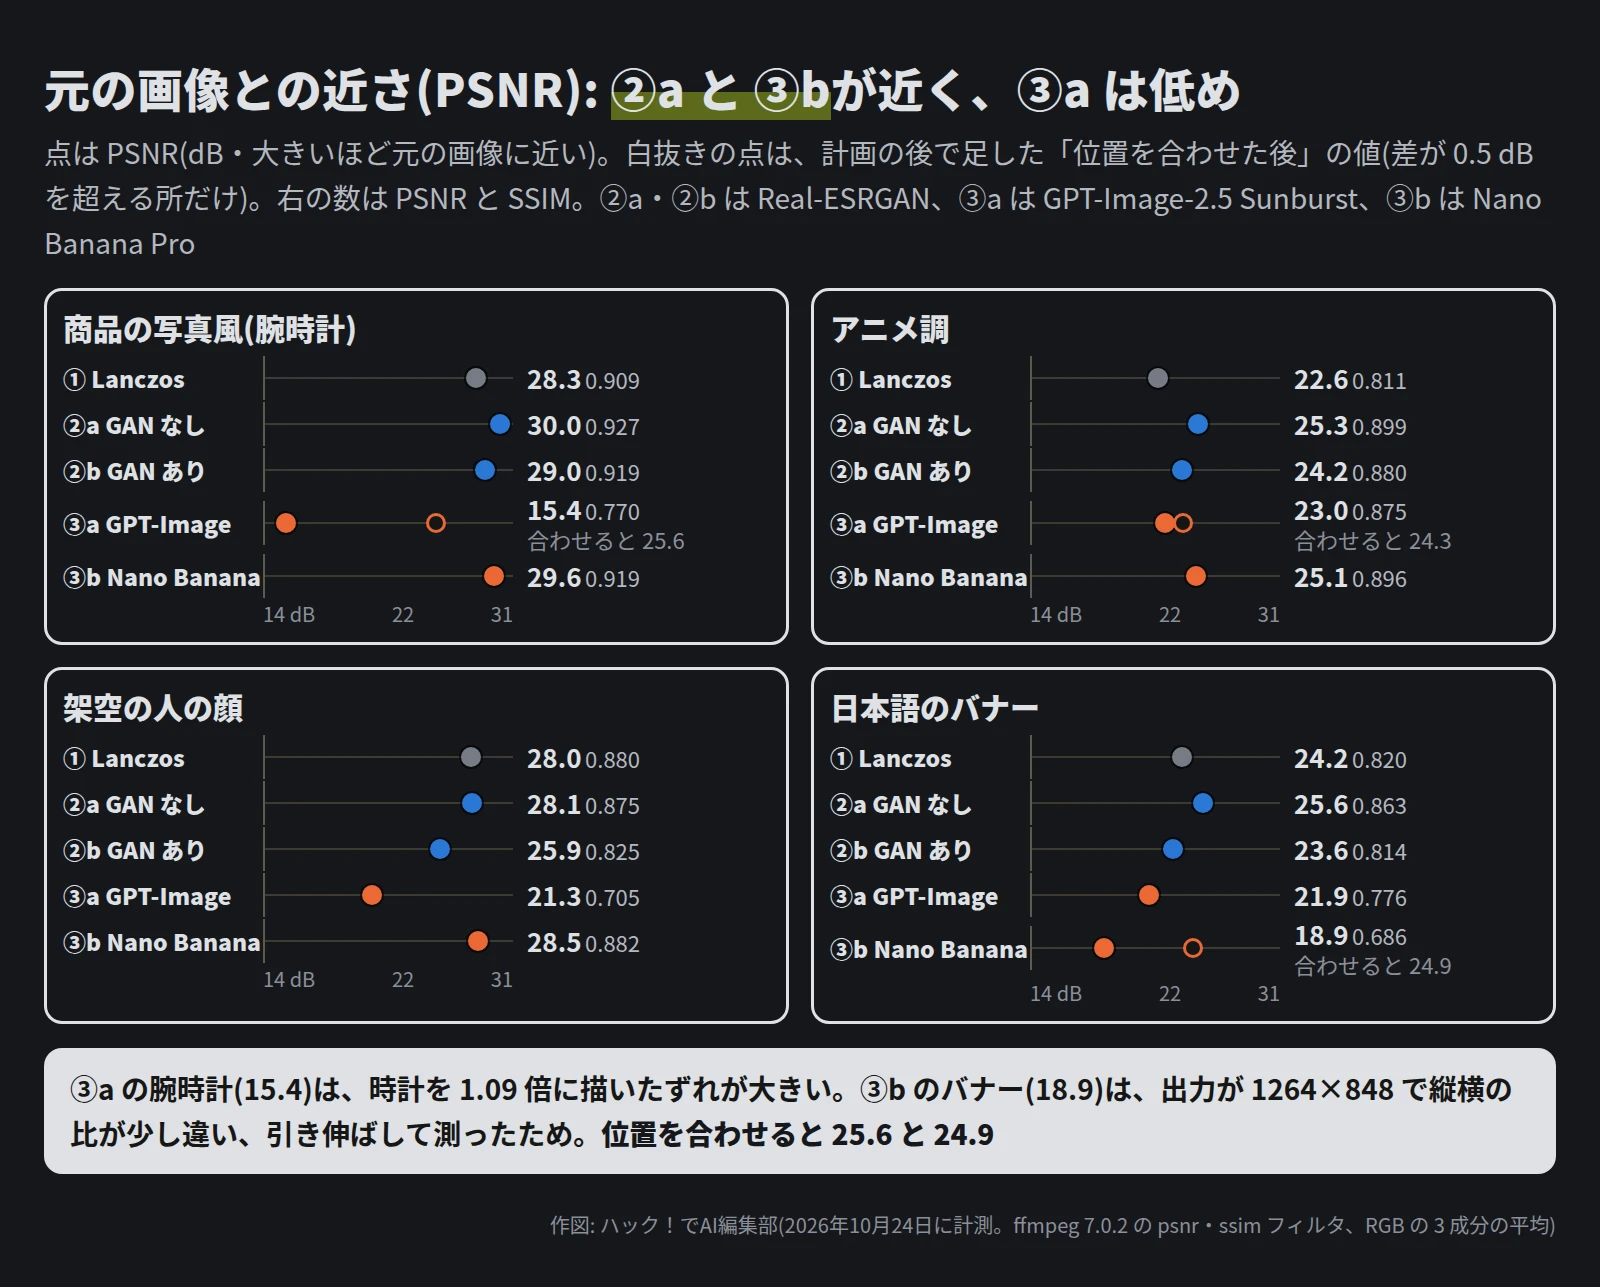
- PSNR がいちばん高かったのは、ぼやけの多い ②a(平均 27.2 dB)です。画素の差を小さくするように学習すると、迷った所を平均に近い色で埋めるので、ぼやける一方で差は小さくなると考えられます。
- 細部をくっきり描いた ③a は 20.4 dB でした。位置のずれと、描き直した模様の分が、差として数えられます。
- PSNR と SSIM は「どれだけ元に戻ったか」の数で、「どれだけきれいか」の数ではありません。描き直しを使うときは、数よりも、顔や字を元と並べて見る方が確かです。
手元は 0 クレジット、描き直しは 1 枚 2.4〜24.2
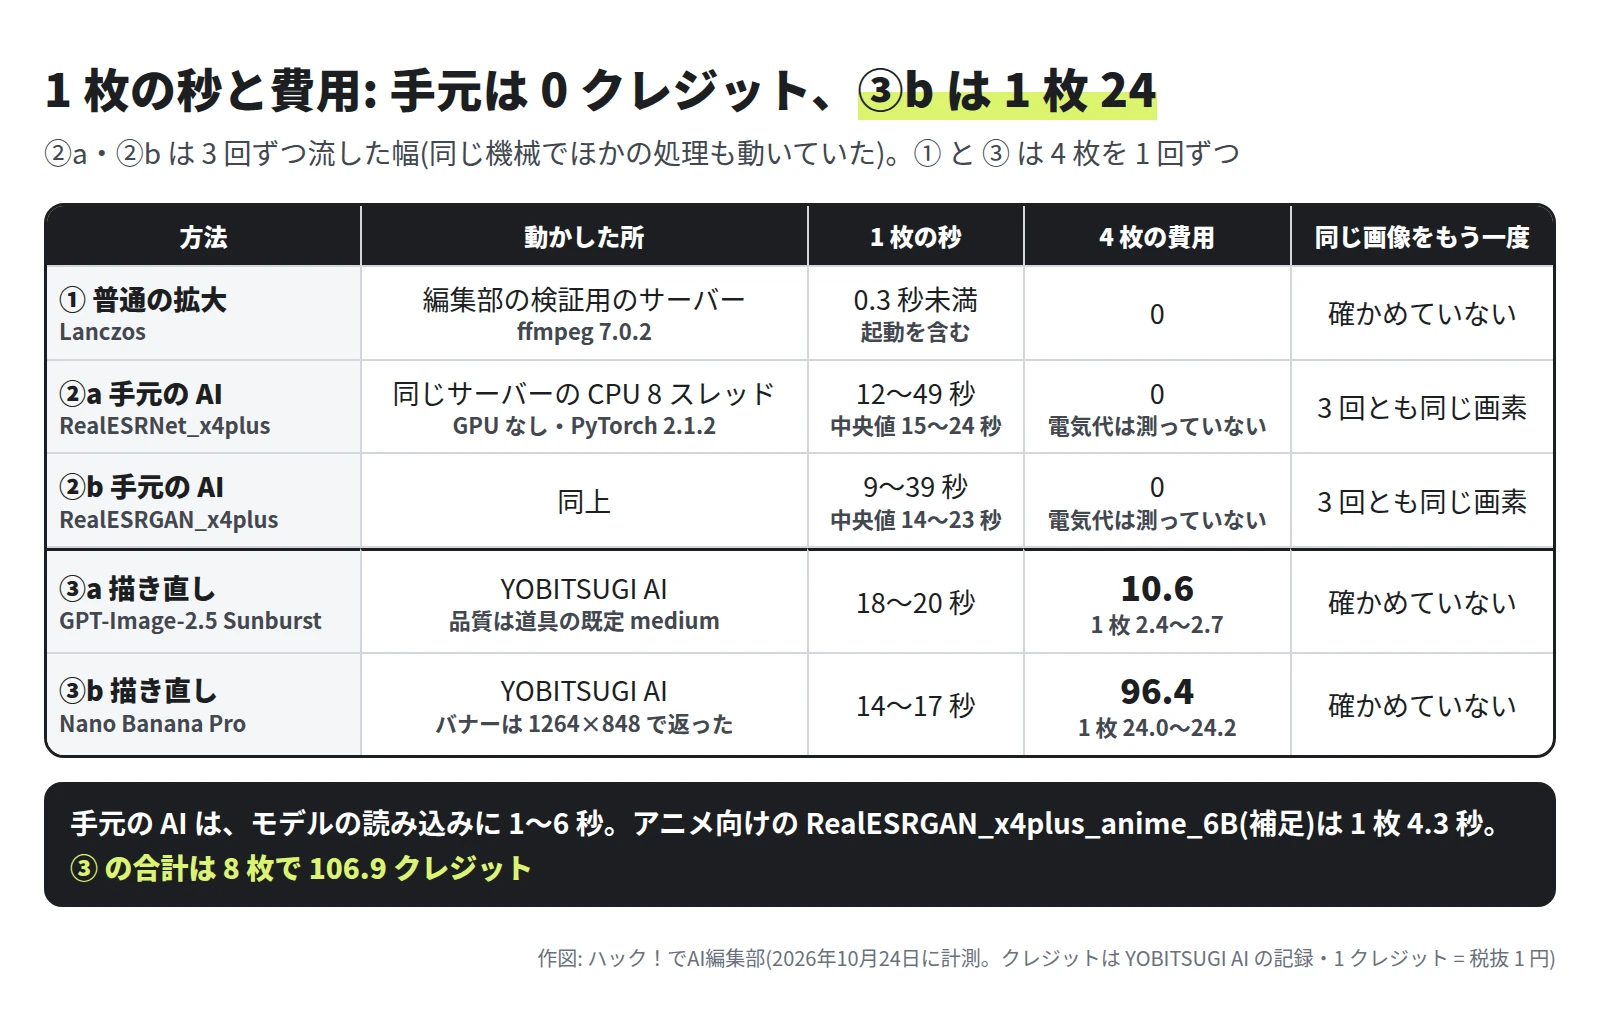
- 手元の Real-ESRGAN は、GPU の無いサーバーの CPU でも 1 枚 9〜49 秒で終わりました。秒の幅は、同じサーバーで動いていたほかの処理の影響と考えられます(確かめていません)。
- Real-ESRGAN の 2 つは、3 回流して 3 回とも同じ画素でした。③ は同じ画像で作り直していないので、毎回同じになるかは確かめていません(普通の拡大も 1 回だけです)。
- ③b Nano Banana Pro は 1 枚 24 クレジット前後で、③a の約 9 倍でした。
違いはなぜ出たか
確かめたこと: 戻す方法(① と ②a)は、縮めた画像に残っていない細部を作りませんでした。その分、ぼやけが残ります。②a がぼやけたのは、公式の説明「over-smooth effects」(なめらかになりすぎる)と合っています。③ は、縮めた画像では判別しにくい字も正しく描き、小さな顔は元と違う目で描きました。
編集部の推測(確かめていません):
- ②b が形を変えたのは、Real-ESRGAN が、ぼけ・縮小・雑音・JPEG の劣化を何段も重ねた画像で学習したモデルだからだと考えられます(論文の説明)。今回のきれいに縮めた画像では、細かい模様を劣化とみなして描き換えた可能性があります。
- ③ が字を正しく描けたのは、ぼやけた形と前後の字から、ありそうな言葉を推し量ったためと考えられます。同じ働きで、11 画素の顔には「笑う顔ならこう」という目を描いたと見ています。
- ③b の × が少なかったのは、1 回ずつの結果です。顔の絵は Nano Banana Pro が作った物なので、自分の絵柄に戻しやすかった可能性もあります。
連載の第 2 回画像生成 AI は下書きを安い AI、清書だけ高い AI で得? 合格までの総額を比べたでも、下書きを渡して清書させると、構図を保ったまま崩れた字が直りました。今回の ③ も、同じ「画像を渡して描かせる」使い方です。
用途ごとに、戻すか描き直すかを決める
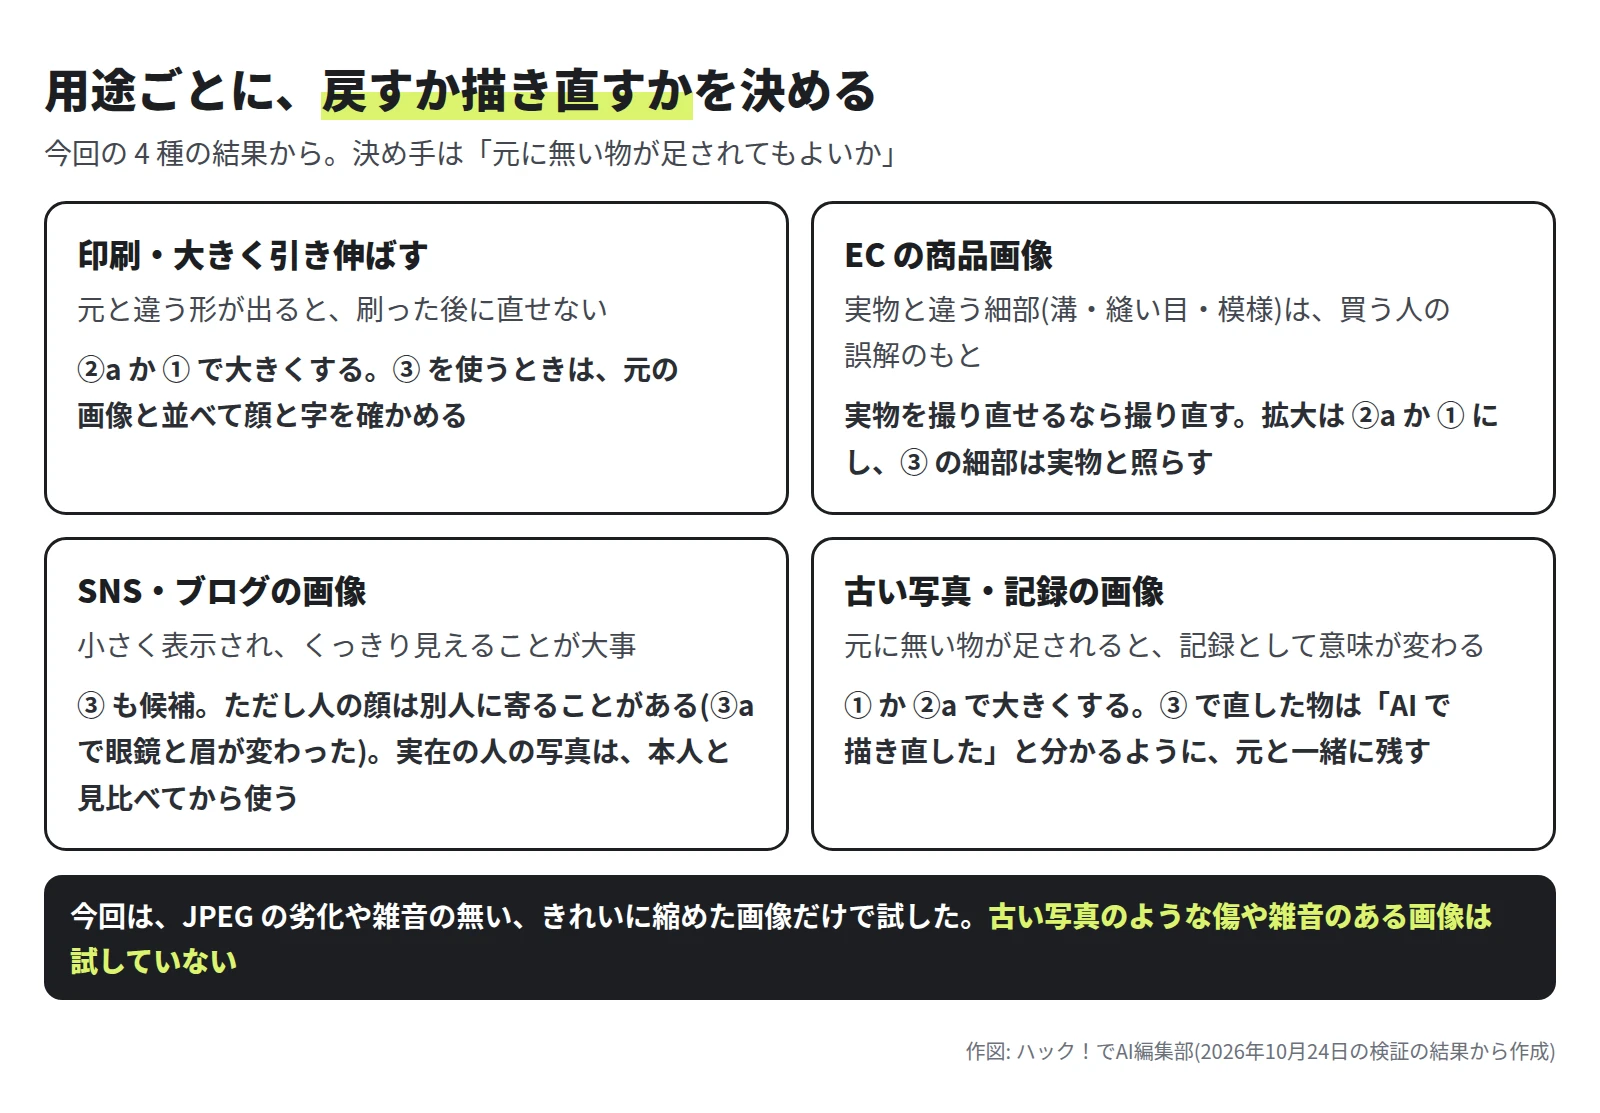
決め手は「元に無い物が足されてもよいか」です。
- 印刷・チラシ: 刷った後は直せません。②a か ① で大きくし、③ を使うなら顔と字を元と並べて確かめます。
- EC の商品画像: りゅうずの溝や縫い目のような細部は、実物と違うと買う人の誤解を招きます。撮り直せるなら撮り直すのが確かです。商品の形やラベルを保ったまま背景を変える話は、商品画像は AI のどれで作る? 同じ商品写真から 5 モデルで作って比べたにあります。
- SNS・ブログ: 小さく表示されるので、③ のくっきりさが役に立ちます。ただし、③a は人の顔の眼鏡と眉を変えました。実在の人の写真は、本人と見比べてから使います。同じ顔を保つ工夫は、第 3 回画像生成で同じ顔・同じキャラを保つ 参照画像・LoRA・IP-Adapter を比べたで試しています。
- 古い写真・記録: 足された細部は、記録の意味を変えます。① か ②a で大きくし、③ で直した物は「AI で描き直した」と分かるようにして、元の画像と一緒に残します。
手元で Real-ESRGAN を動かす(CPU だけで・編集部の手順)
Linux のサーバーで、Python 3.11 の作業用の環境を作って動かしました。編集部は uv(Python の部品を入れる道具)を使いました。
uv venv --python 3.11 .venv
source .venv/bin/activate
uv pip install --index-url https://download.pytorch.org/whl/cpu torch==2.1.2 torchvision==0.16.2
uv pip install "numpy<2" opencv-python-headless==4.10.0.84 Pillow tqdm scipy scikit-image setuptools wheel
uv pip install --no-build-isolation basicsr==1.4.2
uv pip install --no-deps realesrgan==0.3.0
uv pip install "numpy<2"
curl -LO https://github.com/xinntao/Real-ESRGAN/releases/download/v0.1.0/RealESRGAN_x4plus.pth
curl -LO https://github.com/xinntao/Real-ESRGAN/releases/download/v0.1.1/RealESRNet_x4plus.pth
- basicsr 1.4.2 は、入れるときに setuptools が無いと止まりました。先に setuptools を入れ、
--no-build-isolationを付けて入れ直しました。 - basicsr を入れると、依存の部品として opencv-python 5.0.0 と numpy 2 系が入り、PyTorch 2.1.2 が「Numpy is not available」で止まりました。最後に
numpy<2を入れ直しています。 - torchvision 0.16.2 では、読み込むときに「0.17 で消す部品を使っている」という警告が出ました。新しい版の組み合わせは試していません。
動かした台本の中心は次のとおりです。公式の inference_realesrgan.py に --fp32 を付けたときと、同じモデルの形と設定です。
import cv2, torch
from basicsr.archs.rrdbnet_arch import RRDBNet
from realesrgan import RealESRGANer

torch.set_num_threads(8)  # CPU のスレッドの数
model = RRDBNet(num_in_ch=3, num_out_ch=3, num_feat=64, num_block=23, num_grow_ch=32, scale=4)
up = RealESRGANer(scale=4, model_path="RealESRGAN_x4plus.pth", model=model,
                  tile=0, tile_pad=10, pre_pad=0, half=False, device=torch.device("cpu"))
img = cv2.imread("small.png", cv2.IMREAD_UNCHANGED)
out, _ = up.enhance(img, outscale=4)
cv2.imwrite("x4.png", out)
普通の拡大は ffmpeg の 1 行です。
ffmpeg -i small.png -vf "scale=1024:1024:flags=lanczos" x4-lanczos.png
公式は、GPU のある Windows・Mac・Linux 向けに、PyTorch の要らない実行ファイル(realesrgan-ncnn-vulkan)も配っています。今回は試していません。
気をつけること
- 4 種の絵を 1 回ずつの結果です。 ③ は同じ画像でも、作るたびに結果が変わる可能性があります。
- きれいに縮めた画像だけで試しました。 古い写真のような傷・雑音・JPEG の劣化がある画像では、② の結果は変わると考えられます(試していません)。
- 元の画像を作ったモデルが偏っています。 4 枚中 3 枚が GPT-Image-2.5 Sunburst、1 枚が Nano Banana Pro の絵です。自分の絵柄に戻しやすいことがあるなら、③a には 3 枚、③b には顔の 1 枚が有利に働いた可能性があります(確かめていません)。
- 判定は編集部が目で行いました。 名前を伏せましたが、ぼやけと描き直しの見た目は違うので、方法の見当はつきます。
- 人の写真や他人の作品を外のサービスに渡すときは、本人や作者の許可と、各社の利用の決まりを確かめてください。今回は編集部が作った架空の絵だけです。
次にやること
今日やる 1 つ: 手元の小さな画像を 1 枚、普通の拡大と描き直しの両方で大きくし、顔と字を元の画像と並べて見比べてください。
参考にした公式の情報
- GitHub xinntao/Real-ESRGAN(BSD-3-Clause)
- Real-ESRGAN「Model Zoo」
- Real-ESRGAN のリリース(学習済みのモデルの配布)
- arXiv「Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data」(Wang ほか, 2021)
- PyPI「realesrgan 0.3.0」
- GitHub XPixelGroup/BasicSR(Apache-2.0)
- PyTorch「Get Started」
- FFmpeg Filters Documentation(psnr・ssim)
- FFmpeg Scaler Documentation(lanczos)
- GitHub opencv/opencv(Apache-2.0)
- OpenAI API ドキュメント「Image generation」
- Google AI for Developers「Nano Banana image generation」
- YOBITSUGI AI「料金とシミュレーション」
連載・極める 生成AIの品質を突き詰める
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。