記事をAIの声で3分のポッドキャストに 読み違いの差は読み上げAIで開いた
 佐々木 航
この記事でわかること
- 同じ原稿を3つの読み上げAIに読ませると、違った所はいくつ出たか
- 原稿を耳で聞く形に直すと、何が直り、何が残ったか
- 番組1本にかかった時間と費用、仕上げで人がしたこと
確認した環境: 原稿は編集部(Claude Code)/ 声はYOBITSUGI AI(ElevenLabs Eleven v4・OpenAI gpt-realtime-2.1-mini・Gemini 3.8 Flash TTS)/ 2026年10月30日に作成
10月29日に公開した予約SaaSを点検した記事を、AIの2人の声で3分16秒のポッドキャストにしました。同じ原稿を3つの読み上げAIに読ませ、文字起こしで原稿と比べると、違った所はGeminiが1か所、ElevenLabsが3か所、OpenAIが10か所でした。
原稿を耳で聞く形に書き直した原稿2では、OpenAIは5か所でした。ただ、消えた所の半分は言葉を変えていない文で、回ごとのぶれも混じっています。原稿の直しより、読み上げAIどうしの差のほうがずっと大きく出ました。
記事を2人の会話にして、1行ずつ声にした
Googleは2025年4月、NotebookLMの「音声概要」を日本語を含む50以上の言語で使えるようにしました。資料を渡すと、2人が話す形の音声を作ってくれる機能です。ブログや社内の資料を「聞ける形」にしたい人にとって、AIの声はぐっと身近になりました。
ただ、AIに会話まで考えさせると、数字や社名がどう言い換えられたかを確認しにくくなります。そこで今回は、原稿は自分たちで書き、声だけをAIに任せました。声はYOBITSUGI AIから、ElevenLabs、OpenAI、Geminiの3つの読み上げを呼んでいます。YOBITSUGI AIは、ハック!でAIと同じ会社が運営しています。
原稿は聞き手と答える側の23行で、2本作りました。原稿1は記事の言葉づかいのまま、英字や細かい数字もそのまま残しています。原稿2は、耳で聞く人のために5つの点で書き直しました。
これを1行ずつ声にし、0.4秒の間を空けてつなぎました。読み上げAI3つと原稿2本で138行、約3分の音声が6本になります。138行は、11時20分から23分の3分ほどでそろいました。
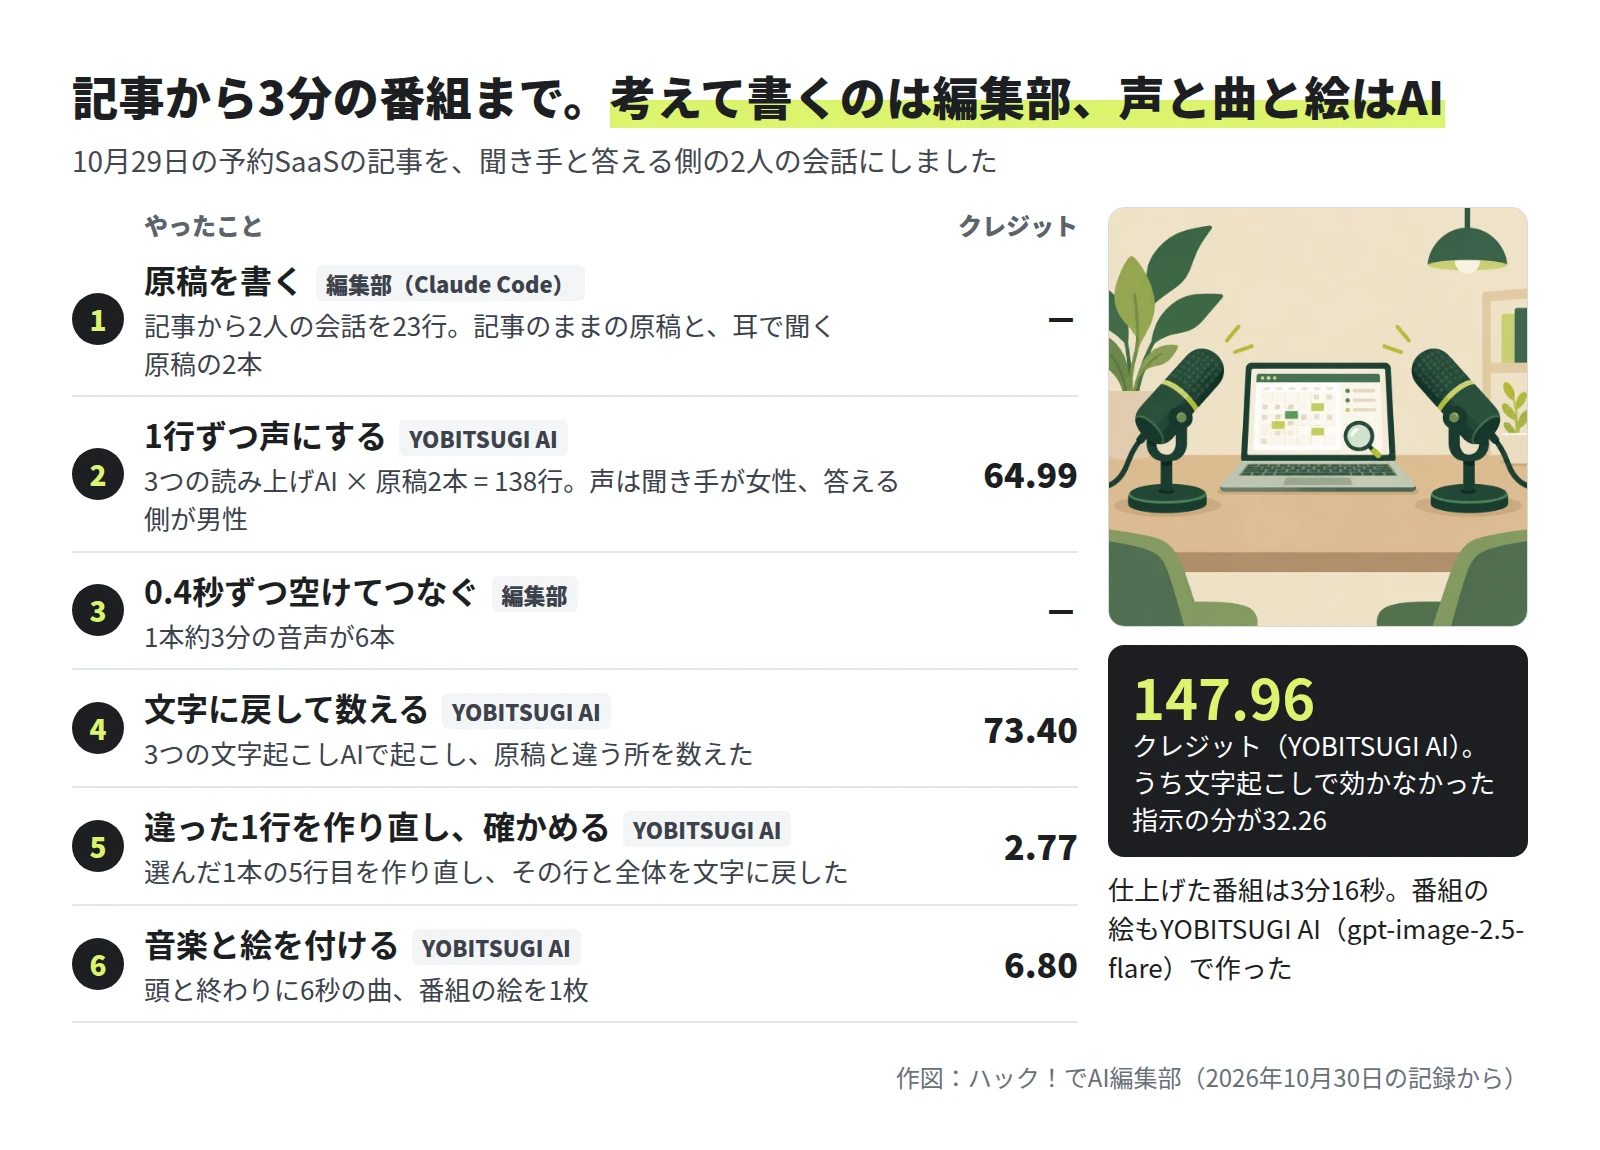
原稿と違った所は、耳では数えていません。6本の音声を3つの文字起こしAIで文字に戻し、2つ以上が同じ場所で同じように原稿と違えた所だけを数えました。1つだけに出た違いは、文字起こしの側の聞き違いかもしれないからです。
違った所は、読み上げAIで1から10まで開いた
先に言ってしまうと、予想は外れました。原稿を耳向けに直せば、読み違いはほとんど消えると考えていたのです。実際には、原稿を直すより、読み上げAIを替えるほうが差が大きく出ました。
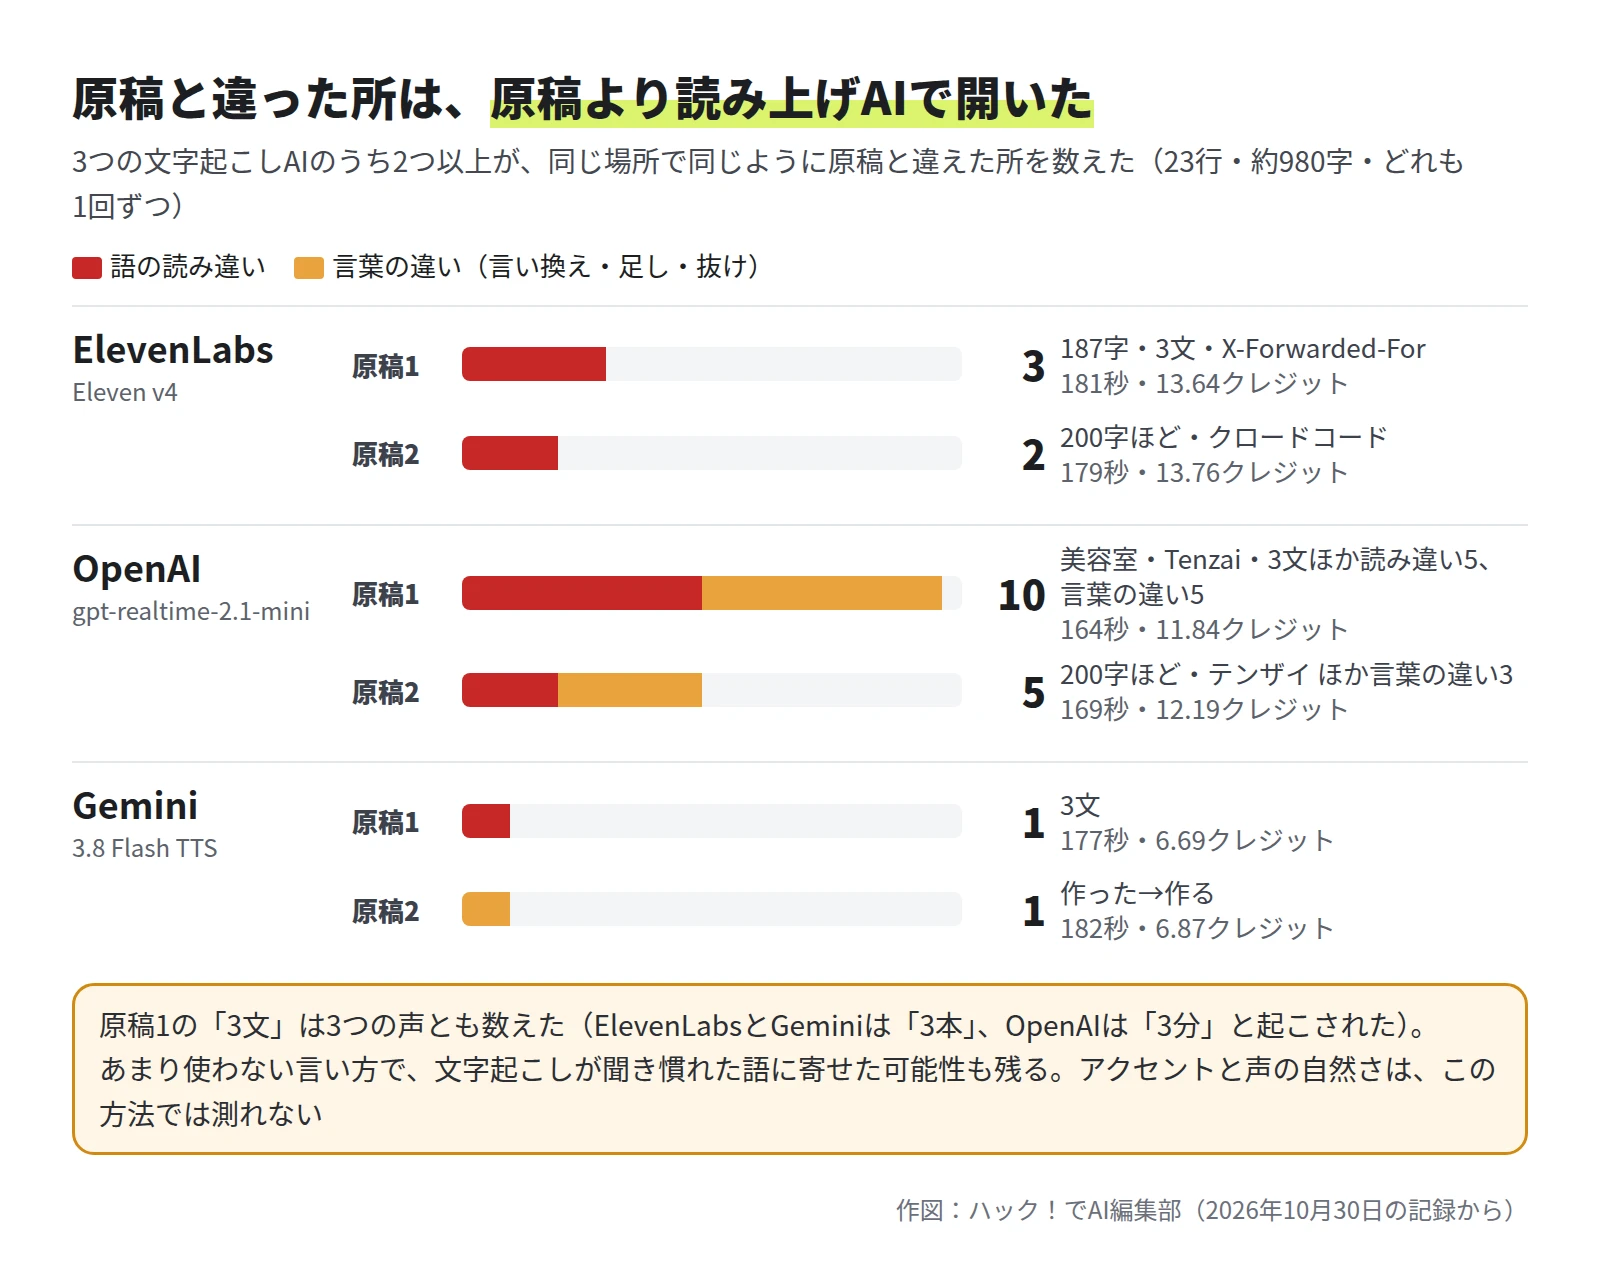
Geminiは原稿1も原稿2も1か所ずつでした。ElevenLabsは3か所と2か所、OpenAIは10か所と5か所です。3分の番組1本を作る費用は、Geminiが約7クレジット、OpenAIが約12、ElevenLabsが約14でした。1クレジットは税抜1円なので、違いが最も少なかったGeminiが、費用も1本7円ほどでいちばん少なく済んでいます。
違いの中身は、2つに分かれます。1つは「美容室」「Tenzai」のように語そのものを読み違えた所、もう1つは「漏れた」が「漏えいした」になるような言葉の違いです。後者はOpenAIに8か所、ほかはGeminiの「作った→作る」の1か所だけでした。
原稿1の「安全の注文を3文足した」の「3文」は、3つの声すべてで数に入っています。ElevenLabsとGeminiでは3つの文字起こしがそろって「3本」、OpenAIでは「3分」でした。あまり使わない言い方なので、文字起こしが聞き慣れた語に寄せた可能性は残ります。
OpenAIは、読むより話していた
OpenAIの声は、原稿にない言葉を足したり、言い換えたりしました。「申し込み」は「お申し込み」に、「14本に無かった」は「14本になっていなかった」に、「漏れたときの」は「漏えいした時の」になりました。どれも、3つの文字起こしがそろって同じ言葉を起こしました。
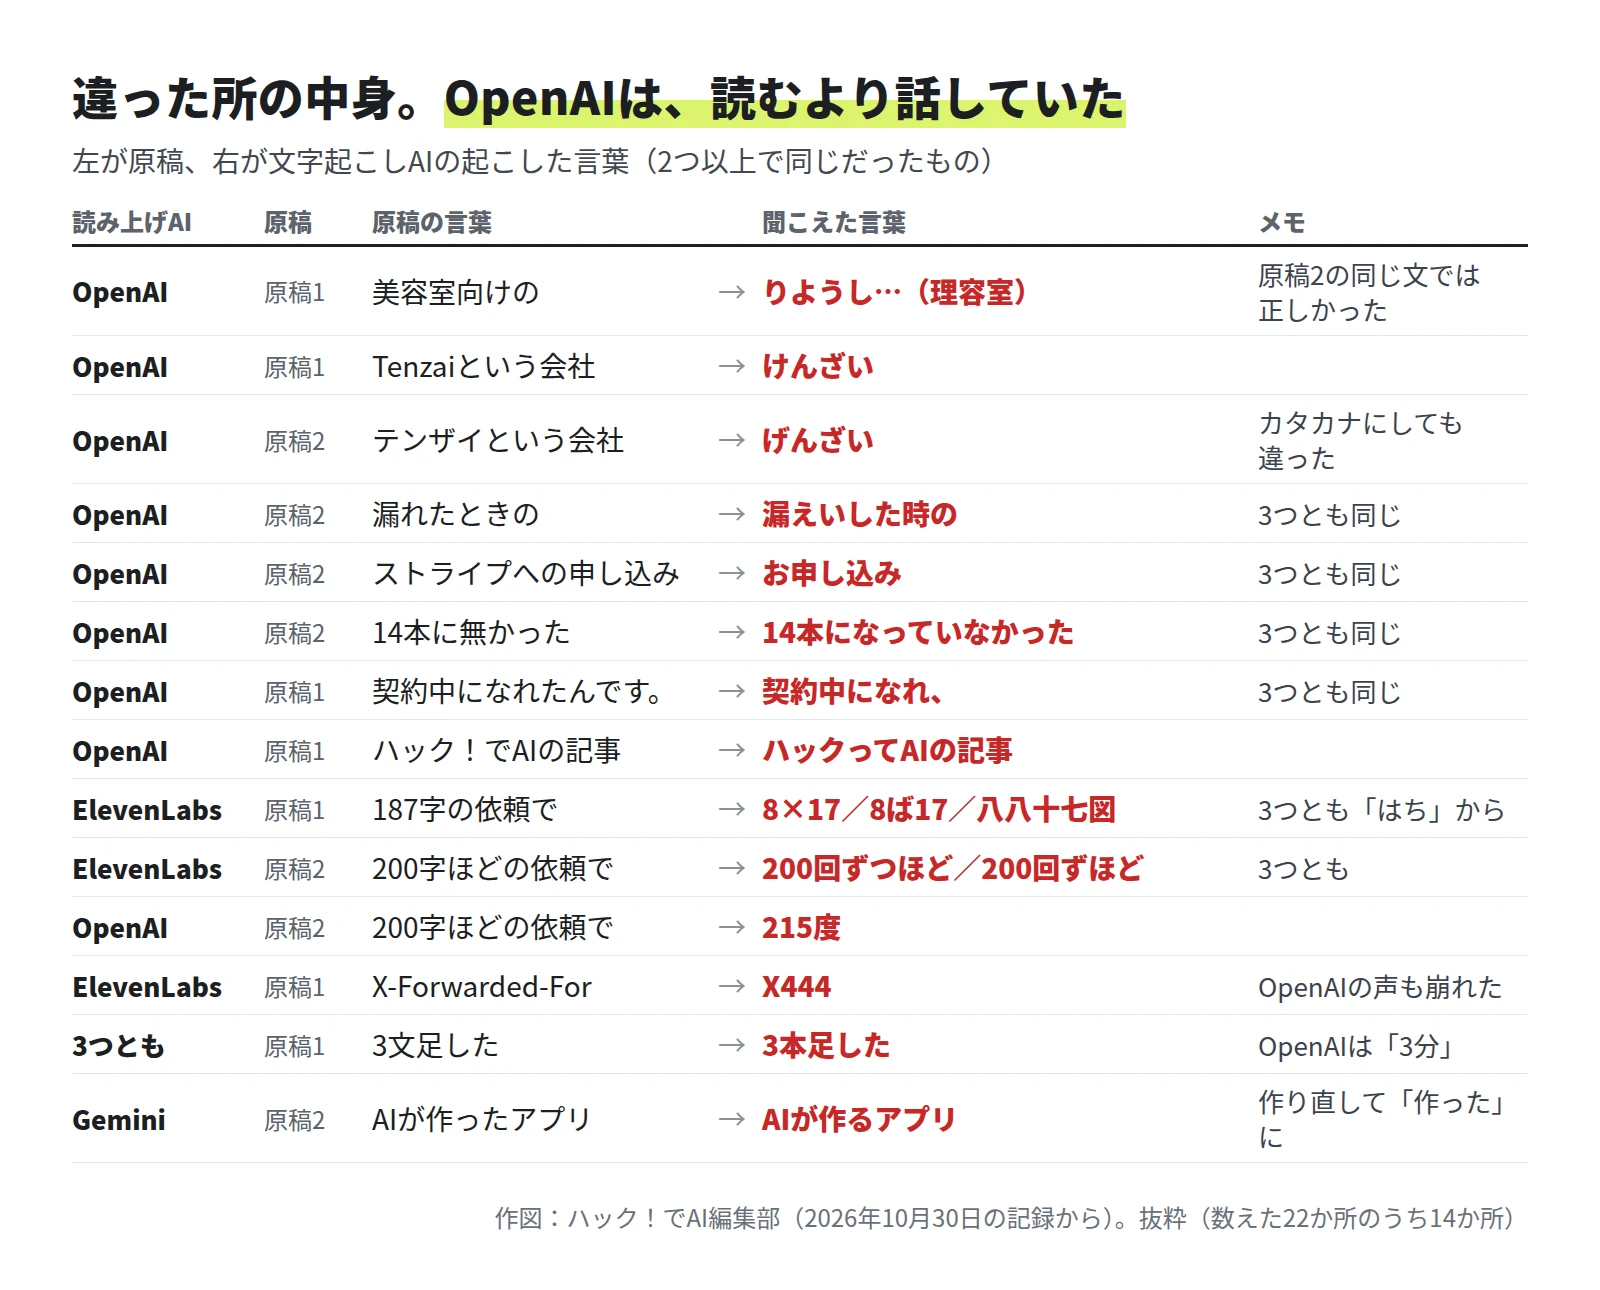
言い換えの多くは、意味を変えませんでした。けれど、「2つとも同じように」が「2つも同じように」、「14本に無かった」が「14本になっていなかった」になった所は、聞くと意味が変わります。原稿1では「美容室向けの」も「りようし…」と起こされました。理容室は、美容室とは別の業種です。
意外にも、原稿2の同じ文では、OpenAIも「美容室」と読めていました。同じ言葉でも、回によって読み方が変わります。
YOBITSUGI AIのOpenAIの読み上げは、リアルタイムの会話のためのモデル(gpt-realtime-2.1-mini)に原稿を読ませる仕組みで、これは10月14日の聞き比べで確認しました。話すためのモデルなので、原稿を「読む」より内容を「話す」ほうに寄るのだとみています。ここは推測で、モデルの中を調べたわけではありません。
「字」と社名は、書き直しても残った
ElevenLabsは、数字のあとに「字」が付く所を崩しました。「187字の依頼で」は、3つの文字起こしがどれも「8」から始まる別の言葉に起こしています。原稿2で「200字ほど」に丸めても、今度は文字起こしが「200回ず…」と書く結果に。
社名の「Tenzai」も残りました。OpenAIの声を、文字起こしは英字のままだと「けんざい」、カタカナの「テンザイ」にしても「げんざい」と書いています。カタカナで書けば正しく読まれる、とは限りません。
耳で聞く原稿で効いたのは、コードを言葉にした所
原稿2では、英字の語をカタカナにする、略語とコードを言い換える、細かい数字を丸める、読みが分かれる数を言い換える、AとBを「1つ目・2つ目」と呼ぶ、の5つの点を直しています。
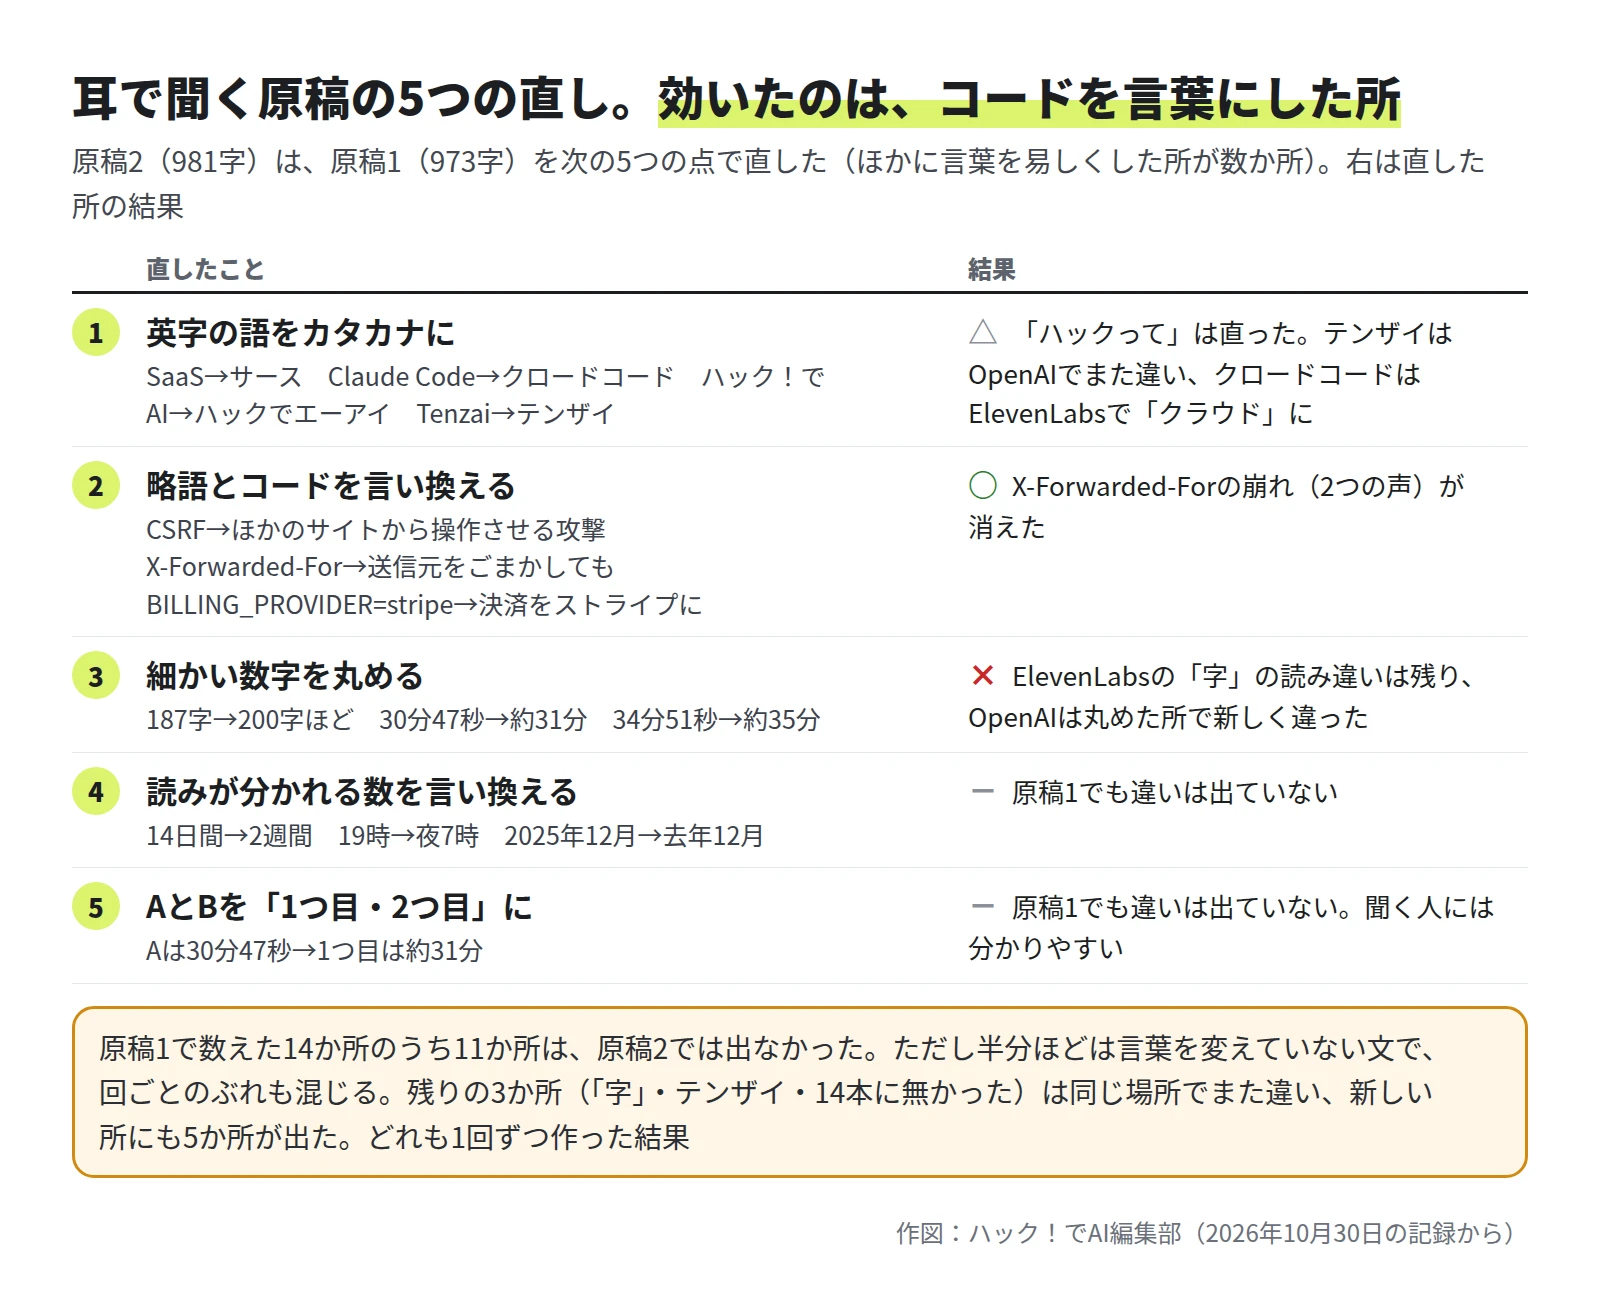
コードのような文字列を言葉にした所は、はっきり効きました。「X-Forwarded-For」は、原稿1ではElevenLabsとOpenAIの声がどちらも崩し、文字起こしは「X444」「X4レッド4」のような文字にしていました。原稿2で「送信元をごまかしても」と書き直すと、この違いは消えています。
一方で、原稿1で数えた14か所のうち3か所は、原稿2でも同じ場所でまた違ったまま。OpenAIの言い換えは、原稿2では新しい場所にも出ました。原稿の直しは「読めない語を消す」のには効いても、読み上げAIの話し方のくせまでは直せませんでした。
仕上げは、違った1行だけ作り直した
番組には、Geminiの原稿2を使いました。違いは原稿1と同じ1か所で、英字やAとBの呼び名がない原稿2のほうが、耳で聞いて分かりやすいからです。その1か所は、5行目の「作った」が「作る」と起こされた所でした。
この行だけを作り直すと、3つの文字起こしがそろって「作った」と起こしました。費用は0.24クレジットです。頭と終わりにはEleven Musicで作った10秒の曲を6秒ずつ付け、番組の絵はgpt-image-2.5-flareで1枚描きました。
費用は合わせて147.96クレジット(税抜で約148円)でした。声の138行が64.99、確認のための文字起こしが73.40で、作る費用を上回っています。ただ、文字起こしのうち32.26は、Geminiに「ひらがなで起こして」と指示した12回の分でした。
この指示は効かず、ふつうの文字起こしと同じ文が返ってきました。そこで、ElevenLabsの文字起こし(Scribe v2)を3つ目に足して数えています。効かなかった分を除くと、確認の費用は41.14です。確認のためのツールも、まず確かめてから使う必要がありました。
聞いて確かめる手間は、減っても無くならない
原稿を書き直すと、コードや略語のような「読めない語」は消せました。それでも、社名や「字」の読み違い、話し方のくせは残っています。番組を出す前に、どこかで人かAIが聞き直す手間は、減っても無くなりません。
今回のやり方なら、3分の番組1本を3つの文字起こしで確認するのに、7クレジットほどかかります(1回あたり1.8〜2.7クレジット)。数字や社名を伝える番組なら、原稿どおりに読む読み上げAIを選び、違った行だけ作り直すのが近道でした。ブログを音声にするなら、まずは1本、文字に戻して原稿と並べてみてください。
測り方
原稿・声・数え方の条件
- 作った日は2026年10月30日です。原稿は編集部(Claude Code)が書き、23行のうち聞き手が12行、答える側が11行です。原稿1は973字、原稿2は981字でした(改行を除き、空白は含めて数えた)。
- 声は、YOBITSUGI AIの読み上げで1行ずつ作りました。声の名前は、聞き手と答える側の順に、ElevenLabs Eleven v4がJessicaとGeorgeです。OpenAI gpt-realtime-2.1-miniはmarinとcedar、Gemini 3.8 Flash TTSはKoreとPuckでした。話し方の指示は付けていません。ElevenLabsは、同時に頼める数の上限で一部が断られ、1件ずつ頼み直しました。
- どの組み合わせも1回ずつ作った結果です。作り直したのは、仕上げの1行だけです。行の間は0.4秒の無音で、音量はつないだあとにそろえました。
- 数え方は、作る前に書いた計画から1か所変えました。計画では、Geminiの「ひらがなで起こす」指示で読みを確かめるはずでした。指示が効かなかったため、文字起こしを3つにしました。OpenAIのgpt-transcribe、Geminiの3.5 Transcribe、ElevenLabsのScribe v2です。このうち2つ以上が、同じ場所で同じ読みを原稿と違えて起こした所を数えています。
- 数字と漢数字、漢字とかな、英字とカタカナのような表記の違いは、数えていません。2つ以上が原稿と違ったのに読みが割れた所は、数に入れていません。OpenAIの原稿1の「バイブコーディング」(バイト・バイ・ザ)と、ElevenLabsの両方とGeminiの原稿2の「Tenzai」「テンザイ」(天才・テンザ)が当たります。
- 目で数えたあと、原稿と3つの文字起こしを字ごとに突き合わせるスクリプトで全部を見直しました。このときOpenAIの原稿1に1か所(14本に無かった→14本には無かった)を足しています。公開前の校閲で、外していた「3文」を決まりどおり3つの声に数え直しました。
- アクセント(語の中の高い低い)と声の自然さは、この方法では測れません。
参考にした公式の情報
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。