同じお題で AI を比べる 第20回
AI はマジカルアイが見える? 立体視の絵に隠した形を 4 つの AI に見せた
 佐々木 航
この記事でわかること
- 立体視の絵 12 枚で、4 つの AI が隠した形を当てた数と作り話の数
- 画像の AI 3 つに頼んだ立体視の絵は、本当に浮き出るか
- 見て分からなくても、台本を書かせると解けるか
確認した環境: YOBITSUGI AI で各モデルを実行・立体視の絵は Python(numpy・Pillow)で作成 / 2026年10月15日に確認
眺めていると形が浮き出てくる立体視の絵を、AI に見せたらどう答えるのか。編集部で立体視の絵を 12 枚作り、Claude・GPT・Gemini・Grok に同じ文で 1 回ずつ見せました。今回の結果では、ランダムドットの絵に隠した形を当てたモデルはありませんでした。当たったのは 4 回で、どれも片目でも形のふちが見える「模様の絵」でした。
結果の早見
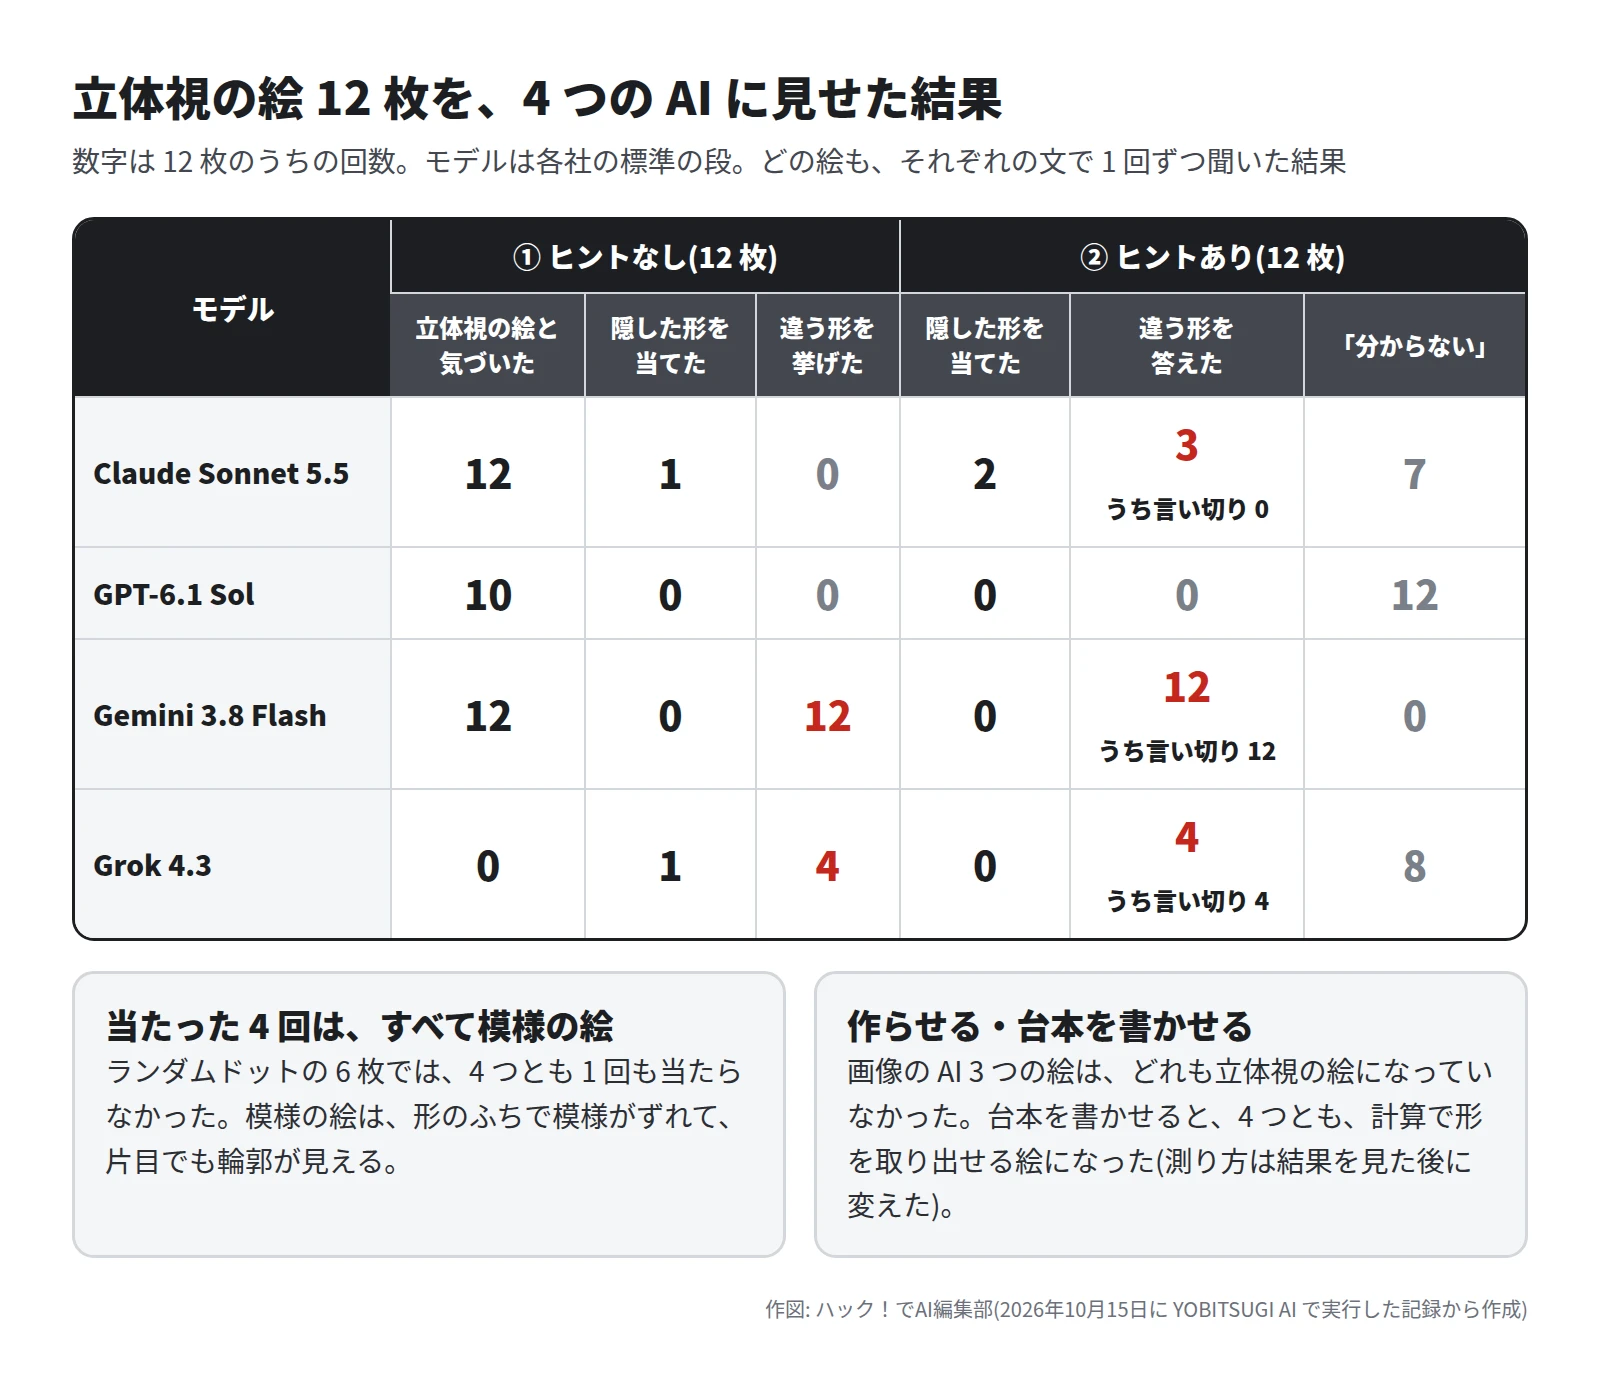
- 「違う形」は、絵に隠していない形を、浮き出る形や隠れた形として答えた回数です。この記事では作り話として数えています。
- Claude Sonnet 5.5 の外れの 3 回は、どれも推測と断った答えでした。Gemini 3.8 Flash と Grok 4.3 の外れは、すべて言い切りでした。
- 当てた数の差は 0〜2 回で、どの絵も 1 回ずつしか聞いていないため、モデルの順位は付けていません。
自分の目で試す
立体視の絵(オートステレオグラム)は、同じ模様を横に少しずつずらしながら並べた 1 枚の絵です。左右の目が少し違う所を見て重ねると、ずれの違いが奥行きに見えます。いわゆる「マジカルアイ」と呼ばれる絵で、この呼び方は書籍の題にも使われています。この記事の絵は、どれも平行法で見る向きに作りました。
- 画面に顔を近づけ、絵の奥を見るつもりで、目の焦点をぼかします。
- そのまま、ゆっくり顔を離します。
- 模様が重なって落ち着くと、形が手前に浮き出ます。
見えにくいときは、図を拡大してください。目が疲れたら、続けて見ないでください。
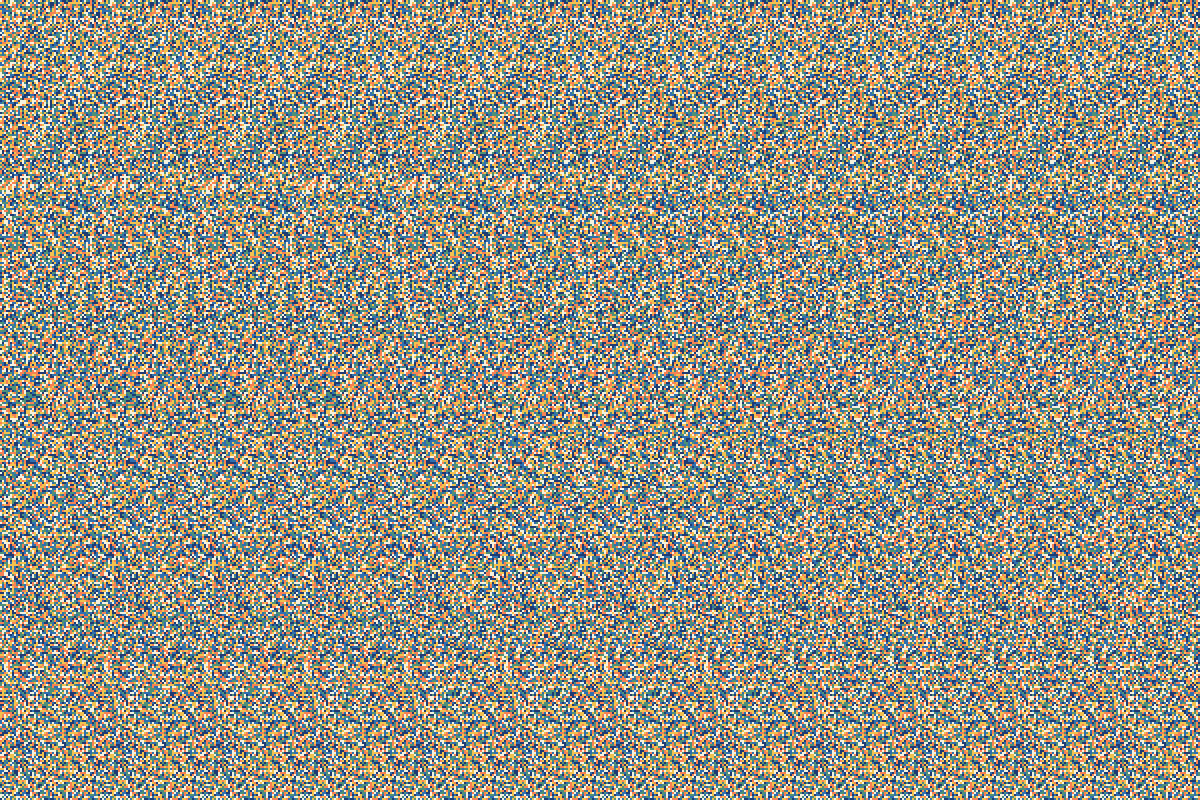
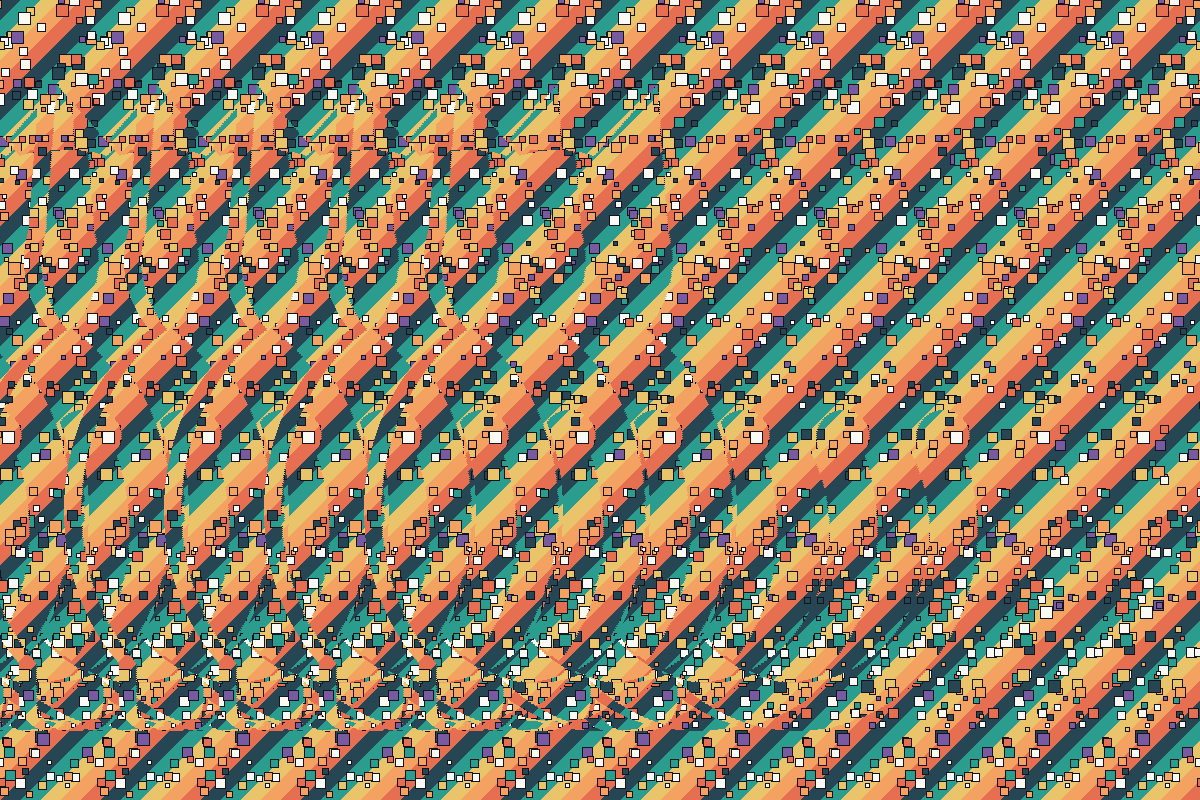
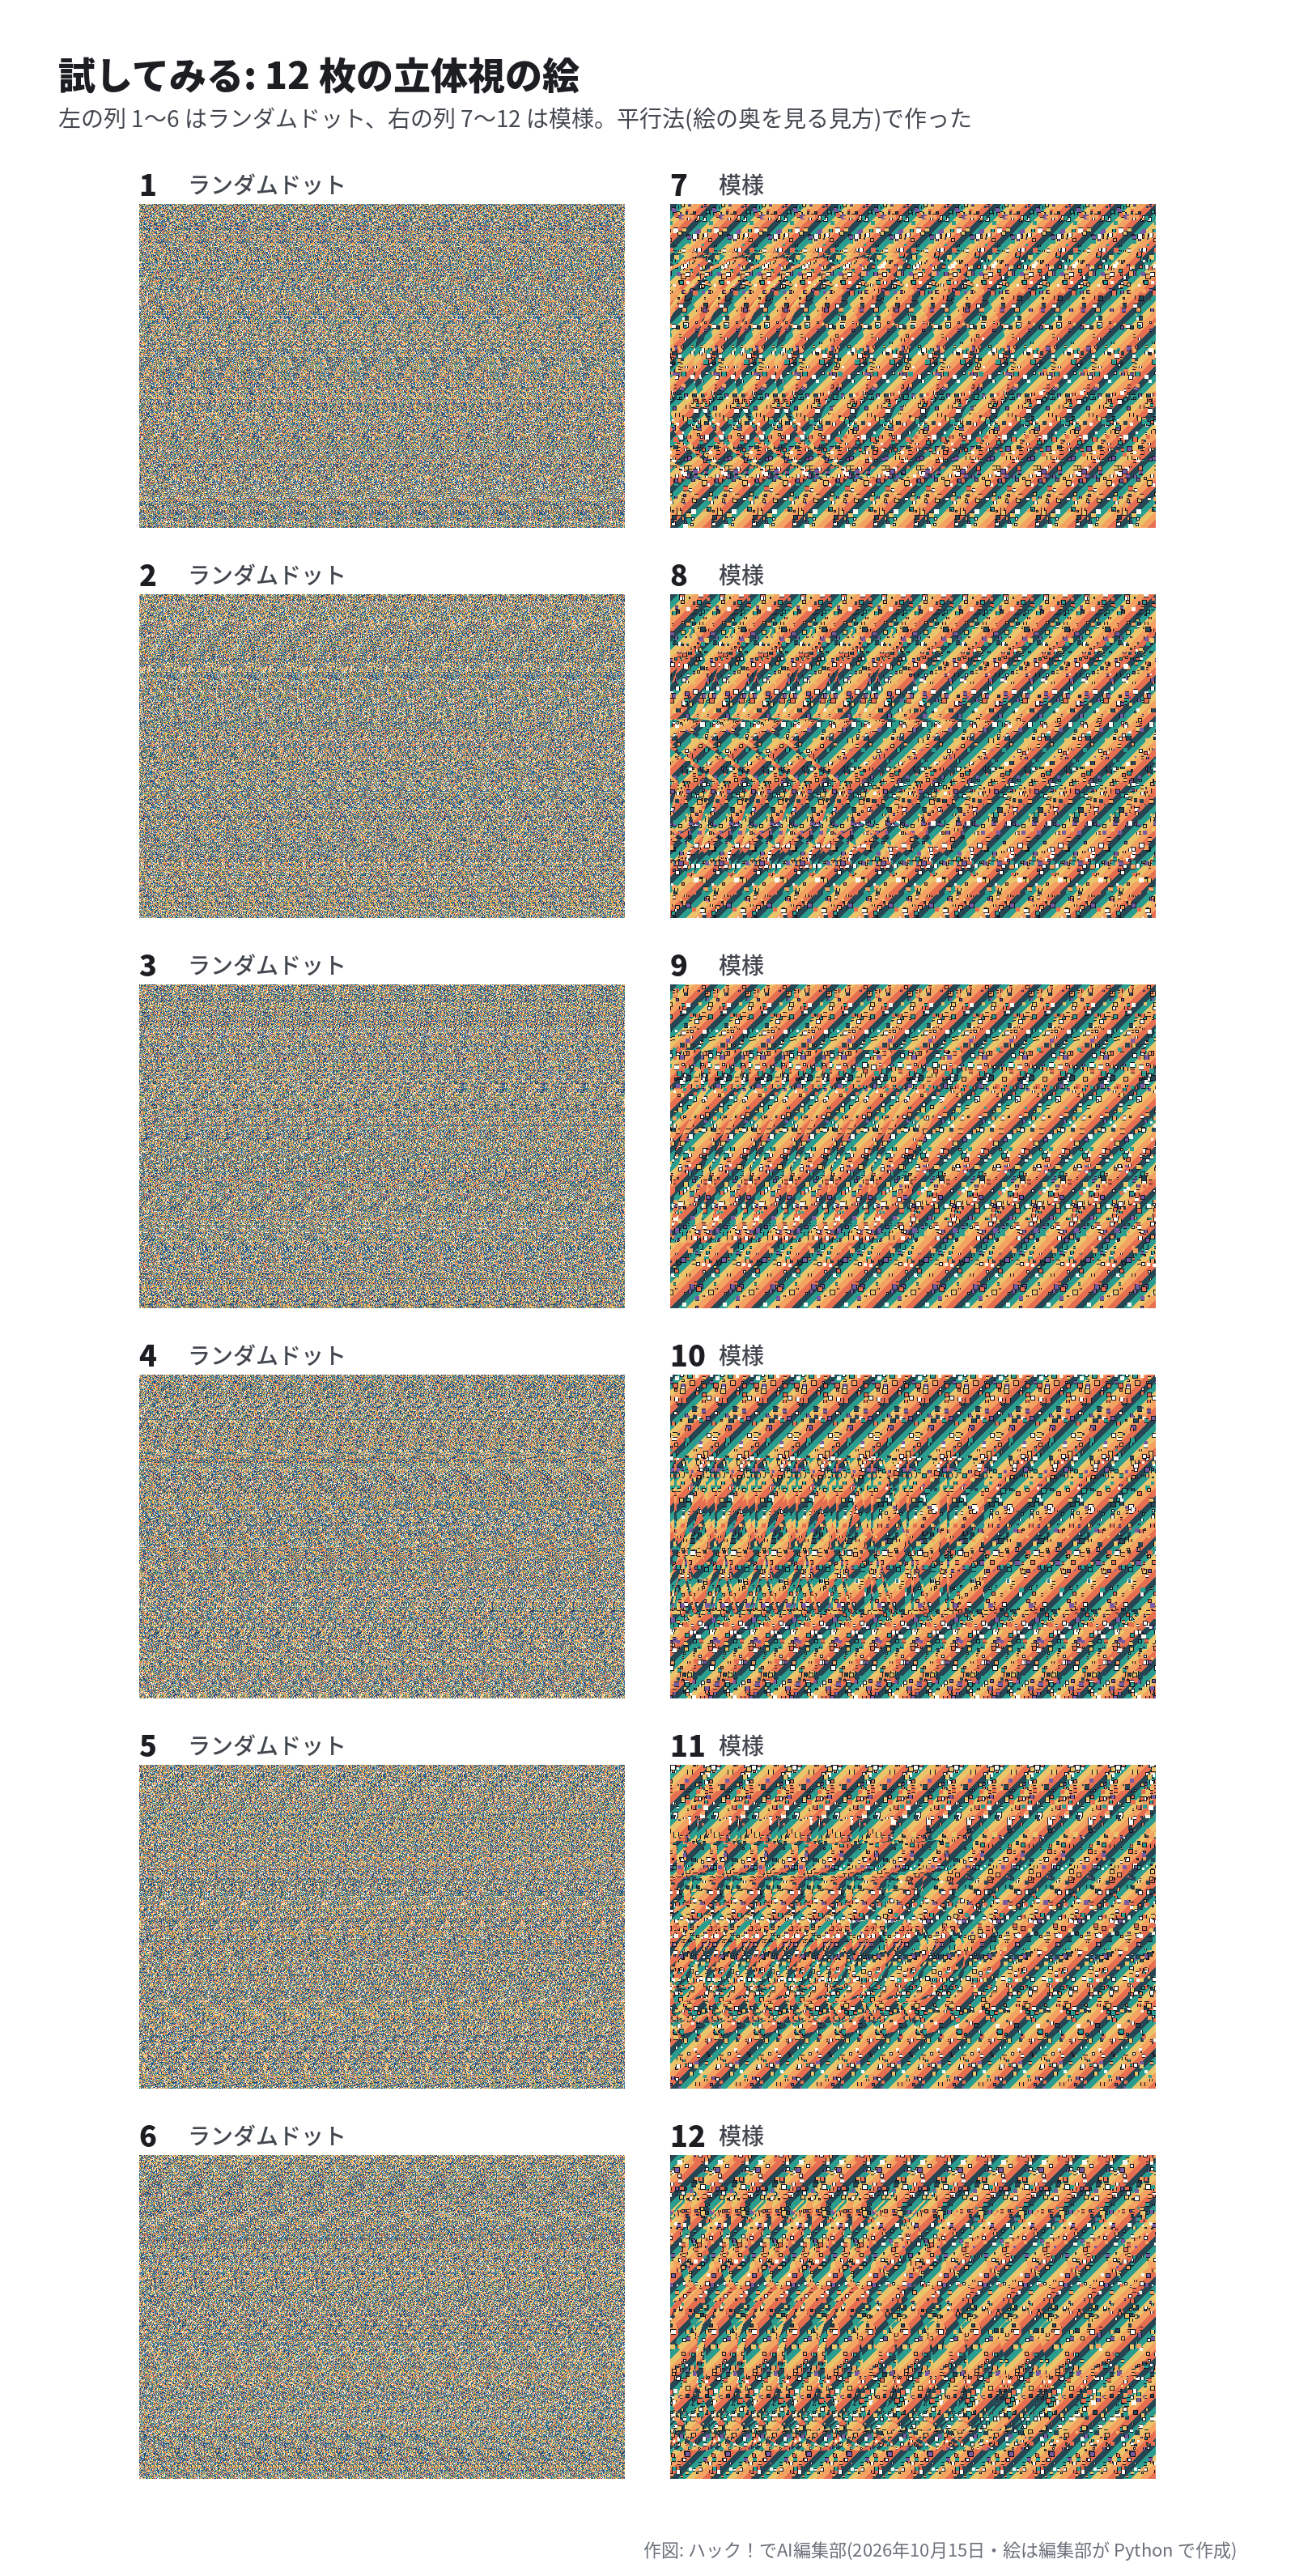
答え: 隠した形と、計算で取り出した奥行き
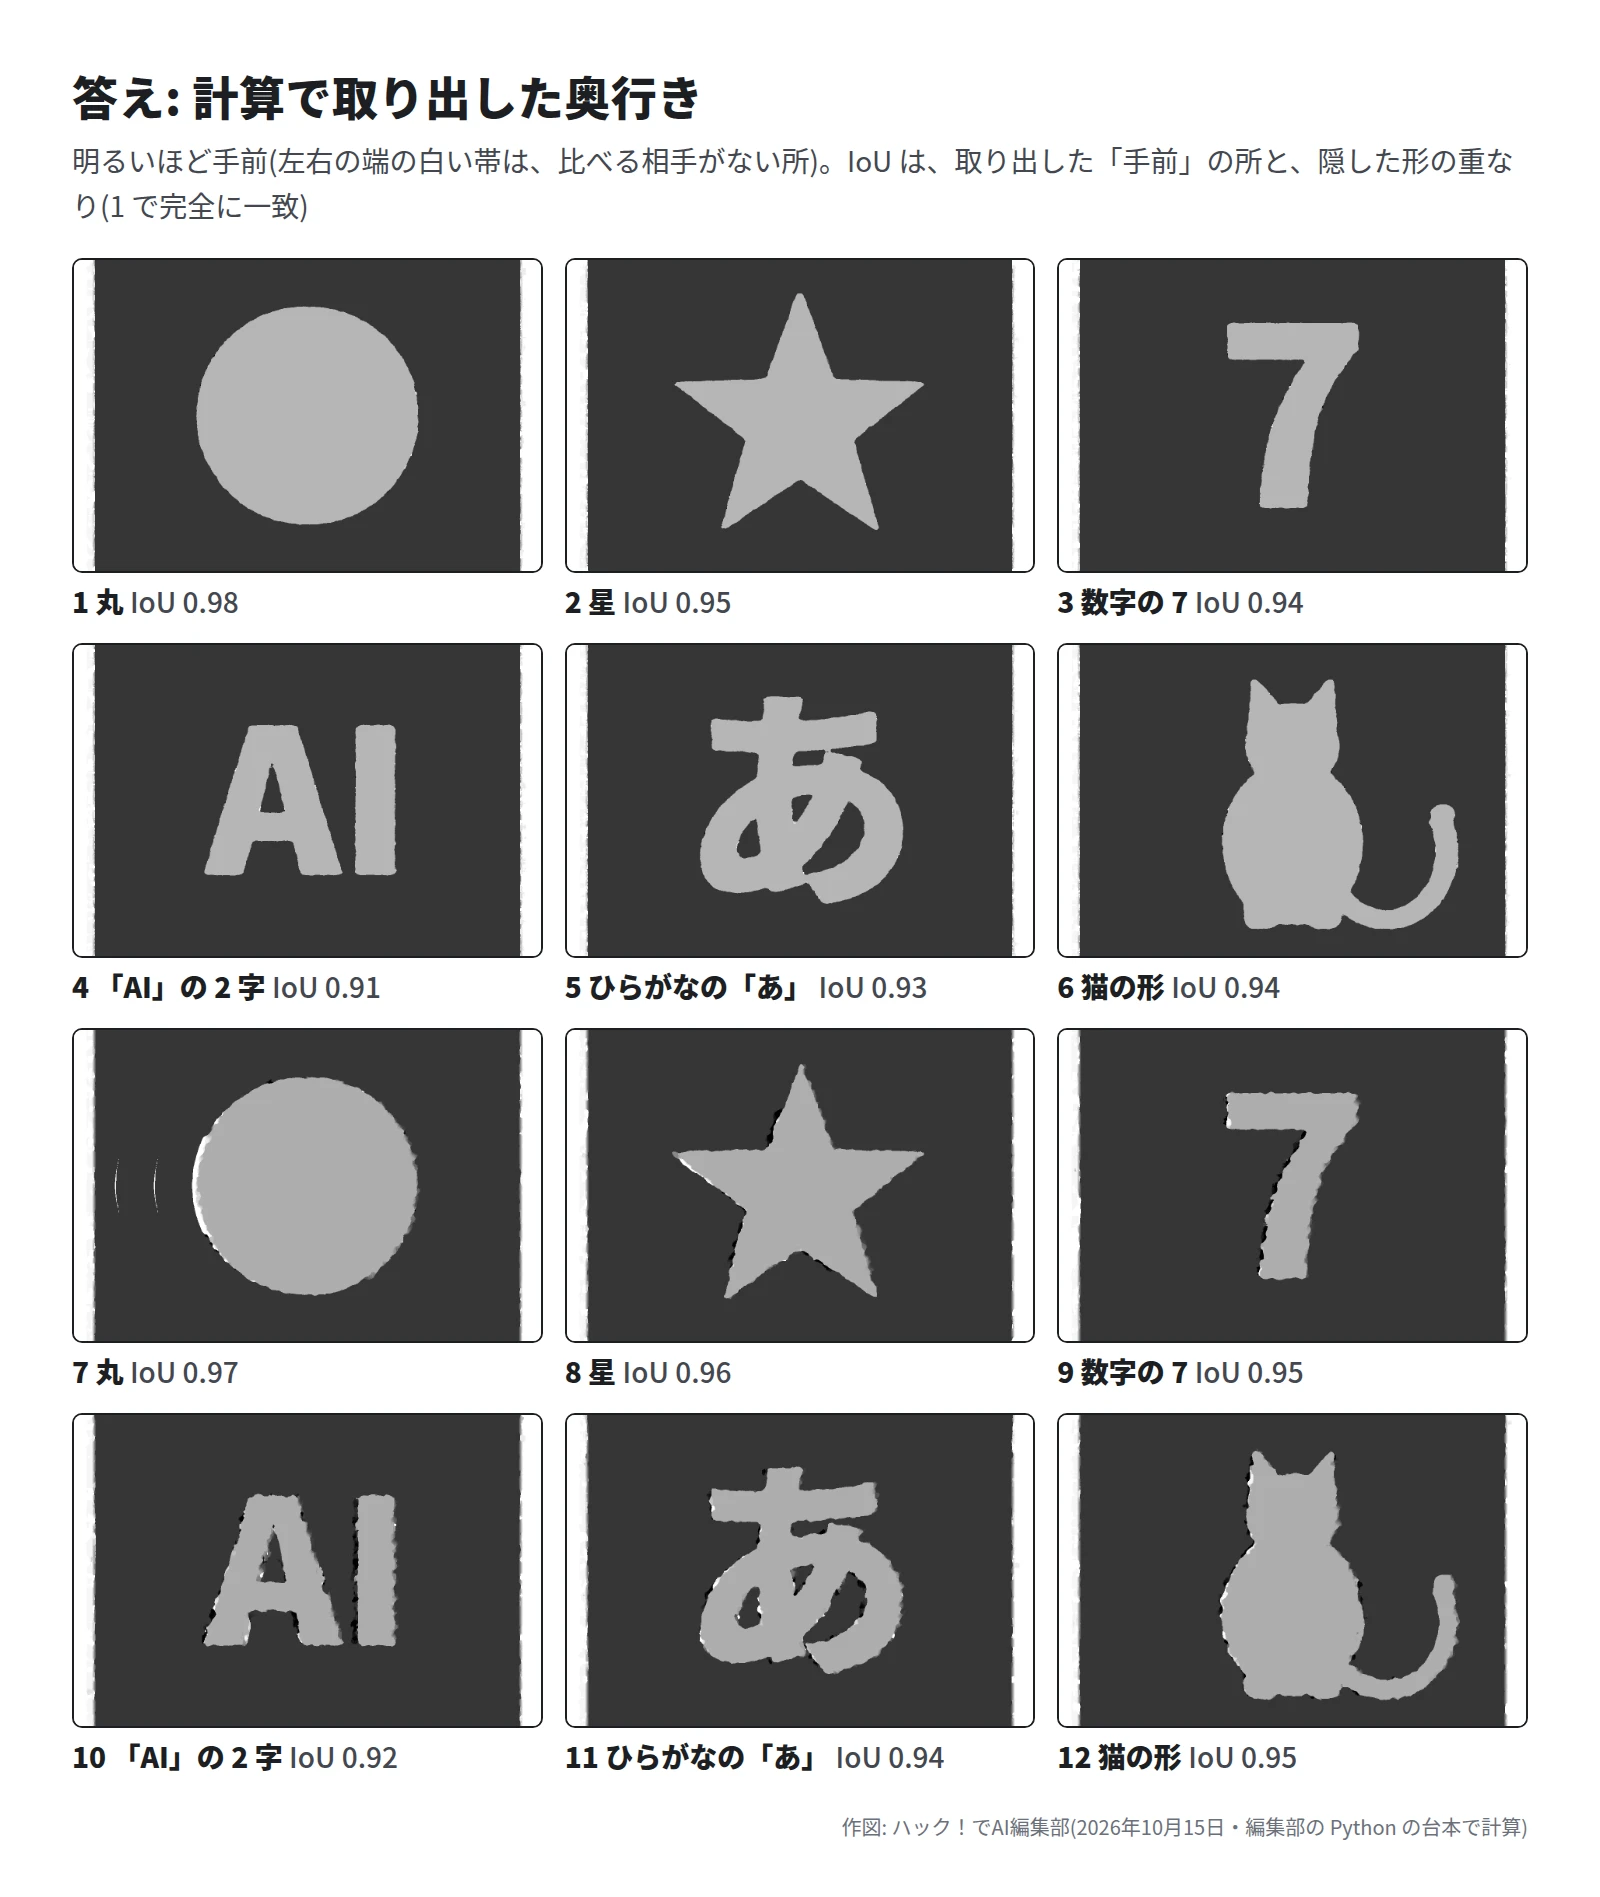
1〜6 と 7〜12 は、同じ順番で、丸・星・数字の 7・「AI」の 2 字・ひらがなの「あ」・猫の形です。
立体視の絵の作り方と、計算での確かめ
ランダムドットの立体視の絵は、Julesz が 1960 年の論文で示した、点だけで奥行きを見せる絵がもとになっています。今回は、Thimbleby・Inglis・Witten の 1994 年の論文の算法で作りました。同じ著者らの 1993 年の報告の要旨には、左右に偏らないこと、隠れた面を除くこと、「echo」と呼ぶ乱れをなくすことが挙げられています。
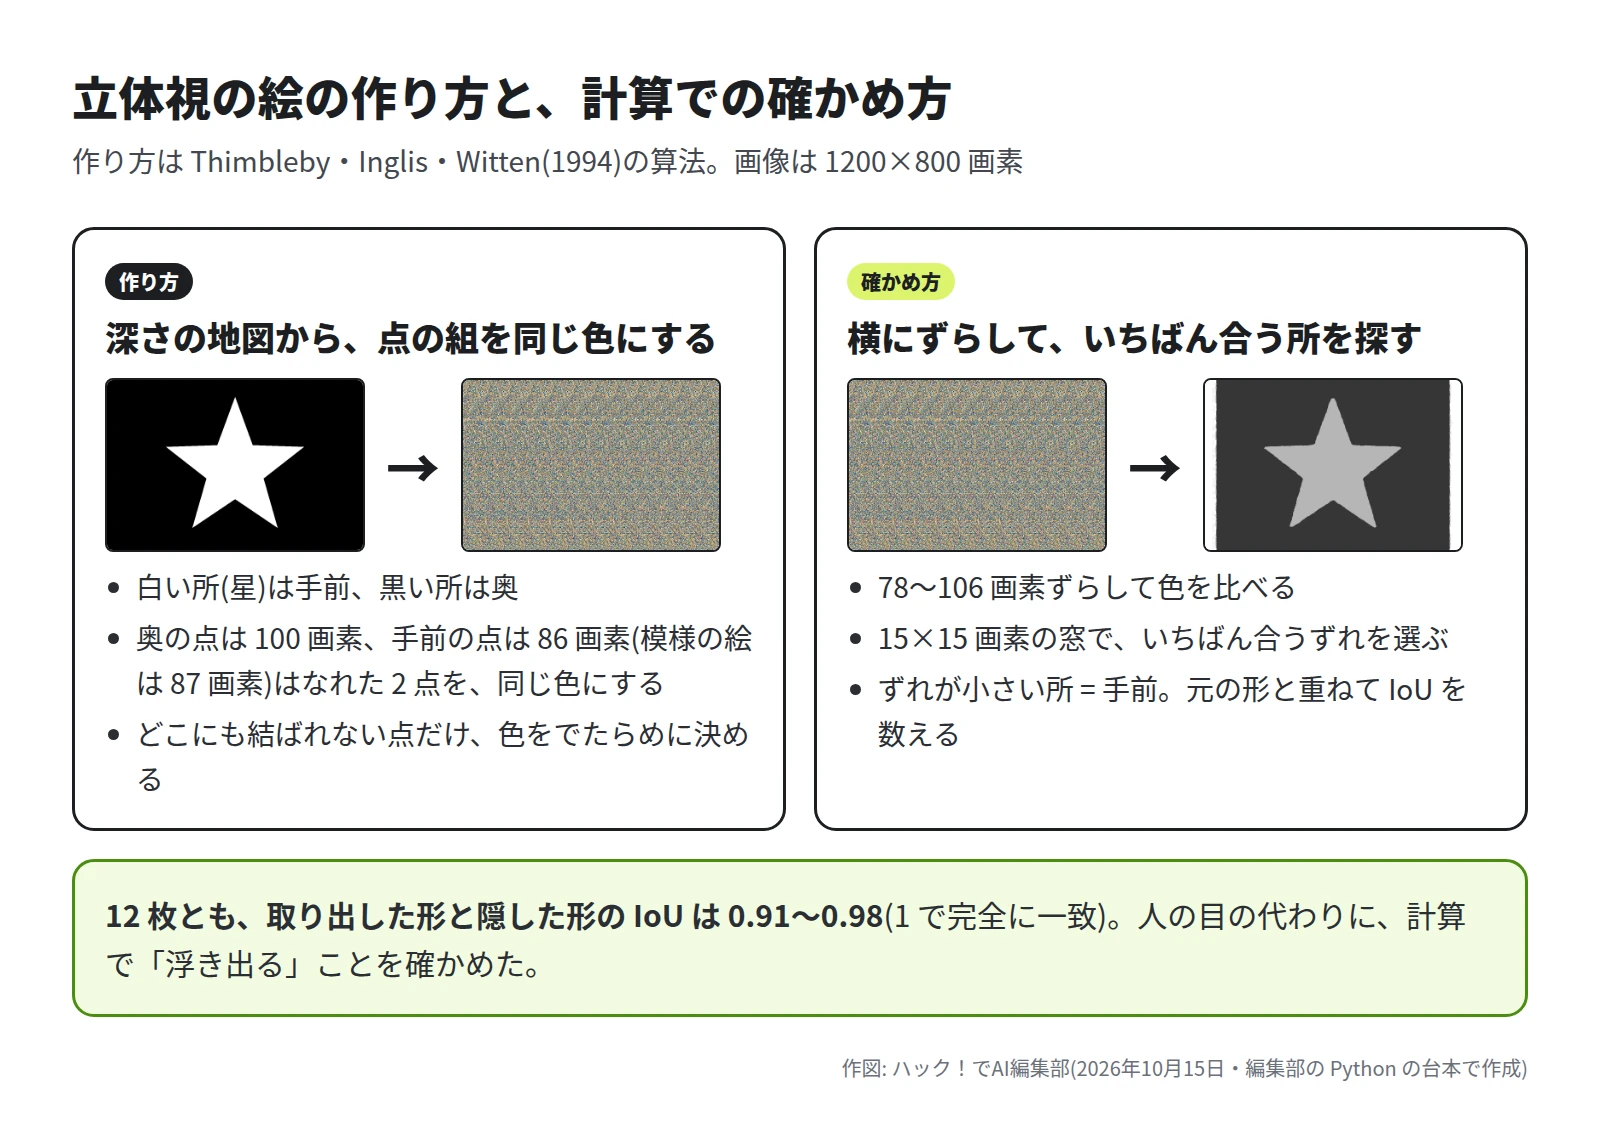
隠した形は 6 つで、形の細かさで「やさしい・ふつう・むずかしい」の目安を付けました(下の答えの表の左の列)。作る台本の要所です(実際の台本から短くしたもの)。
def sep(z, E):
    # 奥行き z(0 = 奥・1 = 手前)の点を、左右の目で見たときの 2 点の間の画素
    return int(round((1 - MU * z) * E / (2 - MU * z)))

for x in range(w):                      # 1 行ずつ、同じ色にする点の組を結ぶ
    s = sep(Z[x], E)
    left = x - (s + (s & y & 1)) // 2
    right = left + s
    if 0 <= left and right < w and visible(x):   # 片方の目から見えない点は結ばない
        link(same, left, right)
for x in range(w - 1, -1, -1):          # 右から左へ、結んだ相手の色を写す
    row[x] = row[same[x]] if same[x] != x else random_color()
浮き出るかどうかは、人の目の代わりに計算で確かめました。
for s in range(78, 107):                # 横に s 画素ずらして、色の差を比べる
    diff = np.abs(img[:, :w - s] - img[:, s:]).sum(axis=2)
    score = uniform_filter(diff, size=15)   # 15×15 画素の窓で平均
    # 各画素で、いちばん差の小さい s を選ぶ
near = best_s < 93.5                    # ずれが小さい所 = 手前
iou = (near & truth).sum() / (near | truth).sum()
- 12 枚とも、取り出した形と隠した形の IoU(重なった面積 ÷ 合わせた面積)は 0.91〜0.98 でした。左右の端の 60 画素は、比べる相手が無いので除いて数えています。
- 模様の絵は、形のふちで模様がずれ、片目でも輪郭が見えます(ふちの線が、繰り返しの幅ごとに何重にも並ぶ)。ランダムドットの絵では、ほとんど見えません。AI の答えを見る前に気づき、そのまま試しました。
AI に見せた
比べ方
| 記事での呼び方 | YOBITSUGI AI の記録の名前 |
|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 |
| GPT-6.1 Sol | gpt-6.1-sol |
| Gemini 3.8 Flash | gemini-3.8-flash |
| Grok 4.3 | grok-4.3 |
各社の標準の段(YOBITSUGI AI の standard)で、12 枚それぞれに 2 通りの文を渡しました(96 回)。
① ヒントなし(4 つのモデルに、この文と画像 1 枚)
この画像に何が写っていますか? 見えるものを、できるだけ具体的に答えてください。
② ヒントあり(4 つのモデルに、この文と画像 1 枚)
これは立体視の絵(オートステレオグラム)です。じっと眺めると、形が浮き出て見えます。浮き出る形は何ですか? 形の名前を 1 つ答え、そう考えた理由を短く書いてください。分からなければ「分からない」と答えてください。
数え方は、結果を見る前に決めました。
- 当てた: 答えの中心に挙げた形が、隠した形と同じ。言い換えは認めます(丸 = 円 など)。「動物」のような大まかな答えは当たりにしません。
- 気づいた(① だけ): 「立体視」「ステレオグラム」「マジックアイ」など、立体視の絵だと言った。
- 違う形(作り話): 隠していない形を、浮き出る形や隠れた形として答えた。模様の説明と「分からない」は数えません。言い切ったか、推測と断ったかを分けて記録しました。
- 採点は編集部(Claude Code を使用)が、この項目で行いました。
ランダムドットの 6 枚
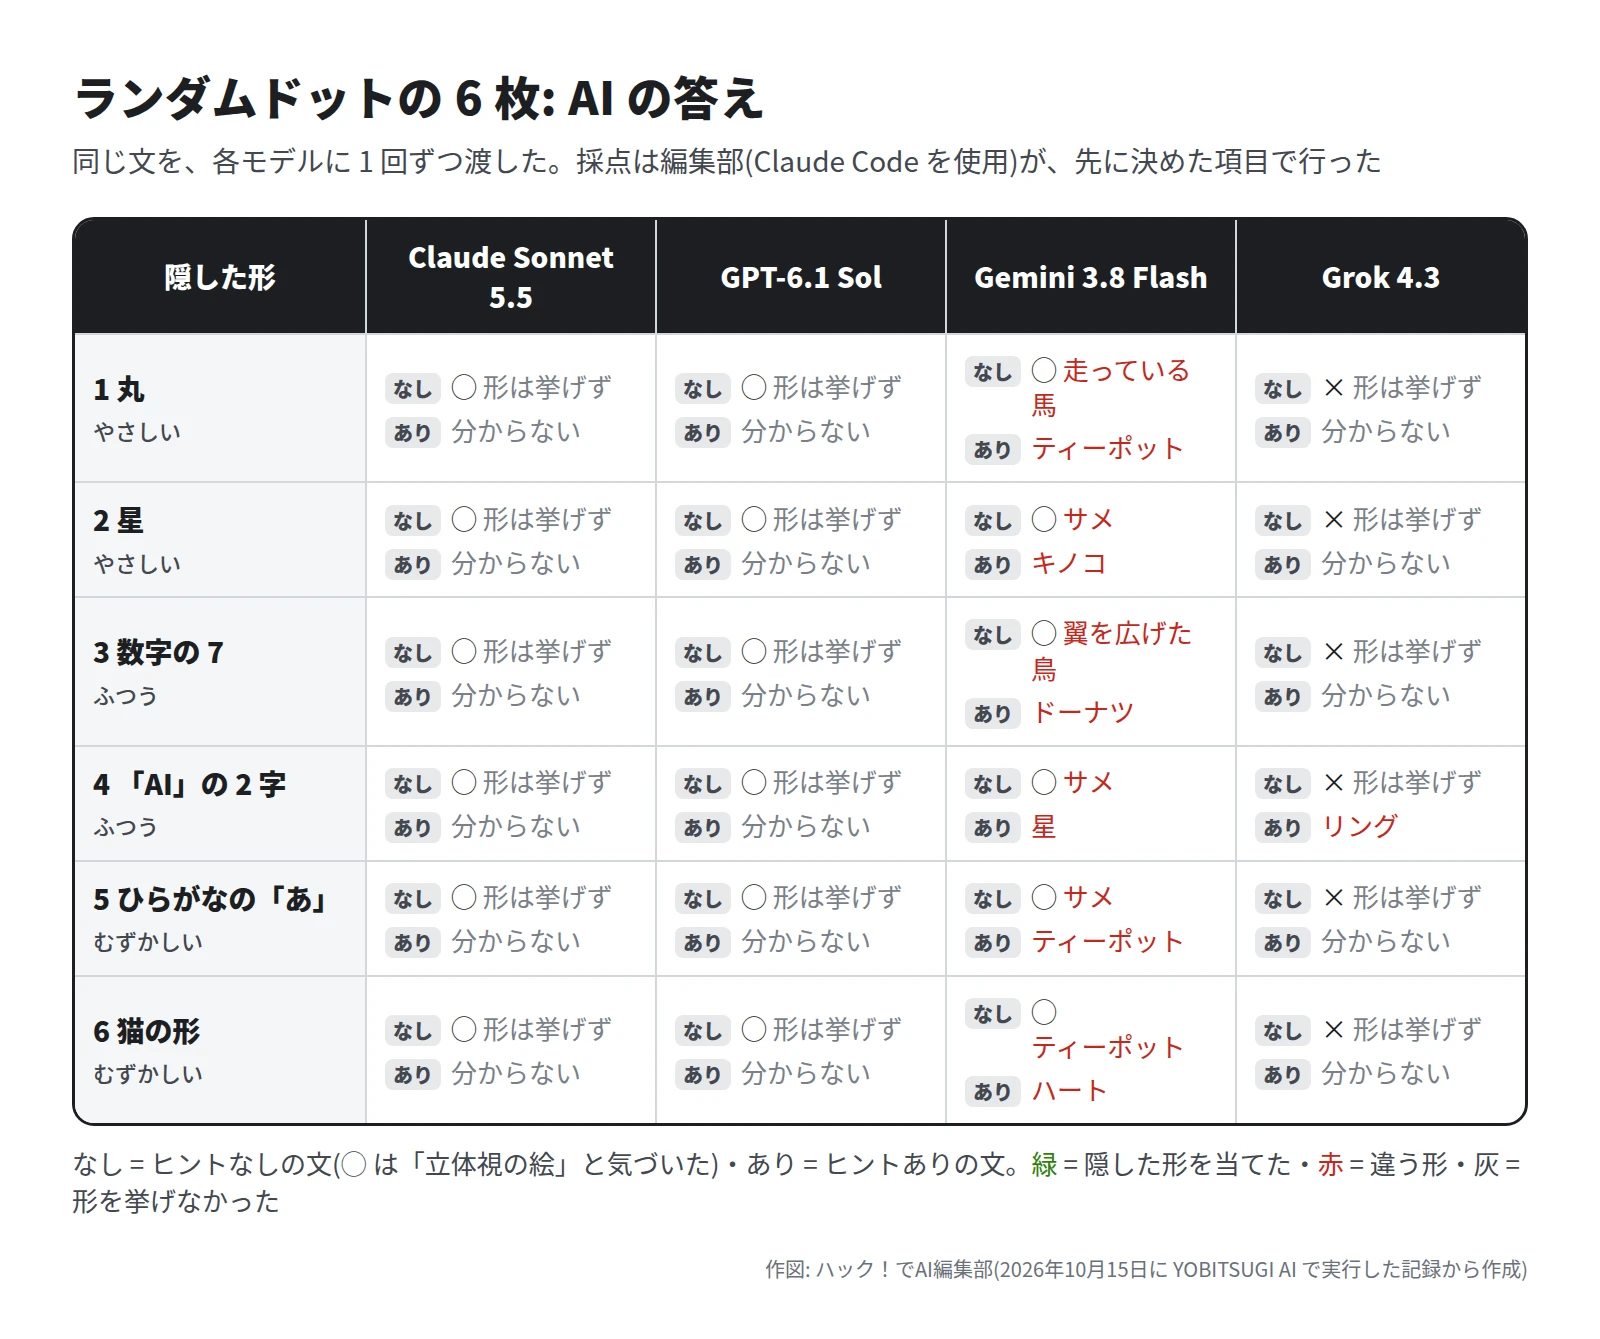
- 4 つとも、隠した形を 1 回も当てませんでした。
- Claude Sonnet 5.5 と GPT-6.1 Sol は、ヒントなしでも 6 回とも立体視の絵だと気づき、隠れた形は判別できないと答えました。Claude Sonnet 5.5 は「約100ピクセル周期」と、繰り返しの幅(編集部の絵は 100 画素)まで書いています。
- Gemini 3.8 Flash は、馬・サメ・鳥などが「くっきりと浮かび上がります」と答えました。Grok 4.3 は、ヒントなしの 6 回とも「ノイズ」と答えました。
模様の 6 枚
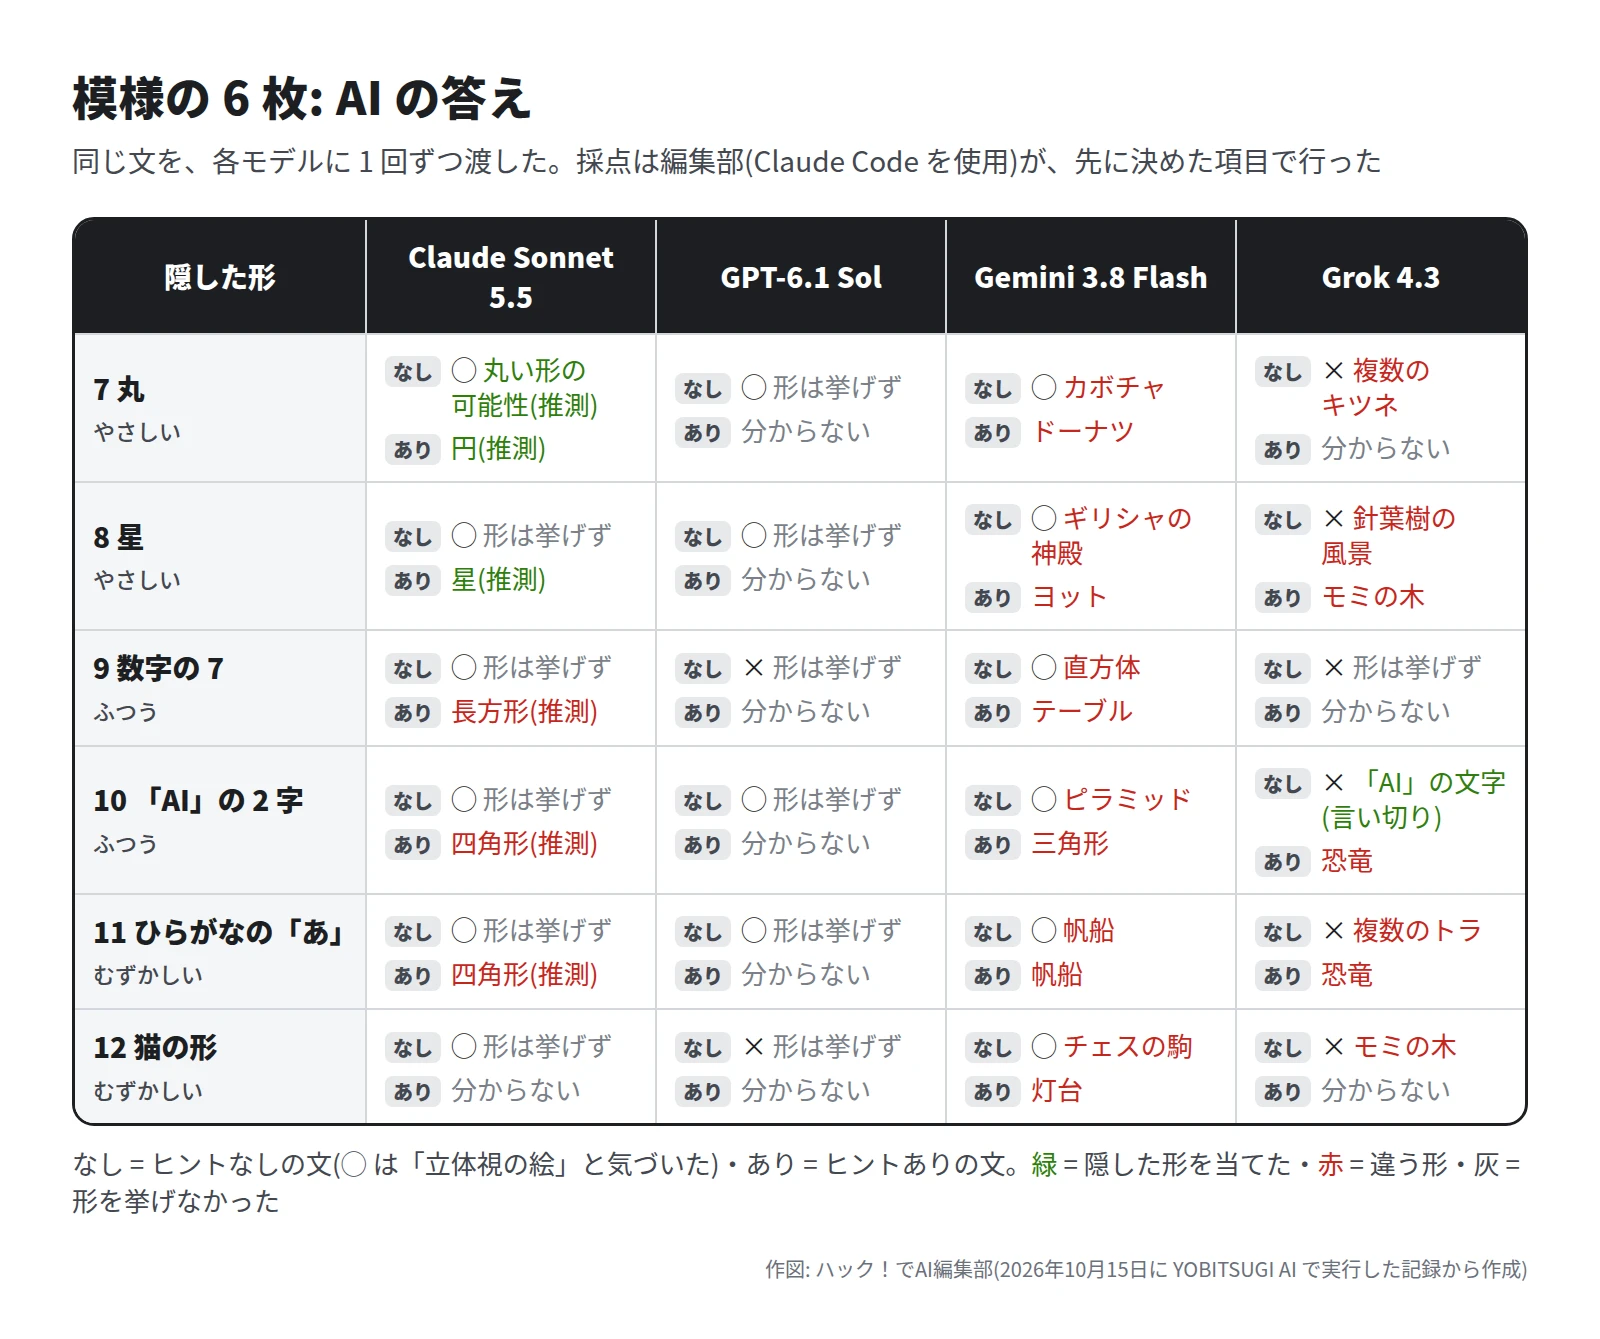
- 当たりの 4 回は、どれも理由に模様のずれや輪郭を挙げています。編集部の見立てでは、立体視をしたのではなく、片目でも見える輪郭を読んだ答えです。
- Claude Sonnet 5.5 は、7 の丸をヒントなしで「円形やドーム状など丸みのある形が隠されている可能性」と推測しました(円形を最初に挙げたので当たりに数えた)。ヒントありでは 7 に「円」、8 に「星(五芒星)」と答えています。
- Grok 4.3 は、10 の「AI」の 2 字を、ヒントなしで「『AI』という文字が浮かび上がるようにデザインされています」と言い切りました。同じ絵に、ヒントありでは「恐竜」と答えています。
最上位のモデルでも試した
確かめとして、YOBITSUGI AI で最上位の段にしているモデルにも、丸の 2 枚を ② の文で見せました(結果を見る前に決めていた確かめです)。
| 最上位の段のモデル | 1 丸(ランダムドット) | 7 丸(模様) | クレジット(2 回) |
|---|---|---|---|
| Claude Opus 5.5 | 分からない | 円(推測と断った) | 5.9 |
| GPT-6 Astra | 分からない | 円 | 13.7 |
| Gemini 3.1 Pro | 星 | サメ | 5.0 |
| Grok 4.7 | 分からない | 数字の 8 | 4.4 |
- ランダムドットの丸は、4 つとも当てませんでした。模様の丸は、Claude Opus 5.5 と GPT-6 Astra が「円」と答え、Claude Opus 5.5 は理由に「左へ膨らむ弧状のずれ」を挙げています。
- 2 枚だけの結果なので、標準の段との差は言えません。
AI の答えの主な部分(原文から抜き出し・太字の記号は省き、かっこの形をそろえた)
1 丸(ランダムドット)・① ヒントなし
Claude Sonnet 5.5: これは「マジックアイ」と呼ばれるオートステレオグラム(隠し絵立体視画像)だと思われます。(中略)ただ、私は画像を立体視できないため、隠れている形が何かは断定できません。
GPT-6.1 Sol: 繰り返し模様を利用して立体像を浮かび上がらせる「ステレオグラム(マジックアイ)」のような画像にも見えます。ただし、この画像にどんな立体形状が隠れているかまでは、確実には判別できません。
Gemini 3.8 Flash: 浮かび上がってくるものは、「駆けている馬(走っている馬 / ギャロップする馬)」の立体的な姿です。
Grok 4.3: 要するに「何も写っていない抽象的なノイズ画像」です。
7 丸(模様)・② ヒントあり
Claude Sonnet 5.5: 答え:円。理由: 絵の左側に、縦に大きく丸みを帯びた弧状のずれの輪郭が見えます(y≈130〜650あたり)。この弧が上下で閉じるように曲がっているので、角のない丸い形が浮き出ていると考えました。ただし輪郭がはっきりせず、自信は高くありません。
GPT-6.1 Sol: 分からない
Gemini 3.8 Flash: 浮き出る形は「ドーナツ(トーラス/円環)」です。
Grok 4.3: 分からない
画像の AI に立体視の絵を作らせた
次は逆に、画像の AI に立体視の絵を頼みました。3 つのモデルに同じ文を渡し、大きさは 1536×1024(横長)にしました。GPT-Image-2.5 Sunburst と Nano Banana Pro は、YOBITSUGI AI の最高の品質の指定(best)で作っています。
渡した文(GPT-Image-2.5 Sunburst・Nano Banana Pro・Grok Imagine 2.0 に同じ文)
立体視の絵(オートステレオグラム)を作ってください。平行法でじっと眺めると、中央に大きな星の形が浮き出て見える絵にしてください。絵の全体は、細かいランダムな点の模様にしてください。
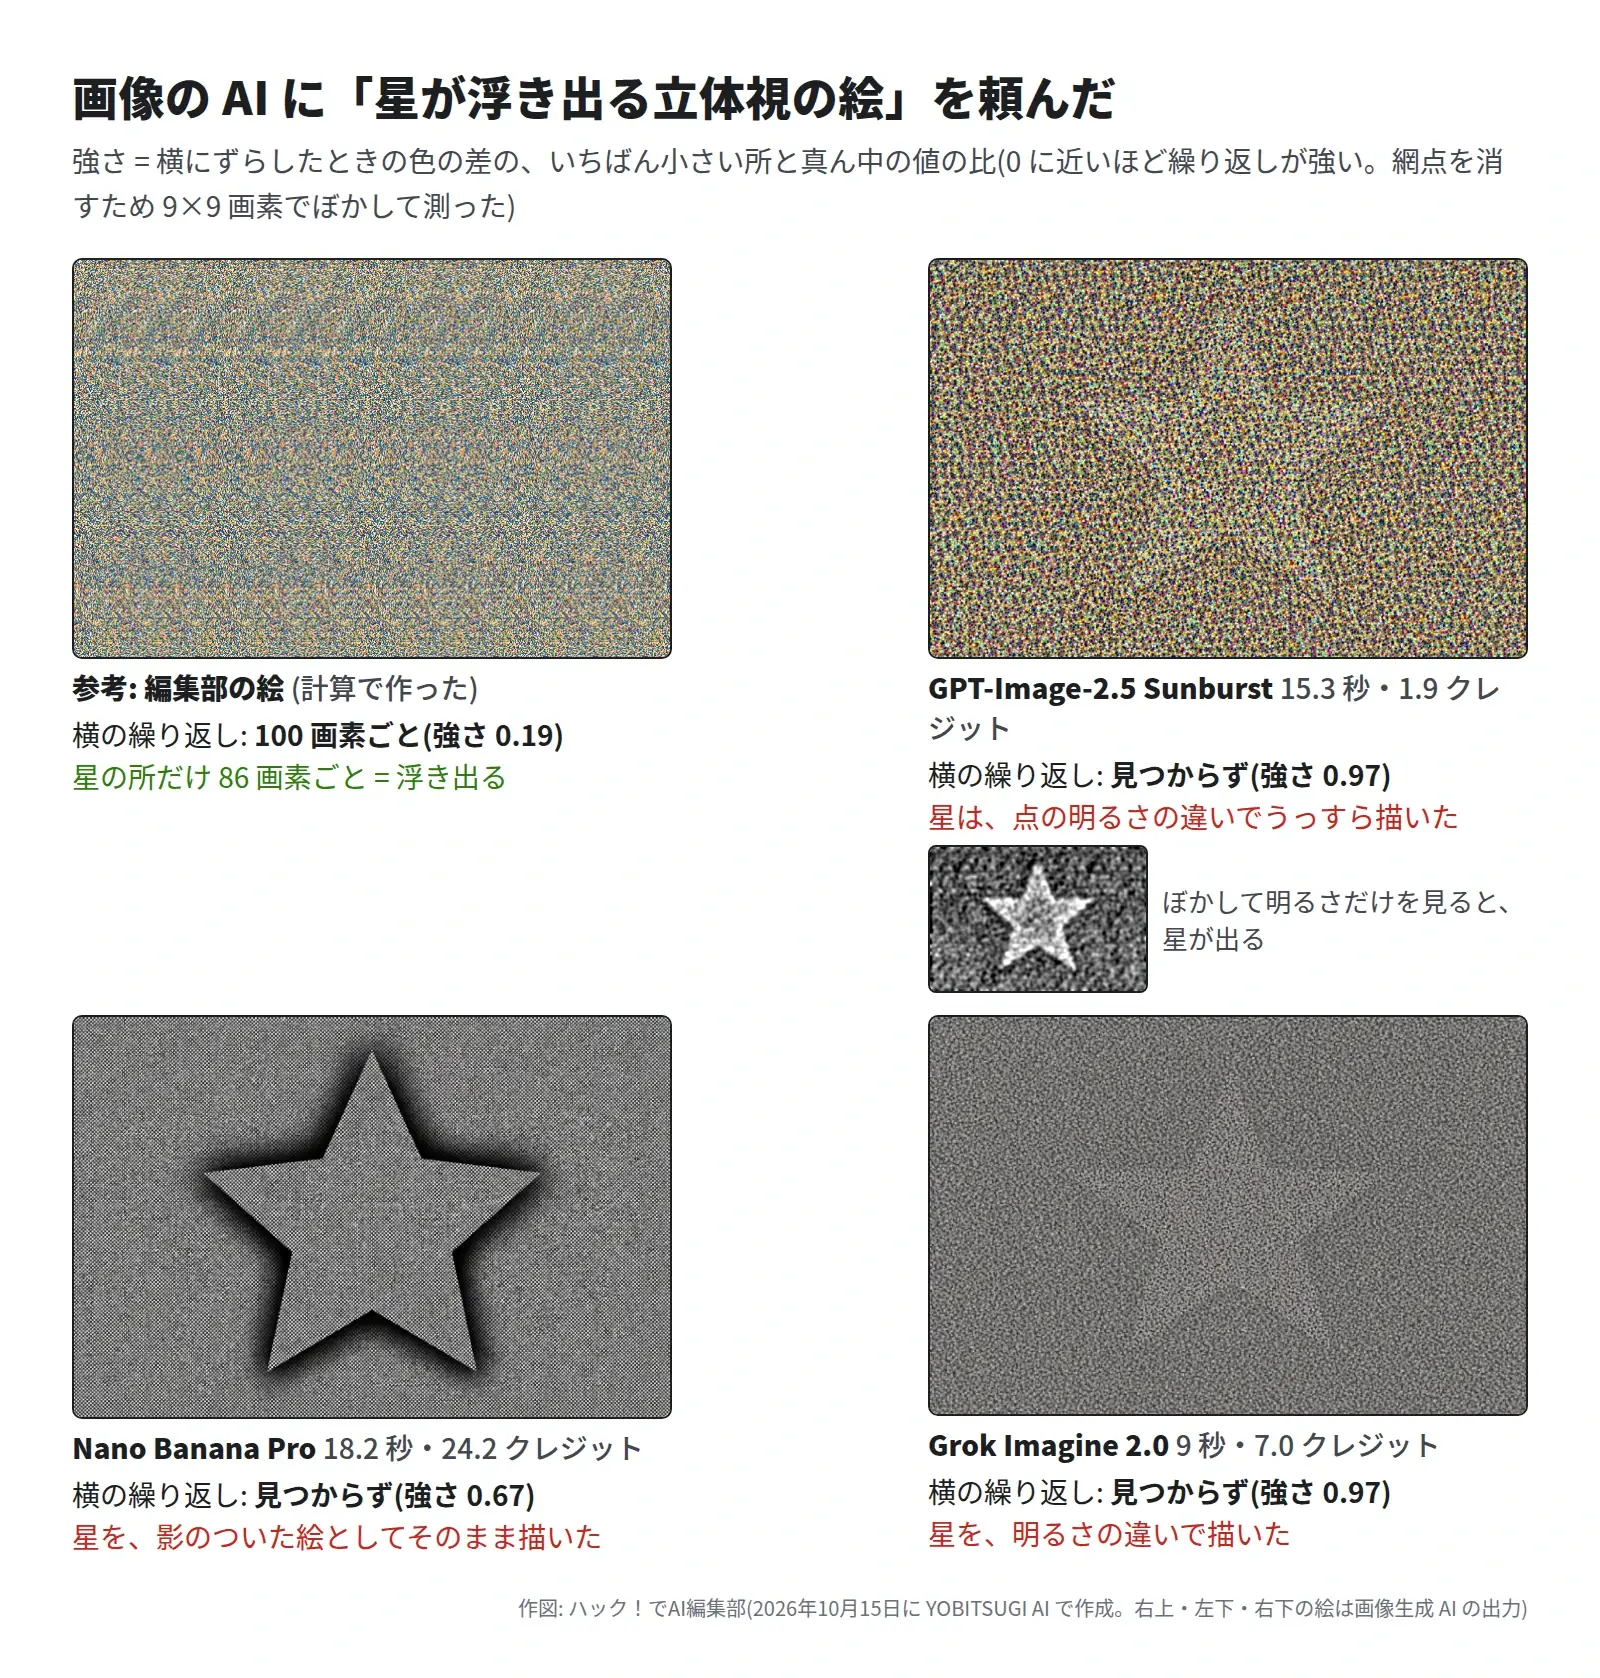
- 立体視の絵なら、横に一定の幅で同じ模様が繰り返し、形の所だけ幅が変わります。編集部の絵の繰り返しの強さは 0.19 でした(0 に近いほど強い)。
- 3 枚とも、こうした繰り返しは見つかりませんでした(強さ 0.67〜0.97)。Nano Banana Pro の 0.67 は探した範囲の端(40 画素)の値で、繰り返しの山ではありません。
- 星は 3 枚とも、片目で見える形で描かれていました。GPT-Image-2.5 Sunburst の星は、ぼかすと点の明るさの違いとして出てきます。
台本を書かせた
見て当てるのがむずかしいなら、計算で解く道はどうか。4 つのモデルに、立体視の絵を作る働き(make)と、絵から奥行きを読み取る働き(decode)を持つ Python の台本を、文字だけで頼みました。
渡した文(Claude Sonnet 5.5・GPT-6.1 Sol・Gemini 3.8 Flash・Grok 4.3 に同じ文)
Python(numpy と Pillow だけを使う)で、次の 2 つの働きを持つ台本 stereo.py を 1 つ書いてください。
1. make: 白黒の深さの地図(白が手前・黒が奥・1200×800 画素の PNG)から、ランダムな点の立体視の絵(オートステレオグラム・平行法で見る)を作って PNG で保存する。
2. decode: 立体視の絵(PNG)から、奥行きを計算で取り出して、白黒の画像(白が手前)として保存する。繰り返しの幅は分からないものとして、絵から求める。
コマンドの行から python stereo.py make depth.png out.png と python stereo.py decode in.png depth_out.png で動くようにしてください。コードは 1 つのコードブロックにまとめ、説明は短くしてください。
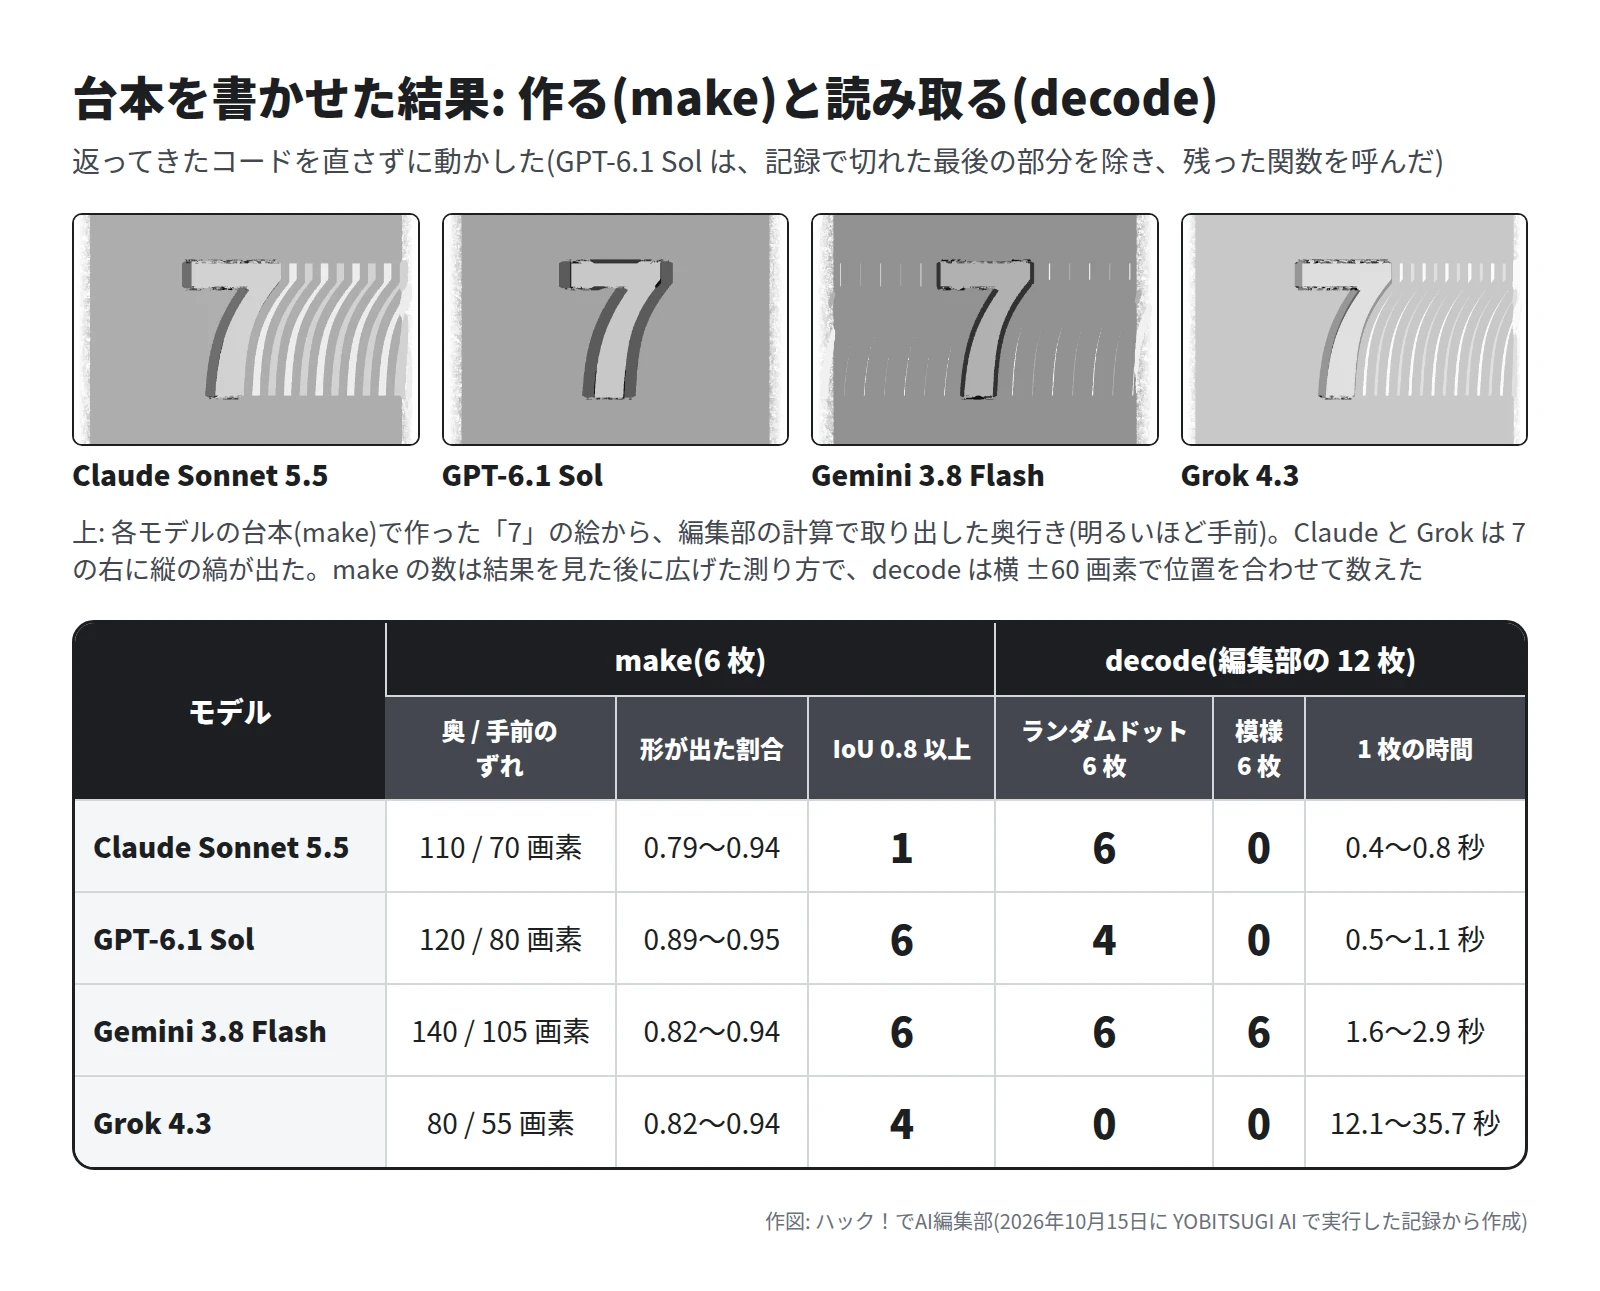
- make: 広げた測り方では、4 つとも、隠した形の 79〜95% が「手前」として出る絵になりました。IoU 0.8 以上は、GPT-6.1 Sol と Gemini 3.8 Flash が 6 枚、Grok 4.3 が 4 枚、Claude Sonnet 5.5 が 1 枚です。
- Claude Sonnet 5.5 と Grok 4.3 の絵は、形の右側に縦の縞が出ました。2 つとも左の点の色を右へ写していく作り方で、縞の所は手前に数えられ、IoU が下がりました。
- decode: Gemini 3.8 Flash の台本は 12 枚すべてで成功しました(IoU 0.86〜0.97)。Claude Sonnet 5.5 はランダムドットの 6 枚、GPT-6.1 Sol はランダムドットの 4 枚で、模様の絵を読めたのは Gemini 3.8 Flash だけです。Grok 4.3 の台本の画像は、全体がほぼ暗い一色でした。
- GPT-6.1 Sol の「7」と「AI」は IoU では外れですが、編集部の見立てでは、目で見ると形は読めます(奥が灰色一色で、2 つに分ける所がずれた)。
Gemini 3.8 Flash が書いた台本(全文・原文のまま)
import sys
import numpy as np
from PIL import Image

def make_stereogram(depth_path, out_path, base_sep=140, max_shift=35):
    depth_img = Image.open(depth_path).convert('L')
    depth = np.array(depth_img, dtype=np.float32) / 255.0
    h, w = depth.shape

    # 出力画像用の配列
    out = np.zeros((h, w), dtype=np.uint8)

    for y in range(h):
        # Disjoint-set (Union-Find) で左右の対応点をリンク
        same = list(range(w))
        for x in range(w):
            sep = int(base_sep - depth[y, x] * max_shift)
            left = x - sep // 2
            right = left + sep
            if 0 <= left and right < w:
                l, r = left, right
                while same[l] != l: l = same[l]
                while same[r] != r: r = same[r]
                if l != r:
                    same[max(l, r)] = min(l, r)

        # リンクに従ってランダムな白黒ドットを配置
        colors = {}
        for x in range(w):
            root = x
            while same[root] != root: root = same[root]
            if root not in colors:
                colors[root] = 255 if np.random.rand() > 0.5 else 0
            out[y, x] = colors[root]

    Image.fromarray(out).save(out_path)

def decode_stereogram(in_path, out_path):
    img = Image.open(in_path).convert('L')
    arr = np.array(img, dtype=np.float32)
    h, w = arr.shape

    # 1. 画像全体の周期(ベースの繰り返し幅)を自己相関から推定
    min_d, max_d = 60, min(250, w // 2)
    diffs = [np.mean(np.abs(arr[:, d:] - arr[:, :-d])) for d in range(min_d, max_d)]
    base_sep = min_d + int(np.argmin(diffs))

    # 探索範囲の設定(手前は周期が狭まるため)
    search_range = range(max(10, base_sep - 45), base_sep + 5)
    costs = []

    # 2. 各シフト量での画素一致コストを計算し、平滑化(ノイズ除去)
    win_r = 4  # 平滑化ウィンドウ半径
    for d in search_range:
        diff = np.zeros((h, w), dtype=np.float32)
        diff[:, d:] = np.abs(arr[:, d:] - arr[:, :-d])
        # 簡易ボックスフィルタ
        c_sum = np.pad(diff, ((win_r, win_r), (win_r, win_r)), mode='edge').cumsum(axis=0).cumsum(axis=1)
        smoothed = (c_sum[2*win_r+1:, 2*win_r+1:] - c_sum[:-2*win_r-1, 2*win_r+1:]
                    - c_sum[2*win_r+1:, :-2*win_r-1] + c_sum[:-2*win_r-1, :-2*win_r-1])
        costs.append(smoothed)

    # 3. 最もコストが小さい周期シフトを選択
    costs = np.stack(costs, axis=0)
    best_shift_idx = np.argmin(costs, axis=0)
    shifts = np.array(list(search_range))[best_shift_idx]

    # 平行法では間隔が狭いほど手前(白)
    depth = base_sep - shifts
    depth[:, :base_sep] = 0  # 左端の余白を初期化
    depth = np.clip(depth, 0, None)

    # 0〜255に正規化して保存
    max_val = np.percentile(depth, 99.5)
    if max_val > 0:
        depth = np.clip(depth / max_val * 255.0, 0, 255)
    Image.fromarray(depth.astype(np.uint8)).save(out_path)

if __name__ == '__main__':
    if len(sys.argv) == 4 and sys.argv[1] == 'make':
        make_stereogram(sys.argv[2], sys.argv[3])
    elif len(sys.argv) == 4 and sys.argv[1] == 'decode':
        decode_stereogram(sys.argv[2], sys.argv[3])
    else:
        print("Usage:")
        print("  python stereo.py make <depth.png> <out.png>")
        print("  python stereo.py decode <in.png> <depth_out.png>")
AI は画像をどう見ているか(公式の説明)
2026年10月15日に、各社の公式のページで確かめた範囲です。
- Anthropic: Claude は画像を 28×28 画素の区切りで見て、区切り 1 つを 1 トークンと数えます。Claude 4.7 以降のモデルは、長い辺 2576 画素まで縮めずに扱います(今回の絵は 43×29 = 1,247 の区切り)。「限界」の項には、質の低い画像などでは誤ることがある、とあります。
- OpenAI: 一部のモデルは画像を 32×32 画素の区切りで覆って数えます。その表に GPT-6 Astra はありますが、GPT-6.1 Sol は見当たりませんでした。「限界」の項には、正確な位置を求める課題が苦手、とあります。
- Google: Gemini 3 では、画像 1 枚のトークンを media_resolution で選べ、指定しないときは 1120 トークンです。
- Grok: API のドキュメントには、画像の大きさの上限(20MiB)と形式(jpg・png)の説明はありますが、画像をどう区切って読むかの説明は見当たりませんでした。
編集部の見立てです。立体視の絵の手がかりは、色が合う 2 点の間の幅(約 100 画素)が、形の所だけ 13〜14 画素変わることです。Claude の区切りの半分ほどです。繰り返しの幅に気づいた答えはありましたが、その小さな変わり目から形を描き出した答えはありませんでした。Claude が画像をどの細かさまで見分けるかは、Claude Code の視力の記事で測っています。
かかった時間と料金
| 試したこと | モデル | 時間(1 回) | クレジット |
|---|---|---|---|
| 見せる(24 回) | Claude Sonnet 5.5 | 2.7〜10.5 秒 | 計 36.8 |
| 見せる(24 回) | GPT-6.1 Sol | 5.4〜30.6 秒 | 計 28.6 |
| 見せる(24 回) | Gemini 3.8 Flash | 6.3〜65.9 秒 | 計 20.2 |
| 見せる(24 回) | Grok 4.3 | 4.4〜11.5 秒 | 計 13.8 |
| 最上位(2 回) | Claude Opus 5.5 | 7.3・12.0 秒 | 計 5.9 |
| 最上位(2 回) | GPT-6 Astra | 5.8・26.2 秒 | 計 13.7 |
| 最上位(2 回) | Gemini 3.1 Pro | 12.0・11.3 秒 | 計 5.0 |
| 最上位(2 回) | Grok 4.7 | 9.5・62.0 秒 | 計 4.4 |
| 作らせる(1 枚) | GPT-Image-2.5 Sunburst | 15.3 秒 | 1.9 |
| 作らせる(1 枚) | Nano Banana Pro | 18.2 秒 | 24.2 |
| 作らせる(1 枚) | Grok Imagine 2.0 | 9.0 秒 | 7.0 |
| 台本(1 回) | Claude Sonnet 5.5 | 64.2 秒 | 13.0 |
| 台本(1 回) | GPT-6.1 Sol | 111.6 秒 | 9.8 |
| 台本(1 回) | Gemini 3.8 Flash | 22.6 秒 | 1.8 |
| 台本(1 回) | Grok 4.3 | 13.3 秒 | 0.6 |
- 111 回の合計は 186.5 クレジットでした。断られたものや、道具の側のエラーで作り直したものはありません。
- 時間は、YOBITSUGI AI に頼んでから答えが返るまでの秒数です(3〜4 件ずつ同時に頼んだ)。Gemini 3.8 Flash の 65.9 秒は 1 回だけで、ほかの 23 回は 6.3〜32.0 秒でした。
- 絵づくりと計算での確かめは編集部のコンピューターで動かしたので、クレジットはかかっていません。
使い分けと気をつけること
- 立体視の絵に何が隠れているかを知りたいときも、浮き出る絵がほしいときも、今回は画像を見せたり描かせたりするより、台本で計算するほうが確かでした。
- 「くっきりと浮かび上がります」という答えでも、作り話のことがあります。
- 「分からなければ『分からない』と答えて」と書いても、答え方はモデルで違いました(ヒントありで「分からない」は GPT-6.1 Sol 12 回・Grok 4.3 8 回・Claude Sonnet 5.5 7 回・Gemini 3.8 Flash 0 回)。
- 模様の絵では、AI が形を当てても、立体視をしたとは限りません。片目でも輪郭が見えるためです。
- どれも 1 回ずつの結果です。同じ文でも、毎回同じ答えになるとは限りません。
まとめ
- 今回の 4 つのモデルは、ランダムドットの絵に隠した形を 48 回のうち 1 回も当てず、当たりは模様の絵の 4 回だけでした。
- 分からないときは、「分からない」と言うモデルと、隠していない形を言い切るモデルに分かれました。
- 立体視の絵を作るのも読むのも、今回は台本を書かせるほうが確かでした。
この記事は、AI 画像の C2PA の記事の番外編です。
参考にした公式の情報
- Anthropic「Vision」(Claude のドキュメント)
- OpenAI「Images and vision」(API ドキュメント)
- Google AI for Developers「Media resolution」(Gemini API)
- Grok API ドキュメント「Image Understanding」
- Thimbleby, Inglis, Witten「Displaying 3D Images: Algorithms for Single-Image Random-Dot Stereograms」IEEE Computer 27(10), pp. 38-48, 1994
- Witten, Inglis, Thimbleby「Displaying 3D images: algorithms for single image random dot stereograms」Waikato 大学 Working Paper 93/2, 1993(要旨)
- Julesz「Binocular Depth Perception of Computer-Generated Patterns」Bell System Technical Journal 39(5), pp. 1125-1162, 1960
- 国立国会図書館サーチ「あっと驚くマジカル・アイ」(宝島社)
- YOBITSUGI AI「料金とシミュレーション」
執筆者
株式会社Game 代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。
この記事は、Claude Code を使って執筆しました。画面の画像は、検証環境で実際に操作して撮影したものです(引用の画像は出典を記載しています)。内容の誤りはお問い合わせからお知らせください。
連載
同じお題で AI を比べる全 20 回の目次
- 1日本語の文字が崩れない画像生成 AI はどれ? 同じ看板を 5 つのモデルに描かせて比べた
- 2Seedance と Kling、どっちがいい? 同じ 1 枚の絵を動画にして比べた
- 3日本語の読み上げが自然な AI はどれ? 同じ原稿を 4 つの声で聞き比べ
- 4生成 AI の使い分け 2026 年版 同じお題で 17 回比べて分かった得意分野
- 5Claude・GPT・Gemini・Grok に同じ仕事を頼んで比べた 要約・メール・企画書の 3 本勝負
- 6GPT-Image-2.5 と Nano Banana Pro、どっちがいい? 同じ 10 のお題で描き比べた
- 7画像生成 AI を実写とアニメで比較 同じプロンプトで 6 モデルの得意と苦手を見る
- 8商品画像は AI のどれで作る? 同じ商品写真から 5 モデルで作って比べた
- 9サムネイルとバナーを AI 5 つに作らせた 文字入りはどこまで使える?
- 10動画生成 AI 5 つを同じプロンプトで比較 動き・破綻・1 本あたりの料金
- 11アニメ調の動画に強い AI はどれ? 同じ 1 枚絵を 5 モデルで動かした
- 12日本語に強い AI はどれ? 敬語・要約・言い換えを 6 モデルで比べた
- 13高いモデルと安いモデル、差が出るのはどんな仕事? 同じ 10 問を料金つきで比べた
- 14文字起こしの精度を AI 3 つで比較 会議・早口・雑音ありの合成音声で試した
- 15Tripo と Meshy を比較 同じ 1 枚の写真から 3D モデルを作って回して見た
- 16AI 動画で同じ人物を保てる? 30 秒以上につないで顔の変わり方を比べた
- 17カメラワークの指示はどこまで通る? パン・ドリーなど 8 種を動画 AI で比べた
- 18絵コンテから AI で動画は作れる? コマの絵を渡す方法と文だけの方法で比べた
- 19画像生成 AI と動画生成 AI の制限はどこから? 水着から戦場まで段階を上げて試した
- 20AI はマジカルアイが見える? 立体視の絵に隠した形を 4 つの AI に見せた(この記事)